Le 9 novembre 2026, Google Cloud a présenté deux nouvelles configurations pour ses systèmes TPU de huitième génération : le TPU 8tx et le TPU 8i Max. Ce dernier intègre deux TPU 8i dans un même boîtier : la puissance de calcul, la SRAM intégrée et la bande passante HBM doublent simultanément. Il est conçu pour les scénarios qui impliquent de longs contextes, une forte concurrence et une inférence collaborative entre plusieurs agents.
Il ne s’agit pas simplement d’une annonce axée sur la puissance de calcul. Les informations ont été confirmées par l’annonce officielle de Google, une annonce de partenariat publiée en parallèle par AMD et des comptes rendus de plusieurs médias. Plutôt que d’énumérer les caractéristiques des puces, cet article s’appuie sur des calculs concrets de cache KV pour illustrer un changement : le principal goulot d’étranglement de l’inférence des agents n’est plus la vitesse de calcul, mais la capacité à acheminer les données à temps vers les unités de calcul.
À retenir : à la fin de cet article, vous saurez estimer la mémoire nécessaire à une requête avec un long contexte, comprendre l’origine du mur mémoire et évaluer ce que la conception de systèmes comme le TPU 8i Max implique pour votre service d’agents.
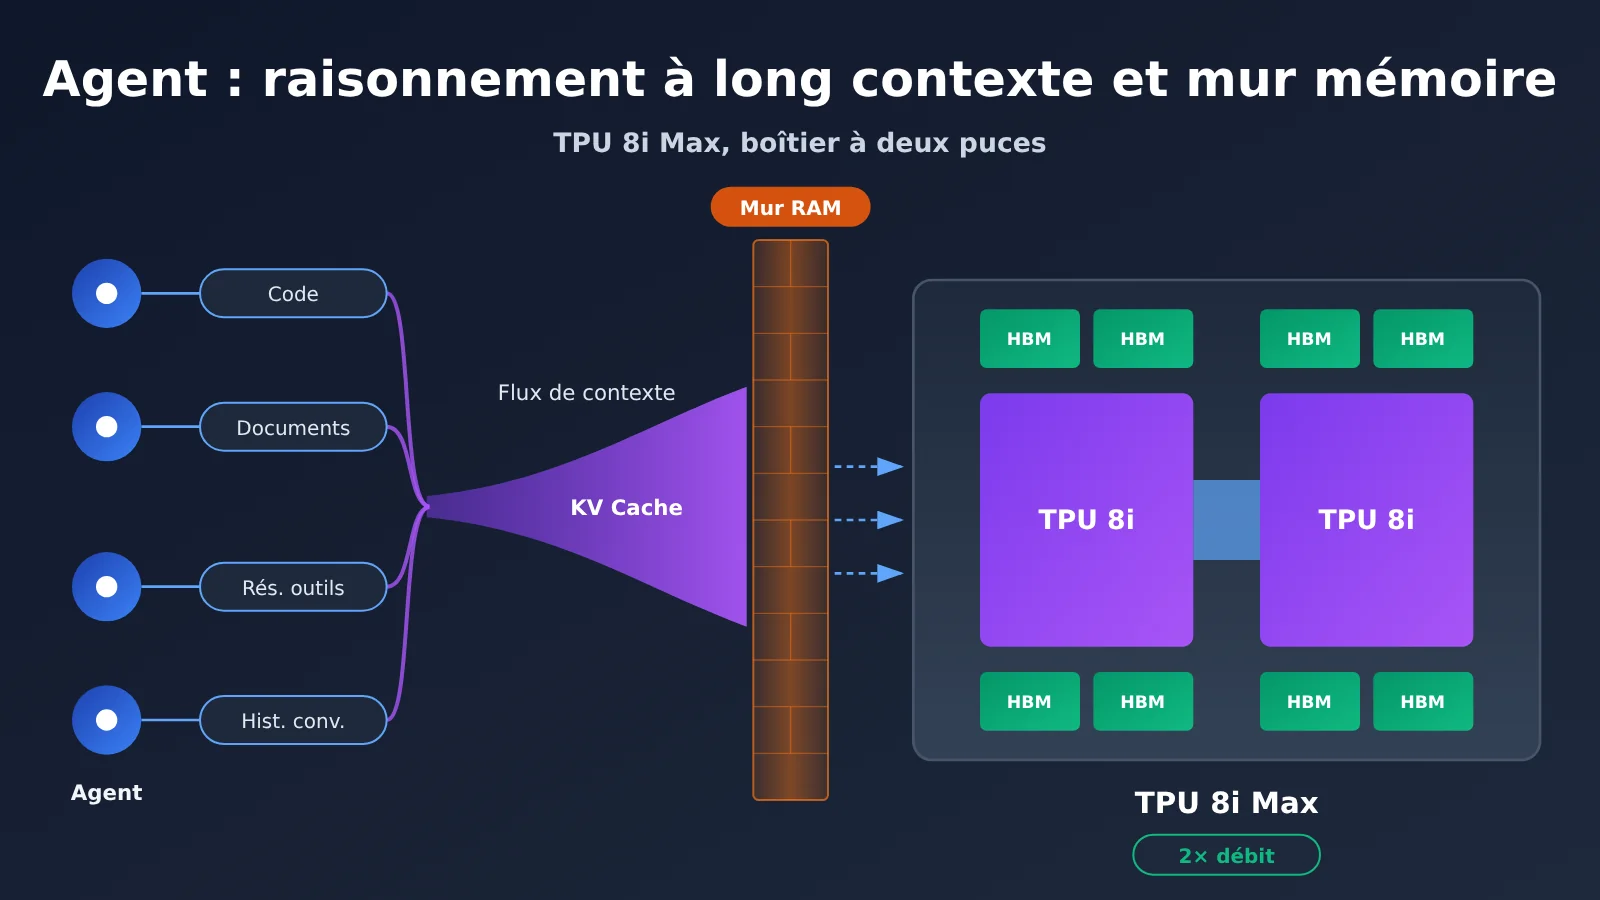
Aperçu des informations clés sur le TPU 8i Max et les agents à long contexte
| Élément | Détails |
|---|---|
| Date de lancement | 9 novembre 2026 |
| Éditeur | Google Cloud |
| Nature du produit | Configuration système de la huitième génération de TPU, et non puce indépendante entièrement nouvelle |
| Packaging | Deux TPU 8i intégrés dans un même boîtier |
| Améliorations confirmées officiellement | Capacité de calcul, SRAM et bande passante HBM multipliées par 2 par rapport au TPU 8i |
| Caractéristiques communiquées lors d’un briefing presse | 384 GB de HBM, 17,2 TB/s de bande passante HBM, 768 MB de SRAM |
| Scénarios visés | Longs contextes, inférence à forte concurrence, collaboration entre plusieurs agents, analyse de longues vidéos, etc. |
| Disponibilité | La page produit officielle indique « Coming soon » ; aucun prix ni aucune date de disponibilité générale (GA) n’ont encore été annoncés |
Il faut souligner que, dans son annonce, Google distingue délibérément la puce du système. La conception d’une puce s’étale sur plusieurs années, tandis qu’une configuration système peut être adaptée plus rapidement à de nouvelles charges de travail en ajustant le packaging, la mémoire, le réseau et les composants de sécurité. Le TPU 8i Max est le fruit de cette approche : il reprend le silicium du TPU 8i, tandis que les changements interviennent au niveau du packaging et du système.
Pourquoi les agents à long contexte consomment plus de mémoire que les conversations classiques
Une conversation classique suit généralement le schéma « une question, une réponse ». Le contexte s’allonge lentement, et son état peut être supprimé à la fin de la session. Un agent, lui, fonctionne autrement : il décompose un objectif en plusieurs sous-tâches, consulte continuellement des ressources externes, utilise des outils, poursuit son raisonnement en fonction des retours et conserve son état pendant qu’il attend les résultats. Chaque étape ajoute du contenu au contexte, qui ne cesse donc de s’allonger.
Prenons l’exemple d’un agent de développement logiciel. Au cours d’une tâche, il peut devoir gérer simultanément :
- Le dépôt de code : des centaines de fichiers source et leurs dépendances
- La documentation du projet : description de l’architecture, conventions d’interface et normes de codage
- L’historique des échanges : plusieurs tours de clarification des besoins et les demandes de modification de l’utilisateur
- Les résultats des outils : journaux de compilation, sorties des tests et traces d’erreur
- Les résultats des agents secondaires : les retours de chaque agent chargé des tests, de la revue ou de la refactorisation
La concurrence rend la situation encore plus exigeante. Lorsqu’un agent principal lance 4 agents secondaires, le système contient simultanément 5 contextes indépendants. Chacun doit rester en mémoire pendant le raisonnement. C’est pourquoi Google cite la « collaboration de plusieurs agents au développement de grands projets logiciels » comme un cas d’usage type du TPU 8i Max. Il faut toutefois préciser que le « contexte d’un million de jetons » évoqué par Google décrit un scénario d’application visé, et non une limite maximale de contexte fixe déjà annoncée.
Comment le cache KV croît linéairement avec les longs contextes des agents
Rôle du cache KV
Lorsqu’il génère un nouveau token, un Transformer doit utiliser la Query du token courant pour calculer les scores d’attention avec les Key de tous les tokens précédents. Il utilise ensuite les poids obtenus pour calculer une somme pondérée des Value de ces tokens. Recalculer les Key et les Value de tout l’historique à chaque nouveau token ferait rapidement exploser le coût de calcul. Le cache KV consiste à stocker les Key et les Value déjà calculées pour les tokens précédents afin de les réutiliser : on échange de la mémoire contre du calcul.
En contrepartie, ce cache augmente continuellement avec la longueur du contexte et le nombre de requêtes traitées simultanément. La formule d’estimation ci-dessous correspond à l’organisation de la mémoire du cache KV dans vLLM :
M_KV = 2 × L × H_KV × D × B × T × N
| Paramètre | Signification | Valeur pour Llama 3.1 70B |
|---|---|---|
| 2 | Deux caches : Key et Value | 2 |
| L | Nombre de couches Transformer | 80 |
| H_KV | Nombre de têtes d’attention Key/Value | 8 (GQA) |
| D | Dimension de chaque tête KV | 128 |
| B | Nombre d’octets par élément | 2 (BF16) |
| T | Nombre de tokens par requête | Variable selon le scénario |
| N | Nombre de requêtes simultanées | Variable selon le scénario |
Exemple de calcul du cache KV pour Llama 3.1 70B
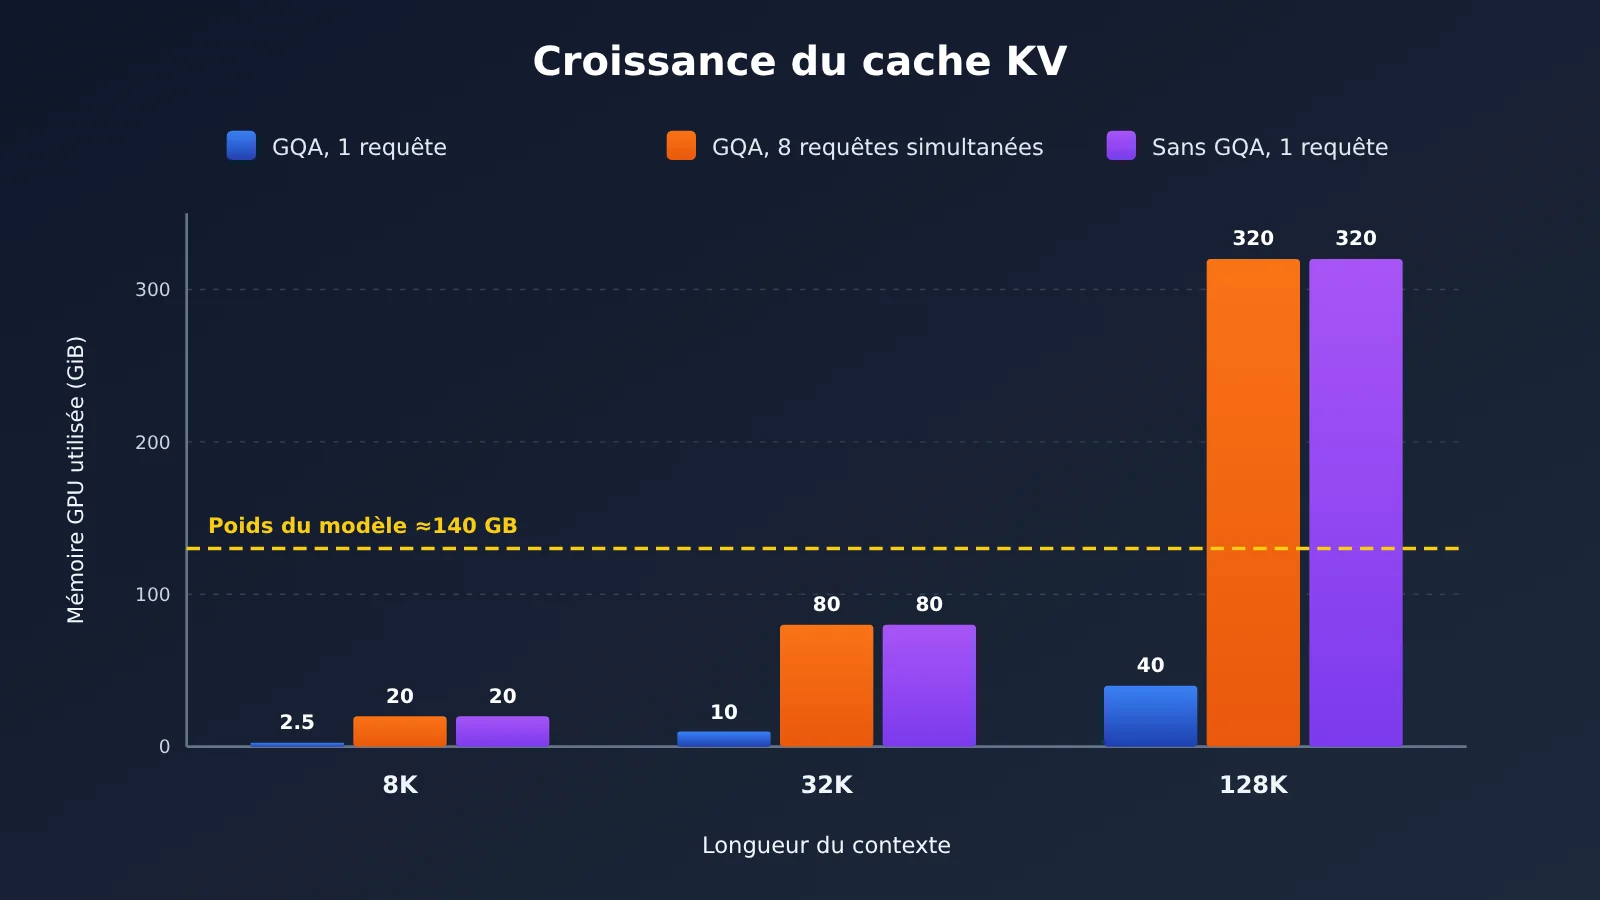
Commençons par calculer la mémoire nécessaire pour un seul jeton : 2 × 80 × 8 × 128 × 2 = 327 680 octets, soit environ 320 Kio par jeton. Ce chiffre peut sembler modeste, mais il augmente rapidement avec la longueur du contexte.
| Scénario | Longueur du contexte | Nombre de requêtes simultanées | Cache KV théorique |
|---|---|---|---|
| Tâche courte | 8K | 1 | 2,5 Gio |
| Tâche de programmation moyenne | 32K | 1 | 10 Gio |
| Agent à long contexte | 128K | 1 | 40 Gio |
| Plusieurs agents en parallèle | 128K | 8 | 320 Gio |
Ces chiffres ne prennent en compte que le cache KV, sans inclure les poids du modèle, l’espace de travail à l’exécution ni la mémoire perdue à cause de la fragmentation. À titre de comparaison, le stockage des poids d’un modèle de 70 milliards de paramètres en BF16 nécessite à lui seul environ 140 Go. Autrement dit, le cache KV nécessaire à 8 sessions simultanées de 128K dépasse déjà le double de la mémoire occupée par les poids du modèle.
Influence de GQA sur la mémoire du cache KV
Llama 3.1 70B possède 64 têtes d’attention, mais seulement 8 têtes KV : c’est le mécanisme GQA (Grouped-Query Attention), où chaque groupe de 8 têtes Query partage un ensemble de clés et de valeurs. Pour le calcul, il faut utiliser 8 et non 64, sans quoi le résultat serait 8 fois trop élevé.
Un scénario hypothétique permet de mieux voir l’intérêt de GQA. Si le modèle utilisait l’attention multi-tête standard, avec des KV distincts pour chacune des 64 têtes, le cache KV d’une seule requête de 128K passerait de 40 Gio à 320 Gio. Une seule requête consommerait alors autant que les 8 requêtes simultanées avec GQA. MQA réduit encore le nombre de têtes KV à une seule, ce qui diminue la mémoire nécessaire, mais il faut aussi tenir compte de son effet sur la qualité du modèle. Enfin, la quantification du cache KV — par exemple, en passant de BF16 à 8 bits — permet de réduire encore de moitié la mémoire utilisée, au prix d’une perte de précision à évaluer.
Le script ci-dessous reprend directement la formule précédente pour estimer rapidement la taille du cache KV de votre modèle selon le contexte et le nombre de requêtes simultanées :
def kv_cache_gib(layers, kv_heads, head_dim, bytes_per_elem, tokens, concurrency=1):
    """Estime le cache KV en Gio selon M_KV = 2 × L × H_KV × D × B × T × N"""
    total = 2 * layers * kv_heads * head_dim * bytes_per_elem * tokens * concurrency
    return total / (1024 ** 3)

# Llama 3.1 70B : 80 couches, 8 têtes KV, dimension 128, BF16
for ctx in (8_192, 32_768, 131_072):
    print(f"{ctx:>7} tokens -> {kv_cache_gib(80, 8, 128, 2, ctx):.1f} GiB")

print("8 并发 x 128K ->", kv_cache_gib(80, 8, 128, 2, 131_072, 8), "GiB")
print("FP8 KV 量化 128K ->", kv_cache_gib(80, 8, 128, 1, 131_072), "GiB")
En quoi consiste le mur de la mémoire pour le raisonnement des agents à long contexte ?
Capacité, bande passante et SRAM : trois dimensions distinctes
L’erreur la plus courante lorsqu’on parle du mur de la mémoire consiste à confondre « grande capacité mémoire » et « mémoire rapide ». En réalité, le système mémoire d’un accélérateur d’IA repose sur au moins trois critères indépendants :
| Critère | Ce qu’il détermine | Ce que cela signifie pour un agent |
|---|---|---|
| Capacité HBM | La quantité de données qui peut être stockée | Le nombre de poids du modèle et de caches KV pouvant être conservés simultanément, donc le nombre de contextes traités en parallèle |
| Bande passante HBM | La quantité de données transférable par unité de temps | La rapidité avec laquelle les poids et le cache KV peuvent être acheminés vers les cœurs de calcul à chaque génération de jeton |
| SRAM sur puce | Le stockage rapide le plus proche des cœurs de calcul | La possibilité de conserver les données fréquemment utilisées sur la puce pour éviter les délais liés aux accès répétés à la HBM |
La HBM est une DRAM qui exploite l’empilement de plusieurs couches et un boîtier avancé pour permettre des accès hautement parallèles. La SRAM est plus rapide et plus proche des unités de calcul, mais son coût par unité de capacité est élevé et sa surface physique limitée. C’est pourquoi les accélérateurs modernes adoptent généralement une hiérarchie de mémoire à plusieurs niveaux, plutôt que de chercher à maximiser la capacité d’un seul type de mémoire.
Le préremplissage et le décodage ont des besoins très différents
L’inférence d’un LLM se déroule en deux phases. Pendant le préremplissage (prefill), tout le contexte d’entrée est traité en une seule fois et le cache KV est créé. De nombreux jetons peuvent être calculés en parallèle : c’est une tâche typiquement limitée par le calcul. Pendant le décodage (decode), les jetons de sortie sont générés un à un. À chaque étape, un seul nouveau jeton est traité, mais il faut lire tous les poids et l’intégralité du cache KV. La quantité de calcul est faible, tandis que le volume de données transférées est important : c’est une tâche limitée par la bande passante.
Une estimation simplifiée permet de se faire une idée de la pression exercée pendant le décodage. Pour une requête de 128K, le cache KV représente environ 40 GiB (environ 43 GB), et il faut le lire intégralement pour générer chaque jeton. Avec la bande passante HBM d’une puce TPU 8i, d’environ 8,6 TB/s, la lecture du seul cache KV nécessite environ 5 millisecondes. Avec les 17,2 TB/s du TPU 8i Max, la limite théorique descend à environ 2,5 millisecondes. Ces chiffres ne tiennent compte ni de la lecture des poids, ni du chevauchement avec les calculs, ni du partitionnement parallèle. Ils suffisent néanmoins à montrer qu’à mesure que le contexte s’allonge, le décodage dépend de plus en plus du transfert des données et de moins en moins du calcul.
Pourquoi les unités de calcul se retrouvent-elles à « attendre les données » ?
Lorsque les cœurs de calcul peuvent effectuer beaucoup plus d’opérations par seconde que la mémoire ne peut fournir de données, les unités de calcul tournent à vide en attendant : c’est le mur de la mémoire. Pour un agent, un long contexte augmente le volume de données à lire à chaque étape de décodage ; un niveau de concurrence élevé multiplie les caches KV à conserver en mémoire ; et les raisonnements en plusieurs étapes nécessitent de relire et de mettre à jour ces caches à plusieurs reprises. L’effet cumulé de ces trois facteurs réduit de plus en plus les gains apportés par une simple hausse de la puissance de calcul maximale.
🎯 Conseil technique : avant d’évaluer votre application d’agent, mesurez le délai avant le premier jeton (TTFT) et la vitesse de génération pour différentes longueurs de contexte. Observez comment le délai évolue avec la taille du contexte. Avec APIYI, sur apiyi.com, vous pouvez passer d’un modèle à l’autre — Claude, Gemini, GPT, etc. — à l’aide d’une seule clé API, et comparer ainsi leurs performances sur les longs contextes.
Comment le boîtier à deux puces du TPU 8i Max augmente la bande passante mémoire
Comment deux TPU 8i sont associés
Le TPU 8i Max est la quatrième configuration système de la huitième génération de TPU. Google a constaté que lorsque plusieurs agents traitent simultanément de grandes bases de code, de longues vidéos ou des documents complexes, le goulot d’étranglement n’est souvent pas la puissance de calcul, mais la vitesse à laquelle les puces lisent et échangent des données. La solution consiste à intégrer deux TPU 8i à faible latence dans un même boîtier et à y placer deux fois plus de silicium, sans augmenter l’encombrement dans le rack.
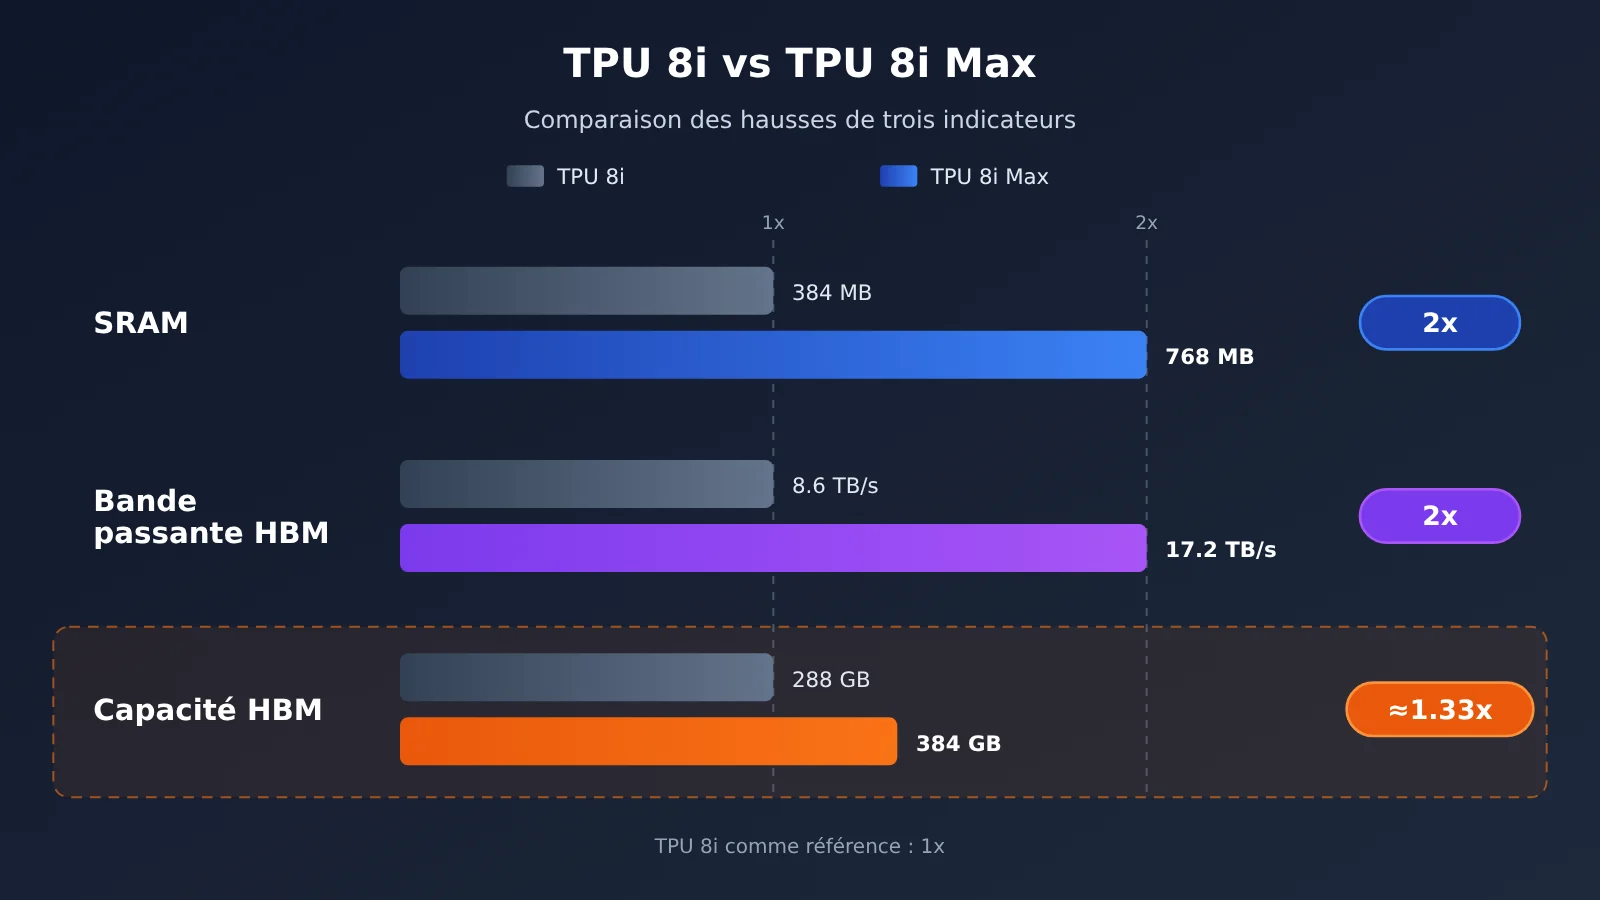
| Indicateur | TPU 8i | TPU 8i Max | Évolution |
|---|---|---|---|
| Boîtier | Une puce | Deux puces | — |
| Puissance de calcul | Référence | 2 fois plus | Multipliée par deux |
| SRAM sur puce | 384 MB | 768 MB | Multipliée par deux |
| Bande passante HBM | 8,601 GB/s | 17,200 GB/s | Environ multipliée par deux |
| Capacité HBM | 288 GB | 384 GB | En hausse d’environ 33 % |
Remarque : les données du TPU 8i proviennent d’un article technique sur son architecture publié par Google en avril 2026. Les valeurs absolues du TPU 8i Max proviennent d’un compte rendu médiatique du 9 novembre ; l’article officiel confirme explicitement le doublement de la puissance de calcul, de la SRAM et de la bande passante HBM.
Pourquoi une mise à l’échelle coordonnée est plus pertinente qu’une simple hausse de la puissance de calcul
Si l’on augmente uniquement la puissance de calcul, la phase de décodage se heurte encore davantage aux limites de la bande passante. À l’inverse, si l’on augmente seulement la bande passante, les unités de calcul risquent de ne pas être suffisamment sollicitées. Le TPU 8i Max fait évoluer à peu près au même rythme la puissance de calcul, la SRAM et la bande passante HBM, de sorte que le rapport entre le débit d’alimentation en données et la vitesse de calcul reste proche de l’équilibre prévu par la conception initiale. La SRAM, deux fois plus grande, permet aussi de conserver davantage de données fréquemment utilisées sur la puce et de réduire ainsi les allers-retours vers la HBM.
La capacité HBM n’augmente que d’environ 33 %, et non du double
C’est le détail le plus facile à présenter de travers. La bande passante HBM passe d’environ 8,6 TB/s à 17,2 TB/s, soit le double, tandis que la capacité HBM ne passe que de 288 GB à 384 GB, une hausse d’environ 33 %. Ces chiffres permettent de comprendre ce que cela implique : le TPU 8i Max offre davantage de bande passante par Go de mémoire et lit donc plus rapidement un KV Cache de même taille. En revanche, l’augmentation du volume de contexte qu’il peut contenir simultanément est bien inférieure à celle de sa bande passante.
Autrement dit, le principal intérêt du TPU 8i Max n’est pas de doubler la limite de contexte d’un modèle, mais de permettre au système de prendre en charge et de traiter plus efficacement un grand nombre de contextes simultanés. Si la capacité ne suffit pas, il faut toujours recourir à des techniques logicielles comme le déchargement du KV Cache, la quantification et le partitionnement sur plusieurs puces.
Comparaison de l’architecture mémoire des GPU et du TPU 8i Max
Pour comprendre le positionnement du TPU 8i Max, on peut prendre comme référence GPU la toute dernière architecture Rubin de NVIDIA.
| Critère | GPU NVIDIA Rubin | Google TPU 8i Max |
|---|---|---|
| Unité de mesure | Un GPU | Un boîtier réunissant deux puces TPU |
| Capacité HBM | 288 GB HBM4 | 384 GB HBM (selon des informations publiées dans les médias) |
| Bande passante HBM | 22 TB/s | 17,2 TB/s (selon des informations publiées dans les médias) |
| Mémoire sur puce | Dépend de la configuration de l’architecture | 768 MB de SRAM (selon des informations publiées dans les médias) |
| Interconnexion entre puces | NVLink 6 | Réseau à faible latence Boardfly (écosystème TPU 8i) |
| Écosystème logiciel | CUDA et principaux moteurs d’inférence | JAX, TorchTPU, backends TPU de vLLM / SGLang |
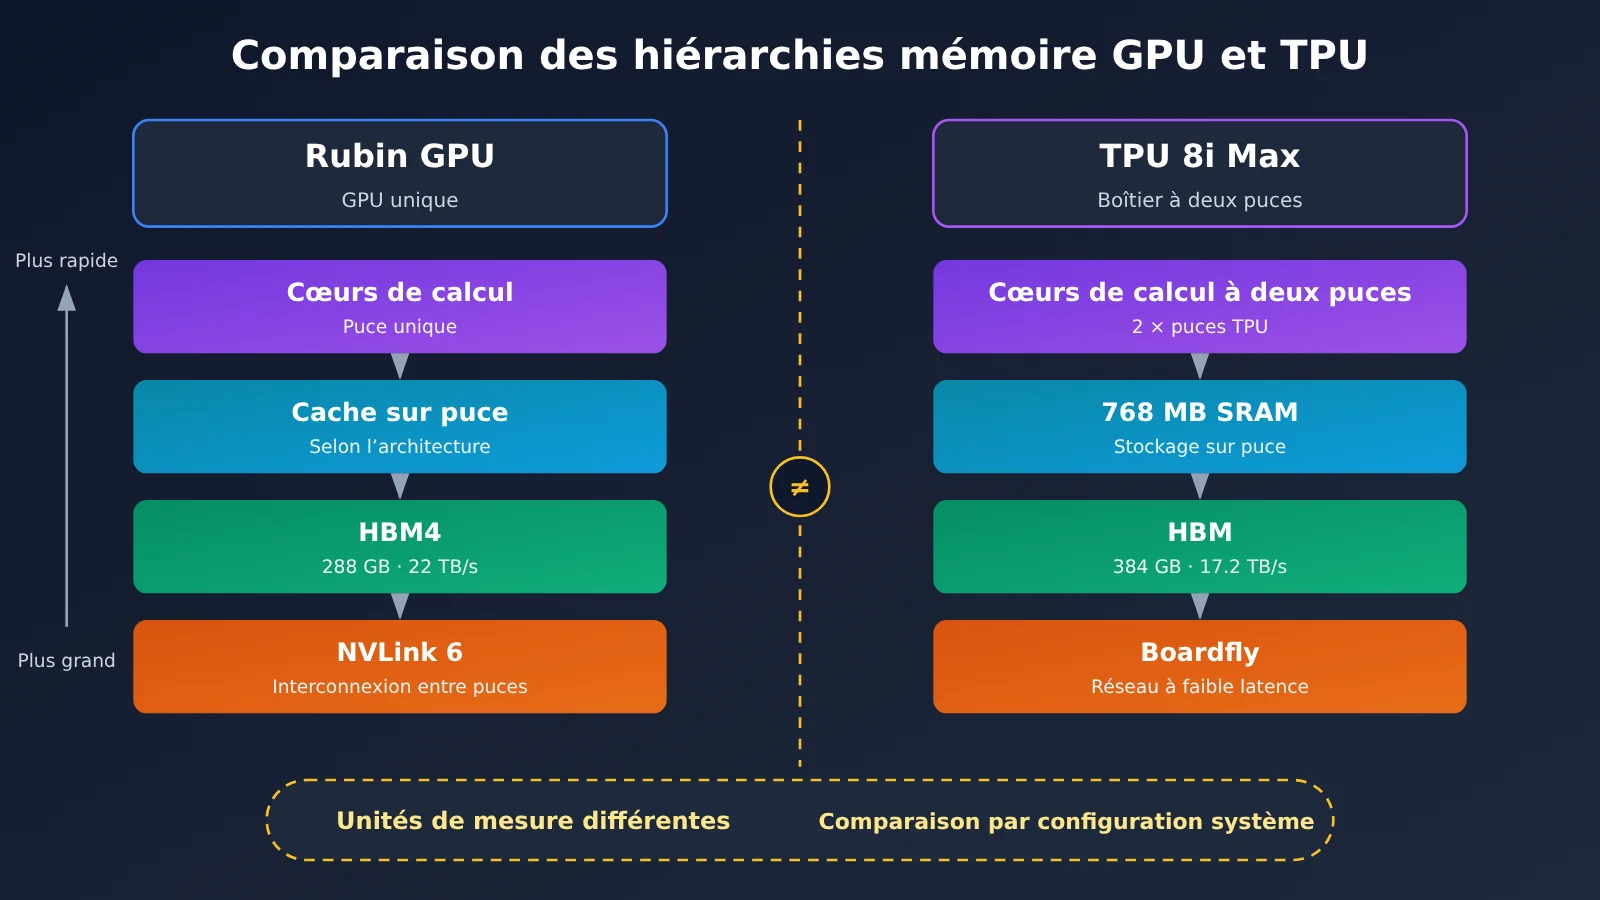
Ce tableau ne permet pas d’établir un classement simple. La comparaison entre 384 GB et 288 GB porte d’un côté sur un boîtier à deux puces et de l’autre sur un seul GPU. La génération de HBM, le type d’interconnexion, l’architecture de calcul et la configuration de la machine complète diffèrent également. En matière de bande passante, le Rubin est supérieur à l’échelle d’un seul GPU ; en capacité, le TPU 8i Max est plus généreux. Mais aucun de ces chiffres ne peut être étudié indépendamment de la taille du système.
La comparaison la plus pertinente consiste à déterminer, à puissance, espace en rack et coût équivalents, combien de contextes concurrents le système complet peut prendre en charge de manière stable, ainsi que son débit, sa latence et son efficacité énergétique lorsqu’il les maintient. Au 10 novembre 2026, le TPU 8i Max n’a pas encore fait l’objet de mesures indépendantes vérifiables publiquement. Il faudra attendre sa commercialisation pour disposer de données permettant ce type de comparaison à l’échelle du système.
💡 Conseil pour choisir : pour la plupart des équipes qui créent des agents via une API, il n’est pas nécessaire de décider soi-même si l’infrastructure repose sur des GPU ou des TPU. Il est plus utile de comparer la latence et le prix unitaire des différents modèles avec de longs contextes. L’interface unifiée d’APIYI apiyi.com permet de tester plusieurs modèles en parallèle à partir d’invites correspondant à des cas d’usage réels.
Impact du TPU 8i Max sur le développement d’agents
Distinguer la fenêtre de contexte, la concurrence réelle et la latence d’inférence
La fenêtre de contexte annoncée d’un modèle indique uniquement la quantité de texte qu’il peut théoriquement traiter. Elle ne signifie pas que le serveur peut gérer autant de requêtes simultanées avec cette longueur de contexte, ni que la latence sera acceptable. Les calculs précédents montrent que, pour une même fenêtre de contexte de 128K, le cache KV nécessaire pour 8 sessions est huit fois plus important que pour une seule. Pour les développeurs, il faut donc examiner séparément trois indicateurs :
- Fenêtre de contexte : la quantité maximale de texte que le modèle peut traiter ; elle détermine le volume de données qu’on peut lui fournir en une seule fois.
- Capacité réelle de traitement simultané : le nombre de longues sessions que le matériel peut maintenir en parallèle ; elle dépend de la capacité de la HBM.
- Latence d’inférence : le TTFT dépend de la charge de calcul du Prefill, tandis que la vitesse de génération des tokens dépend de la bande passante et de la taille du cache KV.
Trois techniques d’atténuation qui se généralisent
Le matériel n’est qu’une partie de la solution au mur mémoire ; l’autre se trouve dans les logiciels. TPU Sync, que Google a publié en open source à la même période, ainsi que les versions de vLLM et de SGLang pour TPU, reposent toutes sur les techniques suivantes :
| Technique | Problème résolu | Coût ou point de vigilance |
|---|---|---|
| KV Cache Offloading | Déplace temporairement les caches inutilisés de la HBM vers la DRAM de l’hôte, un SSD ou un stockage partagé afin de dépasser les limites de capacité | La restauration nécessite du temps de transfert et dépend de l’efficacité du DMA et des transferts asynchrones |
| Quantification du KV Cache | Réduit le nombre d’octets par élément, et donc directement la capacité et la bande passante utilisées | L’incidence sur la précision doit être évaluée |
| Séparation Prefill / Decode | Déploie le Prefill, gourmand en calcul, et le Decode, gourmand en bande passante, sur des nœuds différents | Le KV Cache doit être transféré rapidement entre les nœuds |
| Prefix Caching | Réutilise les mêmes invites système et préfixes d’historique pour éviter de répéter le Prefill | Dépend de la fréquence à laquelle les préfixes des requêtes se répètent |
D’après les données publiées par Google, TPU Sync peut réduire de plus de 90 % la latence de transfert du KV Cache. Dans les scénarios de mise en cache de préfixes avec un contexte de 64K, la réduction du TTFT peut atteindre 90 %. Ces résultats ont toutefois été obtenus sur les TPU Ironwood de septième génération. Par ailleurs, le README GitHub indique que les matériels actuellement validés activement sont les v7x et v6e : ces résultats ne peuvent donc pas être considérés directement comme des performances du TPU 8i Max.
Conséquences concrètes sur les performances et les coûts des ressources
Pour les utilisateurs d’API, ces optimisations de bas niveau se traduisent finalement par deux questions : la latence des requêtes avec un long contexte reste-t-elle stable, et le coût facturé par jeton diminue-t-il ? Côté application, vous pouvez aussi vous inspirer de l’idée de « réduire l’empreinte mémoire » : raccourcir les invites système et garder leur préfixe stable pour profiter du cache, résumer les sorties des outils avant de les réinjecter dans le contexte, et ne transmettre aux sous-agents que les extraits dont ils ont besoin, plutôt que l’historique complet.
L’exemple ci-dessous mesure la latence jusqu’au premier jeton (TTFT) en sortie en continu pour différentes longueurs de contexte. Il permet d’observer l’effet de la croissance du contexte sur le Prefill :
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible avec OpenAI d’APIYI
)

def measure_ttft(context: str, model: str = "gpt-4o-mini") -> float:
    start = time.perf_counter()
    stream = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": context + "\n请用一句话总结上文。"}],
        stream=True,
    )
    for chunk in stream:
        if chunk.choices and chunk.choices[0].delta.content:
            return time.perf_counter() - start
    return -1.0

print(f"TTFT: {measure_ttft('示例代码片段 ' * 2000):.2f}s")
Afficher le code de test par lots pour plusieurs modèles et longueurs
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Une seule clé pour passer d’un modèle à l’autre
)

MODELS = ["gpt-4o-mini", "claude-sonnet-4", "gemini-2.5-flash"]
LENGTHS = [1_000, 5_000, 20_000]  # Nombre de répétitions du fragment, pour augmenter approximativement la taille du contexte

def run_once(model: str, repeat: int) -> dict:
    context = "def handler(event):\n    return process(event)\n" * repeat
    start = time.perf_counter()
    first, tokens = None, 0
    try:
        stream = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": context + "\n指出上面代码的潜在问题。"}],
            stream=True,
            max_tokens=200,
        )
        for chunk in stream:
            if chunk.choices and chunk.choices[0].delta.content:
                tokens += 1
                if first is None:
                    first = time.perf_counter() - start
        total = time.perf_counter() - start
        return {"model": model, "repeat": repeat, "ttft": first, "total": total, "chunks": tokens}
    except Exception as e:
        return {"model": model, "repeat": repeat, "error": str(e)}

for m in MODELS:
    for n in LENGTHS:
        print(run_once(m, n))
🚀 Pour commencer rapidement : inscrivez-vous sur APIYI (apiyi.com) pour obtenir un crédit d’essai gratuit. Gardez
base_urldéfini surhttps://api.apiyi.com/v1dans le script ci-dessus : en quelques minutes, vous pourrez comparer les courbes TTFT de plusieurs modèles selon différentes longueurs de contexte.
Impact sur le secteur
- Accélération de la personnalisation au niveau système : en déclinant rapidement des configurations adaptées à des charges de travail spécifiques à partir d’une même puce, Google montre que la concurrence entre accélérateurs se joue désormais autant sur la conception des systèmes que sur les caractéristiques d’une puce isolée.
- La co-conception matériel-logiciel devient la norme : lancés en même temps que le TPU 8i Max, TPU Sync, Agent Compute Engine et un moteur d’inférence pour TPU montrent que résoudre le problème du mur mémoire dépend à la fois de la bande passante matérielle et de l’ordonnancement logiciel.
- Une commercialisation encore à ses débuts : comme les 8t, 8i et 8tx, le TPU 8i Max porte la mention « Coming soon ». Aucun prix public ni aucune date de disponibilité officielle n’ont été annoncés ; son rapport coût-performances reste donc à vérifier.
Questions fréquentes
Q1 : Qu’est-ce que le TPU 8i Max ?
Le TPU 8i Max est une configuration système de TPU de huitième génération, annoncée par Google le 9 novembre 2026. Elle intègre deux TPU 8i dans un même boîtier. Sa puissance de calcul, sa SRAM intégrée et sa bande passante HBM sont toutes deux fois supérieures à celles du TPU 8i. Elle vise principalement l’inférence avec de longs contextes, une forte concurrence et la collaboration entre plusieurs agents. Il ne s’agit pas d’une puce entièrement nouvelle.
Q2 : La capacité HBM du TPU 8i Max a-t-elle doublé ?
Non. Selon les informations communiquées lors du point presse, la capacité HBM passe de 288 GB à 384 GB, soit une hausse d’environ 33 %. Ce sont la bande passante HBM (d’environ 8,6 TB/s à 17,2 TB/s) et la SRAM (de 384 MB à 768 MB) qui doublent. Capacité et bande passante sont deux indicateurs distincts qu’il ne faut pas confondre.
Q3 : Peut-on déjà utiliser le TPU 8i Max ? Quel est son prix ?
Au 10 novembre 2026, la page produit officielle de Google Cloud indique que le TPU 8i Max est « Coming soon ». Aucun prix public ni aucune date officielle de disponibilité générale (GA) n’ont été annoncés. Il n’existe pas non plus de test de performances indépendant que l’on puisse vérifier publiquement. Pour l’instant, les seules références disponibles sont les déclarations de Google et les caractéristiques communiquées lors du point presse.
Q4 : Le TPU 8i Max permet-il à un modèle de prendre en charge un contexte d’un million de tokens ?
Google présente les contextes de l’ordre du million de tokens comme un cas d’usage visé, mais il ne s’agit pas d’une longueur maximale fixe officiellement annoncée. La longueur de contexte qu’un modèle peut traiter dépend d’abord du modèle lui-même. Le matériel détermine plutôt le niveau de concurrence qu’il est possible de maintenir à cette longueur et si la latence reste acceptable.
Q5 : Comment les développeurs peuvent-ils mesurer l’effet d’un long contexte sur la latence ?
La méthode la plus directe consiste à mesurer le TTFT et la vitesse de génération avec des contextes métier réels de différentes longueurs :
1. Rendez-vous sur APIYI, à l’adresse apiyi.com, pour créer un compte et obtenir une clé API ainsi qu’un crédit d’essai gratuit.
2. Utilisez le script de test de cet article et définissez `base_url` sur `https://api.apiyi.com/v1`.
3. Avec le même ensemble de contextes, essayez plusieurs modèles et comparez la pente d’augmentation de la latence en fonction de la longueur.
Q6 : Quelles sont les limites de la quantification et du déchargement du KV Cache ?
La quantification réduit directement l’utilisation de la mémoire et de la bande passante, mais elle peut dégrader la précision. Il faut donc l’évaluer sur les tâches visées. Le déchargement permet de dépasser les limites de capacité de la HBM, mais la restauration des données prend du temps. Si les transferts entre les différents niveaux de mémoire ne sont pas assez rapides, la latence risque même d’augmenter. Dans les deux cas, les paramètres doivent être ajustés en fonction du niveau de concurrence et des objectifs de latence.
Points clés sur les agents à long contexte et le TPU 8i Max
- Déplacement du goulot d’étranglement : l’inférence des agents ne consiste plus seulement à augmenter la puissance de calcul. Il faut désormais équilibrer le calcul et l’approvisionnement en données depuis la mémoire.
- Croissance linéaire du cache KV : pour Llama 3.1 70B, chaque jeton occupe environ 320 Kio. Une requête de 128K jetons représente près de 40 Gio.
- Le GQA est essentiel : avec 8 têtes KV, le cache n’occupe qu’un huitième de l’espace nécessaire à une attention multi-tête standard.
- Le décodage dépend de la bande passante : chaque jeton généré nécessite de relire l’intégralité du cache KV. Avec un long contexte, la bande passante domine la latence.
- Une mise à l’échelle synchronisée : le TPU 8i Max double simultanément sa puissance de calcul, sa SRAM et sa bande passante HBM, tandis que la capacité HBM n’augmente que d’environ 33 %.
- Le logiciel compte tout autant : le déchargement, la quantification, la séparation du préremplissage et du décodage, ainsi que la mise en cache des préfixes, sont les principaux moyens de réduire la pression sur la mémoire.
- Passez aux essais : APIYI apiyi.com permet de tester la latence à long contexte de plusieurs modèles via une interface unifiée.
Résumé
Les points essentiels concernant le mur mémoire de l’inférence des agents à long contexte :
- Origine de la pression : le code, les résultats des outils et les productions des sous-agents s’accumulent au fil du temps. Le parallélisme entre plusieurs agents amplifie encore l’empreinte du cache KV.
- Approche matérielle : le TPU 8i Max ne se contente pas d’augmenter la puissance de calcul. Il fait évoluer simultanément le calcul, la SRAM et la bande passante HBM afin de maintenir l’équilibre entre le traitement et l’approvisionnement en données.
- Limites d’utilisation : la capacité HBM n’augmente que modérément et le produit n’est pas encore commercialisé. Sa valeur réelle devra être confirmée par des mesures à l’échelle du système.
Pour la plupart des développeurs, la démarche la plus pragmatique consiste à comprendre le coût du cache KV, à maîtriser l’extension du contexte au niveau applicatif et à suivre de près l’évolution de la latence et des tarifs des services de modèles à long contexte. Nous recommandons d’utiliser APIYI apiyi.com pour comparer les performances de plusieurs modèles à long contexte avec des données métier réelles. La plateforme propose une interface compatible avec OpenAI et un quota gratuit pour les nouveaux utilisateurs.
📚 Références
- Google Cloud Blog – Introducing TPU 8tx and TPU 8i Max : annonce technique officielle de cette présentation
- Lien :
cloud.google.com/blog/topics/ai-infrastructure/tpu-8tx-and-tpu-8i-max -
À retenir : confirme le conditionnement à deux puces ainsi que le doublement des capacités de calcul, de la SRAM et de la bande passante HBM
-
Google Cloud – Inside the eighth-generation TPU : analyse détaillée de l’architecture TPU de huitième génération
- Lien :
cloud.google.com/blog/products/compute/tpu-8t-and-tpu-8i-technical-deep-dive -
À retenir : spécifications d’origine de la TPU 8i et architecture réseau Boardfly
-
Google Cloud – Introducing TPU Sync : bibliothèque dédiée au transfert du cache KV et des poids
- Lien :
cloud.google.com/blog/topics/ai-infrastructure/introducing-tpu-sync-fast-kv-cache-and-weight-transfer-on-tpu -
À retenir : hiérarchie mémoire et résultats des tests de déchargement du cache KV (basés sur Ironwood)
-
Network World – Google targets AI’s next infrastructure bottlenecks : compte rendu de presse
- Lien :
networkworld.com/article/4245897 -
À retenir : valeurs absolues de capacité HBM, de bande passante et de SRAM de la TPU 8i Max
-
Dépôt GitHub de Google TPU Sync : dépôt open source
- Lien :
github.com/google/tpu-sync - À retenir : informations sur le matériel compatible et l’état du développement
Auteur : équipe technique d’APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI. Pour plus de ressources d’intégration, consultez le centre de documentation à l’adresse docs.apiyi.com.