Note de l’auteur : décryptage du rachat par OpenAI de Pierre, l’entreprise derrière Code Storage, et de l’ouverture de Codex à toutes les formules : quels outils sont concernés, quelles conséquences pour les utilisateurs actuels et quelle direction prendront les chaînes d’outils pour agents de programmation IA ?
OpenAI a récemment publié deux annonces qui, prises séparément, peuvent sembler modestes. Mises ensemble, elles prennent tout leur sens. La première : OpenAI annonce le rachat de Pierre Computer Company, l’entreprise derrière Code Storage et plusieurs outils open source pour développeurs. La seconde, annoncée en même temps qu’Images 2.6 : Codex devient accessible avec toutes les formules, sur le Web, les applications de bureau et les appareils mobiles.
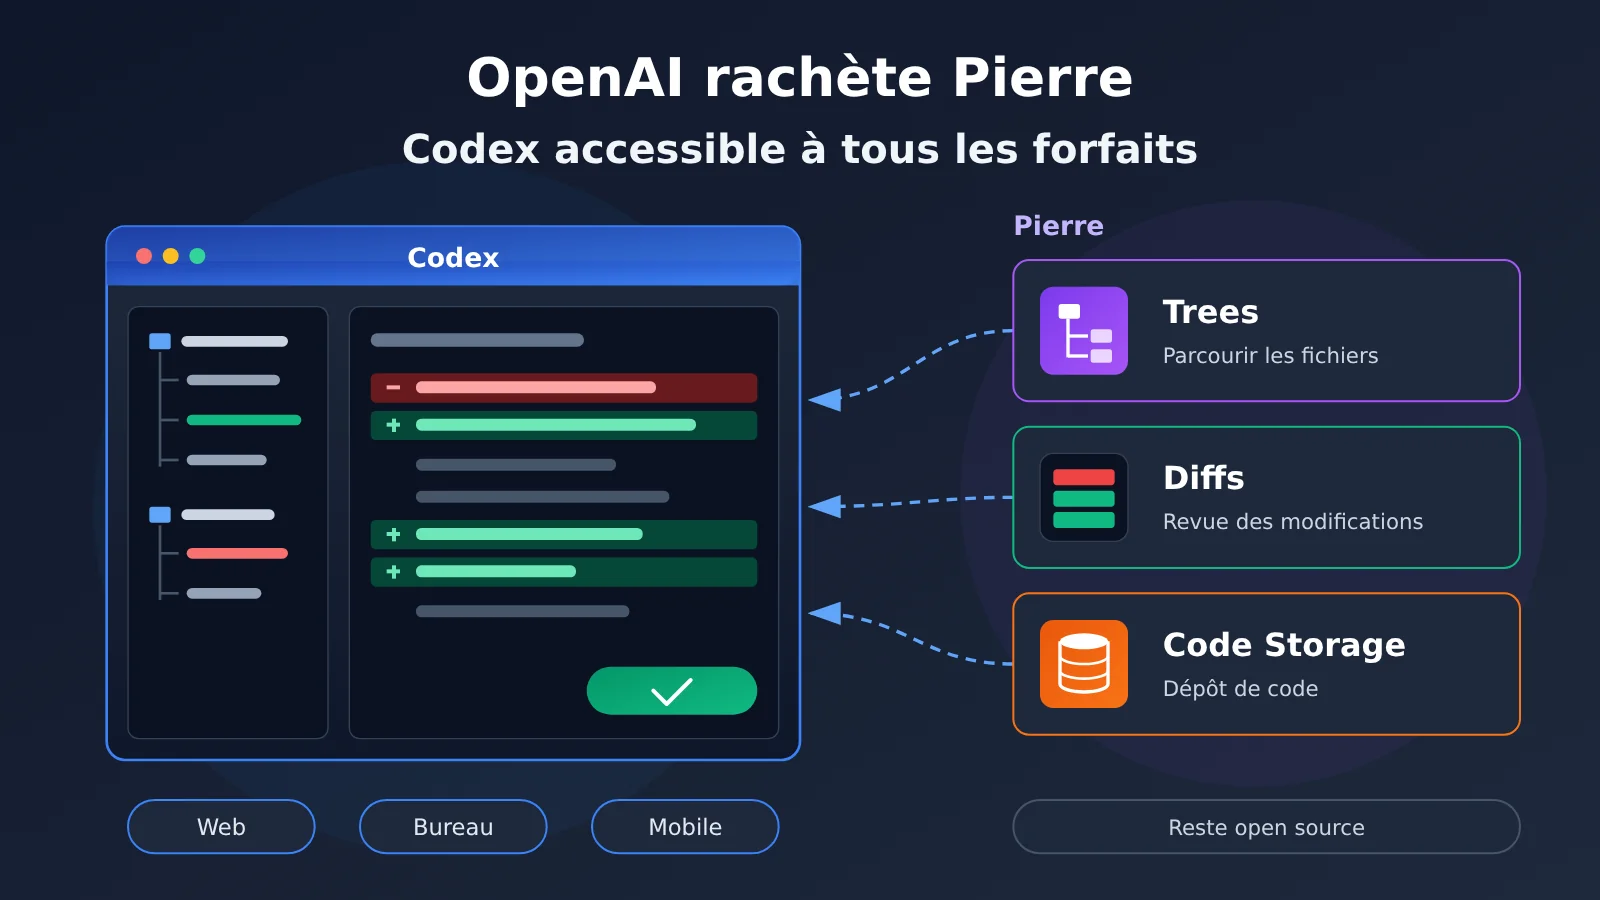
Ce n’est pas un simple rachat d’équipe et de produits. Les deux bibliothèques de Pierre, Trees et Diffs, assurent déjà la navigation dans les fichiers et la revue des modifications de code dans l’application Codex. Avec cette acquisition, OpenAI intègre donc à ses propres produits des composants fondamentaux dont Codex dépend déjà. Dans cet article, nous passons en revue les outils concernés, la situation des différentes catégories d’utilisateurs avant et après la finalisation de l’opération, et notre analyse de l’avenir des chaînes d’outils pour agents de programmation.
L’essentiel : à la fin de cet article, vous saurez ce que le rachat de Pierre par OpenAI signifie pour vos dépendances open source, votre compte Code Storage et votre utilisation quotidienne de Codex.
Rachat de Pierre par OpenAI : l’essentiel en bref
Commençons par les informations publiques disponibles. Les sources sont des résumés d’annonces officielles : ni le montant de la transaction ni son calendrier précis n’ont été divulgués. Les éléments inconnus sont donc indiqués comme tels dans le tableau.
| Élément | Détails |
|---|---|
| Acquéreur | OpenAI |
| Société acquise | Pierre Computer Company, à l’origine de Code Storage et de plusieurs outils open source pour développeurs |
| Composants déjà liés à Codex | Bibliothèque Trees (navigation dans les fichiers), bibliothèque Diffs (revue des modifications de code) |
| Avenir des projets open source | Ils resteront open source après la finalisation de la transaction |
| Clients de Code Storage | Ils pourront continuer à l’utiliser ; ses fonctionnalités seront progressivement intégrées à Codex |
| État de la transaction | En attente d’approbation réglementaire, transaction non finalisée |
| Montant et calendrier | Non divulgués publiquement |
| Actualités connexes | Codex disponible pour toutes les offres (web, application de bureau et mobile), lancement d’Images 2.6 dans ChatGPT |
Quel rôle jouent Trees et Diffs de Pierre dans Codex ?
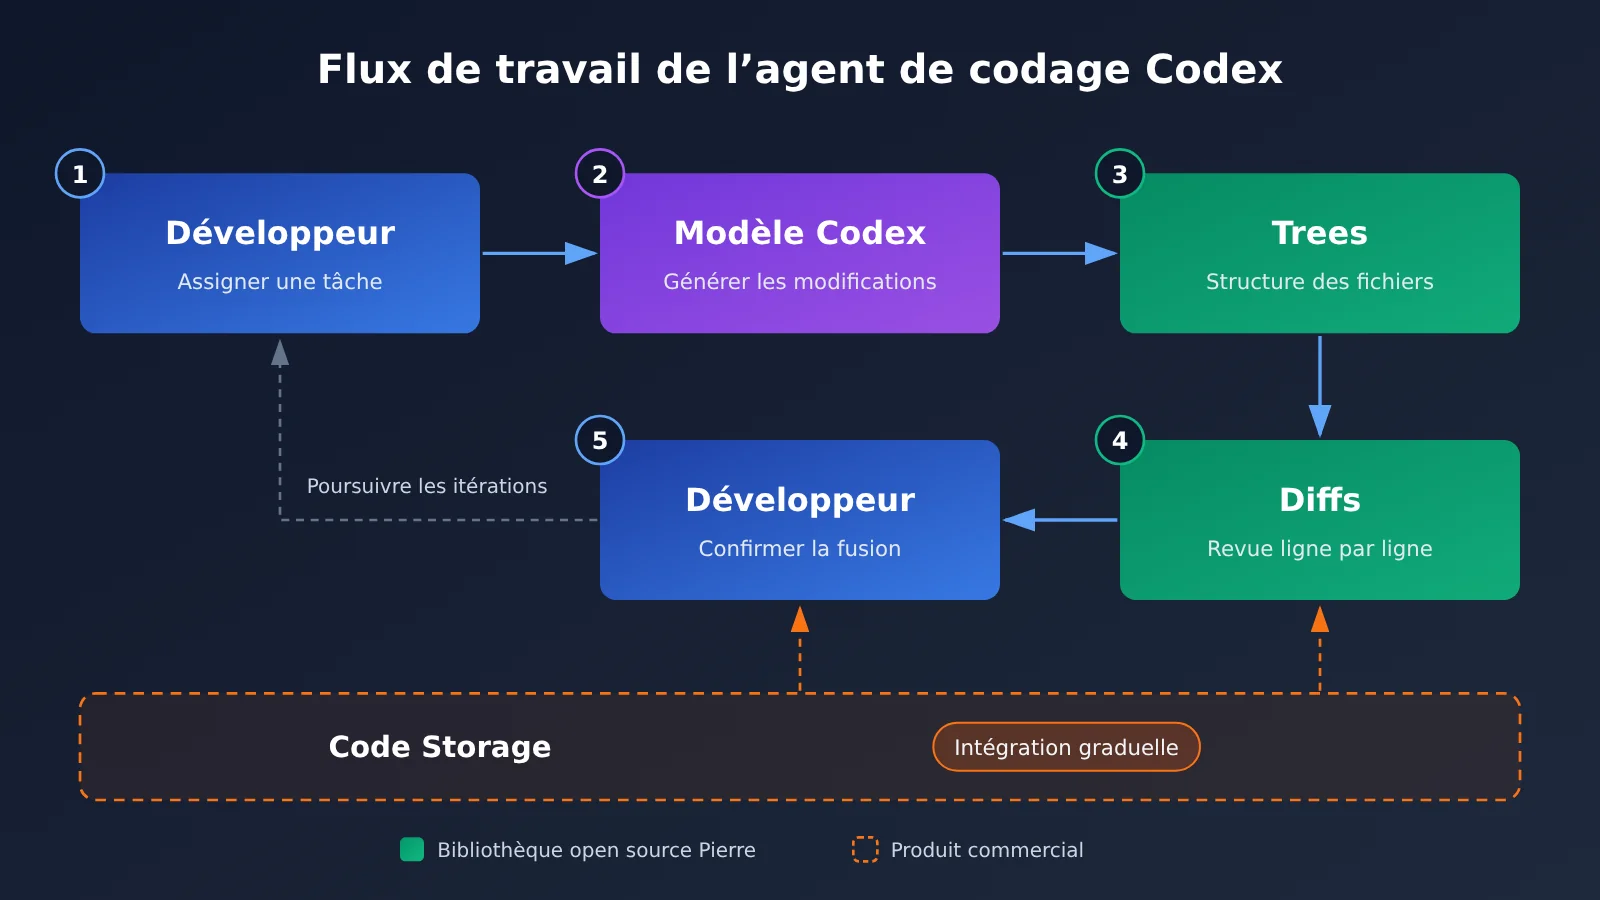
Quand ils utilisent un agent de codage, les développeurs passent beaucoup de temps à vérifier quels fichiers l’agent a touchés et quelles modifications il a apportées au code. Pour la première tâche, il faut un composant d’arborescence capable de présenter efficacement la structure du projet ; pour la seconde, une interface claire pour afficher et examiner les diff. D’après les informations officielles, ces deux fonctionnalités de l’application Codex reposent respectivement sur les bibliothèques Trees et Diffs de Pierre.
Cela rappelle un point facile à oublier : l’expérience avec un agent de codage ne dépend pas uniquement de sa capacité à écrire du code. Si l’agent modifie une dizaine de fichiers d’un coup et que l’interface de revue est confuse, le développeur ne peut pas fusionner les changements en toute confiance. Même un modèle très performant peut alors se retrouver bloqué à l’étape de validation humaine. Trees et Diffs répondent précisément à ce besoin de collaboration entre l’humain et l’agent. Il est donc logique qu’OpenAI ait choisi d’intégrer aussi l’équipe qui les a créés.
| Actif de Pierre | Type | Rôle dans Codex | Devenir après la transaction |
|---|---|---|---|
| Trees | Bibliothèque open source | Navigation dans les fichiers de l’application Codex | Reste open source |
| Diffs | Bibliothèque open source | Revue des modifications de code dans l’application Codex | Reste open source |
| Autres outils open source pour développeurs | Projets open source | Aucun détail individuel communiqué officiellement | Restent open source |
| Code Storage | Produit commercial | Aucune précision officielle sur son intégration actuelle | Les clients peuvent continuer à l’utiliser ; ses fonctionnalités seront progressivement intégrées à Codex |
Codex accessible à toutes les formules : l’agent de codage IA devient une fonctionnalité de base
En parallèle de l’annonce de l’acquisition, OpenAI a annoncé que Codex était désormais accessible à toutes les formules, sur le Web, sur ordinateur et sur mobile. La nouvelle a été publiée en même temps que l’annonce d’Images 2.6 : GPT-Image-2.6 Flare et Sunburst sont également disponibles dans l’API. Mais pour les développeurs, c’est Codex qui a les conséquences les plus directes.
« Toutes les formules » signifie que l’agent de codage n’est plus une fonctionnalité réservée aux abonnements haut de gamme : tous les utilisateurs de ChatGPT peuvent désormais y accéder. Attention toutefois : le résumé officiel ne précise pas les différences entre les formules en matière de nombre d’utilisations, de durée des tâches ou d’exécution simultanée. Ces limites varieront probablement selon la formule. Pour planifier le travail de votre équipe, mieux vaut consulter les dernières précisions sur le site officiel d’OpenAI plutôt que de supposer que tout est identique.
En rapprochant les deux annonces, la stratégie d’OpenAI apparaît clairement : élargir l’accès à Codex tout en renforçant son infrastructure pour la navigation dans les fichiers, la revue des modifications et même le stockage du code. Avec davantage d’utilisateurs, la fiabilité de ces aspects « hors modèle » devient encore plus importante. Reprendre en interne le développement des composants concernés est donc une manière logique de s’y préparer.
Analyse des effets de l’acquisition de Pierre par OpenAI sur les développeurs
Pour les utilisateurs des projets open source de Pierre
Si votre projet dépend directement de Trees, de Diffs ou d’autres outils open source de Pierre, l’annonce officielle garantit qu’ils resteront open source après la finalisation de l’acquisition. À court terme, inutile de chercher une solution de remplacement dans l’urgence : continuez simplement à suivre les nouvelles versions.
Cela dit, « rester open source » ne signifie pas que la feuille de route restera inchangée. Après une acquisition par une grande entreprise, l’évolution d’une bibliothèque open source tend souvent à se rapprocher des besoins des produits de l’acquéreur, par exemple en donnant la priorité aux usages de Codex. Pensez à verrouiller les versions dans vos fichiers de dépendances et à surveiller les éventuels changements de licence, de responsables de maintenance ou de rythme de réponse aux issues du dépôt.
Impact sur les clients actuels de Code Storage
Selon les communications officielles, les clients de Code Storage peuvent continuer à l’utiliser et ses fonctionnalités seront progressivement intégrées à Codex. Deux points restent toutefois à éclaircir : le calendrier précis de cette intégration et le maintien ou non de Code Storage comme produit autonome à long terme. En attendant, le plus prudent est de s’assurer que les données restent exportables et que les processus critiques ne dépendent pas trop d’un seul service.
| Type d’utilisateur | Avant la finalisation de l’opération (actuellement) | Après la finalisation (selon les communications officielles) | Points à confirmer | Actions recommandées |
|---|---|---|---|---|
| Utilisateurs des projets open source Trees / Diffs | Utilisation normale | Les projets restent open source | Rythme de maintenance, feuille de route | Figer les versions et suivre l’activité des dépôts |
| Clients de Code Storage | Utilisation normale | Utilisation maintenue, fonctionnalités progressivement intégrées à Codex | Calendrier d’intégration, maintien du produit autonome | Exporter régulièrement les données et éviter une dépendance excessive |
| Utilisateurs de Codex | Accessible à tous les niveaux d’abonnement | Les capacités de revue et de stockage devraient être renforcées | Limites d’utilisation par niveau | Planifier l’utilisation en consultant la page officielle |
| Utilisateurs d’autres agents de codage (Cursor, Cline, etc.) | Pas d’impact direct | Pas d’impact direct | Évolution de la concurrence dans le secteur | Suivre les améliorations comparables de l’expérience de revue |
Les effets sur toute la chaîne d’outils des agents de codage IA
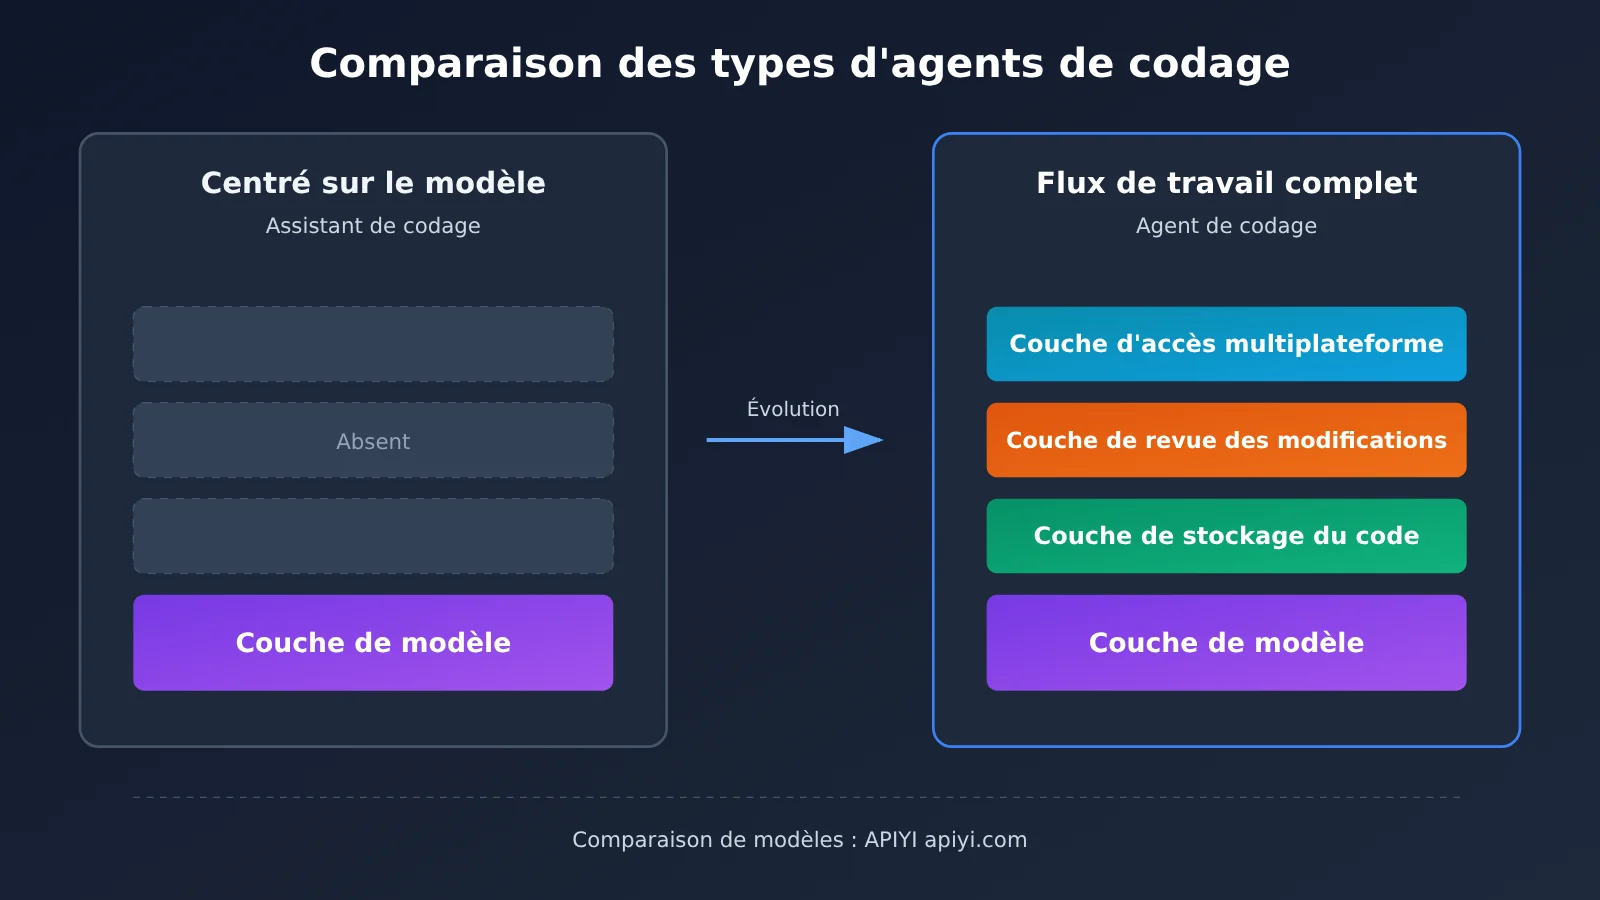
Cette acquisition montre que la concurrence entre agents de codage ne se limite plus à « quel modèle écrit le meilleur code », mais porte aussi sur « qui propose le flux de travail le plus complet ». Un agent de codage complet comprend au moins quatre couches : le modèle génère le code, le stockage gère le code et ses versions, la revue permet aux humains de comprendre et de valider les modifications, et l’interaction donne accès à l’agent depuis différents appareils.
| Couche d’infrastructure | Responsabilités | Actions actuelles d’OpenAI |
|---|---|---|
| Modèle | Comprendre les besoins, générer et modifier du code | Modèles OpenAI derrière Codex |
| Stockage du code | Héberger le code, gérer les versions et les modifications | Acquisition de Code Storage, dont les fonctionnalités sont progressivement intégrées à Codex |
| Revue des modifications | Navigation dans les fichiers, affichage des diff et validation humaine | Bibliothèques Trees et Diffs déjà utilisées dans Codex |
| Points d’accès | Permettre aux développeurs de lancer et de suivre des tâches à tout moment | Codex disponible sur le web, sur ordinateur et sur mobile, pour toutes les formules |
À notre avis, la couche de revue sera l’un des principaux terrains de concurrence entre les agents de codage. Plus un agent est performant, plus il peut modifier de code en une seule soumission, et plus la charge de revue humaine augmente. Les produits capables de rendre lisibles d’un coup d’œil les modifications apportées à des dizaines de fichiers gagneront plus facilement la confiance des équipes.
🎯 Conseil technique : les agents de codage consomment des invocations de modèles. Si vous configurez des modèles personnalisés dans des outils comme Cursor ou Cline, ou si vous créez vos propres scripts de revue de code, APIYI apiyi.com vous permet d’accéder aux modèles OpenAI, Claude, Gemini et autres avec une seule clé API. Vous pouvez ainsi comparer leur qualité de revue sur un même diff.
Créer sa propre revue de diff avec une API compatible OpenAI : une approche minimaliste des agents de codage IA
Les capacités de revue de Codex ne sont actuellement disponibles que dans son application. OpenAI n’a pas non plus précisé les possibilités de connexion de Codex à des API tierces. Mais tout développeur peut reprendre l’idée de « faire examiner une modification de code par un modèle » dans son propre pipeline, à l’aide d’une API compatible OpenAI. Voici un exemple minimaliste qui lit le diff de la zone de staging et demande au modèle de le commenter.
import subprocess
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API compatible OpenAI
)

diff = subprocess.run(["git", "diff", "--staged"], capture_output=True, text=True).stdout

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Peut être remplacé par n’importe quel modèle disponible sur la plateforme
    messages=[
        {"role": "system", "content": "你是资深代码审阅者,指出潜在 bug、风险和改进建议。"},
        {"role": "user", "content": f"请审阅以下代码变更:\n{diff}"}
    ]
)
print(resp.choices[0].message.content)
Voir le code complet (revue fichier par fichier)
import subprocess
from typing import List
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM_PROMPT = (
    "你是资深代码审阅者。针对给定文件的 diff,"
    "按「严重问题 / 潜在风险 / 改进建议」三类输出,没有问题请明确说明。"
)

def changed_files() -> List[str]:
    """Récupère la liste des fichiers modifiés dans la zone de staging"""
    out = subprocess.run(
        ["git", "diff", "--staged", "--name-only"],
        capture_output=True, text=True
    ).stdout
    return [f for f in out.splitlines() if f.strip()]

def file_diff(path: str) -> str:
    """Récupère le diff d’un fichier"""
    return subprocess.run(
        ["git", "diff", "--staged", "--", path],
        capture_output=True, text=True
    ).stdout

def review(path: str, diff: str, model: str = "gpt-4o-mini", max_chars: int = 12000) -> str:
    """Examine les modifications d’un fichier et tronque les diff trop longs"""
    if len(diff) > max_chars:
        diff = diff[:max_chars] + "\n...(diff 过长,已截断)"
    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": f"文件: {path}\n\n{diff}"}
            ],
            max_tokens=1000
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"审阅失败: {e}"

if __name__ == "__main__":
    for path in changed_files():
        print(f"===== {path} =====")
        print(review(path, file_diff(path)))
        print()
Ce script fait essentiellement une version de « revue automatique » de ce que réalisent des composants comme Diffs dans un agent de codage : il répartit les modifications par fichier et les examine une à une. Cette approche évite d’envoyer un contexte trop long en une seule fois et permet d’associer facilement chaque résultat au fichier concerné. Elle s’intègre aussi facilement à un hook Git ou à la CI.
🚀 Pour démarrer : si vous voulez d’abord comparer la qualité des revues de différents modèles sur le code de votre projet, inscrivez-vous sur APIYI apiyi.com pour obtenir un crédit de test gratuit. Il suffit de modifier le paramètre
modelpour changer de modèle, sans toucher au reste du code.
FAQ sur l’acquisition de Pierre par OpenAI et l’ouverture de Codex
Q1 : Quelle entreprise est Pierre ?
Pierre Computer Company est l’entreprise à l’origine de Code Storage et de plusieurs outils open source destinés aux développeurs. Deux de ses bibliothèques, Trees et Diffs, sont déjà utilisées dans l’application Codex pour parcourir les fichiers et examiner les modifications de code. C’est son lien le plus direct avec OpenAI.
Q2 : L’acquisition est-elle finalisée ? Quel est le montant de la transaction ?
Pas encore. OpenAI indique que la finalisation reste soumise à l’approbation des autorités réglementaires. Le montant de la transaction et le calendrier précis n’ont pas été rendus publics. Pour suivre les prochains développements, consultez les annonces officielles d’OpenAI : les informations de cet article peuvent évoluer.
Q3 : J’utilise Code Storage. Dois-je migrer dès maintenant ?
Il n’est pas nécessaire de migrer immédiatement. OpenAI a précisé que les clients peuvent continuer à utiliser Code Storage et que ses fonctionnalités seront progressivement intégrées à Codex. Le rythme de cette intégration et le maintien à long terme du produit indépendant restent toutefois à préciser. Il est donc conseillé d’exporter régulièrement vos données importantes pour garder la maîtrise d’une éventuelle migration.
Q4 : Maintenant que Codex est ouvert à tous les niveaux d’abonnement, les quotas d’utilisation sont-ils identiques ?
Le résumé publié indique seulement que Codex est accessible à tous les niveaux d’abonnement, sur le Web, ordinateur et appareil mobile. Il ne détaille pas les limites d’utilisation de chaque formule. Les quotas varieront probablement selon l’abonnement : avant de planifier l’utilisation en équipe, consultez les dernières indications sur la page officielle.
Q5 : Comment accéder à plusieurs modèles dans des agents de codage comme Cursor ou Cline ?
Ces outils permettent généralement de configurer une interface personnalisée compatible avec OpenAI. Voici comment procéder :
1. Créez un compte sur APIYI apiyi.com et obtenez une clé API
2. Dans les paramètres du modèle de l’outil, saisissez la clé et définissez `https://api.apiyi.com/v1` comme base_url
3. Renseignez le nom du modèle souhaité : vous pourrez alors passer d’un modèle OpenAI, Claude ou Gemini à un autre dans le même outil
À noter que Codex est un produit d’OpenAI et que l’entreprise n’a pas précisé son fonctionnement avec les API tierces. La méthode ci-dessus s’applique aux agents de codage qui acceptent une interface personnalisée.
Q6 : Cette acquisition aura-t-elle un impact sur d’autres agents de codage comme Cursor ou Cline ?
À court terme, il n’y a pas d’impact direct, et les projets open source comme Trees et Diffs ont vocation à le rester. À plus long terme, la concurrence portera davantage sur l’expérience de révision et la prise en charge complète du flux de travail. Pour les outils qui dépendent de l’invocation du modèle, la liberté de choix reste importante. Une interface d’agrégation comme APIYI apiyi.com peut aider à réduire le coût du changement de modèle.
Acquisition de Pierre par OpenAI : points clés
- La cible est identifiée : OpenAI acquiert Pierre, l’entreprise derrière Code Storage et plusieurs outils open source.
- Des composants déjà utilisés : Trees gère la navigation dans les fichiers de Codex, tandis que Diffs sert à examiner les modifications de code.
- L’open source reste ouvert : après la finalisation de l’acquisition, les projets open source de Pierre le resteront.
- Une transition progressive pour Code Storage : les clients peuvent continuer à l’utiliser et ses fonctionnalités seront progressivement intégrées à Codex.
- La transaction n’est pas encore finalisée : elle reste soumise à l’approbation des autorités réglementaires. Son montant et son calendrier n’ont pas été dévoilés.
- Codex devient une fonctionnalité de base : accessible à tous les niveaux d’offre, il est disponible sur le web, sur ordinateur et sur mobile.
- Une validation multimodèle plus souple : pour vos propres processus de revue, l’interface unifiée d’APIYI apiyi.com permet de comparer les modèles.
En résumé
L’acquisition de Pierre par OpenAI et l’ouverture de Codex à tous les niveaux d’offre vont dans le même sens : la concurrence entre agents de programmation ne se limite plus aux capacités des modèles, mais s’étend à l’ensemble du flux de travail.
- La revue gagne en importance : Trees et Diffs montrent qu’aider les utilisateurs à comprendre les modifications d’un agent est aussi important que de lui faire écrire du code.
- Le stockage est intégré : l’intégration des fonctionnalités de Code Storage à Codex signifie que le stockage du code deviendra une capacité native des agents de programmation.
- L’accès s’élargit : disponible à tous les niveaux d’offre et sur trois types de terminaux, Codex contribue à faire des agents de programmation des outils utilisés par défaut.
Pour les développeurs, l’approche la plus pragmatique consiste pour l’instant à verrouiller les versions des dépendances open source et à suivre leur évolution, à veiller à ce que les données Code Storage restent exportables et à se référer aux indications officielles pour l’utilisation de Codex. En parallèle, vous pouvez déjà mettre en place les étapes que vous maîtrisez, comme la revue et les tests, à l’aide d’une interface compatible avec OpenAI. Nous recommandons d’utiliser APIYI apiyi.com pour vérifier rapidement l’efficacité de différents modèles dans la revue de votre projet. Nous continuerons également à suivre les nouvelles informations après la finalisation de l’acquisition.
📚 Références
- OpenAI annonce l’acquisition de Pierre, l’entreprise derrière Code Storage : résumé de l’annonce
- Lien :
aihot.news/items/c39s97tylya5njp0nro6dwvbx -
Détails : utilisation de Trees et Diffs dans Codex, et suite prévue pour les projets open source et les clients de Code Storage
-
OpenAI lance Images 2.6 et ouvre Codex à toutes les formules : résumé des actualités produit publiées à la même période
- Lien :
aihot.news/items/o915zd1u1eq13gyo9x3nsgoq8 -
Détails : disponibilité de Codex sur le web, les ordinateurs et les appareils mobiles
-
Page officielle de présentation d’Images 2.6 par OpenAI : page de lancement officielle
- Lien :
openai.com/index/introducing-images-2-6 - Détails : présentation officielle d’Images 2.6 et des modèles GPT-Image-2.6 Flare et Sunburst
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site officiel d’APIYI. Pour plus de ressources d’intégration, consultez le centre de documentation docs.apiyi.com.