Note de l’auteur : cet article examine point par point les vidéos de 15 secondes de Gemini Omni 1.2 Flash, le respect des références, l’édition en plusieurs tours, le contrôle de la voix et de la caméra, la baisse de prix de 30 % et les limites reconnues par Google. De quoi aider les développeurs à décider s’il mérite d’être évalué pour leurs projets de génération vidéo.
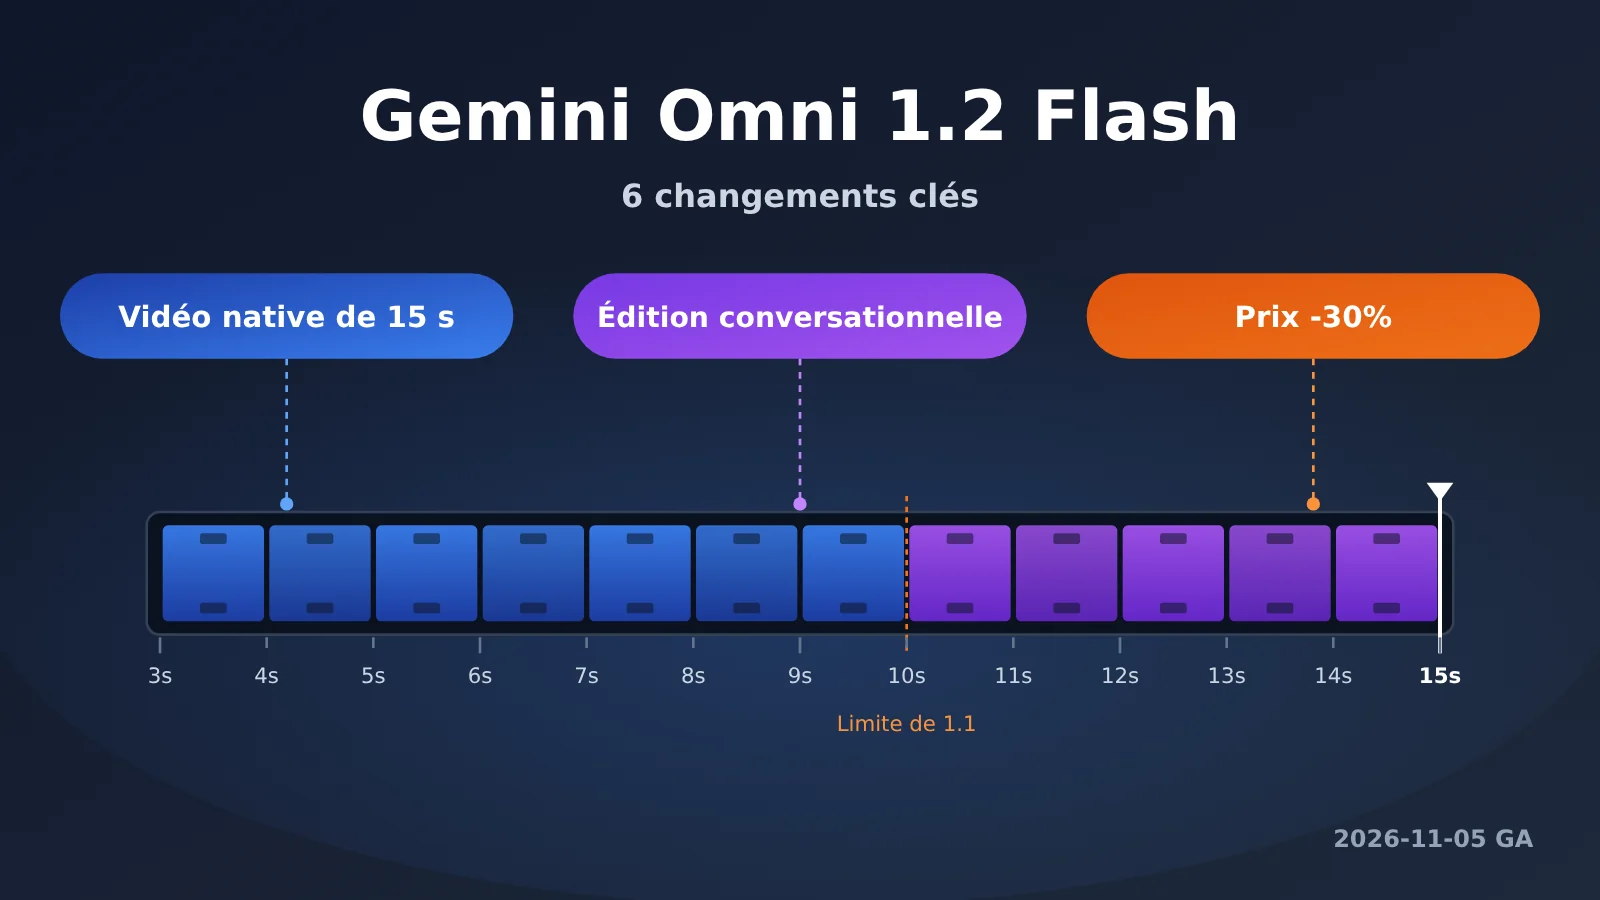
Google a lancé Gemini Omni 1.2 Flash le 5 novembre 2026, avec une disponibilité générale simultanée sur Gemini API et Gemini for business. Cette version apporte trois nouveautés majeures : des vidéos natives de 15 secondes, l’édition conversationnelle en plusieurs tours et un tarif de 0,07 $ par seconde en 720p (30 % de moins que la version 1.1). Le respect des références, la cohérence, la voix et le contrôle de la caméra ont aussi été améliorés.
Ce ne sont pas des rumeurs : ces informations proviennent toutes de l’article de lancement publié sur le blog officiel de Google et signé par un chef de produit de Google DeepMind. L’article officiel met toutefois surtout l’accent sur les résultats visuels et donne peu de détails sur les paramètres, l’identifiant du modèle et les limites de débit qui intéressent les développeurs. Nous allons donc traduire les arguments marketing en spécifications et en limites concrètes, tout en signalant les points à vérifier avec vos propres contenus.
L’essentiel : comprendre en quelques minutes ce qui change entre Gemini Omni 1.1 et 1.2 Flash, distinguer les capacités de l’API des fonctions réservées aux applications Google et déterminer si le modèle vaut la peine d’être évalué dès maintenant.
Gemini Omni 1.2 Flash : l’essentiel en bref
Voici un récapitulatif des points clés de l’annonce. Toutes les informations du tableau proviennent de l’article officiel. Les paramètres qui n’y figurent pas, comme l’ID du modèle, la forme de l’interface ou les limites de débit, sont laissés de côté et repris dans la section « À vérifier » plus loin.
| Information | Détails sur Gemini Omni 1.2 Flash |
|---|---|
| Date de lancement | 2026-11-05, avec disponibilité générale (GA) le jour même |
| Éditeur | Google / Google DeepMind |
| Durée des vidéos | De 3 à 15 secondes, par incréments de 1 seconde (limite de 10 secondes pour la version 1.1) |
| Prix | 0,07 dollar par seconde en 720p (sur la base de 12 dollars par million de tokens de sortie vidéo et de 5 792 tokens par seconde en 720p), soit une baisse de 30 % par rapport à Omni 1.1 |
| Flux de travail par résolution | Produire rapidement un premier résultat en 360p / 720p, puis augmenter la résolution du résultat retenu en 1080p ou 4K |
| Entrées de référence | Images de personnages, de produits ou de style, extraits de mouvement de 3 secondes maximum et invites audio |
| Mode d’édition | Édition conversationnelle en plusieurs échanges, sur l’intégralité d’un extrait de 15 secondes |
| Fonctionnalités pour les entreprises | Infrastructure Google Cloud avec Provisioned Throughput |
| Identification du contenu | Filigrane SynthID imperceptible intégré aux contenus générés |
| Limites reconnues officiellement | Les mouvements sportifs rapides, les changements rapides de scénario et la physique complexe sont encore en cours d’amélioration |
Que signifient la disponibilité générale et Provisioned Throughput pour Gemini Omni 1.2 Flash ?
L’annonce officielle souligne que c’est la première fois que Gemini Omni atteint le statut GA. Pour les développeurs, cela signifie que le modèle a quitté la phase de préversion ou d’expérimentation et peut être utilisé en production. Cela implique généralement aussi une interface et un comportement plus stables que dans une version de préversion.
Provisioned Throughput est la capacité de débit réservée de Google Cloud : les entreprises achètent à l’avance une certaine capacité de traitement pour bénéficier d’une disponibilité et d’une latence plus prévisibles pendant les périodes de pointe. Si vous devez générer des contenus publicitaires en volume ou respecter un SLA sur les délais de production, ce point peut compter davantage que le prix unitaire. L’article ne précise pas le mode de facturation : il faudra le vérifier sur la page de tarification de Google Cloud.
6 changements clés entre Gemini Omni 1.1 Flash et 1.2 Flash
L’article officiel s’appuie sur de nombreuses vidéos pour illustrer les progrès du modèle. Nous avons regroupé ces changements du point de vue des développeurs, en distinguant les « changements de spécifications mesurables » des « améliorations de qualité ». Les premiers peuvent être intégrés directement à une solution technique ; les secondes doivent être vérifiées par des tests.
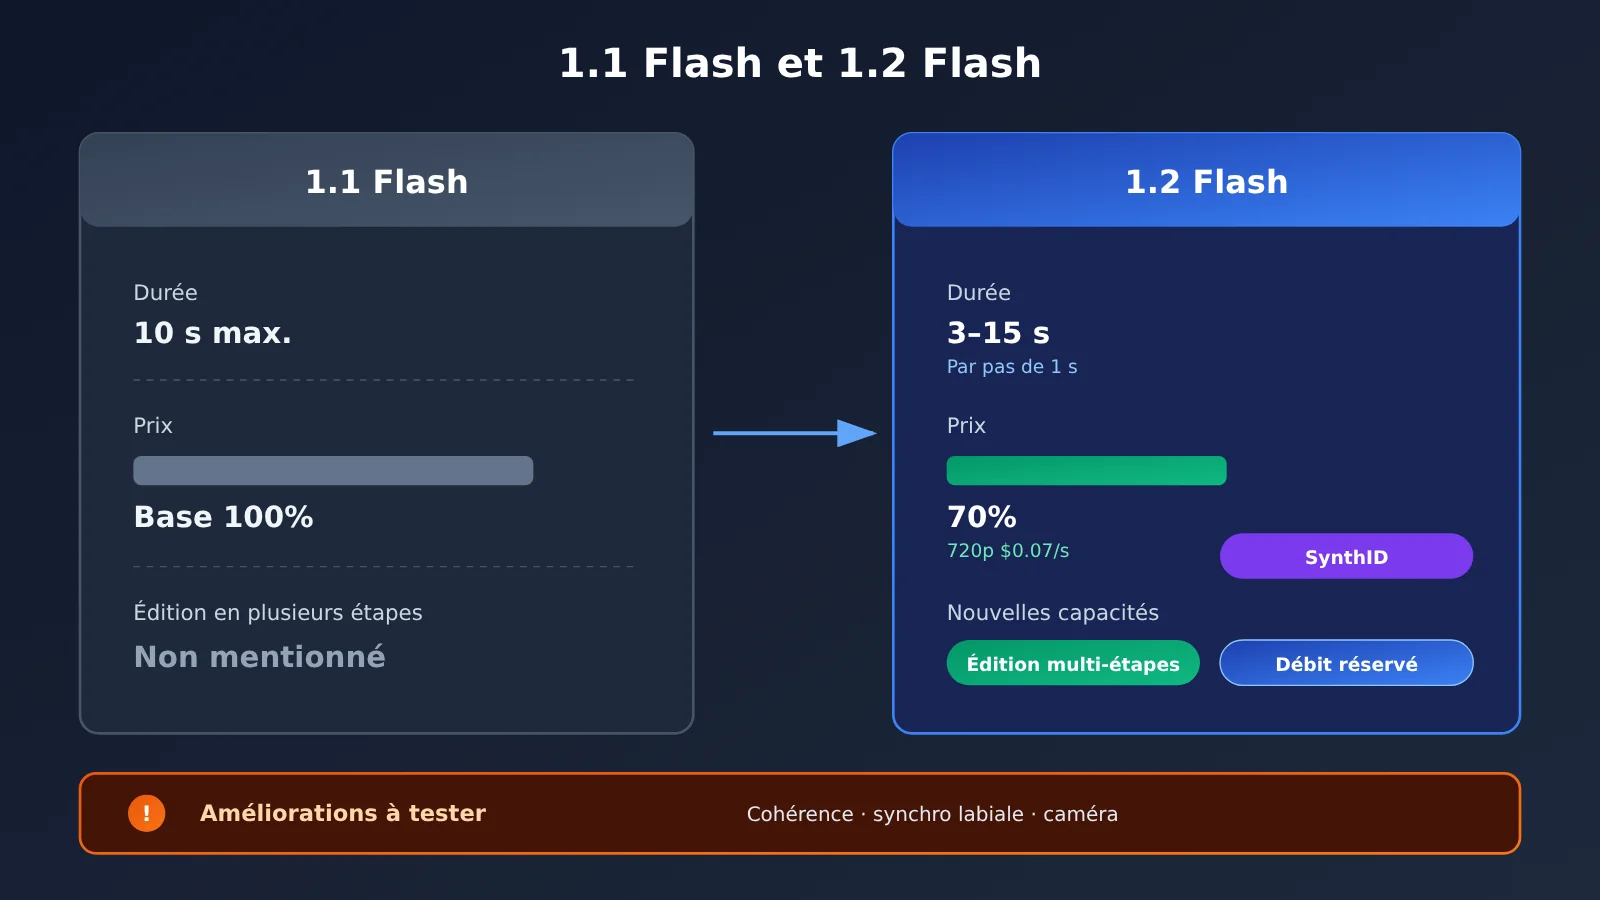
| Critère | Gemini Omni 1.1 Flash | Gemini Omni 1.2 Flash | Type de changement |
|---|---|---|---|
| Durée maximale | 10 secondes | 15 secondes, réglable de 3 à 15 secondes par pas de 1 seconde | Changement de spécification |
| Prix en 720p | 0,10 dollar/seconde (17,50 dollars par million de tokens de sortie vidéo) | 0,07 dollar/seconde (12 dollars par million de tokens de sortie vidéo) | Changement de prix |
| Respect des références | Dans les exemples officiels, la fidélité aux images de référence est limitée | Les visages, vêtements, polices sur les emballages et couleurs de marque restent cohérents d’un angle de prise de vue à l’autre | Amélioration de qualité |
| Cohérence entre la première et la dernière image | Les exemples présentent des écarts dans les détails : un chat sur un toit, une cuillère à soupe qui devient une paire de baguettes, etc. | Moins de dérives et de déformations dans les détails | Amélioration de qualité |
| Modification sur plusieurs tours | Non mentionnée dans l’article de lancement | Possibilité de modifier à chaque tour le produit ou l’arrière-plan, l’éclairage ou la météo, ainsi que le format d’image | Nouvelle fonctionnalité |
| Statut GA | Pas encore en disponibilité générale | Première disponibilité générale, avec prise en charge de Provisioned Throughput | Changement de spécification |
💡 À propos des tarifs : Google facture la sortie vidéo au token, et non à la seconde. Les prix « par seconde » indiqués ici sont donc des équivalents calculés. Les deux chiffres proviennent de la page de tarification de la Gemini API : 17,50 dollars par million de tokens de sortie vidéo pour la version 1.1, contre 12 dollars pour la version 1.2. Sur la base de 5 792 tokens de sortie par seconde en 720p, cela représente respectivement environ 0,10 et 0,07 dollar par seconde, soit une baisse d’environ 30 %. La page précise également qu’à partir du 3 décembre 2026, les requêtes envoyées à gemini-omni-1.1-flash seront automatiquement acheminées vers la version 1.2 et facturées à son tarif.
Premier changement : Gemini Omni 1.2 Flash prend en charge des durées flexibles de 3 à 15 secondes
La durée maximale passe de 10 à 15 secondes. Ce ne sont que 5 secondes de plus en apparence, mais dans bien des cas, cela change tout. Une publicité complète pour les réseaux sociaux, une présentation de fonctionnalité ou une petite histoire avec un début, un développement et une chute tiennent souvent en 12 à 15 secondes. Là où il fallait auparavant assembler deux séquences, une seule génération suffit désormais.
Autre détail facile à manquer : la durée se règle à la seconde près. Avec un modèle facturé à la seconde, pouvoir demander exactement 7 secondes évite d’en payer 10. Un avantage important pour maîtriser les coûts lors de générations en lot.
Deuxième changement : les références peuvent combiner images, extraits de mouvement et audio
1.2 Flash permet de combiner plusieurs types de références : des images de personnages, de produits ou de styles, des extraits de mouvement de 3 secondes maximum et des indications audio. Dans un exemple officiel, une photo de mannequin et des images de face et de dos de trois tenues ont permis de générer une vidéo d’essayage virtuel de 15 secondes. Pendant une rotation à 360 degrés, l’identité du mannequin ainsi que la coupe, le drapé et les détails du dos de chaque vêtement restent cohérents.
L’application la plus évidente est le commerce en ligne : transformer des photos de produits ou des images de référence de personnages en séquences d’essayage, en présentations à 360 degrés ou en publicités de marque. Attention : la limite de 3 secondes pour les extraits de mouvement est stricte. Si votre référence est plus longue, il faut la couper au préalable.
Troisième changement : une meilleure cohérence entre les images de début et de fin et lors de la prolongation des séquences
Selon l’annonce officielle, les personnages, les objets et les décors restent plus stables de la première à la dernière image, avec moins de dérives visuelles et de déformations pendant les mouvements et les changements de plan. Cette amélioration s’applique aussi bien à l’interpolation entre une image de début et une image de fin qu’à la prolongation d’un extrait pour créer une séquence plus longue.
Fait intéressant, la comparaison officielle entre les versions 1.1 et 1.2 reconnaît quelques écarts subtils entre les images de début et de fin : un chat sur un toit ou encore une cuillère à soupe qui se transforme en baguettes. La cohérence est donc « nettement améliorée », mais le problème n’est pas « entièrement résolu ». Les scènes où les détails comptent demandent toujours une vérification manuelle.
Quatrième changement : l’édition conversationnelle en plusieurs tours avec Gemini Omni 1.2 Flash
C’est la nouveauté qui a le plus d’impact sur le flux de travail. Vous pouvez modifier une même vidéo au fil de plusieurs échanges : remplacer un produit ou un arrière-plan, changer l’éclairage ou la météo, ou encore modifier le format d’image, sans devoir tout régénérer depuis le début. Dans l’exemple officiel, l’arrière-plan d’une vidéo générée est remplacé cinq fois de suite, tandis que le jeu des deux personnages, les reflets sur leurs armures et le cadrage restent inchangés.
L’édition en plusieurs tours couvre l’intégralité d’un extrait de 15 secondes. Parmi les usages typiques cités dans l’annonce officielle : produire en série des variantes publicitaires pour différents publics et emplacements de diffusion. Un autre exemple illustre le « transfert de mouvement » : une pieuvre ondulante est d’abord générée, puis remplacée par une danseuse dont la robe reprend les mouvements fluides de l’animal.
Changement n° 5 : des voix plus naturelles et des dialogues entre plusieurs personnages
Les dialogues de 1.2 Flash sont plus fluides, la synchronisation labiale est plus précise et le modèle sait distinguer plusieurs locuteurs. Dans l’exemple officiel, une image de scène est associée à quatre ensembles de références de personnages, de mouvements de lèvres et d’extraits vocaux d’une seconde, afin d’attribuer chaque voix au bon personnage.
Il faut toutefois noter que les applications concrètes citées dans cette section concernent surtout les produits Google : des dialogues entre plusieurs personnages dans Flow, des vidéos explicatives dans Gemini for business et des vidéos avec avatars et narration dans Google Vids. L’article d’annonce ne précise pas comment utiliser les capacités vocales via l’API ni comment transmettre les paramètres.
Changement n° 6 : des mouvements de caméra continus mieux contrôlés
Selon Google, les mouvements de caméra continus et complexes — passages en vue subjective (FPV), dézooms spectaculaires, mouvements circulaires — présentent nettement moins de coupes imprévues et des proportions plus stables. Parmi les exemples figurent un vol FPV sans coupe, créé à partir de deux photos d’un bâtiment, qui traverse une place et des portes en bronze avant de s’élever jusqu’au dôme du Panthéon, ainsi qu’un plan continu de 10 secondes passant d’un gros plan sur la côte à une vue panoramique de l’île.
Comment fonctionne le workflow de maîtrise des coûts de Gemini Omni 1.2 Flash
La baisse de 30 % des prix n’est qu’une partie de l’équation. Google met surtout en avant un workflow conçu pour maîtriser le coût total : produire rapidement un brouillon en basse résolution, affiner les détails par plusieurs séries de modifications, puis agrandir uniquement la version finale retenue. Par rapport à l’ancienne méthode qui consistait à régénérer toute la séquence au moindre défaut, cette approche peut réduire nettement le coût des séquences inutilisées.
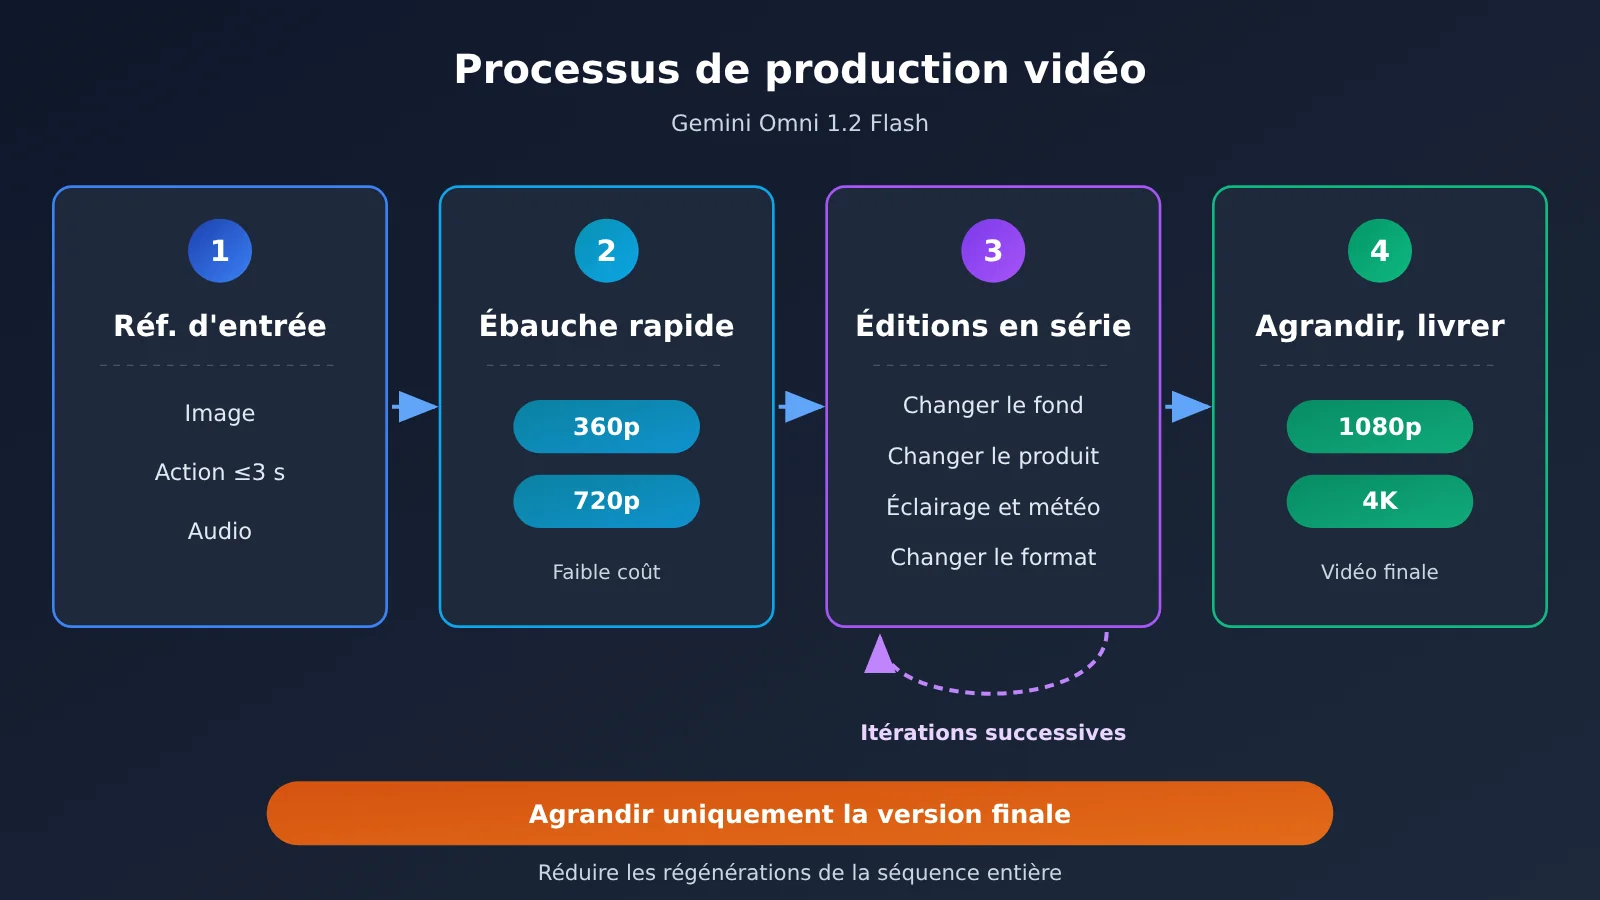
Dans Google AI Studio, la fiche du modèle affiche les tarifs par token : 1,50 dollar par million de tokens en entrée, 9 dollars par million de tokens de texte en sortie et 12 dollars par million de tokens vidéo en sortie. Cela correspond au même tarif que les « 0,07 dollar par seconde » mentionnés plus haut, simplement exprimé dans une autre unité. La page officielle des tarifs convertit le prix en coût par seconde sur la base de 5 792 tokens de sortie par seconde en 720p. Elle indique aussi les valeurs pour les autres résolutions :
- 360p : 1 931 tokens de sortie par seconde, soit environ 0,023 dollar/seconde
- 720p : 5 792 tokens de sortie par seconde, soit environ 0,07 dollar/seconde
- 1080p (suréchantillonnage) : 8 688 tokens de sortie par seconde, soit environ 0,104 dollar/seconde
- 4K (suréchantillonnage) : 17 376 tokens de sortie par seconde, soit environ 0,209 dollar/seconde
Au tarif 720p, le coût approximatif d’une séquence se présente ainsi :
| Durée | Coût par séquence en 720p (0,07 dollar/seconde) | Usages typiques |
|---|---|---|
| 3 secondes | Environ 0,21 dollar | Test de plan, couverture animée |
| 6 secondes | Environ 0,42 dollar | Publicité courte dans un fil d’actualité |
| 10 secondes | Environ 0,70 dollar | Présentation des points forts d’un produit |
| 15 secondes | Environ 1,05 dollar | Publicité complète, présentation détaillée d’un produit |
L’article de lancement ne précise pas si chaque série de modifications est facturée sur la durée complète de la vidéo. Ce point détermine pourtant directement les économies réalisables par rapport à une régénération. Lors d’un essai à petite échelle, il est donc conseillé de relever le montant réellement facturé à chaque tour.
Les essais répétés sur les invites constituent un autre coût important de la génération vidéo. Pour limiter les générations inutiles, beaucoup d’équipes commencent par demander à un grand modèle de langage de transformer un brief créatif en scénario plan par plan et en instructions pour chaque série de modifications, avant de les transmettre au modèle vidéo. Dans sa forme la plus simple, cette approche utilise une interface compatible avec OpenAI pour appeler un modèle de texte et produire en une fois les invites des différentes séries de modifications :
- Installez le SDK : dans Python, exécutez
import openai, puis créez un client avecopenai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1").base_urlpointe vers l’interface compatible OpenAI d’APIYI. Utilisez la clé API disponible dans votre console. - Choisissez le modèle qui rédigera les invites : remplacez
YOUR_TEXT_MODELpar un modèle texte Gemini, GPT ou Claude disponible dans la liste des modèles de la plateforme. Il sert uniquement à rédiger les invites ; le modèle vidéo est appelé séparément. - Envoyez le brief dans un message user : transmettez
messages=[{"role": "user", "content": "为一段 15 秒运动鞋广告写 4 轮编辑指令:换背景、换天气、换灯光、切 9:16"}]àclient.chat.completions.create(...), avec l’ID du modèle. - Récupérez le résultat :
print(resp.choices[0].message.content)affiche les instructions d’édition. Transmettez-les au modèle vidéo une par une, dans l’ordre, pour que chaque étape modifie la vidéo produite à l’étape précédente plutôt que de tout régénérer.
Pour utiliser le même script avec différents briefs, voici une version qui impose une structure de sortie fixe.
- Rédigez l’invite système : définissez une chaîne Python qui demande au modèle de jouer le rôle d’un spécialiste du storyboard publicitaire et de produire uniquement du JSON, avec trois clés :
duration_sec(un entier de 3 à 15),base_prompt(l’invite de génération initiale) etedit_turns(les instructions d’édition à partir de la deuxième étape). Ajoutez une règle : chaque étape ne modifie qu’une seule variable — arrière-plan, produit, éclairage, météo ou format — sans changer le personnage ni le plan. - Définissez la fonction
build_video_plan(brief, variants, model="YOUR_TEXT_MODEL"), qui prend en entrée le brief créatif et la liste des variantes souhaitées. - Composez le message user : utilisez une f-string pour placer le brief après
创意简报:, puis les variantes séparées par des virgules après需要的变体:. - Envoyez deux messages en une seule requête au modèle texte : placez l’invite système dans
systemet la chaîne préparée dansuser, puis ajoutezresponse_format={"type": "json_object"}pour que la réponse puisse être directement analysée en JSON. - Analysez la réponse et limitez la durée : exécutez d’abord
plan = json.loads(resp.choices[0].message.content), puisplan["duration_sec"] = max(3, min(15, int(plan.get("duration_sec", 15)))). Ce modèle accepte en effet des durées de 3 à 15 secondes, par incréments d’une seconde. - Testez avec un vrai brief : par exemple, « nouvelles chaussures de course, jogging matinal en ville, mettre en avant la légèreté et le dynamisme », avec les variantes « rue sous la pluie », « bord de mer au crépuscule » et « passage au format vertical 9:16 ». Affichez le résultat avec
json.dumps(plan, ensure_ascii=False, indent=2). - Transmettez le plan au modèle vidéo : envoyez
base_promptetedit_turnsà l’API vidéo que vous utilisez, puis exécutez chaque étape dans l’ordre. Avant de lancer de nombreuses étapes en lot, notez le coût réel de chacune.
🚀 Conseil pour démarrer : les modèles texte sont bien adaptés à la génération en lot de storyboards et d’instructions d’édition. Avec APIYI sur apiyi.com, vous pouvez comparer la qualité des invites produites par différents modèles texte avec une même clé API. Les nouveaux utilisateurs bénéficient d’un crédit de test gratuit. Pour le modèle vidéo Gemini Omni lui-même, consultez les canaux officiels de Google ; pour savoir s’il est disponible sur APIYI, vérifiez la liste des modèles de la plateforme.
Analyse de l’impact de Gemini Omni 1.2 Flash pour les développeurs
Distinguer les capacités de l’API Gemini Omni 1.2 Flash des fonctionnalités des applications Google
L’article officiel présente ensemble l’API, la plateforme cloud et plusieurs applications Google. Il est donc facile de se tromper sur les fonctionnalités accessibles par API. Le tableau ci-dessous les distingue par canal.
| Canal | Public visé | Capacités décrites par Google | Points à vérifier |
|---|---|---|---|
| Gemini API / Google AI Studio | Développeurs | Disponibilité générale (GA), prototypage dans AI Studio, applications de démarrage interactives et documentation pour développeurs | Consulter la documentation officielle pour les paramètres, l’ID du modèle et les limites de débit |
| Console Google Cloud | Entreprises | Disponibilité générale (GA), infrastructure et sécurité de niveau entreprise, Provisioned Throughput | Adapté aux équipes ayant des exigences de SLA et des besoins de traitement en volume |
| Flow | Créateurs | Mise en scène, modifications en plusieurs étapes, dialogues entre plusieurs personnages | Fonctionnalités propres à l’application, qui ne correspondent pas nécessairement aux capacités de l’API |
| Google Vids | Utilisateurs d’un compte Google ou de Workspace | Clips de 15 secondes, sans frais supplémentaires | Fonctionnalité propre à l’application, adaptée aux équipes non techniques qui souhaitent tester le résultat |
| Application Gemini | Abonnés Google AI Ultra | Vidéos de 15 secondes, en cours de déploiement progressif | Le rythme de déploiement peut varier selon la région et le compte |
| Google Ads | Équipes publicitaires | Extension des campagnes de marketing vidéo | Destiné aux campagnes publicitaires |
| Assistance textuelle (storyboard/invites) | Développeurs | Canal non officiel pour Omni : utilisation de modèles de texte pour générer des scripts et des instructions de montage | Plusieurs modèles de texte sont accessibles par API via des plateformes comme APIYI apiyi.com |
Impact pour les développeurs d’applications
- La conception des workflows va évoluer : l’édition en plusieurs tours rend viable une approche « générer une fois, modifier plusieurs fois ». Les produits peuvent proposer une interface de modification vidéo semblable à un chat, plutôt que de demander aux utilisateurs de réécrire leur invite complète à chaque fois.
- Le modèle de coûts doit être recalculé : la facturation à la seconde et le réglage de la durée par incréments d’une seconde, associés à des brouillons en basse résolution, peuvent réduire le coût unitaire. Il faut toutefois clarifier les règles de facturation des tours d’édition.
- La conformité est plus simple à gérer : le filigrane SynthID est intégré par défaut, un atout pour les plateformes qui doivent signaler les contenus générés par l’IA.
Impact pour les créateurs de contenu et les responsables produit
- Les contenus pour le commerce en ligne et les marques en profitent le plus : le meilleur respect des références et la cohérence accrue répondent à des besoins fréquents comme l’essayage virtuel, la présentation de produits à 360 degrés et les déclinaisons publicitaires.
- Mieux vaut attendre avant de miser sur les scénarios les moins maîtrisés : selon la documentation officielle, les mouvements sportifs rapides, les changements rapides de scénario et la physique complexe sont encore en cours d’amélioration. Pour l’instant, cette technologie ne devrait donc pas être la solution principale pour les contenus sportifs ou d’action, ni pour les plans comportant des interactions physiques complexes.
Gemini Omni 1.2 Flash : liste de vérification avant de choisir
Les exemples officiels sont des démonstrations soigneusement sélectionnées, et les tests indépendants restent rares pour le moment. Avant d’intégrer le modèle à votre solution, mieux vaut vérifier chacun de ces points avec vos propres contenus.
| Point à vérifier | Pourquoi le tester | Approche recommandée |
|---|---|---|
| Fidélité à l’image de référence | Les exemples officiels ne reflètent pas nécessairement vos images de produits ni la conception de vos personnages | Effectuez 10 à 20 générations avec vos propres images de produits et des emballages comportant du texte, puis mesurez le taux de déformation |
| Mouvements rapides et phénomènes physiques complexes | Il s’agit d’une faiblesse reconnue par l’éditeur | Préparez des plans de course, de saut, de collision ou de liquides pour les tester |
| Stabilité des modifications successives | Plus les étapes sont nombreuses, plus les écarts risquent de s’accumuler | Effectuez au moins 5 modifications consécutives et vérifiez que les personnages et la composition restent cohérents |
| Facturation des modifications | Elle détermine les économies réelles | Faites un essai à petit budget et notez le coût de chaque étape |
| Paramètres de l’API et limites de débit | L’article d’annonce ne les précise pas | Consultez la documentation développeur de l’API Gemini et effectuez des tests de charge |
| Voix et synchronisation labiale | Les résultats pour les dialogues en chinois et dans d’autres langues que l’anglais restent inconnus | Testez des dialogues à plusieurs personnes dans la langue cible |
Questions fréquentes (FAQ)
Q1 : Qu’est-ce que Gemini Omni 1.2 Flash ?
Gemini Omni 1.2 Flash est un modèle de génération vidéo lancé par Google en disponibilité générale (GA) le 2026-11-05. Conçu pour être rapide et économique, il prend en charge la génération native de vidéos de 3 à 15 secondes, différents types d’entrées de référence et l’édition conversationnelle en plusieurs tours. Le tarif en 720p est de 0,07 dollar par seconde.
Q2 : Quelles sont les différences entre Gemini Omni 1.2 Flash et la version 1.1 ?
La version 1.1 se limitait à 10 secondes, tandis que la version 1.2 atteint 15 secondes, avec un réglage à la seconde près. Le prix a baissé de 30 % et l’édition conversationnelle en plusieurs tours a été ajoutée. Le respect des références, la cohérence entre les première et dernière images, la synchronisation labiale et la continuité des mouvements de caméra ont également été améliorés. Le modèle est en outre disponible pour la première fois en GA et propose le Provisioned Throughput.
Q3 : Gemini Omni 1.2 Flash est-il déjà disponible ?
Oui. Il est disponible en GA sur Gemini API et Google Cloud, et les développeurs peuvent créer des prototypes dans Google AI Studio. Il est également disponible dans Google Vids, Flow et Google Ads. Son déploiement dans l’application Gemini est en cours pour les abonnés Google AI Ultra.
Q4 : À quels usages Gemini Omni 1.2 Flash convient-il le mieux ?
– **Essayage virtuel et présentation de produits pour le commerce en ligne** : générer des séquences d’essayage et de présentation à 360 degrés à partir de photos de mannequins et de produits
– **Production en série de variantes publicitaires** : modifier une même séquence en plusieurs tours pour créer des versions avec différents arrière-plans, conditions météo et formats d’image
– **Courtes vidéos explicatives et de vulgarisation** : créer une présentation à plusieurs plans en 15 secondes ; dans les exemples officiels, les textes affichés sont correctement orthographiés
– **Présentation d’espaces avec des mouvements de caméra continus** : plans en vue subjective (FPV) et travellings arrière dans des bâtiments ou des sites touristiques
Q5 : Peut-on invoquer Gemini Omni 1.2 Flash via APIYI ?
APIYI donne déjà accès aux modèles textuels de la famille Gemini. Pour les modèles vidéo Gemini Omni, consultez la liste des modèles sur la plateforme : cet article ne garantit pas leur disponibilité. En attendant, vous pouvez utiliser APIYI apiyi.com pour invoquer un modèle textuel et générer des scripts de storyboard et des instructions d’édition en plusieurs tours, puis passer par les canaux officiels de Google pour la génération vidéo.
Q6 : Quelles sont les limites connues de Gemini Omni 1.2 Flash ?
Google reconnaît que les mouvements sportifs rapides, les changements rapides dans le scénario et la physique complexe sont encore en cours d’amélioration. Les exemples utilisant une première et une dernière image montrent aussi de légers écarts dans les détails. Par ailleurs, l’article de lancement ne précise pas les paramètres API, les identifiants de modèles ni les limites de débit : il faut consulter la documentation officielle. L’agrandissement en 1080p coûte environ 0,104 dollar par seconde et en 4K environ 0,209 dollar par seconde, selon la page des tarifs.
Q7 : Comment réduire le coût des essais d’invites pour la génération vidéo ?
Utilisez d’abord un modèle textuel pour transformer votre brief en storyboard structuré et en instructions d’édition qui ne modifient qu’une variable à chaque tour. Confiez ensuite l’exécution au modèle vidéo : vous réduirez ainsi nettement le nombre de séquences inutilisables. Grâce à l’interface unifiée d’APIYI apiyi.com, vous pouvez comparer rapidement les invites rédigées par différents modèles textuels et choisir celui qui convient le mieux à votre activité.
Gemini Omni 1.2 Flash : l’essentiel à retenir
- Durée accrue : jusqu’à 15 secondes, réglable de 3 à 15 secondes par incréments d’une seconde, pour générer une publicité complète en une seule fois
- Prix en baisse : 0,07 dollar par seconde en 720p, soit 30 % de moins que la version 1.1
- Workflow économique : une ébauche en basse résolution, plusieurs retouches, puis une mise à l’échelle de la version finale uniquement
- Références plus fiables : images, séquences de mouvement de 3 secondes maximum et audio se combinent pour maintenir la cohérence entre les angles de caméra
- Première disponibilité générale (GA) : prise en charge de Provisioned Throughput et filigrane SynthID intégré aux contenus générés
- Limites à garder en tête : les mouvements rapides et les interactions physiques complexes restent délicats ; testez impérativement le modèle avec vos propres contenus
- Étape complémentaire : APIYI apiyi.com permet d’utiliser des modèles textuels pour générer en lot des storyboards et des instructions de retouche
En résumé : faut-il évaluer Gemini Omni 1.2 Flash dès maintenant ?
Les points clés de Gemini Omni 1.2 Flash :
- Des caractéristiques en nette progression : une durée de 15 secondes, un réglage à la seconde près, un prix réduit de 30 % et une première disponibilité générale : autant d’éléments à intégrer directement dans un projet technique
- Les retouches successives changent le workflow : on passe d’une « régénération complète » à des « modifications étape par étape », ce qui présente un intérêt particulier pour les variantes publicitaires et les contenus e-commerce
- Les progrès restent à vérifier en pratique : les améliorations de la cohérence, de la synchronisation labiale et des mouvements de caméra proviennent d’exemples officiels. À vous de vérifier les résultats avec vos propres contenus
Si vous créez des vidéos pour l’e-commerce, la publicité de marque ou la présentation de produits, cela vaut la peine de lancer dès maintenant un test comparatif dans Google AI Studio avec vos propres contenus. Si vous travaillez surtout sur du sport, des actions rapides ou des interactions physiques complexes, vous pouvez attendre les prochaines versions.
Pendant votre évaluation, vous pouvez utiliser APIYI apiyi.com pour accéder à plusieurs modèles textuels avec une seule clé API et générer des storyboards et des instructions de retouche. Cela permet de réduire le coût des essais d’invites. La plateforme propose un crédit de test gratuit aux nouveaux utilisateurs.
📚 Références
- Blog officiel de Google – Article de lancement de Gemini Omni 1.2 Flash : source de tous les faits présentés dans cet article
- Lien :
blog.google/innovation-and-ai/technology/developers-tools/introducing-gemini-omni-1-2-flash/ -
Description : présentation officielle de la durée, des tarifs, des entrées de référence, de l’édition en plusieurs tours, des canaux d’accès et des limites connues
-
Google AI Studio : point d’accès pour tester des prototypes avec l’API Gemini
- Lien :
aistudio.google.com - Description : plateforme recommandée par Google pour les essais des développeurs, avec des applications de démarrage et de la documentation
Auteur : Équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI apiyi.com. Pour en savoir plus sur l’intégration, consultez le centre de documentation à l’adresse docs.apiyi.com.