Note de l’auteur : en partant de la structure de coûts d’un service d’inférence, expliquer pourquoi les services de Token perdent facilement de l’argent, et proposer une checklist actionnable pour évaluer un fournisseur d’API de modèle.
Des Tokens se vendent désormais en direct dans des livestreams, et pourtant les résultats financiers de fournisseurs d’inférence comme « SiliconFlow » restent peu réjouissants. Dans une autre actualité, une entreprise trouvait Claude trop cher, est passée à GLM, et fait tourner 2 000 ingénieurs sur 56 B200, avec une baisse des coûts d’IA d’environ 90 %. En mettant les deux cas côte à côte, on voit que la structure de coûts d’un service de Token obéit à ses propres règles. Cet article part de la structure de coûts d’un service d’inférence pour expliquer pourquoi un service de Token perd de l’argent, puis arrive à la question qui intéresse vraiment les développeurs : comment évaluer si un fournisseur d’API de modèle est fiable.
Ce n’est pas un énième décryptage de ragots du secteur. Les analyses ici s’articulent toutes autour de variables techniques : dépréciation des GPU, taux d’utilisation, écart de coût entre Prefill et Decode, KV Cache, taux de succès du cache et stratégies de subvention. Après lecture, vous pourrez l’appliquer directement à votre évaluation de fournisseurs.
L’essentiel : à la fin de cet article, vous comprendrez la structure de coûts qui se cache derrière le prix d’un Token, et vous disposerez d’une méthode d’évaluation de fournisseur en 6 dimensions. Vous saurez aussi comment vérifier la transparence de la facturation à partir de vos données d’appels réelles.
Pourquoi les services de tokens perdent de l’argent : l’essentiel de la structure des coûts d’inférence
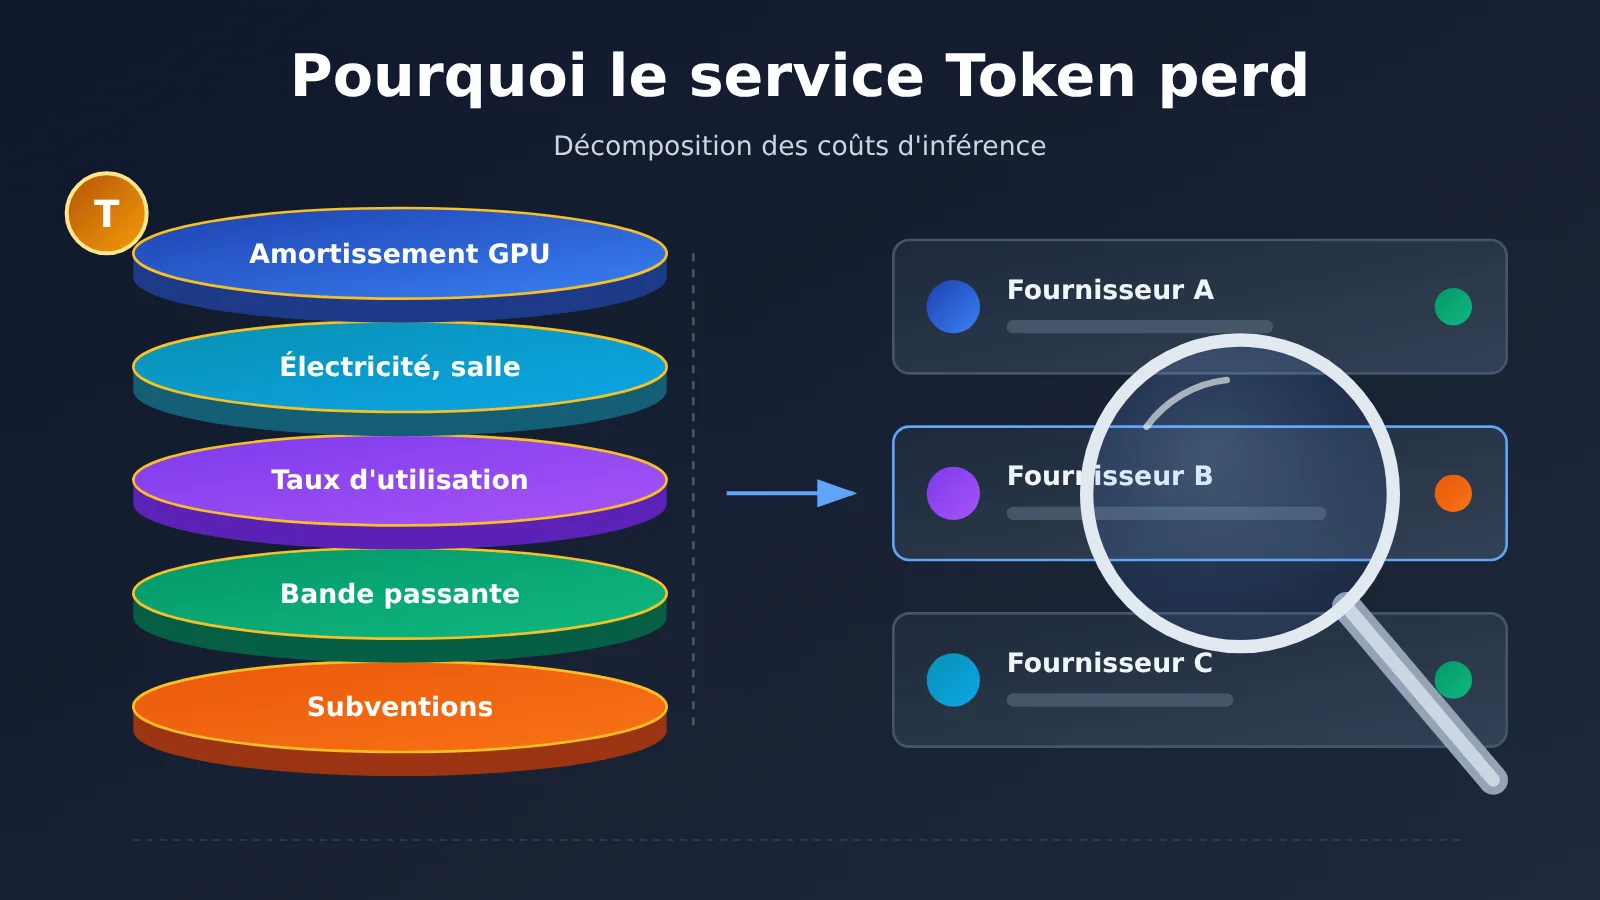
Commençons par la conclusion. La majeure partie du coût d’un service d’inférence est fixe, alors que les revenus sont facturés au volume de tokens ; les deux sont reliés par le « taux d’utilisation ». Si ce taux ne monte pas, ou si la concurrence pousse le prix près du coût marginal, les comptes finissent dans le rouge.
| Élément de coût | Description | Impact sur le prix unitaire du token |
|---|---|---|
| Capex GPU et amortissement | Achat ou location longue durée de GPU haut de gamme, amorti sur plusieurs années | Coût fixe : plus le taux d’utilisation est faible, plus le coût par token est élevé |
| Salle serveur, électricité, réseau | Hébergement, refroidissement, bande passante, reprise après sinistre entre régions | Coût semi-fixe, qui ne se dilue qu’avec l’échelle |
| Taux d’utilisation des GPU | Part du temps où l’inférence tourne réellement et saturation du traitement par lots | Levier central de la rentabilité : l’écart entre pics et creux grignote directement le profit |
| Structure Prefill / Decode | L’entrée est traitée en parallèle, la sortie est générée token par token | Les tokens de sortie coûtent plus cher ; les scénarios à longue sortie sont sous pression |
| Contexte long et KV Cache | La mémoire GPU est occupée par le cache, ce qui réduit la capacité de traitement concurrent | Les requêtes à contexte long réduisent le nombre d’utilisateurs pouvant être servis simultanément |
| Subventions et acquisition de clients | Quotas gratuits, offres d’appel à bas prix, commissions de distribution | Doper le volume à court terme, faire baisser la marge brute à long terme |
Points clés détaillés sur la structure de coûts des services de tokens
L’inadéquation entre coûts fixes et revenus à l’usage est la première raison. Un serveur GPU entièrement équipé génère amortissement, factures d’électricité et coûts de salle serveur qu’il reçoive des requêtes ou non. Or l’utilisateur ne paie que les tokens réellement consommés. Aux heures de pointe de la journée, il faut réserver suffisamment de puissance pour garantir la latence ; la nuit, cette puissance reste inactive, et le coût des périodes creuses finit par être répercuté sur les tokens vendus aux heures de pointe. Si le prix est fixé uniquement d’après le « coût théorique à pleine charge », l’exploitation réelle sera presque certainement déficitaire.
La concurrence par les prix pousse le prix unitaire vers le coût marginal est la deuxième raison. Les poids des modèles ouverts sont accessibles à tous, plusieurs fournisseurs d’inférence déploient le même modèle, la différenciation est faible et le prix devient naturellement le principal moyen de concurrence. Mettre des tokens en promotion pendant une diffusion en direct montre que ce type de produit est déjà proche d’une « matière première standardisée ». Dans ce cas, il est difficile de couvrir les coûts fixes par une prime de prix ; il ne reste qu’à jouer sur l’échelle et l’efficacité de l’orchestration.
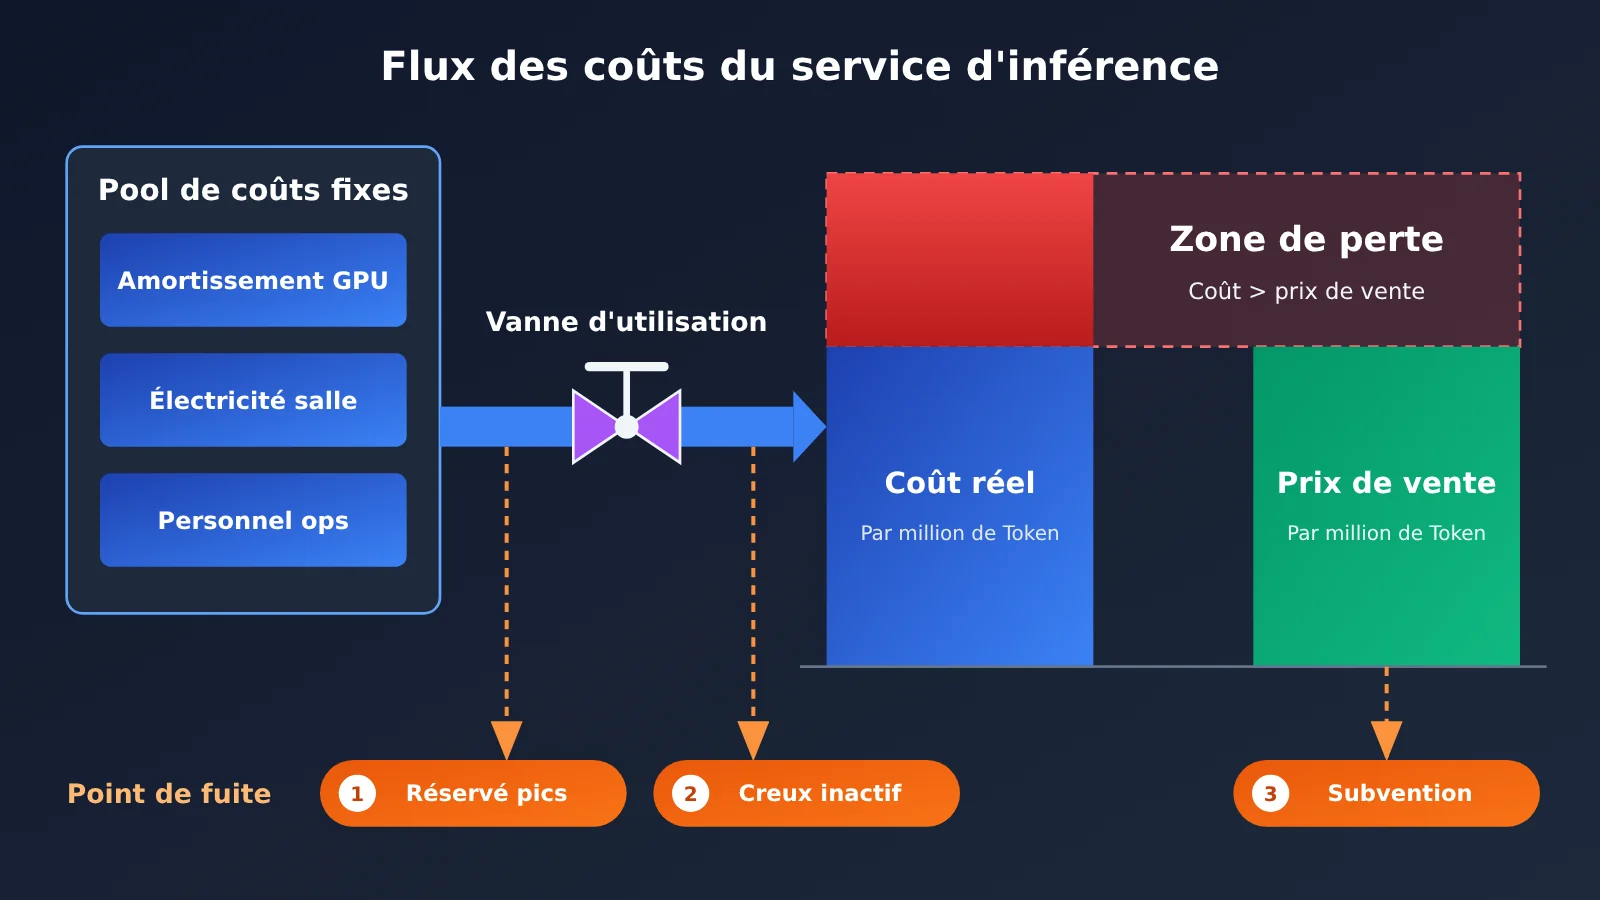
Décomposition des coûts d’un service d’inférence : comment le prix unitaire des tokens est calculé
Pour comprendre pourquoi un service de tokens peut perdre de l’argent, il faut découper une requête d’inférence en deux phases. Chaque phase consomme des ressources différentes, et les règles de facturation ne sont donc pas les mêmes. C’est précisément pour cette raison que de nombreux fournisseurs facturent séparément l’entrée, la sortie et le cache.
Prefill et Decode : pourquoi les tokens de sortie coûtent plus cher
Une requête commence par la phase de Prefill. Le modèle traite en parallèle l’ensemble des tokens d’entrée : le calcul est intensif, mais efficace, et la puissance de calcul du GPU est pleinement exploitée. Vient ensuite la phase de Decode, où le modèle ne génère qu’un seul token à la fois et relit à plusieurs reprises le KV Cache précédent. Cette phase est davantage limitée par la bande passante de la VRAM, et la puissance de calcul du GPU est difficile à saturer.
Ainsi, pour un même nombre de tokens, le coût unitaire de sortie est généralement nettement supérieur à celui d’entrée. Les principaux fournisseurs appliquent d’ailleurs le plus souvent un prix de sortie supérieur au prix d’entrée. Si votre activité repose principalement sur des sorties longues — génération de code, rédaction de documents longs ou raisonnement multi-tours d’un Agent —, les coûts se concentrent du côté de la sortie. Lors de l’évaluation d’un fournisseur, examinez en priorité le prix de sortie et le débit de sortie.
KV Cache et contextes longs : la taxe invisible sur la VRAM
Le coût d’une requête à contexte long ne se limite pas à un volume d’entrée plus important. Le KV Cache occupe davantage de VRAM à mesure que le contexte s’allonge, ce qui réduit le nombre de requêtes qu’une même carte peut servir simultanément. Autrement dit, un utilisateur avec un contexte très long peut monopoliser les places en concurrence de plusieurs utilisateurs ordinaires. Ce coût n’apparaît pas forcément en totalité dans le prix unitaire ; les fournisseurs doivent l’équilibrer par une tarification par paliers, une limitation de débit ou une limite de longueur de contexte.
Cache hit : un levier de réduction des coûts, mais aussi un piège tarifaire
La mise en cache des invites (Prompt Caching) évite de recalculer les préfixes répétés ; la partie qui touche le cache est facturée au tarif réduit de lecture du cache. Pour des cas d’usage comme les Agent ou le RAG, où l’invite système est longue et répétée, le taux de hit du cache pèse sensiblement sur la facture finale. Attention : les règles de facturation de l’écriture dans le cache, de la lecture du cache et de la durée de validité du cache varient d’un fournisseur à l’autre ; certaines fonctionnalités doivent même être activées explicitement. Lors de l’évaluation, vérifiez impérativement que le champ usage renvoyé contient bien les statistiques de tokens liées au cache.
| Règles de facturation | Caractéristiques de consommation des ressources | Points à vérifier lors de l’évaluation |
|---|---|---|
| Tokens d’entrée | Calcul parallèle en Prefill, efficacité élevée | La tarification dépend-elle de la longueur du contexte ? |
| Tokens de sortie | Génération token par token en Decode, limitée par la bande passante de la VRAM | Prix de sortie, débit de sortie (Token/s) |
| Écriture dans le cache | Première écriture dans le cache, facturée séparément sur certaines plateformes | Y a-t-il un surcoût à l’écriture ? Quelle est la durée de validité ? |
| Lecture du cache | Hit sur le préfixe, calcul répété évité | Remise sur la partie en cache, le champ usage est-il exposé ? |
| Tokens de raisonnement | Processus de réflexion interne des modèles de raisonnement | Sont-ils comptés dans la sortie ? Peut-on limiter le budget ? |
💰 Précision sur les règles de facturation : le tableau ci-dessus décrit uniquement les dimensions de facturation et ne donne aucun prix concret. Pour les prix unitaires d’entrée et de sortie ainsi que les prix de lecture/écriture du cache des modèles mentionnés dans cet article, référez-vous aux données réelles de la page de tarifs d’APIYI :
https://docs.apiyi.com/models. Les règles de facturation peuvent varier selon le modèle et le groupe ; vérifiez chaque point avant de commander.
Inférence auto-hébergée vs appel d’API : comment calculer les coûts en tokens
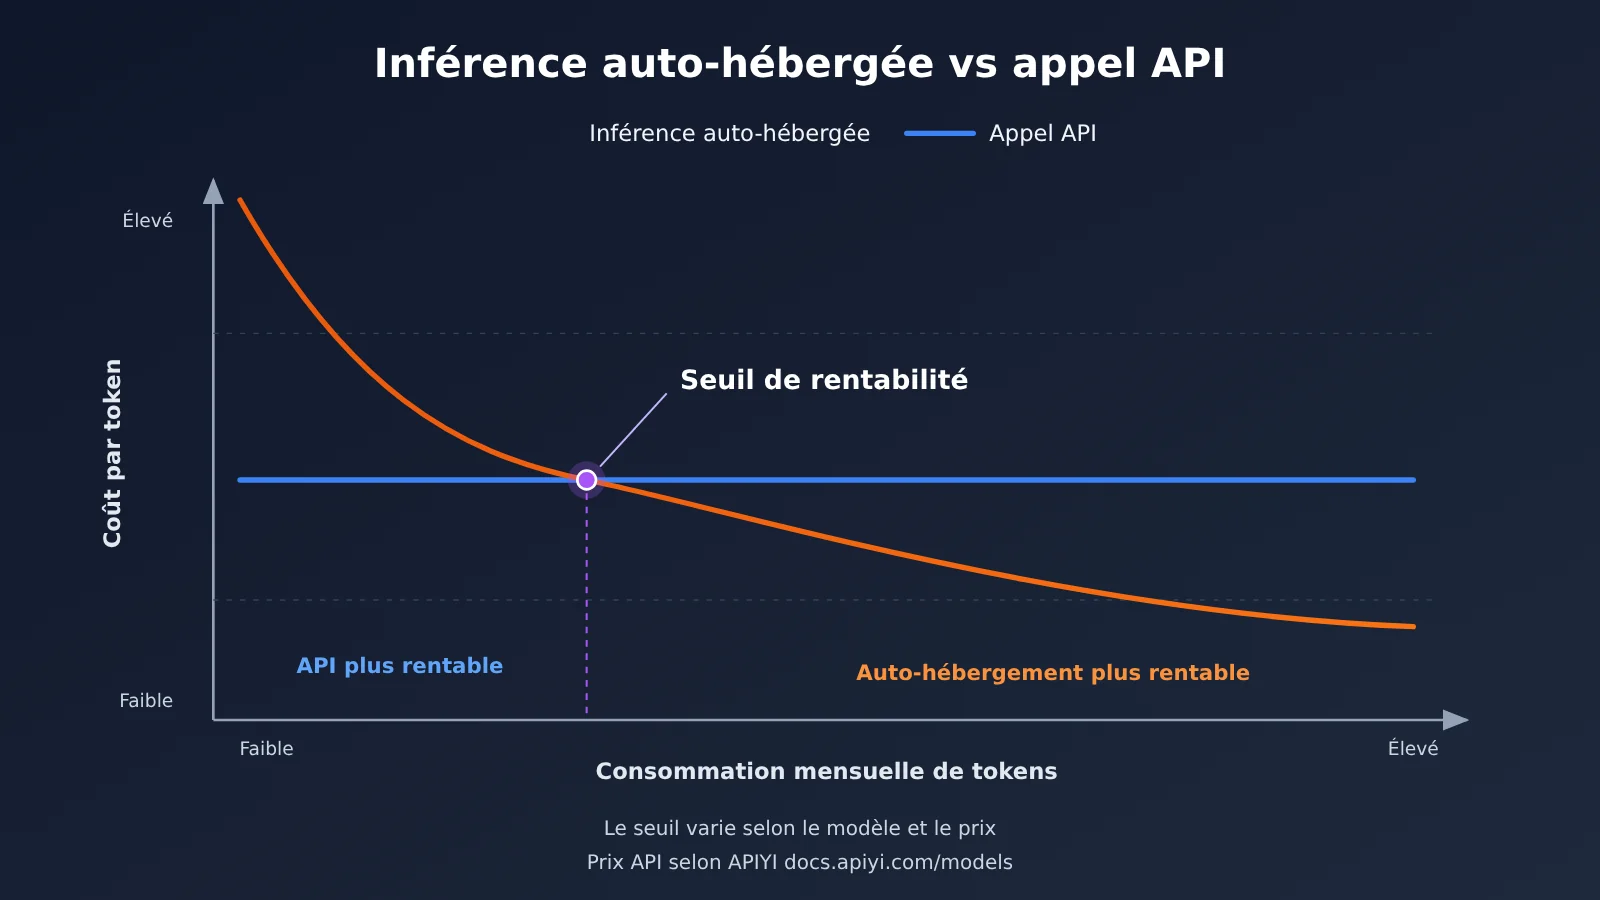
Le cas « 56 cartes B200 pour 2000 ingénieurs, avec des coûts réduits d’environ 90 % » ne tient que sous certaines conditions. La charge de cette entreprise provient de ses ingénieurs internes : le volume de requêtes est élevé et relativement stable. Les pics se concentrent sur les heures de travail, ce qui rend la demande très prévisible. Le modèle utilisé est GLM, open source et déployable en interne. Ces trois éléments permettent d’amortir suffisamment les coûts fixes et évitent précisément le casse-tête du taux d’utilisation qui préoccupe le plus les fournisseurs d’inférence publics.
À l’inverse, ce cas ne signifie pas que toutes les équipes doivent passer à l’auto-hébergement. Si le volume de requêtes est faible, très variable, ou s’il faut changer souvent de modèle propriétaire, le coût d’inactivité d’un cluster GPU auto-hébergé dépassera rapidement la facture API. La valeur des fournisseurs d’inférence publics réside précisément dans le fait de lisser les pics et les creux en mutualisant la charge de nombreux clients, afin d’obtenir un meilleur taux d’utilisation global.
| Solution | Structure de coûts | Cas d’usage | Principaux risques |
|---|---|---|---|
| Cluster GPU auto-hébergé | Coûts fixes élevés, coût marginal faible | Grandes équipes avec un volume important, une charge stable et un modèle fixe | Gaspillage dû à l’inactivité, personnel d’exploitation et de maintenance, dépréciation du matériel à chaque génération |
| API officielle d’un seul modèle | Paiement à l’usage uniquement | Activités fortement dépendantes d’un modèle propriétaire précis | Tarification figée, coût de changement élevé, disponibilité géographique limitée |
| Plateforme d’agrégation d’API multi-modèles | Paiement à l’usage, interface unifiée | Besoin de comparer, changer et combiner plusieurs modèles | Nécessité de vérifier la transparence de la facturation et la stabilité |
| Architecture hybride | Tâches fréquentes auto-hébergées, tâches de longue traîne via API | Taille d’activité moyenne à grande, stratification claire des modèles | Complexité architecturale accrue |
Analyse comparative de l’auto-hébergement : l’auto-hébergement présente un avantage sur le plancher de coût unitaire, à condition toutefois que le taux d’utilisation soit suffisamment élevé et que l’équipe sache gérer le déploiement, la quantification, la mise à l’échelle et la reprise après incident. En comparaison, le coût unitaire d’une solution API est plus prévisible et convient mieux aux équipes dont la charge varie fortement et qui doivent valider plusieurs modèles en parallèle.
Analyse comparative des plateformes d’agrégation : les API officielles ont l’avantage de proposer les nouveaux modèles plus rapidement, mais dans la plupart des cas, un compte ne donne accès qu’aux modèles d’un seul fournisseur. L’intérêt d’une plateforme d’agrégation multi-modèles est de réunir plusieurs modèles derrière une seule interface, ce qui facilite les comparaisons A/B et la répartition des coûts par niveau. Des plateformes comme APIYI apiyi.com sont compatibles à la fois avec les formats d’interface OpenAI et Anthropic : il suffit de modifications minimes du code existant pour changer de modèle.
Comment évaluer un fournisseur de services API pour modèles : une checklist de démarrage rapide en 6 dimensions
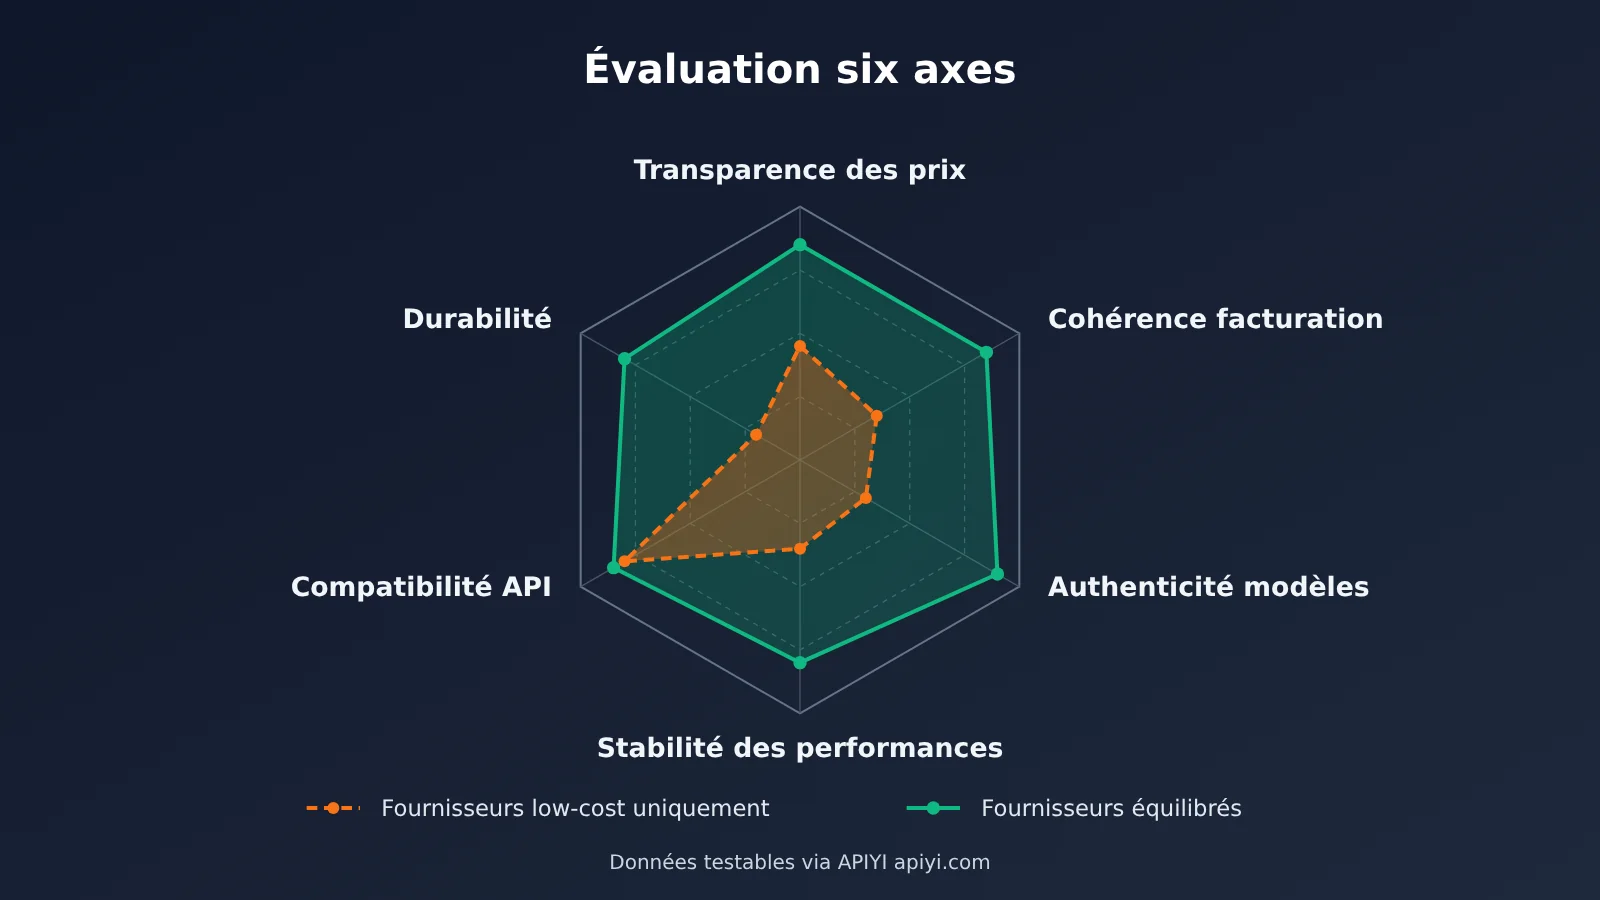
Une fois la structure des coûts comprise, on peut en déduire un principe : un prix durablement inférieur au coût n’est pas viable. Le fournisseur doit soit « économiser » à un endroit, soit s’appuyer sur des subventions pour tenir un temps. Pour évaluer un fournisseur, il ne faut pas se contenter du prix affiché : les 6 dimensions ci-dessous sont à examiner ensemble.
| Dimension | Question clé | Méthode de vérification |
|---|---|---|
| 1. Transparence des prix | Les prix d’entrée, de sortie et de cache sont-ils publiés séparément ? | Comparer la page tarifaire et noter chaque élément selon le même périmètre |
| 2. Cohérence de la facturation | Le montant réellement débité correspond-il à usage ? |
Vérifier le détail de la facture après quelques appels à petite échelle |
| 3. Authenticité du modèle | Y a-t-il une dégradation, un mélange de modèles ou une quantification excessive ? | Comparer la qualité des sorties sur un jeu de tests fixe |
| 4. Stabilité des performances | Qu’en est-il de la latence du premier token, du débit et du taux d’erreur ? | Tester une fois en heure de pointe et une fois en heure creuse |
| 5. Compatibilité de l’interface | Est-elle compatible avec les formats OpenAI / Anthropic ? | Tester avec le SDK existant en ne changeant que base_url |
| 6. Durabilité | Le prix est-il nettement inférieur à la fourchette de coûts raisonnable ? | Juger le risque de subvention à partir de la structure des coûts |
Étape 1 : se connecter via une interface compatible et effectuer un appel minimal
On peut très bien expliquer le processus de test sans écrire de code. Si votre projet utilise déjà le SDK OpenAI, il suffit généralement de modifier deux paramètres : remplacez api_key par la clé fournie par le prestataire, et base_url par l’adresse de l’interface du prestataire. Prenons APIYI comme exemple : avec le format compatible OpenAI, le base_url est https://api.apiyi.com/v1, les requêtes de conversation passent par le chemin /v1/chat/completions, et il suffit de renseigner le nom du modèle cible dans le champ model.
Si votre projet repose sur le SDK Anthropic, par exemple avec les modèles Claude ou des outils comme Claude Code, vous pouvez également remplacer l’adresse de l’interface et passer par le format natif Anthropic sur le chemin /v1/messages. Pour l’adresse exacte et le nom du modèle, référez-vous à la documentation APIYI : https://docs.apiyi.com. Pour un appel minimal, je vous conseille d’activer en même temps la sortie en streaming avec stream, afin de mesurer plus facilement la latence du premier token par la suite.
Étape 2 : vérifier la base de facturation et les champs usage
Dans la réponse de chaque appel, le format OpenAI renvoie usage.prompt_tokens et usage.completion_tokens, et certains modèles fournissent aussi cached_tokens pour les hits de cache. Le format Anthropic correspond à input_tokens, output_tokens, ainsi qu’aux champs de lecture et d’écriture du cache. Vous pouvez estimer le coût d’un appel avec une formule simple : nombre de tokens d’entrée multiplié par le prix unitaire d’entrée, plus nombre de tokens de sortie multiplié par le prix unitaire de sortie, plus nombre de tokens lus ou écrits dans le cache multiplié par le prix unitaire du cache correspondant.
Comparez ensuite cette estimation avec le détail de la facture de la plateforme : l’écart doit pouvoir s’expliquer. Si, sur la durée, la facture dépasse systématiquement ce que les données usage laissent prévoir, ou si les hits de cache n’apparaissent jamais dans la facturation, il faut être vigilant. Pour les prix unitaires utilisés dans l’estimation, référez-vous aux données publiées sur la page tarifs d’APIYI : https://docs.apiyi.com/models.
Troisième étape : tester les performances, la qualité et les heures de pointe
Pour les tests de performance, je recommande de relever trois indicateurs : la latence du premier token (TTFT), le débit de sortie (tokens par seconde) et le taux d’erreur (timeouts, limitation 429, 5xx). Effectuez une série de tests aux heures de pointe en semaine et une autre aux heures creuses la nuit : plus la variation est faible, plus le dimensionnement de capacité du fournisseur est confortable. Pour les tests de qualité, utilisez un ensemble fixe d’invites couvrant le code, le raisonnement et les textes longs, puis comparez les sorties avec celles du canal officiel ou d’autres plateformes. Cela aide à repérer un modèle dégradé ou remplacé.
| Élément de test | Paramètres / champs clés | Référence acceptable |
|---|---|---|
| Latence du premier token | Activer stream, enregistrer l’heure du premier chunk |
L’écart entre heures de pointe et heures creuses ne doit pas être trop important |
| Débit de sortie | completion_tokens ÷ durée de génération |
Proche des autres canaux du même modèle |
| Vérification de la facturation | Champs usage × prix unitaire de la page tarifs |
Écart avec le détail de la facture explicable |
| Cache hit | cached_tokens ou champ de lecture du cache |
Les requêtes répétées avec un long préfixe doivent toucher le cache |
| Stabilité | Nombre de 429 / 5xx / timeouts | Taux d’erreur faible et procédure de réessai documentée |
🚀 Démarrage rapide : si vous souhaitez comparer le coût et les performances de plusieurs modèles derrière la même interface, vous pouvez d’abord vous inscrire via APIYI apiyi.com et obtenir des crédits de test. La plateforme propose l’appel API des principaux modèles abordés dans cet article, compatible avec les formats d’interface OpenAI et Anthropic ; il suffit de remplacer
base_urlparhttps://api.apiyi.com/v1pour commencer la validation. Les tarifs de chaque modèle sont disponibles surhttps://docs.apiyi.com/models.
FAQ — questions fréquentes
Q1 : pourquoi les services de tokens perdent-ils de l’argent ?
Les services d’inférence reposent essentiellement sur des coûts fixes : amortissement des GPU, électricité des salles serveurs, etc. Pourtant, les revenus sont facturés au volume de tokens. Il faut réserver de la capacité pour les pics, capacité qui reste inactive en période creuse — difficile dès lors de maintenir un taux d’utilisation élevé sur la durée. Ajoutez à cela la guerre des prix provoquée par la banalisation des modèles ouverts et les crédits gratuits offerts : le prix de vente finit facilement sous le coût de revient.
Q2 : pourquoi les tokens de sortie coûtent-ils généralement plus cher que ceux d’entrée ?
Les entrées sont calculées en parallèle pendant la phase de Prefill : l’utilisation du GPU y est très efficace. Les sorties, elles, sont générées token par token pendant la phase de Decode, avec des lectures répétées du KV Cache. Le goulot d’étranglement est la bande passante mémoire, ce qui fait grimper le coût unitaire. Les activités à forte production de texte doivent donc surveiller en priorité le prix unitaire de sortie et le débit.
Q3 : est-il toujours moins cher de faire tourner ses propres GPU que d’appeler une API ?
Pas forcément. Les cas comme « 56 B200 pour faire tourner 2000 ingénieurs » reposent sur une charge interne massive, stable et prévisible. Une équipe dont l’usage est faible ou très irrégulier se retrouve avec des machines largement inactives, et un coût unitaire finalement plus élevé. Le conseil : commencez par mesurer votre courbe d’usage réelle via une API, puis évaluez le point d’équilibre.
Q4 : peut-on utiliser un fournisseur d’API vraiment très bon marché ?
On peut tester, mais il faut vérifier sérieusement. Un prix nettement inférieur à la fourchette de coût raisonnable cache en général l’une de ces situations : subvention, limitation de débit, dégradation du modèle ou compromis sur la stabilité. Passer le checklist en 6 dimensions présentée dans cet article — qualité et facturation — est bien plus fiable que de comparer les étiquettes de prix.
Q5 : comment comparer à moindre coût les performances API de plusieurs modèles ?
Le plus simple : utiliser une plateforme multi-modèles compatible avec les formats d’interface courants, et faire un test unifié :
1. Créez un compte sur APIYI apiyi.com et récupérez une clé API
2. Configurez l’interface compatible OpenAI ou Anthropic comme indiqué dans la documentation `https://docs.apiyi.com`
3. Avec un jeu de tests fixe, faites tourner le champ `model` et notez la latence, la qualité et le champ `usage`
Un seul jeu de code suffit pour la comparaison transversale, et le coût de bascule reste minime.
Q6 : comment consulter les prix du cache ? Les plateformes utilisent-elles la même convention ?
Non, elles diffèrent. Certaines plateformes facturent séparément l’écriture en cache, d’autres n’appliquent une remise qu’à la lecture, et la durée de validité comme le mode d’activation varient aussi. Lors d’un appel via APIYI, référez-vous aux données réelles de la page tarifaire `https://docs.apiyi.com/models` pour les prix de lecture et d’écriture du cache, et recoupez la facturation avec les champs de cache renvoyés dans `usage`.
Q7 : quel indicateur est le plus souvent négligé lors de l’évaluation d’un fournisseur ?
La cohérence de la facturation et la stabilité en heures de pointe. Beaucoup d’équipes font un test unique en période creuse avant de passer en production, puis se heurtent à des 429 ou des timeouts dès que la charge monte. D’autres ne vérifient jamais la correspondance entre `usage` et la facture. Ces deux points devraient faire partie des contrôles systématiques avant mise en production.
Coûts du service Token et évaluation des fournisseurs d’API : points clés
- D’où vient la perte : coûts fixes élevés, revenus à l’usage, taux d’utilisation variable — cette combinaison rend les services de tokens facilement déficitaires
- La sortie coûte plus cher : le décodage est bridé par la bande passante mémoire du GPU ; les activités à sortie longue doivent surveiller de près le prix unitaire de sortie et le débit
- Le contexte long a un coût caché : le KV Cache monopolise la VRAM et réduit la concurrence ; les fournisseurs n’ont d’autre choix que d’équilibrer avec des paliers tarifaires et une limitation de débit
- L’auto-hébergement a ses exigences : seule une charge importante et stable permet d’amortir le coût fixe des GPU ; les petites équipes ont intérêt à passer par l’API
- Six dimensions pour évaluer : transparence des prix, cohérence de la facturation, authenticité du modèle, stabilité des performances, compatibilité des interfaces, durabilité
- Pour démarrer : tester rapidement via APIYI, compatible avec les formats OpenAI / Anthropic, les prix faisant foi sur
docs.apiyi.com/models
Conclusion : comprendre le service Token par sa structure de coûts et bien choisir son fournisseur d’API de modèles
Pourquoi les services de tokens perdent-ils de l’argent ? En dernière analyse, tout est déterminé par la structure de coûts de l’inférence :
- Côté coûts : l’amortissement des GPU et l’électricité du datacenter sont des coûts fixes, le taux d’utilisation est le levier de rentabilité, et les tokens de sortie comme le contexte long font encore grimper la facture
- Côté revenus : l’homogénéisation des modèles open source rend la guerre des prix inévitable ; les subventions attirent du volume mais écrasent la marge
- Côté choix : un prix bas ne veut pas dire une bonne affaire ; il faut arbitrer selon six dimensions — transparence des prix, cohérence de la facturation, authenticité du modèle, stabilité des performances, compatibilité des interfaces et durabilité
Pour les développeurs, plutôt que de deviner quel fournisseur tiendra le plus longtemps, mieux vaut s’appuyer sur de vraies données d’appels. Commencez par un faible volume pour valider la facturation et comparer la qualité, puis décidez de votre modèle principal et de vos canaux de secours.
Nous vous recommandons de vérifier rapidement les résultats via APIYI apiyi.com. La plateforme propose l’appel API des modèles présentés dans cet article, compatible avec les formats d’interface OpenAI et Anthropic ; la documentation d’intégration se trouve sur https://docs.apiyi.com. Les prix d’entrée, de sortie et de cache de tous les modèles font foi sur la page tarifaire https://docs.apiyi.com/models.
📚 Références
- 36氪 – Les tokens se vendent même dans le live de Li Jiaqi, alors pourquoi les « SiliconFlow » et consorts sont-ils encore déficitaires ? : reportage sur les difficultés de rentabilité des fournisseurs de services d’inférence
- Lien :
36kr.com/p/4055385238017664 -
Description : comprendre le contexte sectoriel de la marchandisation des tokens et des pertes des fournisseurs de services d’inférence
-
36氪 – Une entreprise dépensait 10 000 dollars par mois, trouvait Claude trop cher et est passée à GLM : cas de réduction des coûts via l’inférence auto-hébergée en entreprise
- Lien :
36kr.com/p/4055383551038595 -
Description : cas d’inférence auto-hébergée avec 56 GPU B200 pour 2 000 ingénieurs, utile pour comprendre la frontière de coût entre auto-hébergement et API
-
Centre de documentation APIYI : intégration des API et prix des modèles
- Lien :
docs.apiyi.com - Description : consultez les modes d’intégration compatibles OpenAI / Anthropic ; les prix des modèles font référence sur
docs.apiyi.com/models
Auteur : équipe technique APIYI
Échanges techniques : pour toute question sur le choix des modèles et l’évaluation des coûts de Token, n’hésitez pas à nous contacter via le site officiel APIYI apiyi.com. Vous trouverez plus de ressources d’intégration dans le centre de documentation docs.apiyi.com.