Note de l’auteur : après une mise à niveau de modèle, on ne supprime pas les invites et le code de correctif au feeling. Cet article s’appuie sur une classification en 4 catégories et un processus de régression en 5 étapes pour vous aider à déterminer ce qu’il faut supprimer, modifier ou conserver.
En novembre 2026, un article de 36Kr sur le départ d’une figure clé de Claude Code chez Anthropic a relancé les discussions de nombreux développeurs autour des outils de programmation IA. Au-delà des histoires de personnes, la question plus concrète que se posent beaucoup d’équipes est la suivante : à chaque mise à niveau de modèle, les invites et le code de correctif s’accumulent. Ont-ils encore une raison d’être ? Cet article présente une méthode de nettoyage en trois temps : classer d’abord, comparer ensuite, déployer progressivement en dernier, pour vous aider à faire le ménage sans sacrifier la stabilité.
Ce n’est pas un article qui vous pousse à « tout supprimer sans retenue ». Les invites peuvent contenir des règles métier, et le code de correctif peut aussi embarquer des garde-fous de sécurité. Le coût d’une suppression accidentelle dépasse souvent celui de payer quelques tokens de plus. Cet article ne fournit pas non plus de benchmark universel, car l’effet du nettoyage dépend de vos échantillons métier : vous devez tirer vos conclusions à partir de vos propres données.
Valeur clé : après lecture, vous saurez déterminer quelles invites et quels codes de correctif peuvent être supprimés après une mise à niveau de modèle, et vous pourrez mener le nettoyage avec un processus réversible.
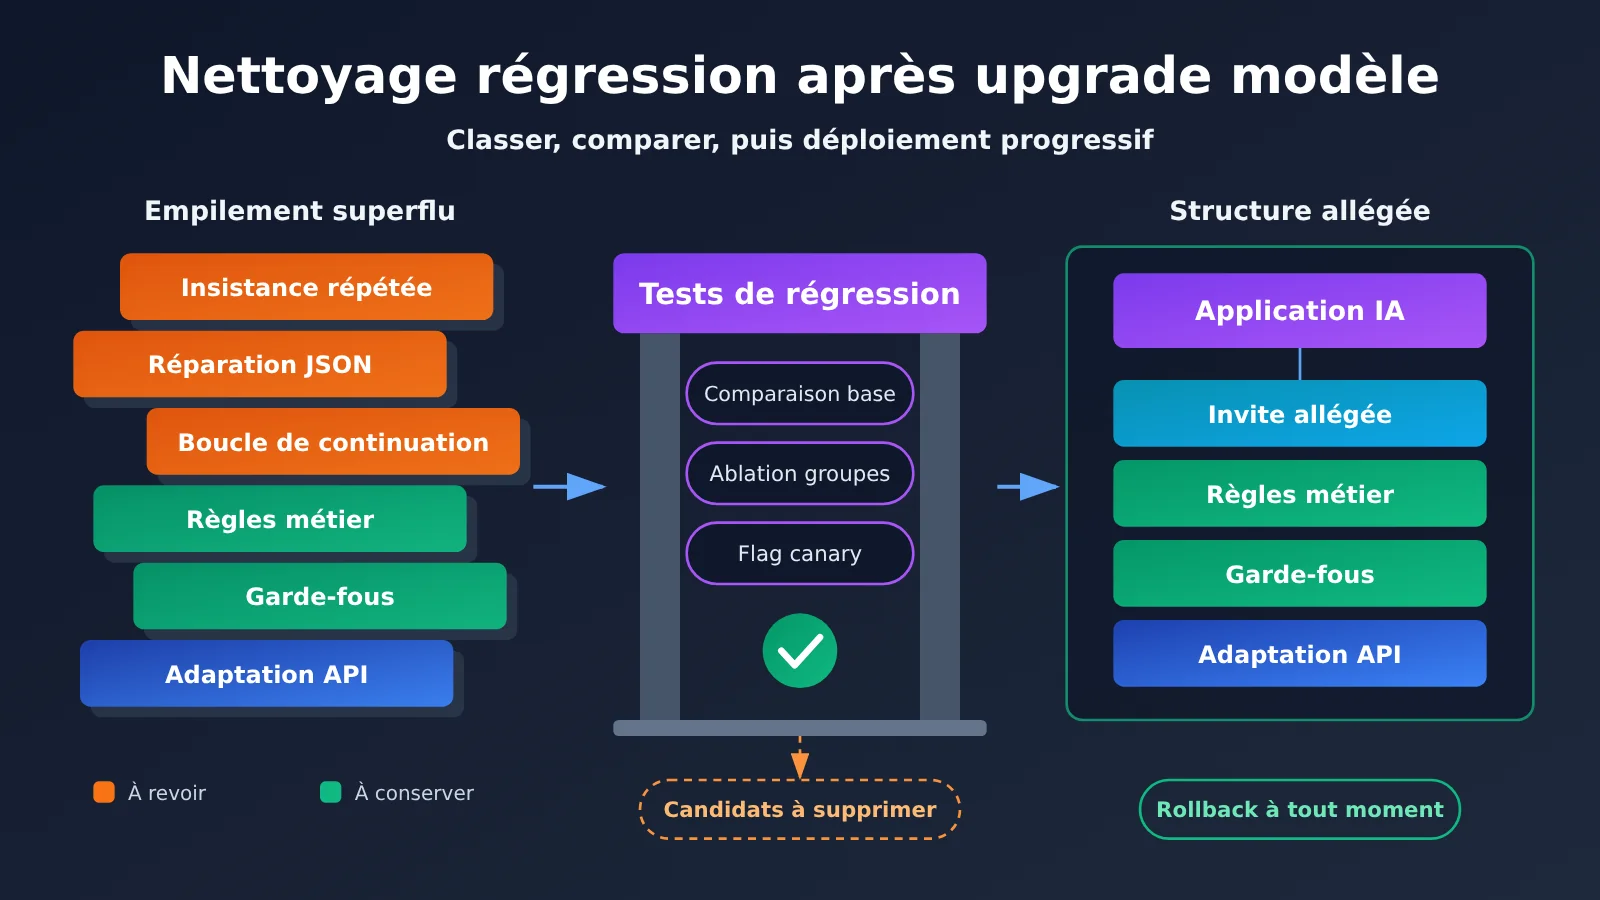
Points clés du nettoyage des invites et du code de correctif après une mise à jour de modèle
Retenez d’abord un principe de jugement : une invite ou un correctif qui servait à compenser les lacunes d’un ancien modèle doit être réexaminé ; s’il exprime une règle métier ou sert à maîtriser un risque, il ne faut pas le supprimer sous prétexte que le modèle a été mis à jour. Le tableau ci-dessous résume le déroulé détaillé plus loin.
| Point clé | Description | Intérêt |
|---|---|---|
| Classer avant d’agir | Répartir en 4 catégories : compensation du modèle, règles métier, garde-fous de sécurité, adaptation d’interface | Éviter de supprimer par erreur une logique critique |
| Ne changer que le modèle pour la référence | Premier tour : garder les invites et le code inchangés | Distinguer l’effet du changement de modèle de celui du nettoyage |
| Tests d’ablation par groupe | Retirer un seul groupe à la fois et comparer les résultats | Identifier précisément le rôle de chaque élément |
| Déploiement progressif avec interrupteur | Le résultat du nettoyage est piloté par configuration, avec retour arrière possible à tout moment | Réduire le risque d’incident en production |
| Vérifier la facture séparément | Une invite plus courte ne signifie pas forcément un coût total plus bas | Éviter de juger sur le seul nombre de tokens |
Pourquoi les invites et le code de correctif deviennent obsolètes après une mise à jour du modèle
Dans la plupart des applications d’IA, les invites ont grandi à force de régler des problèmes en production. Le modèle oubliait un format ? On ajoutait une phrase d’insistance. Sa sortie était tronquée ? On ajoutait une boucle de continuation. Il produisait parfois du JSON malformé ? On ajoutait une fonction de réparation. Ces pratiques étaient raisonnables sur le moment, mais elles sont liées au comportement de l’ancien modèle, et ce lien est rarement documenté.
Après une mise à jour, trois cas de figure peuvent se présenter : le problème a disparu et le correctif devient du code mort ; le problème persiste et le correctif reste utile ; le comportement du modèle a changé et l’ancienne écriture produit même des effets de bord. Par exemple, des formules d’insistance répétées autrefois pour attirer l’attention du modèle peuvent, sur un nouveau modèle qui réagit différemment aux instructions, l’amener à appliquer une règle de façon excessive. L’objectif du réexamen après mise à jour n’est donc pas « le plus court possible », mais que chaque élément ait une raison d’être claire.
Comment répartir les invites et le code correctif en 4 catégories
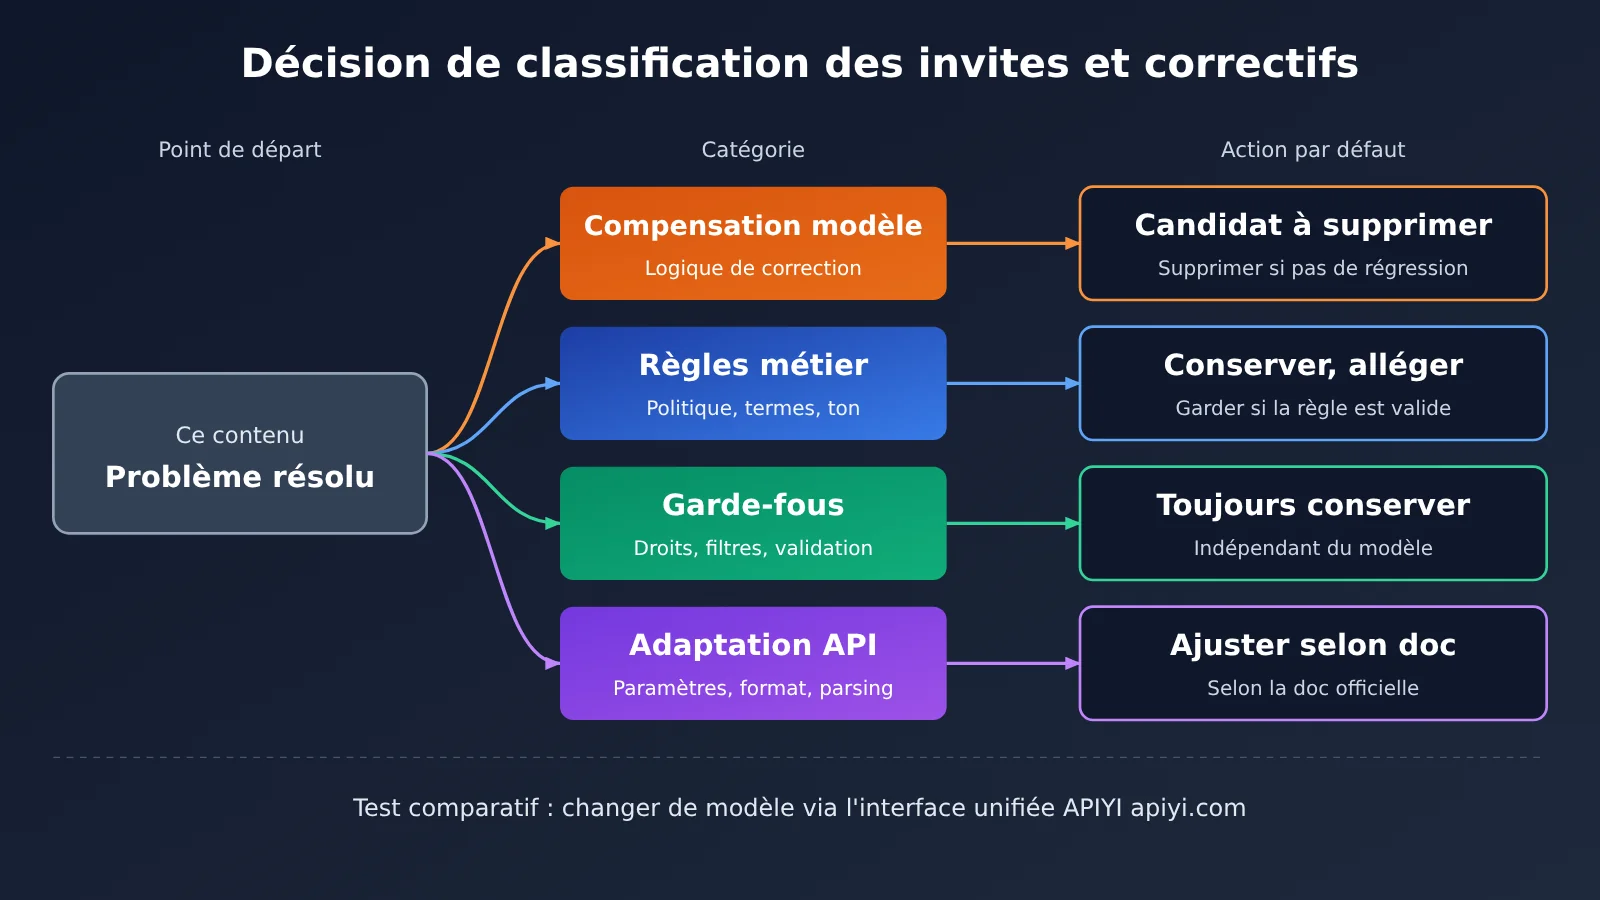
Avant le nettoyage, découpez d’abord l’invite système en paragraphes, puis listez point par point la logique de traitement avant et après l’invocation du modèle. Classez ensuite l’ensemble selon le tableau ci-dessous : les décisions de suppression ultérieures auront ainsi une base.
| Catégorie | Exemples courants | Action par défaut | Critère de décision |
|---|---|---|---|
| Compensation liée au modèle | Répéter sans cesse « ne pas omettre », fonctions de réparation JSON, boucles de continuation après troncature | Placer parmi les candidats à la suppression | Ne supprimer qu’après des tests de régression sans dégradation |
| Règles métier | Politique de remboursement, glossaire, ton de marque, contraintes de domaine | Conserver et alléger la formulation | Conserver si la règle est toujours valable |
| Garde-fous de sécurité | Vérification des autorisations, filtrage des informations sensibles, validation des sorties, protection contre l’injection | Toujours conserver | Ne dépend pas des capacités du modèle |
| Adaptation d’interface | Mappage des paramètres, conversion du format des appels d’outils, analyse des réponses | Ajuster selon le nouveau modèle | Suivre la documentation officielle de l’interface |
Un détail mérite d’être précisé séparément : la logique de réparation peut être envisagée pour suppression ; la logique de validation, elle, ne doit pas être supprimée. Lorsque la sortie structurée du nouveau modèle est plus stable, le code qui répare le JSON par expression régulière peut sans doute être retiré, mais la validation de schéma doit rester. De même, la boucle de continuation prévue en cas de troncature de sortie peut être réexaminée ; en revanche, les nouvelles tentatives en cas d’erreur réseau et de limitation de débit n’ont rien à voir avec les capacités du modèle et ne doivent pas entrer dans le périmètre du nettoyage.
Prise en main rapide du nettoyage des invites et du code de correctif après une mise à niveau de modèle
Le processus en 5 étapes ci-dessous ne demande pas de plateforme sophistiquée : votre framework de test habituel et un simple tableau suffisent. L’essentiel est de ne modifier qu’une seule variable à la fois et de consigner chaque décision.
Étape 1 : recenser l’origine des invites et du code de correctif
Utilisez git log et git blame pour retrouver la date d’introduction de chaque passage ainsi que le problème associé, puis notez quatre informations dans votre inventaire : l’emplacement du contenu, sa catégorie, le problème visé et la méthode de vérification. Si plus personne ne peut expliquer d’où vient une invite, marquez-la comme « à vérifier » plutôt que de la déclarer inutile d’emblée.
Étape 2 : Constituer un jeu d’échantillons de régression pour la montée de version du modèle
Le jeu de régression gagne à comprendre trois parties : les requêtes ordinaires réelles en production, les échantillons d’échec ayant déjà provoqué des incidents, et les scénarios limites métier. La taille de l’échantillon peut être décidée selon le risque ; pour une petite équipe, commencer avec quelques dizaines d’échantillons à forte valeur a déjà du sens. Comme les sorties du modèle sont incertaines, les échantillons clés doivent être exécutés plusieurs fois afin d’éviter de prendre une réussite fortuite pour une réussite stable.
Étape 3 : Ne changer que le modèle, établir une base de référence
Au premier cycle, modifiez uniquement le nom du modèle, en laissant l’invite et le code tels quels, et en fixant les paramètres contrôlables comme la température. Vous obtenez ainsi l’écart entre « ancien modèle + ancienne configuration » et « nouveau modèle + ancienne configuration », et pouvez détecter à l’avance les changements de paramètres d’interface ou de structure de réponse. Si la plateforme prend en charge des noms de modèles à version fixe, privilégiez une version fixe pour éviter que le modèle ne change pendant les tests et ne perturbe les résultats.
Le tableau ci-dessous liste les éléments de configuration à vérifier lors de la mise en place de l’expérience de contrôle.
| Élément de configuration | Comment le renseigner | Points d’attention |
|---|---|---|
base_url |
Utiliser l’adresse d’interface correspondante indiquée dans la documentation APIYI | Les adresses et chemins aux formats OpenAI et Anthropic font foi dans la documentation |
api_key |
Utiliser la clé créée dans la console | À gérer via des variables d’environnement, ne pas l’écrire dans le dépôt |
model |
Indiquer le nom du modèle figurant sur la page des tarifs ou dans la documentation | Les groupes d’expérimentation ancien/nouveau restent identiques hormis le nom du modèle |
temperature |
Utiliser la même valeur pour tous les groupes d’expérimentation | La plage de paramètres peut différer selon les modèles, consultez la documentation |
max_tokens |
Prévoir un espace suffisant pour les anciens et nouveaux modèles | Éviter de confondre une troncature avec un problème de qualité du modèle |
🚀 Conseil pour démarrer rapidement : ce qui prend souvent le plus de temps dans une expérience de contrôle, c’est l’adaptation à plusieurs jeux d’interfaces. APIYI propose l’appel API des modèles Claude, GPT et autres mentionnés dans cet article, et est compatible avec les formats d’interface OpenAI et Anthropic ; il suffit généralement d’ajuster
base_url,api_keyetmodelpour commencer les tests. Voir la documentation APIYI pour les instructions d’accès : https://docs.apiyi.com
Étape 4 : ablation par groupes des invites et du code de correctif
Une fois la base stabilisée, retirez les groupes un par un en commençant par la catégorie des compensations du modèle. Chaque groupe ne doit contenir que des éléments qui répondent au même problème. Par exemple, commencez par retirer les invites liées à l’« insistance sur le format » et leur fonction de correction, puis lancez les tests de régression avant de passer au groupe suivant. Si vous supprimez trop d’éléments d’un coup, il sera difficile d’identifier la cause d’une dégradation, et vous finirez souvent par tout annuler.
| Indicateur | Ce qu’il faut observer | Référence pour la décision |
|---|---|---|
| Taux de réussite sur les échantillons critiques | Les incidents historiques et les scénarios à haut risque passent-ils toujours ? | Rétablir le groupe concerné dès qu’une dégradation apparaît |
| Taux de réussite global des tâches | Évolution de la qualité sur les requêtes ordinaires | Juger selon le seuil défini à l’avance par l’équipe |
| Taux de déclenchement des correctifs | Nombre réel de déclenchements de la logique de correction ou de continuation de génération | Un niveau proche de zéro sur la durée peut justifier une suppression |
| Tokens et latence | Volume de tokens en entrée et en sortie, et temps de réponse | Servent à évaluer le bénéfice réel du nettoyage |
| Taux d’intervention humaine | Proportion de transferts vers un humain ou de reprises par l’utilisateur | À surveiller en continu après la mise en production pour compenser les angles morts des échantillons hors ligne |
Les critères de décision doivent être définis avant de lancer les tests ; sinon, l’équipe risque d’ajuster les critères a posteriori en fonction des résultats. Pour le code de correctif, vous pouvez aussi commencer par seulement journaliser, sans intervenir : laissez-le continuer à s’exécuter tout en remontant « ce qui se passerait sans lui », puis décidez quelques jours plus tard, à partir des données de déclenchement, s’il faut le supprimer. C’est particulièrement utile pour les activités à haut risque.
Étape 5 : déploiement progressif avec possibilité de rollback
Pour la version nettoyée, mieux vaut passer par un interrupteur de configuration : on couvre d’abord une petite part du trafic, on vérifie que les indicateurs restent stables, puis on élargit. Les enregistrements de suppression doivent indiquer clairement la justification, par exemple « la régression de telle version du modèle est validée, le taux de déclenchement du patch reste proche de zéro ». Ainsi, lors de la prochaine mise à niveau, ce jugement pourra être réutilisé directement.
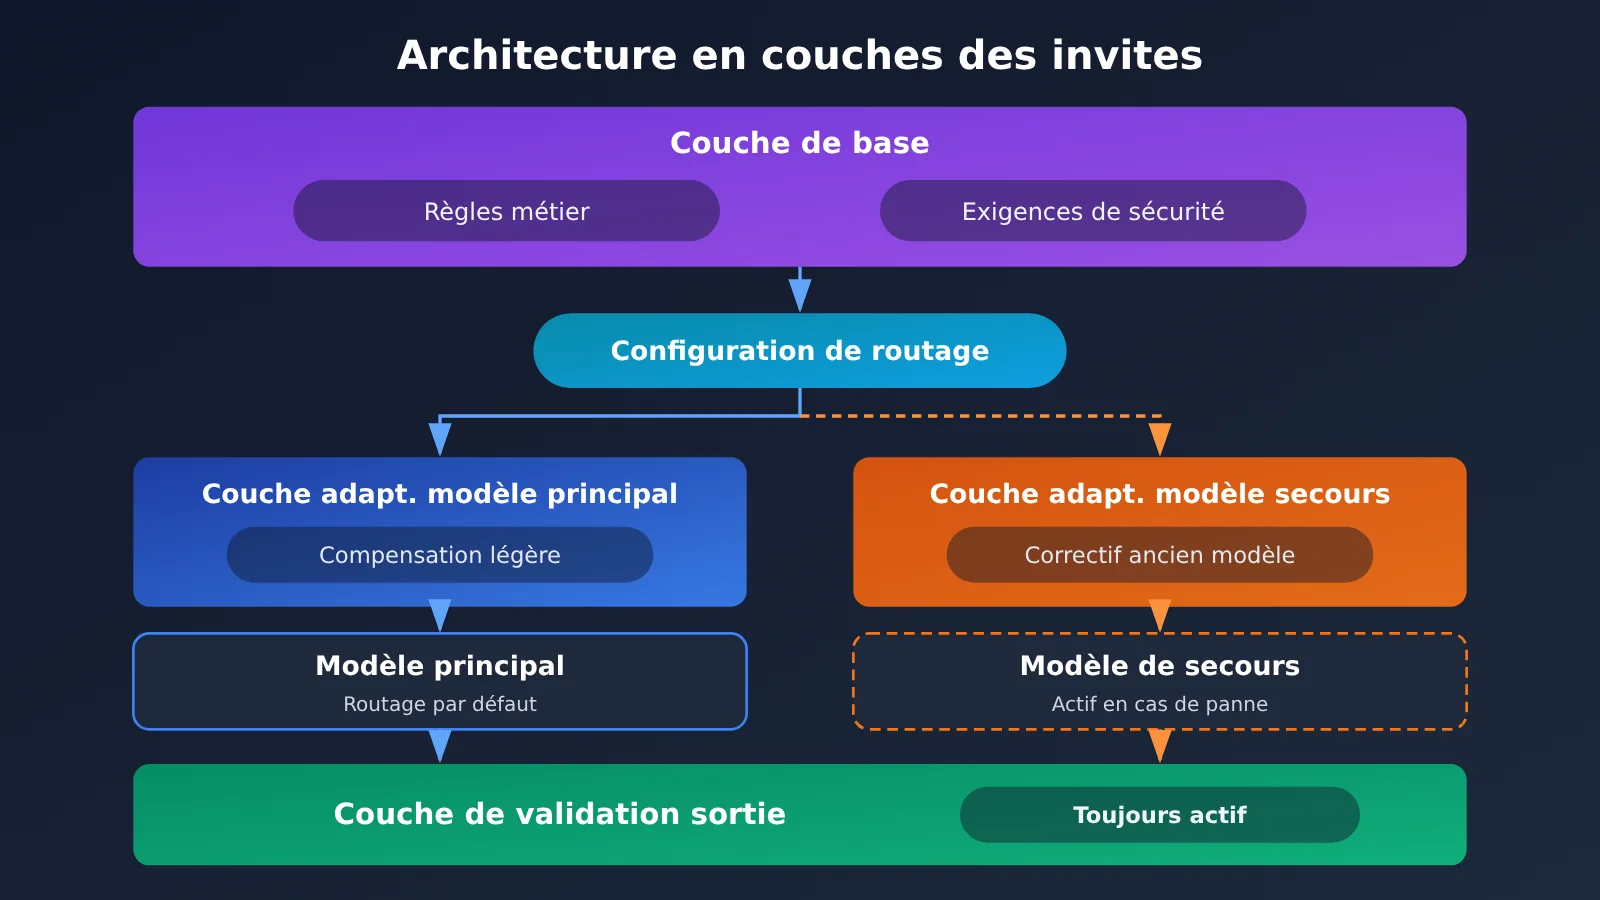
Il faut aussi vérifier tout particulièrement la chaîne de dégradation du modèle. Si le modèle principal est indisponible et qu’on bascule vers l’ancien modèle, les patches écrits pour ce dernier peuvent encore être nécessaires. L’approche la plus sûre consiste à diviser l’invite en deux couches : les règles métier et les exigences de sécurité dans la couche de base, les éléments liés au modèle dans une couche d’adaptation, chargée par la configuration de routage selon le modèle.
Mise à niveau du modèle : comparer 3 approches pour traiter les invites et le code de correctif
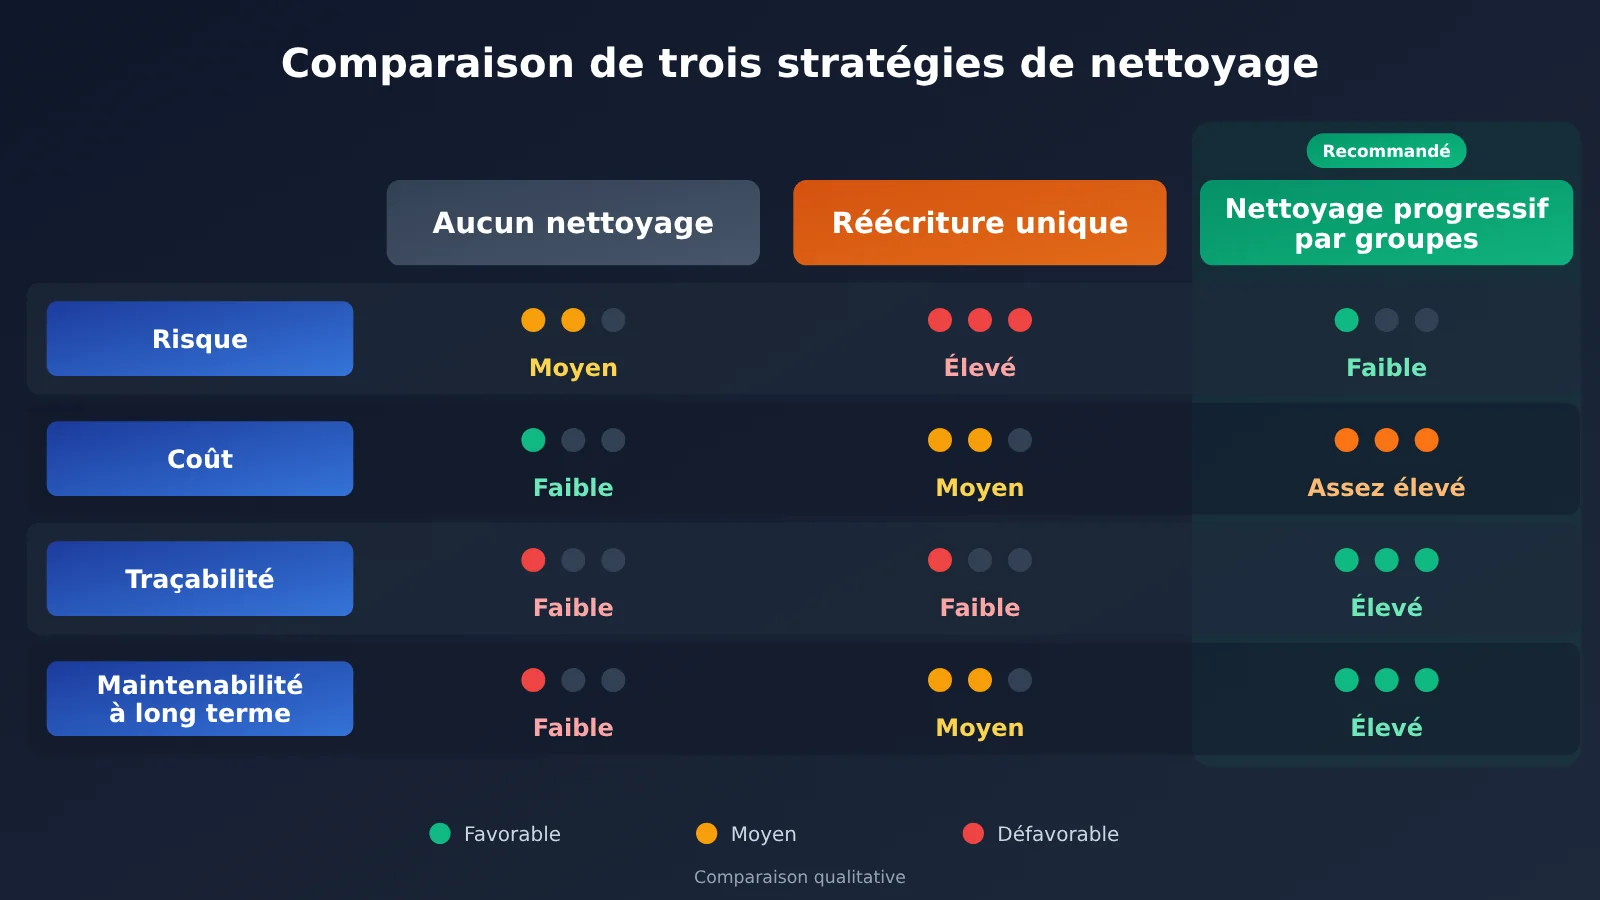
Le nettoyage ne se résume pas à deux extrêmes : tout supprimer ou ne rien toucher. Le tableau ci-dessous compare trois stratégies courantes, à choisir selon le risque métier et l’effort que votre équipe peut y consacrer.
| Approche | Mise en œuvre | Risque principal | Cas adapté |
|---|---|---|---|
| Conservation telle quelle | Changer uniquement le nom du modèle, ne rien modifier d’autre | Le contenu inutile s’accumule et le nouveau modèle a du mal à exploiter son potentiel | Mise à niveau temporaire ou absence de ressources de test à court terme |
| Réécriture en une seule passe | Repartir de zéro en suivant le guide d’invites du nouveau modèle | Des règles métier implicites peuvent être perdues | Invites de petite taille ou refonte métier en cours |
| Nettoyage progressif par groupes | Classer, puis ablater groupe par groupe avec un déploiement progressif | Demande du temps pour construire un jeu de régression | Environnement de production et applications maintenues sur le long terme |
Analyse comparative de la conservation telle quelle : cette approche garde l’avantage sur la vitesse de mise en production, mais les effets de bord des anciennes invites et la charge de maintenance ne disparaissent pas d’eux-mêmes. À l’inverse, le nettoyage progressif par groupes convient mieux aux systèmes de production qui doivent itérer sur la durée.
Analyse comparative de la réécriture en une seule passe : cette approche brille par la propreté de la structure des invites, mais l’expérience métier enfouie dans les correctifs historiques est facile à oublier. Si vous choisissez vraiment de réécrire, validez tout de même avec le même jeu de régression et vérifiez une à une les règles métier de l’ancienne version.
Estimer le coût du nettoyage des invites et du code de correctif après une mise à niveau de modèle
Des invites plus courtes ne signifient pas forcément un coût total plus faible. Le prix d’un appel s’estime ainsi : « tokens d’entrée × prix unitaire d’entrée + tokens de sortie × prix unitaire de sortie ». Avec la mise en cache, il faut aussi distinguer la facturation des lectures et des écritures de cache, et compter les appels supplémentaires générés par les nouvelles tentatives et les replis. Les sorties du nouveau modèle peuvent être plus longues, et modifier le préfixe des invites peut affecter les hits de cache : vérifiez donc avec les volumes réels mesurés pendant l’expérimentation.
💰 Précision sur les tarifs : cet article ne donne aucun prix unitaire. Pour les tarifs des modèles, les règles de facturation, les prix d’entrée et de sortie et le prix du cache, référez-vous aux données réelles de la page tarifaire APIYI https://docs.apiyi.com/models, et notez la date de consultation au moment du calcul.
Questions fréquentes (FAQ)
Q1 : Qu’appelle-t-on « compensation de modèle » dans les invites et le code de patch ?
La compensation de modèle désigne tout le contenu ajouté pour contourner les faiblesses d’un modèle donné : répéter inlassablement le format de sortie, réparer un JSON cassé, recoller des résultats tronqués. Ce qui la distingue d’une règle métier, c’est qu’après être passé à un modèle plus capable, elle peut très bien devenir inutile.
Q2 : Après une montée de version du modèle, faut-il tout supprimer et réécrire les invites et le code de patch ?
En général, non. Une réécriture complète, c’est plus propre, mais on perd facilement des règles métier implicites et le savoir tiré d’incidents passés. Pour un système en production, un nettoyage progressif par groupes est plus adapté ; si les invites sont très peu nombreuses ou que le métier est en pleine refonte, une réécriture reste envisageable, mais il faut la valider via le jeu de régression.
Q3 : Quand est-ce le bon moment pour nettoyer les invites et le code de patch ?
Le meilleur moment, c’est la période d’évaluation du changement de modèle, puisqu’on fait de toute façon tourner la régression à ce moment-là. Autre cas de figure : lorsque le taux de déclenchement des patches reste proche de zéro sur la durée, ou que les invites sont devenues si nombreuses que plus personne n’ose y toucher — là, il faut prévoir un nettoyage dédié. En revanche, évitez de le faire juste avant une grosse promotion ou un pic d’activité.
Q4 : Quelles invites et quels patches ne doivent jamais être supprimés lors d’une montée de version ?
Le contrôle des autorisations, le filtrage des informations sensibles, la validation du schéma de sortie, la protection contre l’injection d’invites et les journaux d’audit doivent toujours rester. Ce sont eux qui encadrent le risque système, et on ne peut pas compter sur un « le modèle se comportera probablement bien ». La logique de retry en cas d’erreur réseau ou de limitation de débit relève aussi de l’infrastructure et ne doit pas entrer dans le périmètre du nettoyage.
Q5 : Comment comparer rapidement l’ancien et le nouveau modèle via l’API ?
Une fois le jeu de régression prêt, faites tourner les deux groupes d’expérimentation avec exactement les mêmes invites et les mêmes paramètres, en ne changeant que le nom du modèle. Avec APIYI, on peut appeler plusieurs modèles via un format d’interface compatible OpenAI ou Anthropic, ce qui facilite le basculement au sein d’un même script de test. Pour la configuration détaillée, voir la documentation : https://docs.apiyi.com
Q6 : Comment savoir si le nettoyage fait réellement économiser de l’argent ?
Comptez séparément, avant et après le nettoyage, les tokens d’entrée, les tokens de sortie, les hits de cache et le nombre de retries, puis multipliez par le prix unitaire en vigueur. Pour les tarifs et la facturation du cache, consultez la page des prix d’APIYI : https://docs.apiyi.com/models . Comparez le coût par appel, mais aussi le coût par tâche réussie, qui reflète plus fidèlement la dépense métier réelle.
Q7 : Quelles sont les limites de ce processus de nettoyage ?
Le jeu de régression ne couvre que les problèmes déjà connus : réussir les tests ne garantit pas qu’aucune nouvelle situation n’apparaîtra en production, donc le déploiement progressif et la supervision restent indispensables. Le processus demande aussi de la main-d’œuvre ; pour un outil interne à faible fréquence ou à faible risque, inutile de le copier intégralement. Avec peu d’échantillons, les indicateurs peuvent fluctuer fortement, et il vaut mieux éviter d’en tirer des conclusions trop fines.
Points clés à retenir sur le nettoyage des invites et du code de patch après une mise à niveau de modèle
- Critère de décision : regardez si le contenu compense l’ancien modèle, ou s’il exprime des règles métier et du contrôle des risques.
- 4 catégories : compensation de modèle, règles métier, garde-fous de sécurité et adaptation d’interface — chacune appelle une action différente.
- La référence d’abord : au premier tour, changez uniquement le modèle, sans modifier en même temps les invites et le code de patch.
- Ablation progressive : ne retirez qu’un seul groupe de contenu à la fois, pour pouvoir localiser précisément une régression.
- Conserver les validations : la logique de réparation JSON peut être revue, mais la validation de schéma et les contrôles de permissions doivent rester en place.
- Vérifier la dégradation : avant de supprimer un patch, assurez-vous que l’ancien modèle du chemin de repli n’en dépend pas encore.
- Outil de comparaison : grâce à l’interface compatible d’APIYI, vous pouvez basculer de modèle avec le même script pour faire de la régression.
En résumé
Après une mise à niveau de modèle, faut-il supprimer les invites et le code de patch ? La réponse ne dépend pas de la communication du nouveau modèle, mais de vos données de régression. On peut résumer le nettoyage en trois points :
- Identifier l’origine d’abord : expliquez ce que résout chaque segment de contenu, puis classez-le selon les 4 catégories.
- Décider par l’expérience : établissez une référence, faites des ablations par groupes et utilisez des indicateurs définis à l’avance pour décider de ce que vous gardez.
- Rendre les changements réversibles : déployez progressivement via des interrupteurs, et gérez séparément le contenu lié au modèle et les règles métier.
Je vous conseille de commencer par un scénario à volume d’appels modéré et à risque maîtrisé, de valider tout le processus de bout en bout, puis de l’étendre au cœur de l’activité. Si vous devez comparer plusieurs modèles, vous pouvez appeler les modèles présentés dans cet article via APIYI ; les modalités d’accès sont sur https://docs.apiyi.com et les tarifs à jour sur la page de prix https://docs.apiyi.com/models.
📚 Références
- 36氪 – Une diplômée en informatique de Princeton quitte soudainement Anthropic, après avoir fait décoller Claude Code : source du contexte d’actualité en ouverture de cet article
- Lien :
36kr.com/p/4055331476526214 -
Note : publié le 4 novembre 2026. La méthode de nettoyage présentée ici est une synthèse de bonnes pratiques d’ingénierie générales, et non une reprise du contenu de cet article.
-
Documentation APIYI : description du format d’interface et de la configuration d’accès
- Lien :
docs.apiyi.com -
Note : utilisée pour vérifier
base_url, le chemin de l’interface et le mode d’appel. -
Page modèles et tarifs APIYI : liste des modèles et informations de facturation
- Lien :
docs.apiyi.com/models -
Note : les prix des modèles, les règles de facturation et les prix du cache mentionnés dans cet article se basent sur les données réelles de cette page.
-
Documentation officielle Anthropic : guide des modèles Claude et des invites
- Lien :
docs.anthropic.com -
Note : lors de la mise à niveau vers un modèle Claude, consultez les changements d’interface et les recommandations d’invites.
-
Documentation officielle OpenAI : guide des modèles GPT et de l’API
- Lien :
platform.openai.com/docs - Note : lors de la mise à niveau vers un modèle GPT, consultez les changements de paramètres et les notes de migration.
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter via la page d’accueil du site APIYI ; davantage de ressources sont disponibles sur le centre de documentation docs.apiyi.com