Note de l’auteur : en prenant Qwen3.5-4B-GLB-3D-Coder comme exemple, nous décomposons le flux de travail de la couche intermédiaire de code « texte → Three.js → GLB », avec des étapes opérationnelles concrètes.
Faire produire directement par un grand modèle de langage des fichiers 3D utilisables, c’est un défi que de nombreux développeurs indépendants et petites équipes de jeux ont déjà rencontré. Un modèle affiné par la communauté de 4B paramètres propose une autre approche : faire écrire au modèle du code Three.js, puis exporter le GLB depuis le navigateur, en séparant la génération et l’export en deux étapes.
Ce n’est pas un énième tour d’horizon des outils text-to-3D. Les assets exportés par Qwen3.5-4B-GLB-3D-Coder peuvent déjà être importés dans l’éditeur Godot, et le développeur de la communauté Naoki Kishida a même utilisé les assets générés pour créer une démo de RPG 3D jouable. Cet article se concentre sur les méthodes d’ingénierie réutilisables derrière cette chaîne.
L’essentiel : après avoir lu cet article, vous comprendrez pourquoi la couche intermédiaire de code est efficace, et vous apprendrez à exécuter de bout en bout, en local ou dans le cloud, le flux complet de l’invite jusqu’à l’asset Godot.
Points clés de la couche intermédiaire de code Three.js
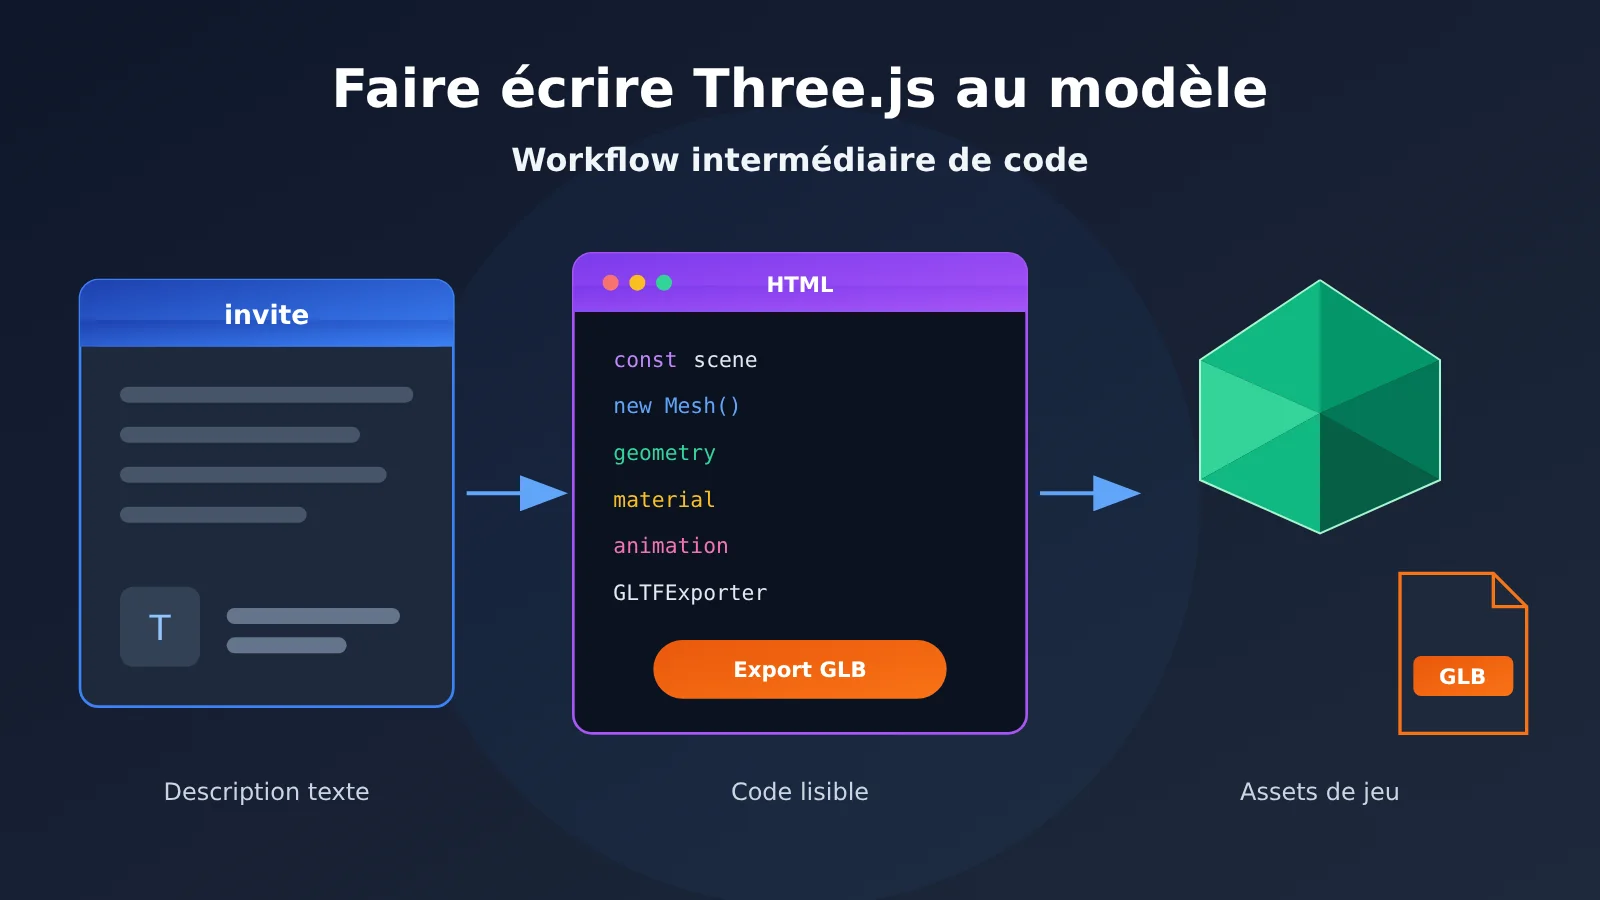
On appelle « couche intermédiaire de code » le principe suivant : le modèle ne produit pas directement le fichier binaire final, mais un programme exécutable qui, ensuite, génère le résultat. Dans ce cas de figure, le modèle produit un fichier HTML autonome contenant une scène Three.js et un bouton « Export GLB ».
| Point clé | Description | Intérêt pour les développeurs |
|---|---|---|
| Sortie du modèle | Un seul fichier HTML, avec la scène Three.js et le bouton d’export | Lisible et modifiable directement, pas un fichier boîte noire |
| Produit final | Un GLB téléchargé après un clic sur le bouton dans le navigateur | Importable dans Godot et tout autre outil compatible GLB |
| Périmètre d’entraînement | Couvre 25 domaines d’assets de jeu : personnages, armes, véhicules, bâtiments modulaires, etc. | Un seul outil couvre la plupart des besoins de placeholders en phase de prototypage |
| Mode d’exécution | Deux versions quantifiées GGUF : Q4_K_M et Q8_0 | Exécution locale via LM Studio ou équivalent |
| Positionnement qualité | Assets low-poly, pas destinés à la production réaliste ou de niveau cinéma | Adapté aux prototypes, aux placeholders et aux projets stylisés |
Précision importante : Qwen3.5-4B-GLB-3D-Coder est une preview indépendante affinée par le développeur CCORE à partir de Qwen/Qwen3.5-4B, et non une publication officielle de Qwen. D’après la fiche du modèle, la plupart des générations sont utilisables du premier coup, surtout avec des invites en anglais, mais certains assets demandent encore une nouvelle tentative ou une retouche manuelle du code.
Le fonctionnement de la couche intermédiaire de code Three.js
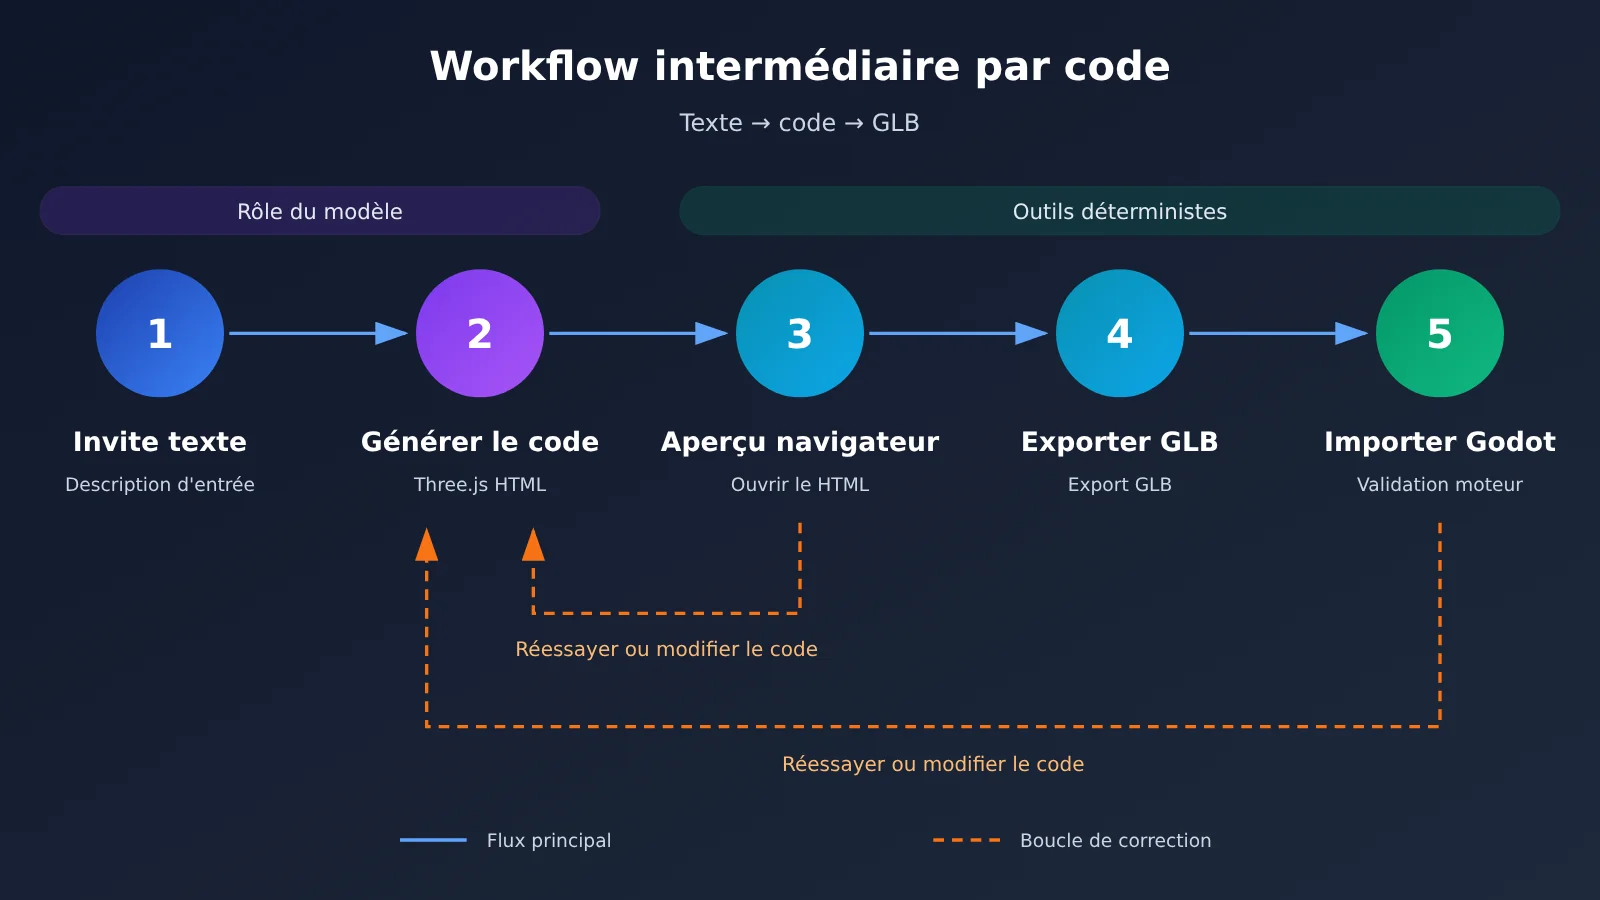
La chaîne complète se résume en six étapes : saisir une description, générer le HTML, enregistrer le fichier, prévisualiser dans le navigateur, exporter le GLB, importer dans le moteur. Les deux premières étapes sont confiées au modèle ; l’export est réalisé par le code qui tourne dans le navigateur, si bien que le modèle n’a jamais à écrire lui-même le contenu binaire d’un GLB.
Si l’asset doit bouger, par exemple une porte qui s’ouvre, l’invite système demande au modèle d’ajouter une animation et de l’inclure dans le GLB exporté. Sans demande explicite, le modèle génère par défaut un asset statique. Il faut donc bien préciser le besoin d’animation dans l’invite.
Cinq enseignements de workflow apportés par la couche intermédiaire de code Three.js
La comparaison ci-dessous est un jugement d’ingénierie que nous tirons de ce cas précis : ce n’est pas un résultat de benchmark. Les différentes approches de génération 3D ont chacune leur domaine de validité ; ici, nous comparons uniquement les différences structurelles entre deux façons de faire.
| Axe de comparaison | Génération directe d’un fichier 3D | Couche intermédiaire de code Three.js |
|---|---|---|
| Sortie du modèle | Maillage ou asset binaire | Code texte lisible |
| Traitement en cas d’erreur | Nécessite en général une régénération, ou un passage par un outil de modélisation pour corriger | Permet de modifier localement la géométrie, les matériaux et l’animation |
| Aperçu avant export | Dépend d’une visionneuse dédiée | Il suffit d’ouvrir le HTML dans un navigateur |
| Prise en charge de l’animation | Dépend du modèle et du pipeline utilisés | Peut être décrite par le code et exportée avec le GLB |
| Points forts | Variable selon l’approche | Assets low-poly à la structure claire |
| Limites principales | Le résultat est difficile à éditer finement | Les assets très détaillés ou photoréalistes sortent du périmètre prévu |
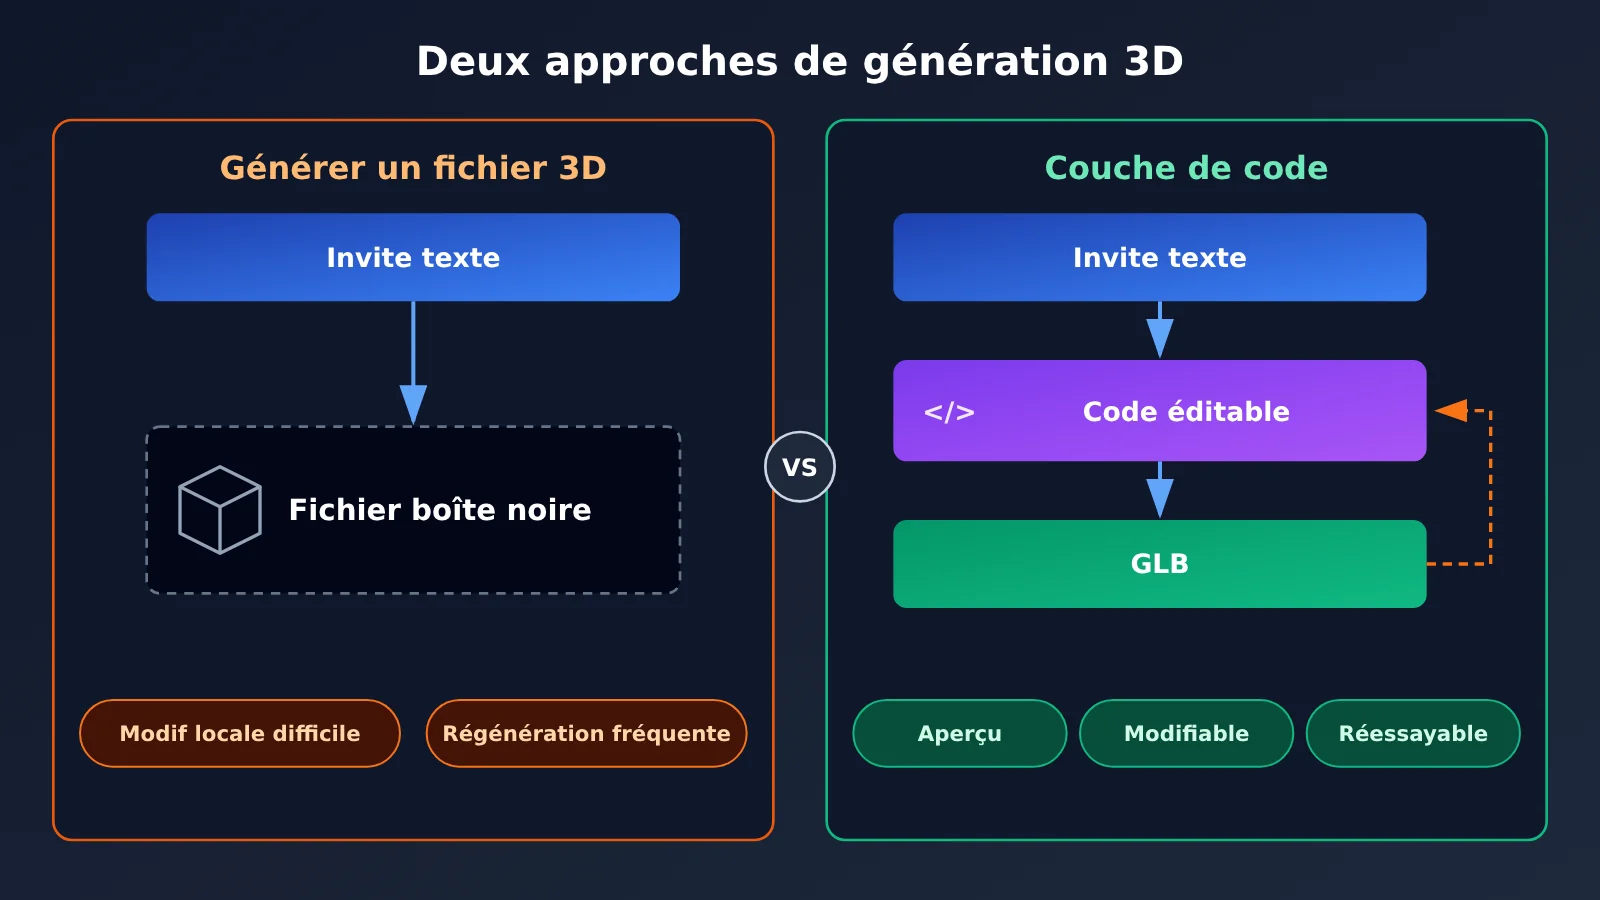
Enseignement n°1 : choisir la couche de représentation dans laquelle le modèle excelle. La force d’un modèle de code, c’est de produire du texte structuré, et Three.js transforme justement un asset 3D en problème de programmation. Ce modèle ne compte que 4B de paramètres et parvient pourtant à assumer une tâche de génération d’assets : la clé, c’est que la tâche a été reformulée sous une forme qu’il sait traiter.
Enseignement n°2 : rendre le produit intermédiaire inspectable. Le fichier HTML est à la fois le résultat de la génération et le point d’entrée du débogage. Quand un matériau est mal placé ou qu’une boucle d’animation part de travers, on peut souvent corriger à la main au lieu de tout régénérer, ce qui réduit fortement le coût d’un échec isolé.
Enseignement n°3 : confier la dernière étape à un outil déterministe. Les détails d’un format de fichier n’ont pas à être la responsabilité octet par octet d’un modèle probabiliste. L’écosystème Three.js dispose déjà de capacités d’export comme GLTFExporter ; le modèle n’a plus qu’à écrire la logique qui l’appelle. De façon générale, plus on délègue d’étapes à des outils matures, plus l’incertitude liée au format diminue.
Enseignement n°4 : une tâche étroite avec des conventions fixes est plus utile qu’une capacité généraliste. L’invite système de ce modèle est figée, et le format de sortie est strictement limité à un seul fichier HTML. En parallèle, les données d’entraînement couvrant 25 domaines garantissent la variété des types d’assets. Quand le périmètre de la tâche est clair, un petit modèle a vraiment la place de s’exprimer.
Enseignement n°5 : valider à la destination réelle. Un rendu joli dans le navigateur ne signifie pas que l’asset est exploitable ; la fiche du modèle montre aussi le résultat après import dans l’éditeur Godot. Le prochain objectif de l’auteur va dans ce sens : obtenir une génération fiable du premier coup, et automatiser au sein d’un framework d’Agent la génération, les tests et l’optimisation.
Cette approche ne se limite pas aux assets de jeu. Un script OpenSCAD peut générer un modèle CAO, du Python Blender peut piloter un pipeline de modélisation, SVG et Mermaid peuvent décrire des formes et des graphiques. Dès qu’un format cible est difficile à produire directement, il suffit de se poser une question : existe-t-il une couche de code capable de le générer de manière fiable ?
Conseil technique : si vous voulez comparer le rendu de différents modèles sur du code Three.js, vous pouvez appeler plusieurs modèles avec le même jeu d’invites via APIYI apiyi.com, puis les évaluer de façon uniforme avec la liste de vérification présentée plus bas.
Prise en main rapide de la couche intermédiaire de code Three.js : déploiement local
Prenons l’exemple de LM Studio : aucune ligne de code supplémentaire n’est nécessaire. LM Studio peut charger directement les modèles GGUF. Vous pouvez rechercher Qwen3.5-4B-GLB-3D-Coder dans le navigateur de modèles, ou télécharger les fichiers depuis Hugging Face puis les charger en local.
Première étape : choisir la version quantifiée GGUF
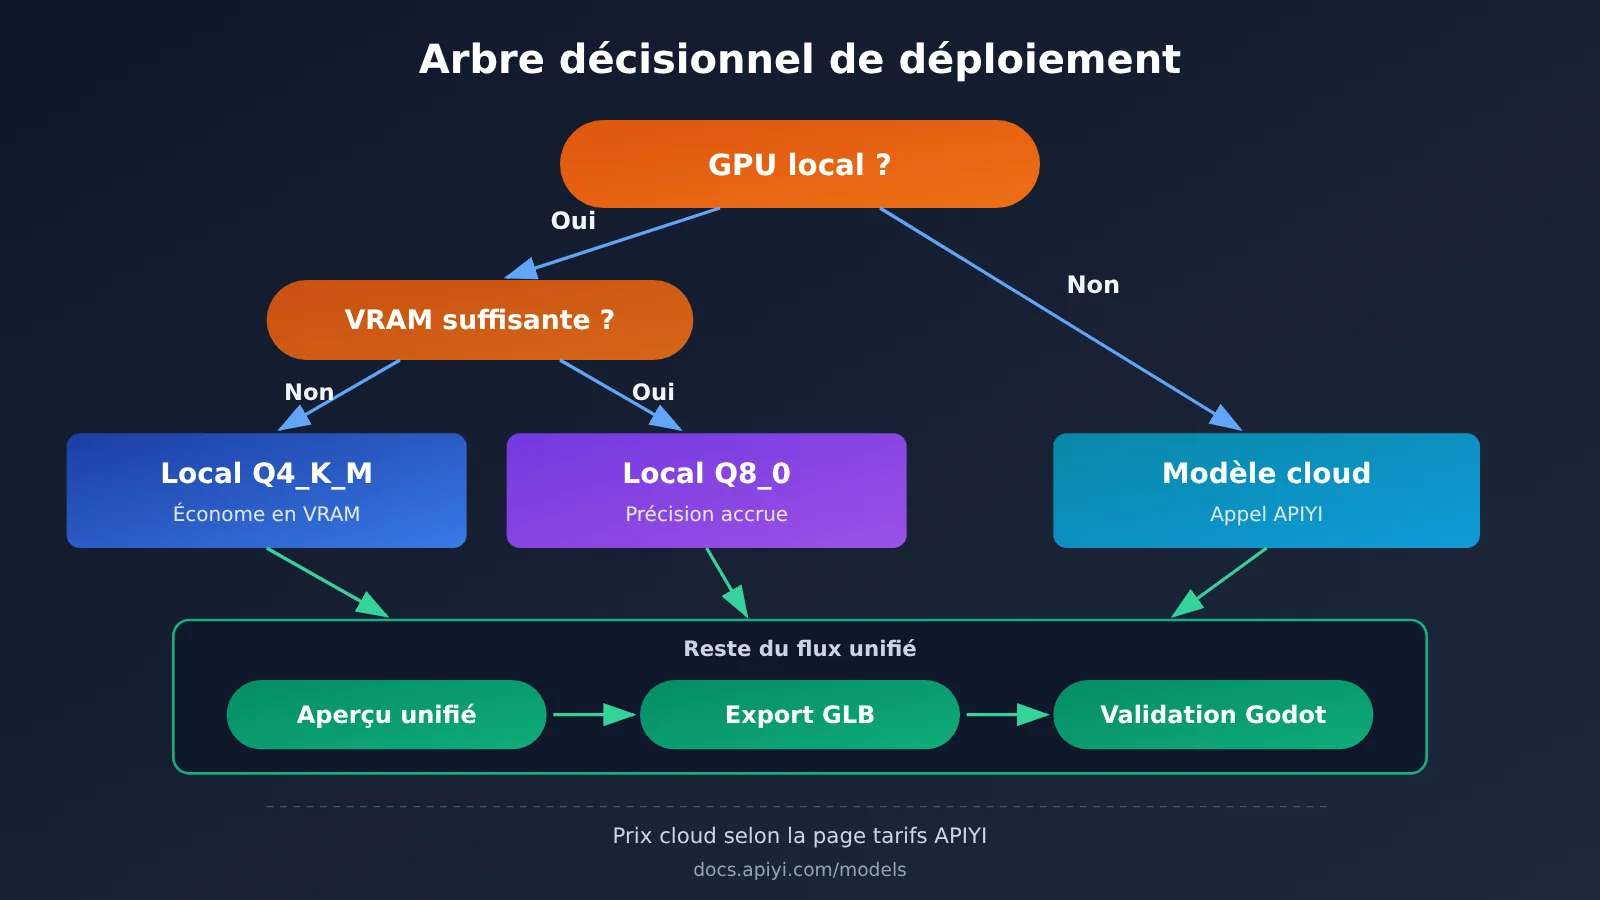
La fiche du modèle ne précise pas les besoins exacts en VRAM. Il faut donc tester sur votre propre matériel. L’inférence sur CPU reste possible, mais sera nettement plus lente.
| Version | Caractéristiques | Cas d’usage recommandés |
|---|---|---|
| Q4_K_M | Fichier plus petit, empreinte mémoire plus faible, inférence plus rapide, avec une légère perte de qualité | GPU de portable, machines aux ressources limitées, itérations rapides |
| Q8_0 | Fichier plus volumineux, plus proche de la précision complète | VRAM confortable, pour augmenter le taux de réussite dès le premier essai sur des actifs complexes |
Attention aux mises à jour de version : les poids des deux versions quantifiées ont été remplacés le 2 novembre 2026. L’auteur annonce une nette amélioration de la qualité visuelle, mais les noms de fichiers n’ont pas changé. Si vous les avez téléchargées avant cette date, mieux vaut les supprimer et les télécharger à nouveau ; sinon, vous risquez d’utiliser encore l’ancienne version.
Deuxième étape : configurer l’invite système et les paramètres d’échantillonnage
Ce modèle a été affiné autour d’un format d’instruction spécifique. Il est donc conseillé d’utiliser tel quel l’invite système fournie dans la fiche du modèle, sans la réécrire :
Create game assets for the Godot editor, which uses GLB files. Create whatever the user requests as a good-quality low-poly asset using only Three.js in one complete standalone HTML file. The HTML must show the asset and include an Export GLB button that downloads a working GLB. If the requested asset needs animation, add it and include the animation in the exported GLB; otherwise make it static.
Collez-la dans le champ de message système de LM Studio, puis réglez les paramètres d’échantillonnage recommandés par l’auteur. Ces valeurs sont le point de départ utilisé lors de ses tests, pas une obligation : vous pourrez les ajuster une fois que tout fonctionne.
| Paramètre | Valeur recommandée | Emplacement de configuration |
|---|---|---|
temperature |
0.8 | Paramètres de génération de LM Studio |
top_k |
40 | Paramètres de génération de LM Studio |
top_p |
0.95 | Paramètres de génération de LM Studio |
min_p |
0.0 | Paramètres de génération de LM Studio |
Troisième étape : générer et exporter le GLB
L’invite utilisateur doit être courte, précise et si possible en anglais. Vous pouvez commencer par Create a blue goblin brute ou Build a jungle siege platform ; si vous voulez une animation, écrivez par exemple Create a wooden gate with an opening animation. Ensuite, procédez dans cet ordre :
- Envoyez l’invite et attendez que le modèle produise le HTML complet.
- Enregistrez la sortie dans un fichier
.html. - Ouvrez le fichier dans un navigateur pour vérifier que l’asset s’affiche correctement.
- Cliquez sur le bouton « Export GLB » pour télécharger le fichier
.glb. - Importez le GLB dans Godot, ou dans tout autre outil compatible avec ce format.
Si la page reste blanche, commencez par ouvrir les outils de développement du navigateur pour consulter les erreurs de la console. Certains scripts peuvent être bloqués par les restrictions appliquées aux fichiers locaux lorsqu’on ouvre le fichier par un simple double-clic. Dans ce cas, lancez python -m http.server dans le répertoire du fichier, puis accédez-y via l’adresse locale.
Étape 4 : valider les assets selon la checklist
Ne vous contentez pas de regarder l’aperçu dans le navigateur. Pour chaque asset, je vous conseille de vérifier les points suivants :
- Structure : les pièces sont-elles complètes, sans décalage ni chevauchement visible ?
- Matériaux : les couleurs et les matériaux restent-ils identiques à l’aperçu une fois importés dans le moteur ?
- Animation : l’animation est-elle réellement enregistrée dans le GLB et lisible dans le moteur ?
- Dimensions et origine : l’échelle et le pivot correspondent-ils aux besoins de la scène ? Cette partie demande souvent un ajustement manuel.
- Corrigibilité : pour les petits problèmes, privilégiez une correction du code ; pour les problèmes structurels, régénérez l’asset.
Solution d’intégration cloud pour la couche intermédiaire de code Three.js
L’un des avantages de la couche intermédiaire de code, c’est qu’elle n’est liée à aucun modèle en particulier. Tant qu’un modèle sait écrire du Three.js exécutable, il peut s’intégrer au même flux. D’après les informations publiques, Qwen3.5-4B-GLB-3D-Coder est actuellement distribué au format GGUF, principalement pour l’inférence locale ; si votre machine a du mal à l’exécuter, ou si vous voulez comparer avec un modèle de codage généraliste, vous pouvez passer par une API cloud.
APIYI propose des appels API pour plusieurs modèles, compatibles avec les formats d’API OpenAI et Anthropic ; les clients existants n’ont généralement qu’à ajuster l’adresse de l’API, la clé API et le nom du modèle. Attention : pour savoir si le modèle affiné ci-dessus est disponible via le cloud, fiez-vous à ce qui apparaît réellement dans la liste des modèles. Pour la configuration détaillée, consultez la documentation APIYI : docs.apiyi.com.
| Option | Caractéristiques clés | Cas d’usage | Base de facturation | Plateformes disponibles |
|---|---|---|---|---|
| Modèle local affiné | Affiné pour les assets GLB, utilisable hors ligne après téléchargement | Génération en lot d’assets de remplacement, besoin d’exécution hors ligne | Pas de frais par appel, matériel à fournir | Outils d’exécution GGUF comme LM Studio |
| Modèle de codage cloud généraliste | Aucune puissance de calcul locale requise, facile à changer et à comparer | Matériel limité, besoin d’essayer des invites complexes | Selon la page tarifs d’APIYI | APIYI apiyi.com et canaux officiels de chaque modèle |
| Hybride local et cloud | Le local traite le volume, les assets difficiles passent par le cloud | Équipes qui veulent concilier coût et taux de réussite | Partie cloud selon la page tarifs d’APIYI | Outils locaux associés à une plateforme API |
Étapes pour appeler un modèle de génération Three.js via une API
- Créez une clé API dans la console APIYI et vérifiez l’adresse d’API actuelle dans la documentation, sans recopier celle d’un tutoriel tiers.
- Selon votre client existant, choisissez le format d’API OpenAI ou Anthropic, puis renseignez
base_urlet la clé API. - Choisissez le modèle à tester dans la liste des modèles et saisissez son nom dans le champ
model. - Placez l’invite système présentée plus haut dans le message system. Comme le modèle généraliste n’a pas été affiné pour cette tâche, vous pouvez ajouter des contraintes du type « ne produire qu’un HTML complet ».
- Enregistrez la réponse dans un fichier
.html; les étapes de prévisualisation, d’export et de validation qui suivent sont identiques à celles de la solution locale.
Le service local de LM Studio expose lui aussi une API compatible OpenAI. Vous pouvez donc basculer entre local et cloud avec le même client, en changeant seulement l’adresse de l’API et le nom du modèle. Ainsi, les étapes de prévisualisation, d’export et de validation en aval de la couche intermédiaire de code n’ont pas à être modifiées.
Note sur la facturation : le prix unitaire des modèles, la base de facturation des entrées/sorties et le prix du cache peuvent évoluer. Cet article ne donne pas de chiffres précis : référez-vous toujours aux données réelles de la page tarifs d’APIYI : https://docs.apiyi.com/models.
FAQ — Questions fréquentes
Q1 : Qu’est-ce que le workflow avec une couche intermédiaire de code Three.js ?
Il s’agit de demander au modèle d’écrire d’abord un programme Three.js, puis de laisser ce programme effectuer le rendu et exporter un GLB, plutôt que de laisser le modèle produire directement un fichier 3D. Cela permet de prévisualiser et de modifier le résultat avant l’export.
Q2 : Qwen3.5-4B-GLB-3D-Coder peut-il générer directement un GLB ?
Non. Il produit un fichier HTML autonome qu’il faut ouvrir dans un navigateur et dans lequel on clique sur le bouton « Export GLB » pour obtenir le fichier GLB.
Q3 : Le GLB exporté ne sert-il qu’à Godot ?
Non. L’invite système cible le workflow Godot, mais le GLB est un format universel qui peut aussi être importé dans Unity, Blender ou un visualiseur 3D web. Le rendu après import doit toutefois être vérifié séparément dans chaque outil.
Q4 : Quels sont les cas d’usage les plus adaptés à ce modèle ?
Il convient surtout aux prototypes de jeux en style low poly et aux assets provisoires : PNJ, armes, véhicules, bâtiments modulaires, pièges. Pour des assets définitifs très personnalisés, il faut s’attendre à des retouches manuelles après l’import.
Q5 : Sans carte graphique adaptée, comment tester ce workflow via une API ?
On peut appeler un modèle de code de la liste via APIYI apiyi.com, puis configurer une interface au format OpenAI ou Anthropic conformément à la documentation. Une fois le HTML généré par le modèle, la prévisualisation et l’export se font entièrement dans le navigateur local.
Q6 : Comment sont calculés les coûts d’appel dans le cloud ?
Le prix unitaire et la base de facturation varient d’un modèle à l’autre ; consultez directement la page tarifaire d’APIYI : https://docs.apiyi.com/models. Il est conseillé de faire d’abord un essai avec quelques invites, puis d’estimer le coût à partir de l’usage réel.
Q7 : Le fichier de projection visuelle est-il obligatoire ?
Non. Le fichier de projection visuelle BF16 optionnel pèse environ 644 MiB ; il sert à fournir une image de référence dans un environnement d’exécution prenant en charge le GGUF multimodal de Qwen3.5. Si vous n’utilisez que des invites textuelles, vous pouvez ne pas le télécharger.
Q8 : Quelles sont les limites actuelles de cette approche ?
Il s’agit pour l’instant d’une version preview : le jeu d’entraînement privilégie les invites simples, la capacité de généralisation sur des demandes complexes ou rares est limitée, et le modèle ne vise pas les assets photoréalistes. L’auteur prévoit de publier le jeu de données et les poids Safetensors, et d’entraîner une version plus grande d’environ 100 000 échantillons avec une fenêtre de contexte de 8K à 128K tokens, mais ces éléments ne sont pas encore disponibles.
Points clés : la couche intermédiaire de code Three.js
- Idée centrale : laisser le modèle écrire du Three.js exécutable, puis laisser le programme exporter le GLB.
- Avantage clé : le produit intermédiaire peut être prévisualisé, lu et modifié par endroits, ce qui réduit le coût d’un échec.
- Pour démarrer en local : chargez un GGUF dans LM Studio, avec une invite système figée et les paramètres d’échantillonnage recommandés.
- Rappel de version : si vous avez téléchargé les poids avant le 2 novembre, mieux vaut les supprimer et les retélécharger.
- Limites d’usage : adapté aux prototypes low-poly et aux assets de remplacement, pas à la production photoréaliste ou de niveau cinéma.
- Voie cloud : on peut passer par APIYI pour accéder aux modèles au format OpenAI ou Anthropic et comparer les résultats.
- Extensions de la méthode : ce design de couche intermédiaire peut aussi s’appliquer à Blender Python, OpenSCAD et d’autres contextes.
En résumé
Ce que Qwen3.5-4B-GLB-3D-Coder nous apprend, ce n’est pas seulement qu’un petit modèle peut générer des assets de jeu : c’est qu’il redessine la répartition des rôles entre le modèle et les outils :
- Le modèle exprime : il transforme une description en langage naturel en code Three.js bien structuré.
- L’outil matérialise : le navigateur et la logique d’export produisent un fichier GLB standard.
- La validation décide de l’utilité : ce n’est qu’une fois importé dans le moteur cible et passé les vérifications que le travail est réellement terminé.
Je vous conseille de commencer par un objet statique simple pour valider toute la chaîne, puis de tester progressivement les animations et des assets plus complexes. Si vous voulez comparer plusieurs modèles cloud, vous pouvez les appeler de façon unifiée via APIYI — les modalités d’accès sont sur docs.apiyi.com, et les tarifs à jour sont ceux indiqués sur https://docs.apiyi.com/models.
📚 Références
- Présentation du modèle Qwen3.5-4B-GLB-3D-Coder : positionnement du modèle, 25 domaines d’actifs et feuille de route
- Lien :
mindstudio.ai/blog/qwen3-5-4b-glb-3d-coder-model -
Description : idéal pour comprendre le projet dans son ensemble et découvrir les retours de la communauté
-
Guide d’exécution locale de Qwen3.5-4B-GLB-3D-Coder : mécanisme de génération, versions quantifiées et analyse d’adéquation
- Lien :
mindstudio.ai/blog/qwen3-5-4b-glb-3d-coder-local -
Description : utile pour vérifier si le modèle correspond aux besoins de votre projet
-
Guide de configuration de LM Studio : invite système, paramètres d’échantillonnage et étapes d’export GLB
- Lien :
mindstudio.ai/blog/run-qwen3-5-glb-3d-coder-locally -
Description : à suivre pas à pas pour réaliser un déploiement local
-
Documentation et page tarifaire APIYI : instructions d’intégration de l’API et données tarifaires des modèles
- Liens :
docs.apiyi.cometdocs.apiyi.com/models - Description : la configuration de l’interface et les informations de facturation suivent toujours le contenu le plus récent publié à ces adresses
Auteur : équipe technique APIYI
Échanges techniques : si vous rencontrez le moindre problème lors de l’intégration, n’hésitez pas à nous contacter via le site officiel APIYI apiyi.com. Vous trouverez par ailleurs davantage de ressources dans le centre de documentation docs.apiyi.com