Note de l’auteur : Google AI Studio a annoncé le retrait de Gemini 2.5 Pro et 2.5 Flash. À partir du 1er décembre, les requêtes API adressées à ces modèles seront automatiquement redirigées vers d’autres modèles. Cet article présente un plan d’action en 6 étapes pour que les applications en production terminent leur migration avant l’échéance.
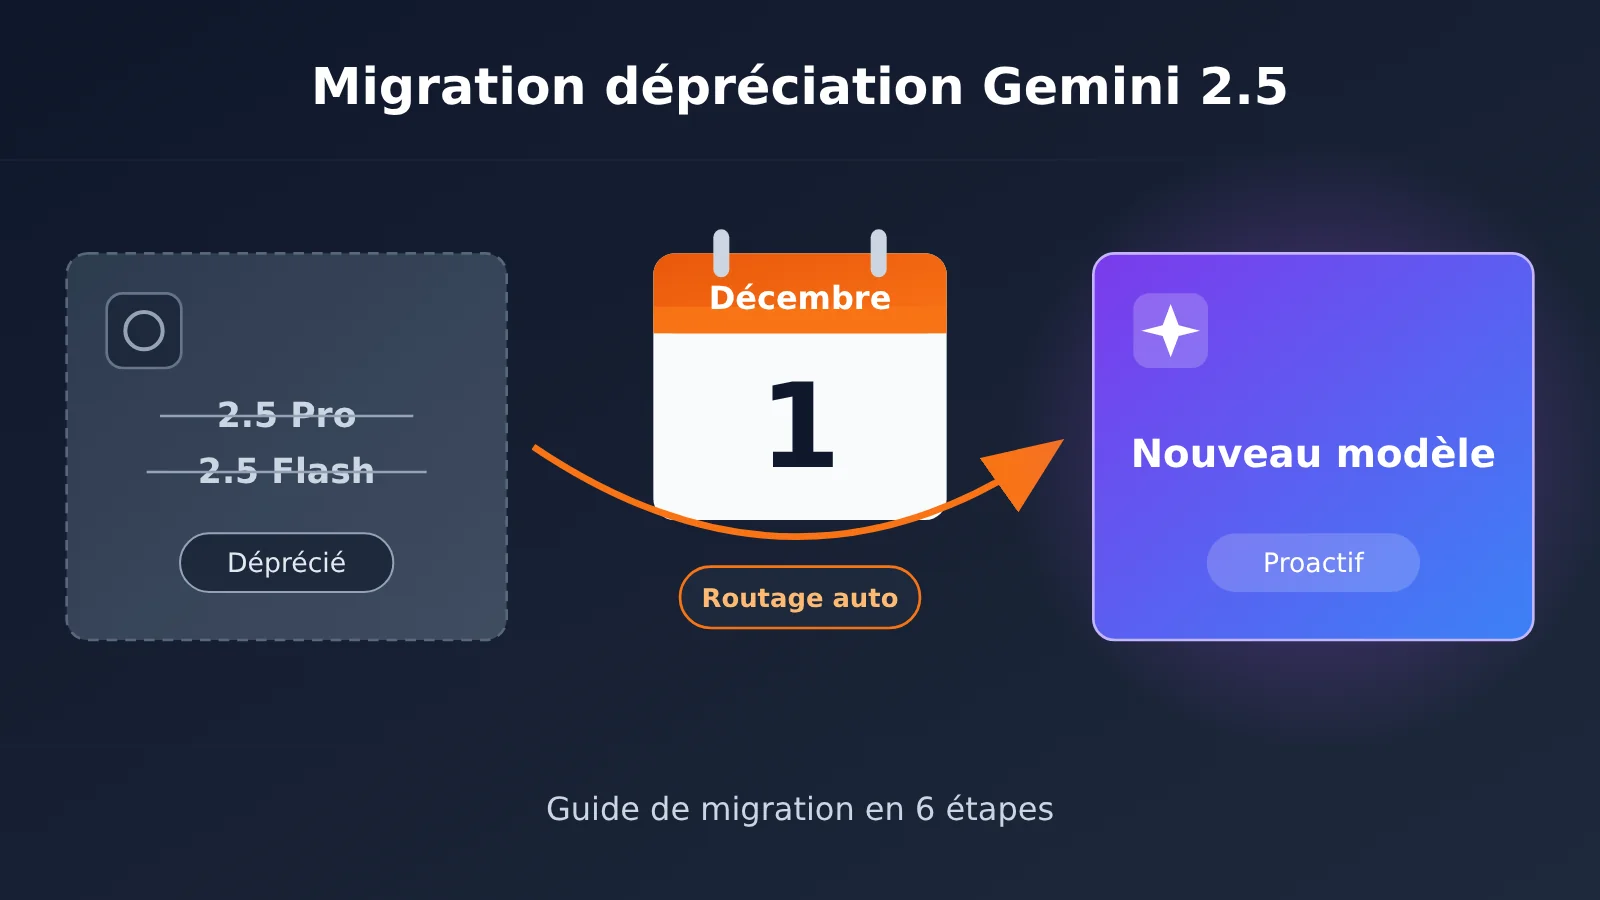
Si votre service en production appelle encore Gemini 2.5 Pro ou Gemini 2.5 Flash, il vous reste moins d’un mois avant le routage automatique du 1er décembre. D’après l’avis de retrait publié par Google AI Studio, ces deux modèles entrent dans le cycle de dépréciation : passé cette date, les requêtes API envoyées aux anciens ID de modèle seront automatiquement transférées vers les modèles de remplacement désignés par Google.
Ce n’est pas une bonne nouvelle du type « vous n’avez rien à faire ». Le routage automatique évite les erreurs franches, mais le comportement du modèle, le style de sortie, la latence et les règles de facturation peuvent tous changer. Pour une application en production qui dépend d’un format de sortie fixe, c’est ni plus ni moins une « mise à jour silencieuse » qui n’a jamais été testée.
L’essentiel : à la fin de cet article, vous disposerez d’un processus de migration en 6 étapes pour remplacer Gemini 2.5 Pro/Flash, exécuter les tests de non-régression et déployer progressivement avant le 1er décembre, en réduisant au minimum l’incertitude liée au routage automatique.
Gemini 2.5 Pro/Flash : dépréciation et routage automatique, l’essentiel
Avant de se lancer dans la migration, commençons par clarifier les faits essentiels de cette dépréciation de Gemini 2.5 Pro/Flash. Le tableau ci-dessous ne reprend que les informations confirmées par les sources de référence, ainsi que les conséquences d’ingénierie que l’on peut en déduire.
| Point clé | Explication | Impact sur les applications en production |
|---|---|---|
| Modèles concernés | Gemini 2.5 Pro et Gemini 2.5 Flash dans Google AI Studio | Tous les services qui codent en dur ces deux ID de modèle sont concernés |
| Date clé | Entrée en vigueur le 1er décembre | La fenêtre pour les tests et le déploiement progressif est réduite : il faut planifier en rétro-planning |
| Traitement | Les requêtes API sont automatiquement routées vers le modèle successeur désigné par Google | L’interface ne renverra pas d’erreur immédiatement, mais le modèle réellement exécuté change |
| Risque principal | Le « changement silencieux » du style de sortie, du format, de la latence et du coût | Le parsing en aval, les métriques d’évaluation et le budget peuvent dériver |
| Stratégie recommandée | Basculer explicitement avant la date limite et terminer les tests de non-régression | Transformer le « changement de modèle subi » en « mise à niveau maîtrisée » |
Pourquoi le routage automatique de Gemini 2.5 ne permet pas de « rester les bras croisés »
Beaucoup d’équipes voient le mot « routage automatique » et respirent immédiatement : puisque les requêtes ne vont pas échouer, autant laisser la transition se faire toute seule le 1er décembre. Le problème, c’est que la stabilité d’une application basée sur un grand modèle de langage ne dépend jamais uniquement du fait que l’interface renvoie un code 200. Vos invites ont été ajustées pour le comportement de Gemini 2.5 Pro ou Flash ; avec un autre modèle, les mêmes invites peuvent produire un contenu plus long ou plus court, et l’ordre comme le format des champs JSON peuvent aussi changer subtilement.
Le risque le plus sournois concerne l’observabilité. Après le routage automatique, vos journaux continuent d’afficher l’ancien ID de modèle, alors que c’est déjà un autre modèle qui traite réellement les requêtes. En cas de plainte sur la qualité, l’enquête peut facilement être faussée par les journaux, ce qui fait perdre un temps considérable en diagnostic. L’intérêt d’une migration proactive, c’est précisément de maintenir la cohérence entre « le modèle écrit dans les journaux » et « le modèle réellement exécuté ».
Comment identifier les modèles cibles concrets du routage automatique
Les sources de référence confirment bien le mécanisme de « routage automatique », mais pour savoir vers quel modèle précis le routage se fait, si le canal Vertex AI est aussi concerné, ou si les anciens ID de modèle bénéficient encore d’une période d’alias, mieux vaut se référer à l’annonce de dépréciation officielle de Google et au journal des mises à jour de l’API Gemini. Cet article ne fait aucune supposition sur ces détails : il propose une méthode de migration qui reste valable quel que soit le modèle cible.
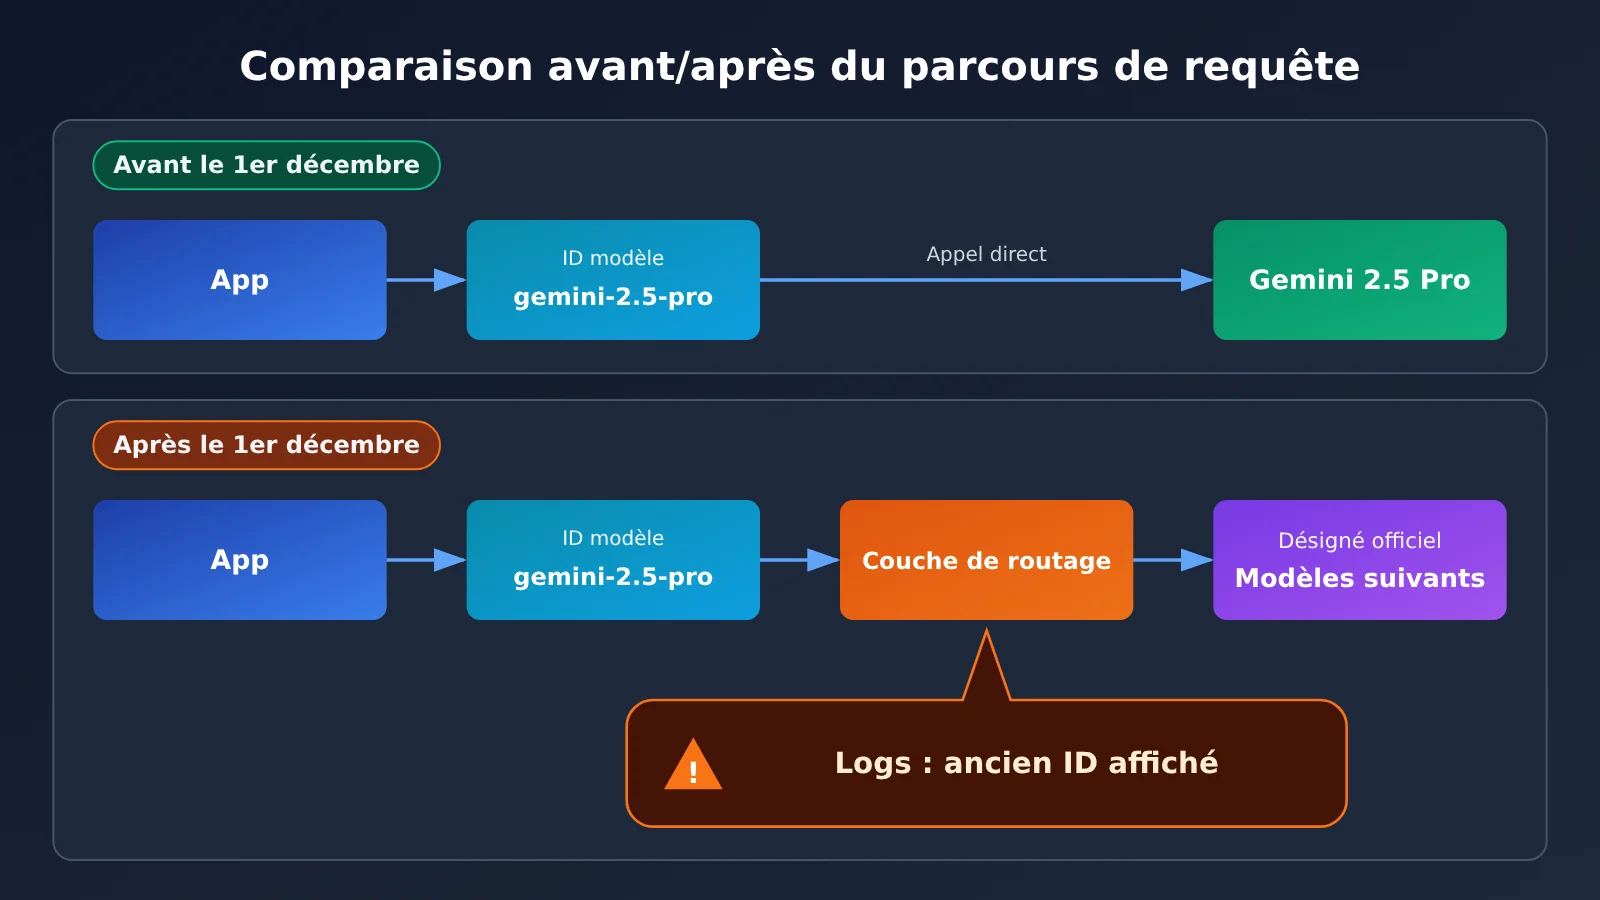
Évaluation de l’impact de la dépréciation de Gemini 2.5 Pro/Flash
Selon le type d’application, l’impact du routage automatique de Gemini 2.5 varie fortement. Une première étape de classification de l’impact permet de définir la priorité de migration et la profondeur des tests.
| Type d’application | Usage typique | Niveau d’impact du routage automatique | Priorité de migration |
|---|---|---|---|
| Sortie structurée / extraction d’informations | Exiger du modèle qu’il renvoie des champs JSON fixes | Élevé : un champ manquant ou un changement de format provoque directement un échec de l’analyse | Maximale |
| Agent / appel d’outils | Dépend du format des paramètres de l’appel de fonction et du moment de l’appel | Élevé : l’ordre des appels et les habitudes de génération des paramètres peuvent changer | Maximale |
| Analyse de documents longs | Utiliser la fenêtre de contexte longue pour le résumé et le questions-réponses | Moyen : la qualité peut varier, la latence et le coût doivent être réévalués | Élevée |
| Dialogue de service client / génération de contenu | Sortie en texte libre | Moyen-faible : les changements de style sont perceptibles mais rarement critiques | Moyenne |
| Outils internes / traitement par lots hors ligne | Non temps réel, réexécutable | Faible : on peut observer et ajuster après le routage | Faible |
Les trois types de dépendances les plus souvent oubliés lors d’une migration Gemini 2.5
Le premier type est la dépendance implicite au modèle. Certaines équipes n’écrivent pas directement l’ID du modèle dans le code métier, mais dans un centre de configuration, des variables d’environnement, la configuration des nœuds d’une plateforme low-code, voire dans les paramètres par défaut d’un SDK tiers. Ces emplacements sont faciles à manquer lors d’une recherche globale ; il faut établir une liste dédiée pour les auditer.
Le deuxième type est la dépendance sémantique aux paramètres. La série Gemini 2.5 prend en charge des configurations liées à la réflexion (thinking), comme le budget de réflexion. La manière dont les modèles suivants prennent en charge ces paramètres, leurs valeurs par défaut et leurs plages de valeurs peuvent différer : réutiliser directement les anciens paramètres peut entraîner leur ignorance, des erreurs ou des coûts anormaux.
Le troisième type est la dépendance à la base de référence d’évaluation. Si vos jeux d’évaluation hors ligne ou vos indicateurs d’expériences A/B s’appuient sur une base de référence produite avec Gemini 2.5 Pro ou Flash, il faut impérativement reconstruire cette base après le changement de modèle, sinon toutes les comparaisons d’indicateurs ultérieures seront faussées.
🎯 Conseil technique : avant la migration officielle, vous pouvez d’abord appeler en parallèle l’ancien modèle et les nouveaux modèles candidats sur le même lot d’échantillons de test via APIYI apiyi.com, afin de comparer rapidement les différences de sortie. APIYI est compatible avec les formats d’interface OpenAI et Anthropic ; pour changer de modèle candidat, il suffit généralement de modifier le nom du modèle. Les instructions d’intégration sont disponibles dans le centre de documentation docs.apiyi.com.
Migration rapide vers Gemini 2.5 Pro/Flash : un processus en 6 étapes
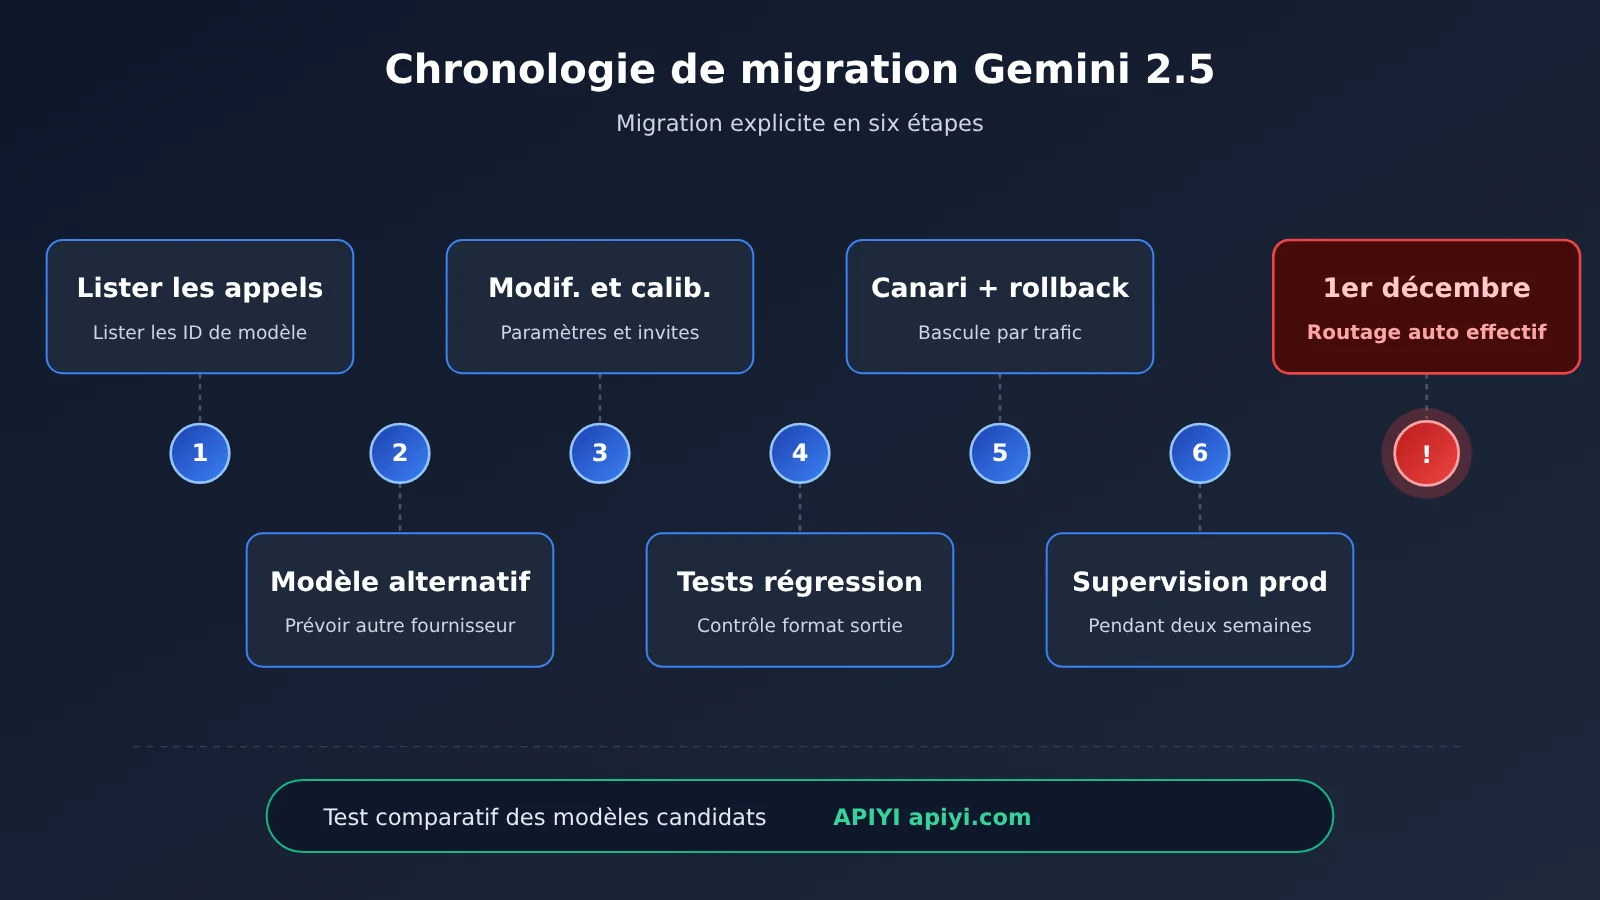
Les 6 étapes ci-dessous constituent le processus de migration standard que nous recommandons. Elles couvrent toute la chaîne, de l’inventaire initial à la supervision après mise en production. Ce processus ne dépend pas du modèle qui prendra le relais : vous pouvez l’appliquer tel quel.
Étape 1 : recenser tous les points d’appel aux modèles Gemini 2.5
Dans les dépôts de code, les centres de configuration, les scripts de déploiement et les workflows low-code, recherchez globalement les mots-clés gemini-2.5-pro et gemini-2.5-flash, en surveillant aussi les variantes d’ID avec suffixe de version ou marqueur de préversion. Consignez chaque point d’appel dans une liste : service concerné, responsable, volume d’appels et niveau d’impact défini dans la section précédente.
Si votre service appelle Gemini via une passerelle ou une plateforme d’agrégation, vérifiez également si la couche passerelle effectue un mappage d’alias de modèle. Il arrive que le code métier utilise un alias interne, tandis que le véritable ID du modèle Gemini 2.5 se cache dans la configuration de la passerelle.
Étape 2 : déterminer le modèle de remplacement de Gemini 2.5
En vous appuyant sur les cibles de routage automatique indiquées dans l’annonce officielle de Google, et en tenant compte de vos propres besoins métier, choisissez un modèle de remplacement pour chaque point d’appel. Le principe général est le suivant : pour les scénarios qui utilisaient Gemini 2.5 Pro pour le raisonnement complexe, les longs documents ou les tâches de code, évaluez en priorité un modèle Pro de nouvelle génération de même niveau ; pour ceux qui utilisaient Gemini 2.5 Flash pour gagner en vitesse et en coût, évaluez en priorité un modèle Flash de nouvelle génération.
Attention toutefois : les cibles de routage automatique officielles ne correspondent pas forcément à la solution optimale pour votre activité. Certaines équipes profitent de cette migration pour réévaluer leurs besoins et basculer une partie du trafic peu exigeant en qualité vers des modèles plus légers, afin d’optimiser les coûts.
💡 Conseil de choix : le choix du modèle de remplacement dépend surtout du scénario précis et des exigences de qualité. Je vous recommande de réaliser de petits tests comparatifs sur les modèles candidats via APIYI apiyi.com. La plateforme propose un appel unifié à plusieurs modèles majeurs, ce qui facilite la comparaison côte à côte avant de décider.
Étape 3 : modifier explicitement l’ID du modèle et recalibrer les paramètres
Ne vous contentez pas d’attendre le routage automatique : remplacez explicitement l’ancien ID de modèle par le nouveau dans le code et la configuration. L’avantage, c’est que les journaux, la supervision et la facturation afficheront bien le modèle réellement utilisé. En cas de problème, vous ne serez pas induit en erreur.
Lors de la modification de l’ID du modèle, vérifiez aussi les paramètres d’appel un par un. Le tableau ci-dessous récapitule les éléments de configuration à surveiller en priorité lors d’une migration :
| Élément de configuration | Points à vérifier lors de la migration | Bonne pratique recommandée |
|---|---|---|
| ID de modèle (model) | Reste-t-il des anciens ID ou alias oubliés ? | Centraliser dans la configuration pour éviter les valeurs codées en dur un peu partout |
| Configuration liée à la réflexion | La prise en charge du budget de réflexion et des autres paramètres, ainsi que les valeurs par défaut, peuvent changer avec le nouveau modèle | Consulter la documentation du nouveau modèle et reconfigurer, sans recopier tel quel |
| Longueur maximale de sortie | La limite de sortie et les valeurs par défaut peuvent différer selon le modèle | La définir explicitement pour éviter les sorties tronquées ou trop longues |
| Sortie structurée / JSON Schema | Le respect des contraintes de champs peut évoluer | Tester avec la tolérance aux erreurs et la validation de la couche d’analyse |
| Définition des outils / appels de fonctions | Le style de génération des paramètres et la fréquence d’appel peuvent changer | Valider en rejouant de vrais échantillons de conversation |
| Paramètres d’échantillonnage comme la température | Une même valeur produit des effets différents selon le modèle | Réajuster finement en se basant sur les résultats d’évaluation |
Étape 4 : effectuer des tests de régression sur des échantillons réels
Prélevez dans les journaux de production des requêtes réelles représentatives pour constituer un jeu de tests de régression. Les échantillons doivent couvrir les scénarios fréquents, les scénarios de longue traîne, ainsi que les cas limites qui ont déjà posé problème par le passé. Pour les applications à sortie structurée, incluez également les échantillons au format le plus complexe.
Faites tourner ce lot d’échantillons sur l’ancien et le nouveau modèle, puis comparez selon plusieurs axes : taux de conformité du format (le JSON est-il correctement analysé ?), exactitude des champs clés, longueur moyenne de sortie, latence du premier token et latence totale, nombre de tokens consommés par requête. Tant que le taux de conformité du format et les indicateurs clés ne baissent pas de manière significative, vous pouvez passer à la phase de déploiement progressif. En cas de baisse marquée, commencez par ajuster l’invite pour adapter le nouveau modèle.
Étape 5 : déploiement canari et plan de retour arrière
Ne basculez pas tout d’un coup. Je recommande un déploiement progressif par paliers de 5 %, 20 %, 50 %, puis 100 %, en observant au moins un cycle métier complet à chaque étape. Mieux vaut placer l’interrupteur du canari dans un centre de configuration, afin de pouvoir basculer dynamiquement l’ID du modèle selon la proportion de trafic ou par groupe d’utilisateurs.
Le plan de retour arrière mérite une précision importante : après le 1er décembre, les anciens ID de modèle seront automatiquement routés, ce qui signifie que la voie « revenir à Gemini 2.5 » ne sera plus réellement disponible. Votre cible de retour arrière doit donc être un autre modèle de secours déjà validé, et non l’ancien modèle. C’est aussi pourquoi je conseille de préparer à l’avance au moins une solution de secours chez un autre fournisseur.
🚀 Démarrage rapide : si vous avez besoin de mettre en place rapidement une chaîne de secours multi-modèles, vous pouvez passer par APIYI apiyi.com pour un accès unifié à plusieurs modèles. Comme la plateforme est compatible à la fois avec les formats d’interface OpenAI et Anthropic, le modèle de secours et le modèle principal peuvent réutiliser la même logique d’appel : en cas de retour arrière, il suffit de changer le nom du modèle.
Étape 6 : la surveillance continue après la mise en production
Une fois la migration terminée, surveillez de près pendant au moins deux semaines les indicateurs suivants : taux d’erreur et taux de timeout, taux d’échec d’analyse des sorties structurées, retours qualité côté utilisateurs (taux de pouces vers le bas, taux de réclamation), consommation de tokens et courbe des coûts. Le conseil : dans le tableau de bord de surveillance, découpez l’ID du modèle comme une dimension à part, histoire de comparer facilement l’avant et l’après bascule.
Il faut aussi être particulièrement vigilant le 1er décembre : si des requêtes portant encore l’ancien ID de modèle apparaissent à ce moment dans la surveillance, c’est qu’il y a eu un oubli lors de la phase d’inventaire. Ces requêtes passent par le routage automatique, il faut donc les localiser au plus vite et les migrer de façon explicite.
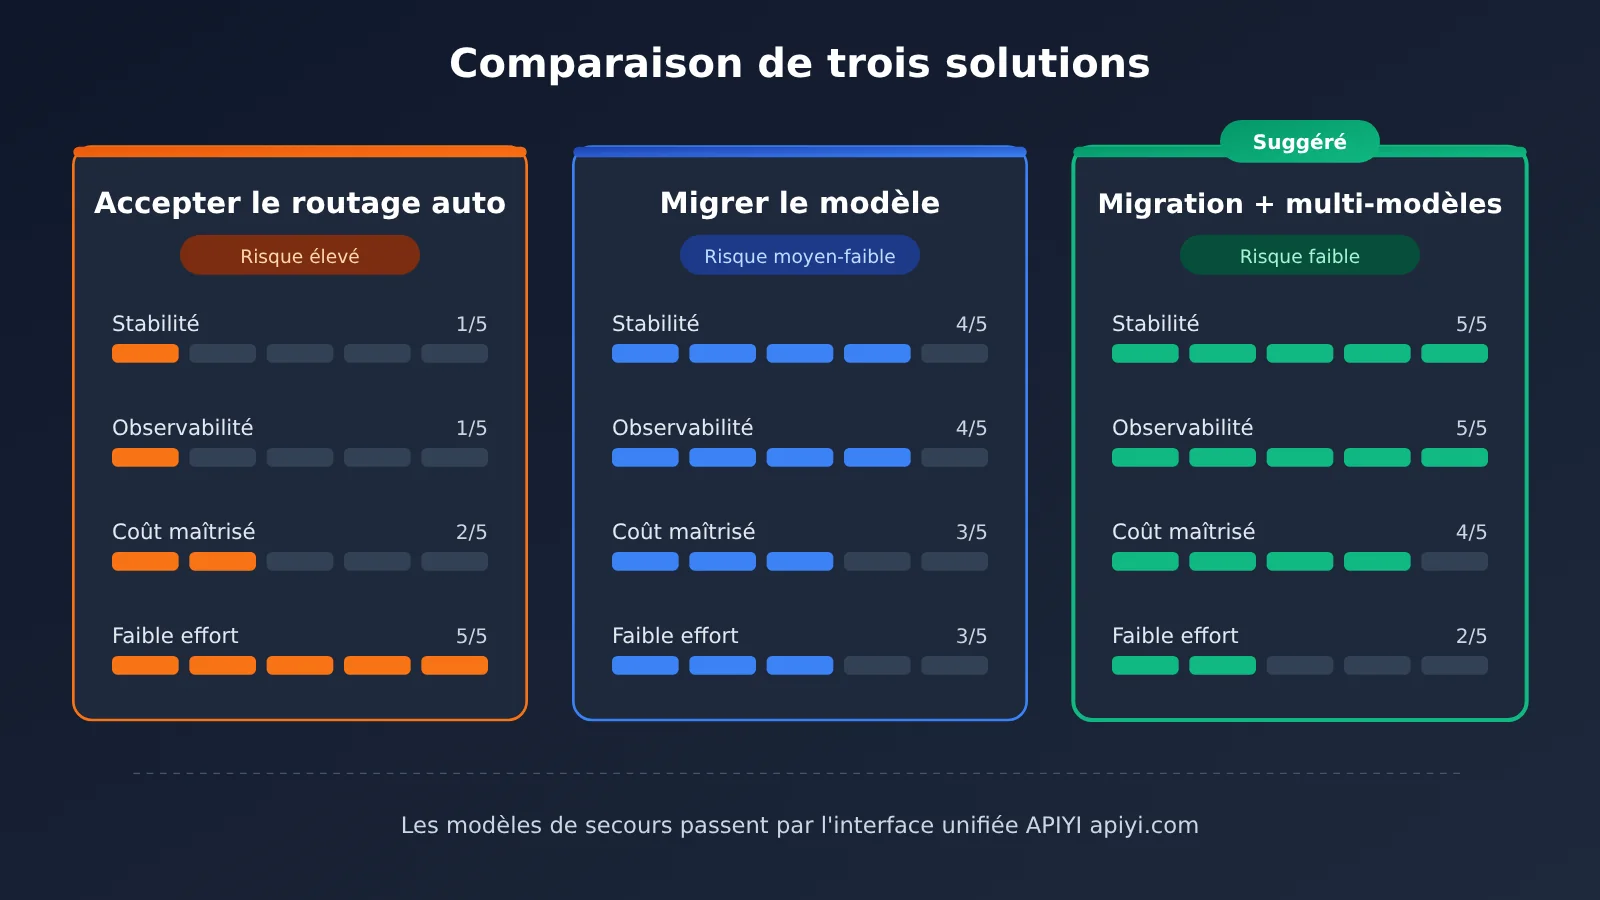
Comparaison des solutions pour Gemini 2.5 : routage passif vs migration active
Face au routage automatique de Gemini 2.5 Pro/Flash prévu le 1er décembre, les équipes ont généralement trois options. Le tableau ci-dessous les compare sous l’angle de la stabilité, de l’observabilité et de la charge de travail.
| Solution | Caractéristiques clés | Cas d’usage | Niveau de risque |
|---|---|---|---|
| Accepter le routage automatique | Aucune modification du code, routage assuré par l’opérateur après le 1er décembre | Outils internes à faible priorité, tâches hors ligne | Élevé : le comportement change en silence, les journaux ne reflètent plus la réalité |
| Migration explicite vers le nouveau modèle Gemini | Modifier activement l’ID du modèle et effectuer les tests de non-régression | La plupart des services en production | Moyen-faible : changement maîtrisé et observable |
| Migration explicite + modèles alternatifs | Migrer le modèle principal, tout en préparant une solution de repli multi-fournisseurs | Activités critiques, services à forte exigence de disponibilité | Faible : véritable chemin de retour arrière disponible |
| Profiter de l’occasion pour rechoisir | Réévaluer par cas d’usage et répartir vers différents niveaux de modèles | Activités sensibles aux coûts, gros volumes d’appels | Moyen : charge de travail plus importante, mais gains à long terme évidents |
Lecture comparative des solutions pour Gemini 2.5
Accepter le routage automatique est l’option la moins gourmande en travail, mais elle confie à un tiers le moment et la cible du changement de modèle. Pour un service en production qui dépend d’un format de sortie fixe, c’est un peu comme publier une mise à jour d’une dépendance critique sans aucun test : en cas de problème, difficile de mettre le doigt sur la cause immédiatement.
Migrer explicitement vers le nouveau modèle Gemini est le meilleur rapport qualité-prix. Vous restez dans l’écosystème Gemini, les invites et le mode d’intégration changent très peu, et vous gagnez une observabilité complète ainsi qu’une couverture de test rassurante. C’est le choix adapté à la grande majorité des équipes.
Migration explicite avec modèles alternatifs convient aux activités critiques. Comme il sera impossible de revenir à Gemini 2.5 après le 1er décembre, préparer un modèle de repli multi-fournisseurs déjà validé constitue le seul véritable plan de retour arrière.
💰 À propos des coûts : pour tout ce qui touche aux tarifs des modèles, aux prix d’entrée et de sortie, aux tarifs du cache et aux règles de facturation, référez-vous aux données réelles de la page tarifaire APIYI https://docs.apiyi.com/models. Cet article ne donne pas de chiffres précis ; lors de l’évaluation de la migration, je vous conseille de croiser ces données avec votre propre consommation de tokens pour calculer l’écart de coût.
FAQ — Questions fréquentes
Q1 : Qu’est-ce que le routage automatique de Gemini 2.5 Pro/Flash ?
Le routage automatique désigne le mécanisme mis en place depuis le 1er décembre, après que Google AI Studio a abandonné Gemini 2.5 Pro et 2.5 Flash : les requêtes API envoyées vers ces deux anciens identifiants de modèle ne renvoient plus directement une erreur, mais sont redirigées vers le modèle successeur désigné par Google. Au niveau de l’interface, tout semble transparent, mais le modèle réellement exécuté a changé.
Q2 : Quelle différence entre le routage automatique et une migration proactive ?
Le routage automatique simplifie les choses côté compatibilité, mais le moment du basculement et le modèle cible sont décidés de l’extérieur, et les journaux continuent d’afficher l’ancien identifiant de modèle, ce qui complique le diagnostic. La migration proactive demande un effort de test, mais l’évolution du modèle est maîtrisée et observable, et c’est l’occasion de recalibrer au passage les paramètres et les invites. Elle est donc plus adaptée aux services en production.
Q3 : Quand le routage automatique de Gemini 2.5 prend-il effet ? Affecte-t-il tous les canaux ?
D’après l’annonce de Google AI Studio, le routage automatique prend effet à partir du 1er décembre. Pour savoir s’il touche aussi Vertex AI et les autres canaux, et s’il existe une période de conservation des alias, référez-vous à l’annonce officielle de dépréciation de Google et au journal des mises à jour de l’API Gemini. Vérifiez impérativement le canal que vous utilisez avant de migrer.
Q4 : Quelles applications doivent traiter en priorité la dépréciation de Gemini 2.5 ?
Les catégories suivantes sont les plus prioritaires :
– **Sorties structurées** : les services d’extraction d’informations et d’analyse de formulaires qui reposent sur des champs JSON fixes
– **Agents et appels d’outils** : les flux automatisés qui dépendent du format des paramètres d’appel de fonction
– **Analyse de documents longs** : les tâches à contexte long pour lesquelles il faut réévaluer qualité, latence et coût
Q5 : Comment comparer rapidement Gemini 2.5 et les modèles de remplacement candidats ?
Je recommande d’utiliser une plateforme d’accès unifié multi-modèles pour faire des tests en parallèle :
1. Rendez-vous sur APIYI (apiyi.com), inscrivez-vous et récupérez une clé API
2. Consultez les instructions d’intégration du centre de documentation docs.apiyi.com, puis configurez vos appels au format compatible OpenAI ou Anthropic
3. Appelez séparément l’ancien modèle et les modèles candidats avec le même jeu d’échantillons de régression, puis comparez le taux de conformité de format, la latence et la consommation de tokens
APIYI propose l’invocation API des principaux modèles, dont la série Gemini concernée par cet article. En général, changer de modèle se limite à modifier le nom du modèle.
Q6 : Quelles sont les limites ou les risques connus de la migration Gemini 2.5 ?
Il faut regarder plusieurs limites avec objectivité. D’abord, après le 1er décembre, impossible de revenir à Gemini 2.5 : tout retour en arrière doit pointer vers un autre modèle déjà validé. Ensuite, la façon dont les nouveaux modèles prennent en charge certains paramètres, comme le budget de réflexion, peut différer : pas question de reprendre la configuration telle quelle. Enfin, les coûts peuvent évoluer. Pour les tarifs unitaires et les modalités de facturation, fiez-vous aux données réelles de la page tarifs d’APIYI docs.apiyi.com/models, afin d’éviter tout écart budgétaire.
Points clés pour faire face à la dépréciation de Gemini 2.5 Pro/Flash
- Fait essentiel : Gemini 2.5 Pro et 2.5 Flash sont dépréciés ; à partir du 1er décembre, les requêtes sont automatiquement routées
- Risque principal : le modèle change en silence, les logs affichent toujours l’ancien ID, et le format comme le coût peuvent dériver
- Action prioritaire : recenser globalement les ID de modèles, y compris dans les centres de configuration, les passerelles et les plateformes low-code
- Méthode de migration : remplacer explicitement les ID de modèles et recalibrer les paramètres comme la réflexion et la longueur de sortie
- Garantie de qualité : lancer des tests de régression avec de vrais échantillons de production, puis déployer progressivement (canary) par paliers
- Plan de rollback : une fois la date limite passée, impossible de revenir à Gemini 2.5 ; il faut préparer à l’avance des modèles alternatifs d’autres fournisseurs
- Pour démarrer : passer par APIYI pour accéder à plusieurs modèles de manière unifiée et comparer rapidement les modèles candidats
Conclusion
Après la dépréciation de Gemini 2.5 Pro/Flash, les points essentiels pour gérer le routage automatique du 1er décembre :
- Ne pas se reposer sur le routage automatique : il garantit seulement que l’interface ne renvoie pas d’erreur, pas que la qualité et le format des sorties restent identiques
- Migrer activement en 6 étapes : inventaire, choix du modèle, modification explicite, tests de régression, canary et rollback, surveillance continue
- Préparer à l’avance une chaîne de secours : après la date limite, impossible de revenir à l’ancien modèle ; une alternative multi-fournisseurs est la véritable solution de repli
Il reste moins d’un mois avant le 1er décembre. Je conseille de terminer cette semaine l’inventaire des points d’appel et la classification des impacts, de passer aux tests de régression la semaine prochaine, et d’achever la mise en production progressive avant la fin du mois, afin de garder une marge avant la date limite.
Nous recommandons de passer par APIYI apiyi.com pour vérifier rapidement les performances des modèles candidats. La plateforme est compatible avec les formats d’API OpenAI et Anthropic ; les instructions d’intégration sont disponibles sur docs.apiyi.com, et les prix des modèles ainsi que les règles de facturation font foi sur https://docs.apiyi.com/models.
📚 Références
- Google AI Studio déprécie Gemini 2.5 Pro et 2.5 Flash : article sur cette dépréciation et sur le routage automatique
- Lien :
aihot.news/items/ewvepczpb5fewcbzo2tkqdldm -
Description : confirme les modèles concernés par la dépréciation et la date du routage automatique au 1er décembre
-
Journal des mises à jour de l’API Gemini : registre officiel Google des mises à jour et dépréciations de modèles
- Lien :
ai.google.dev/gemini-api/docs/changelog -
Description : sert à vérifier les modèles cibles du routage automatique et les canaux concernés
-
Centre de documentation APIYI : guide d’intégration multi-modèles
- Lien :
docs.apiyi.com -
Description : configuration des appels aux formats compatibles OpenAI et Anthropic
-
Page des tarifs des modèles APIYI : prix des modèles et base de facturation
- Lien :
docs.apiyi.com/models - Description : référence tarifaire pour évaluer le coût d’une migration
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; pour plus de ressources, consultez le centre de documentation docs.apiyi.com