Note de l’auteur : une étude de Stanford montre que 44 % des conclusions couramment citées sur les LLM sont déjà dépassées. Celles dont la date d’expiration a pu être estimée ont une durée de validité moyenne de 15,7 mois. Cet article transforme les résultats de l’étude en une liste de vérifications que les équipes de développement peuvent utiliser pour choisir et retester leurs modèles.
« Tel modèle ne sait pas compter les r dans strawberry », « les informations au milieu d’un long contexte se perdent », « les modèles inventent des références bibliographiques » : vous avez sans doute entendu ces affirmations dans des articles, des groupes techniques ou des réunions consacrées au choix d’un modèle. Les chercheurs de Stanford Owen Queen et James Zou ont réexaminé 50 conclusions largement citées sur les LLM à l’aide de 20 modèles. Résultat : 44 % sont déjà dépassées, et celles dont la date d’expiration a pu être estimée ne restent valables que 15,7 mois en moyenne.
Ce n’est pas simplement un constat de plus sur les progrès des modèles. L’étude fournit des données précises : quels types de conclusions deviennent obsolètes le plus vite, lesquelles résistent mieux au temps et quelle est l’ampleur des écarts entre modèles d’une même génération. Cet article adapte les recommandations des chercheurs au monde universitaire pour en faire une démarche que les équipes de développement peuvent suivre lorsqu’elles choisissent un modèle.
À retenir : vous saurez quelles affirmations du type « les modèles ne sont pas bons pour X » sont les moins fiables, et vous pourrez adopter une méthode de sélection : noter le nom et la version du modèle ainsi que la date, conserver les invites et refaire les tests sur le modèle visé.
Les points clés de l’étude sur la péremption des conclusions concernant les LLM
Voici les chiffres essentiels de l’étude. Les modèles étudiés ont été publiés entre juillet 2024 et septembre 2026 par 8 développeurs différents. L’article consacré à cette étude a été publié le 3 novembre 2026.
| Point clé | Données de l’étude | Ce que cela signifie pour le choix d’un modèle |
|---|---|---|
| Proportion de conclusions dépassées | Sur 50 conclusions, 44 % sont dépassées et 34 % se sont nettement affaiblies | La plupart des défauts attribués aux modèles qui circulent en ligne ne peuvent plus être repris tels quels |
| Proportion de conclusions toujours valables | Seules 16 % restent valables et 6 % se sont même renforcées | Certaines tendances persistantes méritent une attention à long terme |
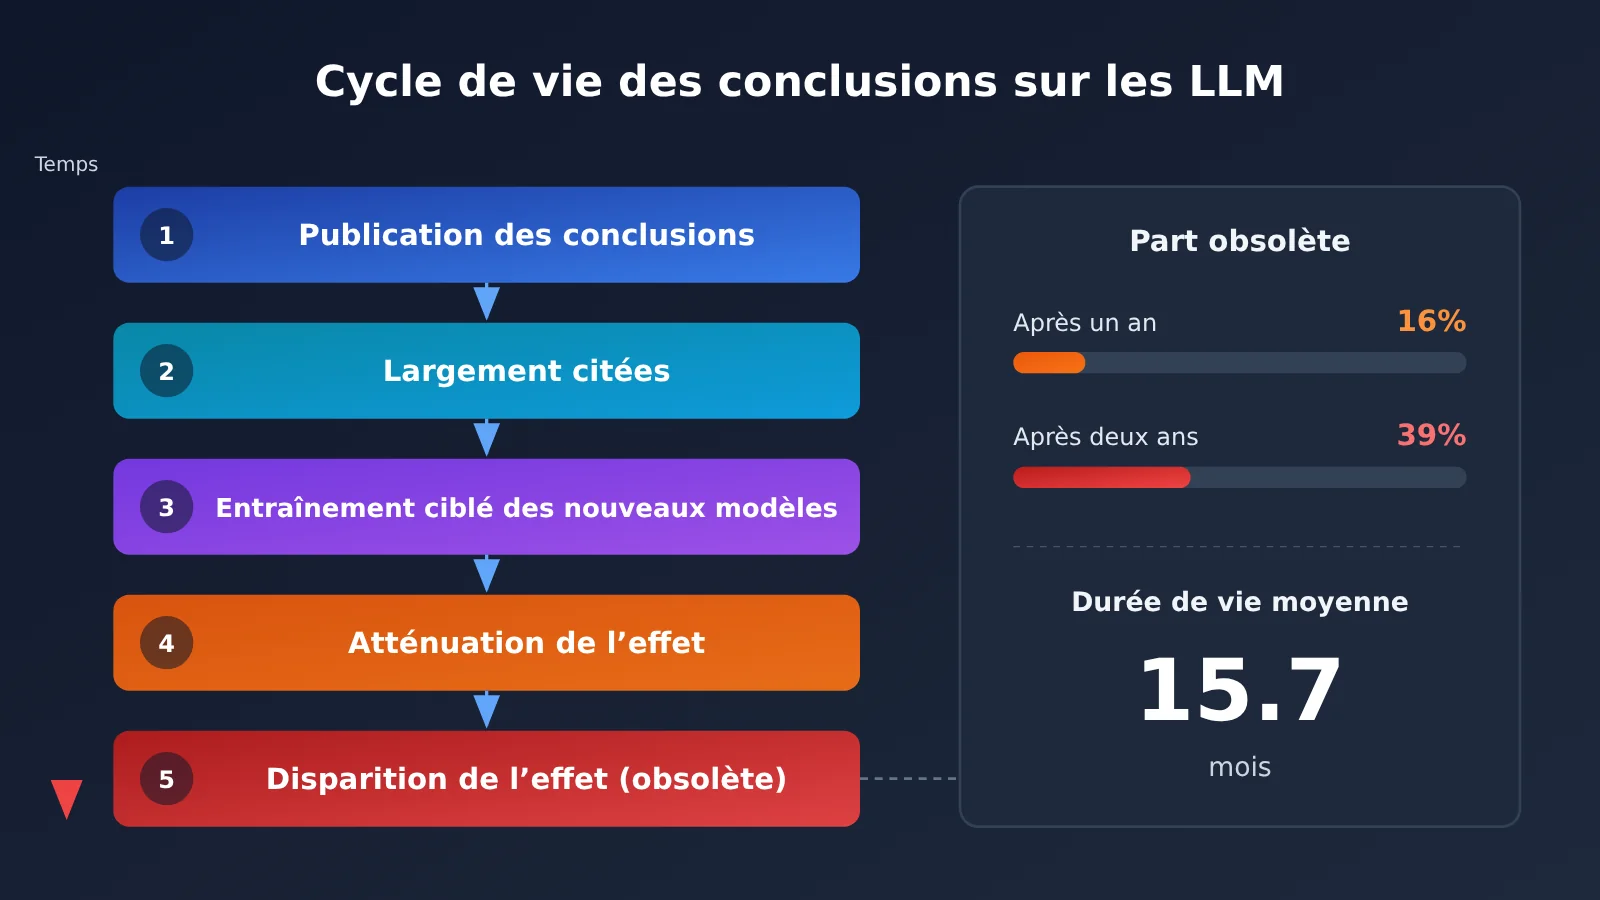
| Durée de validité moyenne | Pour les 22 conclusions dont la date de péremption a pu être estimée : 15,7 mois en moyenne | Les conclusions d’évaluations datant de plus d’un an doivent être considérées avec prudence |
| Évolution dans le temps | 16 % des conclusions sont dépassées après un an, contre 39 % après deux ans | Plus une conclusion est ancienne, plus il est important de la vérifier à nouveau |
| Différences entre modèles d’une même génération | Pour les modèles publiés entre juillet et septembre 2026, le nombre de conclusions dépassées varie de 11 à 30 | La date de publication ne permet pas de déduire les capacités d’un modèle |
Deux conclusions clés sur la péremption des résultats concernant les LLM
Le premier point concerne le sens du mot « dépassé ». Dans l’étude, une conclusion est dite dépassée lorsque l’effet observé à l’origine a pratiquement disparu sur les nouveaux modèles, et non lorsqu’il s’est simplement atténué. Par ailleurs, 34 % des conclusions se sont « nettement affaiblies » : le problème existe encore, mais il est bien moins marqué que ne le décrivait l’article initial. Au total, près de huit conclusions largement reprises sur dix ne peuvent donc plus être appliquées telles quelles aux modèles actuels.
Le deuxième point est que la « durée de vie » d’une conclusion dépend fortement de sa nature. Les conclusions sur les limites des capacités d’un modèle, autrement dit sur ce qu’il « ne sait pas faire », deviennent obsolètes le plus rapidement. Celles qui décrivent ses préférences ou ses tendances, c’est-à-dire sa « façon habituelle de faire », durent plus longtemps. Selon les chercheurs, les erreurs liées aux capacités ont généralement une « bonne réponse » : les développeurs disposent donc d’un objectif clair pour améliorer l’entraînement. Les préférences et les tendances, elles, n’ont pas de réponse standard et sont donc plus difficiles à « corriger ».
Quelles conclusions sur les LLM deviennent obsolètes le plus vite ?
Pour décider quelles conclusions retester en priorité, il faut d’abord comprendre leur nature. À partir des résultats présentés dans l’étude, le tableau ci-dessous distingue les conclusions qui deviennent facilement obsolètes de celles qui résistent mieux au temps.
| Type de conclusion | Exemples typiques | État dans l’étude | Priorité de retest |
|---|---|---|---|
| Limites de raisonnement et de capacité | Compter les lettres dans « strawberry », faire des calculs dans une base numérique inhabituelle, perdre des informations au milieu d’un contexte long, abandonner une réponse correcte après une contradiction de l’utilisateur | Sur 9 conclusions relatives au raisonnement, 5 sont devenues obsolètes et aucune ne s’est maintenue ou renforcée | Très élevée : à retester impérativement avant toute citation |
| Exactitude factuelle et hallucinations | Inventer des références scientifiques | La fréquence est tombée près de 0 pour certains modèles, mais reste très élevée pour d’autres | Élevée : les écarts sont considérables, chaque modèle doit être testé séparément |
| Raisonnement combinatoire | Questions à deux étapes, « malédiction de l’inversion », réponses contradictoires à des paires de questions temporelles | Les effets se sont atténués, mais restent détectables | Moyenne à élevée : les problèmes persistent, mais leur ampleur varie beaucoup |
| Préférences en tant qu’évaluateur | Préférer ses propres réponses, attribuer des notes similaires à des articles acceptés et refusés, être influencé par la formulation de résumés médicaux | Maintenues ou renforcées | Moyenne : risque durable, mais à vérifier régulièrement |
| Complaisance envers l’utilisateur | Aller dans le sens de l’utilisateur | Représente une part importante des conclusions maintenues ou renforcées | Moyenne : prioritaire pour les applications de service client ou de conseil |
| Tendances dans la distribution des réponses | Biais politique à gauche, réponses très similaires aux questions ouvertes, distribution inégale des nombres aléatoires générés | Maintenues ou renforcées | Moyenne : à surveiller pour la génération de contenu et l’échantillonnage |
Une précision s’impose pour les conclusions relatives au raisonnement : le corps de l’article indique que « 5 conclusions sur 9 sont devenues obsolètes et qu’aucune ne s’est maintenue ou renforcée », tandis que la légende du graphique affirme que « les 9 se sont toutes atténuées ». En rapprochant ces deux formulations, on peut comprendre que 5 conclusions sont devenues obsolètes et que les autres se sont également atténuées, sans qu’aucune ne reste inchangée. Comme nous n’avons pas pu consulter la liste complète des 50 conclusions ni la méthode de retest de l’article scientifique original, il convient de se référer à celui-ci pour leur classification précise.
Pourquoi les conclusions sur les préférences des LLM restent-elles valables plus longtemps ?
Parmi les 11 conclusions qui restent valables ou se sont renforcées, 3 concernent l’utilisation des LLM comme évaluateurs, et 3 portent sur leur tendance à flatter l’utilisateur ou à aller dans son sens. Les autres concernent les orientations politiques, la ressemblance entre les réponses aux questions ouvertes et la répartition inégale des nombres aléatoires. Ces problèmes ont un point commun : il est difficile de définir ce qu’est une réponse « correcte » et, par conséquent, de les éliminer par un entraînement ciblé.
Pour les équipes de développement, cela conduit à une hiérarchisation des risques qui peut surprendre. Le fameux « les modèles ne savent pas compter les lettres », souvent cité, n’est généralement plus un problème depuis longtemps. Ce sont plutôt les tendances systématiques moins visibles qui méritent une attention particulière. Si vous utilisez un LLM pour évaluer, noter ou recommander automatiquement des contenus, les problèmes liés à ses préférences devraient figurer dans vos tests de régression habituels.
Les conclusions sur les biais sociaux des LLM sont contrastées
Les chercheurs soulignent que les conclusions sur les biais sociaux n’évoluent pas toutes dans le même sens. Le biais politique à gauche persiste, tandis que les stéréotypes de genre et les biais d’association implicite se sont atténués. Quant aux biais envers les personnes qui parlent l’anglais afro-américain, les données montrent même une inversion de tendance. Cela rappelle qu’une affirmation générale comme « les modèles présentent tous un certain biais » n’a de sens que si l’on précise le modèle et le moment considérés.
Pourquoi le fournisseur et la date de sortie ne suffisent pas à prédire les performances d’un LLM
Lorsqu’elles choisissent un modèle, beaucoup d’équipes partent d’une intuition simple : un nouveau modèle est forcément meilleur qu’un ancien, les modèles d’un même fournisseur se valent, et un grand modèle est toujours plus fiable qu’un petit. Les données de l’étude contredisent directement ces hypothèses.
Le test sur l’invention de références bibliographiques en est l’exemple le plus frappant. Dans l’étude originale de Walters et Wilder, publiée en 2023, GPT-3.5 inventait 55 % des références. Des chercheurs de Stanford ont testé les modèles actuels avec la même invite : le taux est de 0 % pour GPT-6.1 Sol et de 1 % pour Claude Sonnet 5.5. Pourtant, Qwen3.7-Flash, lui aussi sorti en 2026, invente encore 69 % de ses références : c’est même plus que GPT-3.5 trois ans auparavant.
Les écarts sont tout aussi frappants entre des modèles sortis à la même période. Parmi ceux publiés entre juillet et septembre 2026, le nombre de conclusions « réfutées » varie de 11 pour DeepSeek V4 Pro à 30 pour GPT-6.1 Sol. L’étude précise que ni la date de sortie, ni le fournisseur, ni la taille du modèle ne permettent de prédire ces résultats de manière fiable.
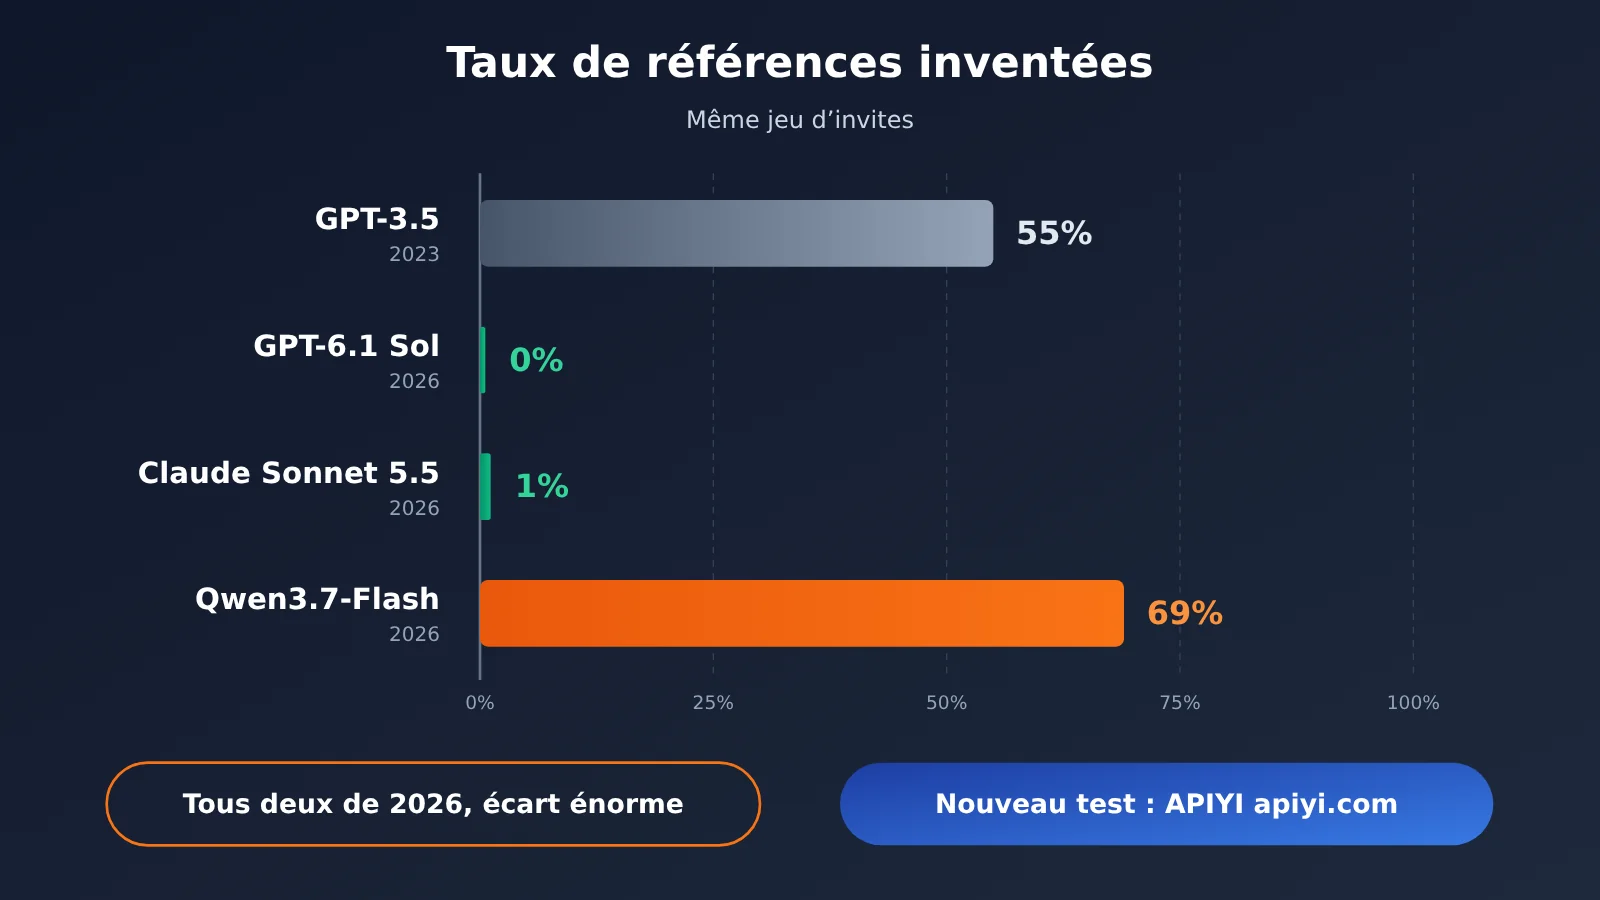
Le message de ce graphique est simple : des modèles de la même époque peuvent se situer aux deux extrêmes d’un même test. Pour reproduire ce type de comparaison en interne, vous pouvez utiliser une plateforme à interface unifiée comme APIYI apiyi.com et soumettre le même ensemble d’invites à plusieurs modèles candidats. Pour connaître les modèles disponibles, consultez la liste officielle de la plateforme.
Les chercheurs rappellent aussi qu’une amélioration ne signifie pas que « le problème est définitivement résolu ». Sur les questions à deux étapes, qui nécessitent de combiner deux faits connus, Claude Sonnet 5.5 se trompe encore sur environ 10 % des questions combinées, même lorsqu’il répond correctement à chacune des deux sous-questions. L’article original rapportait un taux de 43 % pour ChatGPT. La baisse est nette, mais si votre activité dépend de la combinaison de faits en plusieurs étapes, ces 10 % suffisent encore à provoquer des incidents en production.
Réévaluer les LLM avant de choisir : une liste en 5 étapes
Les chercheurs recommandent au monde académique de considérer les conclusions empiriques sur les LLM comme des « observations portant sur un modèle précis à un moment précis », et non comme des vérités universelles. Les publications devraient documenter le modèle, sa version et la date des tests, puis rendre publics les invites et le code d’analyse pour permettre de refaire les tests avec de futurs modèles. Ces recommandations s’appliquent presque telles quelles au processus de sélection des équipes de développement.
Étape 1 : documenter les métadonnées de chaque conclusion sur un LLM
Qu’une conclusion provienne d’un article scientifique, d’un billet de blogue, de l’expérience d’un collègue ou de vos propres tests, commencez par renseigner les champs du tableau ci-dessous. Si des champs essentiels manquent, la conclusion ne peut servir que de « piste à vérifier », pas de fondement à une décision.
| Champ de métadonnées | Informations à consigner | Pourquoi les consigner |
|---|---|---|
| Nom du modèle | Nom complet du modèle, et non « un modèle de tel fournisseur » | Les modèles d’un même fournisseur peuvent être très différents |
| Version précise | Numéro de version ou identifiant de l’instantané | Les performances d’un modèle peuvent changer après une mise à jour, même si son nom reste identique |
| Date du test | Date précise, au jour près | Pour évaluer l’« âge » de la conclusion, en tenant compte de la durée de vie moyenne de 15,7 mois |
| Invite complète | Invite système, entrée utilisateur et exemples | Avec une invite différente, le résultat ne peut pas être reproduit |
| Paramètres d’appel | Température, longueur maximale de sortie, etc. | Les paramètres d’échantillonnage peuvent influencer les conclusions sur la stabilité |
| Critères d’évaluation | Ce qui constitue une réussite ou un échec | Sans eux, les conclusions de différentes personnes ne sont pas comparables |
| Taille de l’échantillon | Nombre de cas testés | Une capture d’écran d’une seule conversation ne permet pas d’établir une proportion |
Étape 2 : définir les priorités de retest des LLM selon le type de conclusion
Face à une conclusion, commencez par déterminer à quelle catégorie elle appartient. Les conclusions portant sur des limites de capacité — difficulté à compter, à calculer, à retenir des informations ou tendance à changer de réponse dès qu’on la conteste — doivent être considérées par défaut comme « probablement dépassées ». Il faut les retester avant de les citer. Les conclusions portant sur des préférences ou des tendances — préférence pour ses propres réponses, complaisance ou réponses répétitives — doivent être considérées comme « probablement toujours valables » et intégrées aux tests de régression à long terme.
Tenez aussi compte de l’ancienneté de la conclusion : selon les données de l’étude, une conclusion de plus d’un an a environ 16 % de chances d’être dépassée ; après deux ans, cette proportion atteint 39 %. Si le modèle concerné a depuis été remplacé par le modèle que vous envisagez d’utiliser, refaites le test, aussi connue soit la conclusion.
Étape 3 : transformer les conclusions en cas de test exécutables pour les LLM
Une affirmation comme « le modèle comprend mal les documents longs » ne peut pas être testée directement. Il faut la transformer en cas concret. Par exemple, placez une information clé au début, au milieu, puis à la fin d’un long document, posez une question dans chaque cas et mesurez le taux de réponses correctes. Vous pouvez aussi demander au modèle de donner d’abord une réponse correcte, puis simuler une contestation de l’utilisateur et mesurer à quelle fréquence il change de réponse.
Pour construire ces cas, rapprochez-vous autant que possible de vos données métier réelles, plutôt que de reprendre uniquement les exemples simplifiés de l’article de recherche. Les questions classiques jugées « dépassées » dans l’étude ont probablement déjà fait l’objet d’un entraînement ciblé chez différents fournisseurs. Réussir ces questions ne garantit donc pas que le modèle réussira aussi avec vos données métier.
Étape 4 : retester tous les LLM candidats avec le même jeu d’invites
Pour que le retest soit fiable, il faut contrôler les variables : mêmes invites, mêmes paramètres et mêmes critères d’évaluation. Seul le modèle change. Si chaque modèle exige son propre SDK et une gestion distincte de l’authentification, le coût du retest risque de décourager l’équipe.
🚀 Conseil pratique : APIYI apiyi.com s’appuie sur le standard unifié de l’API OpenAI. Un seul jeton permet d’invoquer plus de 200 modèles : pour passer d’un candidat à l’autre, il suffit de modifier le paramètre model, sans toucher aux invites ni aux autres paramètres. C’est pratique pour ce type de comparaison. Pour connaître les modèles et versions disponibles, consultez la liste officielle de la plateforme.
Étape 5 : constituer un dossier de conclusions sur les LLM et le réexaminer régulièrement
Conservez les résultats de chaque retest dans un « dossier de conclusions ». Il doit contenir au minimum la conclusion originale, les métadonnées, les résultats du retest et la date du prochain examen. Compte tenu de la durée de vie moyenne de 15,7 mois, prévoyez un examen trimestriel ou semestriel des conclusions dont dépendent vos activités essentielles. Si vous prévoyez de passer à une nouvelle version du modèle, lancez systématiquement un retest complet.
| Situation | Périmètre de retest recommandé | Moment du retest |
|---|---|---|
| Sélection initiale | Toutes les conclusions qui influencent la décision + les cas d’usage essentiels | Avant la revue de sélection |
| Mise à niveau de la version du modèle | Ensemble des cas de régression | Avant la mise en production |
| Utilisation d’une conclusion externe | Conclusions concernées uniquement | Avant de les intégrer au document de conception |
| Exploitation courante | Cas liés aux préférences et tendances + cas à haut risque | Chaque trimestre ou semestre |
| Anomalie en production | Capacités liées à l’anomalie | Immédiatement |
💡 Conseil de sélection : plutôt que de commencer par vous demander « quel est le modèle le plus performant ? », déterminez d’abord quels types d’erreurs seraient les plus préjudiciables à votre activité. Retestez ensuite les modèles candidats sur ces points précis. Grâce à l’interface unifiée d’APIYI apiyi.com, vous pouvez comparer plusieurs modèles dans le même processus de test et réduire les variables supplémentaires liées à l’intégration.
Questions fréquentes (FAQ)
Q1 : Qu’entend-on par conclusion « obsolète » sur les LLM ?
Dans cette étude de Stanford, une conclusion empirique sur les LLM est dite « obsolète » lorsque l’effet sur lequel elle repose a pratiquement disparu dans les nouveaux modèles. C’est différent d’un effet « atténué », qui reste présent mais dont l’ampleur a nettement diminué. Sur les 50 conclusions étudiées, 44 % sont obsolètes et 34 % sont atténuées.
Q2 : Quelle différence entre les conclusions sur les limites des LLM et celles sur leurs tendances ?
Les conclusions sur les limites décrivent ce que les modèles « ne savent pas faire », comme compter des lettres, effectuer des calculs ou retrouver des informations dans un long contexte. Ces tâches ont une réponse correcte et peuvent être corrigées par un entraînement ciblé : ces conclusions deviennent donc obsolètes plus vite. Les conclusions sur les tendances décrivent plutôt comment les modèles « ont tendance à agir », par exemple en préférant leurs propres réponses ou en flattant l’utilisateur. Comme il n’existe pas de réponse standard, ces tendances persistent plus longtemps.
Q3 : Quand cette étude sur l’obsolescence des conclusions sur les LLM a-t-elle été publiée ?
L’article consacré à cette étude a été publié le 3 novembre 2026. L’étude a testé 20 modèles de 8 développeurs, publiés entre juillet 2024 et septembre 2026. Comme les modèles évoluent rapidement, les données citées dans cet article peuvent elles aussi devenir obsolètes. Il est conseillé de consulter l’étude originale avant de les utiliser.
Q4 : Quelles équipes ont le plus besoin de tester à nouveau les LLM selon leur version ?
Cela concerne surtout les équipes et applications suivantes :
– **Les équipes qui choisissent ou changent de modèle** : pour éviter d’écarter des candidats sur la base de défauts observés deux ans auparavant
– **Les équipes qui utilisent des LLM pour évaluer et noter** : les tendances à préférer leurs propres réponses ou à se laisser influencer par la formulation persistent
– **Les applications sensibles à l’exactitude des faits** : le taux de références inventées varie de 0 % à 69 % entre les modèles d’une même génération
– **Les produits conversationnels de service client ou de conseil** : les tendances à flatter l’utilisateur et à aller dans son sens nécessitent un suivi à long terme
Q5 : Comment tester à nouveau plusieurs LLM à moindre coût ?
L’essentiel est d’unifier la couche d’accès pour pouvoir changer uniquement de modèle, sans modifier les autres variables :
1. Rendez-vous sur APIYI apiyi.com pour créer un compte et obtenir une clé API
2. Vérifiez dans la liste officielle des modèles que les modèles et versions envisagés sont disponibles
3. Utilisez le même jeu d’invites et les mêmes paramètres, puis invoquez les modèles à tour de rôle en modifiant uniquement le paramètre model. Consignez les résultats et les métadonnées
Vous pouvez ainsi concentrer vos efforts sur la conception des cas de test plutôt que sur l’intégration répétée des interfaces de différents fournisseurs.
Q6 : Peut-on se fier aux scores des nouveaux modèles dans les classements au lieu de les tester à nouveau ?
Il n’est pas conseillé de s’y fier entièrement. L’étude montre que la date de publication, le fournisseur et la taille ne permettent pas de prédire de manière fiable le comportement d’un modèle sur les points précis étudiés. Les modèles publiés à la même période peuvent présenter de très grandes différences. Les classements sont utiles pour une première sélection, mais la décision finale devrait reposer sur des tests réalisés avec les données de votre propre activité.
Q7 : Quelles sont les limites de cette étude sur les LLM ?
Tout d’abord, il faut consulter l’article original pour obtenir la liste complète des 50 conclusions et les méthodes utilisées pour les retester : les sources secondaires ne peuvent pas couvrir tous les détails. Ensuite, le texte et les légendes des illustrations du compte rendu divergent sur les conclusions liées au raisonnement ; c’est donc l’article original qui fait référence. Enfin, les résultats de l’étude restent des observations valables pour « certains modèles, à un moment donné » : selon la logique même des chercheurs, ils finiront eux aussi par devenir obsolètes.
Conclusions sur les LLM : l’essentiel à retenir
- Un taux d’obsolescence élevé : parmi 50 conclusions répandues sur les LLM, 44 % sont devenues obsolètes et 34 % se sont nettement affaiblies
- Une durée de validité courte : les conclusions dont la durée peut être estimée ne restent valables que 15,7 mois en moyenne ; près de quatre sur dix deviennent obsolètes après deux ans
- Les défauts de capacité deviennent obsolètes plus vite : il faut retester en priorité les affirmations sur le comptage des lettres, le calcul arithmétique ou la perte d’informations dans les contextes longs
- Les biais de préférence persistent davantage : l’autopréférence, la flatterie et la similarité des réponses devraient faire partie des tests de régression à long terme
- Impossible de déduire les résultats du fournisseur ou de la date : parmi les modèles de 2026, le taux de fabrication de références varie de 0 % à 69 %
- Les métadonnées sont indispensables : sans le nom du modèle, sa version, la date et l’invite, une conclusion est difficile à reproduire
- Une interface unifiée réduit le coût des retests : avec APIYI apiyi.com, il suffit de modifier le paramètre model pour comparer plusieurs modèles
Conclusion
Les conclusions sur les LLM deviennent obsolètes au bout de 15,7 mois en moyenne. Ce chiffre nous rappelle trois choses :
- Les conclusions ont une durée de validité : toute affirmation sur un LLM doit être considérée comme une « observation sur un modèle donné, à un moment donné »
- Le type de conclusion détermine la priorité : retestez en priorité les limites de capacité et surveillez les tendances de préférence sur le long terme
- La version est déterminante : ni le fournisseur, ni la date de sortie, ni la taille du modèle ne remplacent un test sur une version précise
La prochaine fois que vous entendrez « ce modèle n’est pas doué pour X » lors d’une réunion de sélection, posez trois questions : quelle version ? Quand a-t-elle été testée ? A-t-on encore l’invite utilisée ? Sans réponse, ajoutez ce point à la liste des éléments à retester.
Vous pouvez utiliser APIYI apiyi.com pour intégrer les modèles candidats à un même processus de test et les réévaluer rapidement avec un même jeu d’invites. Consultez la liste officielle pour connaître les modèles disponibles.
📚 Références
- THE DECODER – Rapid LLM development is outrunning the research meant to explain it, study finds : article sur l’étude de Stanford consacrée à l’obsolescence des conclusions sur les LLM
- Lien :
the-decoder.com/rapid-llm-development-is-outrunning-the-research-meant-to-explain-it-study-finds -
Détails : présente les principaux résultats, notamment les 44 % de conclusions obsolètes, leur durée de validité moyenne de 15,7 mois, un cas de fabrication de références et les différences entre modèles d’une même génération
-
Article original d’Owen Queen et James Zou : étude menée par des chercheurs de Stanford pour retester 50 conclusions sur les LLM
- Lien : recherchez les noms des auteurs et le titre de l’article sur une plateforme de recherche académique
- Détails : nous n’avons pas pu accéder au texte intégral de l’article original. Pour la liste des 50 conclusions et la méthode de retest, veuillez consulter l’article original
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil d’APIYI apiyi.com. Pour plus de ressources sur l’intégration des modèles, consultez le centre de documentation docs.apiyi.com