Note de l’auteur : le 2 novembre 2026, xAI a officiellement retiré l’identifiant grok-imagine-image-quality. Les anciennes requêtes ne renvoient pas d’erreur, mais elles sont désormais exécutées avec Image 2.0 Low. Cet article part de la migration de Grok Imagine pour examiner les risques liés à la gestion des versions des API d’IA et les moyens d’y faire face.
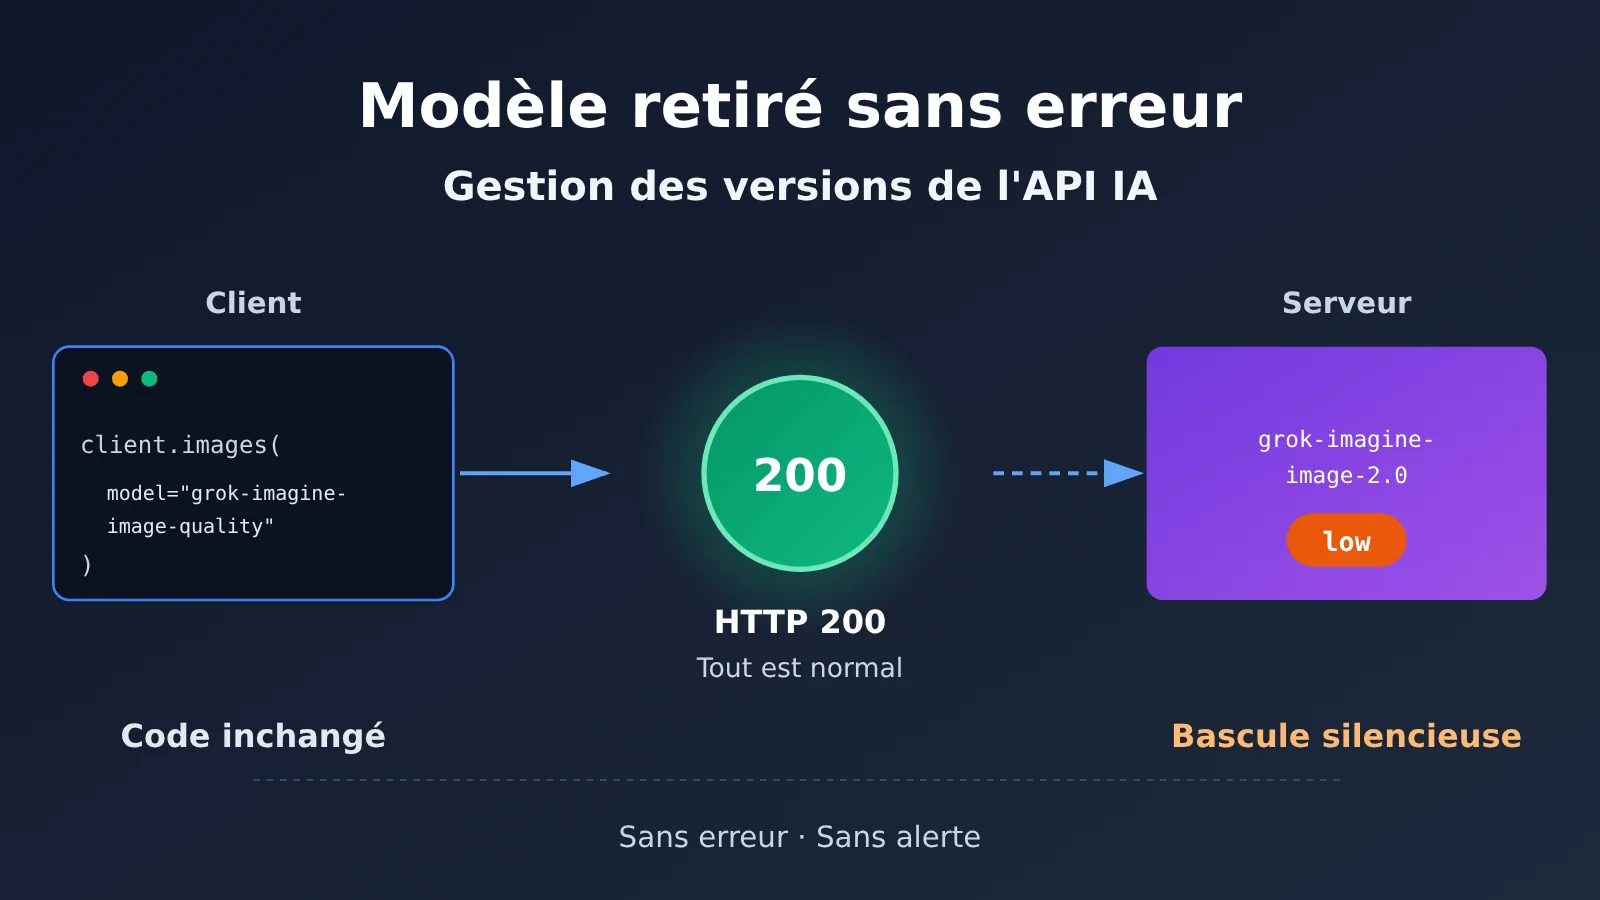
xAI met aujourd’hui, le 2 novembre 2026, en œuvre la migration de son modèle d’image annoncée précédemment. L’ancien identifiant grok-imagine-image-quality fonctionne toujours, mais le modèle utilisé est désormais grok-imagine-image-2.0, avec un niveau de qualité fixé à low. Pour la plupart des applications, aucune ligne de code n’a changé, les requêtes continuent de renvoyer des résultats et les tableaux de surveillance n’affichent aucune alerte rouge.
Ce n’est pas un rapport d’incident. Les règles de migration proviennent des instructions officielles publiées par xAI le 2 septembre, soit 60 jours à l’avance. Rien n’indique à ce jour qu’une panne à grande échelle ait touché les utilisateurs. La question à retenir est plutôt celle-ci : une interface compatible et des requêtes réussies ne garantissent pas que le modèle, la qualité des résultats et les coûts restent inchangés.
Ce que vous allez en retirer : vous comprendrez précisément ce que change cette migration de Grok Imagine et pourquoi les API d’IA ont besoin d’une gestion des versions distincte de la surveillance habituelle de la disponibilité. Vous disposerez aussi d’une liste de vérifications à appliquer immédiatement à vos systèmes.
Retrait du modèle Grok Imagine : l’essentiel
Commençons par les faits confirmés dans la documentation officielle. Point important : le 2 novembre n’est pas la date de lancement d’Image 2.0, sorti le 7 août. C’est la date à laquelle le retrait d’un ancien identifiant API entre en vigueur.
| Information | Détail |
|---|---|
| Date d’effet | 2 novembre 2026 (annonce le 2 septembre, préavis de 60 jours) |
| Source | Guide de migration officiel de xAI |
| Identifiant retiré | grok-imagine-image-quality |
| Modèle de remplacement | grok-imagine-image-2.0, avec quality fixé à low |
| Interfaces concernées | /v1/images/generations et /v1/images/edits |
| Compatibilité | L’ancien identifiant reste reconnu ; la structure des requêtes et des réponses reste compatible |
| Non concerné | xAI confirme que grok-imagine-image (1.0) n’est pas affecté par ce changement |
| Vérification | Le champ model de la réponse indique le modèle réellement utilisé |
La chaîne de redirections des anciens identifiants Grok Imagine
Un détail facile à manquer dans cette migration : les redirections s’enchaînent. Dès le 15 mai 2026, xAI avait retiré l’identifiant encore plus ancien grok-imagine-image-pro et redirigé ses requêtes vers grok-imagine-image-quality. Après le 2 novembre, la chaîne s’allonge d’une étape.
Autrement dit, une application dont la configuration n’a jamais été mise à jour et qui utilise encore l’identifiant pro passe désormais par Image 2.0 Low. Il ne suffit donc plus de vérifier la valeur de model dans le fichier de configuration pour savoir quel modèle est réellement utilisé.
| Identifiant configuré dans l’application | État | Parcours réel après le 2 novembre |
|---|---|---|
grok-imagine-image-pro |
Retiré le 15 mai | pro → quality → 2.0 (low) |
grok-imagine-image-quality |
Retiré le 2 novembre | quality → 2.0 (low) |
grok-imagine-image-2.0 |
Disponible officiellement | 2.0, avec low / medium / auto au choix |
grok-imagine-image |
1.0, toujours disponible | Non concerné par ce changement |
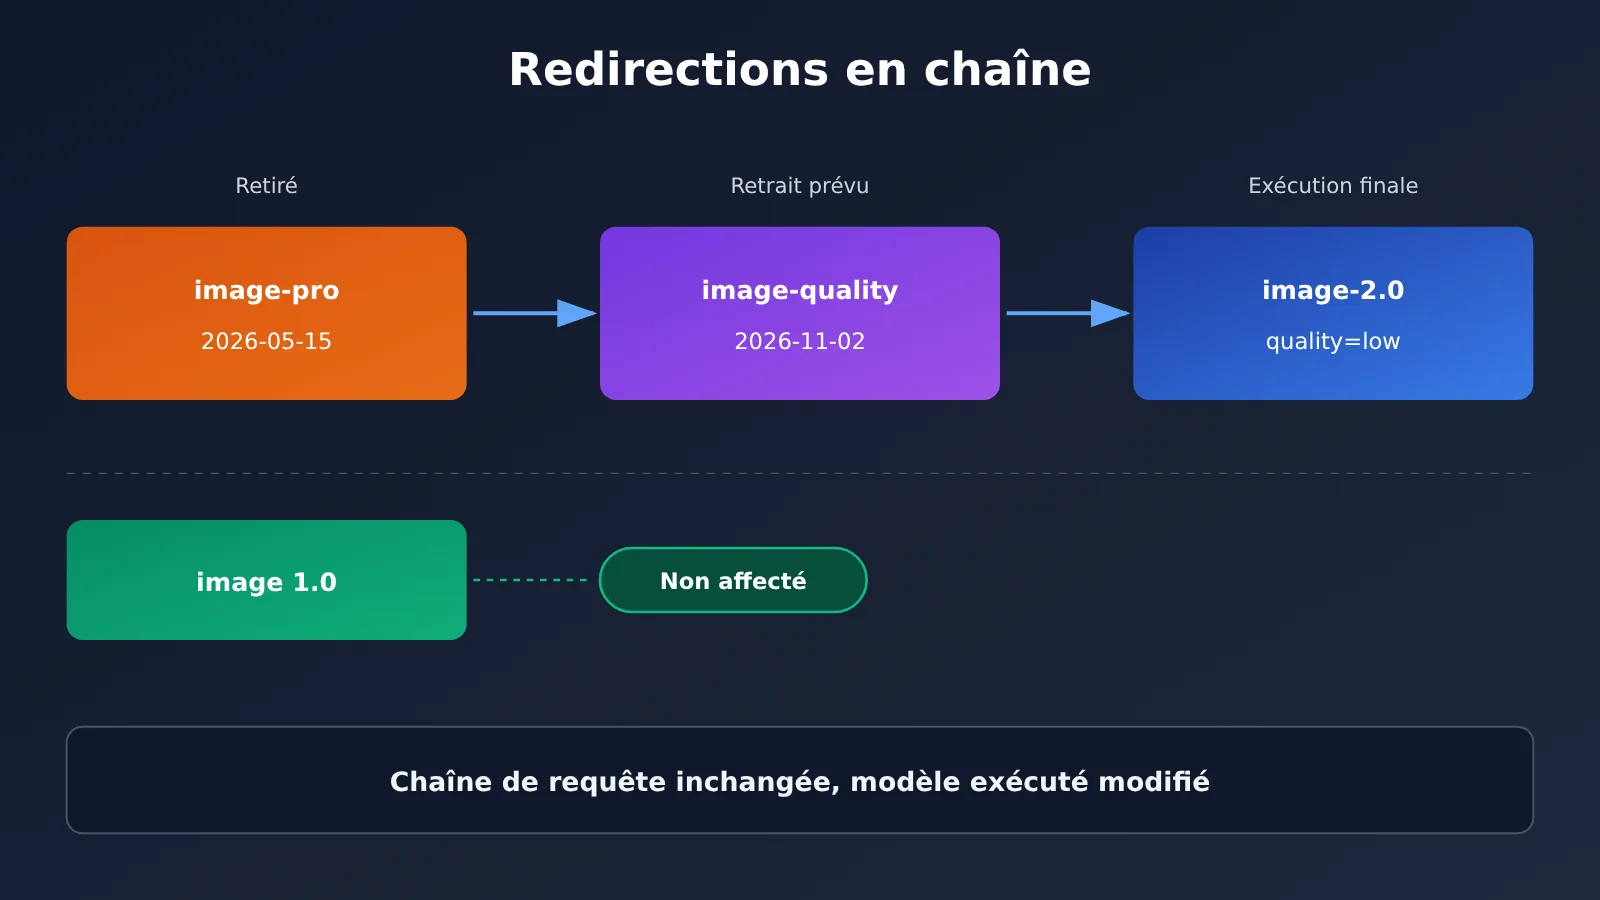
Les 4 risques de gestion des versions d’API IA liés à la migration vers Grok Imagine
L’analyse qui suit déduit les risques techniques des mécanismes officiels ; elle ne présente pas de statistiques sur des incidents survenus chez xAI. Ces risques se répartissent en quatre catégories : identité du modèle, qualité des résultats, facturation et surveillance.
Risque n° 1 : changement d’identité du modèle
La chaîne envoyée par le client ne change pas, mais le modèle exécuté côté serveur est différent. Bonne nouvelle : xAI indique le modèle réellement utilisé dans le champ model de la réponse. Encore faut-il que votre système enregistre et compare ce champ. Beaucoup d’applications inscrivent le nom du modèle en dur dans la requête, sans jamais lire les informations du modèle dans la réponse.
Risque n° 2 : changement de qualité et de style des résultats
Ce que xAI confirme, c’est la « compatibilité de la structure des requêtes », pas une « identité des images produites ». Lors du lancement d’Image 2.0, xAI a surtout mis en avant sa capacité à suivre des invites comportant plusieurs contraintes, à gérer les textes de petite taille et les mises en page complexes, ainsi qu’à modifier des images à partir de plusieurs images de référence. En parallèle, quelques utilisateurs sur Reddit r/grok ont indiqué que la version 2.0 leur semblait moins pratique qu’avant pour les détails de peau, la lumière naturelle et la préservation de l’image d’origine.
Ces avis reflètent des expériences personnelles et concernent principalement le produit grand public. Ils ne permettent pas de conclure à une régression générale de la version 2.0. Ils montrent toutefois qu’une même invite peut produire une composition, un style ou des modifications locales différents après un changement de modèle. C’est un point à vérifier par des tests de régression, plutôt que de supposer que « compatible » signifie « sans conséquence ».
Risque n° 3 : changement de facturation et de niveau de qualité
Cette migration s’accompagne d’une baisse de prix, mais elle montre justement à quel point la configuration du niveau de qualité compte. Voici les tarifs officiels de xAI par image produite, en dollars, hors frais d’entrée des images de référence :
| Résolution | Ancien Quality | 2.0 Low | 2.0 Medium |
|---|---|---|---|
| 1K | $0.05 | $0.04 | $0.06 |
| 1.5K | $0.06 | $0.05 | $0.07 |
| 2K | $0.07 | $0.06 | $0.08 |
Pour 10 000 images 1K par mois, le coût théorique de sortie serait d’environ 400 $ en conservant l’ancien identifiant, qui utilise automatiquement 2.0 Low. C’est 100 $ de moins que les 500 $ de l’ancien niveau Quality. En revanche, passer explicitement à 2.0 Medium porterait le coût à 600 $, soit 100 $ de plus qu’avec l’ancienne version. La modification d’image ajoute des frais d’entrée de 0,01 $ par image de référence. Par exemple, pour une image de référence et une image 1K produite, le coût est de 0,06 $ avec l’ancien Quality, de 0,05 $ avec 2.0 Low et de 0,07 $ avec 2.0 Medium.
La différence entre les valeurs par défaut est moins visible. Depuis le 28 août, si le paramètre quality n’est pas renseigné avec 2.0, sa valeur par défaut est auto. Or, auto sélectionne actuellement low pour le texte vers image et medium pour la modification d’image. La documentation officielle utilise le terme « currently » : ce comportement n’est donc pas garanti de façon permanente. Pour les usages de modification d’image, « conserver l’ancien identifiant » et « passer à 2.0 sans renseigner quality » ne sont donc pas équivalents, et leurs coûts diffèrent. À noter aussi : la grille tarifaire mentionne le 1.5K, mais la documentation des paramètres de génération ne répertorie actuellement que 1k et 2k pour resolution. Il faut donc tester si 1.5k peut être spécifié.
Risque n° 4 : angles morts de la surveillance
Si votre application ne surveille que les codes HTTP, le taux de réussite et le temps de réponse, le changement de modèle est presque « invisible » dans les métriques. Le mode asynchrone (deferred) de génération d’images xAI en donne un autre exemple : pending renvoie HTTP 202, done renvoie HTTP 200, tandis que failed renvoie lui aussi HTTP 200, avec les informations d’erreur dans la réponse. Un HTTP 200 ne signifie pas nécessairement que l’opération métier a réussi.
Comparaison des stratégies de gestion des versions des modèles
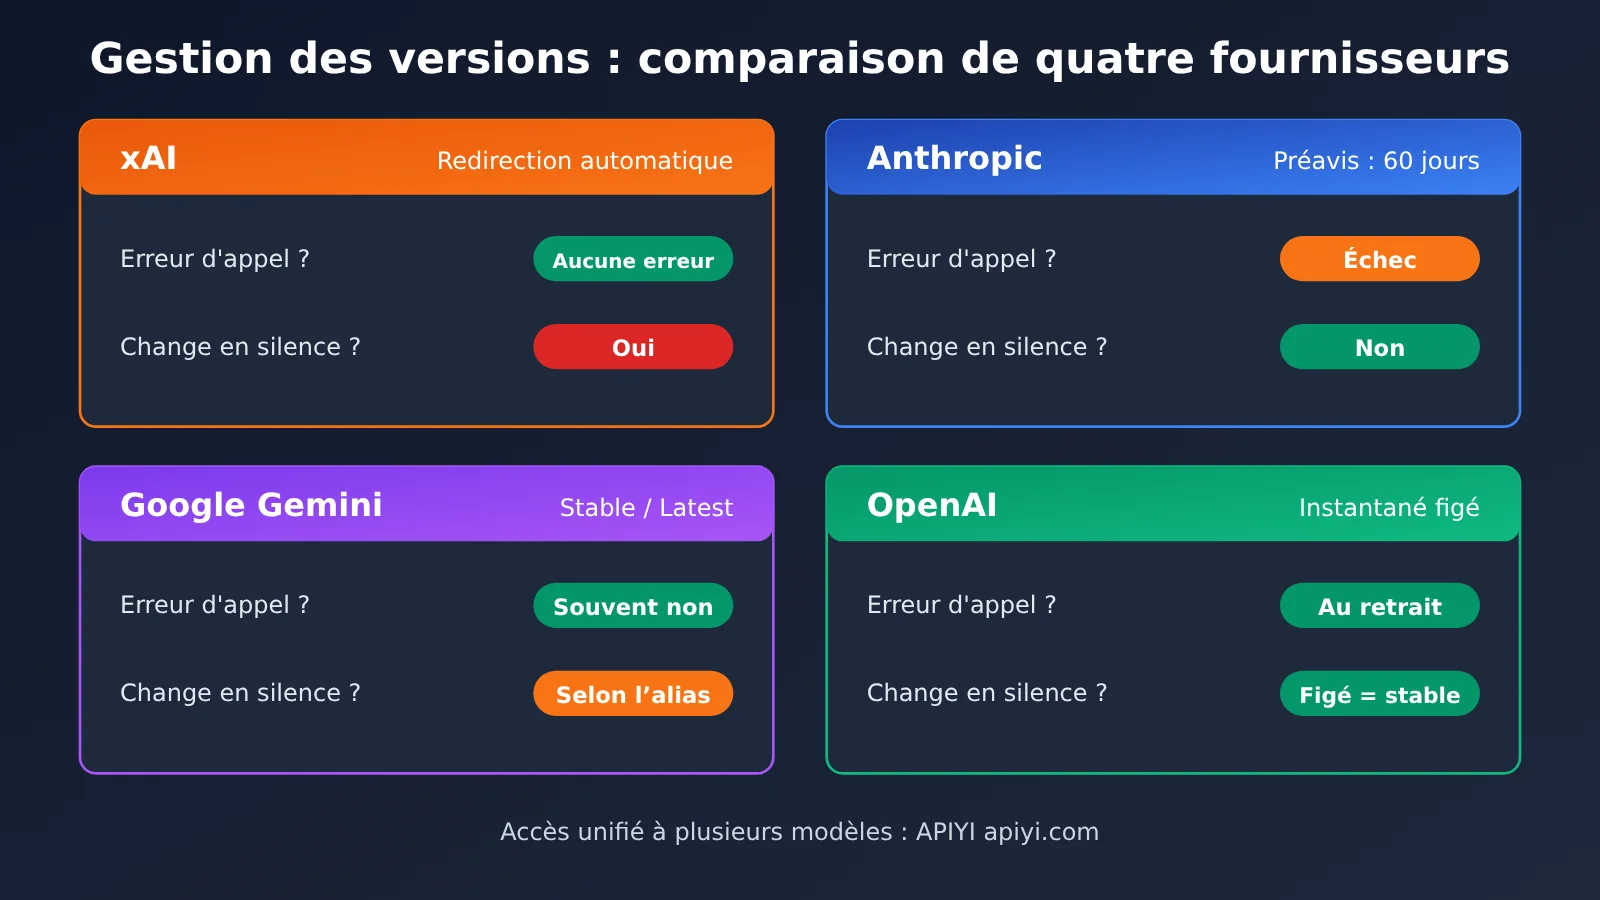
La stratégie de xAI, qui consiste à conserver les anciens identifiants tout en remplaçant le modèle côté serveur, n’est qu’une approche parmi d’autres. Elle ne s’applique pas à tous les fournisseurs. Les différences sont nettes quand on compare leurs documentations officielles.
| Fournisseur | Politique officielle de gestion des versions | Comportement après retrait ou modification | Conséquences pour les développeurs |
|---|---|---|---|
| xAI | Les identifiants retirés restent reconnus et sont redirigés côté serveur | Pas d’erreur, mais le modèle réellement utilisé change | Il faut vérifier le champ model de la réponse |
| Anthropic | Quatre étapes : Active / Legacy / Deprecated / Retired | Les requêtes échouent après le passage au statut Retired ; préavis d’au moins 60 jours pour les modèles publics | L’échec rend le problème visible ; il faut suivre les annonces de dépréciation |
| Google Gemini | Stable / Preview / Latest / Experimental | L’alias Latest bascule automatiquement vers les nouvelles versions ; les changements incompatibles sont annoncés à l’avance | Stable est recommandé en production ; utiliser Latest avec prudence |
| OpenAI | Recommande de fixer un instantané du modèle en production | La rétrocompatibilité de l’API ne garantit pas des résultats identiques | Fixer un instantané et créer un jeu d’évaluation, tout en surveillant les dates de retrait |
Comparaison avec xAI : xAI offre la transition la plus « fluide » côté client : le code existant ne cesse pas soudainement de fonctionner. En contrepartie, le changement de modèle ne se manifeste pas par une erreur. La stratégie d’Anthropic, qui fait échouer les requêtes vers un modèle Retired, est plus « bruyante », mais rend le problème visible plus tôt.
Comparaison avec Google et OpenAI : Google a explicitement intégré le principe d’un identifiant inchangé associé à une version qui évolue dans son alias Latest. C’est donc un mécanisme connu et courant. OpenAI aborde le problème sous un autre angle en recommandant de fixer un instantané en production et de créer un jeu d’évaluation. Ces deux approches montrent que la gestion des versions n’est pas un problème propre à un seul fournisseur : c’est une question d’ingénierie à prendre en compte avec toute API d’IA.
💡 Conseil : la signification des versions varie beaucoup d’un fournisseur à l’autre. Si vous utilisez plusieurs modèles, mieux vaut enregistrer systématiquement le « modèle demandé » et le « modèle exécuté ». Même si vous passez par APIYI apiyi.com pour accéder aux modèles de plusieurs fournisseurs via une interface compatible avec OpenAI, nous vous conseillons de conserver ces deux champs dans votre application pour faciliter les comparaisons.
Comment gérer les versions d’une API d’IA : journaux, coûts et déploiement progressif
Première étape : distinguer le modèle demandé du modèle utilisé
Les conventions sémantiques d’OpenTelemetry pour l’IA générative définissent deux attributs clés : gen_ai.request.model désigne le modèle demandé par le client, tandis que gen_ai.response.model désigne le modèle qui a réellement généré la réponse. xAI ne fournit pas automatiquement tous les champs de télémétrie : l’application doit les collecter et les faire correspondre elle-même. Voici les champs recommandés pour les journaux applicatifs (recommandation technique, pas une obligation officielle) :
| Champ | Utilité | Points d’attention |
|---|---|---|
requested_model / served_model |
Détecter les redirections silencieuses | La valeur de served provient du champ model de la réponse |
quality_requested / quality_effective |
Suivre le niveau de qualité | Si la valeur effective ne peut être déduite que de la documentation, indiquez qu’il s’agit d’une valeur inférée |
response_status / business_status |
Distinguer le résultat HTTP du résultat métier | Un échec asynchrone peut aussi renvoyer HTTP 200 |
cost_usd |
Coût réel par requête | Avec xAI, il peut être calculé à partir de cost_in_usd_ticks |
reference_image_count / resolution |
Attribution des coûts | Pour les opérations de modification, incluez les frais liés aux entrées |
prompt_template_version / evaluation_result |
Comparaison des régressions | N’enregistrez pas par défaut les invites sensibles ni les images des utilisateurs |
Deuxième étape : enregistrer dans le code le modèle réellement utilisé et le coût
La documentation officielle d’xAI sur le suivi des coûts, mise à jour le 10 octobre 2026, indique que l’objet usage de la réponse peut contenir cost_in_usd_ticks. La formule de conversion est cost_usd = cost_in_usd_ticks / 10000000000 : dans l’exemple officiel, 400000000 ticks correspondent à 0,04 $. Ce champ est propre à xAI. Lors d’un appel via un SDK ou une plateforme tierce, vérifiez qu’il est bien transmis tel quel.
L’exemple minimaliste ci-dessous montre comment effectuer la vérification dès la requête :
import requests

BASE_URL = "https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
REQUESTED_MODEL = "grok-imagine-image-2.0"  # 示例名称,可用模型以平台实际列表为准

resp = requests.post(
    f"{BASE_URL}/images/generations",
    headers={"Authorization": "Bearer YOUR_API_KEY"},
    json={"model": REQUESTED_MODEL, "prompt": "A tech magazine cover",
          "quality": "low", "resolution": "1k", "n": 1},
    timeout=180,
).json()

served = resp.get("model")
if served and served != REQUESTED_MODEL:
    print(f"[版本告警] 请求 {REQUESTED_MODEL},实际执行 {served}")
Voir l’implémentation complète avec vérification du coût et du résultat métier
import time
import logging
import requests
from typing import Optional

logging.basicConfig(level=logging.INFO)
log = logging.getLogger("model_governance")

BASE_URL = "https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
TICKS_PER_USD = 10_000_000_000  # xAI 官方换算:1 美元 = 10^10 ticks


def generate_image(
    prompt: str,
    model: str,
    quality: str = "low",          # 显式填写,避免 auto 默认值随上游变化
    resolution: str = "1k",
    api_key: str = "YOUR_API_KEY",
    expected_unit_cost: Optional[float] = None,
) -> dict:
    start = time.time()
    r = requests.post(
        f"{BASE_URL}/images/generations",
        headers={"Authorization": f"Bearer {api_key}"},
        json={"model": model, "prompt": prompt, "quality": quality,
              "resolution": resolution, "n": 1},
        timeout=180,
    )
    latency_ms = int((time.time() - start) * 1000)
    body = r.json() if r.content else {}

    # 1. 执行模型校验
    served_model = body.get("model")

    # 2. 业务结果校验:HTTP 200 不等于拿到可用图片
    data = body.get("data") or []
    has_image = bool(data and (data[0].get("url") or data[0].get("b64_json")))
    business_ok = r.status_code == 200 and has_image and not body.get("error")

    # 3. 成本:字段可能不被透传,缺失时记录为 None 而不是 0
    ticks = (body.get("usage") or {}).get("cost_in_usd_ticks")
    cost_usd = ticks / TICKS_PER_USD if ticks is not None else None

    record = {
        "requested_model": model,
        "served_model": served_model,
        "quality_requested": quality,
        "resolution": resolution,
        "response_status": r.status_code,
        "business_status": "ok" if business_ok else "failed",
        "latency_ms": latency_ms,
        "cost_usd": cost_usd,
    }

    if served_model and served_model != model:
        log.warning("模型重定向: %s -> %s", model, served_model)
    if cost_usd is not None and expected_unit_cost is not None \
            and abs(cost_usd - expected_unit_cost) > 1e-6:
        log.warning("单价偏离预期: 预期 %.4f 实际 %.4f", expected_unit_cost, cost_usd)

    log.info("generation record: %s", record)
    return record


if __name__ == "__main__":
    generate_image(
        prompt="A clean product shot on white background",
        model="grok-imagine-image-2.0",  # 以平台模型列表为准
        quality="low",
        expected_unit_cost=0.04,
    )
🚀 Démarrage rapide : pour tester d’abord cette méthode de suivi, inscrivez-vous sur APIYI apiyi.com afin d’obtenir des crédits de test, puis utilisez quelques invites issues de votre activité pour vérifier les champs des journaux. Pour connaître les modèles d’image disponibles, les paramètres de qualité pris en charge et les tarifs réels, consultez la liste des modèles et la page des prix de la plateforme. Les tarifs d’une plateforme tierce ne sont pas ceux de xAI.
Troisième étape : définir un jeu de test fixe et valider le déploiement progressif
En s’appuyant sur la méthode Canary Release de Google SRE et sur les recommandations d’OpenAI concernant les jeux d’évaluation, voici comment procéder pour migrer un modèle d’image : préparez d’abord un jeu d’échantillons couvrant les affiches avec texte, les images de produits, la retouche de portraits, les compositions à plusieurs sujets et les modifications locales. Fixez ensuite les invites, les images d’entrée, la résolution, la qualité, le rapport largeur/hauteur et le nombre d’images à générer. Comparez ensuite le respect des instructions, la préservation des sujets, l’exactitude du texte, les changements en dehors de la zone modifiée, le taux de validation humaine et le coût par image conforme. Enfin, si vous maîtrisez le routage, basculez une petite partie du trafic et observez les indicateurs avant d’élargir le déploiement.
Un point important : ce retrait de xAI est imposé en amont. Les développeurs ne peuvent donc pas supposer qu’ils pourront revenir à l’ancien modèle sous-jacent Quality une fois celui-ci retiré. Ici, le « retour arrière » signifie passer à un autre modèle validé et toujours disponible, suspendre les fonctionnalités concernées ou ajuster le paramètre quality, et non rétablir une ancienne version devenue inaccessible.
Effets de la migration de Grok Imagine sur les développeurs et les plateformes API
Pour les développeurs
- Élargir les recherches : ne cherchez pas seulement
grok-imagine-image-quality, mais aussi des alias plus anciens commegrok-imagine-image-pro. - Définir les paramètres explicitement : si vous passez directement à la version 2.0, indiquez clairement low ou medium. Ne laissez pas auto décider du niveau de qualité et du coût de vos opérations de retouche.
- Revoir le calcul des coûts : lorsque le fournisseur annonce « 0,01 $ de moins par image », il compare les prix de sortie. La baisse du coût total peut être différente pour les retouches utilisant une image de référence.
- Vérifier les résultats séparément : au-delà du taux de réussite des appels, ajoutez des critères de validation métier et un indicateur de coût par résultat conforme.
Pour les plateformes d’agrégation d’API
Pour les plateformes qui donnent accès à plusieurs modèles, la gestion des versions répond à un besoin réel des clients : ils doivent savoir vers quel modèle en amont leurs requêtes sont dirigées, connaître les dates et les changements de prix liés aux retraits et aux redirections, vérifier que les paramètres clés comme quality sont correctement transmis et disposer d’informations traçables sur les modèles et la facturation. Ce sont autant de fonctionnalités que les plateformes d’agrégation ont intérêt à évaluer et à développer.
🎯 Conseil technique : si vous accédez à plusieurs modèles par l’intermédiaire d’une plateforme d’agrégation comme APIYI apiyi.com, vérifiez trois points pendant la migration : le champ model de la réponse reflète-t-il le modèle réellement utilisé en amont, le paramètre quality est-il bien transmis et la facturation correspond-elle au prix unitaire prévu ? En cas d’écart, conservez l’ID de la requête pour en discuter avec le support technique de la plateforme : c’est bien plus efficace que d’éplucher les factures après coup.
Questions fréquentes (FAQ)
Q1 : Que signifie concrètement le retrait du modèle Grok Imagine ?
À partir du 2 novembre 2026, l’identifiant `grok-imagine-image-quality` de l’API xAI est retiré, mais reste utilisable : le serveur transmet les requêtes à `grok-imagine-image-2.0` en imposant le niveau low. Les interfaces de génération et de modification sont toutes deux concernées. Le modèle 1.0 `grok-imagine-image`, lui, n’est pas affecté.
Q2 : L’ancien code renverra-t-il une erreur 404 ou échouera-t-il immédiatement ?
Non. D’après la documentation officielle, l’ancien identifiant reste reconnu et les requêtes sont automatiquement redirigées, sans changement dans la structure des requêtes et des réponses. C’est justement ce qui demande de la vigilance : l’absence d’erreur ne signifie pas que les résultats et le prix unitaire sont inchangés. Cette approche diffère de celle d’Anthropic, chez qui les requêtes échouent lorsqu’un modèle passe au statut Retired.
Q3 : Si je passe directement à grok-imagine-image-2.0, tout sera-t-il exactement comme avant ?
Pas tout à fait. Avec 2.0, si le paramètre quality n’est pas renseigné, la valeur par défaut est auto : actuellement, la génération de texte vers image utilise low et la modification d’image utilise medium. En conservant l’ancien identifiant, le niveau est fixé à low. Pour la modification d’image en medium, le prix unitaire d’une sortie 1K est de 0,06 $, contre 0,05 $ pour l’ancien modèle Quality. Mieux vaut préciser le niveau et vérifier les résultats sur un jeu de tests fixe.
Q4 : Comment vérifier quel modèle mon système utilise réellement ?
Lisez et consignez le champ `model` de la réponse, puis comparez-le au modèle demandé. Enregistrez aussi le coût réel calculé à partir de `cost_in_usd_ticks`, si cette donnée est disponible. Si vous passez par une plateforme tierce comme APIYI apiyi.com, vérifiez également que ces champs sont transmis sans modification. Pour connaître les modèles disponibles et leurs prix, consultez la page officielle de la plateforme.
Q5 : Si les résultats du nouveau modèle ne me conviennent pas, puis-je revenir à l’ancien Quality ?
Il ne faut pas compter dessus. Le retrait est imposé par le fournisseur en amont, et l’accès à l’ancien modèle sous-jacent Quality n’est pas garanti. Vous pouvez ajuster le paramètre quality, passer à un autre modèle validé pour votre usage ou désactiver temporairement la fonctionnalité concernée. Prévoir une solution de rechange déjà testée et utiliser l’interface unifiée d’APIYI apiyi.com pour comparer plusieurs modèles vous laissera plus de marge que d’improviser en urgence.
Q6 : Image 2.0 est-il meilleur que l’ancienne version ?
Il n’y a pas de réponse universelle. Lors de son lancement, xAI indiquait qu’il occupait alors la deuxième place des classements Arena pour la génération de texte vers image et la modification d’image : c’était le résultat au 7 août. Un instantané d’Arena datant de fin octobre le plaçait cinquième du classement général en modification d’image unique et sixième en texte vers image. Dans la communauté, certains utilisateurs se sont aussi dits insatisfaits du rendu réaliste et de la fidélité à l’image d’origine. Les capacités annoncées par le fournisseur, les tests indépendants et les préférences subjectives mesurent des choses différentes. Le critère le plus fiable reste votre propre jeu de tests métier.
Points clés pour gérer les versions des API d’IA
- Un appel réussi ne signifie pas que le modèle est inchangé : l’ancien identifiant de Grok Imagine ne renvoie pas d’erreur, mais pointe désormais silencieusement vers 2.0 Low.
- Les alias peuvent entraîner des redirections en chaîne : pro → quality → 2.0 Low. Vérifier uniquement la chaîne de configuration ne suffit pas.
- Les valeurs par défaut peuvent aussi changer : auto choisit actuellement low pour la génération et medium pour la modification. Mieux vaut les préciser explicitement.
- Le coût se mesure sur la facture réelle : la modification inclut des frais d’entrée pour l’image de référence. La baisse totale ne correspond donc pas forcément à celle du prix de sortie.
- HTTP 200 ne garantit pas la réussite métier : une tâche asynchrone en état failed peut elle aussi renvoyer 200.
- Les stratégies varient selon les fournisseurs : redirection, échec, bascule à chaud de Latest et instantané figé demandent chacun un traitement adapté.
- Commencez par les journaux : sur APIYI apiyi.com, utilisez le crédit de test pour mettre en place l’enregistrement des deux champs : modèle demandé et modèle exécuté.
En résumé
Les principaux enseignements de cette migration de Grok Imagine :
- Les stratégies de compatibilité peuvent masquer les changements : xAI a choisi une redirection transparente pour les clients. Les changements de modèle, de niveau et de prix unitaire ne se manifestent donc pas par des erreurs.
- La gestion des versions exige des mécanismes distincts : enregistrer à la fois le modèle demandé et le modèle exécuté, suivre les coûts réels et valider les résultats métier va au-delà de la simple surveillance de disponibilité.
- Le retour en arrière doit être prévu à l’avance : la mise hors service imposée par le fournisseur est irréversible. Il faut donc pouvoir compter sur des modèles et des paramètres de remplacement déjà validés.
Faites une vérification dès aujourd’hui : recherchez les anciens identifiants de modèle dans votre code, comparez-les au champ model des réponses, fixez explicitement le paramètre quality pour les tâches de modification et de génération, et préparez un jeu d’échantillons de test stable. Vous pouvez utiliser l’interface unifiée d’APIYI apiyi.com pour mettre en place un environnement de comparaison entre plusieurs modèles et améliorer la visibilité sur les versions avant le prochain changement du fournisseur.
📚 Ressources
- Guide de migration des modèles d’image xAI du 2 novembre 2026 : règles de retrait et de redirection
- Lien :
docs.x.ai/developers/migration/imagine-image-quality-nov-2 -
Description : source officielle sur les identifiants retirés, les modèles de remplacement, les niveaux de qualité et le périmètre concerné
-
Historique des retraits xAI du 15 mai 2026 : migration de l’identifiant pro
- Lien :
docs.x.ai/developers/migration/may-15-retirement -
Description : ressource essentielle pour comprendre les redirections en chaîne
-
Tarifs officiels xAI et page du modèle Image 2.0 : résolutions et prix unitaires par niveau
- Lien :
docs.x.ai/developers/pricing -
Description : base de calcul des coûts des images générées et des images de référence en entrée
-
Documentation xAI sur les paramètres de génération d’images : valeur par défaut de quality et statut asynchrone
- Lien :
docs.x.ai/developers/model-capabilities/images/generation -
Description : comportement de auto et codes HTTP du mode deferred
-
xAI Cost Tracking : champ du coût réel par requête
- Lien :
docs.x.ai/developers/cost-tracking -
Description : signification de cost_in_usd_ticks et méthode de conversion
-
Documentation Anthropic sur la dépréciation des modèles : les quatre étapes du cycle de vie d’un modèle
- Lien :
docs.anthropic.com/en/docs/about-claude/model-deprecations -
Description : comparaison avec la politique d’échec des requêtes après le retrait d’un modèle
-
Documentation Google sur les versions des modèles Gemini : différence entre Stable et Latest
- Lien :
ai.google.dev/gemini-api/docs/models -
Description : mécanisme de bascule automatique des alias
-
Guide OpenAI sur l’ingénierie des invites et l’API : fixation des instantanés et recommandations d’évaluation
- Lien :
developers.openai.com/api/docs/guides/prompt-engineering -
Description : recommandations officielles pour fixer un instantané en production et créer un jeu d’évaluation
-
Google SRE Canary Release : méthode de déploiement progressif
- Lien :
sre.google/workbook/canarying-releases/ -
Description : validation sur une faible part du trafic pour limiter l’impact des changements
-
Conventions sémantiques OpenTelemetry pour l’IA générative : attributs des modèles dans les requêtes et les réponses
- Lien :
opentelemetry.io/docs/specs/semconv/registry/attributes/gen-ai/ - Description : définitions de gen_ai.request.model et gen_ai.response.model
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI. Pour plus de ressources sur l’intégration, consultez le centre de documentation docs.apiyi.com.