Cet article s’appuie sur les cas de migration, de service client et de code de GPT-6.1 Sol et GPT-6.2 Sol pour montrer comment fixer d’abord les critères d’acceptation métier, puis choisir le niveau de raisonnement capable de les respecter de manière stable, et enfin calculer le coût de chaque tâche validée.
Pour faire court : lorsqu’on ajuste le niveau, ce qu’il faut comparer, c’est « combien coûte et combien de temps prend chaque tâche validée » ; le prix affiché d’un appel n’est qu’un élément parmi d’autres. Dans les tests publics réalisés sur un petit échantillon, le niveau low de GPT-6.2 Sol a obtenu le même nombre de réussites que medium sur des questions de politique de service client et sur une série d’exercices de code, tout en prenant moins de temps. Sur les exercices de code, le coût équivalent au prix affiché de low représente environ 70 % de celui de medium. Cette conclusion n’est valable qu’à deux conditions : vos tâches doivent être suffisamment proches de celles des tests, et le seuil d’acceptation ne doit pas se limiter au taux de réussite : il doit aussi vérifier les liens inventés, les champs de montant et les reprises. Pour les tâches marquées par des conflits entre sources, des dépendances complexes aux outils ou un risque d’oublier des contraintes, il faut toujours valider séparément le niveau medium et au-delà.
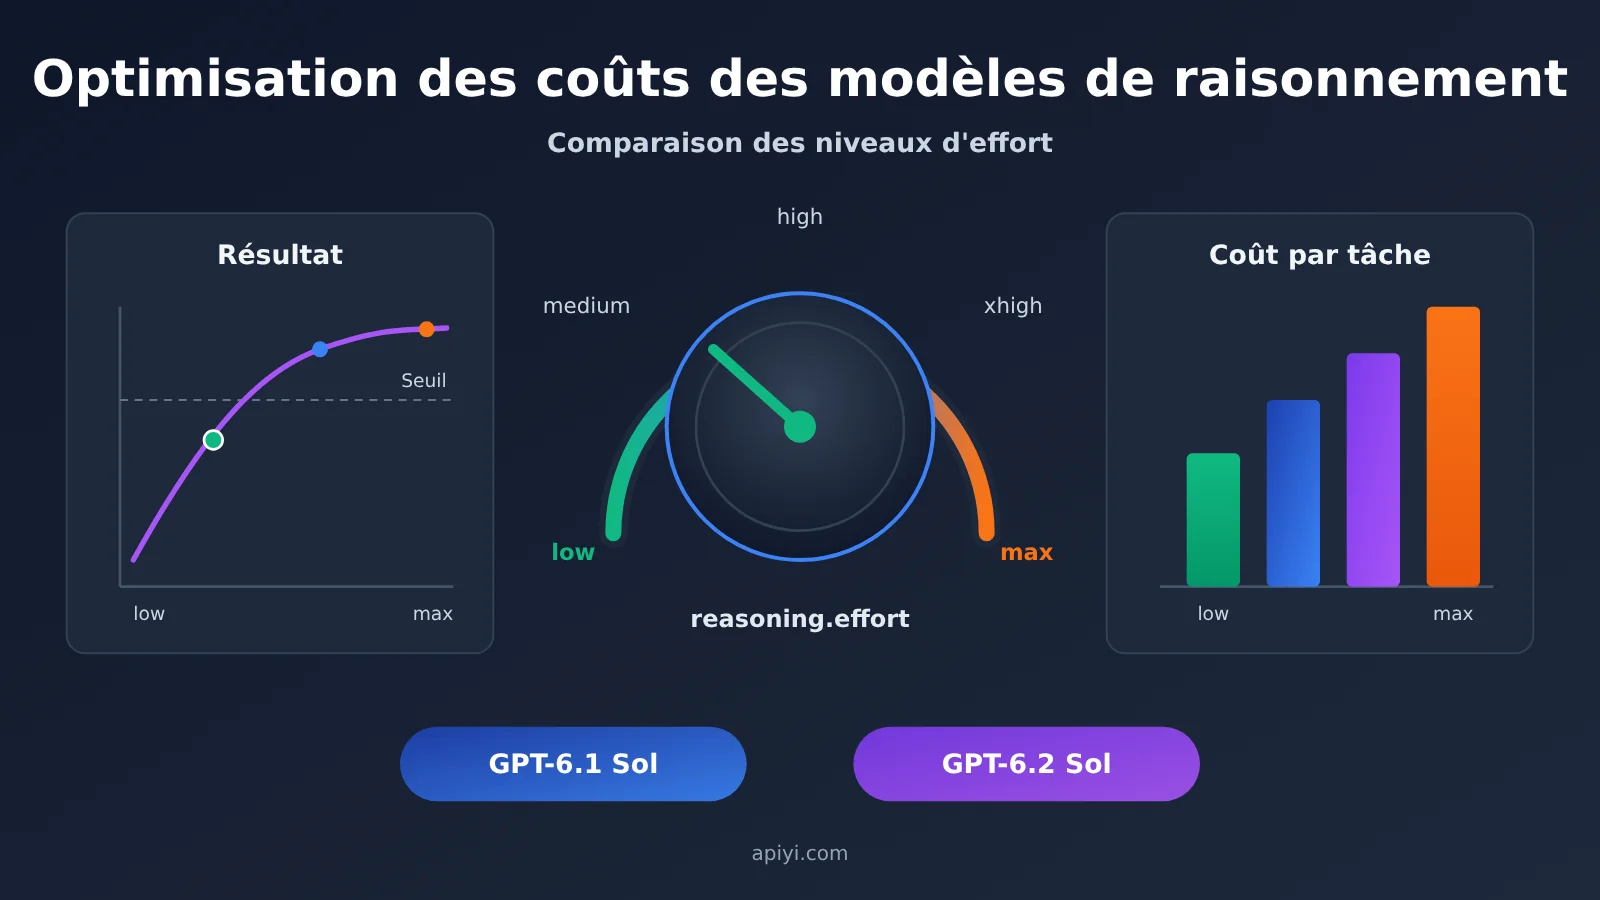
Aperçu comparatif des paliers d’effort des modèles de raisonnement
Le tableau ci-dessous rassemble les quelques jeux de preuves utilisés dans cet article ; chaque ligne précise la source et la méthode de mesure. Les chiffres venant de sources différentes ne peuvent ni s’additionner ni se mélanger.
| Dimension de comparaison | GPT-6.1 Sol | GPT-6.2 Sol | Ce que la différence implique |
|---|---|---|---|
| Paliers disponibles (doc OpenAI) | low, medium, high, xhigh, max | les cinq mêmes, none refusé |
Quand on migre depuis un modèle où l’on peut régler none/minimal, il faut changer le palier de départ |
| Tarif APIYI en contexte court (tableau du 20/11/2026, USD par million de tokens) | entrée 2 $, lecture du cache 0,10 $, sortie 10 $ | idem | En contexte court, les deux générations sont au même prix ; l’écart de coût vient surtout du volume d’usage |
| Prix d’entrée au-delà de 272 000 tokens en entrée | APIYI et OpenAI Standard affichent tous deux 4 $ | APIYI affiche 3 $, OpenAI Standard 4 $ | Sur les entrées longues, un écart de prix apparaît entre les canaux |
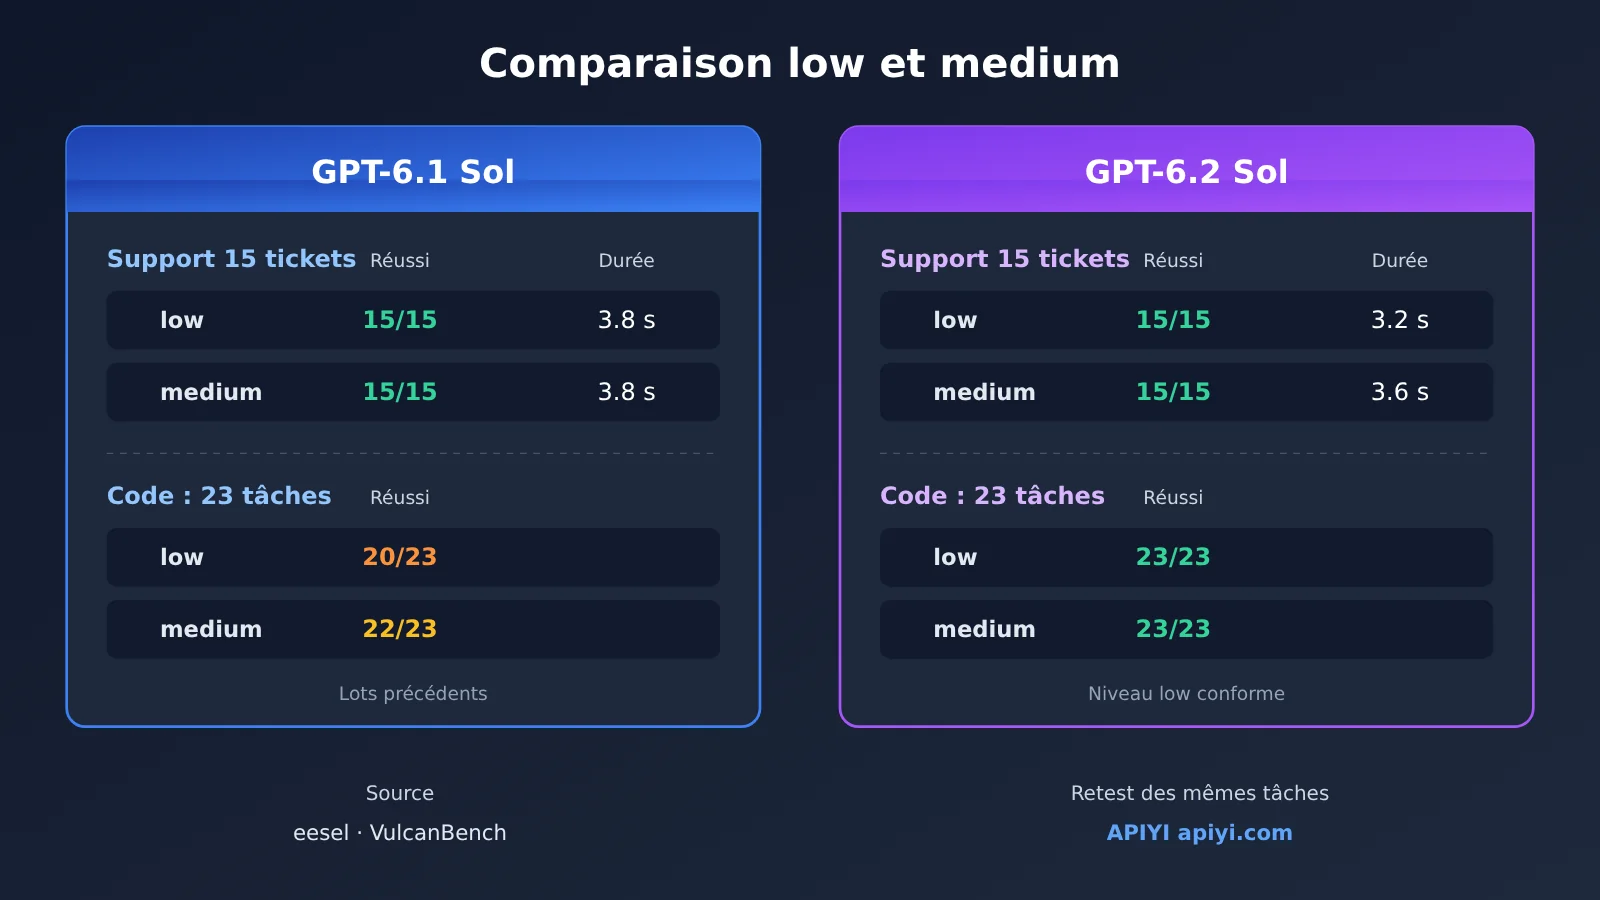
| eesel, 15 tickets de support (low / medium) | 15/15, 3,8 s ; 15/15, 3,8 s | 15/15, 3,2 s ; 15/15, 3,6 s | Taux de réussite identique ; l’écart de coût entre paliers est minime |
| VulcanBench, 23 exercices de code (low / medium) | 20/23 ; 22/23 (lots historiques) | 23/23 ; 23/23 | En low, 6.2 Sol est déjà au niveau ; les chiffres entre versions viennent de lots différents |
| Artificial Analysis Index (cité via OrcaRouter, low / medium) | 35 ; 46 | 41 ; 53 | Indice composite d’un tiers ; les étiquettes de palier sont mappées par l’évaluation elle-même |
Le corps de l’article se déroule dans cet ordre : la section 1 vérifie si le modèle est accessible et comment il est facturé, la section 2 présente les résultats mesurés sur les mêmes tâches, la section 3 détaille les étapes de migration et de recette, la section 4 traite du changement de palier en cours de conversation multi-tours. Si vous avez déjà validé le routage du modèle et le prix, vous pouvez attaquer directement à la section 2.
Termes à connaître sur les niveaux d’effort de raisonnement
| Terme | Explication |
|---|---|
reasoning.effort |
Champ de l’API Responses qui sert à définir l’intensité de réflexion du modèle |
| Tokens de raisonnement | Volume de raisonnement consommé par le modèle pour parvenir à sa réponse. Il est inclus dans les output_tokens facturés et doit être distingué de la sortie visible par l’utilisateur |
low / medium |
Les deux niveaux de raisonnement. Quand un même niveau passe à une nouvelle version, une nouvelle validation reste nécessaire |
| Prix unitaire de lecture du cache | Ne s’applique qu’à la portion d’entrée qui touche un préfixe réutilisable ; impossible à calculer directement à partir du nombre total de tokens |
| Préfixe de requête | Le contexte déjà présent avant le message en cours. Modifier l’historique ancien affecte la réutilisation du cache et des éléments de raisonnement |
configuration_update |
Élément d’entrée utilisé, dans les sessions Responses qui prennent en charge cette fonction, pour ajuster la configuration des tours suivants |
| Seuil de validation | Niveau minimal acceptable fixé pour la conformité aux règles, la réussite fonctionnelle ou le niveau de reprise |
| Coût par tâche conforme | Coût total de l’essai (appels, nouvelles tentatives, outils et reprises manuelles) divisé par le nombre de tâches conformes |
1. Avant d’optimiser le coût d’un modèle de raisonnement : quand cela vaut-il la peine d’ajuster le niveau d’effort
1.1 L’intégration des deux générations de Sol sur APIYI
D’après les actualités de la plateforme APIYI, GPT-6.1 Sol a été mis en ligne le 2026-09-30, et GPT-6.2 Astra ainsi que Sol ont été annoncés en ligne le 2026-11-18. Le tableau tarifaire général du 2026-11-20 montre que les deux Sol proposent en même temps deux routes, responses et chat, et que les groupes concernés sont CodexResponses, Codex_Reverse, Default et SVIP. Les capacités réellement accessibles à un compte dépendent du groupe auquel appartient le jeton.
Selon la documentation OpenAI, les deux générations de Sol prennent en charge Chat Completions et Responses, mais les appels d’outils doivent obligatoirement passer par Responses, et le niveau se règle via reasoning.effort. Donc dès que votre activité comporte des étapes outillées comme la consultation de commandes ou l’exécution de code, l’évaluation comme la mise en production doivent se faire uniformément via la route Responses, pour éviter que les différences de comportement entre les deux routes ne viennent fausser les résultats comparatifs.
1.2 Deux grilles tarifaires : les prix affichés par APIYI et les prix standard de l’amont
| ID du modèle (tableau général APIYI, 2026-11-20) | Entrée standard | Lecture du cache | Sortie | Plateformes disponibles |
|---|---|---|---|---|
gpt-6.2-sol |
$2 | $0.10 | $10 | APIYI apiyi.com, OpenAI officiel |
gpt-6.1-sol |
$2 | $0.10 | $10 | APIYI apiyi.com, OpenAI officiel |
gpt-6-sol |
$2 | $0.20 | $10 | APIYI |
gpt-6.2-astra |
$8 | $0.40 | $40 | APIYI |
Le tableau ci-dessus donne les tarifs par défaut pour un contexte court, en dollars par million de tokens. La fiche tarifaire amont compilée par OrcaRouter indique des prix d’entrée, de lecture du cache et de sortie identiques pour les deux générations de Sol, et ajoute séparément l’écriture du cache à $2.50. Le contexte long demande une vérification à part : pour gpt-6.2-sol, au-delà de 272,000 tokens d’entrée, APIYI affiche actuellement $3, tandis que l’OpenAI officiel Standard affiche $4 ; pour gpt-6.1-sol, c’est $4 des deux côtés. Pour les tarifs de cache et de sortie en contexte long, référez-vous aux règles de facturation en temps réel de chaque canal.
1.3 Lire les coûts depuis la réponse réelle et la facturation
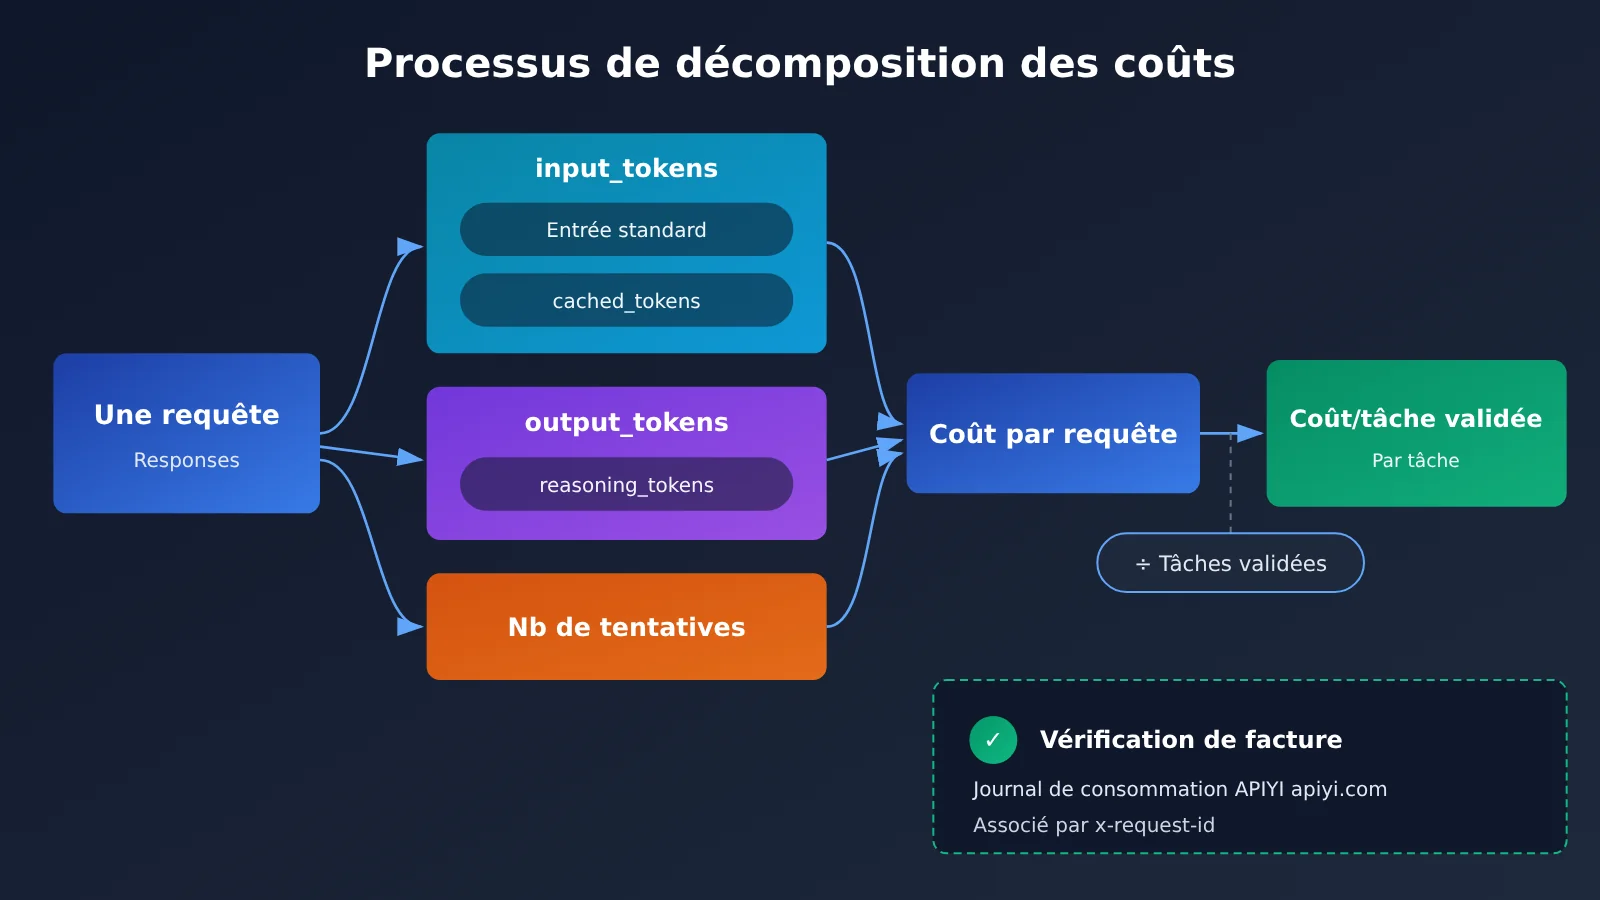
Les prix affichés ne servent qu’à estimer. Voici un exemple chiffré hypothétique pour montrer comment un coût se décompose. On suppose 12 000 tokens en entrée à chaque tour, sans écriture de cache ni frais d’outils :
- Préfixe conservé : 9 000 lectures de cache, 1 000 tokens en sortie au total, soit environ $0.0169 estimés.
- Préfixe modifié : les lectures de cache tombent à 3 000, la sortie totale monte à 1 600, soit environ $0.0343 estimés.
Dans l’écart entre les deux, environ $0.0114 viennent de 6 000 tokens d’entrée repassés du tarif cache au tarif normal, et environ $0.0060 viennent des 600 tokens de sortie supplémentaires. Ce sont des données hypothétiques ; l’écart réel se lit dans usage. S’il existe une ligne distincte pour l’écriture de cache, il faut traiter l’entrée normale, la lecture de cache et l’écriture de cache comme trois catégories mutuellement exclusives et les calculer séparément.
Méthode de vérification de la facturation réelle : utiliser le x-request-id de l’en-tête de réponse pour retrouver l’enregistrement type=2 correspondant dans les journaux de consommation APIYI, convertir quota ÷ 500,000 en valeur facturée en dollars, et noter en même temps le modèle, le groupe de jetons, la fenêtre horaire de l’appel, les volumes d’entrée et de sortie, ainsi que le nombre de tentatives.
Voici un exemple d’appel minimal, qui lit en même temps les champs d’usage nécessaires au diagnostic :
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # interface compatible OpenAI d'APIYI
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "low"},
    input=[{"role": "user", "content": "根据退款政策判断工单 #1024 是否可退"}],
)

u = resp.usage
print(resp.output_text)
print("entrée :", u.input_tokens, "cache touché :", u.input_tokens_details.cached_tokens)
print("sortie totale :", u.output_tokens, "dont raisonnement :", u.output_tokens_details.reasoning_tokens)
🚀 Démarrage rapide : je vous conseille de commencer par exécuter l’exemple ci-dessus avec le crédit gratuit offert aux nouveaux utilisateurs sur APIYI apiyi.com, de vérifier que le groupe cible renvoie bien
cached_tokensetreasoning_tokens, puis de lancer l’évaluation à grande échelle.
2. Comparaison à tâche identique : les résultats mesurés des niveaux low et medium
2.1 Tickets de support client : le niveau low apporte peu
Le 2026-11-18, les testeurs d’eesel ont mesuré via l’API Responses les niveaux low et medium sur les deux générations de Sol, pour un total de 60 appels. Chaque configuration couvre les mêmes 15 tickets — remboursements, recherches de suivi logistique et échecs d’outils de commande —, notés à la main d’après une politique SaaS fictive.
| Configuration (eesel, 15 tickets) | Réussis | Durée moyenne | Équivalent tarifaire / 1 000 tickets |
|---|---|---|---|
| GPT-6.1 Sol low | 15/15 | 3,8 s | 1,32 $ |
| GPT-6.1 Sol medium | 15/15 | 3,8 s | 1,35 $ |
| GPT-6.2 Sol low | 15/15 | 3,2 s | 1,41 $ |
| GPT-6.2 Sol medium | 15/15 | 3,6 s | 1,42 $ |
Dans ces données, low et medium ne diffèrent que de quelques centimes par millier de tickets : le choix du niveau se fait donc plutôt sur la latence que sur le coût. Autre point : en convertissant selon l’usage réellement mesuré, GPT-6.2 Sol revient légèrement plus cher que 6.1 Sol sur ce jeu de questions de support. Plus important encore : bien que les quatre configurations affichent un taux de réussite parfait, les auteurs ont constaté que 6.2 Sol génère des liens de suivi logistique qui n’existent pas dans la réponse de l’outil. Cela signifie que si la validation du support se contente de vérifier « la bonne réponse à la politique », elle laisse passer ce type de problème : la provenance des liens et des champs doit être contrôlée séparément. Ces éléments ne valent que pour ce jeu de tickets, cette grille d’évaluation et l’environnement de test OpenAI.
2.2 Tâches de code : le coût par tâche du niveau low mérite d’être mesuré
Le 19 novembre 2026, VulcanBench a exécuté GPT-6.2 Sol avec Codex, niveau par niveau, sur le même jeu de 23 tâches, soit 115 exécutions au total. Les montants du tableau ci-dessous sont convertis à partir des reçus d’exécution selon le tarif catalogue de l’API ; il ne s’agit pas du règlement réel du compte APIYI.
| Configuration (VulcanBench, 23 tâches) | Réussites | Durée moyenne | Coût catalogue/tâche | Score global |
|---|---|---|---|---|
| GPT-6.2 Sol low | 23/23 | 2,8 minutes | $0.23 | 88.44 |
| GPT-6.2 Sol medium | 23/23 | 4,4 minutes | $0.33 | 88.94 |
| GPT-6.2 Sol max | — | 11,3 minutes | $0.55 | 88.74 |
| GPT-6.1 Sol low (lot historique) | 20/23 | 6,9 minutes | $0.31 | — |
| GPT-6.1 Sol medium (lot historique) | 22/23 | 10,6 minutes | $0.40 | — |
Si l’on ne regarde que le groupe GPT-6.2 Sol : low et medium obtiennent le même nombre de réussites, le coût par tâche y est inférieur d’environ 30 % et la durée est plus courte ; le score global de max ne dépasse pas celui de medium. La comparaison entre versions demande de la prudence : les données de 6.1 Sol proviennent d’une évaluation historique sur le même jeu de tâches, mais d’un lot de tests différent. Le score global est une note de qualité du code ; le taux de réussite aux tests est un autre indicateur, et l’un ne remplace pas l’autre.
L’Artificial Analysis Index v5.0.1, repris par OrcaRouter (consulté le 20 novembre 2026), apporte un autre éclairage : au niveau low, 6.2 Sol obtient 41 points pour $0.18 par tâche, contre 35 points et $0.16 pour 6.1 Sol ; au niveau medium, respectivement 53 points et $0.41, et 46 points et $0.36. Les étiquettes de niveaux de ce classement global correspondent à la propre logique de correspondance de l’évaluateur ; le framework que vous utilisez n’adopte pas forcément la même.
💡 Conseil de choix : les deux mesures ci-dessus montrent que le seuil de validation, le taux de réessai et les retouches manuelles peuvent tous modifier le « niveau le plus rentable », mais aucun ne représente la facture de votre propre activité. Je vous recommande de refaire le test sur APIYI apiyi.com, avec le même groupe et le même lot d’échantillons, avant de prendre une décision.
3. Ordre de migration et seuils d’acceptation pour optimiser les coûts des modèles de raisonnement
3.1 Conserver d’abord la référence, puis ajuster le niveau
Selon les recommandations d’OpenAI dans « Using GPT-6.2 », ne changez qu’une variable à la fois lors de la migration :
- Si vous utilisez actuellement 6.1 Sol
low: passez d’abord à 6.2 Sollowpour établir la comparaison, puis testezmediumséparément. - Si vous utilisez actuellement 6.1 Sol
medium: changez d’abord de modèle en conservantmedium; une fois la validation passée, comparez aveclowsur le même lot de tâches. - Nouvelle intégration : commencez par
medium. - Migration depuis un modèle qui accepte
noneouminimal: testez GPT-6.2 Sol en démarrant àlow.
Pour les tâches simples aux contraintes bien définies, vous pouvez commencer la validation à low ; pour les tâches composites, montez d’un niveau à la fois en fonction des résultats. Pendant l’évaluation, gardez fixes les invites, les définitions d’outils, les groupes et les échantillons de test. Supprimez aussi, conformément à la documentation officielle, les paramètres qui ne s’appliquent plus : par exemple, retirez temperature, top_p et top_logprobs des requêtes Responses.
3.2 Définir les seuils d’acceptation selon le scénario
| Scénario | Seuil d’acceptation | Quand envisager de monter d’un niveau |
|---|---|---|
| Service client courant | Cohérence des politiques, exactitude des champs de montant, conditions de déclenchement de l’escalade vers un humain ; les liens et numéros de dossier doivent provenir du retour d’outil | Lorsque des conflits entre politiques ou des chaînages de plusieurs outils entrent en jeu |
| Modification de code | Tests au vert, fonctionnalités clés complètes, volume de reprise en revue de code | Lorsque le taux de réussite du niveau bas baisse ou que les reprises augmentent nettement |
| Contenu court | Respect des contraintes, exactitude des champs factuels, temps de correction manuelle | En cas de contraintes manquées ou d’erreurs factuelles |
Le coût par tâche conforme se calcule ainsi : additionnez les coûts d’appel, de nouvelle tentative, d’outils et de reprise manuelle, puis divisez par le nombre de tâches conformes. Tant que low atteint le seuil convenu, vous pouvez le choisir ; mais si low exige de nombreuses reprises ou des rattrapages manuels, l’économie affichée peut être annulée.
💰 Optimisation des coûts : pour comparer les niveaux, vous pouvez créer des jetons dédiés à l’évaluation sur APIYI apiyi.com ; les logs seront alors filtrables directement par jeton et par modèle, ce qui facilite le calcul du coût réel de toute la série de tests.
4. Ajuster le niveau d’effort en cours de conversation multi-tours
4.1 Changer de niveau avec configuration_update tout en conservant le préfixe
Dans une session mono-agent OpenAI HTTP Responses qui prend en charge cette fonctionnalité, laissez le reasoning.effort au niveau de la requête à sa valeur initiale, et placez l’élément suivant juste avant le message utilisateur suivant :
{"type": "configuration_update", "reasoning": {"effort": "medium"}}
Ce réglage reste actif jusqu’à la prochaine mise à jour. L’avantage : pas besoin de réécrire l’historique ancien, le préfixe de la requête reste identique. D’après la documentation OpenAI, à partir de GPT-6.2, modifier l’historique ancien peut déclencher prefix_mismatch, ce qui entraîne la suppression des éléments de raisonnement existants ; changer de famille de modèles ou passer à un modèle moins capacitif peut également supprimer des éléments de raisonnement. Réécrire le préfixe a deux coûts : les lectures de cache peuvent diminuer, et la perte d’éléments de raisonnement disponibles peut produire de nouvelles sorties de raisonnement. Selon la documentation officielle, supprimer un élément complet en laissant les autres inchangés, ou ajouter de nouveaux éléments après un élément de raisonnement, ne déclenche pas cette suppression, mais le nombre de hits de cache peut quand même varier. Par ailleurs, dans GPT-6.2, le champ instructions de premier niveau est ajouté après input et facturé comme entrée non mise en cache.
4.2 Compression de contexte et points d’attention avec le routage APIYI
Lorsque vous utilisez context_management côté serveur, la configuration mise à jour peut être conservée. Si vous envoyez directement à l’endpoint autonome /responses/compact un historique contenant un ancien configuration_update, la requête sera rejetée ; la bonne approche consiste à séparer d’abord l’élément de configuration comme indiqué dans la doc officielle, puis à ajouter une configuration à jour une fois la compression terminée.
Sur APIYI, l’approche prudente actuelle consiste à gérer soi-même l’historique input, sans dépendre de previous_response_id. La raison : le guide d’appel natif d’APIYI est incohérent sur ce point — le corps du texte indique que la reprise en chaîne ne fonctionne pas, tandis que la FAQ note qu’un test du 2026-09-02 l’a trouvée fonctionnelle. La documentation APIYI ne liste pas non plus les résultats de validation de configuration_update par groupe. Par conséquent, ces configurations spécifiques, le renvoi d’éléments de raisonnement chiffrés et les champs de diagnostic de cache doivent d’abord être vérifiés séparément sur le canal cible avec une session courte, avant d’être intégrés au workflow de production.
🎯 Conseil technique : vous pouvez commencer par lancer une série de sessions courtes de deux tours sur la route Responses de APIYI apiyi.com, comparer
cached_tokens,reasoning_tokenset la latence entre deux échantillons « ajout seul » et « réécriture du préfixe », puis décider, une fois le comportement confirmé, de la manière d’implémenter le changement de niveau en cours de route.
Le mot de la fin : le choix du niveau devrait se fonder sur le coût par tâche conforme au seuil d’acceptation fixé. Sur APIYI apiyi.com, une comparaison menée avec vos propres échantillons et votre facture en dit plus que n’importe quel classement.
Références
- OpenAI « Using GPT-6.2 » : conseils de migration et de niveau de départ
- Lien :
developers.openai.com/api/docs/guides/latest-model
- Lien :
- OpenAI « Reasoning models » :
configuration_updateet réutilisation des éléments de raisonnement- Lien :
developers.openai.com/api/docs/guides/reasoning
- Lien :
- OpenAI « Compaction » : règles de compression du contexte
- Lien :
developers.openai.com/api/docs/guides/compaction
- Lien :
- OpenAI « Keep the prefix unchanged » : diagnostic du préfixe et du cache
- Lien :
developers.openai.com/api/docs/guides/keep-prefix-unchanged
- Lien :
- eesel AI « GPT-6.2 Sol: what’s new, pricing, benchmarks » : test réel sur des tickets de support client, 2026-11-18
- Lien :
eesel.ai/blog/gpt-6-2-sol
- Lien :
- VulcanBench « GPT-6.2 Sol across effort levels » : évaluation niveau par niveau sur des exercices de code, 2026-11-19
- Lien :
vulcanbench.com/benchmarks/swe-v4-gpt62-sol-v331.html
- Lien :
- OrcaRouter « GPT-6.2 vs GPT-6.1 Sol » : grille tarifaire et reprise d’indices composites, 2026-11-20
- Lien :
orcarouter.ai/blog/gpt-6-2-vs-gpt-6-1-sol
- Lien :
- APIYI « Tableau récapitulatif des prix des modèles » : données mises à jour au 2026-11-20
- Lien :
docs.apiyi.com/models
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil d’APIYI apiyi.com ; pour en savoir plus sur l’intégration, consultez le centre de documentation docs.apiyi.com