Note de l’auteur : comparaison des tarifs d’entrée par paliers de GPT-6.2 Sol et de 6.1 Sol sur APIYI, avec un exemple de document long de 300 000 Tokens pour illustrer l’écart de coût d’entrée au-delà du seuil, et une liste de contrôle pour la vérification des coûts.
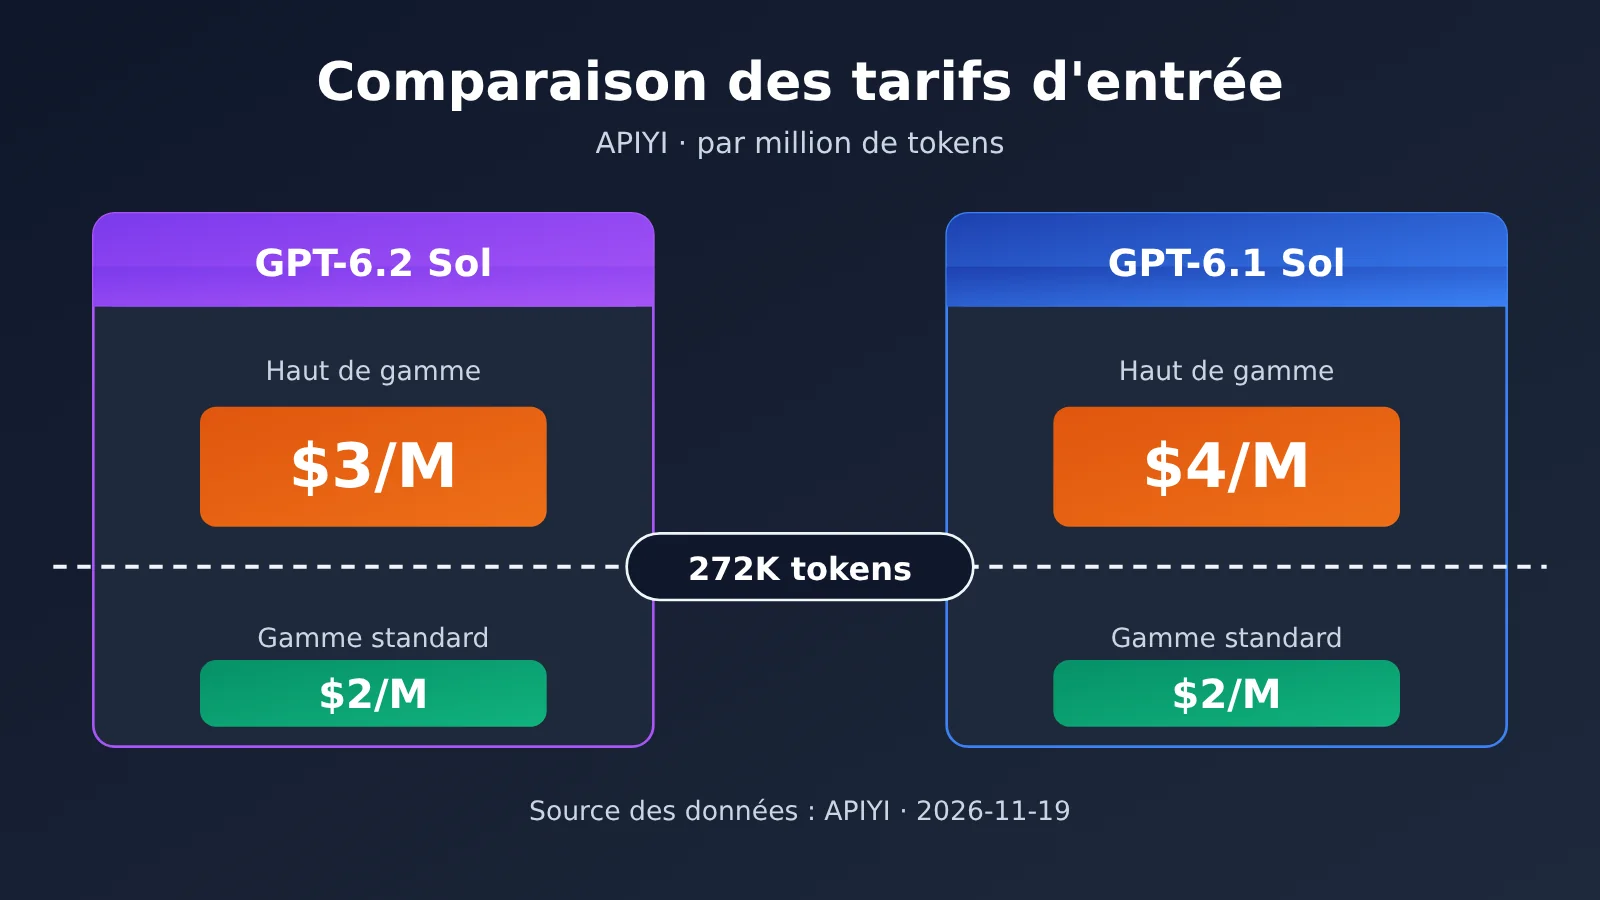
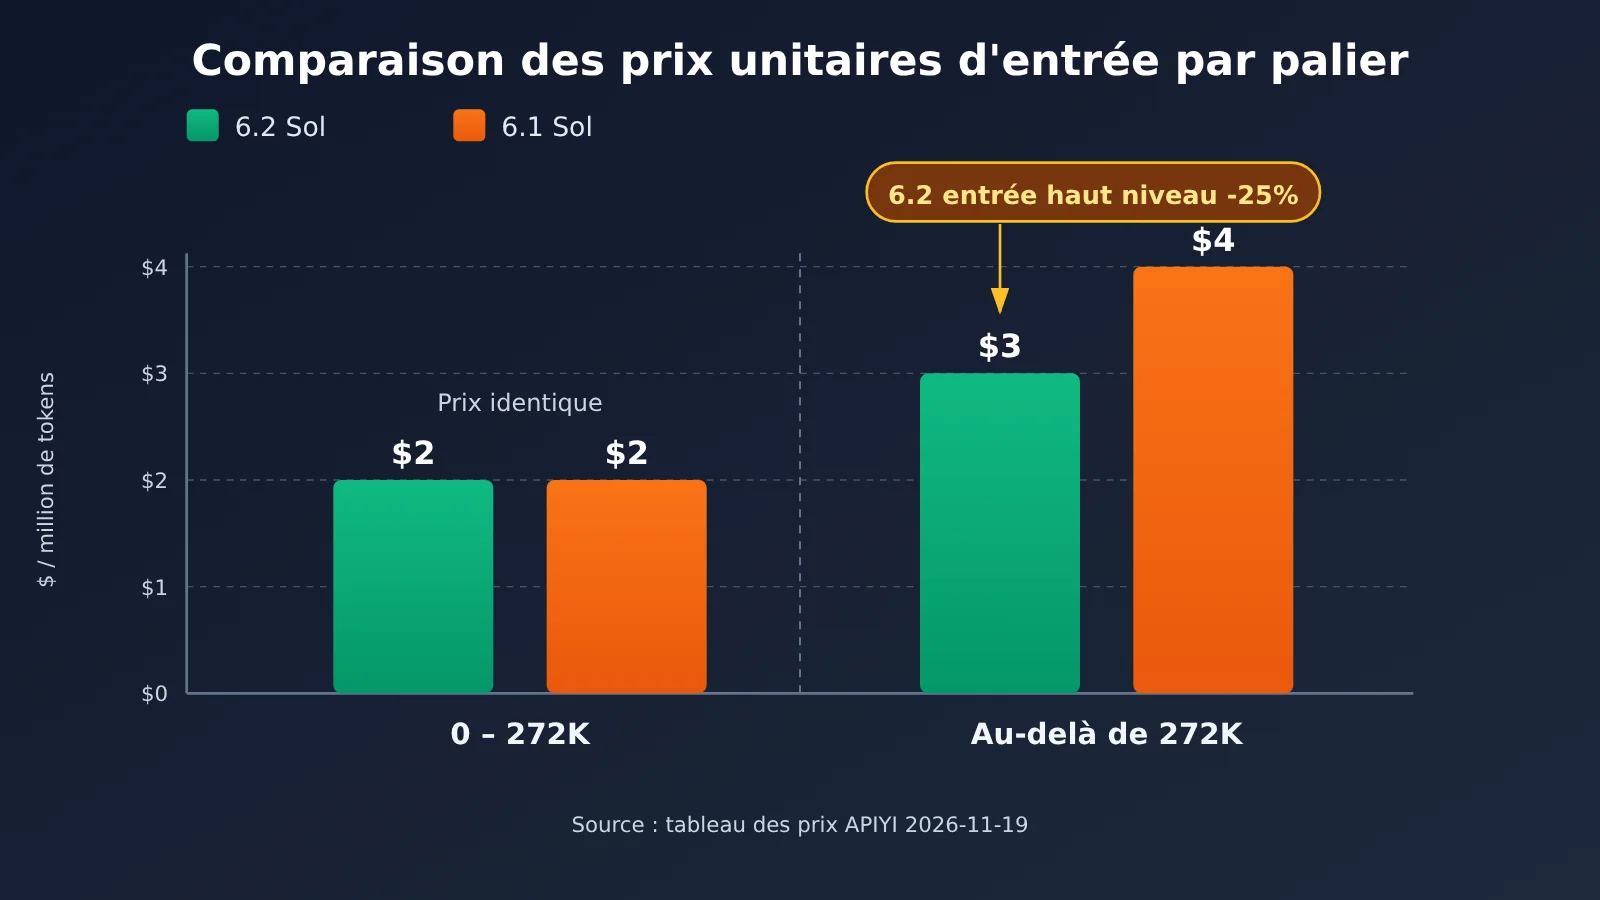
Commençons par la conclusion : pour une entrée unique de moins de 272 000 Tokens, GPT-6.2 Sol et 6.1 Sol sont tous deux facturés $2 par million de Tokens chez APIYI — choisir l’un ou l’autre ne fait rien économiser sur ce tarif. La différence n’apparaît que dans le palier supérieur, au-delà de 272 000 Tokens. Le tableau tarifaire global d’APIYI indique un tarif d’entrée du palier supérieur de $3 pour 6.2 Sol et de $4 pour 6.1 Sol (par million de Tokens) : le prix haut de gamme de 6.2 Sol est donc inférieur de 25 %.
Ce n’est pas une facture réelle. Tous les chiffres de cet article proviennent du tableau des prix des modèles APIYI consulté sur apiyi.com le 2026-11-19. L’exemple de 300 000 Tokens n’est qu’une illustration du coût d’entrée calculé selon des hypothèses de facturation spécifiques ; il ne représente pas le coût total d’une commande et n’inclut ni la sortie ni le cache.
L’essentiel : après avoir lu cet article, vous saurez déterminer si vos tâches sur documents longs basculent dans le palier supérieur, calculer l’écart de coût d’entrée entre GPT-6.2 Sol et 6.1 Sol, et connaître les postes à vérifier avant la mise en production.
GPT-6.2 Sol vs 6.1 Sol : l’essentiel des différences — la tarification par paliers des entrées
Les deux modèles utilisent une tarification par paliers sur APIYI, avec un seuil à 272 000 tokens. Le tableau ci-dessous met côte à côte les tarifs d’entrée de part et d’autre de ce seuil ; les données proviennent des explications sur la tarification par paliers de la table des prix des modèles APIYI, consultée le 2026-11-19.
| Plage d’entrée | Tarif d’entrée gpt-6.2-sol | Tarif d’entrée gpt-6.1-sol | Écart | Source des données |
|---|---|---|---|---|
| 0 – 272 000 tokens | 2 $ / million de tokens | 2 $ / million de tokens | Identique | Table des prix APIYI apiyi.com |
| Au-delà de 272 000 tokens | 3 $ / million de tokens | 4 $ / million de tokens | 6.2 : 25 % moins cher | Table des prix APIYI |
À noter : ce tableau ne couvre que le tarif d’entrée. La table publique d’APIYI ne permet pas d’en conclure que tous les groupes appliquent le palier haut à la facture entière, et cette note ne donne pas non plus les tarifs haut palier pour la sortie et le cache. Autrement dit, « l’entrée de 6.2 Sol coûte 25 % de moins au palier haut » ne se traduit pas directement par « 25 % de moins sur toute la facture » : pour cela, il faut vérifier avec la facture réelle de votre groupe.
Par ailleurs, la fiche modèle officielle d’OpenAI décrit elle aussi ses propres paliers pour gpt-6.2-sol. Les règles officielles de l’éditeur et les tarifs affichés par APIYI relèvent de deux référentiels distincts : cet article ne mélange pas les calculs, tous les chiffres cités sont les tarifs de la plateforme APIYI. Pour connaître les règles de l’éditeur, consultez séparément la fiche modèle officielle.
GPT-6.2 Sol face à 6.1 Sol : exemple de calcul pour 300 000 tokens d’entrée
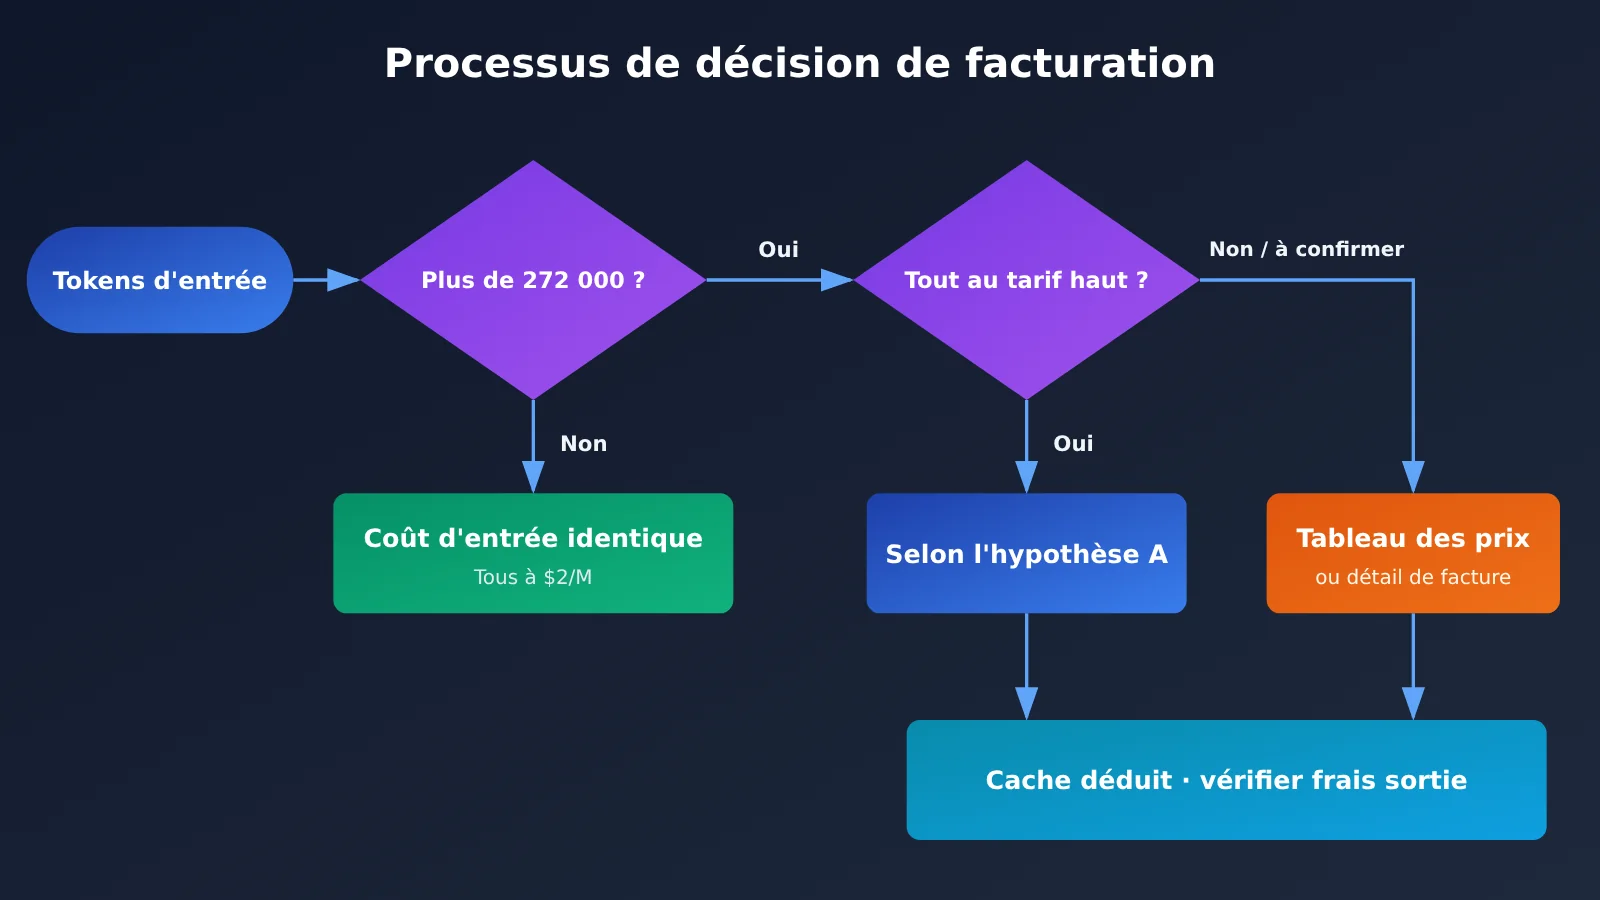
Imaginons qu’une requête ait en entrée 300 000 tokens, et qu’aucun token ne soit servi depuis le cache. On dépasse déjà le seuil de 272 000, et tout dépend de la façon dont la plateforme applique le tarif élevé à cette requête. La facturation par paliers suit couramment deux interprétations ; le tableau ci-dessous donne les résultats pour chacune.
| Hypothèse de facturation | Coût d’entrée gpt-6.2-sol | Coût d’entrée gpt-6.1-sol | Écart | Statut |
|---|---|---|---|---|
| A : tarif élevé appliqué à la totalité de l’entrée | 0.3 × $3 = $0.90 | 0.3 × $4 = $1.20 | $0.30 | Algorithme indicatif donné dans les références, routage à confirmer |
| B : tarif élevé appliqué uniquement au dépassement | 0.272 × $2 + 0.028 × $3 = $0.628 | 0.272 × $2 + 0.028 × $4 = $0.656 | $0.028 | Purement mathématique, non confirmé par la plateforme |
Si la route APIYI que vous utilisez confirme que le tarif élevé s’applique à la totalité de l’entrée, alors pour une requête de 300 000 tokens d’entrée sans cache, l’écart est de $0.30. L’hypothèse B ne sert qu’à illustrer que « selon l’interprétation retenue, l’écart peut varier d’un ordre de grandeur » ; ce n’est pas une règle publiée par la plateforme. Avant d’établir un budget, commencez par vérifier l’interprétation appliquée à votre groupe : c’est plus important que n’importe quel exemple de calcul.
Trois distinctions à faire dans un budget de longs documents : tokens, caractères et facture
Beaucoup d’écarts de budget ne viennent pas des tarifs, mais d’une confusion entre les concepts. Pour budgéter des documents longs avec GPT-6.2 Sol ou 6.1 Sol, il faut bien séparer les trois paires de notions ci-dessous.
| Concept souvent confondu | Bonne compréhension | Impact sur le budget |
|---|---|---|
| Nombre de caractères vs token | La facturation se fait en tokens ; il n’existe pas de ratio fixe entre nombre de caractères et tokens, cela varie selon la langue et le contenu | On ne peut pas appliquer directement l’exemple des 300 000 tokens à un document de « 300 000 caractères » |
| Tokens du document vs tokens d’entrée d’une requête | L’entrée d’une requête comprend aussi l’invite système, l’historique de conversation, les définitions d’outils, etc. | Un document peut rester sous le seuil, mais le dépasser une fois le contexte ajouté |
| Coût d’entrée théorique vs facture réelle | La valeur théorique est le prix catalogue multiplié par le nombre de tokens ; la facture réelle dépend aussi des hits de cache, de l’interprétation du groupe et du coût de sortie | L’exemple de calcul ne peut servir que de plafond indicatif ; fiez-vous au détail de la facture |
La méthode la plus fiable consiste à lire directement le champ usage renvoyé par l’API et à utiliser les vrais prompt_tokens pour savoir si le seuil est dépassé, plutôt que de l’estimer à partir du nombre de caractères.
Comment estimer le coût d’entrée d’un long document avec GPT-6.2 Sol et 6.1 Sol
Exemple minimal : lire le nombre réel de tokens d’entrée
Envoyez d’abord une requête pour récupérer le nombre de tokens d’entrée de ce long document tel qu’il sera réellement facturé :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # interface unifiée APIYI
)

doc = open("long_doc.txt", encoding="utf-8").read()
resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "请总结以下文档:\n" + doc}]
)
print("prompt_tokens:", resp.usage.prompt_tokens)
Voir le code complet : estimer les frais d’entrée selon deux hypothèses de facturation
import openai

# Instantané des prix : tableau des prix APIYI, consulté le 2026-11-19, en USD par million de tokens
# Tarif d'entrée uniquement ; pour la sortie et le cache, référez-vous au tableau des prix et à la facture
PRICES = {
    "gpt-6.2-sol": {"low": 2.0, "high": 3.0},
    "gpt-6.1-sol": {"low": 2.0, "high": 4.0},
}
THRESHOLD = 272_000

def estimate_input_cost(model: str, input_tokens: int, cached_tokens: int = 0,
                        mode: str = "full") -> float:
    """
    Estime le coût d'entrée théorique de la partie non mise en cache
    mode="full":     au-delà du seuil, on applique le tarif haut à la totalité (à vérifier selon votre groupe)
    mode="marginal": on applique le tarif haut uniquement à la partie excédentaire (hypothèse, non confirmée par la plateforme)
    cached_tokens est seulement déduit du calcul ; les frais de la partie en cache doivent être vérifiés à part
    """
    p = PRICES[model]
    uncached = max(input_tokens - cached_tokens, 0)
    if input_tokens <= THRESHOLD:
        return uncached / 1e6 * p["low"]
    if mode == "full":
        return uncached / 1e6 * p["high"]
    low_part = min(uncached, THRESHOLD)
    high_part = max(uncached - THRESHOLD, 0)
    return low_part / 1e6 * p["low"] + high_part / 1e6 * p["high"]

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

doc = open("long_doc.txt", encoding="utf-8").read()
resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "请总结以下文档:\n" + doc}]
)

usage = resp.usage
cached = 0
details = getattr(usage, "prompt_tokens_details", None)
if details is not None and getattr(details, "cached_tokens", None):
    cached = details.cached_tokens

for m in PRICES:
    for mode in ("full", "marginal"):
        cost = estimate_input_cost(m, usage.prompt_tokens, cached, mode)
        print(f"{m} [{mode}] 未缓存输入费估算: ${cost:.4f}")
En remplaçant par input_tokens=300_000 et cached_tokens=0, le mode full donne $0.90 et $1.20, ce qui correspond au cas de calcul A vu plus haut. Les prix du script sont un instantané à la date de consultation : pensez à les mettre à jour quand la plateforme ajuste ses tarifs.
🚀 Pour démarrer vite : le mieux est de lancer d’abord un vrai long document sur APIYI apiyi.com avec les crédits d’essai gratuits pour nouveaux utilisateurs, puis de récupérer
prompt_tokenset le détail de la facture avant de fixer votre budget. C’est bien plus fiable qu’une simple estimation au nombre de caractères.
Recommandations de scénarios : GPT-6.2 Sol face à 6.1 Sol
Le tableau ci-dessous ne donne des conseils qu’en termes de tarif d’entrée : il ne couvre pas les différences de qualité ni de vitesse entre les modèles. Ces deux aspects, c’est à vous de les tester sur vos propres tâches.
| Votre scénario de document long | Conclusion du point de vue du tarif d’entrée | Action recommandée |
|---|---|---|
| Une entrée unique reste sous 272,000 tokens | Les deux sont à $2 par million de tokens : aucun écart sur ce tarif | Choisissez selon les résultats et les autres postes de coûts, sans compter économiser sur les frais d’entrée |
| Une entrée unique dépasse souvent 272,000 tokens | Le tarif d’entrée haut de gamme de 6.2 Sol est 25 % moins cher | Après avoir confirmé le mode de facturation de votre groupe, évaluez 6.2 Sol en priorité |
| L’entrée fluctue autour du seuil | L’écart dépend de la part de requêtes qui dépassent le seuil | Analysez la distribution des prompt_tokens sur une période donnée avant de décider |
| Un même document est interrogé plusieurs fois | Les hits de cache modifient la facture réelle | Vérifiez à part le tarif de la partie mise en cache, et n’extrapolez pas à partir d’un calcul sans cache |
Quand choisir GPT-6.2 Sol
- Des documents très longs — contrats, rapports financiers, dépôts de code — doivent être injectés d’un seul coup dans le contexte, et l’entrée dépasse souvent 272,000 tokens.
- Le budget est essentiellement absorbé par les frais d’entrée haut de gamme, et le mode de facturation de votre groupe a déjà été confirmé.
Quand continuer avec GPT-6.1 Sol
- L’entrée de vos tâches reste durablement sous le seuil : ce tarif est identique à celui de 6.2 Sol, et changer n’apportera aucune économie sur les frais d’entrée.
- Vos processus actuels tournent déjà de manière stable sur 6.1 Sol : avant de migrer, il faut d’abord évaluer les écarts de performance.
GPT-6.2 Sol vs 6.1 Sol : recommandations de décision et checklist de vérification
La logique de décision tient en une phrase : sous le seuil, ce tarif ne vous fera rien économiser ; au-dessus, il faut vérifier en même temps le groupe, le cache et la sortie. Avant de mettre en production des tâches sur documents longs, je vous conseille de passer en revue chaque point de la liste ci-dessous.
| Point à vérifier | Question à trancher | Comment vérifier |
|---|---|---|
| Tokens d’entrée par requête | Dépasse-t-on réellement 272 000 ? Le prompt système et l’historique sont-ils comptés ? | Lire usage.prompt_tokens dans la réponse |
| Base de facturation par groupe | Au-delà du seuil, le tarif supérieur s’applique-t-il à la totalité ou existe-t-il une autre règle ? | Consulter les explications de tarification par paliers du tableau des prix APIYI, et contacter la plateforme si besoin |
| Succès du cache | Quelle part de l’entrée touche le cache, et comment cette partie est-elle facturée ? | Vérifier le champ cached_tokens et le détail de la facture |
| Frais de sortie | La sortie est-elle aussi facturée par paliers, et à quel taux ? | Se référer au tableau des prix de la plateforme ; cet article ne cite aucun prix de sortie non vérifié |
| Validité des prix | L’instantané de cet article date du 2026-11-19 ; les prix ont-ils bougé depuis ? | Interroger à nouveau le tableau des prix avant l’appel |
| Cohérence de la base de calcul | Mélange-t-on les paliers officiels du fournisseur avec les prix affichés par la plateforme ? | Annoter séparément les règles du fournisseur, et n’utiliser qu’une seule base pour le budget |
💡 Recommandation de choix : si vos tâches sur documents longs dépassent vraiment le seuil de façon répétée, je vous suggère d’appeler gpt-6.2-sol et gpt-6.1-sol avec le même document sur APIYI apiyi.com, de comparer le détail de facturation des deux appels, puis de décider s’il faut migrer. Une même clé API suffit pour changer de modèle, ce qui rend ce type de comparaison très simple.
FAQ — Questions fréquentes
Q1 : GPT-6.2 Sol face à 6.1 Sol — où se situe exactement la différence de tarif d’entrée ?
La différence ne joue que sur la tranche supérieure. Selon le tableau tarifaire public d’APIYI, de 0 à 272 000 Token, le tarif d’entrée est de 2 $ par million de Token pour les deux modèles. Au-delà de 272 000, il passe à 3 $ pour 6.2 Sol et à 4 $ pour 6.1 Sol, soit 25 % de moins pour 6.2 Sol.
Q2 : Un document de 300 000 caractères équivaut-il à 300 000 Token ?
Non. Il n’existe pas de ratio fixe entre le nombre de caractères et le nombre de Token, et une entrée unique inclut aussi l’invite système et l’historique de conversation. Fiez-vous aux `prompt_tokens` renvoyés par l’API pour déterminer si le seuil est dépassé.
Q3 : Une entrée de 300 000 Token avec 6.2 Sol permet-elle forcément d’économiser 0,30 $ ?
Pas forcément. Le montant de 0,30 $ est un exemple de frais d’entrée calculé dans l’hypothèse où toute l’entrée est facturée au tarif de la tranche supérieure et où aucun cache n’est utilisé. Si le périmètre de regroupement diffère ou si une partie est servie depuis le cache, l’écart change — et cela n’inclut pas les frais de sortie.
Q4 : Peut-on dire que 6.2 Sol est 25 % moins cher que 6.1 Sol sur la facture complète ?
Non. Ces 25 % ne représentent que l’écart de prix catalogue sur les entrées de la tranche supérieure. Le tableau public d’APIYI ne confirme pas, sur cette base, les règles de facturation applicables à tous les groupes, et il ne donne pas les tarifs de sortie ni de cache pour la tranche supérieure. Pour connaître l’écart sur la facture complète, il faut se référer à la facturation réelle.
Q5 : Comment vérifier rapidement le coût de son long document sur APIYI ?
1. S’inscrire sur APIYI apiyi.com et récupérer une clé API — les nouveaux utilisateurs bénéficient d’un quota de test gratuit.
2. Avec le code de cet article, réglez `base_url` sur `https://api.apiyi.com/v1` et envoyez un véritable document long.
3. Relevez `prompt_tokens` et `cached_tokens`, puis comparez ces valeurs au détail de la facture sur la plateforme.
Q6 : Quelles sont les limites des données de cet article ?
Les chiffres de cet article proviennent uniquement du tableau tarifaire de la plateforme consulté le 2026-11-19. Il ne s’agit pas de factures réelles, et ils ne couvrent ni le prix de sortie, ni la qualité ou la vitesse du modèle. Les règles de palier des fiches modèle officielles du fournisseur et les prix affichés par la plateforme relèvent de logiques différentes ; cet article ne les a pas mélangées. Si les tarifs changent, référez-vous au tableau tarifaire le plus récent.
GPT-6.2 Sol vs 6.1 Sol : points clés à retenir
- Même tarif sous le seuil : jusqu’à 272,000 tokens, les deux modèles affichent un tarif d’entrée de $2 par million de tokens.
- Un écart au palier supérieur : au-delà du seuil, 6.2 Sol est à $3 et 6.1 Sol à $4 : 6.2 Sol est donc 25 % moins cher.
- Un exemple sous conditions : si tous les tokens passent au palier supérieur et qu’aucun cache n’est utilisé, la différence sur 300 000 tokens d’entrée est de $0.30.
- Token ne veut pas dire nombre de caractères : fiez-vous à
prompt_tokenspour savoir si le seuil est dépassé. - Un calcul théorique ne fait pas la facture : le cache, le découpage par groupes de facturation et les coûts de sortie modifient tous la dépense réelle.
- Testez avant de fixer le budget : faites un essai avec un document réel sur APIYI apiyi.com, puis comparez avec la facture avant de décider.
Résumé
Comparaison de GPT-6.2 Sol et 6.1 Sol sur le coût d’entrée des documents longs :
- Aucune différence sous le seuil : tant que l’entrée ne dépasse pas 272,000 tokens, changer de modèle ne permet pas d’économiser sur ce poste.
- Au-delà du seuil, regardez le tarif du palier supérieur : le tarif d’entrée affiché du palier supérieur de 6.2 Sol est 25 % inférieur à celui de 6.1 Sol ; pour 300 000 tokens entièrement au palier supérieur et sans cache, l’écart est de $0.30.
- Le budget se cale sur la facture : vérifiez en même temps le découpage par groupes de facturation, les hits de cache et les coûts de sortie ; l’exemple chiffré n’illustre que le coût d’entrée.
Si votre activité traite vraiment souvent des documents très longs, je vous recommande de comparer les détails de facturation des deux modèles à partir de vraies requêtes via APIYI apiyi.com, puis de choisir le modèle et de fixer votre budget mensuel en conséquence.
📚 Références
-
Tableau récapitulatif des prix des modèles APIYI : explication de la tarification par paliers
- Lien :
docs.apiyi.com/models - Description : source de tous les prix d’entrée cités dans cet article, consultée le 2026-11-19 ; pensez à revérifier avant tout appel
- Lien :
-
Fiche modèle officielle OpenAI – gpt-6.2-sol : explication des niveaux tarifaires du fournisseur
- Lien :
developers.openai.com/api/docs/models/gpt-6.2-sol - Description : les règles du fournisseur et les prix affichés par la plateforme relèvent de référentiels différents ; à consulter séparément, sans les mélanger avec les chiffres de cet article
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site officiel APIYI ; pour plus de ressources sur la facturation et l’intégration, rendez-vous au centre de documentation docs.apiyi.com