Note de l’auteur : à travers quatre angles — les modalités, la tarification des longs contextes, les scores composites de tierces parties et le changement de prix au 1er décembre —, cet article décortique la logique de choix entre GPT-6.2 Sol et Gemini 4 Carbon, et explique pourquoi « même prix affiché » ne veut pas dire « même facture ».
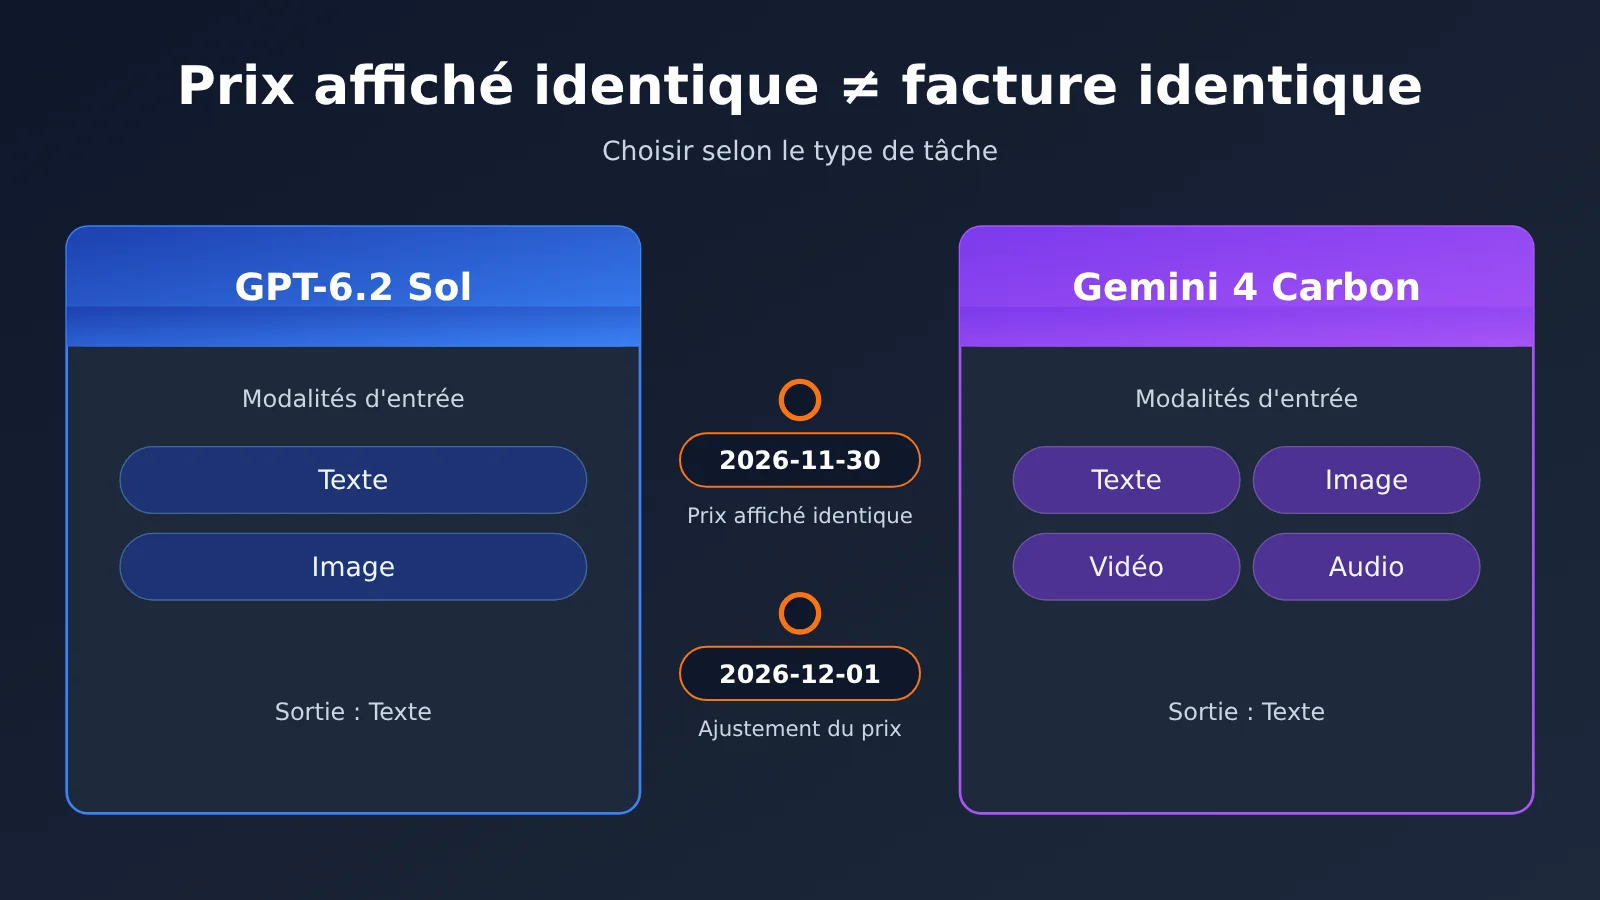
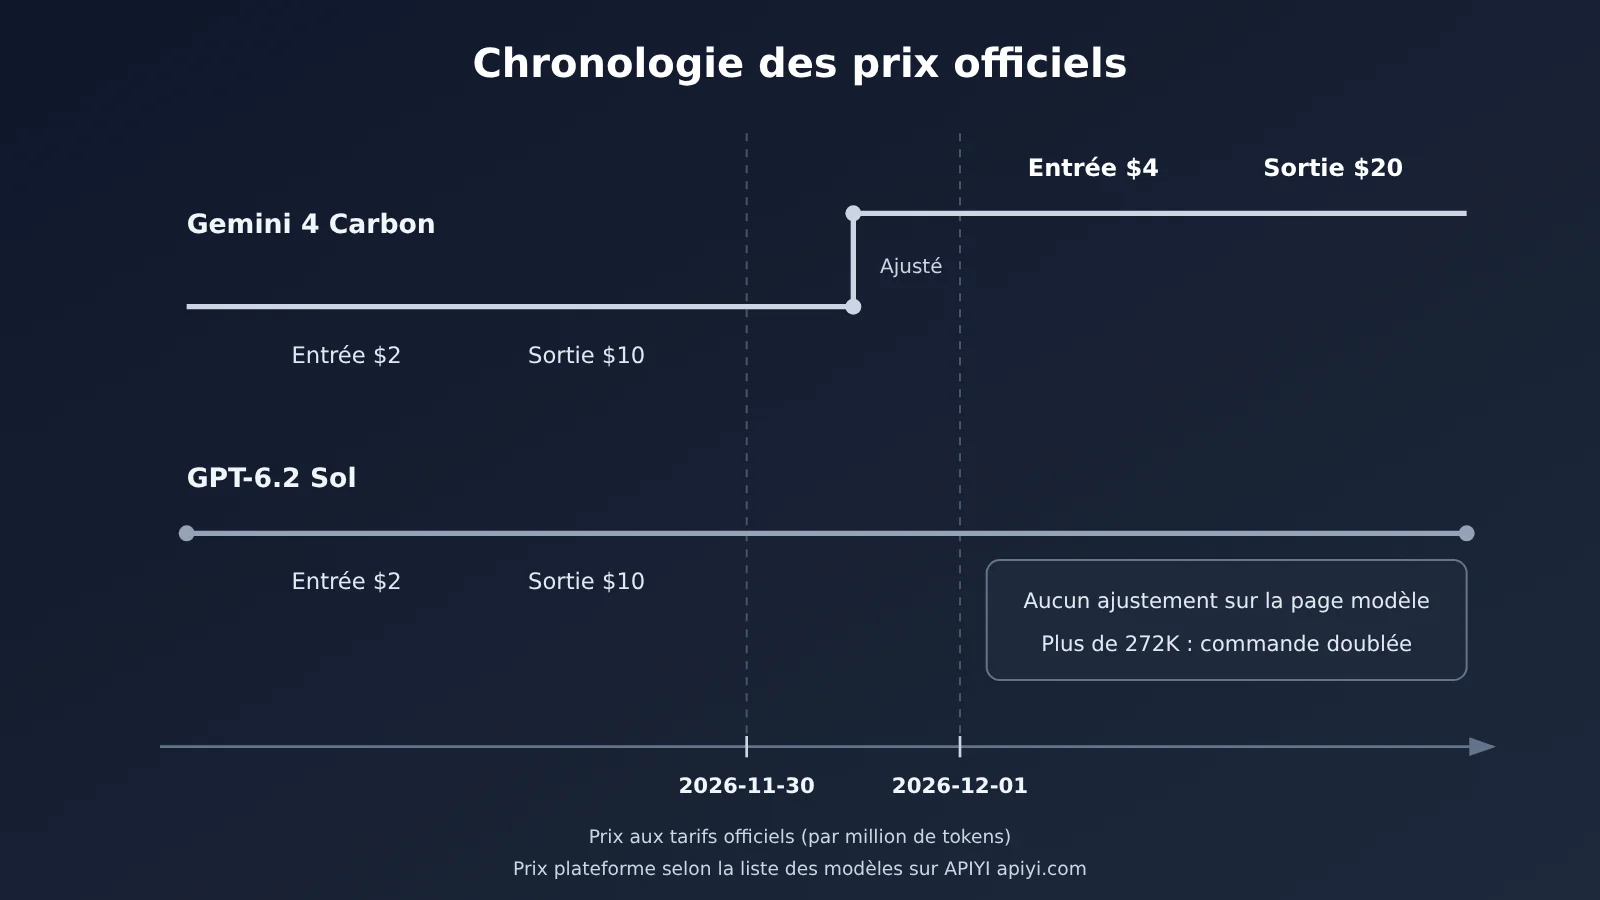
Le 17 novembre 2026, OpenAI a dévoilé GPT-6.2 Astra et GPT-6.2 Sol. Une semaine plus tôt, le 10 novembre, Google a lancé Gemini 4 Carbon. Ouvrez les grilles tarifaires officielles des deux côtés et vous verrez que jusqu’au 2026-11-30, le prix standard en contexte court des deux modèles est strictement identique : 2 $ en entrée, 10 $ en sortie, 0,10 $ en lecture de cache (par million de tokens).
Ce n’est pas un article qui annonce « lequel est le moins cher ». Les chiffres des grilles tarifaires sont les mêmes, mais les règles de tarification, les modalités prises en charge et les scores composites de tierces parties diffèrent — et les prix officiels de Carbon évolueront à compter du 1er décembre. Projetez ces différences sur vos requêtes réelles, et les deux factures peuvent s’écarter de beaucoup.
Ce que vous y gagnez : au terme de cet article, vous retiendrez une date butoir (2026-11-30) et vous saurez juger, selon le type de travail que vous avez à faire, lequel de GPT-6.2 Sol ou de Gemini 4 Carbon est le mieux adapté.
Points essentiels de GPT-6.2 Sol et Gemini 4 Carbon
Commençons par un tableau qui met à plat les informations ayant le plus d’impact sur votre choix. Les prix indiqués sont les tarifs officiels des fournisseurs, exprimés pour 1 million de tokens ; le score global provient du tiers Artificial Analysis, avec le niveau de raisonnement précisé.
| Point clé | GPT-6.2 Sol | Gemini 4 Carbon | Impact sur le choix |
|---|---|---|---|
| Tarifs officiels en contexte court (jusqu’au 30 novembre) | Entrée $2 / Sortie $10 / Lecture du cache $0.10 | Entrée $2 / Sortie $10 (tokens de réflexion inclus) / Lecture du cache $0.10 | Tarifs affichés identiques, mais règles de facturation différentes |
| Tarifs officiels à partir du 1er décembre | Aucun changement de prix indiqué sur la page du modèle | Entrée $4 / Sortie $20 / Lecture du cache $0.20 | Le prix de lancement de Carbon est limité dans le temps |
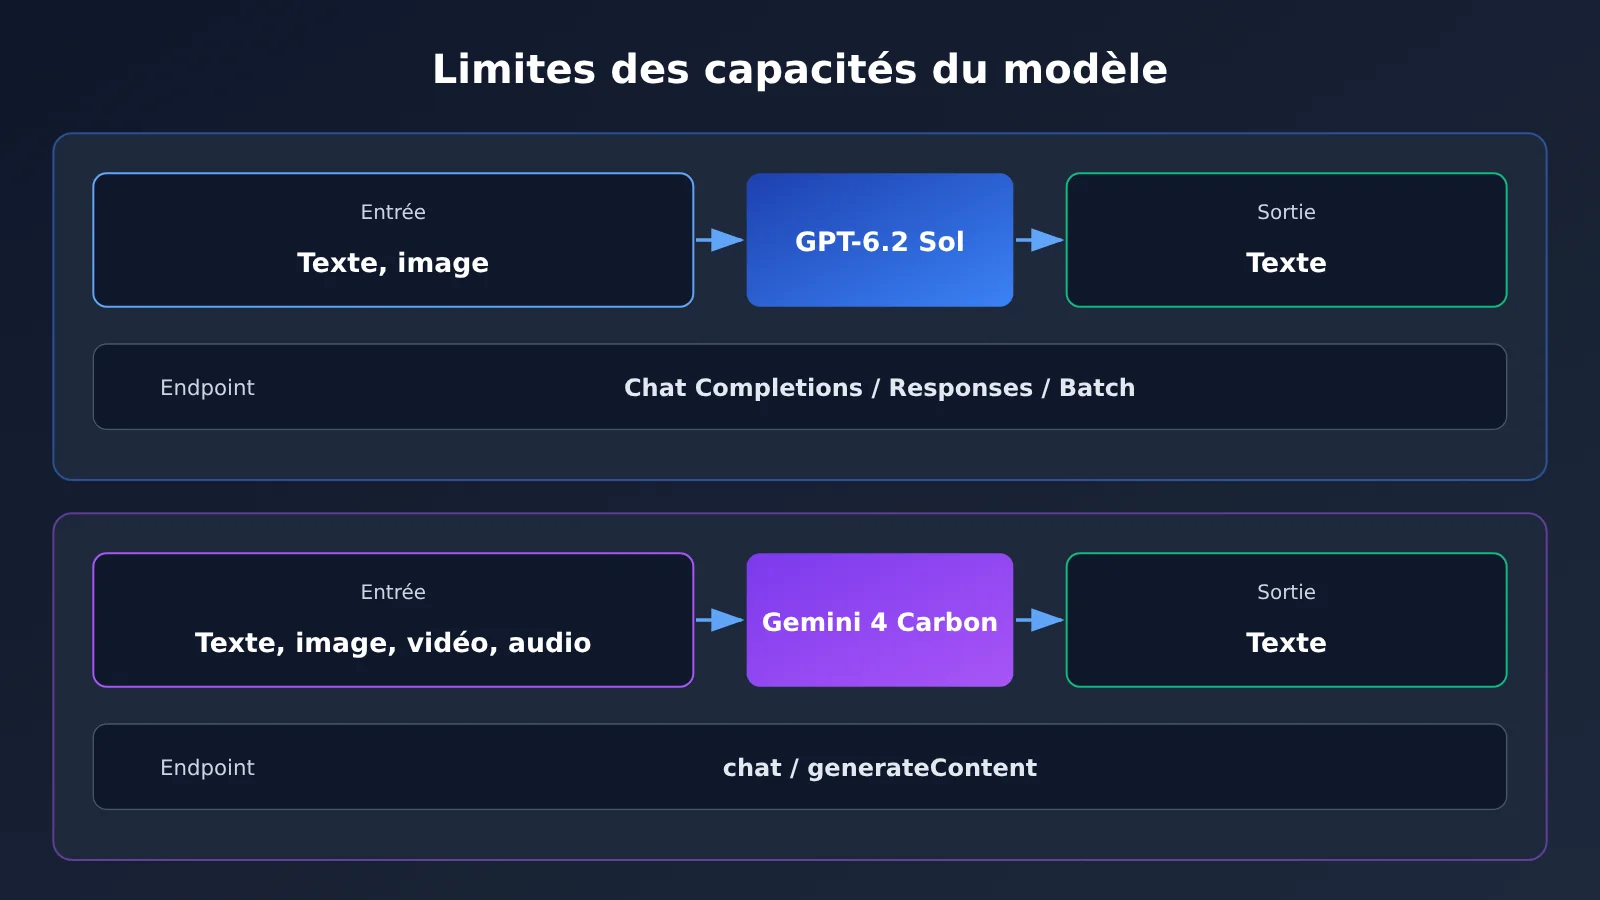
| Modalités d’entrée | Texte, images | Texte, images, vidéo, audio | Écart notable dès qu’on a des besoins audio ou vidéo |
| Facturation doublée au-delà de 272K tokens en entrée | Applicable | Cette ligne n’existe pas dans la grille tarifaire de Google | À budgéter à part pour les longs documents |
| Score global tiers (AA Intelligence Index v5.0.1) | 57 en niveau de raisonnement Max | 60 au niveau de raisonnement le plus élevé | Méthodologie tierce, pas un garant de vos performances sur vos propres tâches |
GPT-6.2 Sol et Gemini 4 Carbon : les points clés en détail
GPT-6.2 Sol est le modèle positionné comme « efficace » dans cette vague de lancements d’OpenAI. La page officielle du modèle indique qu’il n’accepte en entrée que du texte et des images, et ne génère que du texte. Sa fenêtre de contexte atteint 1 050 000 tokens, avec 922 000 en entrée maximale, 128 000 en sortie maximale et une date de coupure des connaissances au 1er juin 2026. Côté endpoints, il prend en charge Chat Completions, Responses et Batch, mais pas Realtime, Assistants, le fine-tuning, la génération d’images, la vidéo ni la voix. Un détail qui piège plus d’un développeur : l’API refuse de fixer le reasoning effort sur none.
Gemini 4 Carbon se distingue par une couverture modale plus large. D’après la page de documentation d’APIYI, il accepte en entrée du texte, des images, de la vidéo et de l’audio, produit du texte en sortie, offre un contexte de 1 048 576 tokens, une sortie maximale de 65 536 et des connaissances arrêtées à mars 2026. La page de tarification de Google précise que Carbon ne prend en charge que le cache implicite et n’a pas d’offre gratuite. Son prix de lancement est identique à celui d’Argon, et une note de bas de page des notes de version indique un passage à $4 / $20 après le 30 novembre.
GPT-6.2 Sol vs Gemini 4 Carbon : les différences clés
En comparant ces deux modèles côte à côte, ce sont les dimensions ci-dessous qui déterminent réellement votre facture et votre expérience. Pas de colonne « gagnant » ici : la performance de chaque critère dépend de la forme de vos requêtes.
| Critère de comparaison | GPT-6.2 Sol | Gemini 4 Carbon | Comment l’interpréter |
|---|---|---|---|
| Fenêtre de contexte / sortie maximale | 1 050 000 / 128 000 | 1 048 576 / 65 536 | Besoin de très longues sorties ? C’est le plafond de Sol qui compte |
| Tarification des longues entrées | Au-delà de 272K, le prix unitaire des entrées et du cache double et les sorties sont facturées à 1,5 fois le tarif, sur l’ensemble de la requête | Cette règle ne figure pas dans la grille tarifaire officielle | Pour le traitement par lots de longs documents, modélisez chaque scénario séparément |
| Mécanisme de cache | L’écriture du cache est facturée séparément : 2,50 $ pour 30 minutes, 5 $ pour 12 heures | Seul le cache implicite est pris en charge | Le taux de succès du cache impacte directement la facture |
| Tokens de réflexion | Le raisonnement est pris en charge, mais effort ne peut pas valoir none | Le prix de sortie inclut les tokens de réflexion | La longueur du raisonnement fait gonfler le volume de sortie réel |
| Validité des prix | Aucun ajustement de tarif mentionné sur la page du modèle | Doublement à partir du 1er décembre | Les projets à cheval sur deux mois doivent être calculés sur deux périodes distinctes |
| Écart de prix régional | Non renseigné | Environ 10 % plus cher dans les régions Cloud non globales | La région de déploiement influence le prix unitaire |
GPT-6.2 Sol et Gemini 4 Carbon : mêmes tarifs affichés, mais des factures potentiellement différentes
La première raison, c’est le temps. Jusqu’au 2026-11-30, le tarif officiel standard de Carbon est de $2 en entrée, $10 en sortie et $0.10 en lecture de cache ; à partir du 2026-12-01, il passe à $4 en entrée, $20 en sortie et $0.20 en lecture de cache. Les régions globales de Google Cloud suivent ces mêmes tarifs, tandis que les régions non globales sont environ 10 % plus chères, soit jusqu’au 30 novembre $2.20 en entrée et $11 en sortie. La page du modèle Sol n’annonce aucun ajustement de prix similaire : pour un projet qui s’étend sur le mois de décembre, le budget de la partie Carbon doit donc être calculé sur deux périodes distinctes.
La deuxième raison, ce sont les règles applicables aux longues entrées. La page du modèle Sol le précise explicitement : lorsqu’une requête dépasse 272K tokens en entrée, les prix unitaires d’entrée et de cache doublent, la sortie est facturée à 1,5 fois le tarif du contexte court, et le calcul porte sur l’ensemble de la requête, pas uniquement sur la partie excédentaire. Le tableau de Google ne comporte aucune ligne de ce type. Si vos requêtes dépassent régulièrement 272K, les prix unitaires réels diffèrent déjà d’un côté comme de l’autre, même si les tarifs contexte court affichés sont rigoureusement identiques.
La troisième raison, ce sont les tokens eux-mêmes. Les modèles ne tokenisent pas de la même façon et leurs longueurs de raisonnement varient : pour un même texte et une même question, le nombre de tokens d’entrée et de sortie générés de part et d’autre sera vraisemblablement différent. Le prix de sortie de Carbon inclut les tokens de réflexion, et Sol produit lui aussi des tokens de raisonnement ; comparer uniquement les prix unitaires sans tenir compte de la consommation réelle conduit donc à des conclusions peu fiables.
Passons aux prix sur la plateforme. D’après les données de la table générale d’APIYI en date du 2026-11-17 15:54 (UTC+8), ainsi que l’API publique de tarification interrogée le même jour, le modèle disponible à l’invocation sur la plateforme est gemini-4-carbon, affiché à $2 en entrée, $0.1 en lecture de cache et $10 en sortie, pour les groupes Default et SVIP, avec un multiplicateur de 1. À noter : cette page présente des prix de lancement et ne mentionne pas l’ajustement tarifaire de Google du 1er décembre ; après le 1er décembre, fiez-vous aux prix en temps réel de la liste des modèles sur APIYI (apiyi.com).
Quant à GPT-6.2 Sol, les tarifs officiels standard d’OpenAI en contexte court sont : $2 en entrée, $0.10 en lecture de cache, $2.50 en écriture de cache (30 minutes) et $10 en sortie. Batch est facturé à 50 % du tarif standard, Fast à 2 fois ce tarif, et Ultrafast à 3 fois jusqu’au 2027-02-28 (heure du Pacifique), puis à 6 fois à partir du 2027-03-01. Ce modèle n’est pas encore disponible sur la plateforme, nous le mettrons en ligne dès que possible ; le nom du modèle et les tarifs de référence sont ceux de la liste des modèles de la plateforme. Les modèles gpt-6.1-sol et gpt-6-sol proposés sur la plateforme sont des générations antérieures : leurs prix ne peuvent pas servir de référence pour le 6.2.
Scores composites de GPT-6.2 Sol et Gemini 4 Carbon : examinons séparément les évaluations tierces et les auto-déclarations officielles
Dans l’Intelligence Index v5.0.1 d’Artificial Analysis (source tierce), GPT-6.2 Sol obtient les scores suivants selon les niveaux de raisonnement : Max 57, Xhigh 56, High 55, Medium 53, Low 41 ; l’article indique que Gemini 4 Carbon atteint 60 sur son niveau de raisonnement le plus élevé. La même source précise que le coût par tâche de Sol sur l’indice composite s’élève à 1,01 $ au niveau Max, et qu’il est 3 points en dessous de GPT-6.1 Sol sur le Coding Agent Index (harnais Codex, max), principalement en raison d’un déficit de 14 points sur SWE-Atlas-QnA-AA et d’une tendance accrue à omettre des faits clés ; le taux d’hallucination AA-Omniscience (Max) s’établit à 55 %. Les données tierces ne fournissent pas de coût par tâche pour Carbon, et nous ne nous aventurerons pas dans une estimation ici.
Les chiffres auto-déclarés par OpenAI relèvent quant à eux d’une tout autre méthodologie. Selon l’entreprise, GPT-6.2 Sol se situe à moins de 0,5 point d’Astra sur FrontierCode 2.0, pour un coût environ cinq fois inférieur (les deux au niveau Max) ; sur LifeVal, un benchmark construit en interne, Sol obtient un score supérieur à GPT-6 Astra, pour un coût environ sept fois inférieur ; sur GDPval v2, Sol dépasse GPT-6.1 Sol de 5,3 points. Il s’agit d’auto-déclarations officielles : les jeux de test, les niveaux de raisonnement et les modèles de référence diffèrent de ceux des évaluations tierces, et les deux séries de chiffres ne doivent donc pas être fusionnées en une conclusion unique du type « lequel est le plus fort ».
Recommandations de scénarios : GPT-6.2 Sol ou Gemini 4 Carbon
Le choix d’un modèle finit toujours par dépendre du type de tâche que vous avez à accomplir. Voici, par forme de tâche, les orientations à privilégier — à condition de revalider le tout sur vos propres données.
Scénarios où choisir GPT-6.2 Sol
- Besoin de sorties très longues en une seule fois : la sortie maximale de Sol atteint 128 000 tokens, idéal pour générer d’un coup des rapports longs ou des fichiers de code volumineux.
- Vous avez déjà construit votre flux de travail sur l’API Responses : Sol prend en charge Responses, tandis que Carbon n’a pas de point de terminaison Responses sur APIYI.
- Vos requêtes restent pour la plupart sous 272K et vous pouvez mettre en place un cache explicite : l’écriture en cache de Sol est facturée séparément et la lecture ne coûte que $0.10, ce qui facilite la maîtrise des coûts quand le taux de hit est élevé.
- Tâches bureautiques quotidiennes et modifications de code : les résultats officiellement auto-déclarés sur LifeVal et FrontierCode 2.0 vont tous dans ce sens, mais attention : des tiers signalent qu’il omet plus facilement des faits essentiels.
Scénarios où choisir Gemini 4 Carbon
- Vos entrées contiennent de la vidéo ou de l’audio : enregistrements de réunions, vidéos de démonstration produit, captations de cours — Sol ne peut pas les traiter directement.
- Vos entrées dépassent souvent 272K en une seule fois : la grille tarifaire de Google n’applique pas de règle de doublement sur la commande entière, ce qui rend le prix unitaire plus facile à estimer pour les longs documents.
- Vous vous fiez aux scores agrégés des tiers : AA affiche 60 sur son palier de raisonnement le plus élevé, contre 57 pour le palier Max de Sol.
- Votre projet peut se terminer avant le 30 novembre : le prix unitaire est le plus bas pendant la période de tarification d’introduction ; si vous franchissez le cap du mois, il faudra recalculer avec les nouveaux tarifs de décembre.
| Forme de tâche | À tester en premier | Raison clé | Points à vérifier en plus |
|---|---|---|---|
| Compréhension et analyse de transcriptions audio/vidéo | Gemini 4 Carbon | Prend en charge les entrées vidéo et audio | Changement de prix unitaire à partir de décembre |
| Génération de très longs textes | GPT-6.2 Sol | Sortie maximale de 128K | Consommation de tokens de raisonnement |
| Questions-réponses sur des documents de plus de 300K | À calculer pour les deux | Sol applique une règle de doublement sur la commande entière | Nombre réel de tokens |
| Agents et modifications de code | Les deux méritent un test | Les conclusions officielles et tierces divergent | Cas d’omission de faits essentiels |
| Base de connaissances du support client avec fort taux de hit | Les deux méritent un test | Cache explicite pour Sol, cache implicite pour Carbon | Taux de hit réel |
Prise en main rapide de GPT-6.2 Sol et Gemini 4 Carbon
Cet article ne contient aucun bloc de code : il indique simplement les points à modifier lors de l’intégration. Les deux modèles sont accessibles via le protocole Chat Completions compatible OpenAI, et le coût de migration se situe donc principalement au niveau du nom du modèle et des paramètres.
- Vérifier la disponibilité du modèle : commencez par rechercher l’ID du modèle dans la liste des modèles d’APIYI. Le modèle actuellement disponible est
gemini-4-carbon;gpt-6.2-soln’est pas encore en ligne, mais nous le mettrons en ligne dès que possible. Les modèles disponibles et leurs tarifs font foi dans la liste des modèles de la plateforme. - Remplacer le base_url : dans votre configuration OpenAI SDK existante, remplacez le base_url par
https://api.apiyi.com/v1et la api_key par la clé API générée par la plateforme ; le reste de la procédure d’appel reste inchangé. - Choisir le point de terminaison : sur la plateforme, Carbon prend en charge le mode chat ainsi que le generateContent natif de Gemini, mais pas Responses ; si votre code dépend de Responses, vous devrez passer par le point de terminaison chat.
- Gérer les paramètres de raisonnement : une fois que Sol sera disponible, lors de l’appel à
gpt-6.2-sol, ne réglez pas le reasoning effort sur none, sinon l’API rejettera ce type de requête. - Enregistrer la consommation réelle : pour chaque requête, notez le nombre de tokens d’entrée et de sortie renvoyés, puis multipliez la consommation réelle par le prix unitaire de la date correspondante, plutôt que de comparer directement les prix affichés.
🚀 Démarrage rapide : nous vous conseillons d’abord d’utiliser le crédit d’essai gratuit pour nouveaux utilisateurs d’APIYI (apiyi.com), en faisant passer 20 à 50 de vos propres requêtes réelles sur
gemini-4-carbon, et en notant la consommation de tokens ainsi que la qualité des sorties. Une fois que le 6.2 Sol sera en ligne, relancez le même lot de requêtes : ce n’est qu’en comparant les résultats que vous obtiendrez des données réellement exploitables.
GPT-6.2 Sol ou Gemini 4 Carbon : nos recommandations
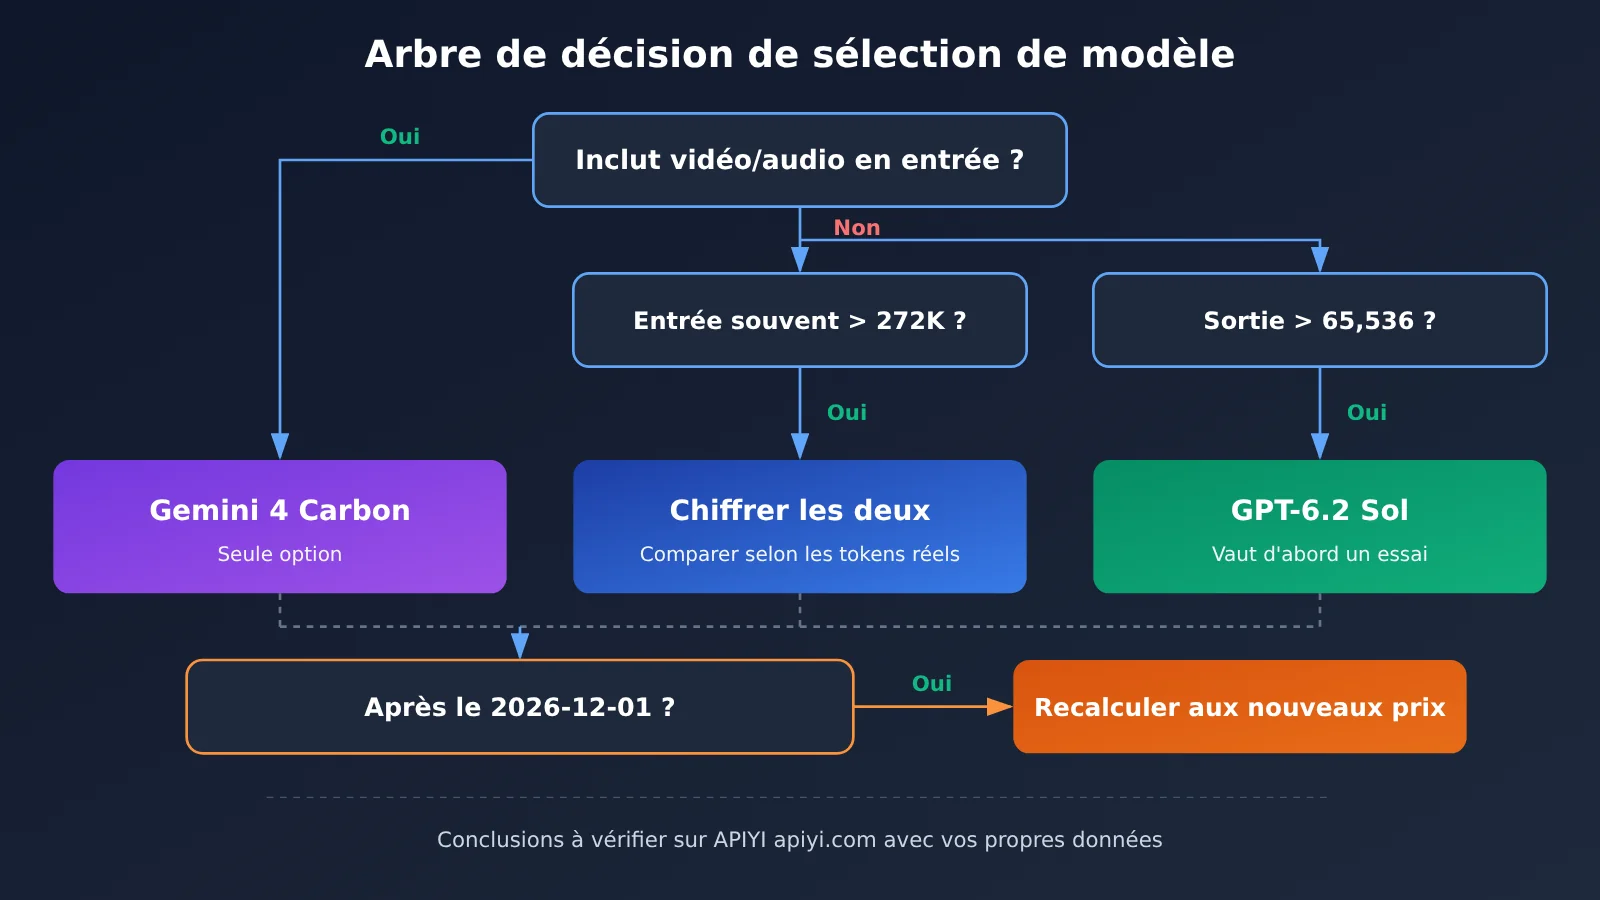
Pour faire votre choix, procédez dans l’ordre « d’abord la modalité, ensuite la longueur, enfin le temps ». Si vos entrées contiennent de la vidéo ou de l’audio, Carbon est pratiquement la seule option ; si tout se limite à du texte et des images, regardez alors si vos requêtes dépassent souvent 272K et si vous avez besoin de sorties uniques supérieures à 65 536 ; enfin, vérifiez si votre projet chevauchera le 1er décembre.
| Modèle | Avantages clés | Points de vigilance | Plateformes disponibles |
|---|---|---|---|
| GPT-6.2 Sol | Sortie maximale de 128K, prise en charge de Responses et Batch | Au-delà de 272K, la requête entière est facturée au double ; n’accepte pas effort défini sur none | API OpenAI ; pas encore référencé sur APIYI, reportez-vous à la liste des modèles de la plateforme |
| Gemini 4 Carbon | Prend en charge les entrées vidéo et audio, palier tiers le plus élevé à 60 | Prix officiels doublés à partir du 1er décembre ; ne prend en charge que le cache implicite | Google AI Studio, Google Cloud ; disponible sur APIYI apiyi.com |
💡 Conseil de choix : les deux modèles affichent le même prix catalogue avant fin novembre, mais ce n’est qu’un point de départ. L’idéal est de faire passer le même lot de requêtes réelles des deux côtés, de mesurer la consommation de tokens de chaque côté, puis d’appliquer respectivement les prix unitaires de novembre et de décembre — et d’analyser les résultats par type de tâche plutôt que de vous contenter d’un total global.
Questions fréquentes (FAQ)
Q1 : Que sont exactement GPT-6.2 Sol et Gemini 4 Carbon ?
GPT-6.2 Sol est un modèle optimisé pour l’efficacité lancé par OpenAI le 17 novembre 2026 ; son identifiant de modèle est `gpt-6.2-sol`, il accepte du texte et des images en entrée et produit du texte. Gemini 4 Carbon, lui, a été lancé par Google le 10 novembre 2026 : il accepte du texte, des images, des vidéos et de l’audio, et produit du texte.
Q2 : Le prix affiché est le même des deux côtés — est-ce que ça coûte la même chose, quel que soit le modèle choisi ?
Non. Le prix affiché n’est que le tarif unitaire par million de tokens ; la facture réelle dépend aussi du volume de tokens, de la longueur d’inférence, du taux de succès du cache, du dépassement ou non du seuil de 272K (qui ne concerne que Sol), et de savoir si la requête passe avant ou après le 1er décembre. Cet article ne cherche pas à trancher sur la question de savoir lequel est le moins cher : on vous conseille simplement de faire le calcul avec vos propres requêtes.
Q3 : Quand le prix de lancement de Gemini 4 Carbon prend-il fin ?
D’après les notes de publication de Google et sa page de tarification, le prix de lancement court jusqu’au 30 novembre 2026 ; à partir du 1er décembre 2026, il passe à 4 $ en entrée, 20 $ en sortie et 0,20 $ en lecture de cache. La page de présentation d’APIYI affiche encore le prix de lancement à l’heure actuelle : après le 1er décembre, fiez-vous aux prix indiqués dans la liste des modèles de la plateforme.
Q4 : Les scores globaux de 60 et 57 mesurés par un tiers suffisent-ils à dire que Carbon est plus fort ?
Ils montrent seulement que, sur l’Intelligence Index v5.0.1 d’Artificial Analysis, Carbon atteint 60 au niveau de raisonnement maximal, contre 57 pour Sol en réglage Max. Les résultats revendiqués par OpenAI elle-même — FrontierCode 2.0, LifeVal, etc. — relèvent d’une autre méthodologie : impossible de les additionner. Pour ce qui est de vos tâches métier, il faudra les tester vous-même.
Q5 : Comment appeler ces deux modèles via une API ?
Inscrivez-vous sur APIYI (apiyi.com) et générez une clé API, puis utilisez l’interface Chat Completions compatible OpenAI : il suffit de définir le modèle sur `gemini-4-carbon` pour appeler Carbon. GPT-6.2 Sol n’est pas encore disponible sur la plateforme ; nous mettrons ce modèle en ligne dès que possible. Pour les modèles disponibles et les tarifs, référez-vous à la liste des modèles de la plateforme.
Q6 : Quelles sont les limites connues de GPT-6.2 Sol ?
Selon la page officielle du modèle, Sol n’accepte ni entrée audio ni entrée vidéo, et ne prend pas en charge les endpoints Realtime et Assistants, le fine-tuning ni les endpoints vocaux ; toute entrée dépassant 272K entraîne une majoration sur l’ensemble de la requête. Artificial Analysis, une source tierce, note qu’il a davantage tendance à omettre des faits essentiels sur SWE-Atlas-QnA-AA. OpenAI précise par ailleurs que la protection en cybersécurité des deux modèles 6.2 a été renforcée : une partie des demandes de recherche de vulnérabilités tout à fait légitimes sera refusée.
Q7 : Quelles sont les limites connues de Gemini 4 Carbon ?
D’après la page de présentation d’APIYI, la sortie maximale est de 65 536 tokens, contre 128 000 pour Sol ; sa base de connaissances s’arrête à mars 2026, alors que celle de Sol va jusqu’au 1er juin 2026. Il ne prend en charge que le cache implicite, n’offre pas de niveau gratuit et ne dispose pas de l’endpoint Responses sur la plateforme. Enfin, les tarifs officiels doublent à partir de décembre : mieux vaut anticiper le budget pour les projets à long terme.
GPT-6.2 Sol et Gemini 4 Carbon : l’essentiel à retenir
- Date butoir : jusqu’au 30/11/2026, les deux modèles affichent le même tarif officiel en contexte court ; à partir du 1er décembre, Carbon monte à $4 / $20.
- Prix affichés ≠ facture : le nombre de tokens, la longueur de l’inférence et le taux de hits du cache déterminent ensemble le coût réel.
- Règle des longues entrées : le doublement de l’ensemble de la requête au-delà de 272K ne s’applique qu’à Sol ; les scénarios de longs documents méritent un calcul à part.
- Écart de modalités : Carbon accepte la vidéo et l’audio, Sol ne traite que le texte et les images.
- Scores à lire séparément : chez le benchmark tiers AA, Carbon atteint 60 dans la catégorie la plus haute et Sol Max 57 — impossible à fusionner avec les scores auto-déclarés par les éditeurs.
- Par où commencer : Carbon est déjà invocable sur APIYI, Sol n’est pas encore disponible — référez-vous à la liste des modèles de la plateforme.
En résumé
Les critères de choix entre GPT-6.2 Sol et Gemini 4 Carbon :
- Les modalités d’abord : avec de l’audio ou de la vidéo en entrée, direction Carbon ; pour du texte et des images uniquement, les deux font l’affaire.
- La longueur ensuite : si vos entrées dépassent régulièrement 272K, il faut recalculer selon la règle de doublement intégrale de Sol ; si vous visez une sortie très longue en un seul appel, regardez du côté du plafond de 128K de Sol.
- Le calendrier enfin : pour un projet à cheval sur le 1er décembre, budgétez la part Carbon aux nouveaux tarifs.
Des chiffres identiques sur une grille tarifaire ne sont qu’un point de départ pour la comparaison. La réponse vraiment fiable vient de vos propres requêtes, de votre propre consommation de tokens et du prix unitaire en vigueur à la date concernée.
Notre conseil : commencez par tester gemini-4-carbon sur APIYI (apiyi.com) avec le quota gratuit, en lançant un lot de tâches réelles ; une fois Sol 6.2 disponible, rejouez exactement le même jeu de données pour comparer.
📚 Références
-
Annonce d’OpenAI : notes de publication de GPT-6.2 Astra et Sol
- Lien :
openai.com/index/introducing-gpt-6-2-astra-sol - Description : tarifs affichés officiellement et données de capacités communiquées par OpenAI lui-même
- Lien :
-
Page modèle OpenAI : spécifications et règles de tarification de GPT-6.2 Sol
- Lien :
platform.openai.com/docs/models/gpt-6.2-sol - Description : fenêtre de contexte, endpoints, règle de doublement intégral à 272K
- Lien :
-
Article d’Artificial Analysis : lecture de l’indice tiers après la sortie de GPT-6.2
- Lien :
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Description : score composite d’un tiers et données par palier de raisonnement
- Lien :
-
Annonce Google : mise en ligne de Gemini 4 Carbon
- Lien :
blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available - Description : prix de lancement et note de bas de page sur les tarifs après le 30 novembre
- Lien :
Auteur : Équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; les modèles et les tarifs sont consultables dans le centre de documentation docs.apiyi.com