Note de l’auteur : cet article décompose, tâche par tâche, les spécifications de Hy4 flash, les tests à l’aveugle menés par des humains, WorkIndex et les scores figurant en annexe. Conclusion : pour la co-rédaction de diapositives, Markdown, les questions-réponses visuelles et les opérations sur ordinateur, Hy4 flash mérite d’être envisagé ; pour la réparation de PPT complexes, les tâches longues en terminal et l’ingénierie logicielle de longue durée, mieux vaut rester sur Hy4 ou DeepSeek-V4.1-Flash-1017.
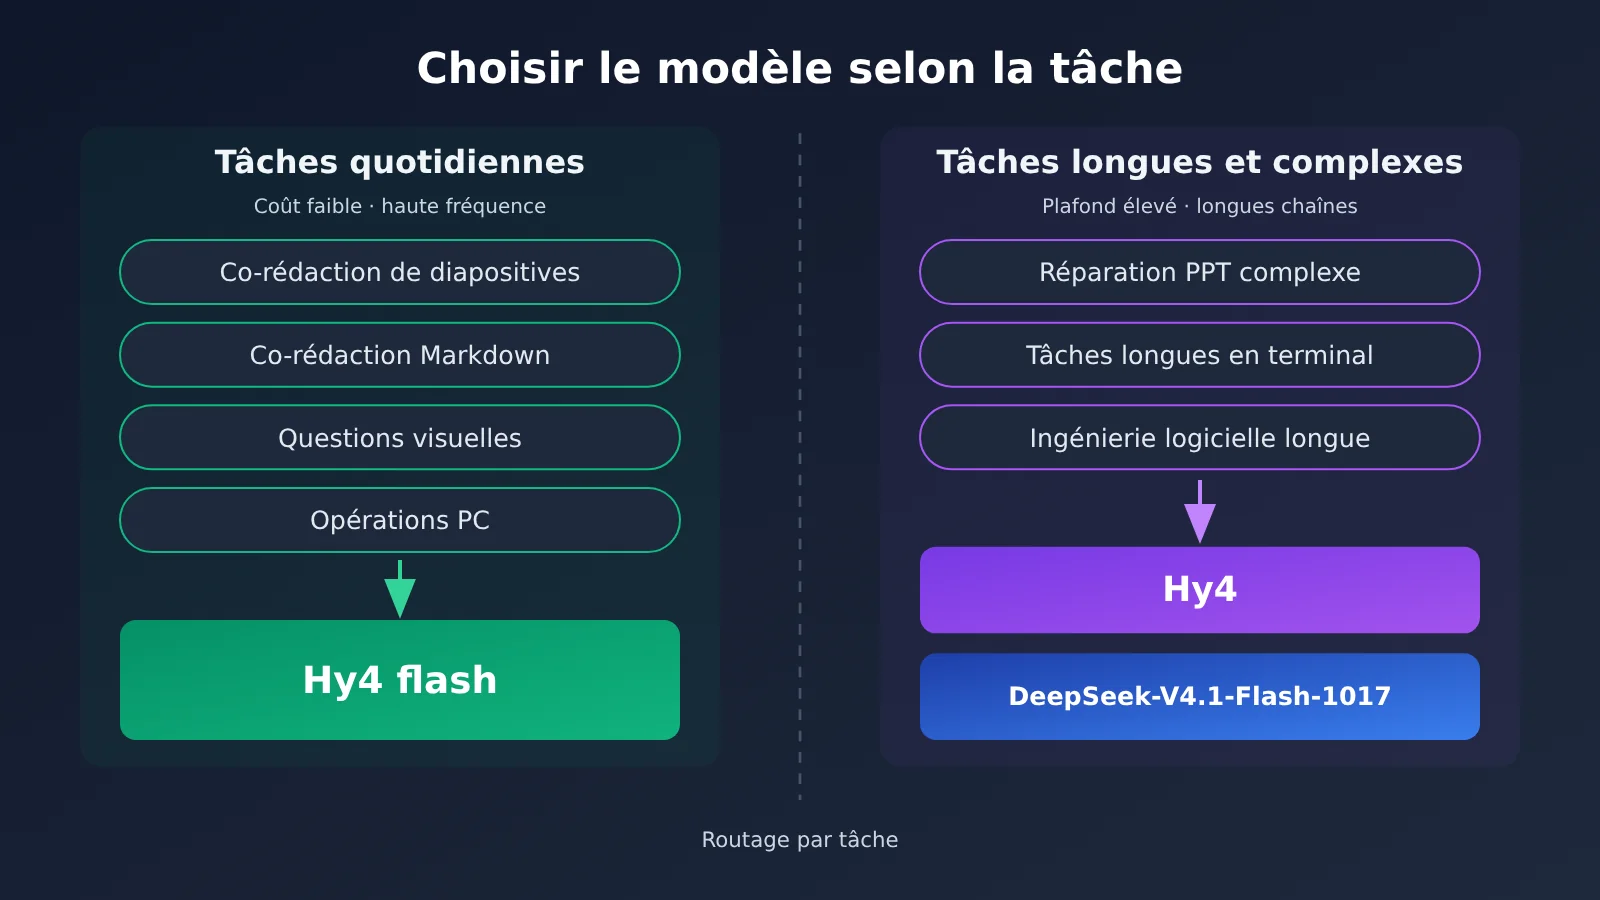
Commençons par la conclusion. Si vous devez choisir un modèle pour le travail de bureau quotidien ou pour des agents légers, Hy4 flash convient aux tâches quotidiennes telles que la co-rédaction de diapositives, la co-rédaction Markdown, les questions-réponses visuelles et les opérations sur ordinateur. Pour réparer des PPT complexes, exécuter de longues tâches en terminal ou faire de l’ingénierie logicielle de longue durée, il n’est pas conseillé de le préférer à Hy4 ou DeepSeek-V4.1-Flash-1017.
Tencent Hunyuan a publié une page de recherche et une annonce officielle le 16 novembre 2026, indiquant que Hy4 flash approche Claude Haiku 5.5 lors de tests à l’aveugle menés par des humains sur des tâches professionnelles courantes, pour un coût par tâche bien inférieur. Ce n’est pas l’histoire d’un modèle bon marché qui ferait tout. L’annexe de cette même page de recherche montre qu’il est nettement distancé par Hy4 sur les benchmarks de terminal et de codage de longue durée. Les tests à l’aveugle, WorkIndex, annexes et témoignages produit cités dans cet article proviennent tous d’autodéclarations officielles de Tencent ou du texte original de la page de recherche ; aucun n’a été reproduit par un tiers.
L’essentiel : après lecture, vous disposerez d’un tableau de sélection par type de tâche et saurez clairement où Hy4 flash est fort, où il est faible, et dans quels cas il ne faut pas changer de modèle.
Quelle est la puissance de Hy4 flash ? Commençons par le choix selon la tâche
Le tableau ci-dessous organise les choses par type de tâche, en s’appuyant sur les usages recommandés dans la page de recherche et sur les scores en annexe. La colonne « Choix privilégié » relève d’un jugement de sélection : elle ne signifie pas qu’un modèle domine totalement sur ce type de tâche.
| Type de tâche | Choix privilégié | Justification (page de recherche / annexe) |
|---|---|---|
| Création de diapositives en co-écriture humain-machine | Hy4 flash | PPTCoEditBench 74.0, Hy4 à 78.9, coût par tâche environ 1/16 de celui de Hy4 |
| Co-écriture Markdown humain-machine | Hy4 flash | MdCoEditBench 56.9, proche des 57.7 de Hy4, nettement au-dessus des 29.2 de DeepSeek |
| Questions-réponses visuelles (sans outils) | Hy4 flash utilisable, pas le meilleur | BuddyVQA 48.5, au-dessus des 43.7 de DeepSeek, en dessous des 55.5 de Hy4 |
| Utilisation d’un ordinateur | Hy4 flash utilisable | OSWorld 2.1 à 68.1, proche des 68.4 de DeepSeek, Hy4 à 78.9 |
| Réparation de présentations PPT complexes | Hy4 ou DeepSeek-V4.1-Flash-1017 | PPTFixBench 23.7, Hy4 à 45.6, DeepSeek à 45.3 |
| Tâches longues en terminal | Hy4 ou DeepSeek-V4.1-Flash-1017 | Terminal-Bench 4.0 seulement 19.2, Hy4 à 44.4 |
| Ingénierie logicielle à long horizon | Hy4 | Recommandation explicite de la page de recherche, ProgramBench 16.0 contre 30.0 pour Hy4 |
L’idée derrière ce tableau est simple. Pour les tâches dont le livrable est court, qui demandent beaucoup d’allers-retours et où le coût compte, on confie le travail à Hy4 flash. Pour les chaînes d’étapes longues, qui exigent un raisonnement continu et des corrections répétées, on passe à un modèle dont le plafond d’intelligence est plus élevé. La page de recherche va d’ailleurs dans ce sens : recherche approfondie, traitement de documents, création de diapositives, démonstrations front-end simples et utilisation d’un ordinateur avec Hy4 flash ; ingénierie logicielle à long horizon avec Hy4.
Les pièges les plus fréquents lors du choix de Hy4 flash
La méprise la plus courante consiste à lire « proche de Haiku » comme « globalement meilleur que Haiku ». Lors du test en aveugle, le score de satisfaction de Hy4 flash est inférieur de 0.02 point à celui de Haiku, et la page de recherche emploie bien l’expression close to. Deuxième méprise : mélanger plusieurs jeux de multiplicateurs de coût. Les 1/8, 1/13 et 1/20 du WorkIndex relèvent d’un même référentiel ; le coût par tâche en yuans du tableau de test en aveugle en relève d’un autre, et les deux ne sont pas interchangeables.
Fonctionnalités et spécifications principales de Hy4 flash
Voici les spécifications données par la page de recherche. Elle ne fournit pas d’ID de modèle API ; cet article n’invente donc pas de nom de modèle. Pour l’utiliser, fiez-vous au nom affiché dans la console Tencent Cloud TokenHub.
| Élément | Hy4 flash (texte original de la page de recherche) |
|---|---|
| Paramètres totaux | 224B, dont 64B de paramètres Engram |
| Activation par token | 12B |
| Modalité | Multimodal natif, comme Hy4 |
| Contexte | 1M tokens |
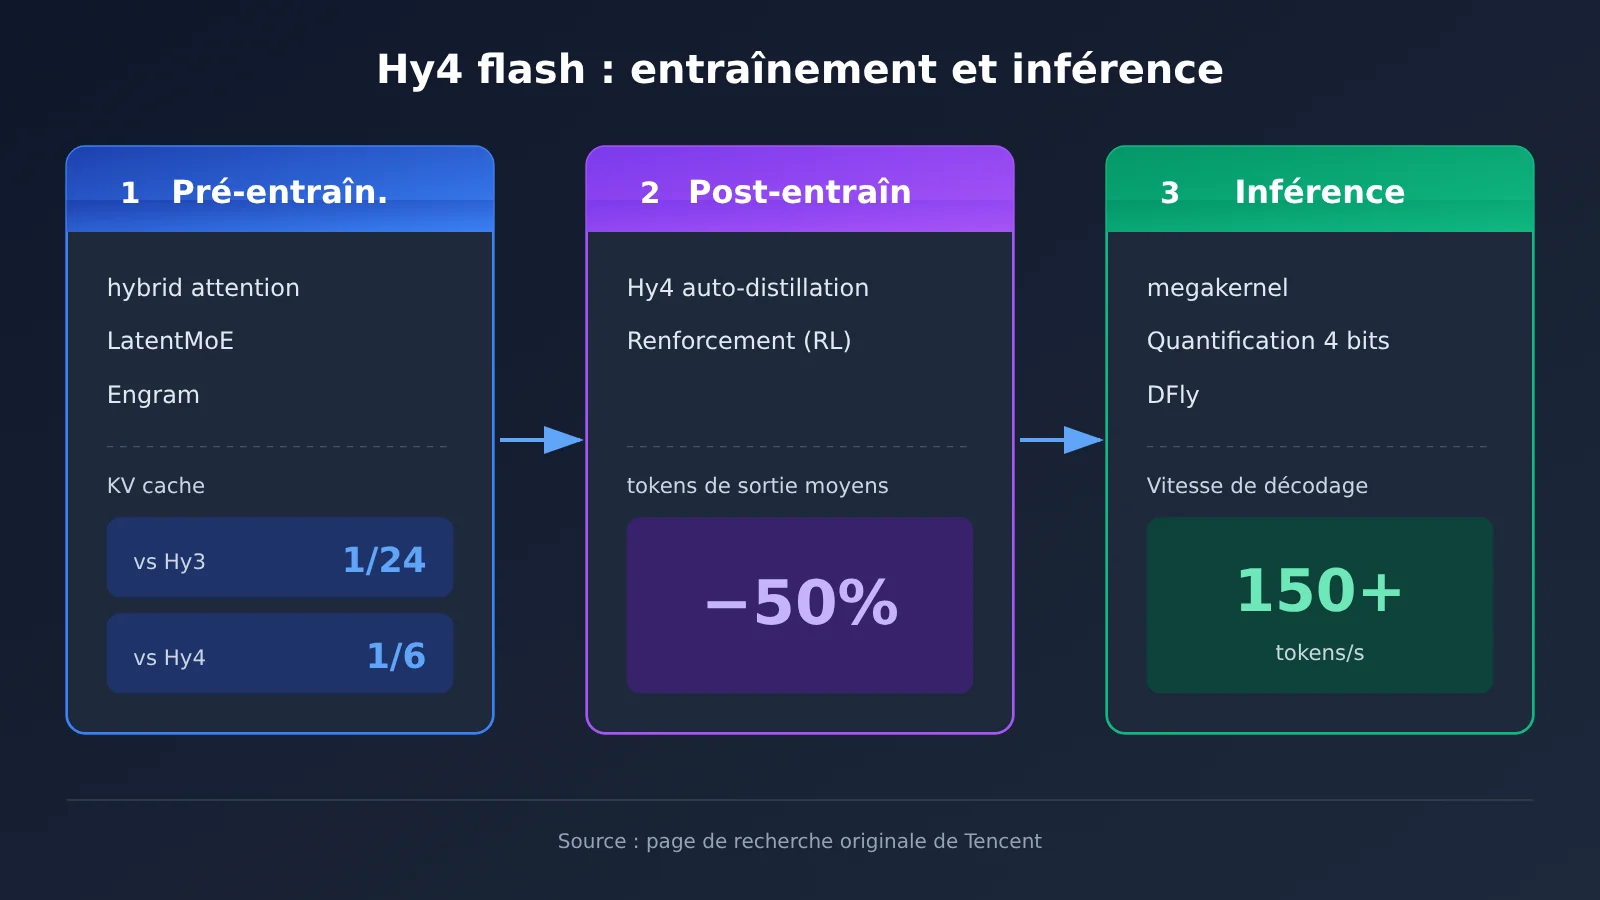
| Cache KV | 1/24 de Hy3, 1/6 de Hy4 |
| Vitesse de décodage | Plus de 150 tokens/s |
| Canaux | Tencent Cloud TokenHub, WorkBuddy, Yuanbao, WeCom, QQ, ima, Marvis ; OpenRouter bientôt disponible |
| Poids | Open source prévu ; la page n’indique pas qu’ils sont déjà publiés |
Stratégie d’entraînement et d’inférence de Hy4 flash
La phase de pré-entraînement a mobilisé trois choix de conception : hybrid attention, LatentMoE et Engram. C’est la principale raison de la forte réduction du cache KV. Le post-entraînement part d’une auto-distillation depuis Hy4, puis l’apprentissage par renforcement réduit de 50 % le nombre moyen de tokens de sortie de bout en bout. Pour la bureautique quotidienne, c’est un point crucial : le coût d’une tâche ne dépend pas seulement du prix unitaire, mais aussi de la quantité de texte produite par le modèle et du nombre d’étapes parcourues.
Côté inférence, l’équipe a utilisé megakernel, la quantification 4 bits et DFly ; la page de recherche annonce une vitesse de décodage supérieure à 150 tokens/s. Pour l’évaluation, Tencent ne s’appuie pas sur des classements publics : l’entreprise a créé son propre WorkIndex et l’a complété par une évaluation humaine. Les critères portent sur la qualité de livraison, la longueur de la sortie par tour et le temps nécessaire à la tâche. Cette approche se rapproche davantage de la question « peut-on finir le travail, et à quel prix ? », mais il s’agit d’un jeu de données interne à Tencent, impossible à reproduire directement depuis l’extérieur.
Hy4 flash, premier retour d’expérience : comparaison en aveugle avec Haiku
L’expression « proche de Haiku » vient d’un test à l’aveugle mené avec des humains. La page de recherche précise que les participants étaient 85 utilisateurs internes de WorkBuddy, sur 259 tâches réparties en 27 catégories. Les données ci-dessous sont autodéclarées par Tencent.
| Modèle | Satisfaction (échelle sur 4) | Temps médian de bout en bout | Coût par tâche (yuans) |
|---|---|---|---|
| DeepSeek-V4.1-Flash-1017 | 3,09 | 10,3 minutes | 1,20 yuan |
| Hy4 flash | 2,79 | 6,7 minutes | 0,26 yuan |
| Claude-Haiku-5.5 | 2,81 | 6,8 minutes | 4,73 yuans |
| GLM-5.3-Flash | 2,53 | 7,6 minutes | 0,81 yuan |
Trois points méritent votre attention à la lecture de ce tableau. Premièrement, le score de satisfaction le plus élevé revient à DeepSeek-V4.1-Flash-1017 avec 3,09, et non à Hy4 flash. Deuxièmement, Hy4 flash est inférieur de 0,02 point à Haiku : on peut donc seulement dire qu’il s’en approche, pas qu’il le dépasse. Troisièmement, les modèles externes utilisent tous le niveau « high », tandis que la ligne Hy4 flash n’indique aucun niveau.
Le véritable avantage de Hy4 flash se situe sur le temps et le coût. Son temps médian d’exécution est le plus court et son coût par tâche est le plus bas du tableau. Le « facteur 18 de réduction du coût par tâche » évoqué dans la publication officielle correspond à 4,73 yuans divisés par 0,26 yuan, soit environ 18,2, la comparaison portant sur Haiku. Ce facteur ne s’applique ni à DeepSeek, ni à Hy4.
Hy4 flash, deuxième série de mesures : le coût selon WorkIndex
L’équipe de recherche conclut, pour WorkIndex, que Hy4 flash obtient globalement des résultats légèrement supérieurs à Hy4 preview sur l’ensemble des tâches. Quant au coût moyen par tâche, il représente 1/13 de celui de Hy4 preview, 1/20 de celui de Hy4, et 1/8 de celui de DeepSeek-V4.1-Flash-1017 (palier Max, tarif de pointe).
Ces trois ratios ne concernent que WorkIndex. WorkIndex regroupe 8 jeux de données internes : génération de diapositives, édition de diapositives, co-écriture humain-IA de diapositives, co-écriture Markdown humain-IA, édition de documents, réparation de feuilles de calcul, traitement audio/vidéo et compréhension visuelle. Il s’agit de deux séries de tâches et de deux méthodes de calcul de coût distinctes de celles du tableau de test à l’aveugle mené auprès de 85 personnes. On ne peut donc pas appliquer le ratio 1/8 au 1,20 元 de DeepSeek figurant dans ce tableau, ni appliquer le facteur 18 à WorkIndex.
Il faut aussi rester prudent sur le « légèrement supérieur à Hy4 preview ». Cela signifie que Hy4 flash a rattrapé la version preview de la génération précédente sur les tâches du quotidien, et non qu’il a rattrapé la version officielle Hy4. L’annexe de la section suivante montrera cet écart.
Hy4 flash, mesures réelles (3) : l’écart entre Hy4 et preview dans l’annexe
L’annexe de la page de recherche donne les scores de Hy4 flash, Hy4, Hy4 preview, DeepSeek-V4.1-Flash-1017, Qwen3.8-Flash-Next, GLM-5.3-Flash et GPT-6 Luna, ainsi que le coût par tâche en yuans. Le tableau ci-dessous n’extrait que les quatre colonnes les plus utiles pour choisir un modèle. Tous les modèles sont pris à leur niveau de raisonnement le plus élevé, et le buddy index interne est évalué sur workbuddy cli. Claude Haiku 5.5 n’apparaît pas dans ce tableau : ne vous en servez donc pas pour en déduire le score de Haiku.
| Benchmark (texte original de l’annexe) | Hy4 flash | Hy4 | Hy4 preview | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|
| PPTCoEditBench | 74.0 | 78.9 | 71.5 | 76.8 |
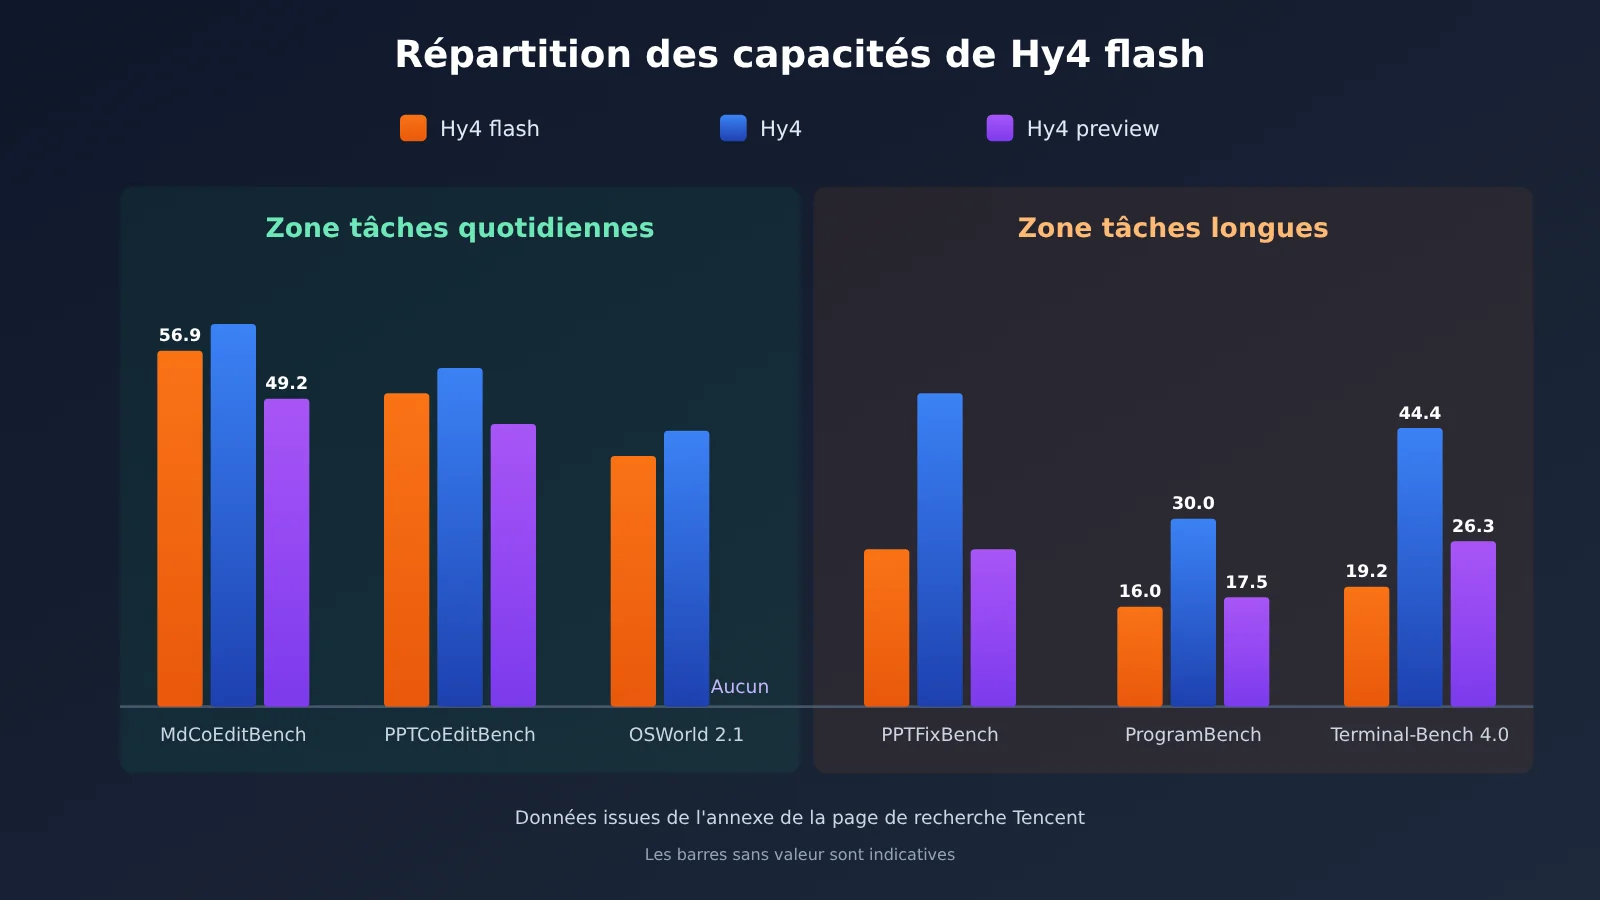
| MdCoEditBench | 56.9 | 57.7 | 49.2 | 29.2 |
| AutomationBench v1.0.6 | 52.2 | 56.2 | 36.3 | 54.3 |
| OSWorld 2.1 (Full, partial) | 68.1 | 78.9 | N/D | 68.4 |
| PPTFixBench | 23.7 | 45.6 | 23.8 | 45.3 |
| ExcelFixBench | 15.6 | 27.8 | 11.7 | 20.0 |
| DeepSWE v1.1 | 64.6 | 74.9 | 64.3 | 73.8 |
| ProgramBench (almost solved) | 16.0 | 30.0 | 17.5 | 29.0 |
| Terminal-Bench 4.0 | 19.2 | 44.4 | 26.3 | 40.0 |
Face à preview, Hy4 flash est le plus souvent au même niveau, voire au-dessus, sur les tâches de co-écriture et d’automatisation. MdCoEditBench passe de 49.2 à 56.9, AutomationBench de 36.3 à 52.2. En revanche, sur PPTFixBench et DeepSWE, il reste globalement au niveau de preview. Et sur ProgramBench et Terminal-Bench 4.0, il passe même en dessous de preview.
Face à la version officielle Hy4, l’écart se creuse à mesure que la tâche devient difficile. Sur la co-écriture, il ne manque que quelques points ; sur les tâches de correction et de terminal, l’écart atteint environ un facteur deux. Côté coût, Hy4 flash revient à environ 0.105 yuan par tâche sur PPTCoEditBench, contre environ 1.714 yuan pour Hy4. Ces montants en yuans sont calculés aux tarifs officiels de chaque modèle, sur la base de 7.2 yuans pour 1 dollar ; pour DeepSeek, c’est le tarif de pointe qui a été retenu. Ce sont les chiffres du tableau de Tencent, pas votre facture réelle.
Les points faibles de Hy4 flash : Terminal-Bench 4.0 et ProgramBench
Ces deux benchmarks méritent d’être traités séparément, car ils mettent précisément en évidence les faiblesses de Hy4 flash. Sur Terminal-Bench 4.0, Hy4 flash n’obtient que 19.2, contre 44.4 pour Hy4 et 40.0 pour DeepSeek-V4.1-Flash-1017 ; même la version preview, à 26.3, fait mieux. Ce benchmark utilise le harness Claude Code, avec jusqu’à 500 tours et une durée maximale de 13 heures par exécution. Or ce type de tâche terminal à longue chaîne est justement celui qui dépend le plus du plafond d’intelligence du modèle.
Sur l’indicateur « almost solved » de ProgramBench, Hy4 flash atteint 16.0, Hy4 30.0 et DeepSeek 29.0. La page de recherche précise d’ailleurs elle-même que pour l’ingénierie logicielle longue durée, il faut continuer avec Hy4. Le témoignage de WorkBuddy mentionne lui aussi une « légère baisse sur le codage longue durée ». Si votre agent passe l’essentiel de son temps à modifier du code dans le terminal, à lancer des tests et à corriger en boucle, ne le basculez pas sur Hy4 flash sous prétexte que le prix unitaire est plus bas.
Témoignages des équipes produit sur Hy4 flash : chacun parle pour soi
La page de recherche s’accompagne des témoignages de plusieurs produits internes. Tous sont des déclarations des équipes produit elles-mêmes ; les références de comparaison et les méthodologies diffèrent, on ne peut donc pas les additionner pour en tirer une conclusion de « supériorité globale ».
- WorkBuddy (Anne) : par rapport à Hy4, le temps moyen par tâche est inférieur de 70 % et le coût environ 15 fois moindre ; la qualité sur les tâches quotidiennes est comparable à Hy4, avec une légère baisse sur le codage longue durée. Ce 1/15 est une évaluation propre à WorkBuddy et ne correspond pas au 1/20 de WorkIndex.
- Yuanbao (Logan) : par rapport à Hy3, la performance agent est supérieure de 13.6 % et l’évaluation humaine en side-by-side de 7.56 % ; en conversation générale, +2.52 % face à GLM-5.3-Flash, l’amélioration la plus marquée concernant les dialogues multi-tours.
- WeChat Pay (Yilin et Simba) : par rapport à DeepSeek-V4.1-Flash-1017, la note moyenne sur quatre workflows est égale ou supérieure, avec environ 6 % d’étapes d’exécution en moins et 29 % de longueur de sortie par tour en moins ; le temps d’achèvement d’un scan statique de code diminue de 37 %, les tokens de 46 %, et la performance de raisonnement reste équivalente.
- WeCom (Dylan) : par rapport à Hy4, la vitesse de sortie est supérieure de 88 % et le nombre de tokens produits en mode réflexion inférieur d’environ 60 %.
- Honor of Kings (TH) : par rapport à DeepSeek-V4.1-Flash-1017 et GLM-5.3-Flash, la capacité à localiser la cause racine est proche, avec 22.0 % à 39.1 % de requêtes modèle en moins et 40.5 % à 61.2 % de tokens en moins ; en revanche, les appels d’outils sont supérieurs de 51.2 % et 7.7 % respectivement.
- ima (Kaycee) : par rapport aux deux modèles ci-dessus, l’attente moyenne est inférieure de 18 % à 35 %, la note des réponses supérieure de 1.8 % et la qualité du contenu de 8.1 %.
- QQ (Red et Look) : par rapport à DeepSeek-V4.1-Flash (la source ne mentionne pas la version 1017), le taux de réponses satisfaisantes est supérieur de 0.92 à 6.16 points de pourcentage sur plusieurs scénarios ; la précision de classification d’intention de l’assistant de canal reste équivalente, et la latence P90 des commentaires est réduite de 39 %.
- Marvis (Baihan) : par rapport à DeepSeek-V4.1-Flash-1017, la satisfaction est plus élevée sur des sous-catégories comme l’installation d’applications, les réglages système et la recherche documentaire, tandis que la satisfaction globale reste équivalente.
Le point commun de tous ces témoignages : « plus rapide, plus économe en tokens, qualité équivalente ou légèrement meilleure ». Les scénarios de comparaison sont surtout la conversation, le support client, les workflows et l’agent du quotidien. Aucune de ces équipes ne l’a utilisé pour de l’ingénierie logicielle longue durée en affirmant que c’était meilleur. Cela rejoint la conclusion de l’annexe.
Hy4 flash : tarifs et protocole — comment vérifier le modèle et le tarif
Tarifs catalogue de la page de recherche (USD par million de tokens) : pour Hy4 flash, entrée en cache 0.003, entrée 0.070, sortie 0.281 ; pour Hy4, respectivement 0.042, 0.834, 2.501. Jusqu’au 2026-11-30, l’API de Tencent Cloud TokenHub bénéficie d’une réduction de 50 %, et son utilisation est gratuite dans WorkBuddy. La page de recherche n’indique pas séparément le prix après réduction. Si on le calcule en divisant le tarif catalogue par 2, on obtient environ 0.035 en entrée et 0.1405 en sortie ; après le 30 novembre, le tarif catalogue s’applique de nouveau.
Sur APIYI, Hy4 flash n’est pas encore disponible ; nous ajouterons ce modèle dès que possible. Le modèle et le tarif de référence sont ceux indiqués dans la liste des modèles de la plateforme. Actuellement, le modèle hy4 disponible sur la plateforme est la version officielle de Hy4, et non la version flash. Le tableau ci-dessous distingue le prix catalogue APIYI et le prix officiel pour les modèles déjà disponibles (USD par million de tokens, dans l’ordre : entrée, sortie, lecture du cache).
| Modèle | Prix catalogue APIYI (liste des modèles apiyi.com) | Prix officiel / page de recherche | Endpoint |
|---|---|---|---|
| Hy4 flash | Pas encore disponible | 0.070 / 0.281 / 0.003 (tarif catalogue de la page de recherche) | — |
hy4 |
0.85 / 2.55 / 0.045 | 0.834 / 2.501 / 0.042 (tarif catalogue de la page de recherche) | chat |
deepseek-v4.1-flash-1017 |
0.30 / 1.20 / 0.006 | Heure de pointe 0.30 / 1.20 / 0.006 ; réduit de moitié en heure creuse | chat, messages |
claude-haiku-5-5 |
0.10 / 0.50 / 0.01 | ≤100 000 tokens : 0.10 / 0.50 / 0.01 ; >100 000 : 0.50 / 2.50 / 0.05 | chat, messages |
glm-5.3-flash |
0.15 / 0.50 / 0.03 | — | Chat Completions uniquement |
Quelques détails méritent d’être précisés séparément. Sur APIYI, les trois noms deepseek-v4.1-flash, deepseek-v4.1-flash-1017 et deepseek-flash de DeepSeek ont le même prix, qui correspond au tarif officiel en heure de pointe ; deepseek-v4-1-flash-260910 et deepseek-v4-1-flash-economy-261017 sont d’autres canaux, avec des tarifs différents, et ne représentent pas toute la série V4.1 Flash. Dans les règles officielles de Haiku, lorsque l’invite dépasse 100 000 tokens, toute la requête est facturée au tarif supérieur ; la note de bas de page du tableau APIYI ne mentionne que le deuxième palier d’entrée à 0.50. Avant d’appeler une tâche avec une longue invite, vérifiez le palier de sortie sur la page des modèles apiyi.com.
Pour les modèles déjà disponibles, l’appel se fait avec une clé API apiyi.com. Envoyez la requête à https://api.apiyi.com/v1 et renseignez base_url et model au format compatible OpenAI, par exemple hy4 ou deepseek-v4.1-flash-1017. Si vous avez besoin du format Anthropic Messages, choisissez un modèle qui prend en charge l’endpoint messages. glm-5.3-flash ne prend en charge que Chat Completions ; deepseek-v4.1-flash-1017 ne figure pas dans le groupe CodexResponses. Avant de le connecter à un outil de type Codex, vérifiez d’abord le groupe.
Analyse des avantages et inconvénients de Hy4 flash
Avantages
- Un bon rapport qualité-prix sur les tâches du quotidien : la satisfaction en tests à l’aveugle est proche de celle de Haiku, pour un coût de 0.26 yuan par tâche, soit environ 1/18 de celui de Haiku (chiffre communiqué par l’équipe).
- Rapide : c’est le temps de réalisation médian le plus court en test à l’aveugle ; la page de recherche indique un décodage supérieur à 150 tokens/s.
- Des sorties concises : après apprentissage par renforcement, le nombre moyen de tokens en sortie est réduit de moitié. Plusieurs retours d’équipes produit mentionnent aussi une baisse du nombre de tokens et d’étapes.
- De solides capacités de co-rédaction : la co-rédaction Markdown est presque au niveau de Hy4, et l’écart sur la co-rédaction de diaporamas ne se compte qu’en quelques points.
Limites
- Faible sur le terminal et le codage de longue haleine : Terminal-Bench 4.0 et ProgramBench sont nettement derrière Hy4, et même en dessous de preview. Pour ce type de tâches, mieux vaut continuer avec Hy4 ou DeepSeek-V4.1-Flash-1017.
- Les tâches de correction sont difficiles : PPTFixBench et ExcelFixBench n’atteignent qu’environ la moitié de Hy4. Pour corriger des documents complexes, il n’est pas recommandé de remplacer votre modèle actuel par celui-ci.
- Des preuves issues d’une seule source : WorkIndex est un jeu de données interne, les participants aux tests à l’aveugle sont des utilisateurs internes, et aucune réplication par un tiers n’existe pour l’instant. L’identifiant du modèle n’est pas encore indiqué sur la page de recherche.
- La vision n’est pas son point fort : BuddyVQA et MMMU-Pro ne sont pas les meilleurs du tableau. Le modèle convient aux scénarios de questions-réponses visuelles où un niveau correct suffit.
FAQ — Questions fréquentes
Q1 : Qu’est-ce que Hy4 flash ?
Hy4 flash est un modèle léger publié par Tencent Hunyuan le 16 novembre 2026. Il compte 224B de paramètres au total, avec 12B activés par token, est nativement multimodal et dispose d’une fenêtre de contexte de 1M. Il est issu d’une auto-distillation de Hy4 et se positionne sur les tâches de productivité du quotidien.
Q2 : Hy4 flash est-il vraiment meilleur que Claude Haiku 5.5 ?
On ne peut pas le dire. Dans les tests à l’aveugle officiels, son score de satisfaction atteint 2,79, contre 2,81 pour Haiku ; la page de recherche parle d’ailleurs de « proche ». Son atout réside dans un temps d’exécution légèrement plus court et un coût par tâche bien inférieur. Par ailleurs, c’est DeepSeek-V4.1-Flash-1017 qui obtient le meilleur score de satisfaction en test à l’aveugle.
Q3 : Quand pourra-t-on utiliser Hy4 flash ?
La page de recherche indique qu’il est déjà disponible sur Tencent Cloud TokenHub, WorkBuddy, Yuanbao et d’autres canaux, et que son arrivée sur OpenRouter est imminente. L’offre — gratuité dans WorkBuddy et 50 % de réduction sur l’API TokenHub — court jusqu’au 30 novembre 2026. Les poids sont annoncés comme open source, mais n’ont pas encore été publiés.
Q4 : Quelles tâches ne faut-il pas faire migrer de Hy4 vers Hy4 flash ?
Les tâches longues en terminal, l’ingénierie logicielle de longue haleine, les présentations PowerPoint complexes et la réparation de tableurs. Dans l’annexe, les scores de ces catégories atteignent environ la moitié de ceux de Hy4, et la page de recherche recommande elle aussi de continuer à utiliser Hy4 pour l’ingénierie logicielle de longue haleine.
Q5 : Peut-on dès maintenant appeler Hy4 flash via APIYI ?
Pas pour l’instant : la plateforme ne propose que la version officielle `hy4`. Une fois le modèle disponible, référez-vous au nom et au tarif indiqués dans la liste des modèles sur apiyi.com. En attendant, vous pouvez utiliser la même clé API pour appeler `hy4`, `deepseek-v4.1-flash-1017` et `claude-haiku-5-5`, histoire de mettre en place votre propre comparatif.
Q6 : Le facteur 18 des tests à l’aveugle et le 1/20 de WorkIndex sont-ils convertibles entre eux ?
Non. Le facteur 18 correspond au rapport, dans le tableau des tests à l’aveugle, entre le coût par tâche en yuans de Haiku et celui de Hy4 flash ; les valeurs 1/8, 1/13 et 1/20 proviennent de WorkIndex, avec pour points de comparaison respectifs DeepSeek, Hy4 preview et Hy4. Le 1/15 cité dans le témoignage WorkBuddy relève encore d’une autre évaluation. Les trois reposent sur des ensembles de tâches et des définitions de coût différentes.
Hy4 flash : points clés (Key Takeaways)
- Positionnement clair : Hy4 flash est un modèle à faible coût, pensé pour le travail bureautique quotidien et les agents légers.
- Proche, sans dépasser : satisfaction de 2,79 en test à l’aveugle, contre 2,81 pour Haiku ; DeepSeek arrive en tête avec 3,09.
- Des bases de coût à distinguer : le facteur 18 concerne Haiku ; le 1/20 concerne Hy4 dans WorkIndex.
- La co-rédaction est directement utilisable : la co-rédaction de Markdown et de diapositives est proche de Hy4.
- Des limites clairement identifiées : score de 19,2 à Terminal-Bench 4.0 et de 16,0 à ProgramBench.
- Statut d’intégration : APIYI ne propose pas encore Hy4 flash ; les modèles déjà disponibles passent tous par une interface compatible OpenAI.
En résumé
Ce que vaut Hy4 flash dépend de la tâche que vous lui confiez :
- Tâches quotidiennes : co-rédaction de diapositives, Markdown, questions-réponses visuelles, utilisation de l’ordinateur. Il peut offrir, à très faible coût, une satisfaction proche de celle de Haiku (test à l’aveugle officiel).
- Tâches complexes : réparation de PPT complexes, tâches longues dans le terminal, ingénierie logicielle de longue haleine. L’écart avec Hy4 est net ; mieux vaut continuer avec Hy4 ou DeepSeek-V4.1-Flash-1017.
- Nature des preuves : toutes les données sont autodéclarées par Tencent. Elles peuvent servir de référence pour le choix du modèle, mais il faudra encore les valider avec vos propres tâches avant la mise en production.
L’approche la plus pragmatique consiste à répartir selon les tâches : basculer d’abord une partie du trafic des tâches quotidiennes vers Hy4 flash, sans toucher aux tâches longues. Une fois Hy4 flash disponible sur APIYI, vous pourrez comparer ses performances réelles à celles de hy4 et de deepseek-v4.1-flash-1017 sur apiyi.com, avec la même clé API.
📚 Références
-
Page de recherche Tencent Hunyuan Hy4 flash : spécifications, tests à l’aveugle, WorkIndex, annexes et témoignages produits
- Lien :
hy.tencent.ai/research/hy4-flash - Note : source originale de toutes les données d’évaluation de cet article, page datée du 2026-11-16
- Lien :
-
Post de publication officiel de Tencent Hunyuan : coût de tâche 18x et tarif catalogue de l’API
- Lien :
x.com/TencentHunyuan/status/2122217770314301469 - Note : communication officielle, l’objet de comparaison étant Claude Haiku 5.5
- Lien :
-
Page de tarification officielle de DeepSeek : tarifs V4.1 Flash en heures de pointe et heures creuses
- Lien :
api-docs.deepseek.com/quick_start/pricing - Note : permet de consulter la définition des heures de pointe et la correspondance avec les noms d’invocation
- Lien :
-
Documentation officielle de Claude Haiku 5.5 : ID du modèle et règles de facturation à deux niveaux
- Lien :
platform.claude.com/docs/en/models/haiku-5-5/overview - Note : précise la règle de facturation sur l’ensemble de la requête lorsque l’invite dépasse 100 000 tokens
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter via la page d’accueil du site APIYI ; les descriptions des modèles et des points de terminaison sont disponibles dans le centre de documentation docs.apiyi.com