gemini-4-argon se lanzó el 13 de octubre de 2026. Poco después de integrarlo, muchos desarrolladores empezaron a recibir errores 429: bastaba con aumentar la concurrencia para que aparecieran, y a veces fallaban incluso las solicitudes individuales. La primera reacción de muchos fue pensar que «el límite de concurrencia de AI Studio es demasiado bajo», pero probablemente esa conclusión sea equivocada. En este artículo analizamos cómo funciona realmente la limitación de velocidad de gemini-4-argon en AI Studio y presentamos una solución práctica para resolver los errores 429.
Esto no es otro tutorial genérico que se limita a decir «añade algunos reintentos y listo». Antes, aclaremos un hecho importante: Google no ha publicado una cifra fija y universal de concurrencia para gemini-4-argon. Por eso, los números que circulan en internet, como «10 solicitudes concurrentes» o «50», carecen de fundamento.
Qué te llevas: al terminar de leer, sabrás distinguir cuatro causas de errores 429: RPM, TPM, velocidad de consumo y capacidad del proveedor. También aprenderás a aplicar retroceso exponencial y limitación de velocidad, y descubrirás cómo usar el canal de alta concurrencia de APIYI (apiyi.com) para superar los límites de cuota de un proyecto individual de AI Studio.
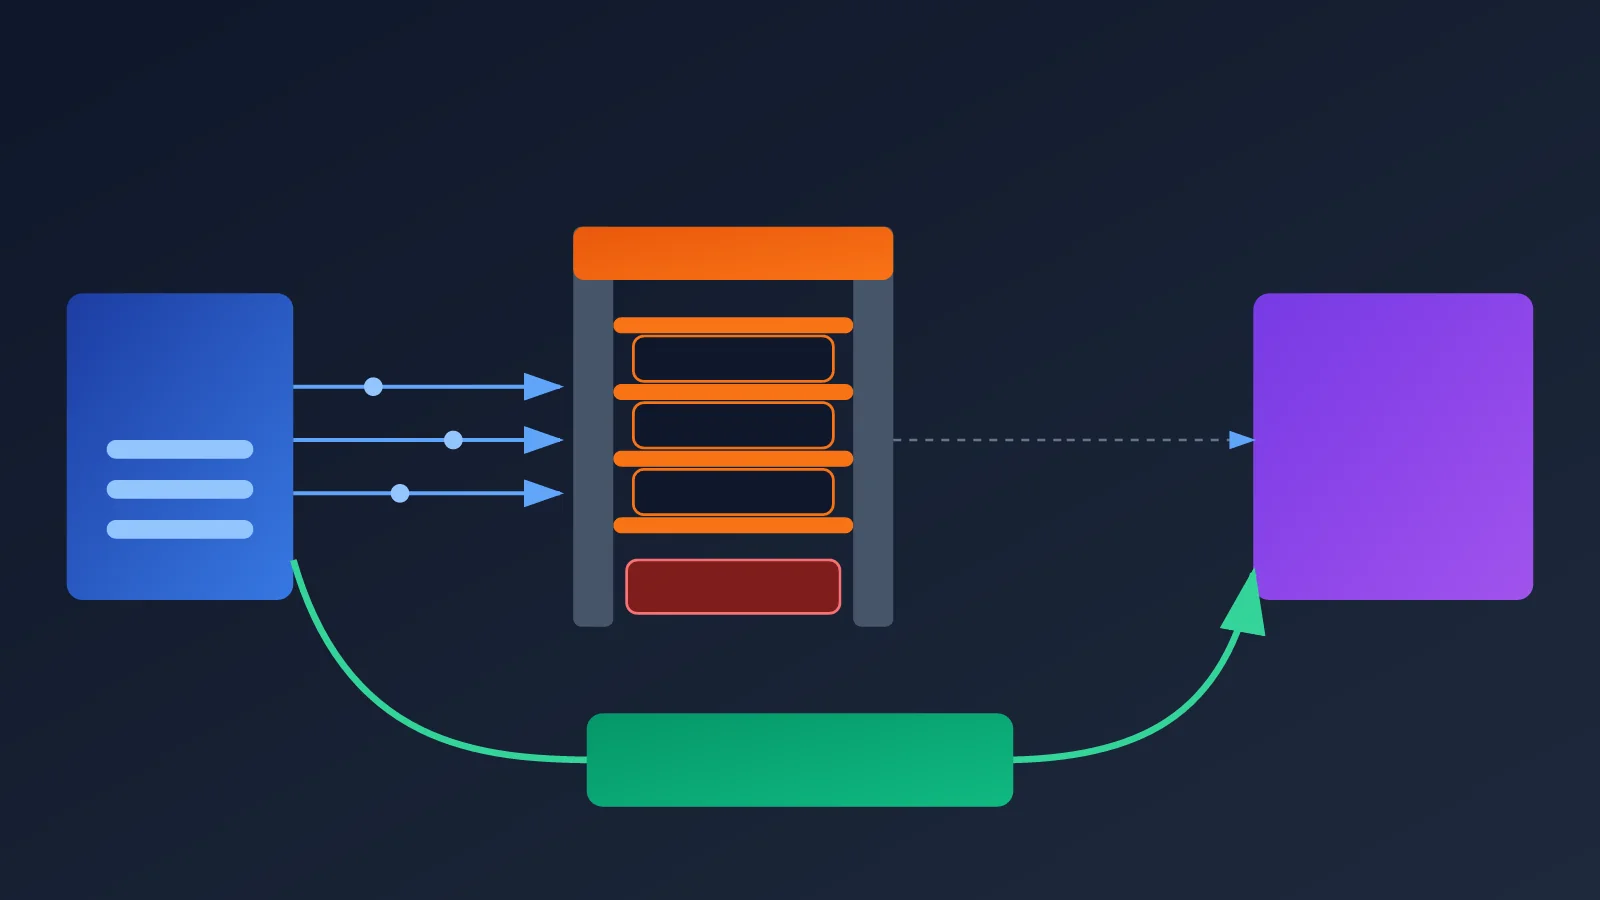
Puntos clave de gemini-4-argon
Primero, resumimos las conclusiones del artículo en una tabla. En las siguientes secciones analizaremos cada punto.
| Punto clave | Descripción | Valor |
|---|---|---|
| No hay un límite fijo de concurrencia publicado | Google no ha publicado un límite de concurrencia unificado para gemini-4-argon. La limitación se basa en métricas como RPM, TPM y RPD | Evita planificar la capacidad con cifras incorrectas |
| RPM no equivale a concurrencia | La cantidad de solicitudes en curso depende del tiempo medio de respuesta, no solo del número de solicitudes por minuto | Permite estimar correctamente las necesidades de concurrencia |
| Los límites se aplican por proyecto | Crear varias claves en un mismo proyecto no multiplica la cuota | Evita perder tiempo alternando claves |
| Límite de consumo de 10 minutos | Tier 1: $10; Tier 2: $50; Tier 3: $200 | Explica por qué puede aparecer un error 429 aunque no se haya superado el límite de RPM |
| Los errores 429 requieren un diagnóstico por etapas | Primero, revisa la respuesta original; después, limita la tasa, aplica retrocesos, cambia de canal o solicita una ampliación de cuota | Resuelve el problema paso a paso y en orden de prioridad |
| Canal de alta concurrencia de APIYI | APIYI apiyi.com admite alta concurrencia con gemini-4-argon. Con menos de 500 RPM, no tendrás que preocuparte por la limitación de tasa | Una opción directa para proyectos de pequeña y mediana escala |
Por qué un error 429 no siempre significa que se haya superado el límite de concurrencia
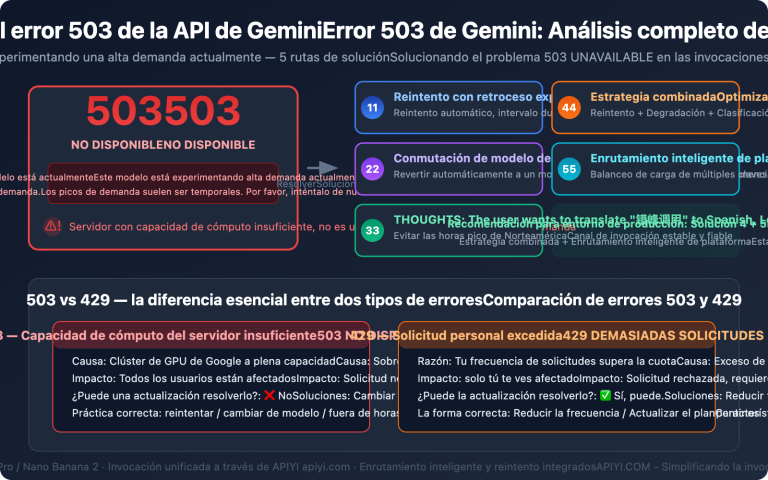
Muchos desarrolladores equiparan el error 429 con «demasiada concurrencia», pero en el sistema de limitación de Google la concurrencia no es una métrica independiente. Un error 429 RESOURCE_EXHAUSTED puede deberse al número de solicitudes por minuto, a los tokens de entrada por minuto, al número de solicitudes diarias, al gasto acumulado en una ventana móvil de 10 minutos o, incluso, a la falta de capacidad del proveedor durante las primeras etapas del lanzamiento de un modelo nuevo.
gemini-4-argon lleva menos de una semana disponible y los recursos del proveedor todavía están aumentando. Por eso, aunque tu cuota sea suficiente, es posible que se rechacen solicitudes temporalmente por falta de capacidad. Así que el primer paso para investigar un error 429 siempre es identificar su causa concreta, no reducir la concurrencia a ciegas.
¿Cuál es la concurrencia de gemini-4-argon en AI Studio?
Respuesta directa: no hay un valor fijo y público que se aplique a todos los casos. En AI Studio, cada proyecto tiene sus propios límites efectivos de RPM, TPM y RPD para gemini-4-argon. Las cifras concretas dependen del nivel de Tier y del estado del proyecto, así que tendrás que consultarlas en el panel de control.
Los cinco tipos de límites de AI Studio
El sistema de límites que utiliza Google se puede resumir en la siguiente tabla. Si se alcanza cualquiera de estos límites, puede devolverse un error 429.
| Métrica de límite | Significado | ¿Puede causar un error 429? |
|---|---|---|
| RPM | Solicitudes por minuto | Sí |
| TPM | Tokens de entrada por minuto | Sí |
| RPD | Solicitudes por día | Sí |
| Velocidad de consumo | Importe de consumo de la API en una ventana móvil de 10 minutos | Sí |
| Capacidad real del servicio | Recursos disponibles en el proveedor de Google | Es posible |
Ten en cuenta la última fila: la falta de capacidad es una situación que «no puedes resolver ajustando parámetros». Solo puedes mitigarla reduciendo el tráfico, reintentando más tarde o cambiando de canal.
Cómo se relacionan RPM y concurrencia
RPM es el total de solicitudes en un minuto; la concurrencia, el número de solicitudes en curso en un mismo momento. Ambas métricas están relacionadas por el tiempo que tarda cada solicitud. Por ejemplo, en un proyecto con un límite de 60 RPM —solo como ejemplo de cálculo, no representa la cuota real de Argon—:
- Si el tiempo medio de respuesta es de 5 segundos, habrá unas 5 solicitudes en curso, en promedio.
- Si el tiempo medio de respuesta es de 30 segundos, habrá unas 30 solicitudes en curso, en promedio.
- Si se envían 60 solicitudes a la vez, puede haber limitaciones temporales de tasa o de capacidad, aunque no se supere el total permitido en un minuto.
El tercer caso es el que más suele pasarse por alto. Muchos scripts de pruebas de carga envían todas las solicitudes a la vez. Este pico de tráfico tiene más probabilidades de activar una limitación que un flujo uniforme, aunque el volumen total cumpla los límites.
Cómo consultar la cuota real de gemini-4-argon en el panel
Abre la página Rate Limits de Google AI Studio (en aistudio.google.com/usage, cambia a la pestaña rate-limit). También puedes acceder desde la documentación oficial sobre límites de velocidad: ai.google.dev/gemini-api/docs/rate-limits. Selecciona el proyecto correspondiente y gemini-4-argon para consultar los límites efectivos de RPM, TPM y RPD, así como el nivel de Tier actual.
Google especifica claramente que los límites se aplican por proyecto, no por clave API. Esto significa que crear más claves en un mismo proyecto no multiplica la cuota. Por tanto, en AI Studio no se puede ampliar la capacidad alternando «varias claves».
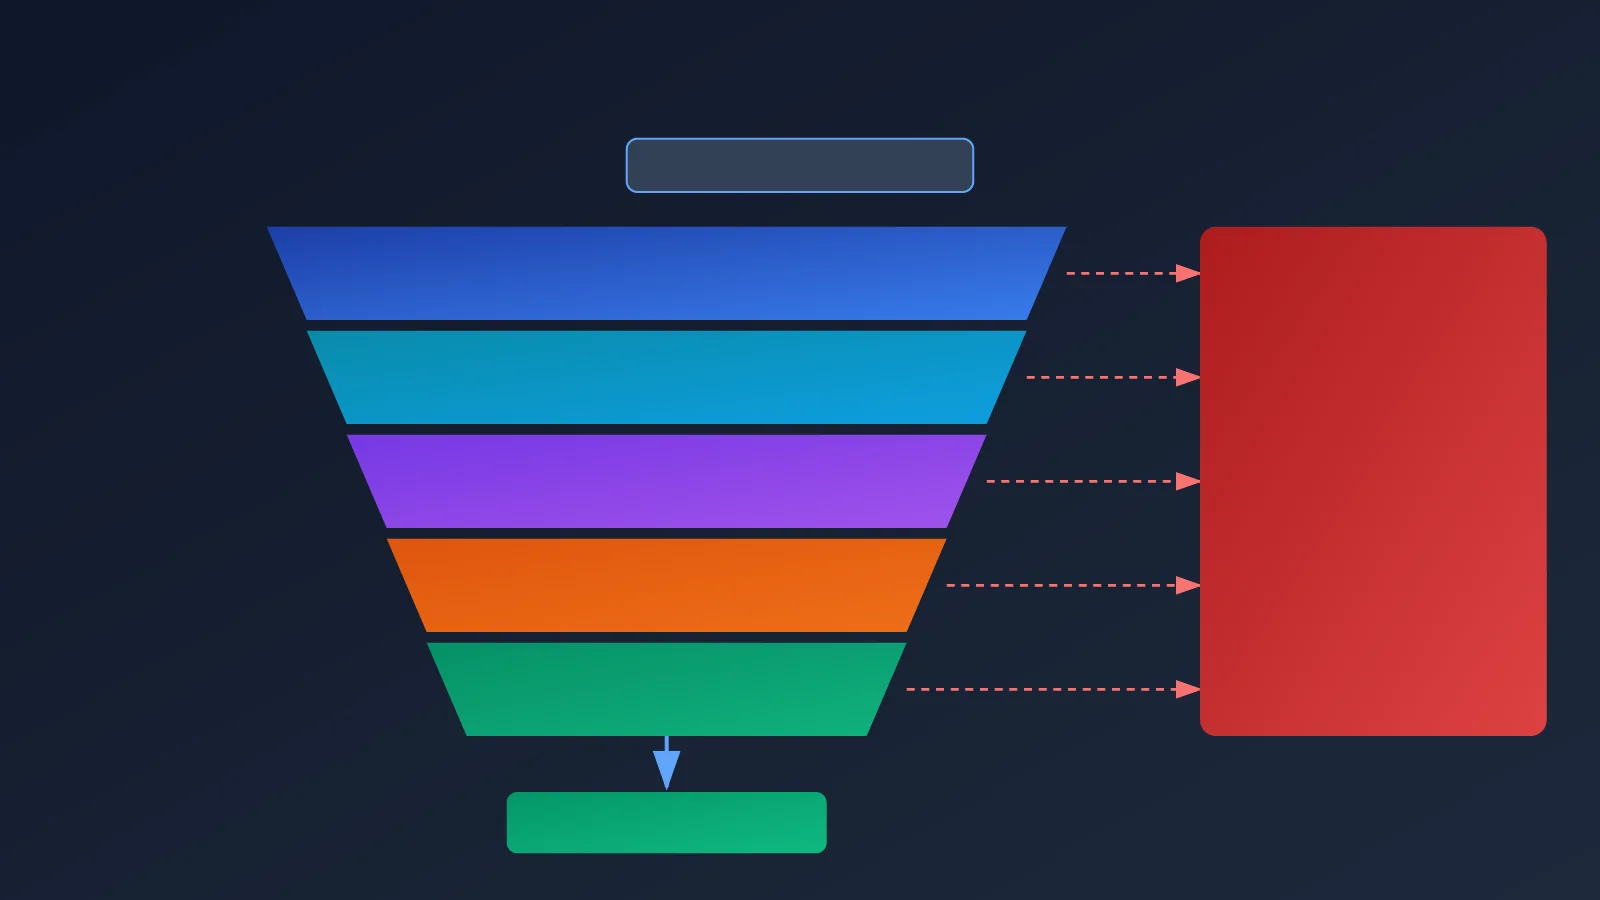
5 causas frecuentes de errores 429 en gemini-4-argon
Ahora que entendemos las métricas de límites, veamos los casos que suelen causar problemas. Estas cinco causas explican la mayoría de los errores 429 reportados para gemini-4-argon.
- Picos en la tasa de solicitudes: las tareas por lotes o los scripts de pruebas de carga envían muchas solicitudes de golpe y generan un pico que supera la capacidad instantánea de RPM.
- Límite de TPM alcanzado: las ventanas de contexto largas y los documentos extensos consumen tokens rápidamente. Aunque haya pocas solicitudes, se puede alcanzar primero el límite de TPM.
- Límite de consumo de 10 minutos alcanzado: es el límite que más fácilmente se pasa por alto; se explica en detalle a continuación.
- Límite diario de RPD agotado: si los errores 429 empiezan después de un tiempo de funcionamiento, suele ser una señal de que se agotó la cuota diaria.
- Capacidad insuficiente del proveedor: cuando se lanza un modelo nuevo, puede haber escasez de recursos. Por eso, las solicitudes podrían rechazarse incluso si la cuota disponible es suficiente.
Una causa fácil de pasar por alto: el límite de consumo de 10 minutos
Según la documentación oficial de Google, actualizada el 15 de octubre de 2026, cada nivel de cuenta tiene un límite de consumo dentro de una ventana móvil de 10 minutos.
| Nivel de cuenta | Límite de consumo cada 10 minutos |
|---|---|
| Tier 1 | $10 |
| Tier 2 | $50 |
| Tier 3 | $200 |
Por ejemplo, si una cuenta Tier 1 acumula un consumo de $10 en 10 minutos, podría recibir 429 RESOURCE_EXHAUSTED aunque no haya superado los límites de RPM ni de TPM. Como modelo de nueva generación, gemini-4-argon puede tener un costo por invocación superior al de los modelos anteriores. Las solicitudes con ventanas de contexto largas hacen que el consumo aumente más rápido, lo que explica por qué a veces se aplican límites incluso con un volumen bajo de solicitudes.
También conviene tener en cuenta que las cuotas de Argon Batch API que aparecen en la documentación de Google son cuotas de tokens para la cola de procesamiento por lotes. No deben interpretarse como cuotas de concurrencia para la API en tiempo real.
¿Cómo identificar el origen de los errores 429 en gemini-4-argon?
Cada tipo de problema apunta a una causa distinta. Investigar según los síntomas es mucho más eficaz que ajustar parámetros a ciegas.
| Síntoma | Aspectos que conviene revisar primero | Qué hacer |
|---|---|---|
| Los errores 429 aparecen con frecuencia al aumentar la concurrencia | Tasa instantánea de solicitudes, RPM y capacidad del proveedor | Haz pruebas de carga escalonadas y distribuye las solicitudes de manera uniforme. Mantener fija la concurrencia no significa mantener fijas las RPM. |
| Los errores 429 empiezan después de un tiempo de funcionamiento | Límite de consumo de 10 minutos, RPD y acumulación de TPM | Revisa la curva de consumo y el uso de la cuota diaria. |
| Aparecen errores 429 con una sola solicitud o con concurrencia muy baja | Capacidad insuficiente del proveedor o restricciones en la cuenta o el proyecto | Consulta la respuesta original y considera cambiar de canal. |
Varios elementos Key presentan errores 429 a la vez |
Las distintas Key pertenecen al mismo proyecto y comparten la cuota |
Reduce el tráfico total del proyecto o usa un canal con una cuota independiente. |
Al investigar, hay dos datos clave: primero, si tu cuenta de AI Studio es Tier 1, 2 o 3; segundo, el contenido original del error 429, especialmente error.message, error.details y el encabezado de respuesta Retry-After. Con estos datos, normalmente puedes distinguir si el problema se debe a una cuota de cuenta demasiado baja, a un volumen de solicitudes excesivo o a una falta de capacidad del nuevo modelo Argon de Google. Cada caso requiere una solución diferente.
Solución en 6 pasos para los errores 429 de gemini-4-argon
A continuación, se indican las medidas según su prioridad práctica. P0 es imprescindible y P2 corresponde a la planificación a largo plazo.
| Prioridad | Medida | Objetivo |
|---|---|---|
| P0 | Revisar la respuesta 429 original y Retry-After |
Determinar la causa concreta de la limitación |
| P0 | Limitar RPM, TPM y velocidad de consumo según la configuración del proyecto | Evitar que se sigan alcanzando los límites de cuota |
| P0 | Aplicar reintentos con retroceso exponencial y fluctuación aleatoria para los 429 | Mitigar las limitaciones causadas por picos repentinos |
| P1 | Cambiar automáticamente a un canal operativo con cuota independiente cuando se produzca un 429 | Aumentar la tasa de éxito |
| P1 | Mejorar el Tier o solicitar a Google un aumento de cuota | Aumentar la capacidad a largo plazo |
| P2 | Evaluar Vertex AI u otros canales con autorización oficial | Ampliar la disponibilidad de recursos |
Paso 1: Interpretar la respuesta 429 original
No te limites a ver el código de estado y reintentar. Primero, imprime el cuerpo completo del error y los encabezados de la respuesta. Fíjate especialmente en error.message, error.details y Retry-After. Si el proveedor ya te indica cuánto tiempo debes esperar, respeta ese intervalo en lugar de elegir uno al azar.
Paso 2: Aplicar límites de velocidad desde el cliente
Mantén las RPM entre el 70 % y el 80 % del límite visible en el panel de control, gestiona las TPM por separado y supervisa también el importe consumido en intervalos de 10 minutos. Dejar margen permite absorber los picos de tráfico y las fluctuaciones del servicio. Muchos equipos limitan solo el número de solicitudes e ignoran los tokens y el importe; por eso acaban recibiendo errores aunque «claramente no hayan superado las RPM».
Paso 3: Aplicar retroceso exponencial con fluctuación aleatoria
Google recomienda usar retroceso exponencial para los errores 429, por ejemplo, esperar 1, 2, 4 y 8 segundos, y añadir una fluctuación aleatoria. Así se evita que muchas solicitudes vuelvan a intentarlo al mismo tiempo y provoquen una nueva congestión. Limita los reintentos a 2 o 3 y prioriza siempre el tiempo de espera que indique el proveedor.
Paso 4: Cambiar de canal si los errores 429 persisten
Si un mismo proyecto sigue devolviendo errores 429, deja de reintentar contra él: solo empeorará la limitación. Lo adecuado es reducir el tráfico o cambiar a un canal operativo con una cuota independiente. Ahí es donde aportan valor los servicios de agregación: al realizar las llamadas mediante APIYI apiyi.com, las solicitudes pueden distribuirse entre varios canales con cuotas independientes, en lugar de hacer que un único proyecto de AI Studio soporte toda la carga.
Paso 5: Mejorar el Tier o solicitar un aumento de cuota
A largo plazo, la falta de capacidad se resuelve mejorando el nivel de la cuenta o solicitando a Google un aumento de cuota. Al subir de Tier, no solo se amplían los límites de RPM y TPM: el límite de consumo en 10 minutos también puede aumentar de 10 a 50 o incluso 200 dólares. Sin embargo, el aumento de cuota requiere tiempo y un historial de consumo, por lo que normalmente no llega a tiempo para el lanzamiento del servicio.
Paso 6: Evaluar otros canales con autorización oficial
Si el servicio sigue creciendo, puedes evaluar Vertex AI u otros canales con autorización oficial para ampliar la disponibilidad de recursos. Operar con varios canales en paralelo también es una forma sólida de reducir el riesgo de depender de un único proveedor.
Recomendaciones para probar la carga de un canal nuevo
Para los canales que se incorporen a Argon, se recomienda empezar las pruebas de carga con una concurrencia de entre 5 y 10. Ten en cuenta que este es solo un parámetro inicial de prueba, no el límite oficial de concurrencia. Después, aumenta la carga por etapas y envía las solicitudes de manera uniforme en cada nivel. Registra por separado la tasa de errores 429, las RPM reales, las TPM, el consumo en intervalos de 10 minutos y la latencia de las solicitudes para cada proveedor, proyecto de Google y modelo. Pasa al siguiente nivel solo cuando hayas confirmado que el actual es estable.
Primeros pasos con gemini-4-argon: llamadas mediante APIYI
Una vez explicada la teoría, veamos el código. APIYI ofrece una interfaz compatible con OpenAI: solo tienes que cambiar base_url para llamar a gemini-4-argon.
Ejemplo mínimo
Con poco más de 10 líneas de código puedes realizar una llamada:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

response = client.chat.completions.create(
    model="gemini-4-argon",
    messages=[{"role": "user", "content": "用一句话解释什么是 429 限流"}]
)
print(response.choices[0].message.content)
Ver el código completo: llamadas concurrentes con retroceso exponencial, fluctuación aleatoria y Retry-After
import random
import time
from concurrent.futures import ThreadPoolExecutor

import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

MAX_RETRIES = 3       # 最多重试 2-3 次
BASE_DELAY = 1.0      # 指数退避起点:1、2、4、8 秒


def call_argon(prompt: str) -> str:
    """调用 gemini-4-argon,429 时指数退避并优先遵循 Retry-After"""
    for attempt in range(MAX_RETRIES + 1):
        try:
            resp = client.chat.completions.create(
                model="gemini-4-argon",
                messages=[{"role": "user", "content": prompt}],
                max_tokens=512,
            )
            return resp.choices[0].message.content
        except openai.RateLimitError as e:
            if attempt == MAX_RETRIES:
                return f"Error after retries: {e}"
            # 优先使用上游返回的 Retry-After
            retry_after = None
            try:
                retry_after = float(e.response.headers.get("Retry-After"))
            except (AttributeError, TypeError, ValueError):
                pass
            delay = retry_after if retry_after else BASE_DELAY * (2 ** attempt)
            delay += random.uniform(0, 0.5)  # 随机抖动,避免集体重试
            print(f"429,第 {attempt + 1} 次重试,等待 {delay:.1f}s")
            time.sleep(delay)
        except Exception as e:
            return f"Error: {e}"


if __name__ == "__main__":
    prompts = [f"请用一句话介绍第 {i} 种限流策略" for i in range(10)]
    # 并发度从 5 起步压测,不是官方上限
    with ThreadPoolExecutor(max_workers=5) as pool:
        for result in pool.map(call_argon, prompts):
            print(result)
Inicio rápido: Te recomendamos registrarte en APIYI apiyi.com y obtener una clave API para comprobar directamente cómo funciona gemini-4-argon con el código anterior. La plataforma ofrece una interfaz unificada compatible con OpenAI, así que no necesitas solicitar ni mantener varios proyectos de Google por tu cuenta.
Implementación sencilla de un limitador de velocidad en el cliente
Además de reintentar, es más importante evitar «darse contra la pared». A continuación se muestra un limitador mínimo basado en el concepto de bucket de tokens, que ayuda a regular el ritmo de las solicitudes y a evitar los picos:
import threading
import time


class RateLimiter:
    """按目标 RPM 匀速放行请求,避免瞬时尖峰"""

    def __init__(self, rpm: int):
        self.interval = 60.0 / rpm
        self.lock = threading.Lock()
        self.next_time = time.monotonic()

    def wait(self):
        with self.lock:
            now = time.monotonic()
            if now < self.next_time:
                time.sleep(self.next_time - now)
            self.next_time = max(now, self.next_time) + self.interval


limiter = RateLimiter(rpm=300)  # 按后台限额的 70%-80% 设置

# 在每次调用前执行:
# limiter.wait()
Coloca el limitador al principio de la función de llamada y combínalo con los reintentos con retroceso anteriores. Así tendrás una doble protección: limitación proactiva y retroceso reactivo.
Canal de alta concurrencia de gemini-4-argon de APIYI
El principal límite de conectarse directamente a AI Studio es que la cuota de cada proyecto es fija. Además, las cuentas Tier 1 están sujetas a un límite de consumo de 10 USD cada 10 minutos. Un servicio de agregación puede distribuir el tráfico entre varios canales con cuotas independientes y cambiar automáticamente a un canal disponible cuando uno de ellos empieza a devolver errores 429 de forma continuada.
APIYI apiyi.com ya admite gemini-4-argon con alta concurrencia. Con menos de 500 RPM, no tienes que preocuparte por los límites de velocidad. Puedes empezar a usarlo directamente. Para la mayoría de las aplicaciones de pequeña y mediana escala, las herramientas internas, los flujos de trabajo automatizados y las pruebas de carga, este nivel es suficiente para cubrir las necesidades habituales. Así, no tendrás que preocuparte por el nivel Tier, la cuota del proyecto ni la ventana de consumo de 10 minutos.
| Aspecto | Conexión directa a AI Studio | Llamadas a través de APIYI |
|---|---|---|
| Asignación de la cuota | Un solo proyecto; varias claves comparten la cuota | Varios canales con cuotas independientes, gestionados por la plataforma |
| Gestión de errores 429 | Debes implementar la espera progresiva y el cambio de canal | La plataforma prioriza el cambio a un canal disponible; el cliente solo necesita reintentos básicos |
| Límites de consumo | Sujeta al límite de consumo de 10 minutos del nivel Tier | No es necesario gestionar el nivel de la cuenta de Google |
| Integración | Hay que solicitar un proyecto y configurar el nivel Tier | Interfaz unificada compatible con OpenAI: basta con cambiar base_url |
| Escala adecuada | Bajo tráfico o nivel Tier superior | Con menos de 500 RPM, no tienes que preocuparte por los límites |
🎯 Recomendación técnica: Si el pico de tráfico de tu aplicación se mantiene por debajo de 500 RPM, puedes llamar directamente a gemini-4-argon a través de APIYI apiyi.com y centrarte en la lógica de negocio. Si esperas superar ese nivel, te recomendamos realizar pruebas de carga por etapas y coordinar con antelación la capacidad con la plataforma.
Aunque uses un canal de alta concurrencia, es buena práctica mantener la espera exponencial y configurar tiempos de espera razonables en el cliente. Pueden producirse fluctuaciones de red o interrupciones breves en el servicio ascendente; una buena lógica de reintentos ayuda a que tu servicio siga funcionando con estabilidad incluso en situaciones extremas.
Preguntas frecuentes (FAQ)
Q1: ¿Cuál es realmente la concurrencia de gemini-4-argon en AI Studio?
Google no ha publicado un límite de concurrencia fijo y uniforme. Los límites reales dependen del RPM, el TPM, el RPD y el límite de consumo de 10 minutos del proyecto. Para consultarlos, selecciona el proyecto y el modelo correspondientes en la página Rate Limits de AI Studio. Las cifras concretas de concurrencia que circulan por Internet no tienen respaldo oficial, así que no conviene usarlas para planificar la capacidad.
Q2: ¿Crear varias claves API aumenta la cuota de gemini-4-argon?
No. Google especifica claramente que los límites se aplican por proyecto, no por clave API. Todas las claves de un mismo proyecto comparten la misma cuota. Para tener cuotas realmente independientes, necesitas proyectos de Google diferentes o usar un servicio de agregación multicanal como APIYI (apiyi.com).
Q3: ¿Por qué recibo un 429 si no he superado ni el RPM ni el TPM?
La causa más común es haber alcanzado el límite de consumo de 10 minutos: 10 $ para el Tier 1, 50 $ para el Tier 2 y 200 $ para el Tier 3. Además, al principio, la capacidad de los proveedores puede ser insuficiente cuando se lanza un modelo nuevo, lo que puede hacer que se rechacen solicitudes aunque no se haya superado la cuota. Te recomendamos revisar también `error.details` en el cuerpo original del error para confirmar la causa.
Q4: ¿Cuál es una forma razonable de reintentar ante un 429?
Usa una espera exponencial, por ejemplo, 1, 2, 4 y 8 segundos, y añade una variación aleatoria. Limita los reintentos a 2 o 3 y da prioridad al encabezado `Retry-After` de la respuesta. Si sigues recibiendo errores 429 en el mismo proyecto, reduce el tráfico o cambia a un canal con cuota independiente en lugar de seguir reintentando.
Q5: ¿Cómo puedo empezar a usar gemini-4-argon rápidamente a través de APIYI?
1. Visita APIYI (apiyi.com), regístrate y obtén una clave API.
2. Configura `base_url` en el código como `https://api.apiyi.com/v1`.
3. Establece el nombre del modelo en `gemini-4-argon` y podrás ejecutar el código de ejemplo de este artículo.
APIYI admite un alto nivel de concurrencia para gemini-4-argon. Con un RPM inferior a 500, no tendrás que preocuparte por los límites de velocidad, por lo que es una buena opción para hacer pruebas rápidas y lanzar proyectos de escala pequeña o mediana.
Q6: ¿Puedo seguir encontrándome con errores 429 después de usar APIYI?
En condiciones normales de uso y con un RPM inferior a 500, prácticamente no tendrás que preocuparte por los límites de velocidad. Aun así, cualquier servicio upstream puede sufrir interrupciones breves, por lo que recomendamos conservar una estrategia básica de reintentos con espera exponencial. Si el tráfico de tu aplicación puede superar ese nivel, realiza primero pruebas de carga graduales y confirma la capacidad con la plataforma a través de APIYI (apiyi.com).
Q7: ¿Se puede usar la cuota de Batch API como referencia para la concurrencia en tiempo real?
No. La cuota de Argon Batch API que aparece en la documentación de Google corresponde a los tokens de la cola de procesamiento por lotes y se usa para tareas offline. Es un sistema distinto de los límites de concurrencia y RPM de la API en tiempo real, así que no se pueden aplicar unos como referencia de los otros.
Puntos clave sobre los errores 429 de gemini-4-argon
- No hay un límite fijo de concurrencia: Google no ha publicado un límite uniforme para gemini-4-argon. Consulta la cuota real en el panel.
- El RPM no equivale a la concurrencia: la concurrencia depende de la duración de las solicitudes. Los picos de tráfico pueden activar los límites con más facilidad que un flujo constante.
- Los límites se aplican por proyecto: tener más claves API no aumenta la capacidad; todas comparten la cuota del proyecto.
- Ten en cuenta el límite de consumo de 10 minutos: los límites de los Tier 1, 2 y 3 son de 10 $, 50 $ y 200 $, respectivamente. Puedes recibir un 429 aunque no hayas superado el RPM.
- Combina espera exponencial, control de velocidad y cambio de canal: añade variación aleatoria a los reintentos y, si los errores 429 persisten, cambia a un canal con cuota independiente.
- Más concurrencia, menos complicaciones: APIYI (apiyi.com) admite un alto nivel de concurrencia para gemini-4-argon. Con un RPM inferior a 500, no tendrás que preocuparte por los límites de velocidad.
Resumen
Los errores 429 frecuentes de gemini-4-argon en AI Studio no se deben principalmente a que «la concurrencia sea demasiado baja», sino a la combinación de varios límites: RPM, TPM, RPD, la tasa de consumo en 10 minutos y la capacidad disponible en el proveedor de los modelos nuevos. La solución también debe abordarse por etapas: primero, entender la respuesta original; después, limitar la velocidad de forma proactiva y aplicar reintentos con retroceso exponencial y variación aleatoria. Si los errores 429 persisten, cambia de canal. A largo plazo, amplía la capacidad subiendo de Tier o habilitando canales adicionales.
Para quienes prefieren dedicar menos tiempo a gestionar las cuotas, una opción más práctica es usar un canal agregador. Te recomendamos probar rápidamente el resultado a través de APIYI (apiyi.com). La plataforma permite realizar llamadas de alta concurrencia a gemini-4-argon y funciona sin problemas con menos de 500 RPM. Puedes probarla cuando quieras.
Referencias
- Página de uso y límites de velocidad de Google AI Studio: consulta las RPM, TPM, RPD y el nivel de Tier del proyecto.
- Enlace:
aistudio.google.com/usage -
Nota: selecciona un proyecto y gemini-4-argon para consultar las cuotas reales.
-
Documentación sobre los límites de velocidad de la API de Gemini: explica el mecanismo oficial de limitación de velocidad y cómo gestionar los errores 429.
- Enlace:
ai.google.dev/gemini-api/docs/rate-limits - Nota: incluye los límites de consumo de 10 minutos y recomendaciones sobre el retroceso exponencial.
Autor: APIYI Team
Intercambio técnico: Comparte en los comentarios tus experiencias al investigar errores 429 de gemini-4-argon. Encontrarás más información para la integración en el centro de documentación de APIYI: docs.apiyi.com.