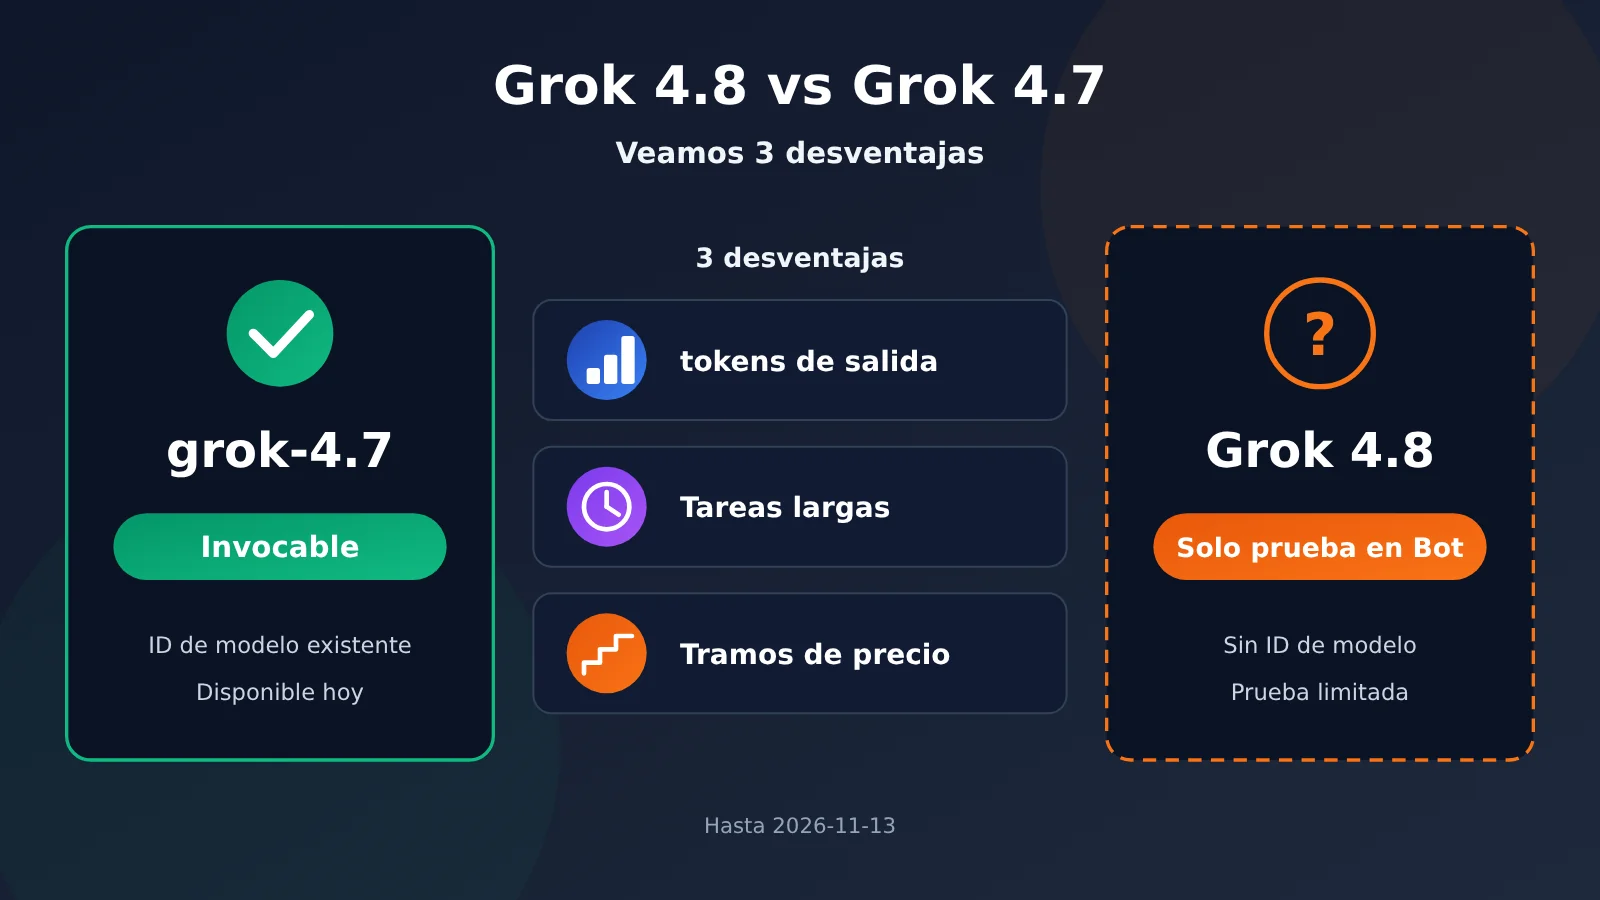
Nota del autor: hoy toca llamar a la API, así que seguimos con grok-4.7. A fecha de 2026-11-13, Grok 4.8 todavía no tiene ID de modelo; en este artículo revisamos, con fuentes, las 3 debilidades de Grok 4.7 y comprobamos si 4.8 ya tiene evidencia de haberlas cubierto.
Si ya estás llamando a grok-4.7 en producción, seguro que últimamente te ronda una duda: ¿conviene parar y esperar a Grok 4.8? Vamos primero con la conclusión: hoy toca llamar a la API, así que usa grok-4.7. A día 2026-11-13, Grok 4.8 no tiene ID de modelo, ni ficha de modelo, ni puntuaciones en rankings, ni precio. Eso de «esta semana» que dijo Musk es solo un despliegue suave (soft rollout) para un grupo reducido de usuarios de Grok Bot, no una apertura de la API.
Este no es un artículo de avance del tipo «la nueva versión será necesariamente más potente». Aquí solo contrastamos las tres debilidades que se pueden verificar con los datos públicos de Grok 4.7. Cada una lleva indicada su fuente: autodeclaración oficial, ranking de terceros o palabras textuales de Musk. Y después vemos si, por ahora, Grok 4.8 tiene evidencia de haberlas cubierto.
Valor principal: cuando termines de leer, sabrás exactamente dónde flaquea Grok 4.7, de quién son los datos y cómo controlar el coste por tramos de 200 000 tokens antes de que Grok 4.8 llegue al mercado.
Grok 4.8 vs Grok 4.7: cómo elegir hoy
Esta comparación no es como las habituales entre una versión nueva y otra. Por ahora, de Grok 4.8 solo tenemos unas declaraciones de Musk en X, sin ninguna puntuación que se pueda verificar. Así que la “comparación” en realidad significa esto: qué debilidades de Grok 4.7 están documentadas con datos públicos y si los cambios conocidos de Grok 4.8 encajan con esas debilidades.
| Tu situación | Recomendación | Motivo |
|---|---|---|
| Esta semana tienes que lanzar o modificar la API | Usa grok-4.7 | En la lista de modelos de la plataforma solo está grok-4.7 |
| Estás evaluando una elección a largo plazo | Usa primero grok-4.7 para establecer una línea base | 4.8 no tiene ranking, no hay forma de compararlos en igualdad de condiciones |
| Quieres probar 4.8 cuanto antes | Vigila la lista de modelos de la plataforma | Un lanzamiento suave del Bot no equivale a que la API esté disponible |
| Tienes requisitos muy altos para tareas largas | No pongas tus esperanzas en 4.8 | No hay evidencia de que la brecha en tareas largas se haya cerrado |
Cabe aclarar que “Bot users” se refiere a los usuarios de Grok Bot, no a robots de hardware. “soft rollout” es un despliegue gradual a pequeña escala, no una API abierta a desarrolladores. Tomarlo como “un ID de modelo que ya puedes usar en lugar del anterior” hará que la invocación falle directamente.
Diferencias clave entre Grok 4.8 y Grok 4.7: el origen de 3 puntos débiles
La siguiente tabla enumera primero el tipo de origen de cada uno de los tres puntos débiles. El desarrollo posterior sigue estrictamente este orden.
| Punto débil | Tipo de origen | Fecha de origen | ¿Grok 4.8 tiene evidencia para compensarlo? |
|---|---|---|---|
| Demasiados tokens de salida | Ranking de terceros (Artificial Analysis) | 2026-09-21 | No |
| Tareas prolongadas de varias horas por detrás de Fable | Autodeclaración oficial (tabla del blog de xAI) | 2026-09-21 | No |
| Subida de precios por niveles en contexto largo + Musk no reconoce la base | Lista de precios de la plataforma + palabras textuales de Musk | 2026-11-13 / 2026-11-10 | No |
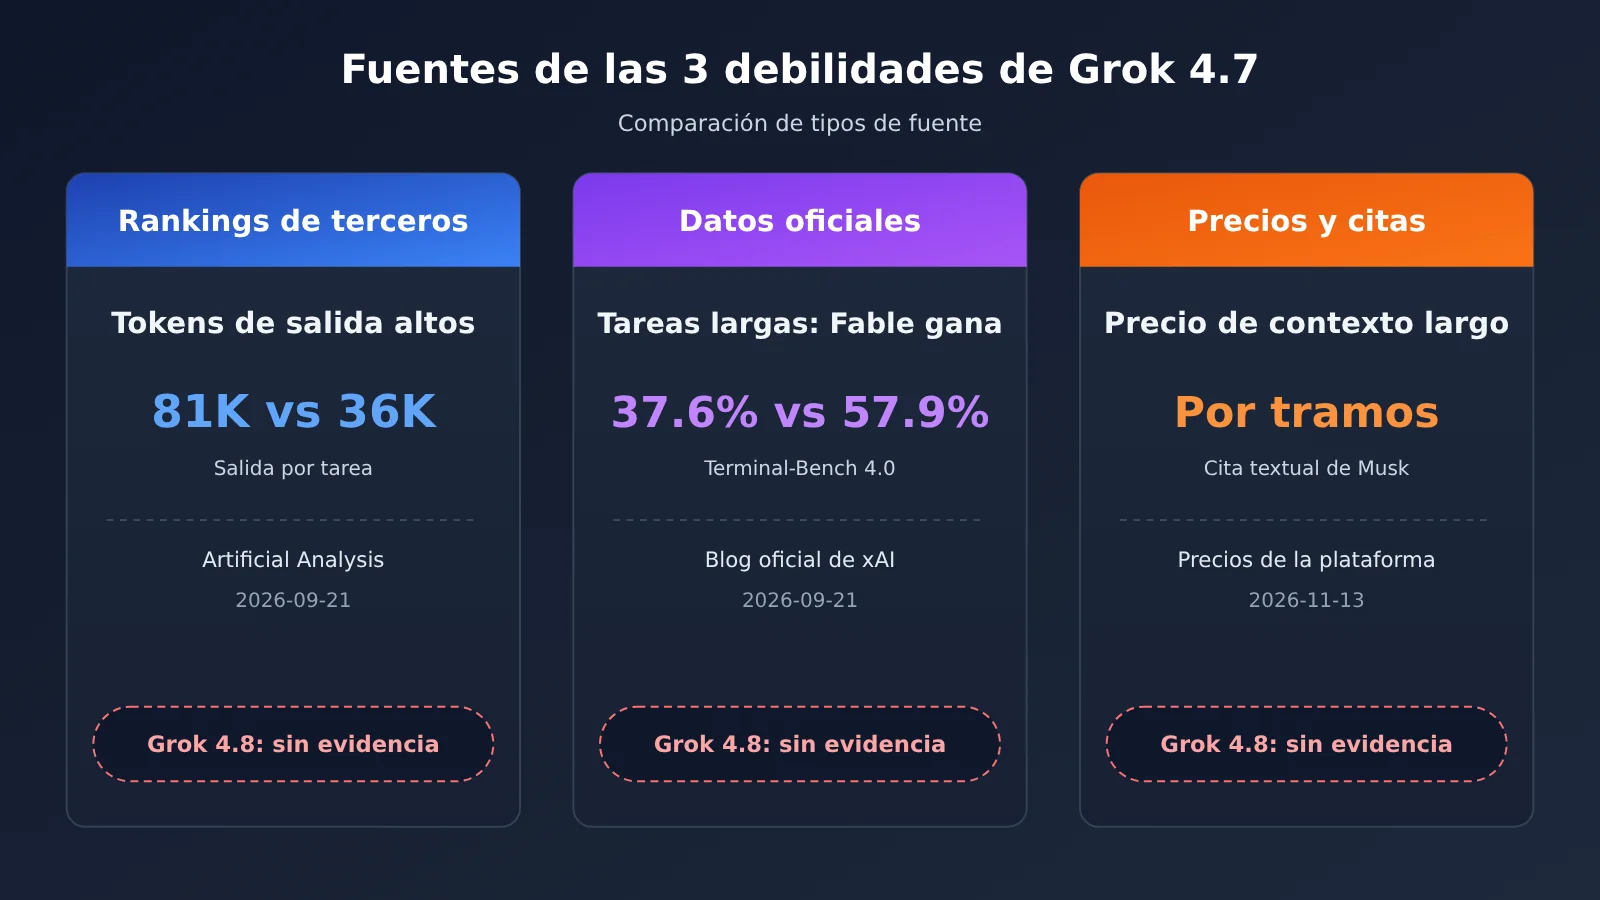
Punto débil 1: Grok 4.7 genera demasiados tokens de salida (ranking de terceros)
La fuente de este punto es la evaluación de Grok 4.7 publicada por Artificial Analysis el 2026-09-21; se trata de un ranking de terceros, no de datos oficiales ni de pruebas del autor de este artículo. Realizaron las pruebas con el nivel xhigh; el índice de inteligencia de Grok 4.7 es 46, 2 puntos más que Grok 4.6. La puntuación subió, pero a costa de un aumento evidente de los tokens de salida.
La comparación del volumen de salida del mismo análisis es la siguiente; ojo: los dos valores de Grok 4.6 corresponden a niveles distintos y no deben combinarse en uno:
- Grok 4.7 (xhigh): alrededor de
81,000tokens de salida por cada tarea del índice de inteligencia - Grok 4.6 (high): alrededor de
36,000tokens de salida - Grok 4.6 (xhigh): alrededor de
38,000tokens de salida; la evaluación señala que 4.7 es más del doble de esta cifra - GPT-6 Astra (max): alrededor de
27,000tokens de salida
Para hacerse una idea de la magnitud, se puede hacer un cálculo aproximado con el precio oficial de salida de $6 / 1M tokens: 81,000 tokens de salida cuestan alrededor de $0.49, y 36,000, alrededor de $0.22. Esto es solo un método de conversión para las tareas del ranking, para ilustrar «en una misma pregunta, en qué se va el dinero»; no es la factura real de ninguna plataforma.
Artificial Analysis también indica que el contexto de Grok 4.7 es 500K, con un precio de $2 / $6 y $0.50 por acierto de caché, iguales a los de 4.6. Es decir, el precio unitario no subió, pero cada tarea genera más tokens, por lo que el coste real por tarea aumenta.
Punto débil dos: Grok 4.7 todavía va por detrás de Fable en tareas largas de varias horas (según reporte oficial)
La fuente aquí es la tabla comparativa del blog oficial de xAI (2026-09-21), es decir, datos autoreportados por el propio fabricante. Los cuatro encabezados de columna son, en orden: Grok 4.7 xHigh, Grok 4.6 High, GPT-5.6 Sol Max y Fable 5.1 Max. Las dos filas que mejor ilustran la brecha en tareas largas son estas:
- Terminal-Bench 4.0: Grok 4.7
37.6%, Fable 5.1 Max57.9%(Grok 4.6 era20.3%y GPT-5.6 Sol37.3%) - CursorBench 4.0: Grok 4.7
46.3%, Fable 5.1 Max51.8%(Grok 4.6 era40.4%y GPT-5.6 Sol41.7%)
Pero la tabla oficial no muestra un «rezago general». La mejora de Grok 4.7 frente a 4.6 es real, y además lidera en dos benchmarks especializados:
- EEBench: Grok 4.7
64.0%, por encima del53.0%de 4.6, del39.4%de GPT-5.6 Sol y del56.4%de Fable 5.1 - Harvey Legal Agent Benchmark: Grok 4.7
19.6%, por encima de15.8%/2.5%/6.7% - DeepSWE v1.1: Grok 4.7
71.0%, con la nota oficial de que se midió en high effort y no en xhigh, ligeramente por debajo del72.7%de GPT-5.6 Sol - AA Briefcase v1.1: Grok 4.7
1657, ligeramente por debajo del1678de Fable - HealthBench Professional: Grok 4.7
56.7%, por debajo del60.5%de GPT-5.6 Sol y del62.1%de Fable
| Benchmark de la tabla oficial | Frente a Grok 4.6 | Frente a GPT-5.6 Sol | Frente a Fable 5.1 |
|---|---|---|---|
| Terminal-Bench 4.0 | Claramente superior | Prácticamente igual, algo por encima | Brecha notable |
| CursorBench 4.0 | Superior | Superior | Inferior |
| DeepSWE v1.1 | Superior | Algo inferior | Algo superior |
| EEBench | Superior | Superior | Superior |
| Harvey Legal Agent | Superior | Superior | Superior |
| HealthBench Professional | Superior | Inferior | Inferior |
Hay otro conjunto de datos de rankings de terceros que conviene señalar por separado. Las evaluaciones de Artificial Analysis muestran que, frente a Grok 4.6, Grok 4.7 sube 4.5 puntos en Terminal-Bench 4.0 y 3.0 puntos en GDP.pdf; pero baja 3.7 puntos en AA-LCR y 1.1 puntos en AutomationBench-AA. Ese «+4.5 puntos» no pertenece al mismo sistema de puntuación absoluta que el 37.6% frente al 20.3% de la tabla oficial, así que no se pueden mezclar.
Debilidad tres: la escala de precios de Grok 4.7 y las palabras textuales de Musk (tarifas + declaraciones)
Este tercer punto tiene dos partes: una es el precio del contexto largo, y la otra es la actitud del propio Musk hacia el 4.7. Primero veamos el precio. La tabla general de la plataforma y la interfaz de tarifas no coinciden del todo en lo que registran para más de 200.000 tokens:
| Concepto de precio | Tabla general de modelos de la plataforma | Interfaz de tarifas billing_expr |
|---|---|---|
| Entrada / salida / lectura de caché ≤ 200.000 tokens | Ya especificado | Ya especificado, coincide con la tabla general |
| Entrada de más de 200.000 | Ya especificado | Ya especificado, coincide con la tabla general |
| Salida de más de 200.000 | No especificado por separado | Ya especificado |
| Lectura de caché de más de 200.000 | No especificado por separado | Ya especificado |
Las cifras concretas son las siguientes; la fecha de los datos de precio es 2026-11-13 y las unidades son por cada 1M tokens:
- Nivel bajo (0–200.000 tokens): entrada
$2, salida$6, lectura de caché$0.5; la tabla general y la expresión de tarifas coinciden - Entrada de nivel alto (200.001–500.000 tokens):
$4; la tabla general y la expresión de tarifas coinciden - Salida de nivel alto: la expresión de tarifas es
$12; el escalón de la tabla general no lo incluye - Lectura de caché de nivel alto: la expresión de tarifas es
$1; el escalón de la tabla general no lo incluye
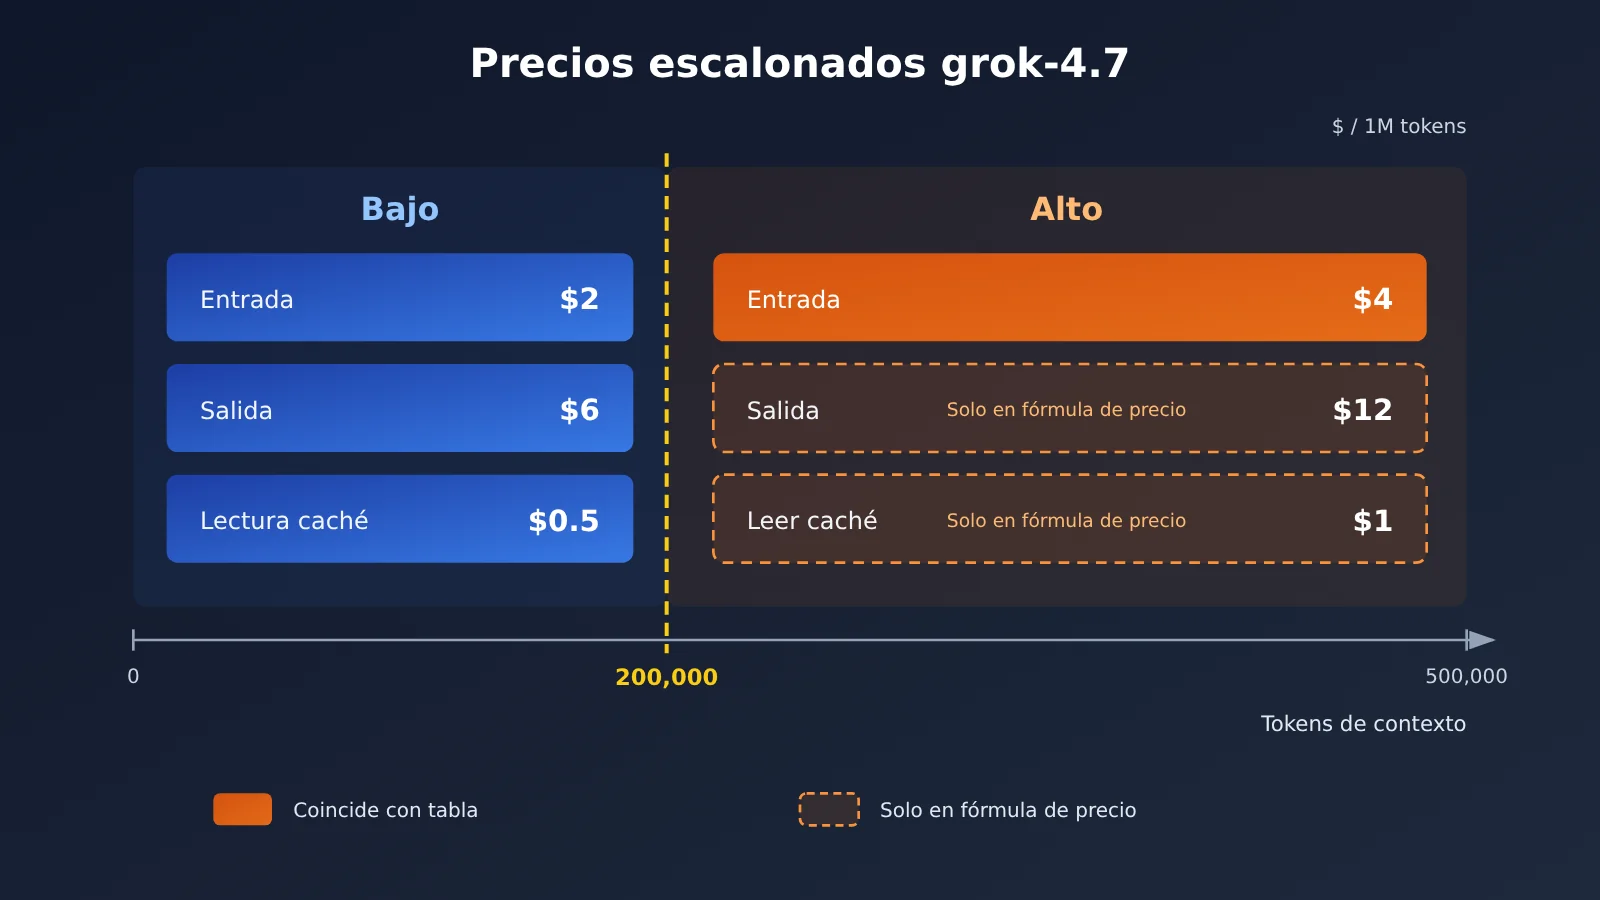
La información de precios de la figura anterior proviene de la interfaz de tarifas y la tabla general de modelos de APIYI apiyi.com; fecha de verificación 2026-11-13, y prevalece la lista de modelos de la plataforma.
Ahora veamos las declaraciones textuales. El 2026-11-10 a las 17:35, Musk dijo en X que Grok 4.8 «will bear no resemblance to 4.7 (thankfully). It is not yet incredible». Ese mismo día a las 18:22, en una respuesta, añadió «Not as good. Opus 5.5 is a masterpiece.», es decir, que el 4.8 todavía no está a la altura de Opus 5.5. Al mismo tiempo, prevé que Grok 5 podría superar a Opus 5.5 en dos o tres meses.
Estas son actitudes, no las puntuaciones de Grok 4.8. Que un fundador diga que la nueva versión «no se parece al 4.7, y menos mal» solo demuestra que no aprueba la base del 4.7; no permite concluir que el 4.8 ya haya mejorado en las tres debilidades anteriores.
¿Puede Grok 4.8 cubrir estas 3 deficiencias?
De lo único que se puede hablar es de lo que aparece en la publicación original de Musk. Menciona que abandonaron JAX/SGLang y reescribieron desde cero, en C/C++, el stack de aprendizaje por refuerzo (RL) y el de inferencia; que el preentrenamiento ya está terminado; que los datos de SFT se han limpiado a fondo; y que 4.8 está ahora en fase de RL, con «evals are starting to climb». La publicación no da ningún nombre de benchmark ni puntuación, ni tampoco el número de parámetros.
Si cruzamos esa información con las tres deficiencias, la conclusión es bien prudente:
- Demasiados tokens de salida: la fase de RL ciertamente puede influir en la longitud de la salida, pero no menciona la eficiencia de tokens.
- Tareas largas por detrás de Fable: no menciona Terminal-Bench ni CursorBench, ni aporta dato alguno sobre tareas largas.
- Precio por encima de 200 000 tokens: no hay ninguna información de precios, y 4.8 tampoco aparece en ninguna lista de precios.
Así que las conjeturas se quedan en el nivel de «reescribieron el stack de RL y el de inferencia, y limpiaron los datos de SFT». No hay pruebas de que esos tres puntos ya estén cubiertos. Habrá que esperar a que 4.8 tenga model card y benchmarks de terceros para comparar punto por punto; solo entonces tendrá sentido.
Ahora toca ajustar grok-4.7: ¿cómo se reparten los tramos a partir de 200 000 tokens?
Antes de que 4.8 salga al catálogo, lo más práctico es controlar bien el coste de grok-4.7. El punto clave está justo en la línea de los 200 000 tokens: en cuanto la entrada la cruza, el precio unitario se duplica directamente y, según la expresión de la lista de precios, la salida y la lectura de caché también se duplican. Abajo van los datos de acceso aplicables y las recomendaciones por tramo:
- ID del modelo:
grok-4.7, endpoint chat, con los gruposCodexResponses,DefaultySVIP - Dirección de la interfaz: formato compatible con OpenAI, pon
https://api.apiyi.com/v1como base_url y asignagrok-4.7a model, y listo - Control en el tramo bajo: mantén el contexto de cada petición dentro de
200,000tokens siempre que puedas; usa resúmenes o fragmentos recuperados en lugar de meter documentos enteros - Presupuesto en el tramo alto: cuando de verdad necesites contexto largo, calcula con
$4de entrada,$12de salida y$1de lectura de caché, y ojo con la inconsistencia de que la tabla general no indica la salida del tramo alto - Longitud de salida: en línea con la primera deficiencia, define max_tokens en las tareas que lo necesiten para que la salida no se descontrole en niveles de razonamiento alto
Los modelos y precios se rigen por la lista de modelos de la plataforma; puedes consultar la información más reciente en docs.apiyi.com/models. El blog oficial también menciona que Grok 4.7 tiene una variante fast, con una velocidad de salida de aproximadamente el doble y un precio también del doble, pero la tabla general de la plataforma no tiene un ID de modelo fast independiente, así que no te lo inventes al hacer la llamada.
🚀 Inicio rápido: en cuanto grok-4.8 salga al catálogo, APIYI apiyi.com publicará este modelo lo antes posible. Mientras tanto, deja funcionando la línea base de grok-4.7 con la misma clave API; cuando 4.8 esté disponible, bastará cambiar un único parámetro model para comparar.
Escenarios recomendados: Grok 4.8 frente a Grok 4.7
Casos en los que conviene seguir usando Grok 4.7
- Tareas especializadas de derecho e ingeniería: En la tabla oficial, Grok 4.7 ocupa el primer lugar en EEBench y Harvey Legal Agent; en este tipo de tareas no hay motivo para esperar.
- Negocios con contexto controlable por debajo de 200 000: Pueden mantenerse de forma estable en el tramo de precios bajo, con un precio unitario igual al de 4.6.
- Proyectos que deben salir a producción de inmediato: grok-4.7 es actualmente la única versión que se puede invocar.
Casos en los que vale la pena seguir observando Grok 4.8
- Agentes de varias horas / tareas largas en terminal: La diferencia entre Terminal-Bench 4.0 y Fable 5.1 es evidente; conviene evaluar también otros modelos como alternativas.
- Tareas por lotes sensibles al costo de tokens de salida: Las clasificaciones de terceros muestran que la salida de 4.7 tiende a ser más larga; si 4.8 mejora, reducirá costos directamente, pero por ahora no hay evidencia.
- Aplicaciones que dependen mucho de contextos de más de 200 000: El precio del tramo alto se duplica; vale la pena prestar atención a la forma de facturación una vez que 4.8 esté disponible en la plataforma.
Recomendaciones para decidir entre Grok 4.8 y Grok 4.7
| Aspecto clave | Acción actual | Cuándo reevaluar |
|---|---|---|
| Estabilidad en producción | Usar grok-4.7 | Cuando 4.8 aparezca en la lista de modelos de la plataforma |
| Costo por tarea | Controlar el contexto y la longitud de salida | Cuando haya datos de terceros sobre el uso de tokens de 4.8 |
| Capacidad para tareas largas | Evaluar modelos alternativos en paralelo | Cuando 4.8 publique puntuaciones como Terminal-Bench |
| Transparencia de precios | Presupuestar según la API de precios | Cuando la tabla general de la plataforma incluya el precio de salida del tramo alto |
💡 Recomendación: La versión que elijas depende de si tus tareas son de larga duración y de si superan con frecuencia los 200 000 tokens. Te sugerimos probar tus propias muestras con el mismo conjunto de interfaces a través de APIYI apiyi.com, y luego decidir si conviene mover las tareas largas a otro modelo.
Preguntas frecuentes (FAQ)
Q1: ¿Se puede invocar Grok 4.8 por API ahora mismo?
No. A fecha de 2026-11-13, Grok 4.8 no tiene ningún ID de modelo: tanto la tabla maestra de modelos de la plataforma como la interfaz de precios solo listan grok-4.7. El lanzamiento suave que Musk anunció para esta semana está dirigido únicamente a los usuarios de Grok Bot.
Q2: ¿Quién es realmente más fuerte, Grok 4.8 o Grok 4.7?
Por ahora no se puede determinar. Grok 4.8 no tiene ningún ranking ni puntuación públicos; Musk solo dijo que «las evaluaciones van subiendo», que «aún no sorprende» y que «no está a la altura de Opus 5.5». Eso son posturas, no datos comparables.
Q3: ¿De dónde viene la afirmación de que Grok 4.7 genera más tokens de salida?
Proviene de la evaluación de terceros de Artificial Analysis del 2026-09-21, con el nivel de prueba xhigh. Alrededor de 81 mil tokens de salida por tarea, frente a los 36 mil de 4.6 high y los 38 mil de 4.6 xhigh. No se trata de datos oficiales.
Q4: ¿Grok 4.7 empeoró en todos los aspectos respecto a Grok 4.6?
No. En la tabla oficial, Grok 4.7 supera a 4.6 en varios benchmarks como Terminal-Bench, CursorBench y EEBench. Los rankings de terceros muestran 3,7 puntos menos en AA-LCR y 1,1 puntos menos en AutomationBench-AA; son retrocesos puntuales.
Q5: ¿Cómo invoco grok-4.7 ahora mismo?
Regístrate en APIYI apiyi.com y obtén una clave API; los usuarios nuevos reciben crédito de prueba gratuito. Usa el SDK compatible con OpenAI, pon la dirección del endpoint de la plataforma en base_url y configura grok-4.7 como model.
Q6: ¿Cómo se cobran exactamente las salidas de más de 200 mil tokens?
La expresión de precios indica $12 de salida y $1 de lectura de caché; la tabla resumen por tramos solo menciona $4 para la entrada de gama alta, sin detallar por separado la salida de gama alta. Ambos registros no coinciden del todo, así que al presupuestar conviene hacer una estimación conservadora según la expresión de precios y tomar como referencia la lista de modelos de la plataforma.
Q7: ¿Cómo migro cuando Grok 4.8 esté disponible?
En las novedades en tiempo real de la plataforma todavía no hay ningún registro de Grok 4.8. Cuando esté disponible, normalmente bastará cambiar el parámetro model; se recomienda comparar primero, con el mismo lote de muestras, los tokens de salida, la tasa de éxito en tareas largas y el costo por tramo, y solo después redirigir el tráfico.
Grok 4.8 frente a Grok 4.7: puntos clave
- La elección de hoy: si quieres llamar a la API, usa grok-4.7; Grok 4.8 todavía no tiene ID de modelo.
- Punto débil 1 (rankings de terceros): con xhigh, cada tarea genera unos 81 000 tokens de salida, demasiado largo.
- Punto débil 2 (según la propia empresa): en Terminal-Bench y CursorBench sigue por detrás de Fable 5.1.
- No va por detrás en todo: Grok 4.7 ocupa el primer puesto en EEBench y Harvey.
- Punto débil 3 (tarifas + declaraciones textuales): la entrada por encima de 200 000 tokens cuesta el doble, y Musk no reconoce la base de 4.7.
- Cambios conocidos en 4.8: reescritura del RL y del stack de inferencia, limpieza del SFT; no hay pruebas de que cubra los tres puntos débiles.
- Cómo empezar: corre primero la línea base de grok-4.7 a través de APIYI apiyi.com; cuando 4.8 esté disponible, compara directamente.
Resumen
Puntos clave de la comparación entre Grok 4.8 y Grok 4.7:
- Disponibilidad: a fecha de 2026-11-13, solo se puede invocar grok-4.7; el lanzamiento suave del bot no equivale a una API abierta.
- Tres puntos débiles: demasiados tokens de salida (rankings de terceros), retraso frente a Fable en tareas largas (según la propia empresa) y subida de precios en contextos largos junto con las declaraciones del fundador (tarifas y declaraciones textuales); las fuentes son distintas en cada caso.
- Evidencia sobre 4.8: por ahora solo existen afirmaciones sobre la reescritura del RL y del stack de inferencia y la limpieza del SFT; no hay puntuaciones, precios ni model card.
En lugar de quedarte esperando, conviene controlar desde ya los tramos de contexto y la longitud de salida de grok-4.7, y cuando 4.8 tenga datos verificables, comparar punto por punto. Recomiendo usar APIYI apiyi.com para validar primero, con una interfaz unificada, el rendimiento de grok-4.7 en tu negocio y dejar preparada una línea base para el cambio futuro.
📚 Referencias
- Blog oficial de xAI – Lanzamiento de Grok 4.7: tabla comparativa de benchmarks y precios autodeclarados por la propia compañía
- Enlace:
x.ai/news/grok-4-7 -
Descripción: fuente de datos como Terminal-Bench 4.0, CursorBench 4.0, EEBench, etc.
-
Artificial Analysis – Evaluación de Grok 4.7: clasificación de terceros, incluye el consumo de tokens de salida
- Enlace:
artificialanalysis.ai/articles/benchmarking-grok-4-7 -
Descripción: índice de inteligencia, comparación de tokens de salida, cambios en AA-LCR y otras métricas
-
Publicación de Musk en X (2026-11-10): declaraciones textuales sobre el progreso de Grok 4.8
- Enlace:
x.com/elonmusk/status/2120088070443655190 -
Descripción: reescritura del stack de RL y razonamiento, limpieza de SFT, lanzamiento suave del Bot
-
Respuesta de Musk en X (2026-11-10): opinión sobre la comparación entre 4.8 y Opus 5.5
- Enlace:
x.com/elonmusk/status/2120099798078656909 -
Descripción: origen de la frase «Not as good»
-
Tabla general de modelos de APIYI: modelos grok-4.7, agrupaciones y precios escalonados
- Enlace:
docs.apiyi.com/models - Descripción: los modelos y precios se basan en esta tabla; fecha de verificación 2026-11-13
Autor: Equipo técnico de APIYI
Contacto técnico: no dudes en contactarnos desde la página principal del sitio de APIYI; para más materiales, visita el centro de documentación docs.apiyi.com