Nota del autor: este artículo usa dos sistemas de evaluación, el índice integral AA y la evaluación de tareas profesionales MKA, para comparar el rendimiento, el tiempo de ejecución y el costo de Gemini 4 Carbon, Claude Fable 5.2 y GPT-6 Astra. También explica la configuración de las pruebas y el alcance de las conclusiones estadísticas.
Antes de leer: 7 términos clave de la comparativa de los tres modelos
- MKA (Multimodal Knowledge Agent): benchmark que evalúa tareas de trabajo profesional multimodales. Mide si el modelo es capaz de leer documentos complejos como planos, escaneos o imágenes médicas, y de entregar un resultado profesional completo.
- Climb WSR: tasa de cumplimiento ponderada que se calcula solo sobre los criterios de puntuación con mayor poder discriminatorio. Sirve para marcar diferencias entre los modelos de primer nivel.
- Regression WSR: indicador ponderado que mide si se cumplen los requisitos básicos. Equivale al aprobado mínimo de una entrega profesional.
- Nivel de razonamiento: ajuste de la intensidad de razonamiento que puede usar el modelo. Por ejemplo, LOW, MEDIUM y HIGH en Carbon, o configuraciones como Max y Xhigh en Fable y Astra dentro del ranking.
- Costo por tarea: suma de todo lo que cuestan las invocaciones del modelo para completar una tarea concreta. No es el precio fijo de una sola petición a la API.
- Lectura de caché: forma de reutilizar contenido de entrada que ya está en caché, con una tarifa unitaria más baja.
- Significancia estadística: indicador que determina si la diferencia de puntuación entre dos modelos tiene suficiente respaldo estadístico. Si la diferencia no llega a ser significativa, no se puede tomar como una victoria o derrota definitiva.
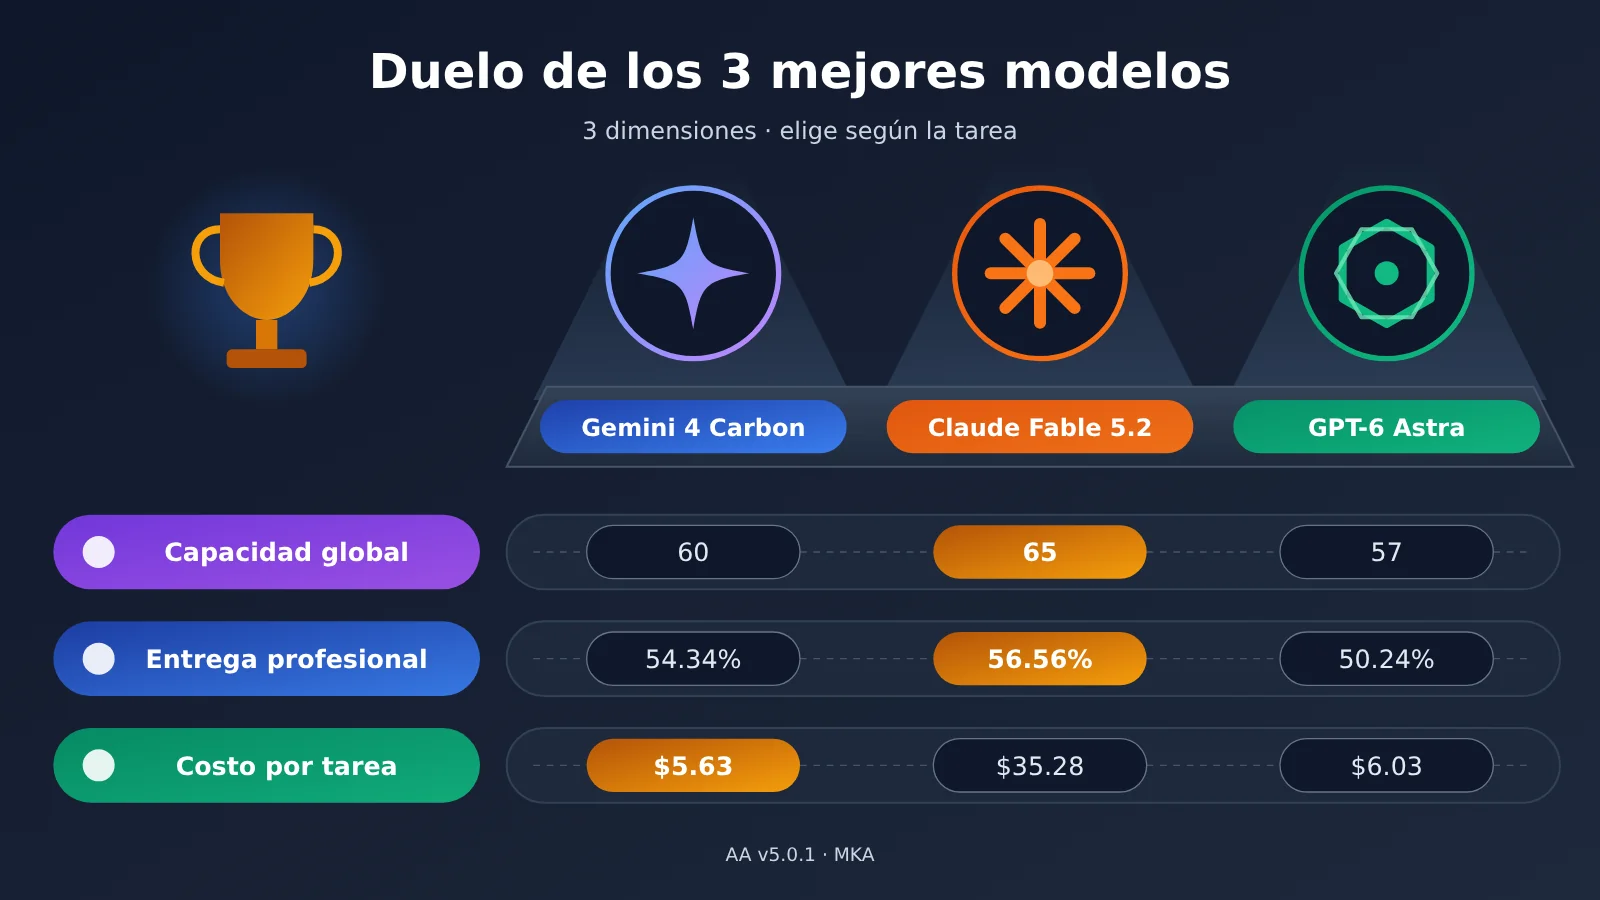
La competencia entre los modelos de primer nivel ya no se puede explicar con un solo ranking general. Este artículo compara Gemini 4 Carbon, Claude Fable 5.2 y GPT-6 Astra en tres dimensiones: capacidad general, entrega profesional y costo por tarea. Al final propone qué modelo elegir según el tipo de tarea.
Esto no es una lectura que mezcla todas las puntuaciones en un único ranking. El índice integral y MKA son dos sistemas de evaluación distintos, así que aquí los analizamos por separado. También aclaramos qué diferencias tienen respaldo estadístico y cuáles no tienen pruebas suficientes.
Valor central: al terminar el artículo podrás decidir qué modelo conviene priorizar según lo que exija tu tarea en calidad, velocidad y costo.
一、Gemini 4 Carbon, Claude Fable 5.2 y GPT-6 Astra entran en el mismo ring
Los tiempos de esta ronda de competencia están muy concentrados. Google presentó por primera vez Gemini 4 Carbon el 28 de octubre de 2026, Anthropic lanzó Claude Fable 5.2 el 9 de noviembre, y Carbon se abrió oficialmente a desarrolladores, empresas y consumidores el 10 de noviembre. Ese mismo día, Google DeepMind y Artificial Analysis lanzaron la evaluación MKA. El 11 de noviembre se actualizó el Artificial Analysis Intelligence Index v5.0.1, que ya incluye Fable 5.2.
El posicionamiento público de los tres modelos es bastante distinto. Carbon está construido sobre Gemini 4 Argon y apunta a agentes de largo recorrido, ingeniería de software compleja e investigación científica, con soporte de entrada de texto, imagen, audio y video. Fable 5.2 usa Adaptive Thinking, tiene una ventana de contexto de 1M tokens y una salida máxima de 128K tokens. GPT-6 Astra aparece en las dos evaluaciones que citamos en este artículo y suele usarse como referencia de eficiencia.
| Dimensión | Claude Fable 5.2 | Gemini 4 Carbon | GPT-6 Astra | Valoración actual |
|---|---|---|---|---|
| Capacidad general (AA v5.0.1) | 65 (Max) | 60 (High) | 57 (Max) | Fable lidera |
| Entrega profesional (MKA Climb-WSR) | 56.56% | 54.34% | 50.24% | Fable y Carbon están cerca, ambos por delante de Astra |
| Costo por tarea (MKA, tabla 4) | $35.28 | $5.63 | $6.03 | Carbon es el más bajo |
| Tiempo de ejecución (MKA, tabla 4) | 83.2 minutos | 29.2 minutos | 18.5 minutos | Astra es el más rápido |
| Consumo de tokens (MKA, tabla 4) | 40.48M | 7.05M | 2.43M | Astra es el más económico |
La columna «Valoración actual» solo se refiere a cada métrica por separado. Ningún modelo queda primero en todas las dimensiones.
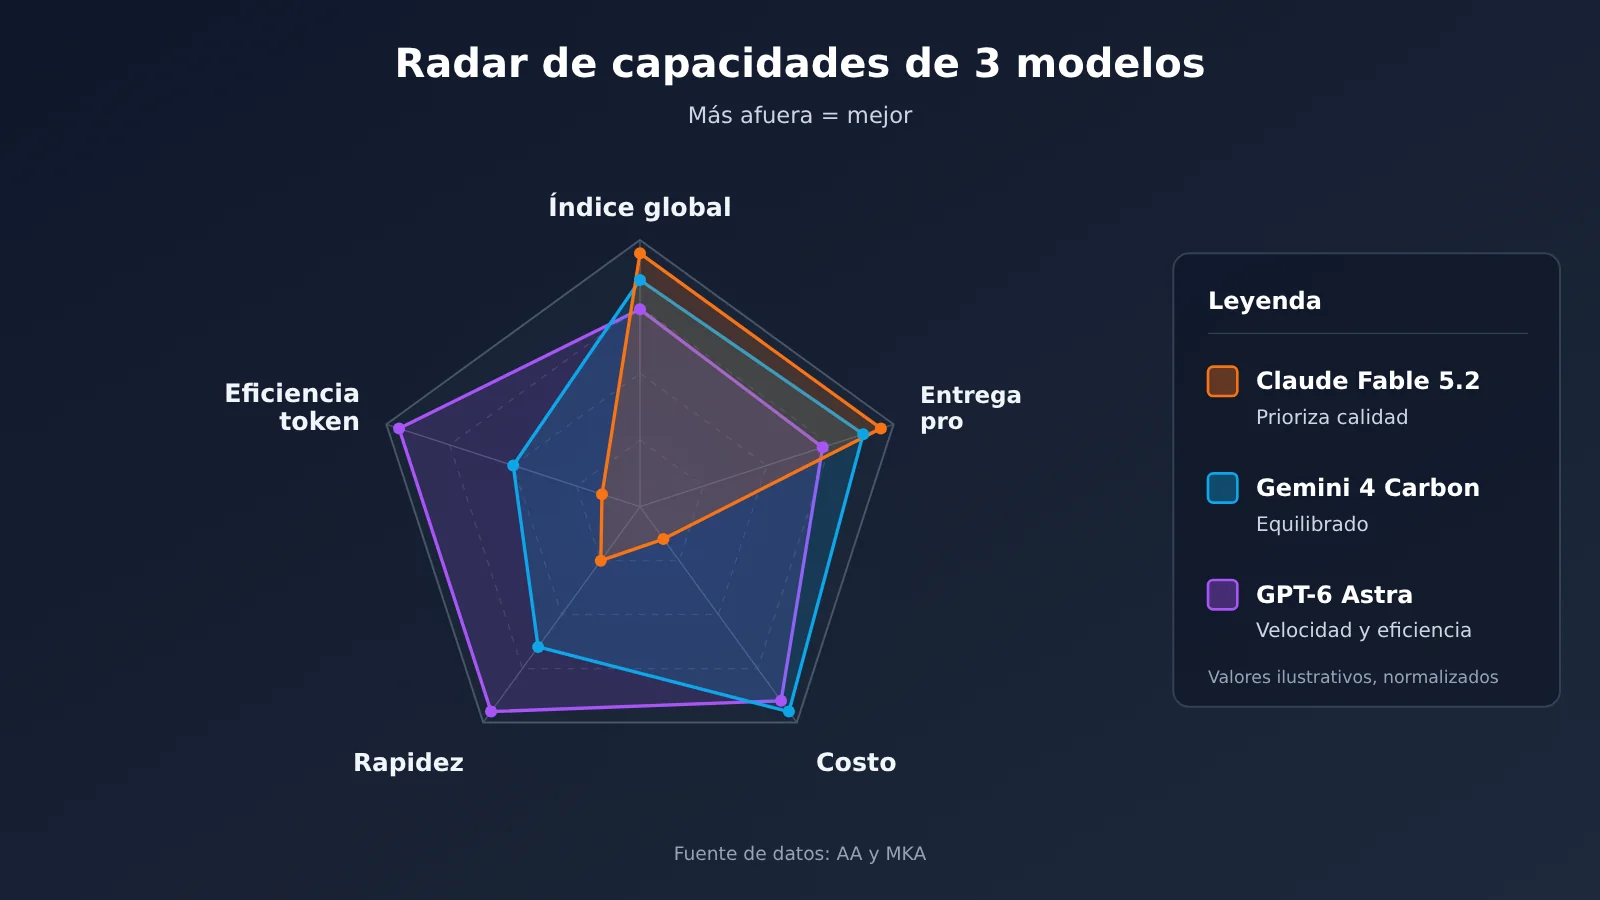
📊 Nota sobre los datos: los datos de la tabla provienen, por un lado, de una captura del ranking de AA y, por otro, del artículo técnico de MKA. Las dos metodologías no son equivalentes y no se pueden convertir entre sí. Si quieres validar tu propio caso de uso, puedes hacer una comparación a pequeña escala con APIYI (apiyi.com), usando las mismas indicaciones en los tres modelos para ver cómo se comportan con cargas reales.
II. Ranking general de AA: Claude Fable 5.2 lidera por ahora y Gemini 4 Carbon le sigue de cerca
El Artificial Analysis Intelligence Index v5.0.1 se compone de 9 evaluaciones: AA-Briefcase v1.1, AutomationBench-AA, Terminal-Bench 4.0, FrontierCode 2.0, AA-Omniscience v1.1, GDP.pdf, HLE-Diamond, CritPt v2 y Terminal-Bench-Science 0.1. Cubren trabajo del conocimiento, automatización, código, razonamiento científico y fiabilidad factual. La pregunta que responde este índice es: «¿qué tan potente es el modelo en conjunto?».
| Configuración del modelo | AA Index v5.0.1 | Costo por tarea de evaluación | Tiempo por tarea |
|---|---|---|---|
| Claude Fable 5.2 Max | 65 | $26.54 | 44.4 minutos |
| Gemini 4 Carbon High | 60 | $7.76 | 24.9 minutos |
| GPT-6 Astra Max | 57 | $6.24 | 23.0 minutos |
Conviene fijarse en las diferencias de configuración de esta tabla. Los tres modelos usan los niveles Max, High y Max respectivamente, así que el presupuesto de razonamiento no es el mismo y los resultados no deben leerse como una comparación pura de capacidad en igualdad de condiciones. Además, un mismo modelo cambia de puntuación según el nivel: Fable 5.2 obtiene 62 puntos tanto en Xhigh como en High, mientras que Carbon logra 58 en Medium y 54 en Low.
Los datos de niveles dentro de Carbon merecen una mirada aparte. Según los cálculos de AA, el costo por tarea en Medium es de $6.59, que resulta incluso menor que los $7.19 de Low. High tiene la puntuación más alta, pero la latencia hasta el primer token de la respuesta llega a 67.54 segundos. Esto indica que subir el nivel de razonamiento no siempre da un beneficio proporcional. Los $7.76 de la tabla son el costo medio por tarea de AA calculado con el precio estándar de Carbon ($4/$20), no el precio de una solicitud normal.
III. Entrega profesional en MKA: qué tan bien completan su trabajo los tres modelos
El índice AA mide la capacidad general, mientras que MKA mide si un modelo es capaz de completar trabajo profesional real. Según el artículo técnico de MKA, el planteamiento es el siguiente:
- En total hay 200 tareas privadas y reales, que cubren 10 sectores y 83 profesiones. Cada tarea equivale a unas 3-8 horas de trabajo de un profesional.
- Cada tarea tiene alrededor de 70 criterios de evaluación ponderados. El 88 % de las tareas exige generar archivos independientes, como Word, Excel, PPT, PDF, HTML o imágenes.
- Todos los modelos se ejecutan dentro del mismo Stirrup Agent Harness, con el mismo entorno de herramientas y un presupuesto uniforme de 250 turnos. Cada tarea se ejecuta una sola vez.
| Modelo | Climb-WSR | Overall WSR | Regression-WSR |
|---|---|---|---|
| Claude Fable 5.2 | 56.56% | 73.26% | 95.71% |
| Gemini 4 Carbon | 54.34% | 71.89% | 96.36% |
| GPT-6 Astra | 50.24% | 69.34% | 95.17% |
Cada una de las tres métricas tiene su significado. Regression-WSR refleja el cumplimiento de los requisitos básicos: los tres modelos superan el 95 %, con Carbon ligeramente por delante. Climb-WSR solo cuenta los criterios de alta dificultad y es la referencia principal para distinguir a los modelos de primer nivel. Overall WSR es la tasa de cumplimiento ponderada de todos los criterios en conjunto. Ninguna de estas cifras es el porcentaje de aciertos de un cuestionario normal, así que tampoco se pueden comparar con los 65, 60 y 57 del índice AA.
Significancia estadística entre Claude Fable 5.2 y Gemini 4 Carbon
La significancia estadística es lo que más hay que tener en cuenta al interpretar MKA. Estos son los datos que da el artículo:
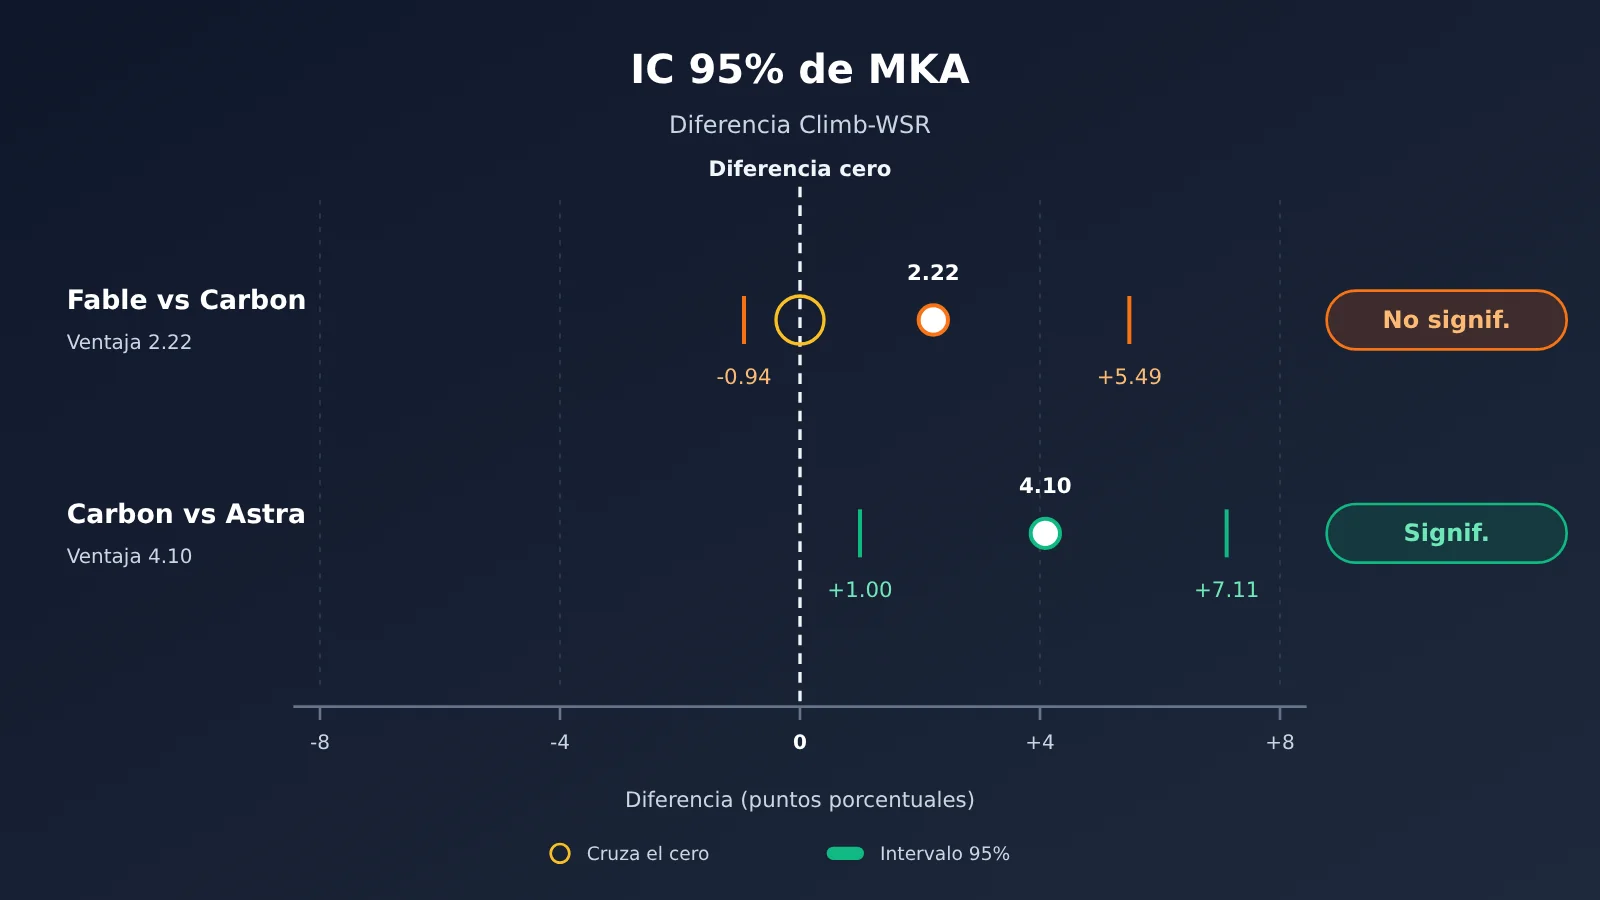
- Fable frente a Carbon: ventaja de 2.22 puntos porcentuales, con un intervalo de confianza del 95 % de -0.94 a +5.49. El intervalo cruza el 0, por lo que la diferencia no alcanza significancia estadística.
- Carbon frente a Astra: ventaja de 4.10 puntos porcentuales, con un intervalo de confianza del 95 % de +1.00 a +7.11. El intervalo queda por completo por encima de 0, así que la diferencia sí es estadísticamente significativa.
Por tanto, lo correcto es decir que en MKA Fable 5.2 y Carbon están a un nivel parecido, y la evidencia actual no basta para afirmar que Fable supere claramente a Carbon. La conclusión del artículo es que ambos modelos van significativamente por delante de Astra.
IV. Comparación de costes por tarea: lo que cuesta realmente que los tres modelos completen la misma tarea
La tabla 4 del artículo de MKA recoge el consumo medio de recursos por tarea. El coste de API se estima con los precios de lista de cada proveedor, combinados con la facturación por caché de indicaciones.
| Métrica media por tarea | Claude Fable 5.2 | Gemini 4 Carbon | GPT-6 Astra |
|---|---|---|---|
| Tokens totales | 40.48M | 7.05M | 2.43M |
| Tokens de salida | 378.9K | 129.5K | 42.0K |
| Turnos del agente | 128.8 | 46.6 | 29.0 |
| Tiempo de ejecución | 83.2 minutos | 29.2 minutos | 18.5 minutos |
| Coste por tarea | $35.28 | $5.63 | $6.03 |
De esta tabla se sacan tres conclusiones:
- Fable es el que más recursos invierte: sus tokens totales son 5.74 veces los de Carbon, y su tiempo de ejecución es aproximadamente 2.85 veces el de Carbon. Sus resultados de alta calidad se apoyan en muchas rondas de exploración y un gran número de llamadas.
- Carbon ofrece la mejor relación calidad-precio: su coste por tarea es aproximadamente una sexta parte del de Fable, y en Climb-WSR queda solo 2.22 puntos porcentuales por debajo, una diferencia que además no es significativa.
- Astra es el más rápido y el que menos tokens consume: tiene el menor tiempo de ejecución y el menor consumo de tokens, pero su coste por tarea sigue siendo algo mayor que el de Carbon, y en Climb-WSR queda claramente por detrás de Carbon.
Precio por token, consumo de tokens y factura por tarea: no son lo mismo
Estos tres conceptos se confunden a menudo. En cuanto al precio por token, Fable 5.2 cuesta $8 por millón de tokens de entrada y $40 por millón de salida. Carbon tuvo un precio de lanzamiento de $2/$10 hasta el 30 de noviembre, y desde el 1 de diciembre pasa a $4/$20. Pero un precio unitario bajo no implica una factura baja. Astra consume solo cerca de un tercio de los tokens de Carbon y, aun así, su coste por tarea es ligeramente superior. Esto indica que tanto la estructura de precios de cada modelo como la tasa de aciertos de caché influyen en el coste final.
La lectura de caché es una variable que suele pasarse por alto en escenarios de agentes. En cada turno, el agente reenvía una gran cantidad de contexto; en el caso de Carbon, el precio de entrada en caché es aproximadamente el 5 % del precio de entrada normal. Fable suma 40.48M de tokens totales, y buena parte de ellos es contexto que se lee repetidamente, así que la forma de facturar impacta directamente en la factura. Además, en Carbon los tokens de razonamiento se cuentan como salida, y cuando se usa Grounding, las solicitudes de búsqueda se cobran aparte.
Los datos de coste tienen tres criterios distintos y conviene citarlos por separado: la tabla 4 del artículo de MKA (Carbon $5.63, Fable $35.28), el ranking dinámico de MKA (Carbon $6.29, Fable $31.97) y el coste por tarea del índice AA ($7.76 y $26.54). El alcance estadístico de cada uno es diferente, así que no se pueden mezclar.
Cinco. Dónde se nota la ventaja multimodal de Gemini 4 Carbon
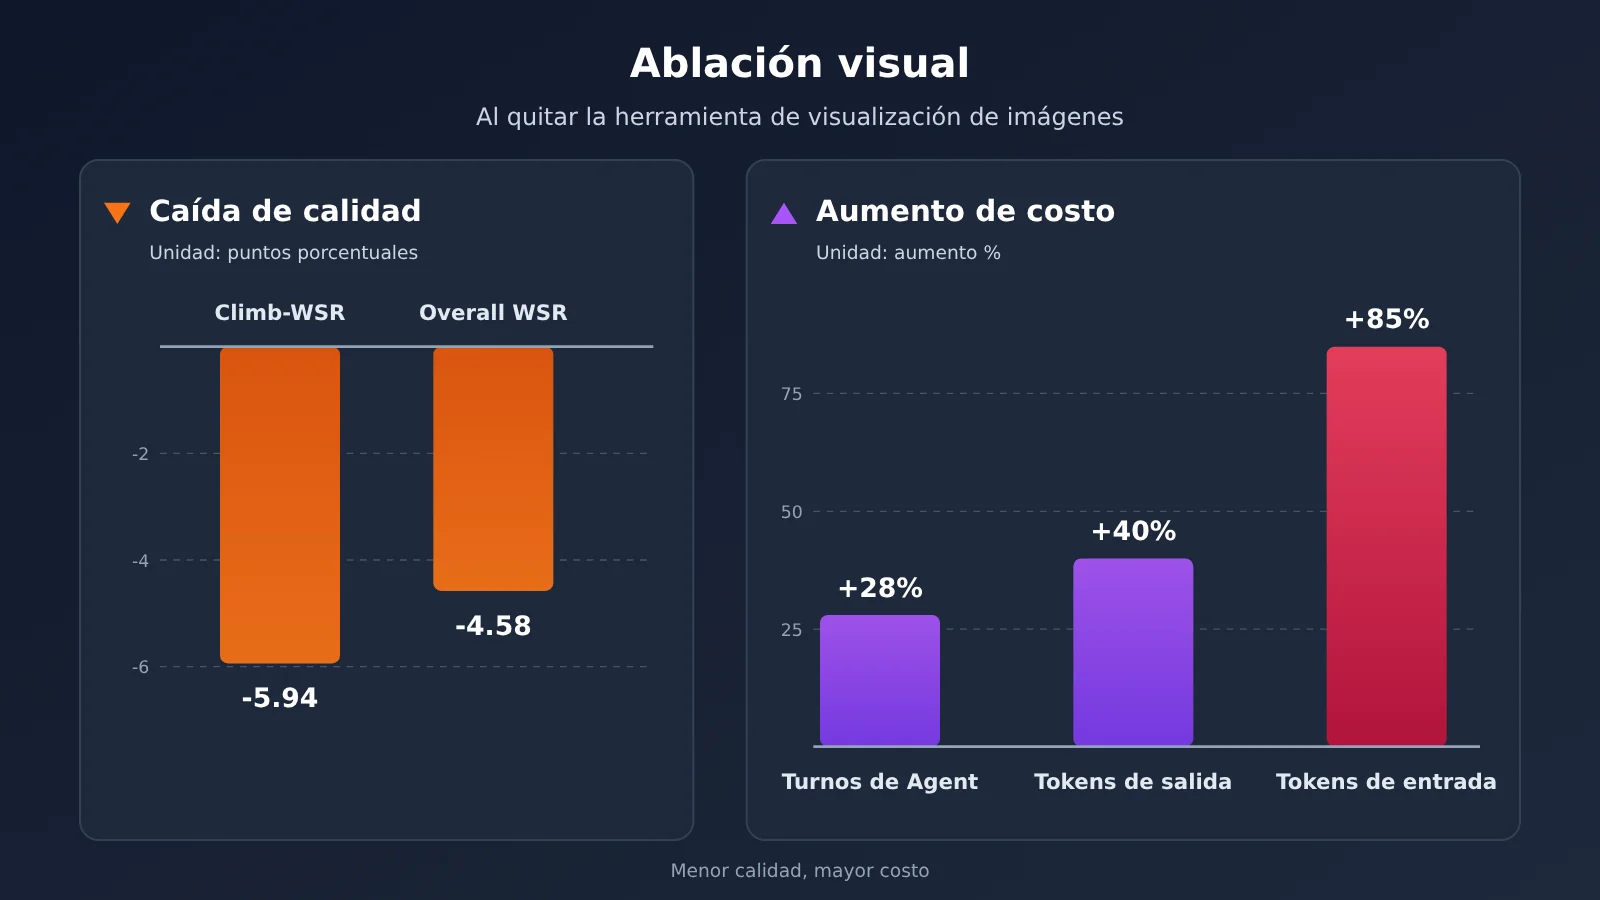
El artículo de MKA incluye un experimento de ablación: se elimina de Carbon la herramienta de visualización de imágenes view_image y se le obliga a resolver las tareas solo con OCR, ejecución de código y métodos tradicionales de visión por computadora. Estos son los resultados:
- Climb-WSR baja 5,94 puntos porcentuales y Overall WSR baja 4,58 puntos porcentuales.
- El número de turnos del agente aumenta un 28 %, los tokens de salida un 40 % y los tokens de entrada un 85 %.
- El modelo intenta compensarlo con imágenes ASCII, Unicode Braille y OpenCV, pero con fotos reales e imágenes médicas sigue fallando con facilidad.
Estos datos muestran que, en el trabajo profesional, la comprensión visual es muy difícil de sustituir con extracción de texto. Las relaciones espaciales de un plano arquitectónico, la ubicación de una lesión en una imagen médica o la codificación visual de un gráfico se pierden en su mayor parte al pasar por OCR. El modelo no tiene más remedio que escribir código una y otra vez para adivinar el contenido de la imagen, y el resultado es peor calidad y mayor costo.
Los resultados por sector del ranking de MKA van en la misma línea. Carbon lidera en salud y médico, y junto con Argon destaca en entregables de tipo imagen. Fable 5.2 lidera en software y datos, ingeniería, logística y mapas, negocios y finanzas, y se impone en tipos de entregable como PDF, Word y hojas de cálculo. Ningún modelo lidera en los 10 sectores, y Word y los archivos de texto plano siguen siendo los tipos de entregable más difíciles: ningún modelo supera el 52 % en ellos.
Sexta parte: escenarios recomendados para Gemini 4 Carbon, Claude Fable 5.2 y GPT-6 Astra
Cuándo elegir Claude Fable 5.2
- Entregas profesionales complejas donde la calidad del resultado es lo más importante: por ejemplo, informes de análisis financiero, propuestas de ingeniería y proyectos de software y datos. En este tipo de tareas un error sale caro, así que se pueden aceptar tiempos de ejecución más largos y facturas más altas.
- Entregas centradas en documentos de Office: los resultados en PDF, Word y hojas de cálculo son un punto fuerte de Fable en MKA.
Cuándo elegir Gemini 4 Carbon
- Trabajo complejo con agentes que necesita equilibrar calidad y costo: en MKA, Carbon alcanzó un nivel estadísticamente similar al de Fable con aproximadamente una sexta parte del costo.
- Tareas que dependen de la comprensión visual: por ejemplo, interpretación de planos, análisis asistido de imágenes médicas y entregas basadas en imágenes. Conviene empezar con el nivel de razonamiento MEDIUM, que en las pruebas de fiabilidad factual de AA inventa respuestas con menos frecuencia.
Cuándo elegir GPT-6 Astra
- Pipelines donde importa la velocidad de ejecución: en MKA tardó menos y necesitó menos turnos de agente, lo que lo hace adecuado para tareas que requieren respuestas rápidas.
- Escenarios sensibles al presupuesto de tokens o a la presión sobre la ventana de contexto: Astra tiene el menor consumo total de tokens, pero hay que asumir una brecha en la calidad de las entregas profesionales.
| Tipo de tarea | Modelo preferido | Modelo alternativo | Fundamento principal | Forma de acceso |
|---|---|---|---|---|
| Informes profesionales de alto valor | Claude Fable 5.2 | Gemini 4 Carbon | Mayor puntuación en AA y MKA | API oficial, APIYI |
| Tareas complejas de agentes en lote | Gemini 4 Carbon | Claude Fable 5.2 | Calidad similar, con un costo de aproximadamente una sexta parte | API oficial, APIYI |
| Análisis de planos e imágenes | Gemini 4 Carbon | Claude Fable 5.2 | Evidencia de ablación visual y liderazgo en el ámbito médico | API oficial, APIYI |
| Pipelines de ejecución rápida | GPT-6 Astra | Gemini 4 Carbon | Menor tiempo y menor consumo de tokens | API oficial, APIYI |
VII. Cómo probar los tres modelos con una interfaz unificada
Las clasificaciones públicas son solo un punto de partida; al final lo que cuenta es cómo rinde cada modelo en tus propias tareas. El siguiente ejemplo usa una interfaz compatible con OpenAI: basta con cambiar el parámetro model para invocar distintos modelos con el mismo código:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

resp = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "用三点概括这份季度财报摘要的主要风险。"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # Registra el consumo de tokens, para estimar el costo más adelante
Ver el código completo de la prueba comparativa de los tres modelos
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Los nombres de los modelos dependen de la lista de modelos de la plataforma; GPT-6 Astra es solo un nombre de ejemplo
MODELS = ["claude-fable-5-2", "gemini-4-carbon", "gpt-6-astra"]

# Precio unitario (USD por millón de tokens); complétalo según tu canal real
# Ejemplo: Fable 5.2 con precio oficial; Carbon con precio de lanzamiento hasta el 30 de noviembre
PRICES = {
    "claude-fable-5-2": {"input": 8.0, "output": 40.0},
    "gemini-4-carbon": {"input": 2.0, "output": 10.0},
    "gpt-6-astra": None,  # Complétalo por tu cuenta
}

def build_messages(task, image_url=None):
    content = [{"type": "text", "text": task}]
    if image_url:
        content.append({"type": "image_url", "image_url": {"url": image_url}})
    return [{"role": "user", "content": content}]

def run_once(model, messages):
    start = time.time()
    resp = client.chat.completions.create(model=model, messages=messages)
    elapsed = time.time() - start
    usage = resp.usage
    cost = None
    price = PRICES.get(model)
    if price and usage:
        # Estimación aproximada: no distingue la lectura de caché; los tokens de razonamiento suelen contarse como salida
        cost = (usage.prompt_tokens * price["input"]
                + usage.completion_tokens * price["output"]) / 1_000_000
    return {
        "model": model,
        "seconds": round(elapsed, 1),
        "prompt_tokens": usage.prompt_tokens if usage else None,
        "completion_tokens": usage.completion_tokens if usage else None,
        "est_cost_usd": round(cost, 4) if cost is not None else None,
        "answer": resp.choices[0].message.content[:200],
    }

if __name__ == "__main__":
    task = "根据这张户型图,列出各房间面积估算和三条改造建议。"
    msgs = build_messages(task, image_url="https://example.com/floor-plan.png")
    for m in MODELS:
        try:
            print(run_once(m, msgs))
        except Exception as e:
            print(m, "调用失败:", e)
Este código mide una sola invocación. En una tarea real de un Agent, el costo se obtiene sumando todas las rondas, que es lo que en este artículo llamamos costo por tarea. Además, ten en cuenta que Carbon no admite thinking_budget: si lo envías, devuelve un HTTP 400. Los parámetros de muestreo como temperature también se ignoran, así que el nivel de razonamiento debe configurarse como indica la documentación de la plataforma.
🚀 Recomendación para empezar rápido: lo mejor es reclamar primero el crédito de prueba gratuito para nuevos usuarios en APIYI (apiyi.com), ejecutar el script comparativo de arriba con entre 5 y 10 muestras reales de tu negocio, anotar el tiempo, los tokens y la puntuación de calidad, y solo entonces decidir cuál será tu modelo principal. La plataforma da acceso a OpenAI, Claude, Gemini y otros modelos populares con una misma clave API, con facturación por uso, y para cambiar de modelo solo tienes que modificar un parámetro.
Recomendaciones de decisión: cómo elegir entre los tres modelos
A la hora de elegir, conviene identificar primero cuál es la restricción más importante de tu tarea y luego fijarte en la métrica que corresponde:
- La calidad es una restricción imprescindible: toma como referencia principal el Climb-WSR de MKA y elige entre Fable 5.2 y Carbon. Como la diferencia entre ambos no es significativa, lo mejor es validarlo con tus propias muestras.
- El presupuesto es una restricción imprescindible: mira el costo por tarea de la tabla 4 de MKA, no el precio por token. Carbon tiene una ventaja clara en este punto.
- El tiempo de respuesta es una restricción imprescindible: fíjate en el tiempo de ejecución y en el número de turnos del Agent. Astra es el más rápido, pero hay que asumir la conclusión de que se queda bastante atrás en calidad de entrega profesional.
💡 Recomendación: puedes inspirarte en el enfoque de Google /swarm: usa el modelo más potente en las fases de planificación y revisión, y un modelo rápido en la fase de ejecución por lotes. Con la interfaz unificada de APIYI (apiyi.com) puedes asignar un modelo distinto a cada rol de Agent dentro del mismo proyecto, sin tener que mantener varios SDK.
Preguntas frecuentes (FAQ)
P1: ¿Cuál es el posicionamiento de Gemini 4 Carbon, Claude Fable 5.2 y GPT-6 Astra?
Los tres son modelos de razonamiento de primer nivel de la segunda mitad de 2026. Fable 5.2 lidera en calidad global y en entregables profesionales. Carbon ofrece un buen equilibrio entre calidad, capacidad multimodal y costo por tarea. La fortaleza de Astra es la velocidad de ejecución y la eficiencia en Tokens.
P2: En MKA, Fable 5.2 supera a Carbon por 2,22 puntos porcentuales. ¿Eso demuestra que Fable es más potente?
No. El intervalo de confianza del 95% de esa diferencia va de -0,94 a +5,49, es decir, incluye el 0, así que no alcanza significancia estadística. Lo más preciso es decir que ambos están en un nivel similar, y que los dos superan de forma significativa a Astra.
P3: ¿Se pueden comparar directamente los 65 puntos del índice AA con el 56,56% de MKA?
No. El índice AA es una puntuación compuesta de 9 evaluaciones, y cada modelo usa un nivel de razonamiento distinto. MKA, en cambio, mide la tasa de cumplimiento ponderada de entregables profesionales bajo un Harness unificado. Evalúan cosas distintas y puntúan de forma diferente, así que no se pueden convertir entre sí.
P4: Si el precio por Token de Carbon es una cuarta parte del de Fable, ¿el costo por tarea también es una cuarta parte?
No necesariamente. Durante el lanzamiento, el precio unitario de Carbon es efectivamente el 25% del de Fable 5.2, y a partir del 1 de diciembre pasa a ser el 50%. Pero la factura real depende del consumo de Tokens, los Tokens de razonamiento, los aciertos de caché y las llamadas a herramientas. En la tabla 4 de MKA, el costo por tarea de ambos difiere en unas seis veces, porque Carbon además consume bastantes menos Tokens.
P5: ¿Cómo puedo verificar los tres modelos por mi cuenta con un costo bajo?
Te recomiendo usar una interfaz agregada que soporte varios modelos:
1. Regístrate en APIYI (apiyi.com) para obtener tu clave API y créditos de prueba gratuitos;
2. Configura el `base_url` del código de este artículo como `https://api.apiyi.com/v1`;
3. Ejecuta una comparación con los archivos y tareas reales de tu negocio, y registra la calidad, el tiempo y el uso de Tokens.
P6: GPT-6 Astra es el que menos Tokens consume, ¿por qué su costo por tarea no es el más bajo?
Menos Tokens no significa una factura más baja. Cada modelo tiene una estructura de precios distinta para entrada, salida y caché, y el costo final es la suma del consumo multiplicado por su precio correspondiente. En la tabla 4 de MKA, Astra usa aproximadamente un tercio de los Tokens de Carbon, pero su costo es ligeramente superior.
P7: ¿Qué limitaciones tienen las conclusiones de estas evaluaciones?
En MKA cada tarea se ejecuta una sola vez, y el Judge es GPT-6 Luna Medium, con una tasa de concordancia del 96% con los revisores expertos. El ranking de AA es una instantánea dinámica, y cuando el precio de Carbon cambie el 1 de diciembre, el costo calculado con el precio estándar también variará. Si necesitas hacer un seguimiento de costos a largo plazo, puedes consultar el detalle de uso en APIYI (apiyi.com) y sumar el gasto real por modelo, para tener tus propios datos de costos.
Puntos clave de la comparativa entre los tres modelos (Key Takeaways)
- Capacidad general: en AA v5.0.1, Fable 5.2 Max obtiene 65 puntos, por delante de Carbon High (60) y Astra Max (57).
- Entrega profesional: en MKA, la diferencia entre Fable y Carbon no es significativa, y ambos superan de forma clara a Astra.
- Costo por tarea: según el criterio de la tabla 4 del artículo, Carbon cuesta $5.63 por tarea, aproximadamente una sexta parte de lo que cuesta Fable.
- Velocidad y eficiencia: Astra tarda 18.5 minutos por tarea y consume 2.43M de tokens, lo que lo convierte en el mejor en velocidad y eficiencia de tokens.
- Valor multimodal: al quitarle la herramienta de visualización de imágenes, la calidad de Carbon baja y los tokens de entrada aumentan un 85 %.
- Límites del criterio de medición: el precio por token, el consumo de tokens y la factura por tarea son tres conceptos distintos.
- Cómo empezar: con APIYI (apiyi.com) puedes hacer una prueba comparativa a pequeña escala de los tres modelos con una sola clave.
Conclusión: ningún indicador por sí solo determina cuál es el mejor modelo
Volviendo a la pregunta del principio, las diferencias entre estos tres modelos de primer nivel están en cómo equilibran calidad, velocidad y costo:
- Claude Fable 5.2: lidera tanto en el índice general como en la puntuación de entrega profesional, a cambio del mayor tiempo de ejecución y del costo por tarea más alto.
- Gemini 4 Carbon: su calidad en entrega profesional es estadísticamente similar a la de Fable, tiene el costo por tarea más bajo y su comprensión visual es su gran diferenciador.
- GPT-6 Astra: es el más rápido y el que menos tokens gasta, pero su calidad en entrega profesional queda claramente por debajo de los otros dos.
La capacidad general, la calidad de las tareas, la velocidad de respuesta y el costo por tarea conviene evaluarlos por separado. En lugar de fijarte solo en la posición en el ranking, lo más fiable es hacer una prueba comparativa con tus propias tareas. Te recomendamos usar APIYI (apiyi.com) para comprobar rápidamente cómo rinden los tres modelos en tu caso de uso; la plataforma ofrece crédito gratuito de prueba y una interfaz unificada para varios modelos.
📚 Referencias
- Informe técnico de MKA: MKA: Evaluating Multimodal Knowledge Agents on end-to-end professional tasks
- Enlace:
storage.googleapis.com/deepmind-media/papers/mka_tech_paper.pdf -
Descripción: datos originales del WSR de los tres modelos, intervalos de confianza, costos de la tabla 4 y experimentos de ablación visual
-
Ranking de modelos de Artificial Analysis: Intelligence Index v5.0.1
- Enlace:
artificialanalysis.ai/leaderboards/models -
Descripción: instantánea dinámica de puntuación global, costo por tarea y tiempo de ejecución
-
Ranking de evaluación MKA: clasificación de agentes de conocimiento multimodal
- Enlace:
artificialanalysis.ai/zh/evaluations/mka -
Descripción: resultados desglosados de los modelos líderes del sector y por tipo de archivo entregado
-
Ficha del modelo Gemini 4 Carbon: documentación oficial de Google DeepMind
- Enlace:
deepmind.google/models/model-cards/gemini-4-carbon -
Descripción: modalidades, contexto, niveles de razonamiento y limitaciones conocidas
-
Página de precios de la API de Gemini: precio estándar, precio con caché y precio Batch de Carbon
- Enlace:
ai.google.dev/gemini-api/docs/pricing -
Descripción: precio de lanzamiento y ajuste de precios a partir del 1 de diciembre
-
Documentación de la API de Claude Fable 5.2: descripción oficial del modelo por Anthropic
- Enlace:
platform.claude.com/docs/en/models/fable-5-2/overview - Descripción: contexto, salida máxima, precio por token y Fast Mode
Autor: equipo técnico de APIYI
Intercambio técnico: te invitamos a contactarnos desde la página principal de APIYI; para más información sobre la integración, visita el centro de documentación en docs.apiyi.com