Nota del autor: comparo Gemini 4 Carbon y Claude Opus 5.5 en 7 dimensiones (especificaciones, precio, mecanismo de razonamiento, protocolo y puntuaciones de las fichas oficiales de los modelos) y te doy una recomendación de «qué tipo de tarea darle a cada uno».
Primero la conclusión: la recuperación en contexto largo, el razonamiento científico y la ingeniería de múltiples pasos a largo plazo van para Gemini 4 Carbon. El control del ordenador, la automatización de escritorio y los flujos de trabajo que ya están conectados al protocolo messages de Anthropic van para Claude Opus 5.5. Entre los dos no hay uno que sea «mejor en todo»: solo hay tareas que le van mejor a uno u otro.
Esto no es un análisis tibio de «cada uno tiene lo suyo». Todas las puntuaciones de este artículo salen de las fichas oficiales de los modelos y de la documentación de los fabricantes, y están marcadas como autorreportadas por el fabricante. En precios, listo a la vez el precio oficial y el precio de APIYI a fecha de 2026-11-11, para que puedas compararlos directamente.
Valor principal: al terminar este artículo comparativo de Gemini 4 Carbon frente a Claude Opus 5.5, tendrás una tabla lista para usar en la elección de modelo, y entenderás por qué Carbon tiene un precio unitario más bajo y, aun así, no necesariamente te hace pagar una factura menor.
Gemini 4 Carbon vs Claude Opus 5.5: diferencias clave
Los dos son modelos insignia lanzados en la segunda mitad de 2026. Anthropic publicó Claude Opus 5.5 el 2026-09-22. Gemini 4 Carbon se anunció por primera vez el 2026-10-28 y, en ese momento, solo estaba disponible para equipos de defensa en ciberseguridad verificados por el Fairwind Program. No llegó a GA para desarrolladores de pago y empresas hasta el 2026-11-10.
Google posiciona a Carbon con bastante claridad: está basado en Gemini 4 Argon y está pensado para tareas que llevan la inteligencia al límite, como programación y depuración complejas de varios pasos o investigación científica abierta. Consume más thinking tokens que Argon, explora las hipótesis una por una y alarga los ciclos de verificación. Opus 5.5, por su parte, destaca por su pensamiento adaptativo, su salida grande de 128K y su capacidad de control del ordenador. Ambos modelos ya están disponibles en APIYI (apiyi.com), y puedes cambiar de uno a otro con la misma clave API.
Comparativa de especificaciones: Gemini 4 Carbon vs Claude Opus 5.5
| Aspecto | Gemini 4 Carbon | Claude Opus 5.5 |
|---|---|---|
| ID del modelo | gemini-4-carbon |
claude-opus-5-5 |
| Fecha de lanzamiento | Anunciado el 2026-10-28, GA el 2026-11-10 | 2026-09-22 |
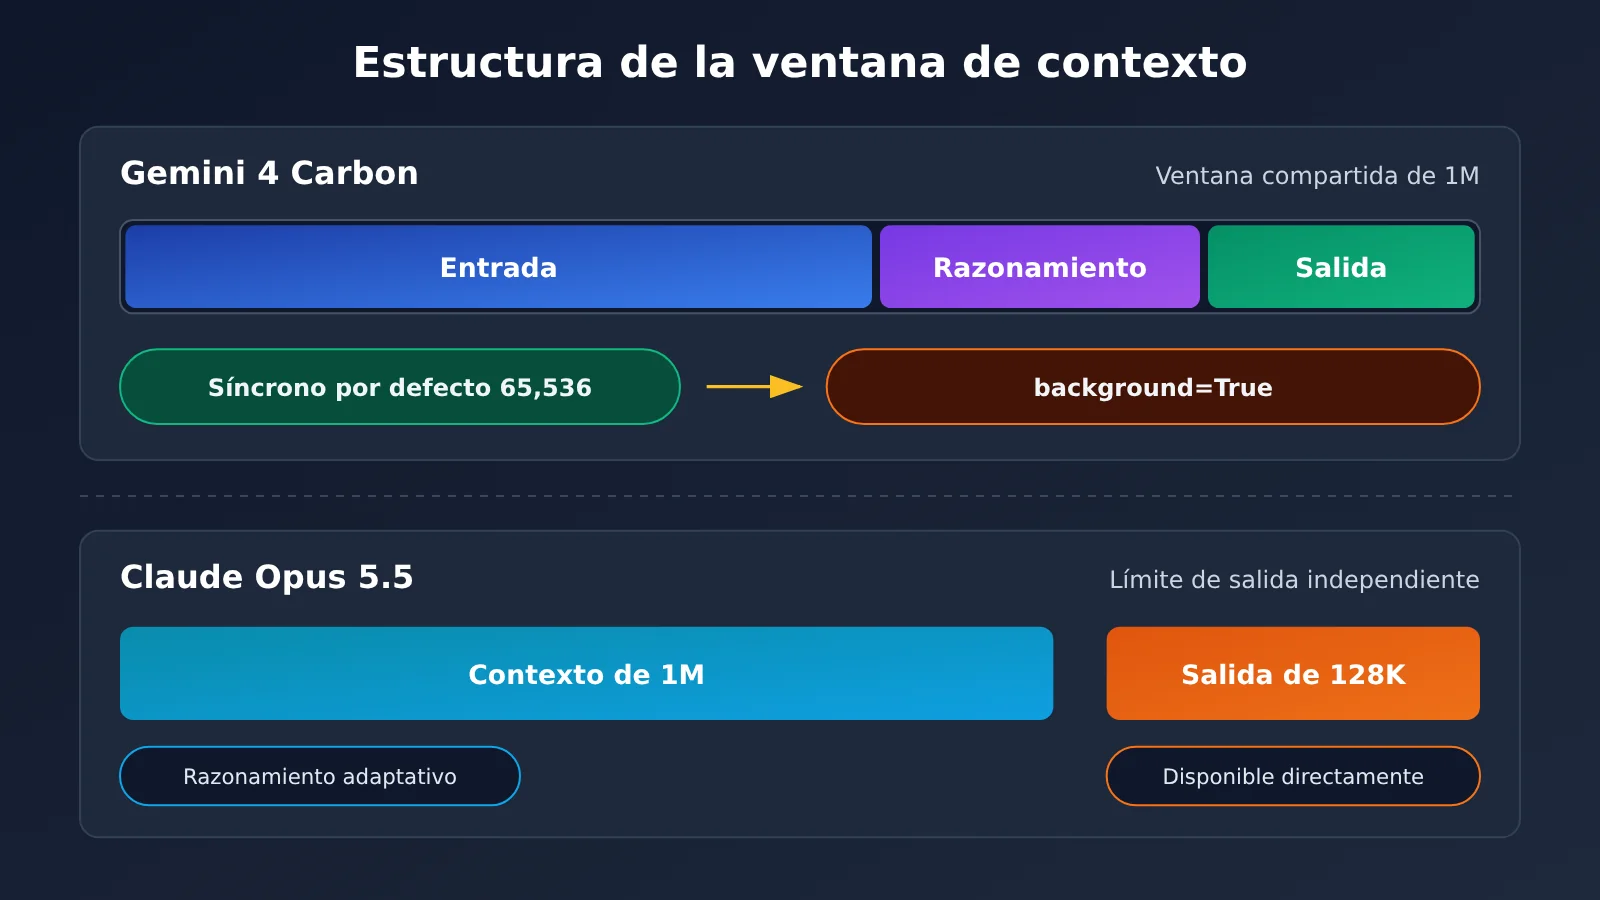
| Contexto | 1M; entrada, pensamiento y salida comparten una sola ventana | 1M |
| Límite de salida | 65,536 por defecto en modo síncrono; el modo en segundo plano permite ampliarlo, compartiendo el 1M con la entrada | 128K |
| Control de pensamiento | thinking_level: low / medium / high, por defecto medium |
El pensamiento adaptativo no se puede desactivar; el effort por defecto es medium |
| Corte de conocimiento | March 2026 (en algunos ámbitos puede ser anterior) | Corte de conocimiento fiable: June 2026 |
| Modalidades de entrada | Texto, imagen, audio, vídeo | Según la documentación oficial |
| Modalidades de salida | Texto (no genera imágenes ni vídeo) | Texto |
En esta tabla hay dos puntos en los que es fácil tropezar. El primero es el límite de salida: el 1M de Carbon es una ventana compartida, y por defecto una petición síncrona produce como máximo 65,536 tokens. Si necesitas una salida más larga, tienes que configurar background=True en la Interactions API y subir max_output_tokens por encima de 65536, dejando además margen para el pensamiento; si no, la respuesta puede quedar cortada. En Opus 5.5, en cambio, los 128K son un límite que puedes usar directamente.
El segundo es el mecanismo de pensamiento. Los tres niveles de Carbon se ajustan según la tarea: low sirve para clasificación, enrutamiento y extracción puntual; medium es el valor por defecto y equilibra velocidad, coste y acierto a la primera; high encaja con el análisis de causa raíz en varios archivos, las matemáticas formales y el diseño de arquitectura en fases tempranas. El pensamiento adaptativo de Opus 5.5 no se puede apagar, solo puedes ajustar el effort. Si tu negocio necesita un modo de baja latencia con «cero pensamiento», ninguno de estos dos modelos insignia es la mejor opción.
Gemini 4 Carbon vs. Claude Opus 5.5: precios y facturación
Si solo miras el precio unitario, Carbon es claramente más barato. Pero su precio bajo en el canal oficial es una promoción, y además «gasta» más tokens de razonamiento, así que la diferencia de precio unitario no se traduce directamente en una diferencia en la factura.
Precios oficiales vs. precios de lista en APIYI
La unidad es dólares por 1M de tokens. Los precios de lista de APIYI son los del grupo predeterminado a fecha de 2026-11-11, no precios con descuento.
| Concepto | Carbon oficial (hasta 11-30, global) | Carbon oficial (desde 12-01, global) | Opus 5.5 oficial | APIYI gemini-4-carbon |
APIYI claude-opus-5-5 |
|---|---|---|---|---|---|
| Entrada | 2 | 4.00 | 4 | 2 | 4 |
| Salida (incluye razonamiento) | 10 | 20.00 | 20 | 10 | 20 |
| Lectura de caché | 0.10 | 0.20 | 0.20 | 0.10 | 0.20 |
| Escritura de caché | Caché implícita, sin precio aparte | Igual | 5 min: 5 / 1 h: 8 | Sin multiplicador de escritura de caché aparte | Equivale a 5 (multiplicador 1.25) |
| Grupos disponibles | — | — | — | default, svip | ClaudeCode, ClaudeCodeReverse, ClaudeOfficial, default, svip |
Algunos detalles oficiales más. Durante la promoción, los endpoints no globales de Carbon cuestan 2.20 / 0.11 / 11. Gemini 4 Carbon Cyber Permissive no entra en la promoción y se factura directamente a 4 / 0.20 / 20. El Fast mode de Opus 5.5 cuesta 8 de entrada y 40 de salida, y la inferencia exclusiva en EE. UU. multiplica además por 1.1.
En APIYI, los multiplicadores de cada grupo se calculan aparte. En Opus, el grupo ClaudeCode tiene 0.95, ClaudeCodeReverse 0.5 y ClaudeOfficial 1.2, mientras que default y svip tienen 1. Carbon solo tiene los grupos default y svip, ambos con multiplicador 1. Las recargas usan un tipo de cambio fijo de 1:7 y se pueden combinar con los bonos de recarga y los descuentos por grupo; el cargo real es el que aparece en la consola. Los modelos y precios se rigen por la lista de modelos de apiyi.com. Si la tabla general de la documentación todavía no muestra la fila de Carbon, guíate por la consola y la interfaz de precios.
Por qué la diferencia de precio unitario no es la diferencia en la factura
El costo de una solicitud es aproximadamente: tokens de entrada × precio de entrada + (tokens de razonamiento + tokens de respuesta) × precio de salida. El precio de salida de Carbon es la mitad que el de Opus, pero Google dice explícitamente que gasta más tokens de razonamiento que Argon para ejecutar sus bucles de verificación. Si tomas una misma tarea, basta con que el total de «razonamiento + respuesta» de Carbon supere el doble que el de Opus para que la parte de salida acabe siendo más cara.
En el canal oficial, a partir del 1 de diciembre los precios unitarios de Carbon y Opus son exactamente iguales, así que la factura más baja será la del modelo que use menos tokens. Anthropic también tiene su propio argumento de ahorro: según sus cifras, Opus 5.5 necesita alrededor de un 40% menos de tokens que Opus 5 para hacer el mismo trabajo. Es un dato autodeclarado por el fabricante, no un experimento comparativo entre estos dos modelos. Lo más sensato es ejecutar un lote de tus propias tareas reales con cada uno y mirar el cargo efectivo en la consola.
El mecanismo de caché tampoco es el mismo. Carbon activa por defecto la caché implícita, con un 95% de descuento en la entrada cacheada, y la guía para desarrolladores indica que ya no hay que crear ni pasar cached_content de forma explícita. En Opus, la caché hay que escribirla: la escritura de 5 minutos cuesta 5 dólares, lo que encaja bien con llamadas repetidas que comparten un system prompt largo y fijo.
Gemini 4 Carbon frente a Claude Opus 5.5: puntuaciones de las fichas de modelo oficiales
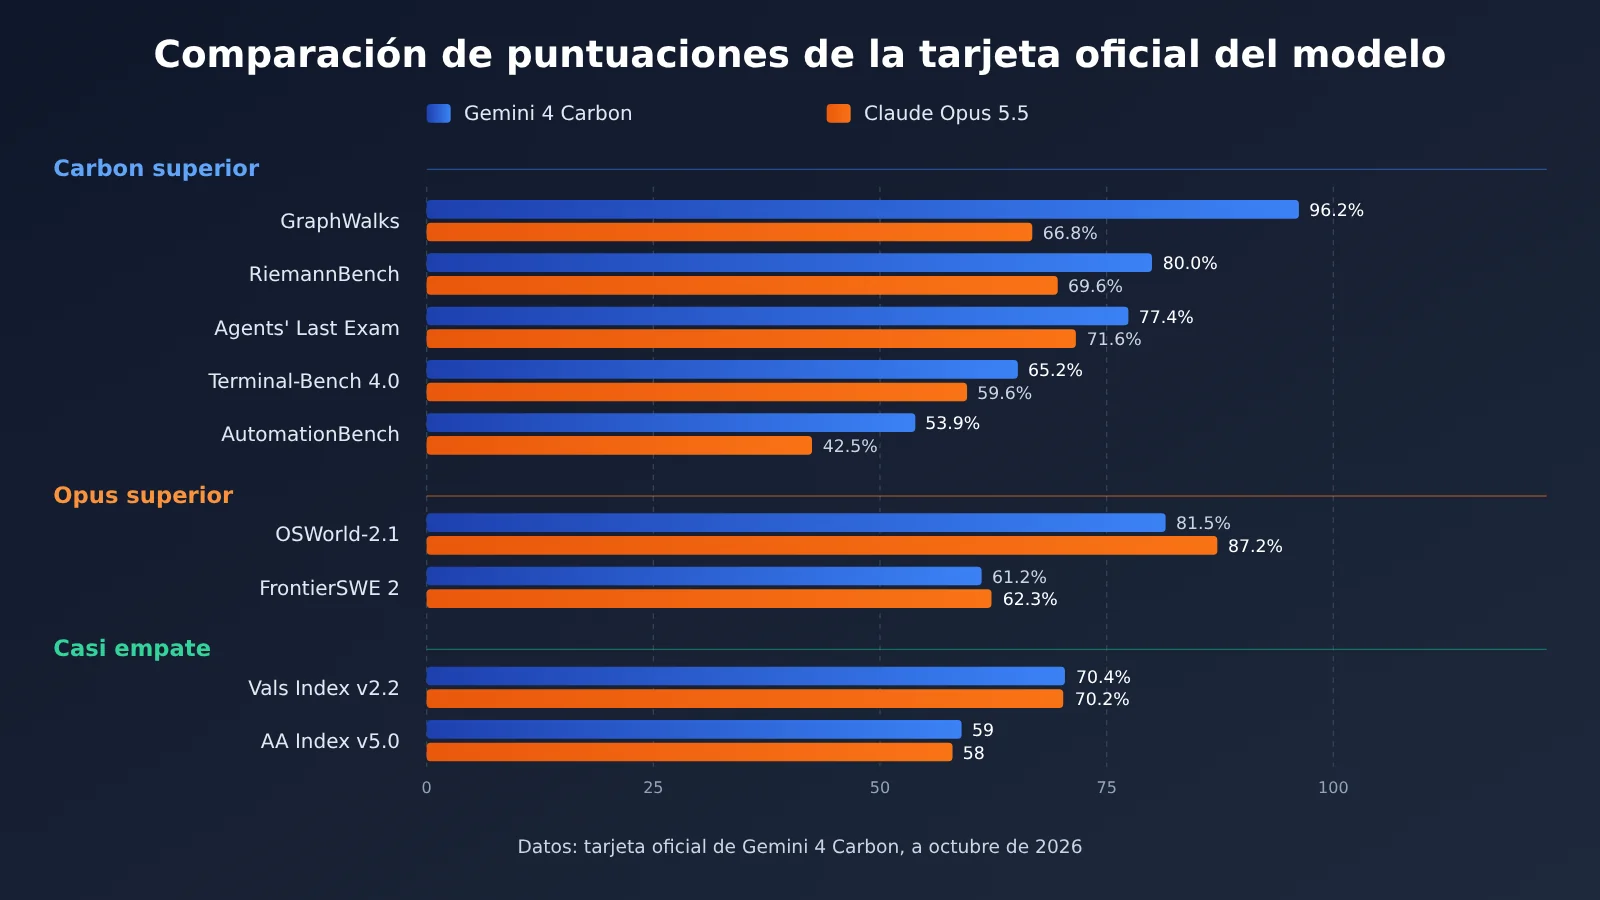
Todos los datos de la tabla provienen de la ficha de modelo oficial de Gemini 4 Carbon publicada por Google, con resultados a octubre de 2026, y son autodeclarados. Las cifras de Opus 5.5 de la tabla también están tomadas de esa misma ficha, no de pruebas independientes de Anthropic.
| Benchmark (ficha de modelo oficial) | Gemini 4 Carbon | Claude Opus 5.5 | Conclusión |
|---|---|---|---|
| OSWorld-2.1 subconjunto offline (uso del ordenador) | 81.5% | 87.2% | Opus es superior, y es además la puntuación más alta de la tabla |
| FrontierSWE 2 | 61.2% | 62.3% | Opus ligeramente superior; ambos quedan por debajo del 65.5% de GPT-6 Astra |
| Vals Index v2.2 | 70.4% | 70.2% | Casi empate |
| AA Index v5.0 | 59 | 58 | Casi empate |
| SWE-sweep | 9.6% | 3.6% | Carbon es superior |
| Terminal-Bench 4.0 (AA) | 65.2% | 59.6% | Carbon es superior |
| Agents’ Last Exam v1.1 | 77.4% | 71.6% | Carbon es superior |
| AutomationBench (Zapier) | 53.9% | 42.5% | Carbon es superior |
| GraphWalks 256k–1M BFS (F1) | 96.2% | 66.8% | Carbon claramente superior (contexto largo) |
| RiemannBench | 80.0% | 69.6% | Carbon es superior (razonamiento científico) |
| Terminal-Bench-Science 0.1 (AA) | 64.8% | 59.0% | Carbon es superior |
| Chartography | 72.5% | 66.3% | Carbon es superior |
Esta tabla deja tres ideas claras. Primero, el contexto largo y el razonamiento científico son las áreas donde Carbon se despega más: en GraphWalks la diferencia ronda los 30 puntos porcentuales. Si tu tarea consiste en hacer búsquedas multisalto sobre cientos de miles de tokens de material, este es el dato más útil como referencia.
Segundo, el uso del ordenador es terreno de Opus 5.5. En el subconjunto offline de OSWorld-2.1, Opus supera a Carbon por unos 6 puntos porcentuales. Si trabajas con agentes de escritorio, automatización del navegador o de interfaces gráficas (GUI), Carbon no es el número uno en este apartado.
Tercero, en las tareas de ingeniería de software sobre repositorios públicos, ninguno de los dos queda en primer lugar. En FrontierSWE 2, GPT-6 Astra es el mejor, Opus es segundo y Carbon tercero, con diferencias pequeñas. En SWE-sweep, el 9.6% de Carbon supera al 3.6% de Opus, pero el valor absoluto es muy bajo y además es casi igual al 9.5% de Astra, así que no conviene leerlo como una ventaja de un orden de magnitud.
La ficha del modelo también incluye tres resultados de ciberseguridad: CWE-bench, ExploitGym y SEC-bench Pro. Sin embargo, corresponden al rendimiento bajo la vía del Fairwind Program, y el comunicado del 28 de octubre aclara que se evaluaron sin salvaguardas. La API de pago no ofrece por defecto esa misma capacidad, así que estos tres resultados no deberían usarse como base para elegir un modelo para programación cotidiana.
Recomendaciones por escenario: Gemini 4 Carbon vs. Claude Opus 5.5
Cuándo elegir Gemini 4 Carbon
- Búsqueda y síntesis sobre material muy extenso: bases de normativa, repositorios de código completos, preguntas de varios saltos sobre investigaciones largas. Aquí se aprovecha al máximo la ventana compartida de 1M y su ventaja en GraphWalks.
- Razonamiento científico y matemáticas formales: lidera en RiemannBench y en Terminal-Bench-Science. Conviene poner
thinking_levelen high para que el modelo verifique a fondo. - Ingeniería de largo recorrido en varios pasos y auditoría de arquitectura: Google recomienda que, dentro de /swarm en Antigravity, Carbon asuma los roles que exigen el razonamiento más profundo (arquitectura, coordinación y auditoría), y que las partes de implementación en paralelo se las pases a
gemini-4-argonogemini-3.8-flash. - Documentos multimodales: admite texto, imágenes, audio y vídeo, y obtiene mejor puntuación en Chartography, así que va bien para analizar informes con muchos gráficos.
Cuándo elegir Claude Opus 5.5
- Control del ordenador y agentes de escritorio: tiene la puntuación más alta de la tabla en OSWorld-2.1, así que es la primera opción para automatizar interfaces gráficas.
- Flujos de trabajo que ya usan Claude Code o el protocolo messages: no hace falta cambiar el protocolo, basta con sustituir el ID del modelo.
- Salidas únicas muy largas: el límite de salida de 128K se puede usar directamente, sin tener que pasar al modo en segundo plano como ocurre con Carbon.
- Conocimiento más reciente: su fecha de corte fiable es June 2026, tres meses posterior a la de Carbon (March 2026).
Cuándo ninguno de los dos es la mejor opción
Para el desarrollo de funcionalidades del día a día y la programación interactiva, Google recomienda seguir con Gemini 4 Argon. Tiene el mismo precio unitario que Carbon, pero gasta menos tokens y responde más rápido. Si ya trabajas con la Responses API y necesitas 1.05M de contexto y razonamiento en nivel max, puedes valorar GPT-6 Astra. Eso sí, su precio de lista es unas 5 veces el precio promocional de Carbon (10/50 frente a 2/10), y además se encarece por tramos a partir de 272K de entrada.
Gemini 4 Carbon vs. Claude Opus 5.5: cómo se integra cada uno
Las diferencias de protocolo suelen pesar más en el trabajo de ingeniería que las diferencias de puntuación. Opus 5.5 usa de forma nativa el protocolo Anthropic messages; Carbon usa el protocolo nativo de Gemini o el chat completions compatible con OpenAI, pero no Anthropic messages.
| Dimensión de integración | Gemini 4 Carbon | Claude Opus 5.5 |
|---|---|---|
| Protocolo nativo | Gemini nativo (/v1beta) | Anthropic messages |
| Endpoint en APIYI | gemini, openai (/v1/chat/completions) | anthropic (messages), openai (chat) |
| Parámetros de razonamiento | thinking_level; thinking_budget está obsoleto |
effort; el razonamiento no se puede desactivar |
| Parámetros de muestreo | Si personalizas temperature, top_p o top_k, se ignoran y se muestra una advertencia | Se configuran según la documentación de Anthropic |
| Recomendación de timeout | Los problemas difíciles pueden tardar varios minutos: configura el timeout del cliente en al menos 15–20 minutos, o usa background=True |
Configuración habitual para tareas largas |
Cambiar rápido entre modelos con la interfaz compatible con OpenAI
Si quieres probar ambos modelos con un mismo código, lo más sencillo es usar la interfaz compatible con OpenAI. Estos son los pasos:
- Crea una clave API en la consola y elige el grupo default o svip (estos dos grupos cubren ambos modelos).
- En el SDK de OpenAI, configura
base_urlcomohttps://api.apiyi.com/v1y pon tu clave enapi_key. - Al llamar a chat completions, asigna a
modelel valorgemini-4-carbonoclaude-opus-5-5según el caso; la estructura de messages no cambia. - Cuando pruebes Carbon, quita parámetros de muestreo como temperature y sube el timeout del cliente a más de 15 minutos.
- Compara en la consola el uso de tokens y el cobro real de cada modelo, en lugar de fijarte solo en el precio unitario.
Si tu proyecto ya está integrado con Claude Code o con el SDK de Anthropic, Opus 5.5 puede seguir usando el endpoint messages. Si necesitas un grupo específico para Claude Code, puedes elegir ClaudeCode o ClaudeOfficial.
🚀 Recomendación para empezar: usa primero la interfaz compatible con OpenAI de APIYI (apiyi.com), envía el mismo conjunto de tareas reales a ambos modelos y compara la calidad de las respuestas y el cobro en la consola. Una vez que tengas clara la división del trabajo, decide si Opus vuelve al protocolo nativo messages.
Gemini 4 Carbon vs. Claude Opus 5.5: recomendaciones para decidir
Resumimos todo lo anterior en una tabla de decisión:
| Tu tarea principal | Recomendación | Argumento clave |
|---|---|---|
| Recuperación en contextos largos (nivel 1M) y síntesis multisalto | Gemini 4 Carbon | GraphWalks 96.2% frente a 66.8% (ficha oficial del modelo) |
| Razonamiento científico y matemáticas formales | Gemini 4 Carbon | Lidera en RiemannBench y Terminal-Bench-Science |
| Uso del ordenador, agentes de escritorio/navegador | Claude Opus 5.5 | OSWorld-2.1 87.2% frente a 81.5% |
| Flujos de trabajo ya montados sobre messages / Claude Code | Claude Opus 5.5 | Protocolo nativo, salida de 128K |
| Ingeniería de software en repositorios públicos | Están cerca; conviene considerar Astra | En FrontierSWE 2 Astra obtiene la puntuación más alta y Opus queda ligeramente por encima de Carbon |
| Desarrollo diario y programación interactiva | Gemini 4 Argon | Mismo precio que Carbon, gasta menos tokens y es más rápido |
| Trabajo de conocimiento en general | Cualquiera de los dos, según el coste | Vals Index 70.4% frente a 70.2%, prácticamente empate |
💡 Nuestro consejo: la mayoría de los equipos no necesita elegir solo uno. Puedes enrutar según el tipo de tarea: las solicitudes de contexto largo e investigación científica van a Carbon, y las de operación de GUI y flujos con messages van a Opus. Ambos modelos están disponibles en los grupos default y svip de APIYI (apiyi.com), así que para enrutar solo tienes que cambiar el campo
model.
Una advertencia más: las capacidades especializadas de ciberseguridad con enfoque defensivo se obtienen a través del Fairwind Program. Cambiar el nombre del modelo a gemini-4-carbon no significa que obtengas la versión Cyber Permissive, y además, en el canal oficial, Cyber Permissive no se beneficia del precio promocional de 2 dólares.
Preguntas frecuentes (FAQ)
Q1: ¿Quién es más potente, Gemini 4 Carbon o Claude Opus 5.5?
Ninguno gana en todo. Según las fichas oficiales de los modelos (a octubre de 2026), Carbon rinde más en contexto largo, razonamiento científico y tareas de terminal; Opus 5.5 va por delante en OSWorld (uso del ordenador) y en FrontierSWE 2. En Vals Index y AA Index, los dos están prácticamente empatados.
Q2: Carbon cuesta la mitad que Opus, ¿significa eso que siempre ahorro dinero?
No necesariamente. Carbon consume más tokens de razonamiento, y esos tokens se facturan al precio de salida. El precio promocional de 2 dólares en el canal oficial solo dura hasta el 30 de noviembre de 2026; desde el 1 de diciembre se iguala al de Opus. La factura final depende del cobro real que veas al ejecutar la misma tarea.
Q3: ¿Cuándo se pueden usar los dos modelos a través de la API?
Opus 5.5 salió el 22 de septiembre de 2026. Carbon se anunció por primera vez el 28 de octubre de 2026 y solo estaba disponible para los defensores de Fairwind; desde el 10 de noviembre de 2026, la Gemini API pasa a GA (disponibilidad general) para desarrolladores de pago y empresas. Para los usuarios gratuitos y los planes de consumo más básicos, la documentación oficial no da ninguna fecha.
Q4: ¿Puedo llamar a Carbon con el protocolo messages de Anthropic?
No. Carbon funciona con el protocolo nativo de Gemini o con chat completions compatible con OpenAI. Si tu código se basa en el SDK de Anthropic, para integrar Carbon tendrás que cambiar al SDK de OpenAI o al de Gemini. Opus 5.5, en cambio, admite tanto el endpoint messages como el de chat.
Q5: ¿Cómo comparo rápido el rendimiento de ambos modelos en mi propio caso de uso?
Regístrate en APIYI (apiyi.com), crea una clave del grupo default, apunta el SDK de OpenAI a la interfaz `/v1` y ejecuta el mismo lote de tareas poniendo `model` en `gemini-4-carbon` y en `claude-opus-5-5`. Los usuarios nuevos tienen crédito gratuito de prueba, suficiente para una comparación a pequeña escala.
Q6: ¿Por qué se corta la salida de Carbon?
El límite de salida por defecto en las peticiones síncronas es de 65.536 tokens, y los tokens de razonamiento también cuentan dentro de ese presupuesto. Si necesitas salidas más largas, puedes configurar `background=True` en la Interactions API y subir `max_output_tokens`, dejando además margen para el razonamiento.
Q7: ¿Qué limitaciones conocidas tiene cada modelo?
La ficha de Carbon reconoce problemas como alucinaciones, una resistencia a jailbreaks que todavía se está reforzando, lentitud o timeouts ocasionales y un mayor consumo de tokens en los niveles de razonamiento alto; además, su corte de conocimiento es anterior (marzo de 2026). En Opus 5.5 el razonamiento no se puede desactivar, lo que lo hace poco adecuado para escenarios de baja latencia, y en los benchmarks de contexto largo y ciencia de la ficha queda por debajo de Carbon.
Gemini 4 Carbon frente a Claude Opus 5.5: puntos clave
- Para contexto largo y razonamiento científico, elige Carbon: lidera con claridad en los resultados de las fichas oficiales del modelo, como GraphWalks y RiemannBench.
- Para operar el ordenador, elige Opus 5.5: su 87,2 % en el subconjunto offline de OSWorld-2.1 es el más alto de la tabla.
- En ingeniería de software están muy parejos: en FrontierSWE 2 Opus queda ligeramente por delante y Astra obtiene el mejor resultado; en SWE-sweep Carbon es superior.
- El precio unitario no es lo mismo que la factura: Carbon gasta más tokens de razonamiento, y el precio promocional oficial solo llega hasta el 30 de noviembre.
- El protocolo determina el coste de adaptación: Opus usa messages, mientras que Carbon usa la interfaz nativa de Gemini o la compatible con OpenAI.
- La salida y el mecanismo de razonamiento son distintos: Opus ofrece 128K de salida y el razonamiento no se puede desactivar; Carbon tiene una salida predeterminada de 65.536 tokens y tres niveles de
thinking_level.
Resumen
En la comparación entre Gemini 4 Carbon y Claude Opus 5.5, lo importante no es quién gana, sino cómo se reparten el trabajo:
- Carbon se encarga del «pensamiento más profundo»: contexto largo, razonamiento científico, arquitectura y auditoría, a cambio de más tokens de razonamiento.
- Opus 5.5 se encarga de «ponerse manos a la obra» y de la compatibilidad: operación del ordenador, flujos de trabajo con messages y una salida grande de 128K.
- La factura depende del consumo real: durante la promoción Carbon tiene ventaja en precio unitario, pero el cobro final depende del total de tokens.
Te recomendamos hacer primero una pequeña prueba de enrutamiento según el tipo de tarea y después decidir cuál será tu modelo principal. Con APIYI (apiyi.com) puedes invocar ambos modelos con una sola clave, con pago por uso, lo que facilita compararlos y cambiar de uno a otro.
📚 Referencias
- Blog de Google – Anuncio de disponibilidad de Gemini 4 Carbon: abierto a desarrolladores de pago desde el 2026-11-10
- Enlace:
blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available -
Descripción: alcance de la disponibilidad y las nuevas evaluaciones autorreportadas oficialmente en noviembre
-
Ficha de modelo oficial de Gemini 4 Carbon: resultados de benchmarks hasta octubre de 2026
- Enlace:
deepmind.google/models/model-cards/gemini-4-carbon/ -
Descripción: fuente de todas las puntuaciones de este artículo, incluidas las limitaciones conocidas
-
Guía para desarrolladores de Gemini 4 Carbon: thinking_level, ventana compartida de 1M y notas de migración
- Enlace:
aistudio.google.com/learn/gemini-4-carbon-developer-guide -
Descripción: modo background, tiempos de espera y configuración de caché implícita
-
Precios de modelos de Google Cloud: precio promocional de Carbon y precio estándar a partir del 1 de diciembre
- Enlace:
cloud.google.com/model-garden/pricing -
Descripción: precios de los endpoints globales y no globales
-
Documentación oficial de Claude Opus 5.5: especificaciones, mecanismo de razonamiento y precios
- Enlace:
platform.claude.com/docs/en/models/opus-5-5/overview -
Descripción: salida de 128K, fecha de corte de conocimiento y precio de escritura en caché
-
Tabla general de modelos de APIYI: modelos de la plataforma y precios de lista por defecto
- Enlace:
docs.apiyi.com/models -
Descripción: si aún no se ha actualizado, consulta la consola
-
Interfaz de precios de APIYI: multiplicadores en tiempo real e información de grupos
- Enlace:
api.apiyi.com/api/pricing - Descripción: fuente de los datos de precios del 2026-11-11 usados en este artículo
Autor: Equipo técnico de APIYI
Intercambio técnico: escríbenos desde la página principal de APIYI; encontrarás más materiales en el centro de documentación docs.apiyi.com