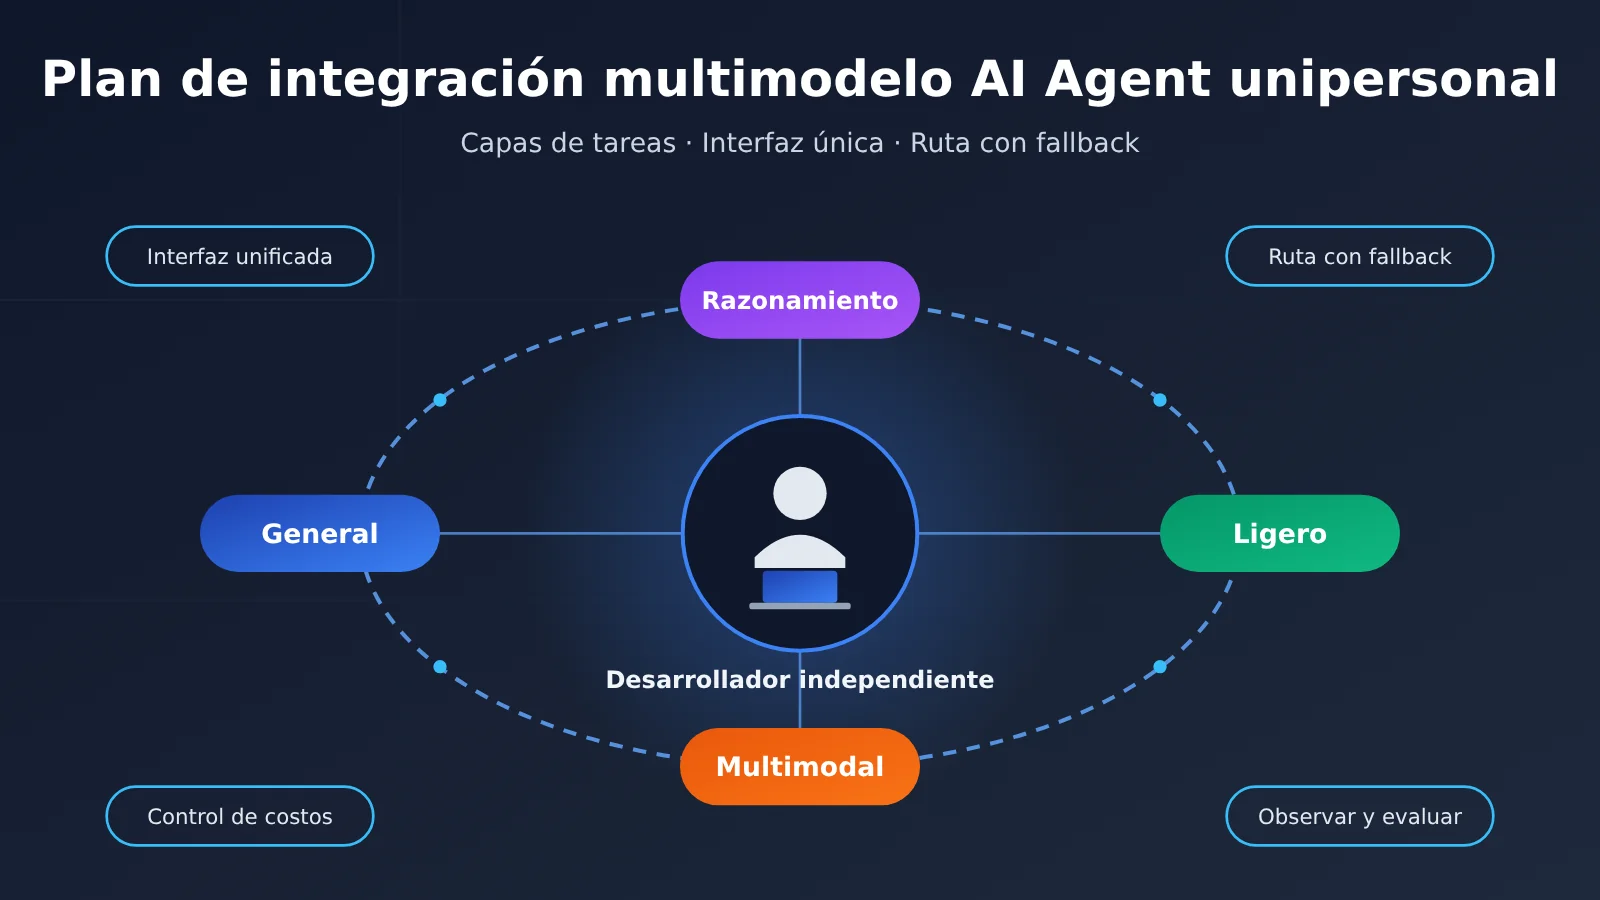
Nota del autor: para desarrolladores independientes, este artículo organiza la integración multimodelo de agentes de IA y flujos de trabajo en proyectos unipersonales en 5 etapas: estratificación por tareas, interfaz unificada, enrutamiento con degradación, control de costos y observación/evaluación.
Cuando una sola persona desarrolla un producto de IA, lo que más suele bloquear el avance no es la indicación, sino la integración de múltiples modelos. Al planificar agentes y flujos de trabajo, enseguida aparecen varias preguntas: qué modelo elegir, si conviene integrar varios proveedores a la vez, cómo gestionar las claves API, cómo controlar la factura y qué hacer cuando el servicio de un proveedor se vuelve inestable. Este artículo propone un método de planificación para la integración multimodelo basado en “estratificación por tareas + interfaz unificada + enrutamiento con degradación”, para que en un proyecto unipersonal puedas hacer esto con poco mantenimiento y de forma escalable.
Esto no es una versión reducida de la arquitectura de una gran tecnológica. En un equipo hay personas dedicadas a mantener la puerta de enlace, el monitoreo y la conciliación financiera; un proyecto unipersonal no tiene esas condiciones. Las recomendaciones siguientes giran en torno a un principio: conseguir la flexibilidad suficiente con el mínimo costo de mantenimiento.
Valor principal: al terminar este artículo, sabrás cómo definir niveles de modelos para tus agentes de IA y flujos de trabajo, unificar la forma de integración, diseñar cadenas de degradación y ver con claridad cuánto cuesta cada invocación del modelo.
Aspectos clave para integrar varios modelos en un Agente de IA de un proyecto unipersonal
Antes de ponerte a escribir código, ten claros estos cinco puntos. Van a determinar si durante los próximos tres meses estás iterando el producto o arreglando la capa de integración.
| Punto clave | Descripción | Valor para un proyecto unipersonal |
|---|---|---|
| Segmentación de tareas | Dividir las llamadas del Agente y del Workflow en 3-4 niveles según dificultad y frecuencia | Usar modelos caros solo en las partes críticas y mantener el costo total bajo control |
| Interfaz unificada | Que todos los modelos usen un mismo formato de petición, por ejemplo el formato compatible con OpenAI | Cambiar de modelo implica tocar un solo parámetro, sin reescribir el código de negocio |
| Enrutamiento y degradación | Configurar un modelo principal y otro de respaldo para cada nivel | Si un servicio falla, el producto no se queda completamente inutilizado |
| Criterio de costos | Distinguir partidas de facturación como entrada, salida y caché, tomando como referencia la página de precios de la plataforma | Evitar que la factura de fin de mes se descontrole |
| Observabilidad y evaluación | Registrar el modelo, la latencia, los tokens y la calidad del resultado de cada invocación | Decidir con datos si cambiar de modelo o no, y no por intuición |
Los puntos clave de la planificación, en detalle
La segmentación de tareas es el punto de partida de toda la planificación. Un Agente de IA típico hace muchas cosas de naturaleza distinta: entender la intención del usuario, planificar pasos, llamar herramientas, resumir resultados y formatear la salida. Estos pasos exigen capacidades muy diferentes. Para tareas como clasificar intenciones o extraer campos, normalmente basta con un modelo ligero; solo la planificación de varios pasos, la generación de código complejo o el razonamiento sobre documentos largos necesitan un modelo de gama alta. Si usas el modelo más potente en todo el flujo, el costo y la latencia se multiplican; si usas solo modelos ligeros, es fácil que fallen los puntos críticos. Primero segmentar y después elegir modelo: es lo más rentable para un proyecto unipersonal.
La interfaz unificada determina tu costo de mantenimiento. Los SDK oficiales de cada proveedor no coinciden del todo en los nombres de parámetros, el formato de respuesta en streaming ni la estructura de las llamadas a herramientas. Conectarte directamente a tres o cuatro proveedores oficiales implica mantener tres o cuatro conjuntos de código de adaptación, tres o cuatro cuentas y tres o cuatro facturas. Para una sola persona, ese esfuerzo debería ir al producto. Lo más realista es elegir una capa de integración agregada que sea compatible con los formatos de OpenAI y Anthropic; en el lado del negocio solo reconoces un protocolo y los modelos pasan a ser elementos de configuración intercambiables.
Cómo seleccionar modelos por capas según la tarea en un AI Agent de proyecto unipersonal
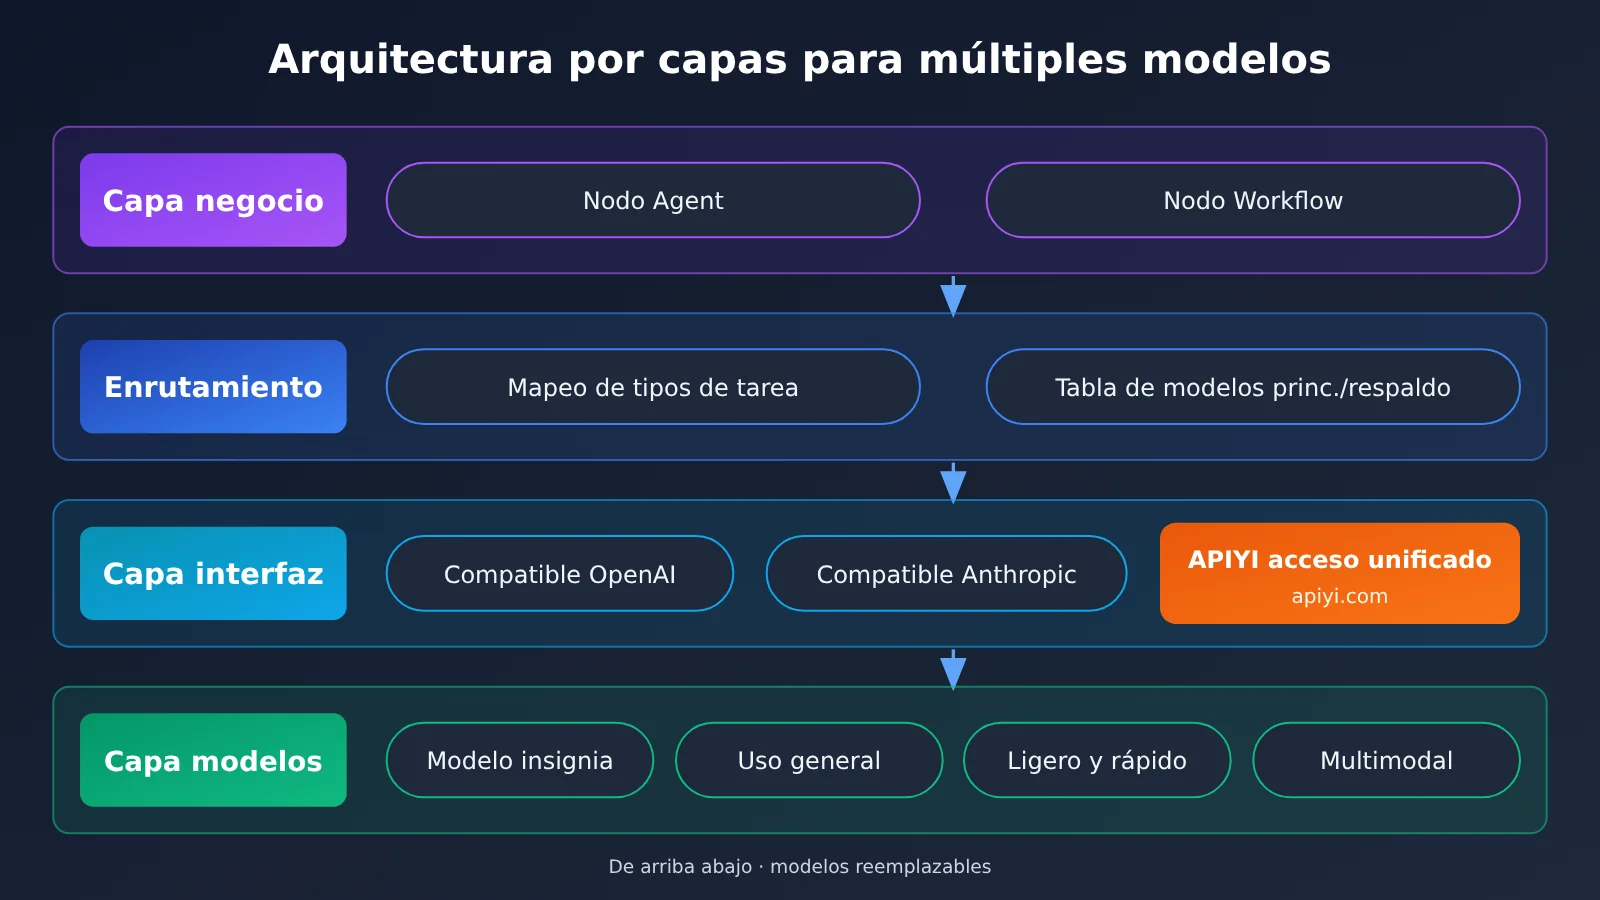
La clave para estratificar es dividir según las características de la tarea, no según el nombre del modelo. A continuación tienes una división en cuatro capas válida para la mayoría de AI Agents y Workflows, que puedes usar directamente como punto de partida y ajustar después según tu propio negocio.
| Capa | Tareas típicas | Requisitos de capacidad del modelo | Criterio de selección |
|---|---|---|---|
| L1 Capa de razonamiento | Planificación de varios pasos, código complejo, análisis de documentos largos | Razonamiento profundo, buen seguimiento de instrucciones, contexto largo | Modelos insignia o de razonamiento de cada proveedor, con baja frecuencia de invocación |
| L2 Capa principal | Conversación habitual, generación de contenido, invocación de herramientas | Capacidad integral equilibrada, invocación de herramientas estable | Modelos generales de uso común, que asumen la mayor parte del tráfico |
| L3 Capa ligera | Clasificación de intenciones, extracción de campos, resúmenes, reescritura | Rapidez, bajo precio, formato estable | Modelos ligeros o de nivel mini, con invocación de alta frecuencia |
| L4 Capa especializada | Comprensión de imágenes, generación de imágenes, voz, vectorización | Capacidad en una modalidad específica | Selección individual por función, desacoplada del flujo de texto |
Tres principios para llevar la estratificación a la práctica en el Workflow de un proyecto unipersonal
Dibujar la tabla de capas no es difícil; lo difícil es ejecutarla de verdad dentro del Workflow. Estos tres principios te ayudarán a evitar rodeos:
- Por defecto, baja de capa; sube solo después de validar. Cuando añadas un nodo nuevo, pruébalo primero con un modelo ligero de L3; si el resultado no alcanza el nivel, entonces súbelo a L2 o L1. Así evitas la costumbre de usar el modelo más caro para todo.
- Separa la planificación de la ejecución. El «pensar bien qué hacer» del Agent se lo dejas a L1, y el «hacerlo concretamente» a L2 o L3. Muchos frameworks de Agent permiten configurar modelos distintos para el planificador y el ejecutor; esta es la optimización con mejor relación coste-beneficio.
- Para salidas estructuradas, prioriza modelos con formato estable. El downstream del Workflow a menudo tiene que parsear JSON; si el modelo de vez en cuando suelta texto de más, toda la cadena falla. En este tipo de nodos, la selección debe fijarse en la estabilidad del formato, no solo en lo «listo» que sea el modelo.
Cabe advertir que las versiones de los modelos se actualizan muy rápido, por eso la tabla anterior evita deliberadamente fijar modelos concretos. Lo más prudente es elegir 2 o 3 candidatos por capa dentro de la lista de modelos de la plataforma de integración y decidir después de probarlos con tus propias muestras reales. La lista de modelos de APIYI cubre modelos de texto, razonamiento y multimodales de los principales proveedores, y permite hacer comparaciones horizontales dentro de una misma cuenta, algo ideal para pruebas de selección en proyectos unipersonales.
Flujo de trabajo para un proyecto individual: inicio rápido con acceso a múltiples modelos
Esta sección presenta los pasos de implementación en orden. Para facilitar la lectura, todos los elementos de configuración se explican mediante tablas y texto, sin desglosar código.
Paso 1: definir un protocolo de acceso unificado
Se recomienda que el lado del negocio adopte de forma unificada el formato Chat Completions compatible con OpenAI. Los principales frameworks de agentes, las herramientas de orquestación de flujos de trabajo y la mayoría de los proyectos de código abierto admiten este formato de forma predeterminada, por lo que ofrece la mejor compatibilidad con el ecosistema. Si utilizas intensivamente las características de la familia Claude, como la estructura nativa de llamada a herramientas o la caché de indicaciones, también puedes usar el formato Anthropic Messages en los nodos correspondientes. APIYI es compatible con los formatos de interfaz de OpenAI y Anthropic al mismo tiempo, y ambos protocolos pueden compartir una misma cuenta y una misma clave.
Paso 2: convertir los parámetros del modelo en configuración
No codifiques el nombre del modelo directamente en la lógica del negocio. Todos los parámetros relacionados con el modelo deben extraerse a archivos de configuración o variables de entorno. La siguiente tabla muestra los elementos de configuración que se recomienda separar:
| Elemento de configuración | Función | Práctica recomendada |
|---|---|---|
base_url |
Dirección de la interfaz | Introduce la dirección de acceso indicada en la documentación de APIYI docs.apiyi.com; en todo el proyecto solo debe existir en este lugar |
api_key |
Clave de autenticación | Colócala en una variable de entorno; usa claves distintas para desarrollo y producción |
model |
Nombre del modelo | Nómbralo por niveles, como MODEL_L1, MODEL_L2, MODEL_L3 |
fallback_model |
Modelo de respaldo | Configura al menos uno por nivel, preferiblemente de distintos proveedores |
timeout |
Tiempo de espera | Configura tiempos cortos para L3 y largos para L1, para evitar que los modelos de razonamiento se marquen por error como fuera de tiempo |
max_tokens |
Límite de salida | Configúralo por nodo para evitar que salidas anormalmente largas aumenten el costo |
Después de hacer esto, cambiar de modelo solo requiere modificar la configuración; ni la lógica del agente ni la orquestación del flujo de trabajo necesitan cambios.
Paso 3: marcar los niveles en los nodos del flujo de trabajo
Abre tu diagrama de orquestación de flujos de trabajo y marca con L1 a L4 cada nodo que invoque un modelo. Ya sea que uses una herramienta de orquestación visual o código de flujo escrito por ti mismo, puedes indicar el nivel en la descripción o en los parámetros del nodo, y luego leer el modelo correspondiente desde la configuración. Este paso se completa rápidamente, pero te permite ver de un vistazo en qué nodos se concentra principalmente el costo.
Paso 4: configurar la degradación y los reintentos
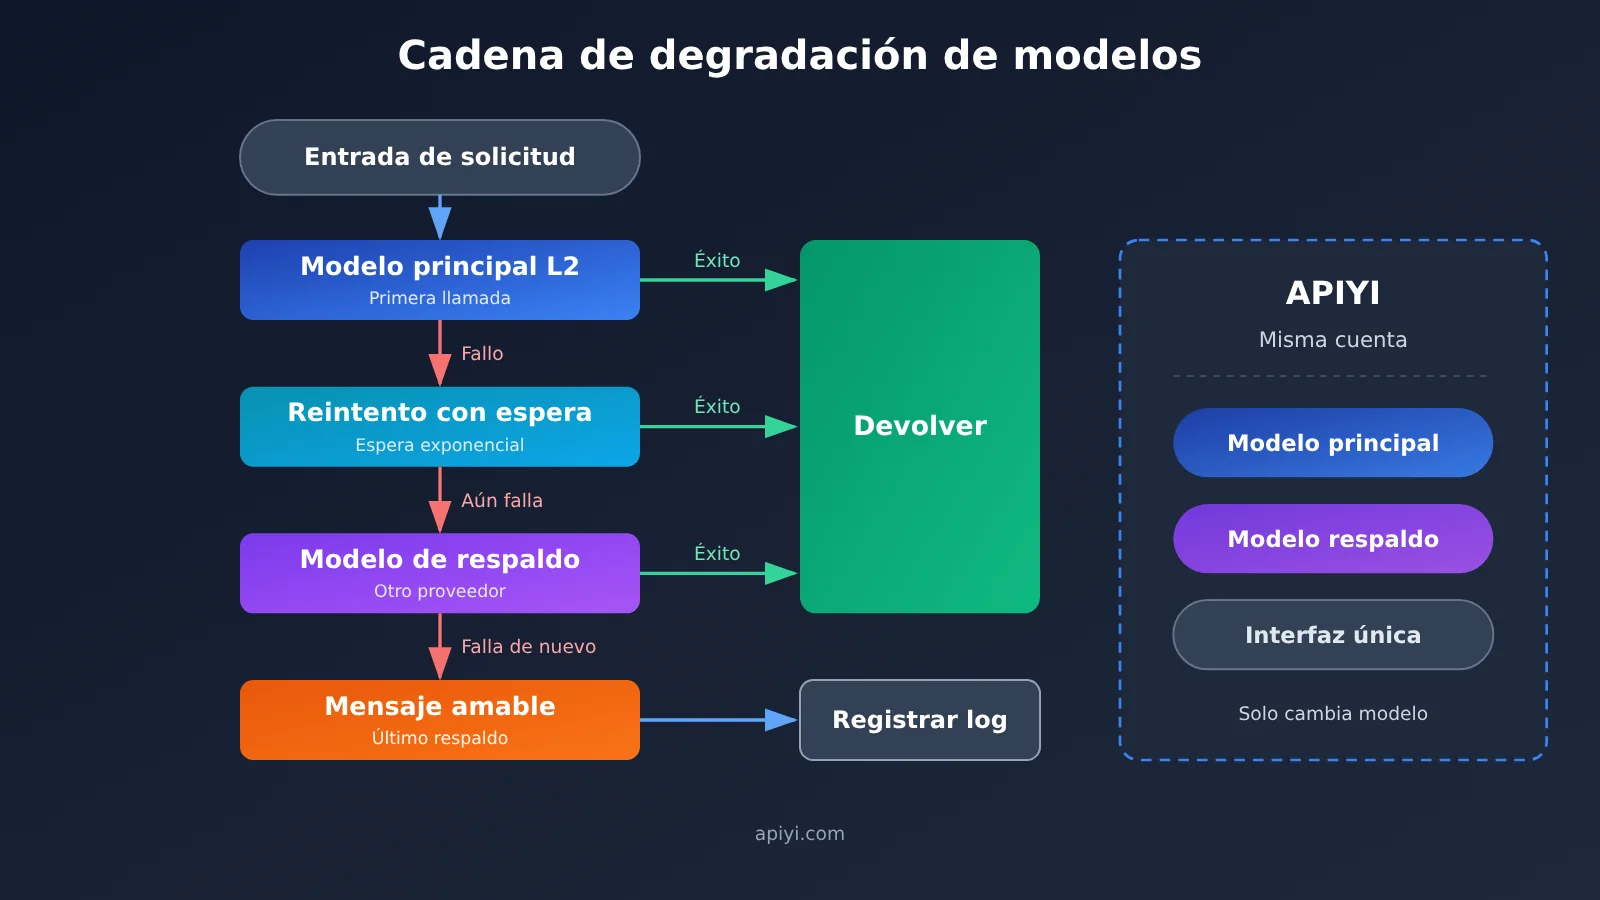
Configura en cada nivel la secuencia «modelo principal → modelo de respaldo». Cuando el modelo principal devuelva limitación de tasa, tiempo de espera agotado o un error del servidor, primero realiza uno o dos reintentos con retroceso; si sigue fallando, cambia al modelo de respaldo. En la medida de lo posible, elige como respaldo un producto del mismo nivel de otro proveedor, para así evitar fallos concentrados de un mismo servicio.
Paso 5: registrar cada invocación
Registra al menos estos elementos: hora, nombre del nodo, nivel, nombre del modelo, tokens de entrada, tokens de salida, tiempo consumido, si se activó la degradación y si finalmente tuvo éxito. Una tabla de logs sencilla o una herramienta ligera de observabilidad es suficiente; lo clave es registrar de forma constante.
🚀 Sugerencia para empezar rápido: en un proyecto individual se recomienda registrarse primero en APIYI apiyi.com y obtener cuota de prueba, y con la misma clave ejecutar una muestra real con cada uno de los modelos candidatos de L1 a L3. Después de definir la selección, escribirla en la configuración ahorra mucho más trabajo que integrar primero y luego modificar el código repetidamente.
Comparativa de soluciones de integración de múltiples modelos para agentes de IA en proyectos unipersonales
A grandes rasgos, hay cuatro enfoques para integrar múltiples modelos, y el costo de mantenimiento de cada uno varía mucho.
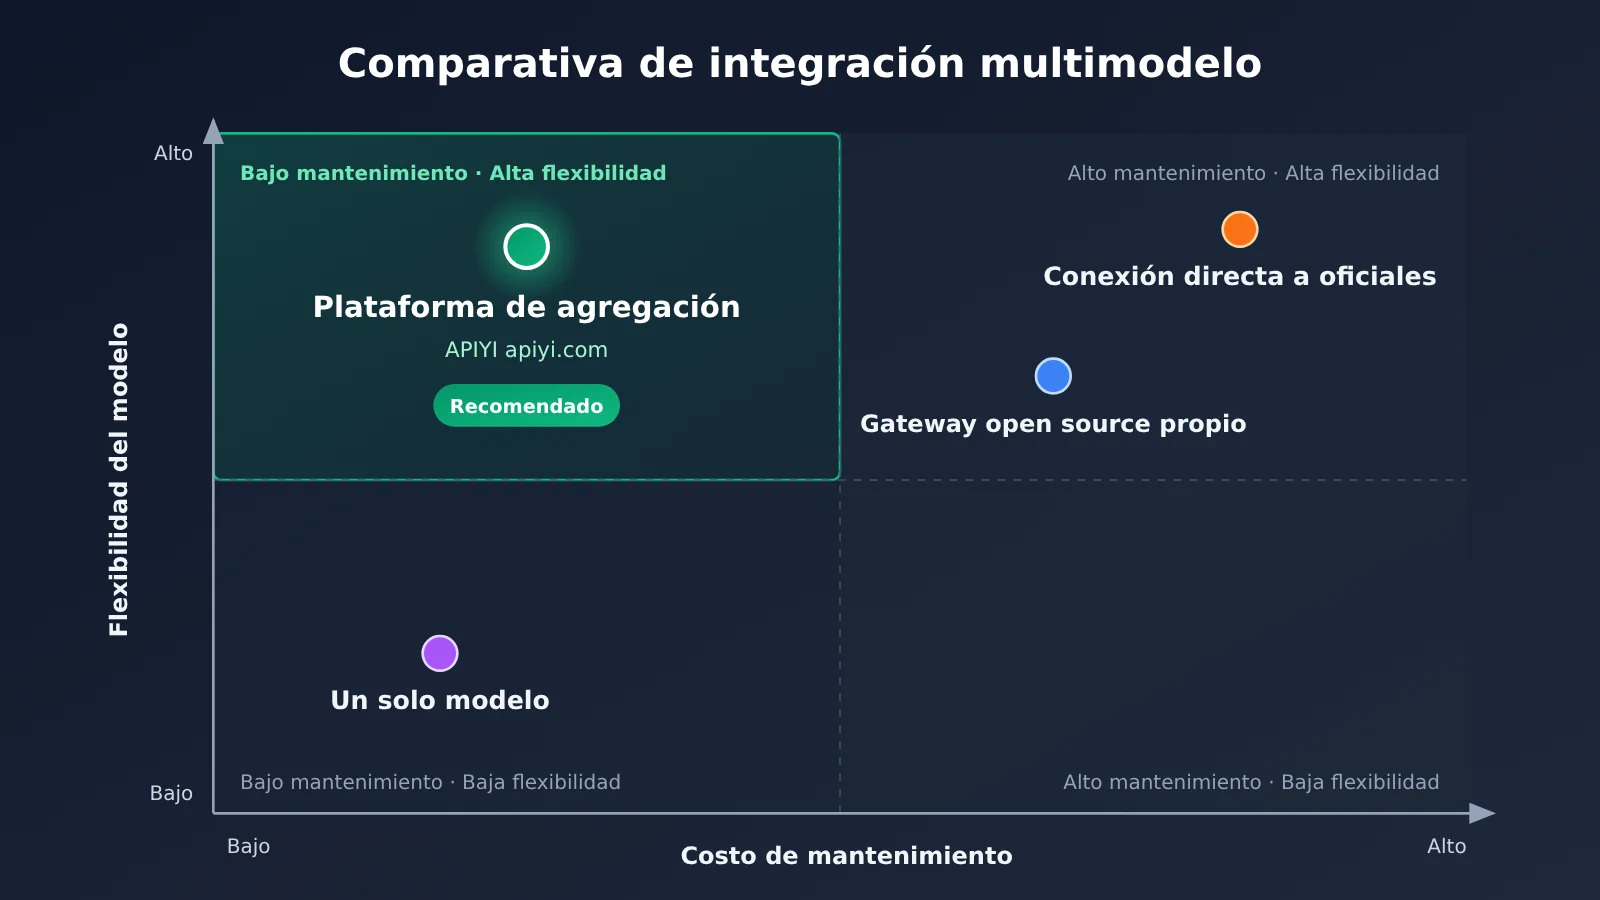
| Solución | Característica principal | Cuándo conviene | Carga de mantenimiento en proyectos unipersonales |
|---|---|---|---|
| Usar un solo modelo | Un proveedor y un modelo; lo más sencillo | Validación de prototipos y herramientas pequeñas con una sola función | Baja, pero sin mecanismos de respaldo |
| Conexión directa con varios proveedores oficiales | Integrar por separado la API oficial de cada proveedor | Dependencia profunda de las funciones de un proveedor concreto | Alta; requiere varios SDK, cuentas y facturación |
| Gateway de código abierto autoalojado | Desplegar tu propia capa de proxy unificada | Tienes experiencia en operaciones y necesitas despliegue privado | Media-alta; implica desplegar, actualizar y resolver problemas por tu cuenta |
| Plataforma de agregación | Un único endpoint para acceder a varios modelos | Necesitas varios modelos, pero no quieres mantener la capa de integración | Baja; plataformas como APIYI (apiyi.com) ofrecen una interfaz unificada |
Análisis comparativo de las soluciones de integración de múltiples modelos
Comparativa de la solución de un solo modelo: usar un único modelo es lo más eficiente al principio, ya que no exige diseñar ningún tipo de enrutamiento. Sin embargo, deja la disponibilidad y el costo completamente en manos de un solo proveedor: si ese proveedor limita las solicitudes o cambia sus precios, casi no tendrás margen de maniobra. En cambio, preparar desde el inicio una interfaz unificada y parámetros de modelo configurables casi no añade trabajo de desarrollo y te da mucho margen para ampliar más adelante.
Comparativa de la conexión directa con varios proveedores oficiales: las APIs oficiales tienen la ventaja de seguir de cerca las novedades y permiten usar de inmediato una capacidad recién publicada por algún proveedor. Pero mantener varios conjuntos de código de adaptación, varias cuentas de recarga y varias conciliaciones contables consume de forma constante la energía de una sola persona. Para la mayoría de los proyectos unipersonales, lo más realista es conectarse directamente solo en los nodos donde de verdad dependes de una característica exclusiva de un proveedor oficial, y dejar el resto en una interfaz unificada.
Comparativa del gateway autoalojado: un gateway de código abierto autoalojado ofrece el mayor control y encaja en escenarios que requieren despliegue privado. Pero el despliegue, las actualizaciones, la supervisión y la resolución de problemas corren por tu cuenta, lo que equivale a mantener un servicio adicional. Si tu objetivo principal es entregar el producto cuanto antes, una plataforma de agregación suele ser un punto de partida más seguro; cuando el negocio crezca, podrás evaluar si conviene montar tu propio gateway.
💡 Recomendación: si todavía no lo tienes claro, puedes empezar usando APIYI para poner en marcha todos los nodos y, al mismo tiempo, mantener tu lógica de negocio dependiendo solo del formato compatible con OpenAI. Así, aunque en el futuro migres a un gateway autoalojado o a la conexión directa con proveedores oficiales, los cambios se concentrarán únicamente en la capa de configuración.
Control de costos y estabilidad en un proyecto unipersonal con múltiples modelos integrados
En un proyecto de una sola persona no hay un compañero de finanzas que revise las facturas, así que el control de costos tiene que venir integrado en la arquitectura. Esta tabla resume las palancas de costo más habituales:
| Palanca de costo | Cómo aplicarla | Nota sobre el criterio de facturación |
|---|---|---|
| Degradación por niveles | Usar modelos ligeros L3 en los nodos de alta frecuencia | El precio unitario varía bastante entre modelos; consulta la página de precios de APIYI |
| Controlar la longitud de salida | Definir max_tokens para cada nodo |
En la mayoría de los modelos, el precio unitario de salida es mayor que el de entrada; consulta la página de precios |
| Aprovechar la caché | Colocar las indicaciones de sistema fijas y las definiciones de herramientas al principio de la solicitud | Que se admita caché y cómo se facture depende de cada modelo; consulta la página de precios |
| Comprimir el contexto | Resumir periódicamente las conversaciones multiturno del Agent; no acumular historial sin límite | Los tokens de entrada crecen de forma lineal con los turnos y son una parte importante del costo oculto |
| Configurar alertas de presupuesto | Contar el uso diario de tokens y avisar al superar el umbral | Contrastar con los registros de llamadas y la facturación de la plataforma |
Sobre los precios, este artículo no incluye a propósito ninguna cifra concreta. Los precios unitarios de entrada y salida, los precios de lectura y escritura de caché y los criterios de facturación cambian según la estrategia de cada proveedor; estimar de memoria o con datos antiguos es muy propenso a error. Al planificar costos, basa tus cálculos en los datos reales de la página de precios de APIYI, docs.apiyi.com/models, y estima el costo mensual con esta lógica: «llamadas diarias promedio por nivel × tokens de entrada promedio × precio unitario de entrada + tokens de salida promedio × precio unitario de salida». Deja además una columna aparte para los aciertos de caché.
En cuanto a la estabilidad, hay tres cosas que conviene dejar hechas antes de salir a producción:
- Simulacro de la cadena de degradación: cambia manualmente el nombre del modelo principal por un valor inválido y confirma que el Workflow cambia automáticamente al modelo de respaldo y termina sin problemas.
- Timeouts por niveles: los modelos de razonamiento tardan más en pensar, así que el umbral de timeout debe ser claramente superior al de los modelos ligeros; si no, pasa eso de que «cuanto más inteligente, más probable es que sufra timeout».
- Diseño idempotente: las llamadas a herramientas con efectos secundarios, como enviar correos o escribir en la base de datos, deben evitar ejecutarse dos veces cuando hay un reintento.
Preguntas frecuentes
Q1: ¿Qué es la planificación de integración de múltiples modelos en un proyecto unipersonal?
Se trata de decidir de antemano, en un contexto de desarrollo independiente, qué tipo de modelo se usará en cada parte de un Agent de IA y de un Workflow, a través de qué interfaz se accederá, cómo se degradará el servicio si hay errores y cómo se contabilizarán los costos. El objetivo es obtener a la vez ventajas de costo y garantías de disponibilidad sin aumentar demasiado la carga de mantenimiento.
Q2: ¿Qué diferencia hay entre un Agent de IA y un Workflow en cuanto a la integración de modelos?
Los pasos de un Workflow están predefinidos, por lo que el modelo de cada nodo se puede especificar de forma estática y la división por capas resulta bastante intuitiva. Un Agent decide por sí mismo el orden y el número de llamadas, y el volumen de invocaciones es difícil de estimar; por eso necesita aún más una separación entre modelos de planificación y de ejecución, además de límites máximos de turnos y un presupuesto de tokens por tarea.
Q3: ¿Hay que integrar varios modelos desde el principio?
No es necesario empezar con muchos proveedores, pero el diseño de la interfaz debe quedar unificado desde el primer momento. Conviene que, ya en la primera versión, el nombre del modelo sea configurable, que se use el formato compatible con OpenAI y que se reserve un modelo de respaldo para los nodos principales. Así el trabajo adicional de desarrollo es mínimo y las futuras ampliaciones serán mucho más sencillas.
Q4: ¿En qué escenarios de proyectos unipersonales encaja mejor la integración de múltiples modelos?
– **Herramientas de escritura con IA o de contenido**: esquema con L1, texto principal con L2 y reescritura de títulos con L3.
– **Agent de atención al cliente inteligente**: reconocimiento de intención con L3 y escalado de consultas complejas a L2 o L1.
– **Workflow de procesamiento de datos**: extracción y clasificación por lotes con L3, y revisión de muestras anómalas con L2.
– **Herramientas de asistencia a la programación**: planificación de código con L1, y autocompletado y comentarios con L2 o L3.
Q5: ¿Cómo llamar rápidamente a varios modelos mediante una interfaz unificada?
Puedes usar APIYI, compatible con los formatos de interfaz de OpenAI y Anthropic:
1. Entra en APIYI (apiyi.com), registra una cuenta y obtén la clave API.
2. Configura `base_url` y la clave siguiendo la documentación de APIYI en docs.apiyi.com.
3. Cambia el parámetro `model` para alternar entre modelos de distintos proveedores sin modificar el código de negocio.
Los modelos de razonamiento, de uso general, ligeros y multimodales que aparecen en este artículo se pueden invocar y comparar a través de la interfaz unificada de APIYI.
Q6: ¿Cómo estimar el costo mensual de una solución con múltiples modelos?
Primero, revisa en los registros de llamadas el número medio de invocaciones diarias y la cantidad media de tokens de cada capa. Después, calcula con los precios unitarios de entrada, salida y caché de cada modelo que aparecen en la página de precios de APIYI, docs.apiyi.com/models. No reutilices precios de artículos antiguos ni de memoria: toma como referencia los datos reales de la página de precios y revísalos una vez al mes.
Q7: ¿Qué limitaciones conocidas tiene una solución con múltiples modelos?
Cada modelo responde con un estilo distinto a una misma indicación, así que al cambiar a un modelo de respaldo pueden aparecer pequeñas diferencias en el formato de salida y las rutinas de análisis posteriores deben tolerarlas. Algunas funciones exclusivas de ciertos proveedores pueden no estar totalmente disponibles en los formatos compatibles. Además, cuantos más modelos haya, mayor será la carga de evaluación; se recomienda limitar los modelos candidatos a dos o tres por capa.
Puntos clave para integrar varios modelos en un AI Agent de un proyecto unipersonal
- Primero define capas, luego elige modelos: divide de L1 a L4 según la dificultad y la frecuencia de las tareas, no según el nombre del modelo.
- La interfaz debe ser única: el lado del negocio depende de un solo protocolo y el nombre del modelo es un elemento de configuración que se puede sustituir.
- Separa la planificación de la ejecución: deja la planificación del Agent en manos de un modelo potente y la ejecución en el modelo principal o en uno ligero.
- El fallback se ensaya: los modelos principal y de respaldo deben venir de proveedores distintos; antes de salir a producción, simula fallos a mano para verificarlo.
- El precio manda: la página de precios: contrasta todos los precios unitarios y el cobro de caché con docs.apiyi.com/models.
- Los logs son la base de las decisiones: registra el modelo, los tokens, el tiempo de respuesta y los casos de fallback; decide cambiar de modelo con datos.
- Para arrancar, una plataforma agregadora: APIYI es compatible con los formatos de OpenAI y Anthropic; con una sola clave API puedes probar varios modelos.
Resumen
Cuando montas un AI Agent y un Workflow en un proyecto unipersonal, la planificación de la integración multimodelo se reduce a tres ideas:
- Estratificar las tareas: que cada etapa use el modelo que justo necesita, con costo y calidad bajo control al mismo tiempo.
- Interfaz unificada + configuración: el modelo pasa a ser un parámetro reemplazable y el mantenimiento se mantiene dentro de lo que una sola persona puede asumir.
- Fallback y observabilidad: si hay un respaldo para la disponibilidad y datos para decidir, el proyecto puede iterar de forma estable a largo plazo.
Te sugiero empezar poniendo en marcha todos los nodos con una interfaz unificada y, después, optimizar la selección de modelos capa por capa según los datos de los logs. Si no quieres mantener tú mismo la capa de acceso, puedes llamar a los principales modelos de forma unificada a través de APIYI (apiyi.com); la interfaz es compatible con los formatos de OpenAI y Anthropic. Las instrucciones de integración están en la documentación de APIYI, docs.apiyi.com, y los precios de los modelos y los criterios de facturación se rigen por la página de precios docs.apiyi.com/models.
📚 Referencias
- Centro de documentación de APIYI: especificaciones de la dirección de acceso, el método de autenticación y el formato de la interfaz
- Enlace:
docs.apiyi.com -
Descripción: consúltelo al configurar
base_url, la clave, o al cambiar entre el formato de OpenAI y el de Anthropic -
Página de modelos y precios de APIYI: lista de modelos, precio unitario de entrada y salida, y facturación de caché
- Enlace:
docs.apiyi.com/models -
Descripción: todos los datos de costos de este artículo se basan en los datos reales de esta página
-
Documentación de la API de OpenAI: referencia del formato de la interfaz Chat Completions
- Enlace:
platform.openai.com/docs -
Descripción: para conocer los parámetros y la estructura de llamada a herramientas del formato compatible con OpenAI
-
Documentación oficial de Anthropic: interfaz Messages y descripción de la caché de indicaciones
- Enlace:
docs.anthropic.com - Descripción: consúltela cuando use el formato de Anthropic en el nodo de Claude
Autor: Equipo técnico de APIYI
Intercambio técnico: puede contactarnos desde la página principal del sitio web de APIYI; además, hay más material de integración disponible en el centro de documentación docs.apiyi.com