Este artículo usa casos de migración, atención al cliente y código con GPT-6.1 Sol y GPT-6.2 Sol para mostrar cómo fijar primero las condiciones de aceptación del negocio, elegir después el nivel de razonamiento que las cumple de forma estable y calcular el coste de cada tarea que cumple los criterios.
Primero, la conclusión: al cambiar de nivel, lo que hay que comparar es «cuánto cuesta y cuánto tarda cada tarea que cumple los criterios»; el precio de lista por invocación es solo uno de los factores. En las mediciones publicadas con muestras pequeñas, low de GPT-6.2 Sol alcanzó el mismo número de aprobados que medium tanto en preguntas sobre políticas de atención al cliente como en un conjunto de problemas de código, y además tardó menos. En los problemas de código, el coste calculado a partir del precio de lista de low es aproximadamente el 70% del de medium. Esta conclusión solo se sostiene bajo dos condiciones: que tus tareas se parezcan lo suficiente a las tareas de prueba y que el umbral de aceptación no se limite a la tasa de aprobación, sino que también revise enlaces inventados, campos de importe y reprocesos. Las tareas con conflictos entre documentos, dependencias complejas de herramientas o que tienden a omitir restricciones deben validarse igualmente por separado en medium o en niveles superiores.
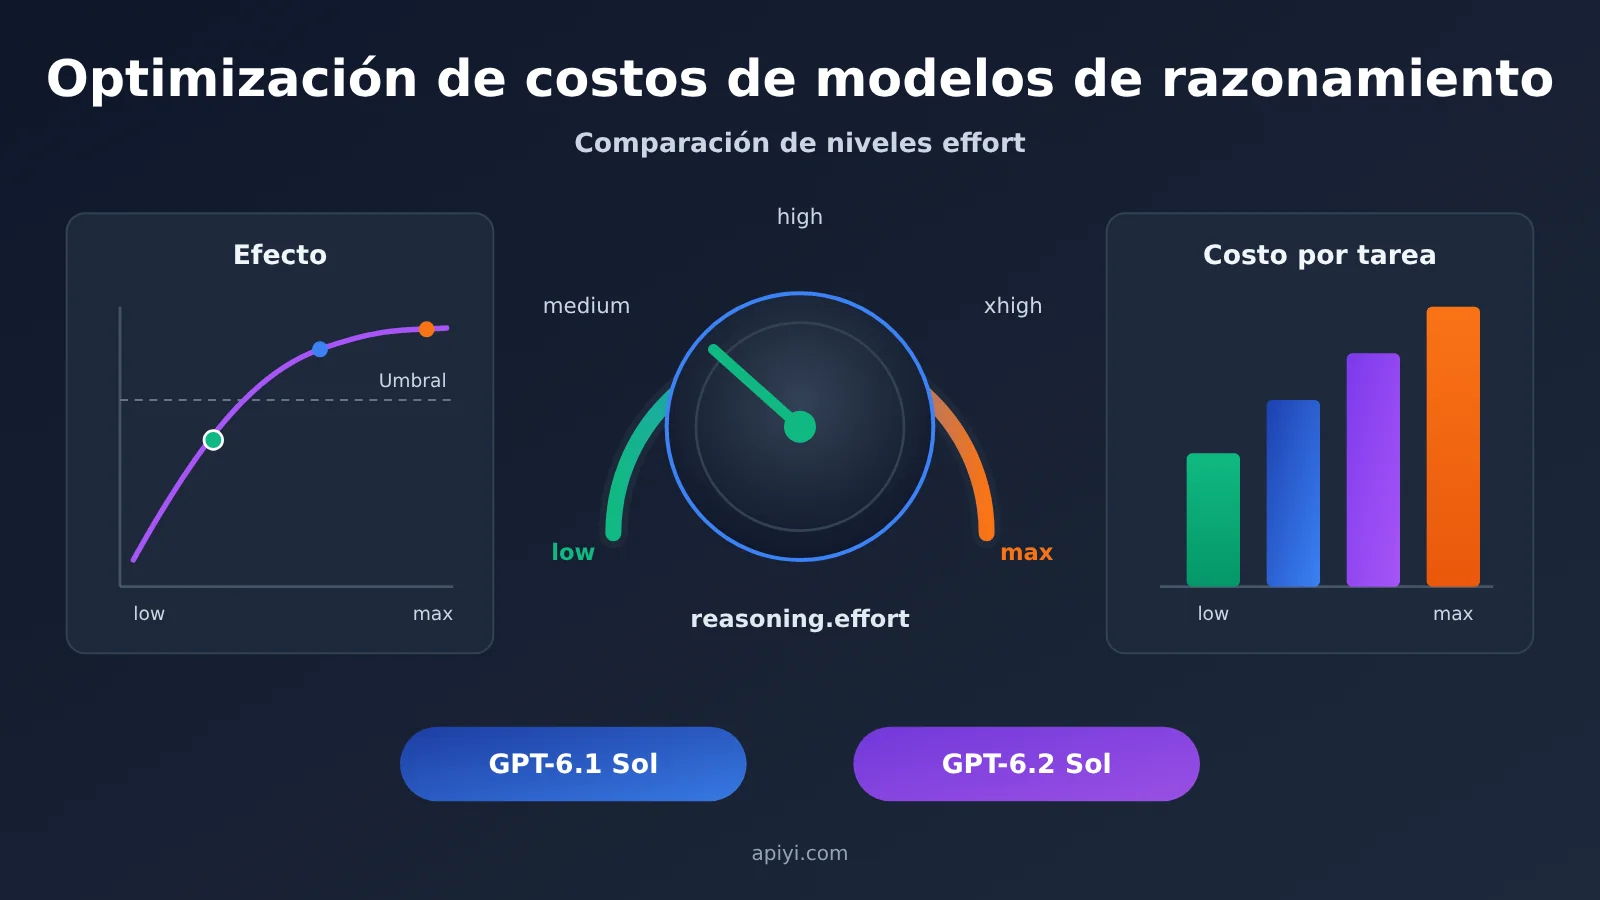
Comparación rápida de los niveles de esfuerzo (effort) en modelos de razonamiento
La siguiente tabla reúne varios conjuntos de evidencia que usaremos en este artículo; cada fila indica la fuente y el criterio de medición. Los números de fuentes distintas no deben sumarse ni mezclarse directamente.
| Dimensión de comparación | GPT-6.1 Sol | GPT-6.2 Sol | Qué implica la diferencia |
|---|---|---|---|
| Niveles disponibles (documentación de OpenAI) | low, medium, high, xhigh, max | Los mismos cinco niveles; rechaza none |
Al migrar desde modelos que permiten none/minimal, hay que ajustar el nivel de partida |
| Precio de lista de APIYI para contexto corto (tabla general del 2026-11-20, USD/millón de tokens) | Entrada $2, lectura de caché $0.10, salida $10 | Igual | En contexto corto, el precio de ambas generaciones coincide; la diferencia de costo viene principalmente del uso |
| Precio de entrada al superar 272,000 tokens de entrada | Tanto APIYI como OpenAI Standard indican $4 | APIYI indica $3; OpenAI Standard indica $4 | En escenarios de entrada larga, aparecen diferencias de precio entre canales |
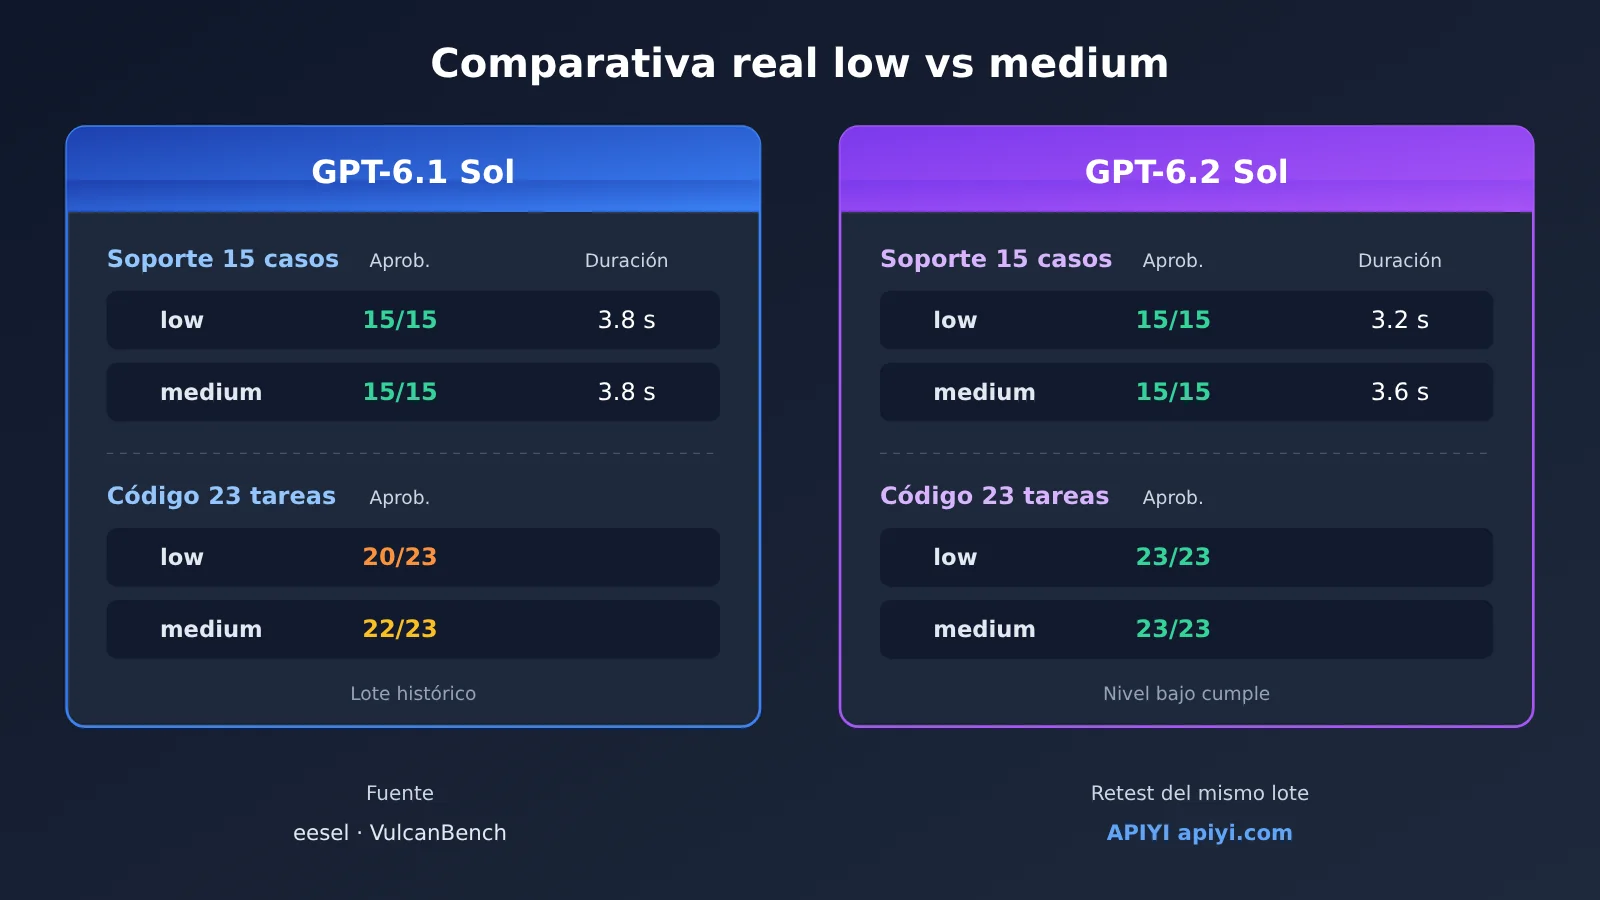
| 15 tickets de atención al cliente de eesel (low / medium) | 15/15, 3.8 s; 15/15, 3.8 s | 15/15, 3.2 s; 15/15, 3.6 s | La tasa de aprobación es la misma; la diferencia de costo entre niveles es muy pequeña |
| 23 problemas de código de VulcanBench (low / medium) | 20/23; 22/23 (lote histórico) | 23/23; 23/23 | El nivel low de 6.2 Sol ya alcanza el estándar; los números entre versiones provienen de lotes diferentes |
| Artificial Analysis Index (citado por OrcaRouter, low / medium) | 35; 46 | 41; 53 | Índice integral de terceros; las etiquetas de nivel las mapea la propia evaluación |
El contenido se desarrolla en el siguiente orden: la sección 1 confirma si se puede integrar y cómo se factura; la sección 2 muestra los resultados medidos en las mismas tareas; la sección 3 presenta los pasos de migración y validación; la sección 4 aborda el problema de cambiar de nivel a mitad de una conversación de varios turnos. Si ya confirmaste el enrutamiento del modelo y el precio, puedes empezar directamente por la sección 2.
Términos que conviene conocer sobre los niveles de effort de razonamiento
| Término | Explicación |
|---|---|
reasoning.effort |
Campo de la API Responses que establece la intensidad de razonamiento del modelo |
| Tokens de razonamiento | Consumo de razonamiento que el modelo utiliza para llegar a una respuesta. Está incluido en los output_tokens facturados y debe distinguirse de la salida visible para el usuario |
low / medium |
Dos niveles de razonamiento. Al cambiar a una versión nueva dentro del mismo nivel, aún hay que volver a validarlo |
| Precio unitario de lectura de caché | Solo se aplica a la parte de la entrada que coincide con un prefijo reutilizable; no puede calcularse directamente a partir del número total de tokens |
| Prefijo de la solicitud | Contexto que ya existía antes del mensaje actual. Modificar el historial inicial afecta la reutilización de la caché y de los elementos de razonamiento |
configuration_update |
Elemento de entrada que se usa para ajustar la configuración posterior en sesiones de Responses compatibles con esta función |
| Umbral de aceptación | Estándar mínimo aceptable definido para la corrección de políticas, la aprobación de funcionalidades o el nivel de retrabajo |
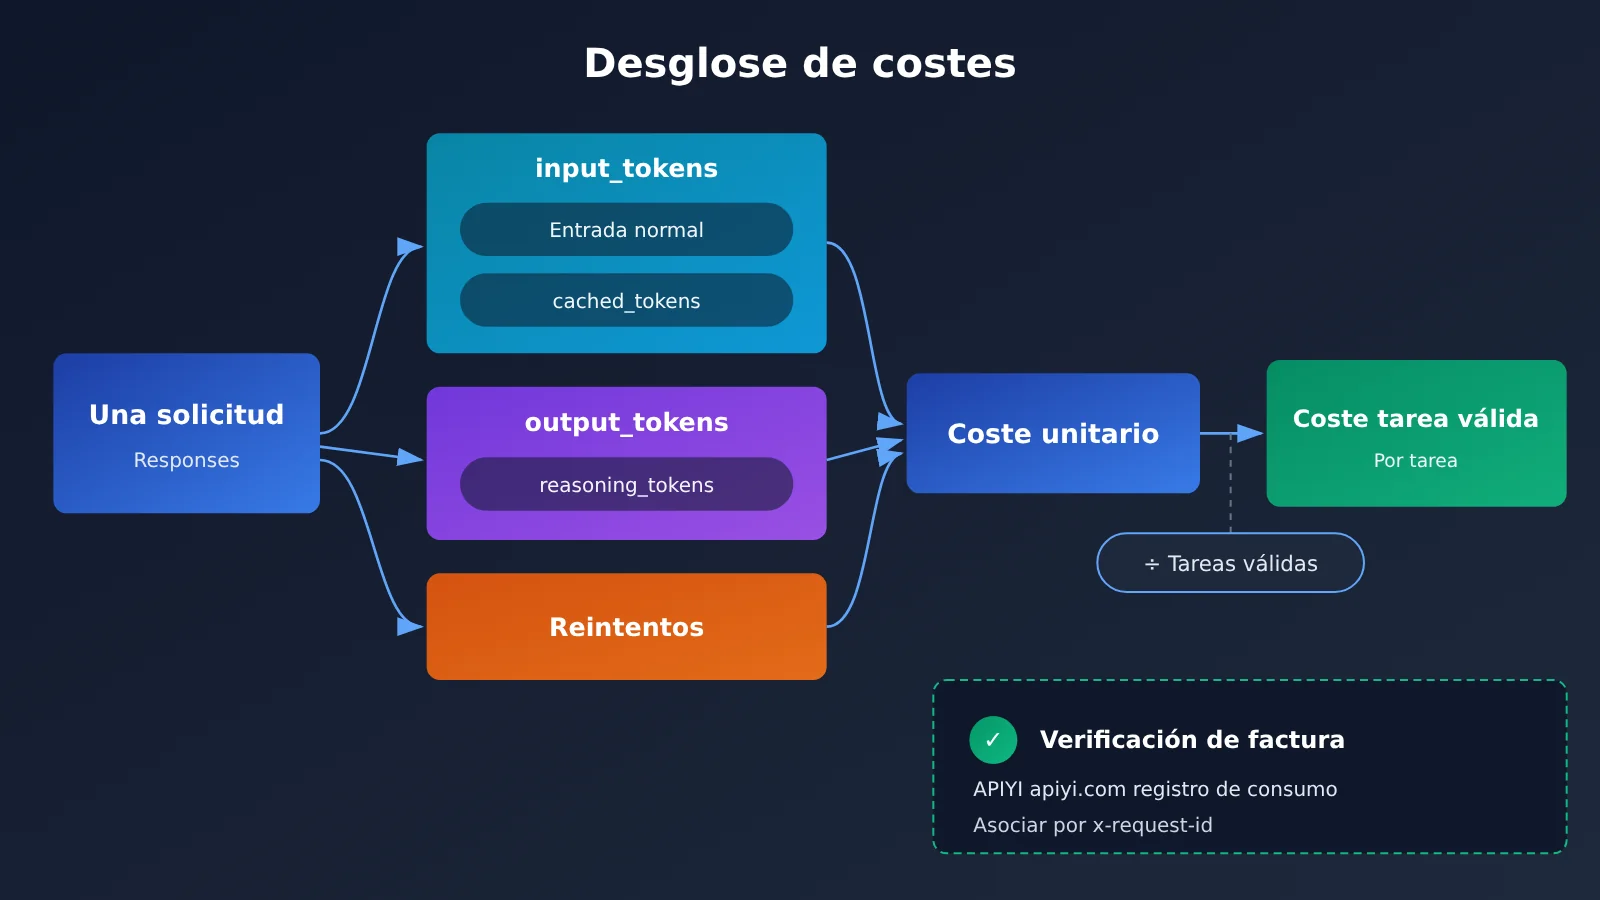
| Costo por tarea que cumple los criterios | Costo de llamadas, reintentos, herramientas y retrabajo manual de todo el experimento, dividido por el número de tareas que cumplen los criterios |
1. Antes de optimizar el costo de los modelos de razonamiento: cuándo vale la pena ajustar el nivel de effort
1.1 Situación de acceso de las dos generaciones de Sol en APIYI
Según las novedades de la plataforma APIYI, GPT-6.1 Sol se lanzó el 2026-09-30, y el 2026-11-18 se anunció el lanzamiento de GPT-6.2 Astra y Sol. La tabla maestra de precios del 2026-11-20 muestra que ambas versiones de Sol oferecen simultáneamente las rutas responses y chat; los grupos implicados son CodexResponses, Codex_Reverse, Default y SVIP. Las capacidades que una cuenta puede invocar realmente dependen del grupo al que pertenece su token.
Según la documentación de OpenAI, las dos generaciones de Sol admiten Chat Completions y Responses, pero las llamadas a herramientas deben usar Responses, y el nivel se configura mediante reasoning.effort. Por eso, siempre que el negocio incluya pasos con herramientas como consultas de pedidos o ejecución de código, tanto las evaluaciones como el despliegue en producción deben usar de forma uniforme la ruta Responses, para evitar que las diferencias de comportamiento entre ambas rutas contaminen los resultados de la comparación.
1.2 Dos criterios de precios: precio de lista de APIYI y precio estándar del proveedor upstream
| ID del modelo (tabla general de APIYI, 2026-11-20) | Entrada normal | Lectura de caché | Salida | Plataformas disponibles |
|---|---|---|---|---|
gpt-6.2-sol |
$2 | $0.10 | $10 | APIYI apiyi.com, OpenAI oficial |
gpt-6.1-sol |
$2 | $0.10 | $10 | APIYI apiyi.com, OpenAI oficial |
gpt-6-sol |
$2 | $0.20 | $10 | APIYI |
gpt-6.2-astra |
$8 | $0.40 | $40 | APIYI |
La tabla anterior recoge el precio de lista predeterminado para contexto corto, en dólares por millón de tokens. La tarjeta de precios upstream recopilada por OrcaRouter muestra los mismos precios de entrada, lectura de caché y salida para las dos generaciones de Sol, y además indica un precio de escritura de caché de $2.50. El contexto largo debe verificarse por separado: cuando la entrada de gpt-6.2-sol supera los 272,000 tokens, APIYI indica actualmente $3, mientras que OpenAI oficial Standard indica $4; en gpt-6.1-sol, ambas partes indican $4. Para los precios de caché y salida en el nivel de contexto largo, hay que remitirse a las reglas de facturación en tiempo real de cada canal.
1.3 Los costos se deben leer de las respuestas reales y de la facturación
El precio de lista solo sirve para estimar. A continuación usamos un conjunto de ejemplos hipotéticos para explicar cómo se desglosa el costo. Supongamos que cada ronda tiene 12,000 Tokens de entrada, sin escritura de caché ni cargos por herramientas:
- Prefijo conservado: lectura de caché 9,000, salida total 1,000, estimación aproximada de $0.0169.
- Prefijo modificado: la lectura de caché baja a 3,000, la salida total sube a 1,600, estimación aproximada de $0.0343.
De la diferencia entre ambos, aproximadamente $0.0114 proviene de 6,000 Tokens de entrada que pasan de precio de caché a precio normal, y aproximadamente $0.0060 proviene de los 600 Tokens de salida adicionales. Estos son datos hipotéticos; la diferencia real se rige por usage. Si existe una línea separada para escritura de caché, se deben calcular como tres categorías mutuamente excluyentes: entrada normal, lectura de caché y escritura de caché.
Método para verificar el cargo real: use el x-request-id del encabezado de respuesta para correlacionar con el registro type=2 en el registro de consumo de APIYI, convierta a dólares el valor realmente cobrado usando quota ÷ 500,000, y registre al mismo tiempo el modelo, el grupo de tokens, la ventana de tiempo de invocación, el uso de entrada y salida, y el número de reintentos.
A continuación, un ejemplo de invocación mínimo, que además lee los campos de uso necesarios para el diagnóstico:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "low"},
    input=[{"role": "user", "content": "根据退款政策判断工单 #1024 是否可退"}],
)

u = resp.usage
print(resp.output_text)
print("输入:", u.input_tokens, "缓存命中:", u.input_tokens_details.cached_tokens)
print("总输出:", u.output_tokens, "其中推理:", u.output_tokens_details.reasoning_tokens)
🚀 Inicio rápido: se recomienda ejecutar primero el ejemplo anterior en APIYI apiyi.com usando el crédito gratuito para nuevos usuarios, confirmar que el grupo objetivo devuelve correctamente
cached_tokensyreasoning_tokens, y luego comenzar la evaluación por lotes.
2. Comparación en la misma tarea: resultados medidos de los niveles low y medium
2.1 Tickets de atención al cliente: el nivel low aporta pocos beneficios
Los evaluadores de eesel probaron el 2026-11-18, mediante la Responses API, los niveles low y medium en las dos generaciones de Sol, con 60 invocaciones en total. Cada configuración cubrió los mismos 15 tickets, que incluían reembolsos, consultas de logística y fallos de herramientas de pedidos; una persona los puntuó según una política ficticia de SaaS.
| Configuración (eesel, 15 tickets) | Aprobados | Tiempo medio | Precio de lista por cada 1000 tickets |
|---|---|---|---|
| GPT-6.1 Sol low | 15/15 | 3,8 s | $1,32 |
| GPT-6.1 Sol medium | 15/15 | 3,8 s | $1,35 |
| GPT-6.2 Sol low | 15/15 | 3,2 s | $1,41 |
| GPT-6.2 Sol medium | 15/15 | 3,6 s | $1,42 |
En estos datos, low y medium solo se diferencian en unos centavos por cada mil tickets, y la elección de nivel se basa más en la latencia que en el coste. Además, al calcularlo con el uso medido, GPT-6.2 Sol sale algo más caro que 6.1 Sol en este conjunto de preguntas de atención al cliente. Lo más importante: aunque las cuatro configuraciones tienen una tasa de aprobación perfecta, el autor también descubrió que 6.2 Sol produce enlaces de logística que no existen en la respuesta de la herramienta. Esto muestra que, si la validación de atención al cliente solo comprueba si “responde correctamente a la política”, se perderán este tipo de problemas; hay que revisar por separado la procedencia de los enlaces y los campos. Estas evidencias solo son aplicables a este conjunto de tickets, este criterio de puntuación y este entorno de pruebas de OpenAI.
2.2 Tareas de código: el costo por pregunta del nivel bajo merece medirse en la práctica
VulcanBench ejecutó GPT-6.2 Sol con Codex el 2026-11-19, nivel por nivel, sobre el mismo conjunto de 23 preguntas, con un total de 115 ejecuciones. Los importes de la tabla siguiente se calcularon a partir de los recibos de ejecución según el precio de lista de la API; no corresponden a la liquidación real de una cuenta de APIYI.
| Configuración (VulcanBench, 23 preguntas) | Aprobadas | Tiempo medio | Equivalente de precio de lista/pregunta | Puntuación global |
|---|---|---|---|---|
| GPT-6.2 Sol low | 23/23 | 2.8 minutos | $0.23 | 88.44 |
| GPT-6.2 Sol medium | 23/23 | 4.4 minutos | $0.33 | 88.94 |
| GPT-6.2 Sol max | — | 11.3 minutos | $0.55 | 88.74 |
| GPT-6.1 Sol low (lote histórico) | 20/23 | 6.9 minutos | $0.31 | — |
| GPT-6.1 Sol medium (lote histórico) | 22/23 | 10.6 minutos | $0.40 | — |
Si nos fijamos solo en el grupo GPT-6.2 Sol: low y medium tienen el mismo número de aprobadas, el costo por pregunta es aproximadamente un 30 % menor y también tardan menos; la puntuación global de max no supera a la de medium. La comparación entre versiones requiere cautela: los datos de 6.1 Sol provienen de una evaluación histórica sobre el mismo conjunto de preguntas y pertenecen a un lote de pruebas diferente. La puntuación global es una calificación de calidad del código, y la tasa de aprobación de pruebas son dos métricas distintas que no pueden sustituirse entre sí.
El Artificial Analysis Index v5.0.1 citado por OrcaRouter (consultado el 2026-11-20) ofrece otra perspectiva: en el nivel low, 6.2 Sol obtiene 41 puntos y $0.18 por tarea, mientras que 6.1 Sol obtiene 35 puntos y $0.16; en el nivel medium, son 53 puntos y $0.41 frente a 46 puntos y $0.36, respectivamente. Las etiquetas de nivel de esta clasificación global corresponden al mapeo propio del evaluador; puede que el framework que uses no adopte el mismo mapeo.
💡 Recomendación de elección: las dos mediciones anteriores muestran que el umbral de aprobación, la tasa de reintentos y el retrabajo manual pueden cambiar el «nivel más rentable», pero ninguno de esos factores es la factura de tu propio negocio. Te sugiero volver a probar en APIYI apiyi.com con el mismo grupo y el mismo lote de muestras, y decidir después.
3. Optimización de costos de modelos de razonamiento: orden de migración y criterios de aceptación
3.1 Primero conserva la línea base, luego ajusta el nivel
Según la recomendación de OpenAI en «Using GPT-6.2», al migrar cambia solo una variable a la vez:
- Si usas 6.1 Sol
low: primero cambia a 6.2 Sollowcomo referencia y después pruebamediumpor separado. - Si usas 6.1 Sol
medium: primero cambia el modelo pero manténmedium; cuando pase la aceptación, comparalowcon el mismo lote de tareas. - Integración nueva: empieza con
medium. - Si migras desde un modelo que permite
noneominimal: empieza probando GPT-6.2 Sol conlow.
Para tareas simples con restricciones claras, puedes empezar validando con low; para tareas compuestas, ve subiendo de nivel según los resultados. Durante la evaluación, mantén fijas las indicaciones, las definiciones de herramientas, la agrupación y las muestras de prueba. Además, según la documentación oficial, elimina los parámetros que ya no aplican; por ejemplo, en las solicitudes de Responses quita temperature, top_p y top_logprobs.
3.2 Define los criterios de aceptación por escenario
| Escenario | Criterio de aceptación | Cuándo considerar subir de nivel |
|---|---|---|
| Atención al cliente habitual | Coherencia con las políticas, campos de importe correctos, condiciones que disparan el escalado a una persona; los enlaces y números de pedido deben venir de lo que devuelve la herramienta | Cuando haya conflictos entre políticas o encadenamiento de varias herramientas |
| Modificación de código | Pruebas aprobadas, funcionalidad clave completa, volumen de retrabajo en la revisión de código | Cuando la tasa de aprobación en el nivel bajo disminuye o el retrabajo aumenta de forma evidente |
| Contenido corto | Cumplimiento de restricciones, campos factuales, tiempo de edición manual | Cuando aparezcan restricciones omitidas o errores factuales |
El costo de cada tarea que cumple los criterios se calcula así: suma los costos de las llamadas, los reintentos, las herramientas y el retrabajo manual, y luego divide entre el número de tareas que cumplen los criterios. Basta que low alcance los criterios acordados para elegir low; si low necesita varios reintentos o intervención manual, ese ahorro sobre el papel puede quedar anulado.
💰 Optimización de costos: Al hacer la comparación de niveles, puedes crear tokens independientes para la evaluación en APIYI apiyi.com; así los registros se filtran directamente por token y modelo, lo que facilita calcular el gasto real de todo el lote de pruebas.
4. Ajustar el nivel de effort a mitad de una conversación de múltiples turnos
4.1 Ajustar el nivel con configuration_update y conservar el prefijo
En las sesiones de un solo agente de OpenAI HTTP Responses que admiten esta función, mantén el valor inicial de reasoning.effort a nivel de solicitud y coloca el siguiente elemento antes del próximo mensaje del usuario:
{"type": "configuration_update", "reasoning": {"effort": "medium"}}
Esta configuración se mantiene activa hasta la siguiente actualización. La ventaja de hacerlo así es que no hace falta reescribir el historial anterior y el prefijo de la solicitud se mantiene intacto. Según la documentación de OpenAI, a partir de GPT-6.2, editar el historial anterior puede provocar un prefix_mismatch, lo que hace que se eliminen los elementos de razonamiento existentes; cambiar de familia de modelos o pasar a un modelo de menor capacidad también puede eliminar elementos de razonamiento. El coste de reescribir el prefijo tiene dos partes: las lecturas de caché pueden disminuir y, tras perder elementos de razonamiento disponibles, también pueden generarse nuevos resultados de razonamiento. Según las indicaciones oficiales, eliminar un elemento completo y dejar el resto sin cambios, o añadir nuevos elementos después de los de razonamiento, no dispara esta eliminación, pero el volumen de aciertos de caché aún puede variar. Además, en GPT-6.2 las instructions de nivel superior se añaden después de input y se facturan como entrada no cacheada.
4.2 Consideraciones sobre la compresión de contexto y el enrutamiento de APIYI
Cuando usas context_management del lado del servidor, la configuración actualizada puede mantenerse. Si entregas directamente el historial que contiene un configuration_update antiguo al endpoint independiente /responses/compact, la solicitud será rechazada; lo correcto, según las indicaciones oficiales, es separar primero el elemento de configuración y, una vez terminada la compresión, añadir la configuración más reciente.
En APIYI, por ahora lo más prudente es gestionar tú mismo el historial de input, sin depender de previous_response_id. El motivo es que la guía de llamadas nativas de APIYI es inconsistente en este punto: el texto principal dice que la continuación encadenada no funciona, mientras que la FAQ registra que el 2026-09-02 se comprobó en pruebas que sí funcionaba. Además, la documentación de APIYI tampoco enumera actualmente los resultados de verificación de configuration_update en cada grupo. Por eso, este tipo de configuración específica, el reenvío de elementos de razonamiento cifrados y los campos de diagnóstico de caché deberían validarse primero por separado en el canal de destino con sesiones cortas, y solo integrarse en el flujo de trabajo oficial una vez confirmado que funcionan.
🎯 Recomendación técnica: puedes empezar ejecutando un conjunto de sesiones cortas de dos turnos en la ruta Responses de APIYI apiyi.com, comparando
cached_tokens,reasoning_tokensy el tiempo de ejecución entre las dos muestras, «solo añadir» y «reescribir el prefijo», y luego decidir cómo implementar el cambio de nivel a mitad de conversación una vez confirmado el comportamiento.
Una última frase: la base para elegir el nivel debería ser el coste por tarea que cumple los criterios bajo un umbral de aceptación fijo. Hacer una ronda comparativa en APIYI apiyi.com con tus propias muestras y tu propia factura dice más que cualquier ranking.
Referencias
- OpenAI, «Using GPT-6.2»: recomendaciones de migración y niveles de esfuerzo iniciales
- Enlace:
developers.openai.com/api/docs/guides/latest-model
- Enlace:
- OpenAI, «Reasoning models»:
configuration_updatey reutilización de elementos de razonamiento- Enlace:
developers.openai.com/api/docs/guides/reasoning
- Enlace:
- OpenAI, «Compaction»: reglas de compactación de contexto
- Enlace:
developers.openai.com/api/docs/guides/compaction
- Enlace:
- OpenAI, «Keep the prefix unchanged»: diagnóstico de prefijos y caché
- Enlace:
developers.openai.com/api/docs/guides/keep-prefix-unchanged
- Enlace:
- eesel AI, «GPT-6.2 Sol: what’s new, pricing, benchmarks»: pruebas reales con tickets de atención al cliente, 18-11-2026
- Enlace:
eesel.ai/blog/gpt-6-2-sol
- Enlace:
- VulcanBench, «GPT-6.2 Sol across effort levels»: evaluación de problemas de código por nivel de esfuerzo, 19-11-2026
- Enlace:
vulcanbench.com/benchmarks/swe-v4-gpt62-sol-v331.html
- Enlace:
- OrcaRouter, «GPT-6.2 vs GPT-6.1 Sol»: tarjetas de precios y citas de índices agregados, 20-11-2026
- Enlace:
orcarouter.ai/blog/gpt-6-2-vs-gpt-6-1-sol
- Enlace:
- APIYI, «Tabla maestra de precios de modelos»: datos actualizados el 20-11-2026
- Enlace:
docs.apiyi.com/models
- Enlace:
Autor: Equipo técnico de APIYI
Contacto técnico: Puedes contactarnos desde la página principal de APIYI en apiyi.com; para más detalles de integración, consulta el centro de documentación en docs.apiyi.com