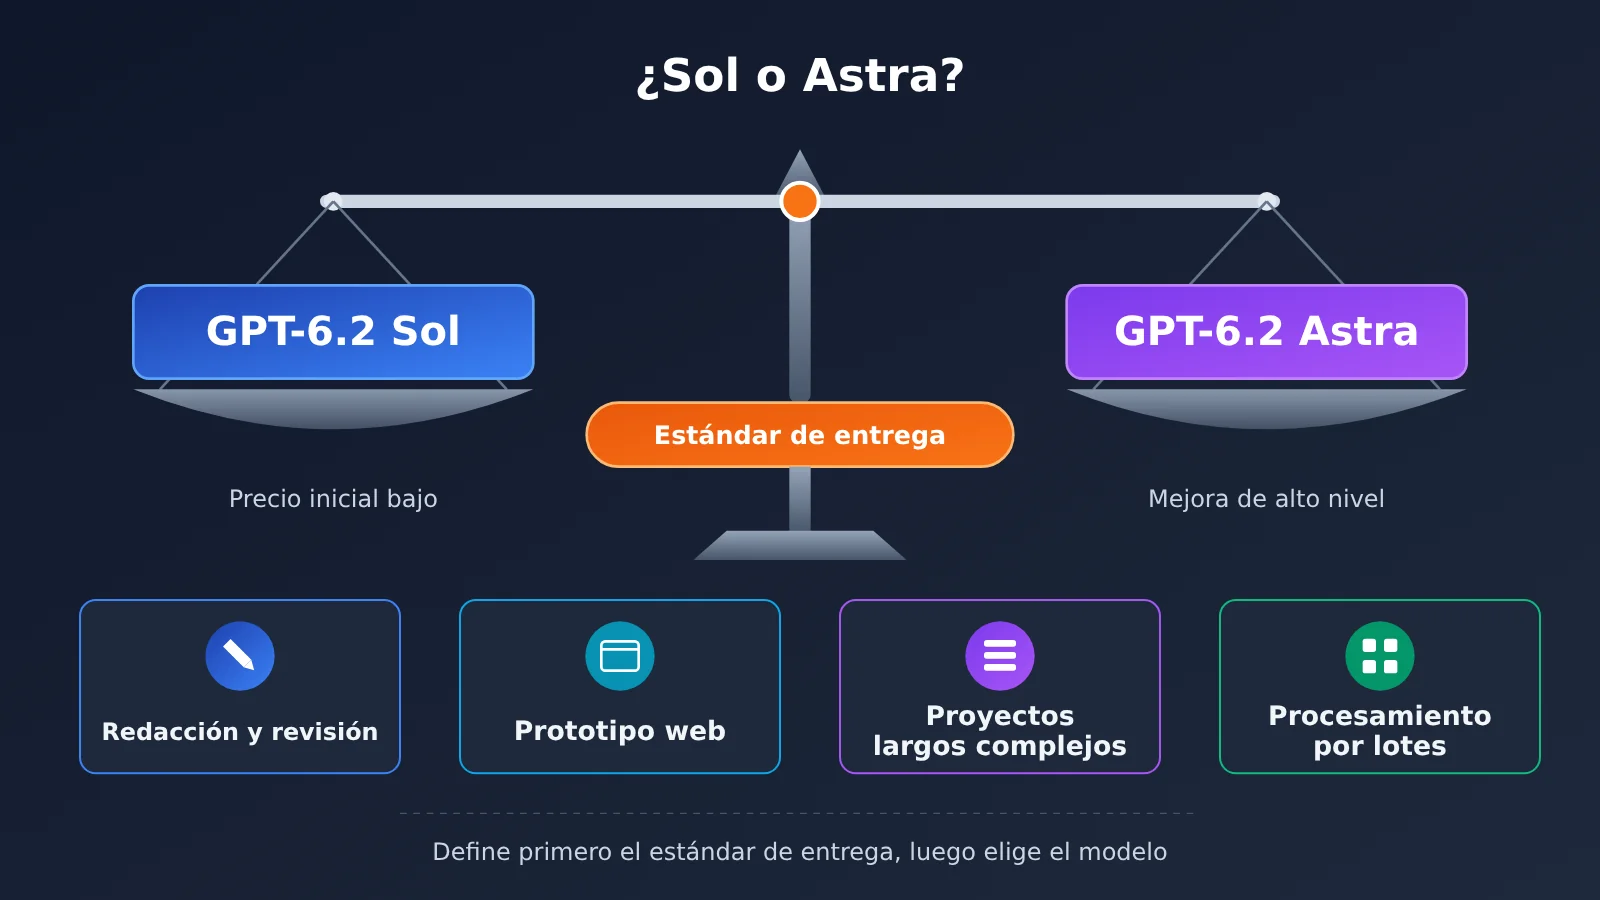
Respuesta directa: en la mayoría de las tareas cotidianas de redacción, los prototipos web y el procesamiento por lotes, te recomendamos empezar con GPT-6.2 Sol; solo cuando los resultados de Sol no alcancen el estándar de entrega que definiste de antemano, o cuando el costo de retrabajo ya supere la diferencia de precio, cambia a GPT-6.2 Astra. El precio de lista oficial de la API difiere en un factor de 4 entre ambos. Las evaluaciones oficiales muestran que la diferencia entre ambos no es grande en algunas tareas, pero esos resultados solo son válidos para evaluaciones específicas y no deben tomarse directamente como conclusiones generales. Por eso, la clave de esta elección no está en qué modelo es más potente, sino en qué tan alto es el estándar de entrega que exige tu tarea.
Esta recomendación es una sugerencia editorial, no una guía oficial de selección de OpenAI, ni tampoco una conclusión de nuestras propias pruebas. Los datos de evaluación citados en este artículo provienen del informe oficial de OpenAI.
¿Qué aprenderás al leer este artículo?
- Fecha de lanzamiento, disponibilidad, capacidades de entrada y salida, y precio de lista oficial de la API de GPT-6.2 Sol y Astra.
- Qué cifras de las evaluaciones oficiales son significativas y cuáles no se pueden extrapolar.
- Con qué modelo empezar en cada una de estas 4 categorías de escenarios: redacción y edición de textos cotidianas, prototipos web, proyectos largos y complejos y procesamiento por lotes con presupuesto ajustado; en qué casos conviene pasar a Astra y qué pasos requieren revisión humana obligatoria.
- Una tabla de registro de pruebas A/B que puedes copiar y usar directamente para comparar precisión factual, usabilidad, número de rondas de retrabajo y costo total.
Índice: empieza por la tabla de conceptos «To Know» y el resumen de impactos para entender rápidamente la terminología y lo que este lanzamiento significa para distintos perfiles de usuarios. La parte 1 reúne los hechos objetivos: información de lanzamiento, evaluaciones oficiales y reglas de precios. La parte 2 recoge el análisis y el criterio editorial: ofrece una tabla de decisiones por escenario, un método de estimación de costos y un flujo de pruebas A/B; al final, se incluyen enlaces a las fuentes.
Para saber: conceptos relacionados con GPT-6.2 Sol y Astra
| Concepto | Explicación breve |
|---|---|
| GPT-6.2 Astra | Modelo de la serie GPT-6.2 lanzado por OpenAI el 17 de noviembre de 2026, con un posicionamiento y un precio más altos |
| GPT-6.2 Sol | Otro modelo lanzado el mismo día; su precio oficial en la API es aproximadamente una cuarta parte del de Astra |
| GDPval v2 | Una de las evaluaciones utilizadas en el informe oficial de OpenAI; este artículo solo cita la mejora indicada por la propia OpenAI |
| ALE (Agents’ Last Exam) | Evalúa flujos de trabajo profesionales de varios pasos; en este artículo, la mejora toma GPT-6 Astra como base y no se mezcla con GDPval v2 |
| FrontierCode 2.0 | Evaluación de programación incluida en el informe oficial; la comparación de costos citada aquí solo es válida dentro de esta prueba |
| max 推理档 | El nivel más alto de intensidad de razonamiento del modelo; normalmente implica más pensamiento y un mayor costo |
| 百分点 | La diferencia entre dos porcentajes; por ejemplo, pasar de 50% a 56.2% equivale a una mejora de 6.2 puntos porcentuales |
| 缓存读取 | Cuando el contenido de entrada reutilizado coincide con la caché, se factura a un precio unitario más bajo |
| 缓存写入 | El costo de escribir contenido en la caché; la documentación oficial indica que se cobra aparte |
| 272K 阈值 | Cuando la entrada de una solicitud supera aproximadamente 272 000 tokens, toda la solicitud se factura con un multiplicador más alto |
| 交付标准 | Premisa de selección planteada por el editor: definir de antemano “qué nivel de calidad debe alcanzar la salida para considerarse utilizable” |
GPT-6.2 Sol y Astra: panorama rápido de impacto
- Usuarios de ChatGPT estándar: la documentación de ayuda oficial indica que esta tanda se abre de forma gradual principalmente a ChatGPT Work y Codex; el Chat normal queda fuera del alcance de este lanzamiento, así que a corto plazo probablemente no noten cambios.
- Desarrolladores y equipos pequeños: ambos modelos se irán abriendo por API. Dado que la diferencia de precio unitario es de 4 veces, la estrategia de enrutamiento de modelos afecta directamente la factura, así que vale la pena diseñarla con antelación.
- Creadores de contenido: la entrada de ambos modelos es texto e imágenes, y la salida es texto; no cuentan con generación de vídeo nativa, por lo que no sustituyen a las herramientas de generación de vídeo.
- Usuarios de procesamiento por lotes con presupuesto ajustado: la regla del multiplicador que se aplica cuando la entrada larga supera los 272K tiene un peso enorme en el coste del procesamiento masivo de documentos extensos, y resulta más determinante que comparar solo el precio unitario.
1. Hechos objetivos sobre GPT-6.2 Sol y Astra
Esta sección recopila únicamente la información que OpenAI ha publicado oficialmente, sin juicios editoriales. Fecha de verificación: 18 de noviembre de 2026.
1.1 Lanzamiento y alcance de acceso de GPT-6.2 Sol y Astra
OpenAI lanzó simultáneamente GPT-6.2 Astra y GPT-6.2 Sol el 17 de noviembre de 2026. Según la información oficial, ambos modelos se irán abriendo de forma gradual en ChatGPT Work, Codex y la API; el Chat normal queda fuera de esta primera fase. Esa «apertura gradual» significa que distintas cuentas pueden recibir acceso en momentos diferentes; la referencia será la documentación oficial de ayuda.
En cuanto a sus capacidades, ambos modelos aceptan entrada de texto e imágenes y generan salida de texto. El material oficial no menciona una capacidad nativa de generación de video. Si lo que necesitas es generar video, este lanzamiento no resuelve directamente esa necesidad.
1.2 Datos oficiales de evaluación de GPT-6.2 Sol y Astra
La siguiente tabla resume las conclusiones de evaluación del informe oficial. Ojo: cada fila es una evaluación independiente y su línea base de comparación también cambia; no mezcles cifras de filas distintas en una comparación horizontal.
| Evaluación | Objeto | Resultado del informe oficial | Limitaciones de uso |
|---|---|---|---|
| GDPval v2 | GPT-6.2 Astra | Mejora de 6.2 puntos porcentuales respecto a GPT-6 Astra; reducción del 22% en tokens de salida | La línea base de comparación es Astra de la generación anterior |
| GDPval v2 | GPT-6.2 Sol | Mejora de 5.3 puntos porcentuales respecto a GPT-6.1 Sol | La línea base es GPT-6.1 Sol, distinta de la línea base de Astra |
| ALE | GPT-6.2 Astra | Mejora de 5.2 puntos respecto a GPT-6 Astra | La unidad son «puntos»; no debe mezclarse con los «puntos porcentuales» de GDPval |
| FrontierCode 2.0 | Sol frente a Astra | Cuando ambos están en el nivel de razonamiento max, la diferencia entre Sol y Astra está dentro de 0.5 puntos y el coste de la tarea ronda 1/5 del de Astra | Solo se cumple en esa prueba y ese nivel de razonamiento; no es una conclusión general sobre costes |
Todos estos datos proceden del informe oficial de OpenAI, no de pruebas realizadas por nuestro equipo. En cuanto a la reducción del 22% en tokens de salida de Astra, se da en el contexto de GDPval v2; si se puede extrapolar a tu tarea concreta, tendrás que verificarlo por tu cuenta.
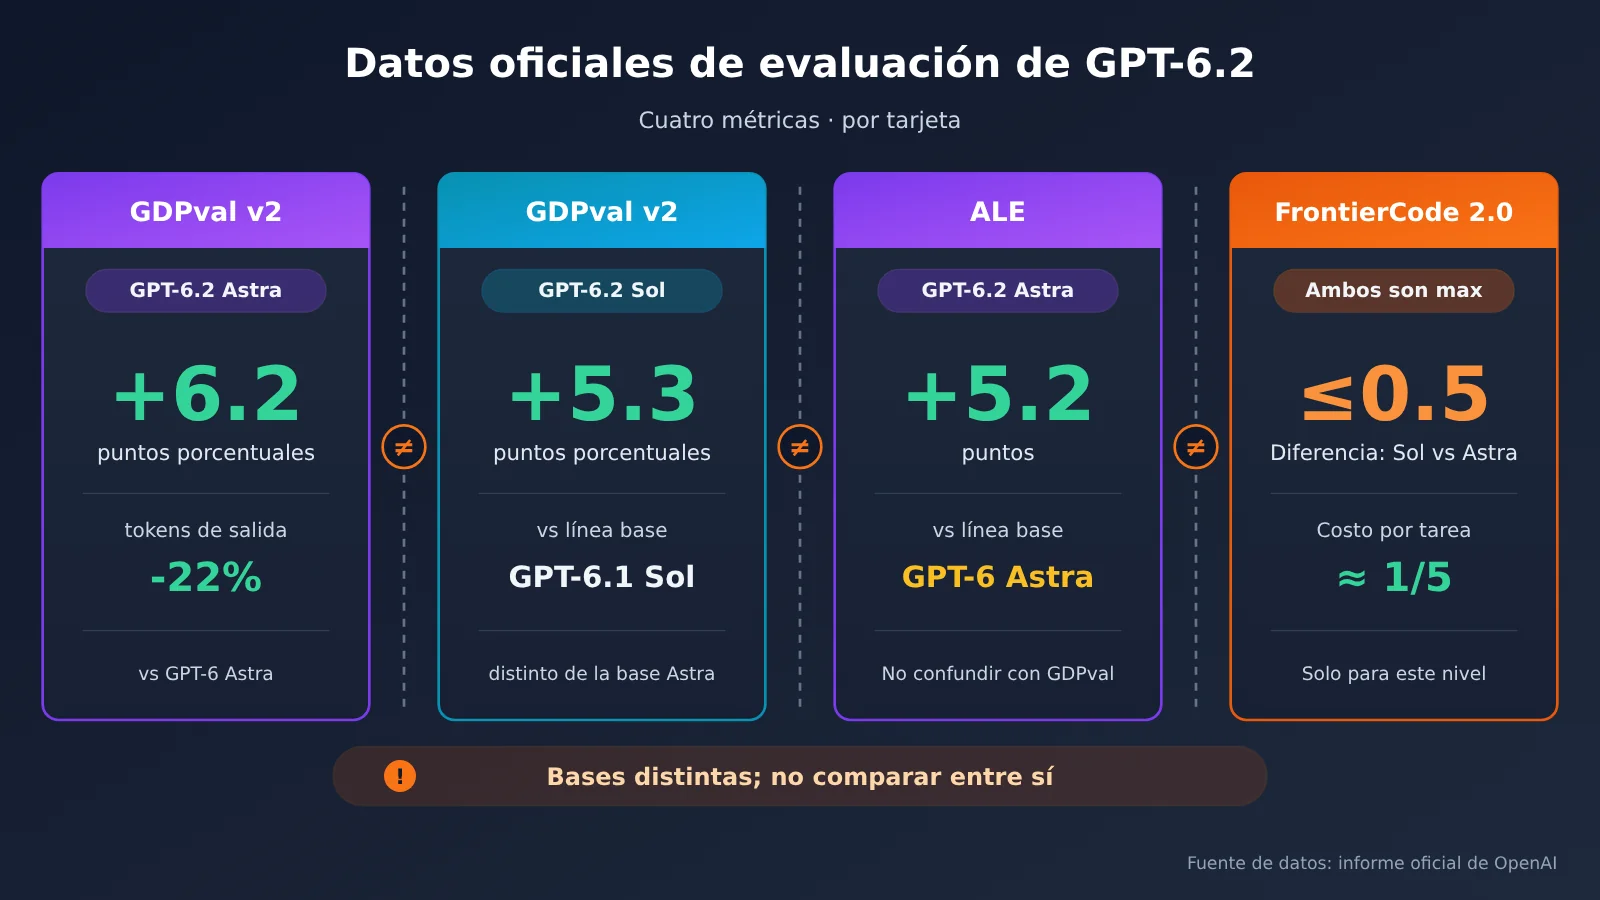
La imagen anterior divide las 4 evaluaciones en tarjetas independientes, para evitar que los lectores comparen cifras de distinta línea base. Si quieres contrastar con los datos de tu propio negocio, puedes registrar los resultados con la plantilla de la sección 2.4 y luego alternar modelos dentro del mismo código mediante interfaces compatibles con OpenAI como APIYI apiyi.com.
1.3 Reglas oficiales de precios de las API de GPT-6.2 Sol y Astra
A continuación se presentan los precios estándar de la API oficial, en USD por millón de tokens:
| Concepto de facturación | GPT-6.2 Astra | GPT-6.2 Sol | Descripción |
|---|---|---|---|
| Entrada sin caché | $8 | $2 | Sol es 1/4 de Astra |
| Lectura de caché | $0.4 | $0.1 | Precio unitario de entrada tras acertar en caché |
| Salida | $40 | $10 | Sol es 1/4 de Astra |
| Escritura de caché | Se cobra aparte | Se cobra aparte | Consultar la página oficial del modelo para más detalles |
| Entrada superior a 272K | Tarifas de entrada y caché de toda la solicitud ×2, salida ×1.5 | Igual que a la izquierda | Se calcula sobre toda la solicitud, no solo sobre la parte que supera el límite |
Hay que prestar especial atención a la última fila. Después de superar el umbral de 272K, el multiplicador se aplica a toda la solicitud, no solo a los tokens que exceden el umbral. Para tareas en las que hay que incorporar una gran cantidad de documentos largos, esta regla debe presupuestarse por separado, y no basta mirar solo el precio unitario base.
💡 Nota sobre precios: La tabla anterior muestra los precios estándar de la API oficial de OpenAI. Los precios y la disponibilidad en plataformas de terceros deben verificarse por separado. Este artículo no verificó si estos dos modelos están disponibles en APIYI apiyi.com; consulte la lista de modelos de la plataforma.
2. Cómo elegir entre GPT-6.2 Sol y Astra: el criterio analítico del editor
Lo siguiente son inferencias y recomendaciones del editor basadas en los hechos de la Parte 1; no representan la opinión oficial de OpenAI ni han sido verificadas con nuestras propias pruebas.
2.1 Primero define el criterio de entrega, luego elige GPT-6.2 Sol o Astra
Cuando mucha gente elige un modelo, lo primero que pregunta es «cuál es más potente». Pero los datos oficiales de FrontierCode 2.0 sugieren otra perspectiva: en esta prueba, con ambos en el nivel de razonamiento max, la diferencia entre Sol y Astra está dentro de 0.5 puntos, mientras que el costo de la tarea es solo aproximadamente 1/5. Aunque esta conclusión no se pueda extrapolar, basta para mostrar que la ganancia de «ser más potente» puede ser muy pequeña, mientras que la diferencia de costo puede ser muy grande.
Por eso, el editor recomienda responder tres preguntas antes de elegir un modelo: ¿quién usará este resultado? ¿qué tan alto es el costo de un error? ¿cuántas rondas de retrabajo se pueden aceptar como máximo? Cuanto más clara sea la respuesta, más fácil será determinar si Sol ya es suficiente. Si el criterio de entrega no está bien definido, cambiar a Astra solo significa repetir el ensayo y error de una forma más cara.
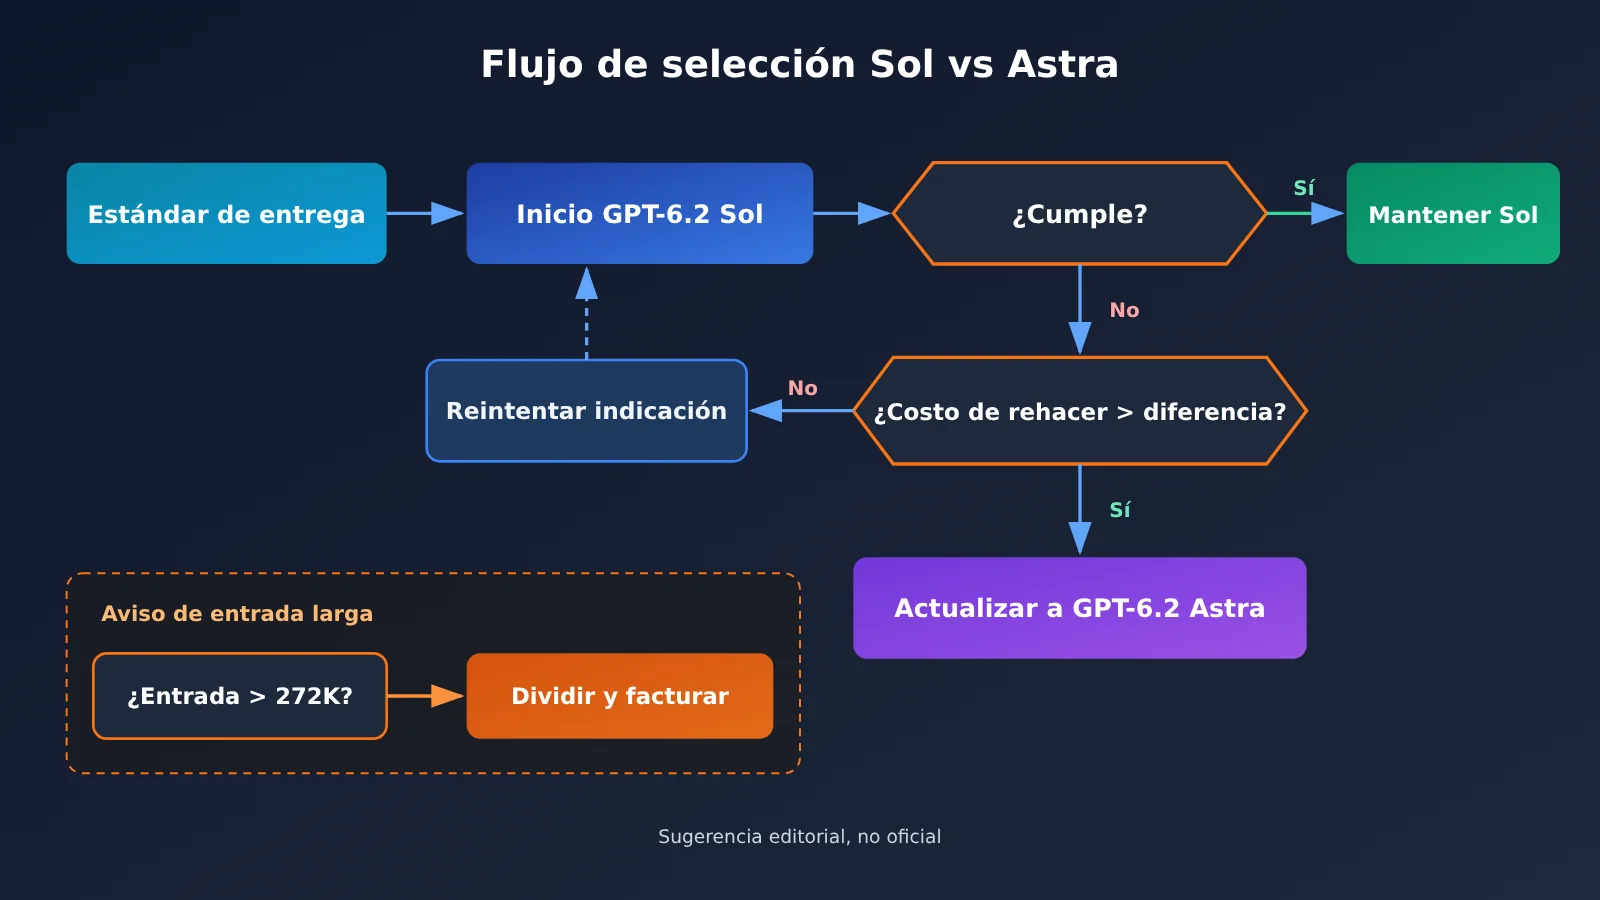
2.2 Tabla de decisión para 4 tipos de escenarios: GPT-6.2 Sol y Astra
La siguiente tabla es una recomendación editorial, no una guía oficial. La “condición para escalar a Astra” se refiere a situaciones en las que vale la pena probar Astra; el “punto de verificación manual” es una etapa que no se puede omitir, uses el modelo que uses.
| Escenario | Modelo inicial | Condición para escalar a Astra | Puntos que requieren verificación manual |
|---|---|---|---|
| Redacción y revisión cotidiana | GPT-6.2 Sol | Después de 2 o 3 rondas consecutivas, sigue sin cumplir los requisitos de tono o estructura; se necesita trabajar con textos largos de argumentación rigurosa | Hechos, datos, citas y nombres; si se cambió el significado original por iniciativa propia |
| Prototipado web | GPT-6.2 Sol | La lógica de interacción abarca varias páginas y el código generado por Sol presenta errores de estado repetidos; se necesita una reproducción de alta fidelidad a partir de imágenes del diseño | Ejecución real en el navegador; validación de formularios y adaptación a móviles; si los paquetes de dependencias existen realmente |
| Proyectos largos y complejos | Según el estándar de entrega; se puede probar Astra directamente | Cadena de tareas larga y muchas dependencias de contexto; un error en un punto puede provocar un retrabajo extenso en las etapas posteriores | Puntos clave de decisión, consistencia entre archivos y cobertura de pruebas |
| Procesamiento por lotes sensible al presupuesto | GPT-6.2 Sol | La tasa de error en el muestreo supera el umbral que estableciste y el coste de corrección posterior es mayor | Verificación mediante muestreo proporcional; si una entrada individual supera 272K; tasa de aciertos de caché |
En el escenario de redacción y revisión cotidiana, la dificultad suele estar en la exactitud de los hechos y la adherencia al estilo, no en la profundidad de razonamiento. Empezar con Sol sale más rentable, pero, uses el modelo que uses, los datos y las citas deben verificarse manualmente.
En el escenario de prototipado web, “que funcione” es un criterio obligatorio y se puede juzgar objetivamente. Para determinar si Sol es suficiente, hay que ejecutarlo de verdad y revisar las interacciones principales, los estados de error y la adaptación a móviles; no conviene decidir si escalar basándose en una única ejecución exitosa.
Los proyectos largos y complejos son el escenario con más motivos para considerar Astra directamente. El informe oficial indica que GDPval v2 reduce los tokens de salida en un 22%, tomando como línea base de comparación el antiguo GPT-6 Astra; no se puede usar esto para estimar el ahorro relativo frente a GPT-6.2 Sol. El coste total de la tarea de ambos modelos nuevos todavía debe verificarse por tu cuenta bajo el mismo estándar de entrega. Para el procesamiento por lotes sensible al presupuesto, conviene priorizar el control de la longitud de cada entrada para evitar activar el multiplicador de 272K.
2.3 Método de estimación de costos de GPT-6.2 Sol y Astra
A continuación hacemos un cálculo ilustrativo con los precios oficiales estándar, para mostrar el impacto de las reglas de facturación; no representa el consumo de ninguna tarea real. Supongamos que cada solicitud tiene 50K tokens de entrada (sin caché) y 5K tokens de salida:
- Sol: 0.05 × $2 + 0.005 × $10 = $0.15
- Astra: 0.05 × $8 + 0.005 × $40 = $0.60
Si aumentamos la entrada a 300K tokens y la salida a 10K tokens, se activa el multiplicador de 272K:
- Sol: 0.3 × $4 + 0.01 × $15 = $1.35
- Astra: 0.3 × $16 + 0.01 × $60 = $5.40
De este ejemplo se desprenden dos cosas. Primero, con el mismo consumo de tokens, la diferencia de precio se mantiene estable en torno a 4 veces. Segundo, al superar los 272K, el costo por solicitud sube de forma notable. Para tareas de procesamiento por lotes, dividir documentos largos por debajo del umbral puede reducir el cargo adicional por contexto largo, pero el ahorro neto depende del contexto repetido, de las solicitudes extra y de la pérdida de calidad; no conviene dar por sentado que sale más barato que cambiar de modelo.
El costo real también depende de la longitud efectiva de salida y del número de rondas de retrabajo. Si Sol necesita en promedio 3 rondas para cumplir el estándar y Astra lo logra en 1, la diferencia en la factura final se reduce; por eso la sección 2.4 recomienda registrar el «número de rondas de retrabajo».
El siguiente código es solo un ejemplo de integración y no se probó para este artículo. La salida del script A/B es una estimación equivalente al precio oficial estándar sin caché y con entrada no superior a 272K, no la factura real de un tercero; las tarifas de terceros deben calcularse según su tasa efectiva.
El código de ejemplo a continuación sirve para cambiar de modelo dentro del mismo código. Los ID de modelo siguen la nomenclatura de la página oficial de modelos; consulta la lista real de modelos de la plataforma que uses:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI; la disponibilidad de modelos depende de la lista de la plataforma
)

response = client.chat.completions.create(
    model="gpt-6.2-sol",  # si necesitas escalar, cámbialo a "gpt-6.2-astra"
    messages=[{"role": "user", "content": "按以下交付标准改写这段文案:……"}]
)
print(response.choices[0].message.content)
print(response.usage)  # registra el uso de tokens para calcular el costo total
Ver el script de comparación A/B (ejecutar dos modelos con la misma tarea y registrar el consumo)
import openai

PRICES = {  # Estimación equivalente al precio estándar oficial, no la factura real de terceros; solo válida para solicitudes ≤272K y sin caché
    "gpt-6.2-sol":   {"input": 2.0, "output": 10.0},
    "gpt-6.2-astra": {"input": 8.0, "output": 40.0},
}

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Cambia de modelo mediante la interfaz unificada de APIYI
)

def run_once(model: str, prompt: str) -> dict:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    if u.prompt_tokens > 272000 or cached:
        raise ValueError("此简化估算仅适用于输入≤272K且无缓存的请求")
    p = PRICES[model]
    cost = u.prompt_tokens / 1e6 * p["input"] + u.completion_tokens / 1e6 * p["output"]
    return {
        "model": model,
        "output": resp.choices[0].message.content,
        "input_tokens": u.prompt_tokens,
        "output_tokens": u.completion_tokens,
        "official_standard_equivalent_usd": round(cost, 4),
    }

task = "在这里放同一个任务的完整提示词和交付标准"
for m in PRICES:
    r = run_once(m, task)
    print(r["model"], r["input_tokens"], r["output_tokens"], r["official_standard_equivalent_usd"])
🚀 Consejo para empezar: la clave de una prueba A/B es «misma tarea, misma indicación, mismos criterios de entrega». Cuando uses una interfaz compatible con OpenAI como APIYI apiyi.com, basta cambiar el parámetro
modelpara cambiar de modelo, lo que facilita controlar las variables. Antes de salir a producción, confirma que el modelo objetivo ya aparezca en la lista de modelos de la plataforma.
2.4 Plantilla de registro para pruebas A/B de GPT-6.2 Sol y Astra
A continuación tienes una plantilla en blanco; completa tus propios resultados. Para cada escenario, se recomienda elegir al menos de 3 a 5 tareas representativas y registrarlas por separado. No bases tus conclusiones en un único resultado.
| Dimensión de verificación | Método de registro | GPT-6.2 Sol | GPT-6.2 Astra |
|---|---|---|---|
| Exactitud factual | Verificar dato por dato, citas y nombres, y anotar el número de errores | ||
| Cumplimiento de entrega | ¿Cumple el criterio de entrega definido de antemano? (sí / no / parcial) | ||
| Rondas de retrabajo | Cuántas rondas se usaron desde la primera generación hasta cumplir el estándar | ||
| Tokens de entrada / salida | Acumulado por ronda; ojo si supera 272K | ||
| Costo total | Calcular según el acumulado de tokens por ronda, con las rondas de retrabajo incluidas | ||
| Tiempo manual | Minutos dedicados a revisar y corregir | ||
| Conclusión | Qué modelo usar por defecto para esta tarea en adelante |
Al completarla, conviene analizar juntos el “costo total” y el “tiempo manual”. Si el valor del tiempo manual que ahorra Astra supera el costo adicional de API, actualizarse tiene sentido; si no, lo mejor es seguir con Sol y concentrarse en optimizar las indicaciones y los criterios de entrega.
2.5 Cómo diseñar el enrutamiento entre GPT-6.2 Sol y Astra en equipos pequeños
Para equipos pequeños, la recomendación editorial es apostar por un enrutamiento del tipo «Sol por defecto, Astra como escalado condicional». En concreto, puedes trasladar al flujo de trabajo las condiciones de activación de la tabla de la sección 2.2: por ejemplo, si un tipo de tarea necesita rehacerse más de cierto número de rondas, se cambia automáticamente a Astra para regenerarla y se anota el motivo en los logs. Después de acumular un tiempo, tendrás una base de selección construida sobre tus propios datos de negocio, bastante más fiable que cualquier evaluación genérica.
Este tipo de enrutamiento necesita una capa de acceso que permita cambiar de modelo sin fricción. APIYI apiyi.com ofrece una interfaz compatible con OpenAI: con una sola clave API puedes invocar varios modelos principales, lo que encaja bien para montar este tipo de enrutamiento. Eso sí, antes de que la serie GPT-6.2 aparezca oficialmente en la lista de modelos de la plataforma, conviene validar el proceso con los modelos que ya tienes.
Hay otro punto que merece seguimiento continuo: ambos modelos están en fase de apertura gradual, así que los precios oficiales, el alcance de disponibilidad y la información de las páginas de modelo pueden cambiar. Lo que sigue es una predicción: a medida que aparezcan más evaluaciones de terceros, las diferencias entre Sol y Astra en tareas concretas se verán con mucha más granularidad que en los informes oficiales. Para entonces, tu propia tabla de registros A/B tendrá más valor de referencia que cualquier puntuación aislada de benchmark.
Referencias
- Página oficial de lanzamiento de OpenAI: notas de lanzamiento y evaluaciones oficiales de GPT-6.2 Astra y Sol
- Enlace:
openai.com/index/introducing-gpt-6-2-astra-sol/ - Descripción: los datos de GDPval v2, ALE y FrontierCode 2.0 de este artículo provienen de esa página
- Enlace:
- Centro de ayuda de OpenAI: información sobre la disponibilidad de ChatGPT Work y Codex
- Enlace:
help.openai.com/en/articles/20001275-chatgpt-work-and-codex - Descripción: alcance de lanzamiento e información sobre el despliegue gradual
- Enlace:
- Ficha del modelo GPT-6.2 Astra: página oficial del modelo en la API
- Enlace:
developers.openai.com/api/docs/models/gpt-6.2-astra - Descripción: reglas de precios, caché y facturación de contexto largo
- Enlace:
- Ficha del modelo GPT-6.2 Sol: página oficial del modelo en la API
- Enlace:
developers.openai.com/api/docs/models/gpt-6.2-sol - Descripción: reglas de precios, caché y facturación de contexto largo
- Enlace:
Los modelos seguirán evolucionando, así que lo más fiable es definir primero con claridad los criterios de entrega y luego comparar con la misma tarea. Si necesitas comparar varios modelos dentro de un mismo código, puedes integrarte mediante APIYI apiyi.com y después registrar los resultados con la plantilla de este artículo.
Lo que se prepara con antelación prospera; lo que se improvisa fracasa. — Libro de los Ritos · Zhongyong
Autor: equipo técnico de APIYI
Contacto técnico: puedes contactarnos en la página principal de APIYI apiyi.com; para más material de integración, visita el centro de documentación docs.apiyi.com