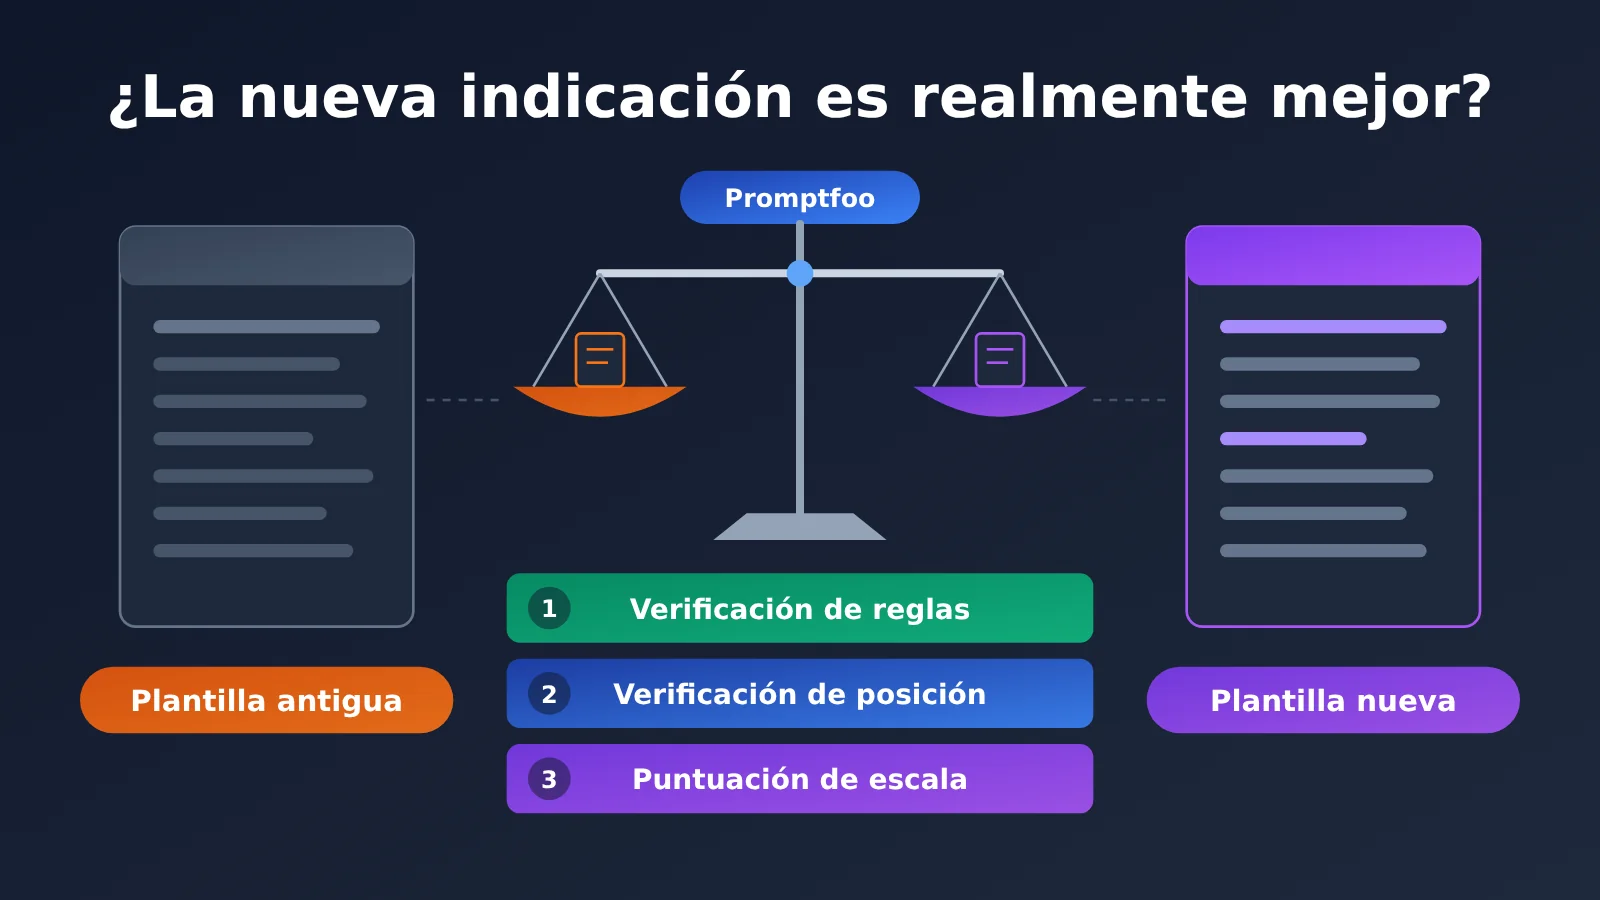
Respuesta directa: una nueva indicación no es necesariamente mejor, y “parece mejor” tampoco cuenta como evidencia. Para decidir qué plantilla de artículo es mejor, conviene fijar los materiales, el modelo y la configuración de generación, cambiar solo la plantilla y usar las aserciones de Promptfoo para revisar por capas la estructura, el orden y la calidad del contenido. También hay que presentar los resultados por dimensiones, para que una puntuación de estilo no compense errores factuales. Este artículo propone un plan experimental; no ejecuta un A/B real, así que no ofrece tasas de victoria, puntuaciones ni ahorro de cuota.
Al terminar de leer, sabrás:
- Qué pueden comprobar y qué no pueden probar las aserciones
contains, JavaScript yllm-rubricde Promptfoo. - Cómo ejecutar por separado un archivo de aserciones sobre salidas de modelo ya existentes, para evitar regenerar cuando solo se cambian las reglas de puntuación.
- Un diseño experimental para comparar plantillas de artículo antiguas y nuevas, incluido control de variables, revisión en tres capas y presentación por dimensiones.
- Los límites entre el modelo juez y las aserciones basadas en reglas, y el problema de coste que traen los modelos de revisión de pago.
Índice: primero una tabla de conceptos para explicar varios términos clave de la evaluación con Promptfoo; después, qué implica todo esto para equipos de contenido, desarrolladores y responsables de evaluación. La sección “Hechos objetivos” del texto solo reúne las capacidades de aserción y el estado de verificación descritos en la documentación. La sección “Análisis y juicio” presenta recomendaciones de diseño experimental, ejemplos de configuración y debate de limitaciones, e indica punto por punto qué es una recomendación y no una conclusión medida.
Conceptos que debes conocer antes de comparar plantillas de indicaciones con Promptfoo
Estos términos aparecerán repetidamente en las secciones siguientes. La mayoría provienen de la documentación de configuración de Promptfoo, y algunos también son expresiones habituales en experimentos de evaluación.
| Concepto | Breve explicación |
|---|---|
| Promptfoo | Una herramienta de código abierto para evaluar indicaciones y salidas de modelos de lenguaje grandes, que permite definir casos de prueba y aserciones mediante archivos de configuración |
| Aserción (Assertion) | Regla de verificación automática sobre la salida del modelo, que determina si la salida cumple una condición |
| contains | Comprueba si el texto especificado aparece en la salida; es una coincidencia determinista de cadenas |
| Aserción JavaScript | Implementa condiciones de evaluación más complejas mediante una expresión o función de JavaScript |
| llm-rubric | Hace que un modelo puntúe la salida según una rúbrica personalizada; es una aserción del tipo «puntuación por modelo» |
| Proveedor de calificación (Grading Provider) | El modelo que ejecuta la calificación de llm-rubric; se puede configurar por separado |
| Rúbrica (Rubric) | Criterio de evaluación escrito para el modelo calificador, que indica qué situaciones se consideran aprobadas y cuáles restan puntos |
| Modelo juez (LLM-as-a-Judge) | Práctica de usar un Modelo de Lenguaje Grande en lugar de una revisión humana para evaluar la calidad de la salida |
| Control de variables | En un experimento, cambiar solo un factor (aquí, la plantilla) y mantener los demás constantes |
Vista rápida del impacto de evaluar plantillas de indicaciones nuevas y antiguas
El valor de este tipo de métodos de evaluación no está en lo novedosa que pueda ser la herramienta, sino en convertir «me parece que la nueva plantilla es mejor» en un registro de verificación que se puede revisar. Cada rol obtiene algo diferente de este proceso.
| Perfil | Impacto real |
|---|---|
| Equipos de contenido y editores | La actualización de la plantilla dispone de una base de aceptación revisable y permite detectar problemas como «la estructura es correcta, pero los párrafos de hechos incluyen suposiciones» |
| Ingenieros de indicaciones y desarrolladores | Pueden dividir los requisitos de la plantilla en aserciones de reglas y aserciones de rúbrica; al modificar las reglas de puntuación, no hace falta regenerar todas las salidas |
| Responsables de evaluación | Necesitan informar los resultados por dimensiones y distinguir con claridad la fuerza probatoria de la puntuación del modelo, las coincidencias de reglas y la revisión humana |
| Responsables de presupuesto | Las aserciones de reglas casi no añaden costo de llamadas; si llm-rubric utiliza modelos de pago, generará costos de revisión |
Hechos objetivos sobre las capacidades de aserción de Promptfoo
Esta sección se limita a exponer las capacidades descritas en la documentación de Promptfoo. Revisamos las páginas de documentación correspondientes el 2026-11-17, pero la fecha de primera publicación de estas capacidades no ha sido verificada, por lo que este artículo no ofrece fechas concretas de lanzamiento.
La aserción contains de Promptfoo: comprobar si un texto aparece
contains es el tipo de aserción más básico y sirve para comprobar si un fragmento de texto determinado aparece en la salida del modelo. Es una coincidencia de cadenas determinista: la misma salida dará el mismo resultado en cada ejecución.
Conviene subrayar que que contains pase solo significa «se ha encontrado este texto». No indica si el párrafo donde aparece está bien redactado ni si el contenido es correcto.
La aserción de JavaScript de Promptfoo: implementar condiciones complejas
Cuando la condición de evaluación va más allá de «¿está incluido?», se puede escribir lógica personalizada mediante una aserción de JavaScript. Por ejemplo, comparar la posición relativa de dos títulos, contar cuántas veces aparece cierta sección o comprobar si un texto concreto cae dentro de una sección específica. Este tipo de aserción sigue siendo determinista y su resultado es reproducible.
Evaluar salidas ya existentes de Promptfoo con un archivo de aserciones independiente
Promptfoo permite ejecutar un archivo de aserciones independiente sobre salidas de modelo ya generadas, sin necesidad de regenerar todas las salidas. Esto es importante para iterar en la evaluación: las reglas de puntuación suelen necesitar ajustes repetidos, mientras que la generación en sí consume tiempo y llamadas.
La aserción llm-rubric de Promptfoo: puntuar con un modelo según una rúbrica
llm-rubric es un tipo de aserción basada en evaluación por modelo. Entrega la salida y una rúbrica personalizada al modelo evaluador, que decide si pasa y ofrece la razón. La documentación indica que el proveedor que realiza la puntuación puede configurarse por separado, y que la indicación usada durante la evaluación también puede personalizarse.
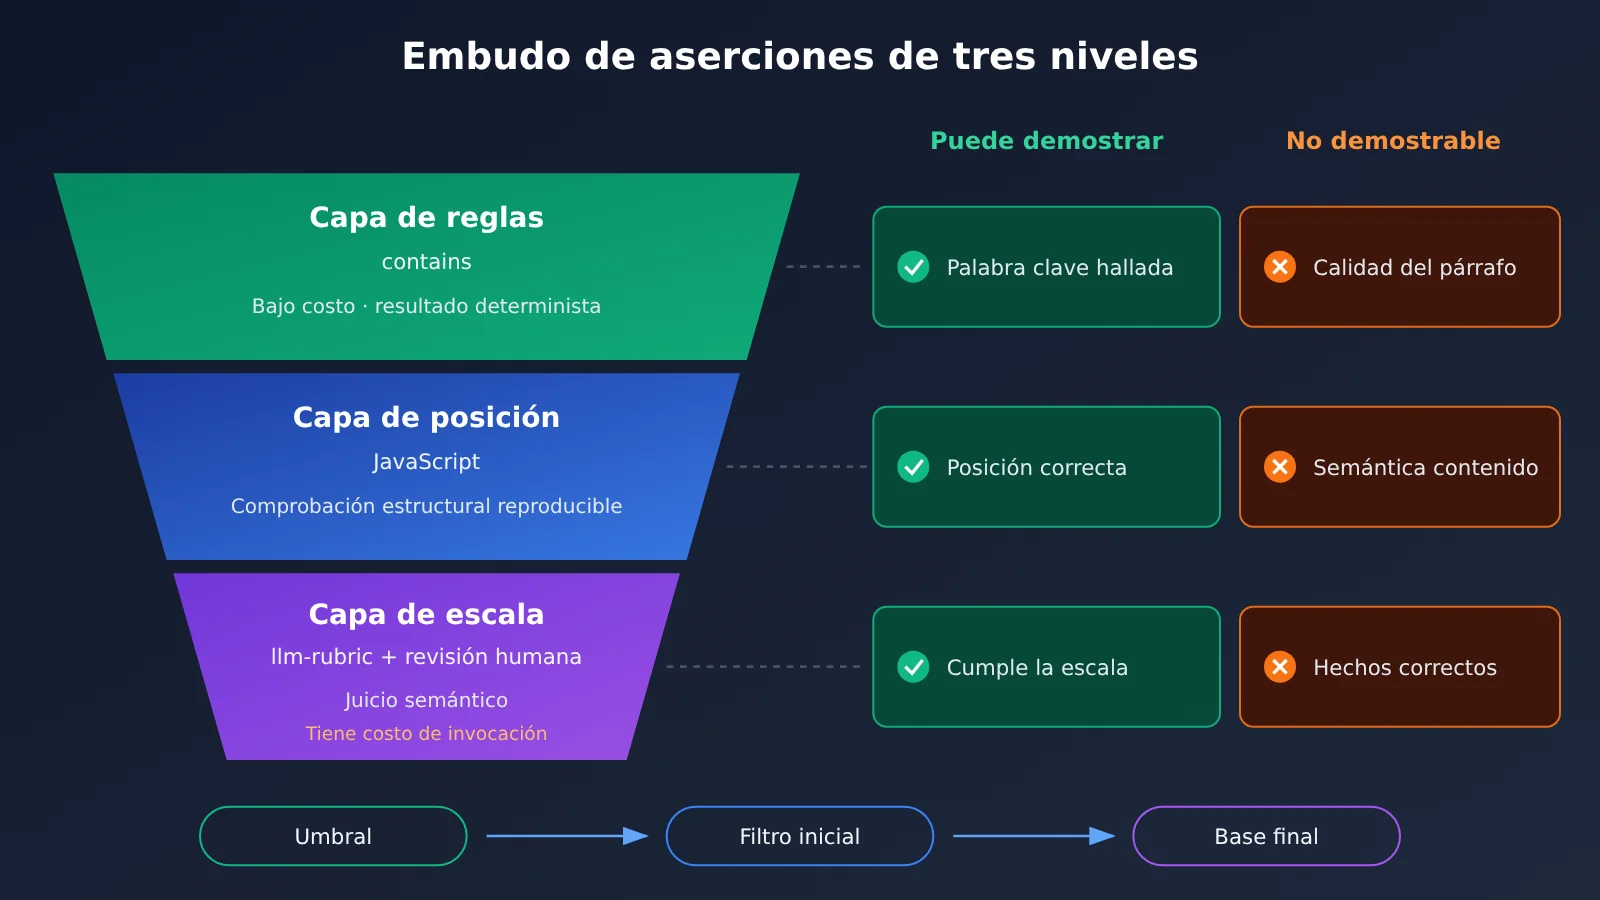
| Tipo de aserción | Método de evaluación | ¿Resultado determinista? | Qué puede demostrar | Qué no puede demostrar |
|---|---|---|---|---|
| contains | coincidencia de cadenas | determinista | que el texto especificado aparece | la calidad del párrafo, la corrección del contenido |
| JavaScript | lógica de código personalizada | determinista | condiciones codificables como estructura, orden o recuento | si algo es bueno o malo a nivel semántico |
| llm-rubric | el modelo puntúa según una rúbrica | influido por el modelo evaluador | que la salida, a juicio del modelo evaluador, cumple la rúbrica | la corrección factual, y tampoco sustituye la revisión humana |
Fuentes y estado de la verificación
La parte factual de este artículo se basa en las siguientes páginas de documentación de Promptfoo, revisadas el 2026-11-17:
- Documentación de aserciones y métricas de Promptfoo: promptfoo.dev/docs/configuration/expected-outputs/
- Documentación de aserciones con evaluación por modelo de Promptfoo: promptfoo.dev/docs/configuration/expected-outputs/model-graded/
- Documentación de llm-rubric de Promptfoo: promptfoo.dev/docs/configuration/expected-outputs/model-graded/llm-rubric/
Este artículo no ha ejecutado un experimento A/B real entre la plantilla antigua y la nueva. La configuración y el flujo que aparecen más adelante son solo recomendaciones de diseño y no representan ningún resultado medido.
Comparar con Promptfoo el análisis y el juicio de plantillas de artículos antiguas y nuevas
Lo siguiente es nuestra interpretación y nuestras recomendaciones a partir de los hechos anteriores. Tomemos como ejemplo la «plantilla de artículo de noticias»: supongamos que la nueva plantilla exige que el artículo contenga dos secciones, «hechos objetivos» y «análisis y juicio», con los hechos primero y el análisis después, y que en la sección de hechos no se mezclen conjeturas.
Diseño del experimento: al comparar plantillas con Promptfoo, cambiar solo una variable
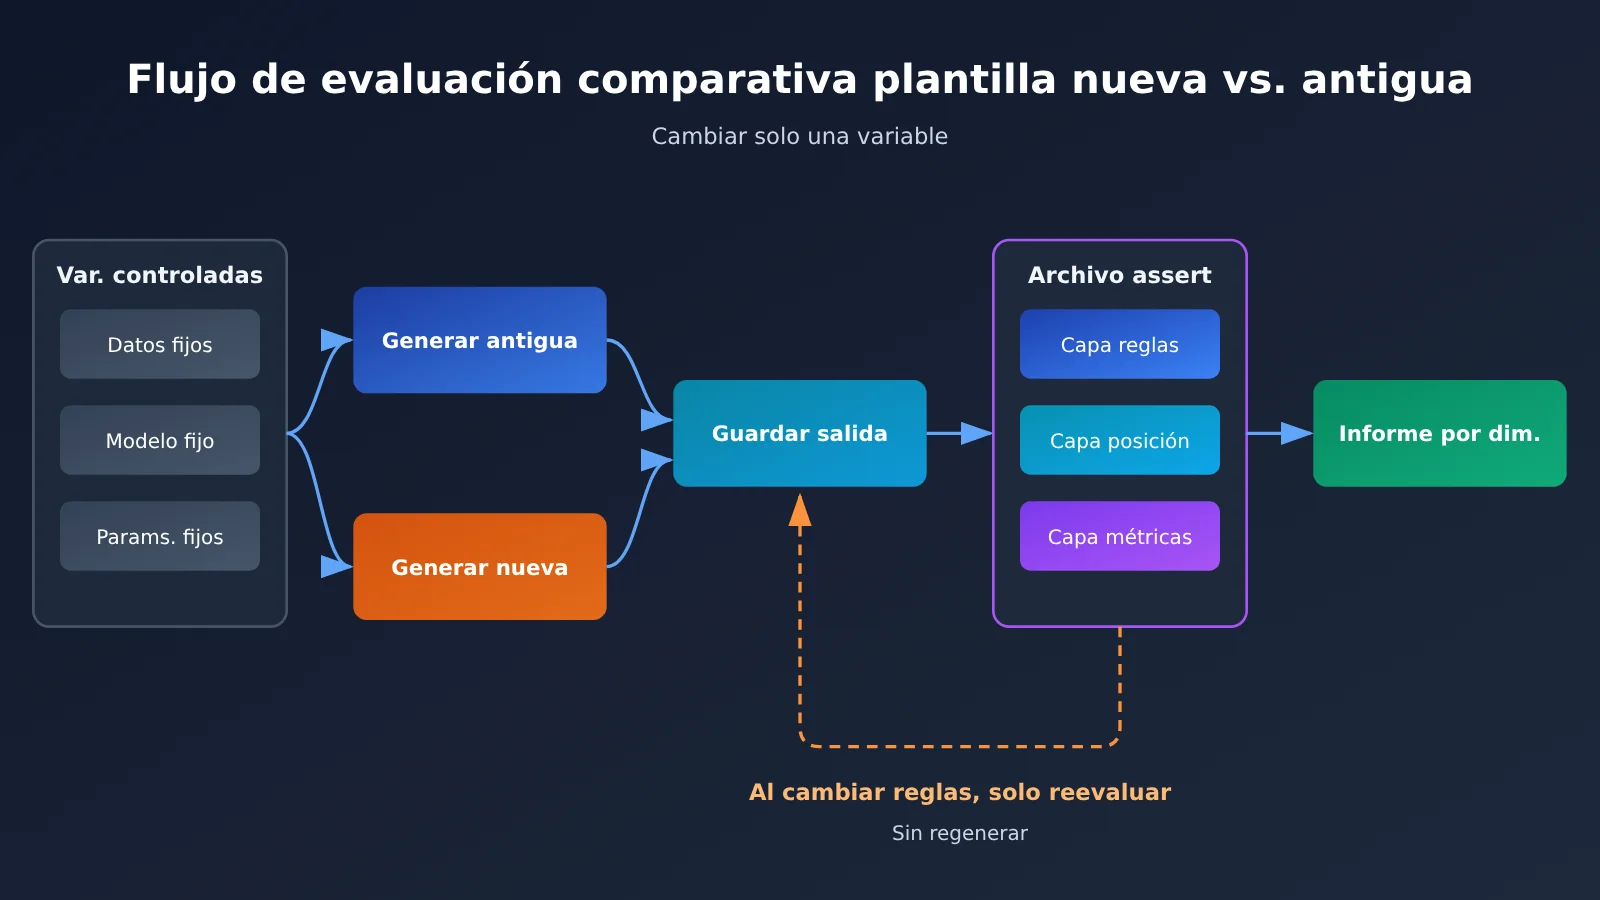
El error más común al comparar plantillas es cambiar la plantilla y, al mismo tiempo, cambiar también los datos, el modelo o los parámetros de temperatura. Así, aunque el resultado mejore, no queda claro si la mejora se debe a la plantilla o a otros factores. Por eso, el primer paso es fijar todas las variables excepto la plantilla.
| Variable | Cómo se trata | Motivo |
|---|---|---|
| Datos de entrada | Fijar el mismo lote y compartirlo entre la plantilla antigua y la nueva | Si los datos cambian, el contenido de los hechos cambia directamente |
| Modelo de generación | Fijar el mismo modelo y la misma versión | La diferencia de estilo de escritura entre modelos puede ser mayor que la diferencia entre plantillas |
| Parámetros de generación | Fijar la temperatura, la longitud máxima y demás ajustes | Los parámetros afectan la estabilidad y la extensión de la salida |
| Plantilla de indicación | La única variable que se cambia | Es el objeto que se quiere validar |
| Reglas de puntuación | Usar el mismo conjunto de aserciones en los dos grupos, antiguo y nuevo | Garantizar que ambos grupos reciban las mismas comprobaciones |
Capa de reglas y capa de posición de Promptfoo: primero la estructura, luego el orden
La primera capa es la comprobación de reglas: usar contains para confirmar si aparece el título exigido por la plantilla. La segunda capa es la comparación de posiciones: usar una aserción de JavaScript para confirmar que el título «客观事实» aparece antes del título «分析判断». Ambas capas son comprobaciones deterministas, de bajo costo y resultados estables, por lo que conviene colocarlas al principio para filtrar salidas claramente no válidas.
A continuación se muestra una forma ilustrativa de escribir las aserciones; para los nombres exactos de los campos, consulta la documentación oficial de Promptfoo:
# Configuración ilustrativa: solo para explicar la idea; verifica los detalles de los campos en la documentación oficial
assert:
  # Capa de reglas: si aparece el título
  - type: contains
    value: "## 客观事实"
  - type: contains
    value: "## 分析判断"

  # Capa de posición: la sección de hechos debe ir antes de la sección de análisis
  - type: javascript
    value: |
      const a = output.indexOf('## 客观事实');
      const b = output.indexOf('## 分析判断');
      return a >= 0 && b >= 0 && a < b;
Fíjate que, en la forma de escribir la capa de posición, primero se comprueba que ambos títulos existan. Si solo escribieras a < b, cuando faltara el título «客观事实», indexOf devolvería -1 y también se cumpliría la condición de «menor que», provocando una falsa evaluación. Esta es precisamente la razón por la que las aserciones deterministas también deben redactarse con cuidado.
La capa de rúbrica de Promptfoo: usar una rúbrica explícita para comprobar si el apartado de hechos contiene especulaciones
Que los títulos estén completos y en el orden correcto no significa que el apartado de hechos esté limpio. «Si el apartado de hechos mezcla especulaciones» es un juicio semántico que las aserciones basadas en reglas difícilmente pueden cubrir; para eso conviene usar llm-rubric. La rúbrica debe ser concreta y decirle al modelo evaluador qué se considera una infracción, en lugar de preguntar de forma vaga «si está bien escrito».
# Configuración ilustrativa: tanto el proveedor de evaluación como el contenido de la rúbrica son solo ejemplos
assert:
  - type: llm-rubric
    value: |
      Evalúa únicamente la sección «hechos objetivos».
      Si en esa sección aparecen predicciones, valoraciones subjetivas o inferencias sin fuente indicada, márcala como no aprobada y cita la frase original problemática.
      No evalúes el estilo de redacción ni otras secciones.
    provider: your-grading-model   # El proveedor de evaluación puede configurarse por separado
Las conclusiones de la capa de rúbrica siguen necesitando muestreo manual. El modelo evaluador puede dejar pasar casos o marcar como especulación una afirmación factual legítima. Lo más prudente es revisar uno por uno los casos no aprobados y luego extraer aleatoriamente una parte de los aprobados para inspección manual.
Presentación por dimensiones: evitar que la puntuación de estilo de Promptfoo compense los errores de hecho
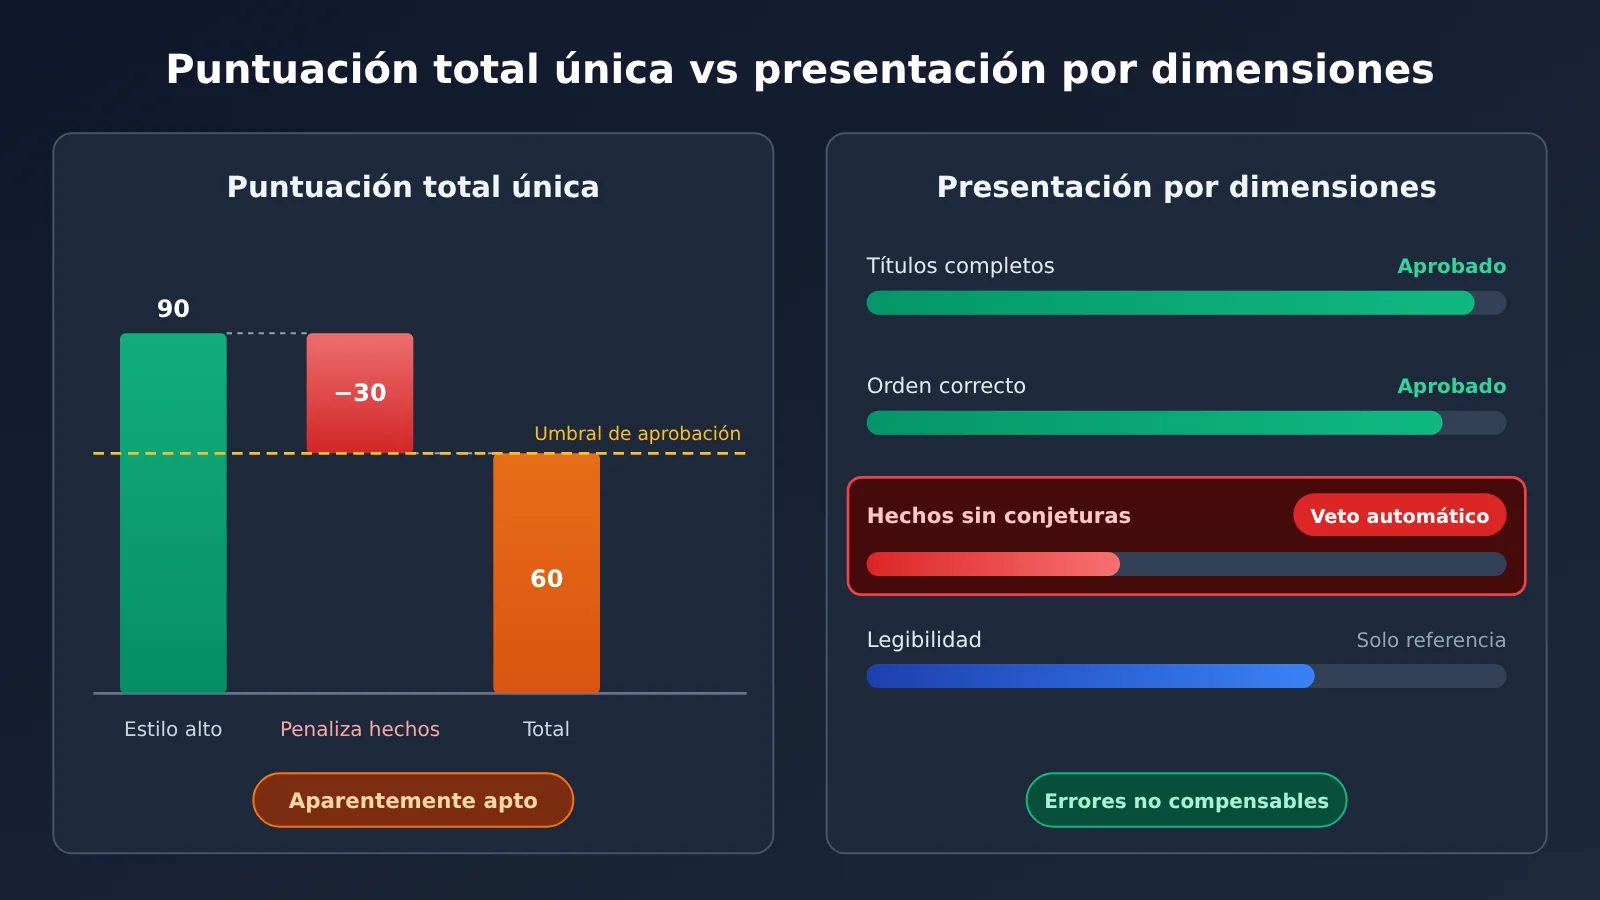
Si se combinan todas las aserciones en una puntuación total, un artículo con redacción fluida pero con especulaciones en el apartado de hechos podría obtener una puntuación parecida a la de un artículo bien estructurado pero algo plano. Para contenido periodístico, esa «compensación mutua» es peligrosa. Por eso se recomienda informar por dimensiones separadas y convertir las dimensiones factuales en un veto absoluto.
| Dimensión de evaluación | Método de comprobación | Forma de presentación | ¿Puede compensarla otra dimensión? |
|---|---|---|---|
| Títulos obligatorios completos | contains | Tasa de aprobación | No, es un requisito estricto |
| Orden de secciones correcto | JavaScript | Tasa de aprobación | No, es un requisito estricto |
| Apartado de hechos sin especulaciones | llm-rubric + revisión manual | Tasa de aprobación + lista de frases problemáticas | No, veto absoluto |
| Expresión y legibilidad | llm-rubric | Se muestra por separado | Solo como referencia, no participa en la compensación |
Cuando solo se cambian las reglas de puntuación de Promptfoo, reevaluar directamente las salidas anteriores
Durante las iteraciones de evaluación, lo que suele cambiar con más frecuencia son las reglas de puntuación, no la plantilla en sí. Por ejemplo, cuando se descubre que la descripción de la rúbrica no es lo bastante clara, o que una aserción de posición omitió algún caso límite. En ese momento, ni la plantilla ni las salidas han cambiado, así que no tiene sentido volver a generarlas.
Gracias a la capacidad de Promptfoo de ejecutar archivos de aserciones independientes sobre salidas ya existentes, se puede separar por completo la generación de la puntuación: generar una vez, guardar las salidas y, después, en cada ajuste de reglas, volver a ejecutar solo las aserciones. Esto ahorra tiempo y garantiza que las dos rondas de puntuación se enfrenten exactamente al mismo texto, lo que hace que la comparación tenga sentido.
Límites y costos del modelo juez de Promptfoo
Hay tres puntos que conviene dejar claros para no sobreinterpretar los resultados de la evaluación:
- La puntuación del modelo juez no puede demostrar que algo sea factualmente correcto. llm-rubric solo indica que, a ojos del modelo de puntuación, la salida cumple la rúbrica; la verificación de hechos sigue exigiendo volver a las fuentes originales.
- Que contains pase solo significa que se encontró el texto literal. Indica que el título está presente, no que la calidad del párrafo debajo de ese título sea adecuada.
- La evaluación con modelos de pago tiene costos. Las aserciones basadas en reglas prácticamente no generan llamadas adicionales al modelo, pero llm-rubric llama al modelo de puntuación por cada salida evaluada; por eso, no se puede decir que todo el conjunto de evaluación sea «totalmente gratuito».
Con estos límites presentes, nuestra postura es clara: las aserciones deterministas encajan como «umbral», la puntuación del modelo como «filtro inicial», y la revisión humana es la base final de las conclusiones factuales. Los tres tienen responsabilidades distintas y no pueden sustituirse entre sí.
Direcciones que merecen atención en el futuro
Las siguientes son líneas de observación que aún no se han validado; se incluyen únicamente como sugerencias para futuros experimentos:
- Consistencia del modelo de puntuación. Si al puntuar varias veces una misma salida las conclusiones se mantienen estables, y si al cambiar a otro modelo de puntuación las conclusiones se invierten. Si no hay estabilidad, la escala debe redactarse de forma más concreta.
- Grado de coincidencia entre la revisión manual por muestreo y la puntuación del modelo. Esto determina hasta qué punto se puede confiar en llm-rubric para hacer un filtro inicial.
- Si el tamaño de la muestra es suficiente. Cuando solo se comparan unos pocos artículos, factores aleatorios pueden ocultar diferencias entre plantillas; se necesitan suficientes datos de entrada para llegar a conclusiones significativas.
Antes de contar con datos empíricos sobre estas cuestiones, cualquier afirmación del tipo «qué tasa de victorias tiene la nueva plantilla» o «cuánto mejora la puntuación» debe tratarse con cautela. Este artículo evita deliberadamente dar ese tipo de cifras, y esa es precisamente la razón.
Lo que se aprende en el papel siempre sabe a poco; para dominar de verdad un asunto, hay que ponerlo en práctica. —Lu You, «Leyendo de noche para instruir a mi hijo Ziyu»