Hinweis des Autors: Dieser Test beleuchtet die GPT-6 Luna Decisions API aus vier Blickwinkeln – Funktionsprinzip, Messmethodik, Latenzkennzahlen und Geschäftsszenarien. Damit kannst du einschätzen, ob „entscheidungsbasierte Aufrufe“ schneller sind als normale Modellaufrufe und ob sie besser zu deinem Business passen.
Seit die Decisions API von GPT-6 Luna offiziell an den Start gegangen ist, diskutieren Entwickler vor allem eine Frage: Wie viel schneller ist sie wirklich im Vergleich zum normalen Modellaufruf, und für welche Workloads lohnt sich die Umstellung? Dieser Artikel bewertet die Kernfunktionen der GPT-6 Luna Decisions API aus der Praxis heraus – inklusive der Ursachen für die Geschwindigkeitsvorteile, einer nachvollziehbaren Testmethodik und typischen Einsatzszenarien.
Das hier ist keine Nacherzählung der offiziellen Marketingtexte. Je nach Account, Region, Parallelität und Eingabeaufforderung können die Latenzunterschiede deutlich auseinanderliegen. Deshalb nennt dieser Artikel bewusst keinen „festen Faktor“, der dich in die Irre führen könnte, sondern liefert ein reproduzierbares Testskript plus Beurteilungskriterien – damit du mit deinen eigenen Business-Daten zu einem belastbaren Ergebnis kommst.
Der Kernnutzen: Nach der Lektüre kannst du mit einem einzigen Python-Skript den Latenzunterschied zwischen der GPT-6 Luna Decisions API und einem normalen Aufruf quantifizieren und entscheiden, ob sie für deine entscheidungsnahen Workloads wie Klassifizierung, Routing, Moderation und Risikoprüfung geeignet ist.
🎯 Hinweis zur Messung: Der gesamte Code in diesem Artikel basiert auf einer OpenAI-kompatiblen Schnittstelle und lässt sich direkt über APIYI apiyi.com ausführen. Konkrete Modell-IDs, Schnittstellenparameter und die Abrechnung richten sich nach der offiziellen Dokumentation und der Plattform-Konsole.
Kernfunktionen der GPT-6 Luna Decisions API
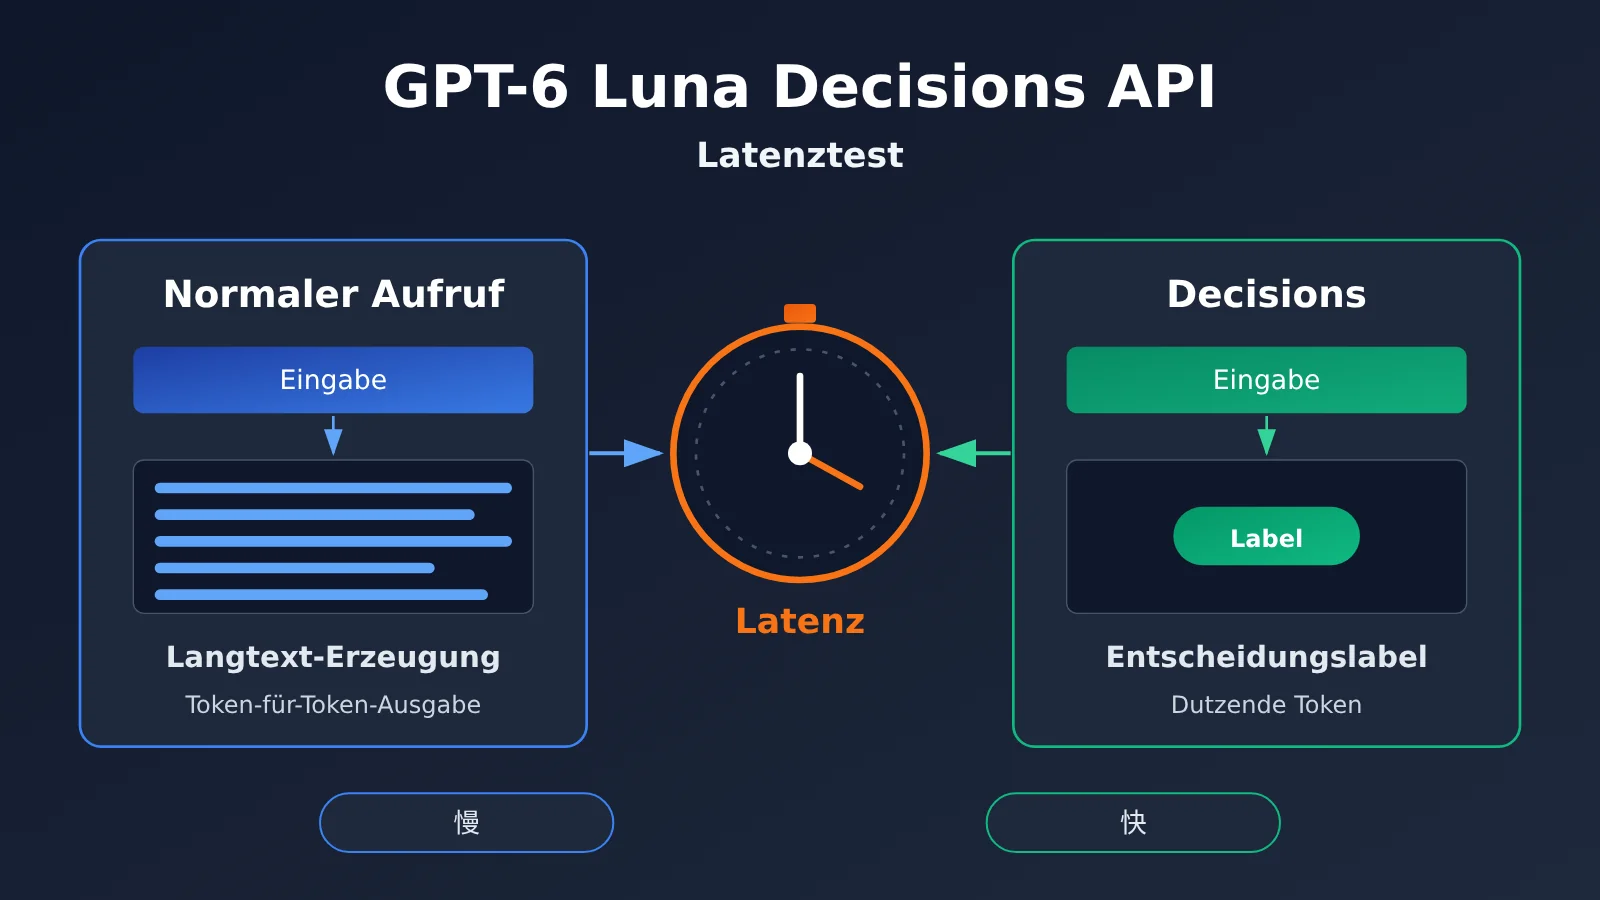
Bevor Sie die Decisions API verstehen, sollten Sie den grundlegenden Unterschied zu normalen Dialogaufrufen kennen. Bei einem normalen Aufruf geht es darum, „einen Inhalt zu erzeugen“; bei einem entscheidungsorientierten Aufruf geht es darum, „innerhalb einer begrenzten Anzahl von Optionen eine Entscheidung zu treffen“. Die beiden Aufgabentypen unterscheiden sich völlig in Ausgabelänge, Formatvorgaben und Latenzstruktur.
| Punkt | Beschreibung | Nutzen für Entwickler |
|---|---|---|
| Entscheidungsorientierte Ausgabe | Die Ausgabe konzentriert sich auf strukturierte Ergebnisse wie Labels, Optionen oder Scores statt auf langen Text | Ergebnisse können direkt von Programmen verarbeitet werden, ohne sie erneut zu parsen |
| Kurze Ausgabelänge | Ein typisches Entscheidungsergebnis umfasst nur einige Dutzend Token, deutlich weniger als bei normalen Generierungsaufgaben | Die Gesamtantwortzeit hängt hauptsächlich vom ersten Token und der Eingabeverarbeitung ab |
| Formatvorgaben möglich | Lässt sich mit strukturierten Ausgabevorgaben wie JSON Schema kombinieren | Senkt die Fehlerquote beim Format und reduziert Wiederholungsversuche |
| Für häufige Aufrufe geeignet | Anfragen wie Routing, Klassifizierung oder Moderation sind oft zahlreich und pro Anfrage einfach | Optimierungen bei Latenz und Kosten fallen stärker ins Gewicht |
Unterschiede zwischen Decisions API und normalen Aufrufen
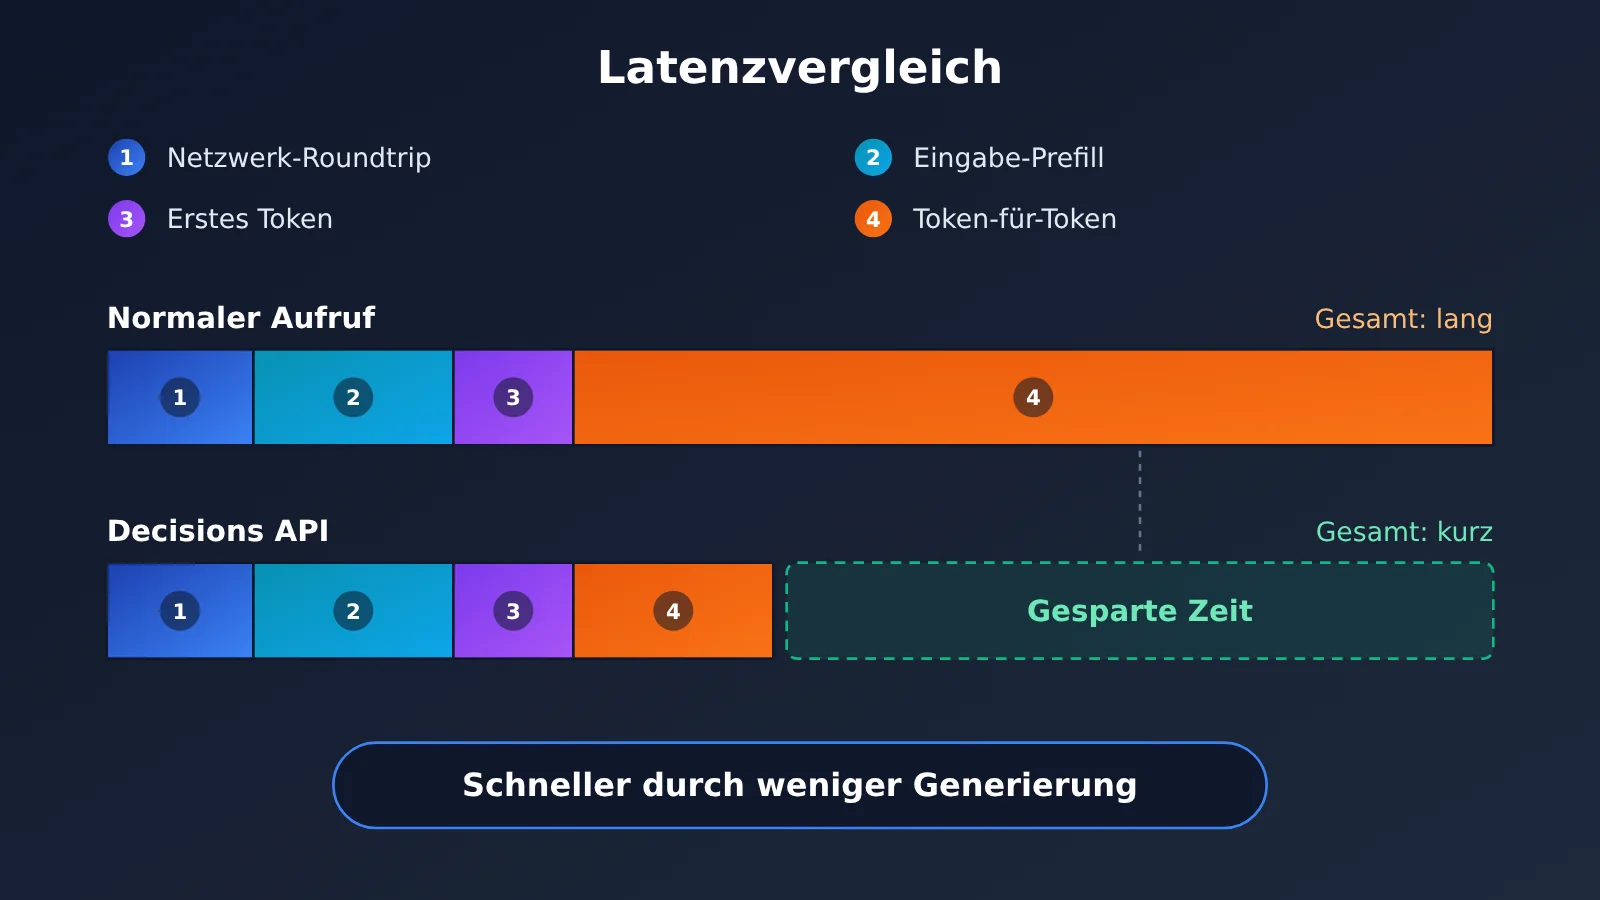
Aus technischer Sicht setzt sich die Gesamtlaufzeit eines normalen Modellaufrufs grob aus drei Teilen zusammen: Netzwerk-Roundtrip, Eingabeverarbeitung (Prefill) und tokenweise Generierung. Bei generativen Aufgaben macht der dritte Teil oft den größten Anteil aus – je länger die Ausgabe, desto langsamer.
Entscheidungsorientierte Aufrufe komprimieren die Ausgabe auf ein strukturiertes Ergebnis, wodurch die Generierungsphase deutlich kürzer wird. Das bedeutet: Die Geschwindigkeitsvorteile der GPT-6 Luna Decisions API kommen vor allem daher, dass weniger generiert wird – nicht daher, dass schneller generiert wird. Wenn Ihr Anwendungsfall von Natur aus langen Text benötigt, ist diese Schnittstelle nicht für Sie gedacht.
Woher die Beschleunigung der Decisions API kommt
Entscheidungsorientierte Schnittstellen bringen in der Regel noch in zwei weiteren Bereichen Vorteile. Erstens ist das Format festgelegt: Programme müssen Antworten nicht mit regulären Ausdrücken aus natürlicher Sprache heraussuchen, und die Wahrscheinlichkeit von Wiederholungsversuchen nach Fehlern sinkt. Zweitens lässt sich der Inferenzprozess steuern: Wenn das Modell die Inferenzintensität anpassen kann, benötigen Entscheidungsszenarien oft keine langen Gedankenketten, was die Wartezeit weiter verkürzt.
Wichtig ist: Dies sind Analysen auf Mechanismenebene. Wie stark die tatsächliche Beschleunigung ausfällt, hängt von Ihrer bisherigen Ausgabelänge ab. Wenn das Modell bisher nur ein Wort zurückgeben musste, ist der Gewinn nach dem Wechsel sehr begrenzt. Wenn es bisher „zuerst erklären und dann das Fazit nennen“ musste, ist der Gewinn deutlich spürbar.
GPT-6 Luna Decisions API: Schnellstart
Minimalbeispiel
Das Folgende ist ein Minimalbeispiel, das mit strukturierter Ausgabe eine einzelne Entscheidungsanfrage ausführt. Ersetzen Sie den Modellnamen durch die tatsächliche Modell-ID von GPT-6 Luna, die Ihnen in der Plattformkonsole angezeigt wird.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible Schnittstelle von APIYI
)

resp = client.chat.completions.create(
    model="gpt-6-luna",  # maßgeblich ist der tatsächliche Name in der Modellliste der Konsole
    messages=[{"role": "user", "content": "Ticketinhalt: Meine Rechnung wurde falsch ausgestellt. Bitte bestimmen Sie die zuständige Abteilung."}],
    response_format={"type": "json_object"},
    max_tokens=50
)
print(resp.choices[0].message.content)
Der Kern dieses Codes liegt bei max_tokens und response_format: Ersteres begrenzt die Obergrenze der Ausgabe, Letzteres stellt sicher, dass das Ergebnis vom Programm ausgewertet werden kann. Genau diese beiden Parameter sind der Schlüssel zur Geschwindigkeitssteigerung bei entscheidungsorientierten Aufrufen.
Vollständiges Benchmark-Skript anzeigen (Latenzvergleich zwischen normalem Aufruf und Entscheidungsaufruf)
import time
import json
import statistics
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Aufruf über die einheitliche Schnittstelle von APIYI
)

MODEL = "gpt-6-luna"  # maßgeblich ist die tatsächliche Modell-ID in der Konsole; falls es ein eigenes Decisions-Modell/-Interface gibt, hier ersetzen

SAMPLES = [
    "Meine Rechnung ist falsch ausgestellt, kann sie neu ausgestellt werden?",
    "Bei der App-Anmeldung wird ständig ein Fehler beim Bestätigungscode angezeigt",
    "Ich möchte den Tarif von monatlicher auf jährliche Zahlung umstellen",
    "Die Bestellung zeigt 'zugestellt' an, aber ich habe sie nicht erhalten",
]

DECISION_SCHEMA = {
    "type": "json_schema",
    "json_schema": {
        "name": "route",
        "schema": {
            "type": "object",
            "properties": {
                "department": {"type": "string", "enum": ["finance", "tech", "sales", "logistics"]},
                "confidence": {"type": "number"}
            },
            "required": ["department", "confidence"]
        }
    }
}

def timed_call(prompt: str, mode: str) -> dict:
    """Gibt die Zeit bis zum ersten Token, die Gesamtdauer und die Ausgabelänge zurück"""
    kwargs = dict(model=MODEL, stream=True)
    if mode == "generate":
        kwargs["messages"] = [{"role": "user", "content": f"Bitte analysieren Sie das folgende Ticket und erläutern Sie, welche Abteilung es bearbeiten sollte und warum: {prompt}"}]
    else:
        kwargs["messages"] = [{"role": "user", "content": f"Ticket: {prompt}. Geben Sie nur die Abteilungsentscheidung aus."}]
        kwargs["response_format"] = DECISION_SCHEMA
        kwargs["max_tokens"] = 60

    start = time.perf_counter()
    ttft, chunks = None, []
    for event in client.chat.completions.create(**kwargs):
        delta = event.choices[0].delta.content if event.choices else None
        if delta:
            if ttft is None:
                ttft = time.perf_counter() - start
            chunks.append(delta)
    total = time.perf_counter() - start
    return {"ttft": ttft or total, "total": total, "chars": len("".join(chunks))}

def bench(mode: str, rounds: int = 5) -> dict:
    results = [timed_call(p, mode) for _ in range(rounds) for p in SAMPLES]
    totals = sorted(r["total"] for r in results)
    return {
        "mode": mode,
        "ttft_avg": round(statistics.mean(r["ttft"] for r in results), 3),
        "total_p50": round(totals[len(totals) // 2], 3),
        "total_p95": round(totals[int(len(totals) * 0.95) - 1], 3),
        "avg_chars": round(statistics.mean(r["chars"] for r in results), 1),
    }

if __name__ == "__main__":
    for m in ("generate", "decision"):
        print(json.dumps(bench(m), ensure_ascii=False))
Das Skript verwendet Streaming-Ausgabe, sodass sowohl die Zeit bis zum ersten Token (TTFT) als auch die Gesamtdauer erfasst werden. Führen Sie jeden Modus mindestens 20 Mal aus und wechseln Sie die Modi innerhalb desselben Zeitraums ab, um Verzerrungen durch Netzwerkschwankungen zu vermeiden.
🚀 Schnellstart: Die offizielle Empfehlung: Fordern Sie zuerst bei APIYI apiyi.com ein kostenloses Testkontingent für neue Nutzer an, lassen Sie das obige Skript einmal mit Ihren eigenen echten Arbeitslast-Stichproben laufen und entscheiden Sie dann, ob Sie die GPT-6 Luna Decisions API in die Produktionsumgebung integrieren.
GPT-6 Luna Decisions API: Messdaten aus der Praxis
Auf die Frage „Wie viel schneller als ein normaler Aufruf?“ gibt es keine pauschale Antwort. Deshalb liefert dieser Abschnitt einen reproduzierbaren Testrahmen. Nur wenn Sie die folgenden Umgebungsbedingungen und Kennzahlen einhalten, können Ihre Zahlen wirklich als Grundlage für Geschäftsentscheidungen dienen.
Testumgebung konfigurieren
| Konfiguration | Empfohlene Einstellung | Beschreibung |
|---|---|---|
| Aufrufendpunkt | OpenAI-kompatible Schnittstelle (base_url verweist auf ein einheitliches Gateway) | Stellt sicher, dass beide Modi über denselben Netzwerkpfad laufen |
| Beispieldaten | 20–100 echte Geschäftsanfragen | Mit synthetischen Daten gemessene Latenzen sind oft zu optimistisch |
| Aufrufmodus | stream=True |
Nur so lässt sich die Zeit bis zum ersten Token messen |
| Parallelität | Zuerst seriell (eine Anfrage), dann schrittweise bis zur geschäftlichen Spitzenlast | Latenzschwankungen unter hoher Parallelität beobachten |
| Zeitfenster | Jeweils eine Runde während der Spitzen- und der Nebenzeiten an Werktagen | Zeitabhängige Lastunterschiede ausschließen |
Zentrale Latenzkennzahlen
| Kennzahl | Bedeutung | Bewertungskriterium |
|---|---|---|
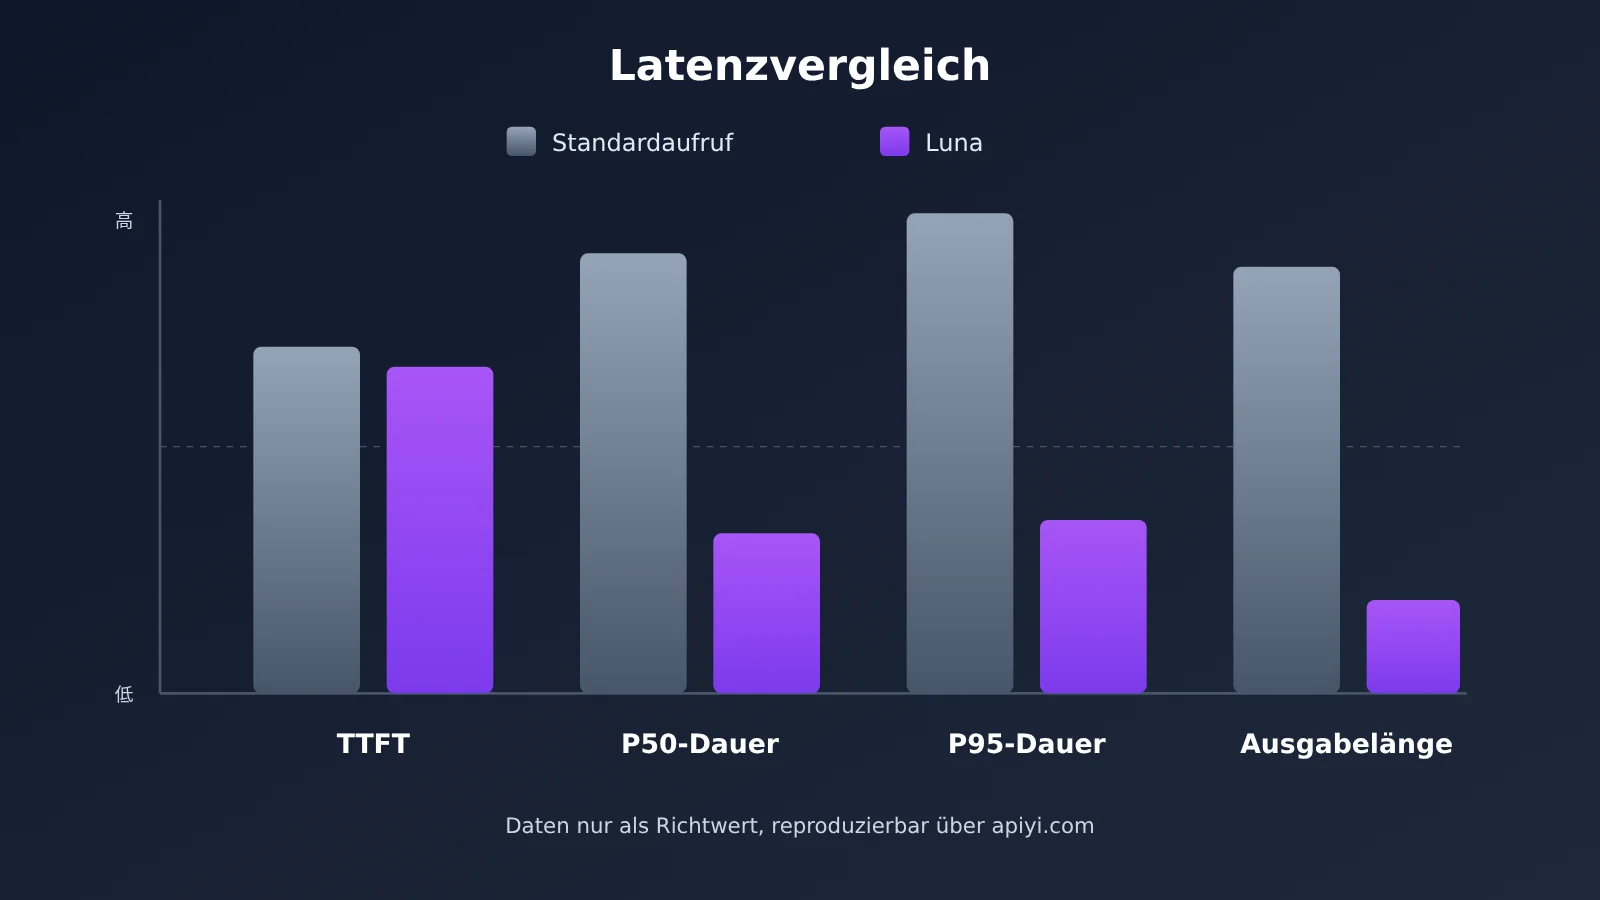
| TTFT – Zeit bis zum ersten Token | Von der Anfrage bis zum Empfang des ersten Zeichens | Bei beiden Modi meist ähnlich; hängt vor allem von der Eingabelänge ab |
| P50-Gesamtdauer | Zeit, in der die Hälfte der Anfragen abgeschlossen ist | Zentrale Kennzahl für den Vorteil des Decisions-Modus; je größer der Unterschied, desto eher lohnt der Wechsel |
| P95-Gesamtdauer | Dauer der Anfragen im langen Tail | Bestimmt die Untergrenze der Nutzererfahrung; für Online-Dienste unverzichtbar |
| Durchschnittliche Ausgabelänge | Anzahl Zeichen oder Token pro Antwort | Erklärt die Geschwindigkeitsgewinne und steht direkt mit den Kosten in Zusammenhang |
| Format-Erfolgsquote | Anteil der Antworten, die direkt geparst werden können | Fehlgeschlagene Wiederholungen fressen die eingesparte Zeit wieder auf |
So interpretieren Sie die Ergebnisse des Decisions-API-Tests
Wenn Sie feststellen, dass die TTFT bei beiden Modi nahezu gleich ist, die P50-Gesamtdauer aber deutlich abweicht, dann kommt die Beschleunigung tatsächlich daher, dass „weniger generiert“ wird – das ist das Ergebnis, das den Erwartungen am ehesten entspricht. Vergleichen Sie in diesem Fall zusätzlich die durchschnittliche Ausgabelänge: Je größer der Unterschied, desto beträchtlicher sind die eingesparte Zeit und die eingesparten Ausgabekosten.
Wenn der P50-Unterschied gering, der P95-Unterschied aber deutlich ist, wird der lange Tail bei normalen Aufrufen vor allem durch gelegentliche sehr lange Ausgaben verursacht. In diesem Fall kann ein Wechsel zu GPT-6 Luna Decisions API die Stabilität von Online-Diensten deutlich verbessern, auch wenn der Durchschnitt keine auffällige Verbesserung zeigt.
Ein weiterer Fall ist, dass sich beide Modi kaum unterscheiden. Das bedeutet meist, dass Ihre bisherigen Eingabeaufforderungen bereits sehr knapp gefasst sind. Dann liegt der Wert eines Wechsels vor allem in der Formatzuverlässigkeit, nicht in der Geschwindigkeit.
💡 Validierungsempfehlung: Testen Sie dieselbe Stichprobe abwechselnd über dasselbe Gateway. Wir empfehlen, den Vergleich direkt über die einheitliche Schnittstelle von APIYI apiyi.com durchzuführen, damit die Ergebnisse nicht durch unterschiedliche Netzwerkausgänge verfälscht werden.
Für welche Geschäftsfelder eignet sich die GPT-6 Luna Decisions API?
Der Wert einer Entscheidungs-API liegt nicht darin, dass ein einzelner Aufruf ein paar Hundert Millisekunden schneller ist. Der Wert liegt in Szenarien mit hoher Frequenz, einfachen Aufgaben und Ergebnissen, die programmatisch weiterverarbeitet werden – dort summieren sich diese Millisekunden über Tausende von Anfragen. Die folgende Tabelle zeigt, wie gut fünf typische Geschäftsfelder dazu passen.
| Geschäftsszenario | Typische Ausgabe | Eignung | Erläuterung |
|---|---|---|---|
| Routing von Support-Tickets | Abteilungs-Label + Konfidenz | Hoch | Hohes Anfragevolumen, feste Auswahloptionen – Zeitgewinn und Formatvorteil fallen gleichermaßen deutlich aus |
| Prüfung von Inhalten auf Sicherheit | Freigeben / Ablehnen / Manuelle Prüfung | Hoch | Empfindlich gegenüber P95-Latenz, Ergebnisse müssen den Prozess direkt steuern |
| Werkzeugauswahl im Agenten | Welches Tool mit welchen Parametern aufgerufen wird | Hoch | In mehrstufigen Agenten spart jeder Schritt Zeit, die Effekte addieren sich |
| Erstprüfung bei Risiko- und Betrugskontrolle | Risikostufe | Mittel | Geeignet als erste Filterstufe, kritische Entscheidungen brauchen weiterhin Regeln oder einen menschlichen Fallback |
| Langtext-Erstellung / Berichtsgenerierung | Umfangreiche natürliche Sprache | Niedrig | Erfordert naturgemäß lange Ausgaben, kein Zielszenario für eine Entscheidungs-API |
Vergleich: Decisions API und andere Entscheidungsansätze
Für Entscheidungsaufgaben ist ein großes Sprachmodell nicht die einzige Option. Die folgende Tabelle stellt die GPT-6 Luna Decisions API einigen gängigen Ansätzen gegenüber.
| Ansatz | Kernmerkmal | Geeignete Szenarien | Latenzniveau | Verfügbare Plattformen |
|---|---|---|---|---|
| GPT-6 Luna Decisions API | Sprachverständnis eines großen Modells + strukturierte kurze Ausgaben | Entscheidungen mit komplexer Semantik und klarem Optionsraum | Niedrig (Eigenmessung maßgeblich) | APIYI apiyi.com, offizielle API |
| Gewöhnlicher generativer Aufruf | Flexibel, kann Begründungen mitliefern | Seltene Entscheidungen, bei denen eine Begründung nötig ist | Mittel bis hoch, steigt mit der Ausgabelänge | Etablierte Plattformen für große Sprachmodelle |
| Klassifikation mit kleinen, leichten Modellen | Günstig und schnell, aber begrenztes Sprachverständnis | Klassifikation mit einfacher Semantik und ausreichend Labels | Niedrig | Etablierte Plattformen für große Sprachmodelle oder Selbst-Hosting |
| Regel-Engine | Millisekundenbereich, vollständig kontrollierbar | Klare, nahezu unveränderliche Bedingungen | Sehr niedrig | Selbst betrieben |
Benchmark-Analyse: Bei Geschwindigkeit und Kontrollierbarkeit bleibt die Regel-Engine vorn. Sobald die Eingaben aber umgangssprachlich und sprachlich variabel werden, steigen die Pflegekosten der Regeln sprunghaft an. Kleine, leichte Modelle punkten klar beim Preis, verstehen jedoch unscharfe Semantik und lange Kontexte zu wenig. Die GPT-6 Luna Decisions API eignet sich dagegen besser für Szenarien, in denen die Semantik komplex, der Antwortraum aber begrenzt ist – ein Kompromiss zwischen Regeln und gewöhnlichen Aufrufen großer Modelle.
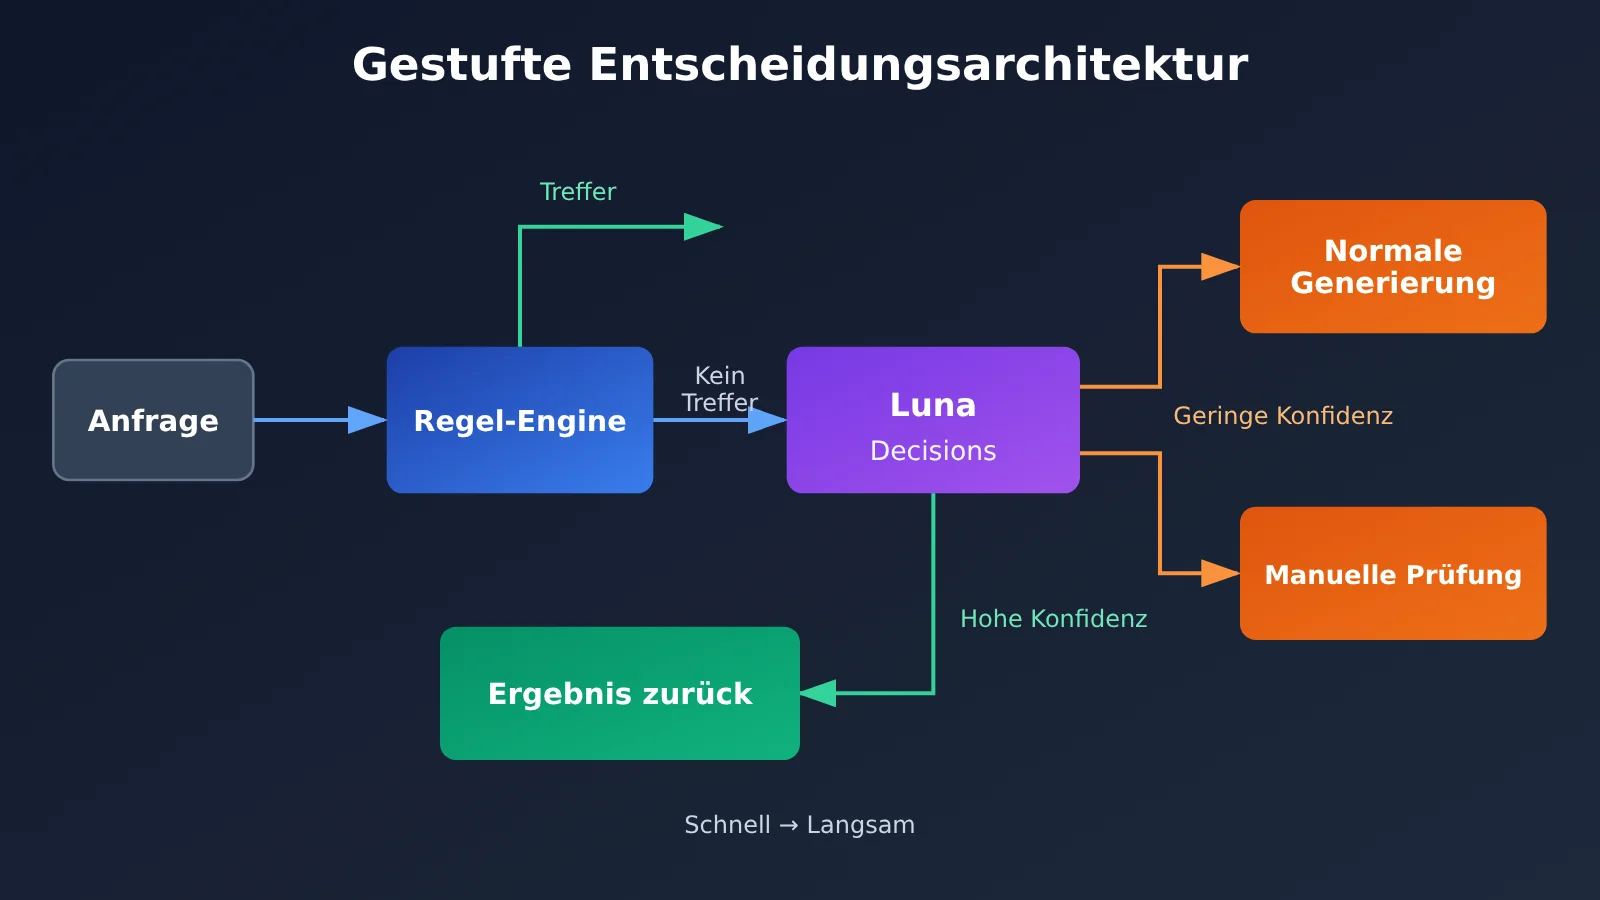
In der Praxis hat sich eine geschichtete Architektur bewährt: Die Regel-Engine übernimmt eindeutige Bedingungen, die GPT-6 Luna Decisions API kümmert sich um unscharfe Anfragen, und nur wenn eine Begründung nötig ist, wird auf einen gewöhnlichen generativen Aufruf zurückgegriffen.
GPT-6 Luna Decisions API – Vor- und Nachteile
Vorteile
- Gesamtlaufzeit besser kontrollierbar: Die Ausgabe wird auf strukturierte Ergebnisse komprimiert, wodurch die Generierungsphase deutlich schneller wird und auch die Tail-Latenz stabiler bleibt.
- Ergebnisse direkt weiterverarbeitbar: In Kombination mit JSON Schema lassen sich Rückgabewerte direkt in Geschäftsprozesse einbinden. Das reduziert Parsing-Code und Wiederholungsversuche bei Fehlern.
- Günstigere Kostenstruktur: Weniger Ausgabe-Token bedeuten auch geringere Ausgabekosten – besonders deutlich in Szenarien mit hoher Aufruffrequenz.
- Geringe Einstiegshürde: Dank OpenAI-kompatiblern Protokoll muss vorhandener Code in der Regel nur um den Modellnamen und die Ausgabevorgaben angepasst werden.
Einschränkungen
- Erklärt wenig: Das Entscheidungsergebnis enthält keine Begründung. Wenn eine Prüfung erforderlich ist, kann für Stichproben mit geringer Konfidenz zusätzlich ein normaler Aufruf zur Ergänzung der Erklärung gestartet werden.
- Geschwindigkeitsgewinn variiert je nach Szenario: Wenn der bisherige Aufruf ohnehin nur ein Label ausgibt, ist der Nutzen begrenzt. Es empfiehlt sich, den Effekt zunächst mit einem Evaluierungsskript zu quantifizieren, bevor migriert wird.
- Eingabelänge bleibt ein Engpass: Die Entscheidungs-API optimiert die Ausgabeseite. Die Prefill-Zeit bei sehr langem Kontext verschwindet dadurch nicht. Bei Bedarf sollte die Eingabe vorher gekürzt oder per Retrieval komprimiert werden.
- Hängt von der Qualität der Optionsgestaltung ab: Unklare Enum-Werte führen dazu, dass das Modell zwischen ähnlichen Optionen schwankt. Im Schema sollten klare, sich gegenseitig ausschließende Optionen definiert werden.
Häufige Fragen (FAQ)
Q1: Was ist die GPT-6 Luna Decisions API?
Sie ist ein Aufrufmodus für Entscheidungsaufgaben. Im Kern geht es darum, dass das Modell aus vorgegebenen Optionen eine kurze, strukturierte Bewertung ausgibt, statt langen Text zu generieren. Geeignet für Klassifizierung, Routing, Moderation und Tool-Auswahl. Die konkreten Parameter findest du in der offiziellen Dokumentation.
Q2: Wie viel schneller ist die Decisions API im Vergleich zu einem normalen Modellaufruf?
Einen pauschalen Faktor gibt es nicht. Der Geschwindigkeitsgewinn entsteht vor allem durch die kürzere Ausgabe – je länger die bisherige Ausgabe war, desto größer der Nutzen nach dem Umstieg. Am besten nutzt du das Messskript aus diesem Artikel und vergleichst auf deinen echten Samples die Gesamtlaufzeit bei P50 und P95, um eine belastbare Aussage für dein Geschäftsmodell zu bekommen.
Q3: Worin unterscheidet sich die GPT-6 Luna Decisions API von einem normalen Aufruf mit JSON-Ausgabe?
Ein normaler Aufruf mit JSON-Constraint kann einen ähnlichen Effekt erzielen. Wie groß der Unterschied ist, hängt davon ab, ob der Anbieter spezielle Optimierungen für Entscheidungsszenarien vorgenommen hat – etwa bei der Inferenzintensität, den Ausgaberestriktionen oder der Service-Planung. Die verlässlichste Einschätzung liefert weiterhin ein direkter Praxistest unter gleichen Bedingungen.
Q4: Welche Geschäftsprozesse sollte man zuerst umstellen?
Priorisiere Anwendungen mit hohem Anfragevolumen, festem Antwortraum und hoher Latenzempfindlichkeit – etwa Routing von Support-Tickets, Content-Moderation oder die Tool-Auswahl in Agents. Anwendungen, die von Natur aus lange Ausgaben brauchen, wie das Schreiben langer Texte oder die Erstellung von Berichten, solltest du nicht umstellen.
Q5: Wie rufe ich die GPT-6 Luna Decisions API schnell über die API auf?
Empfohlenes Vorgehen:
1. Registriere dich bei APIYI auf apiyi.com und hole dir einen API-Schlüssel
2. Prüfe in der Modellliste der Konsole die tatsächliche Modell-ID von GPT-6 Luna
3. Setze im Code aus diesem Artikel die `base_url` auf `https://api.apiyi.com/v1` und ersetze den Modellnamen, dann ausführen
Die Plattform nutzt eine OpenAI-kompatible Schnittstelle – mit einem einzigen Schlüssel kannst du parallel andere gängige Modelle für Vergleichstests aufrufen.
Q6: Wie lassen sich die Kosten der Decisions API im Griff behalten?
Entscheidungsorientierte Ausgaben sparen schon von sich aus Ausgabe-Token. Für weitere Optimierung gibt es drei Ansatzpunkte: unnötigen Kontext kürzen, eindeutige Anfragen mit einer Regel-Engine abfangen und nur Samples mit geringer Konfidenz ein zweites Mal aufrufen. In der Konsole von APIYI auf apiyi.com kannst du die Nutzung pro Modell einsehen und so die größten Kostenverursacher identifizieren.
Q7: Welche bekannten Einschränkungen hat die GPT-6 Luna Decisions API?
Die wichtigsten Einschränkungen: Es werden keine Begründungen für Entscheidungen geliefert, der Geschwindigkeitsvorteil hängt von der bisherigen Ausgabelänge ab, und die Prefill-Zeit bei sehr langen Eingaben lässt sich nicht beseitigen. Bei risikoreichen Entscheidungen in Finanzen oder Medizin solltest du sie als unterstützende Einschätzung einsetzen und eine menschliche Prüfung beibehalten.
GPT-6 Luna Decisions API – die wichtigsten Punkte
- Klare Positionierung: Die Decisions API löst das Problem, „aus einer begrenzten Auswahl schnell eine Entscheidung zu treffen“ – nicht das Generieren langer Texte.
- Woher die Geschwindigkeit kommt: Hauptsächlich durch kürzere Ausgaben. Je länger die bisherige Ausgabe war, desto deutlicher der Gewinn beim Umstieg.
- Entscheidende Kennzahlen: Achten Sie vor allem auf die Gesamtlaufzeit bei P50 und P95. Die TTFT ist in beiden Modi in der Regel ähnlich.
- Beste Einsatzfelder: Häufige Entscheidungsaufgaben wie Ticket-Routing, Content-Moderation oder die Werkzeugauswahl bei Agenten.
- Empfohlene Architektur: Eine gestaffelte Absicherung aus Regel-Engine + Decisions API + normalem Modellaufruf als Fallback.
- So starten Sie: Vergleichsskripte über die einheitliche OpenAI-kompatible Schnittstelle laufen lassen und erst nach eigenen Messwerten migrieren.
Fazit
Die Kernpunkte der GPT-6 Luna Decisions API:
- Schnell durch weniger Generierung: Der Geschwindigkeitsvorteil kommt vor allem aus strukturierten, kurzen Ausgaben – nicht aus einer höheren Generierungsgeschwindigkeit pro Token.
- Der Nutzen hängt vom Szenario ab: Am meisten profitieren Business-Prozesse mit hoher Frequenz, festen Optionen und hoher Latenzempfindlichkeit. Für Langtext-Szenarien ist sie nicht geeignet.
- Fazit nur mit echten Messwerten: Je nach Eingabeaufforderung und Stichprobe unterscheiden sich die Geschwindigkeitsgewinne stark. Ermitteln Sie P50 und P95 unbedingt anhand realer Daten.
Wenn Sie gerade an Kundenrouting, Content-Moderation oder Agent-Orchestrierung arbeiten, lohnt sich eine sorgfältige Prüfung der GPT-6 Luna Decisions API. Behalten Sie zunächst Ihre bestehenden Aufrufe als Vergleichsgruppe bei, schalten Sie einen Teil des Traffics schrittweise um und entscheiden Sie dann anhand von Latenz und Erfolgsquote bei der Formatierung, ob Sie vollständig migrieren.
Am besten holen Sie sich über APIYI apiyi.com ein kostenloses Kontingent und prüfen mit dem Skript aus diesem Artikel schnell, wie groß der tatsächliche Geschwindigkeitsgewinn in Ihrem Business-Szenario ist.
📚 Weiterführende Ressourcen
- Offizielle OpenAI-API-Dokumentation: Erläuterungen zu Modellaufrufen, Streaming-Ausgabe und strukturierten Ausgaben
- Link:
platform.openai.com/docs -
Hinweis: Autoritative Quelle zur Bestätigung von GPT-6 Luna und den zugehörigen Decisions-Parametern
-
OpenAI Python SDK: Offizieller Python-Client
- Link:
github.com/openai/openai-python -
Hinweis: Das SDK, das in den Testskripten dieses Artikels verwendet wird, inklusive Beispielen für Streaming-Aufrufe
-
JSON-Schema-Spezifikation: Standard zur Definition von Einschränkungen für strukturierte Ausgaben
- Link:
json-schema.org - Hinweis: Referenzspezifikation für die Gestaltung von Entscheidungsoptionen und Enum-Werten
Autor: APIYI Technik-Team
Technischer Austausch: Sie erreichen uns gerne über die Startseite von APIYI. Weitere Integrationsunterlagen finden Sie im Dokumentationszentrum unter docs.apiyi.com