Autorenhinweis: Die Gewichte von MiniMax M3.1 Flash sollen am 23. Oktober veröffentlicht werden. Dieser Artikel erklärt, welche Hardware für den lokalen Betrieb ungefähr erforderlich ist, und vergleicht anhand von vier Kriterien, ob sich der Eigenbetrieb oder der direkte API-Aufruf mehr lohnt.
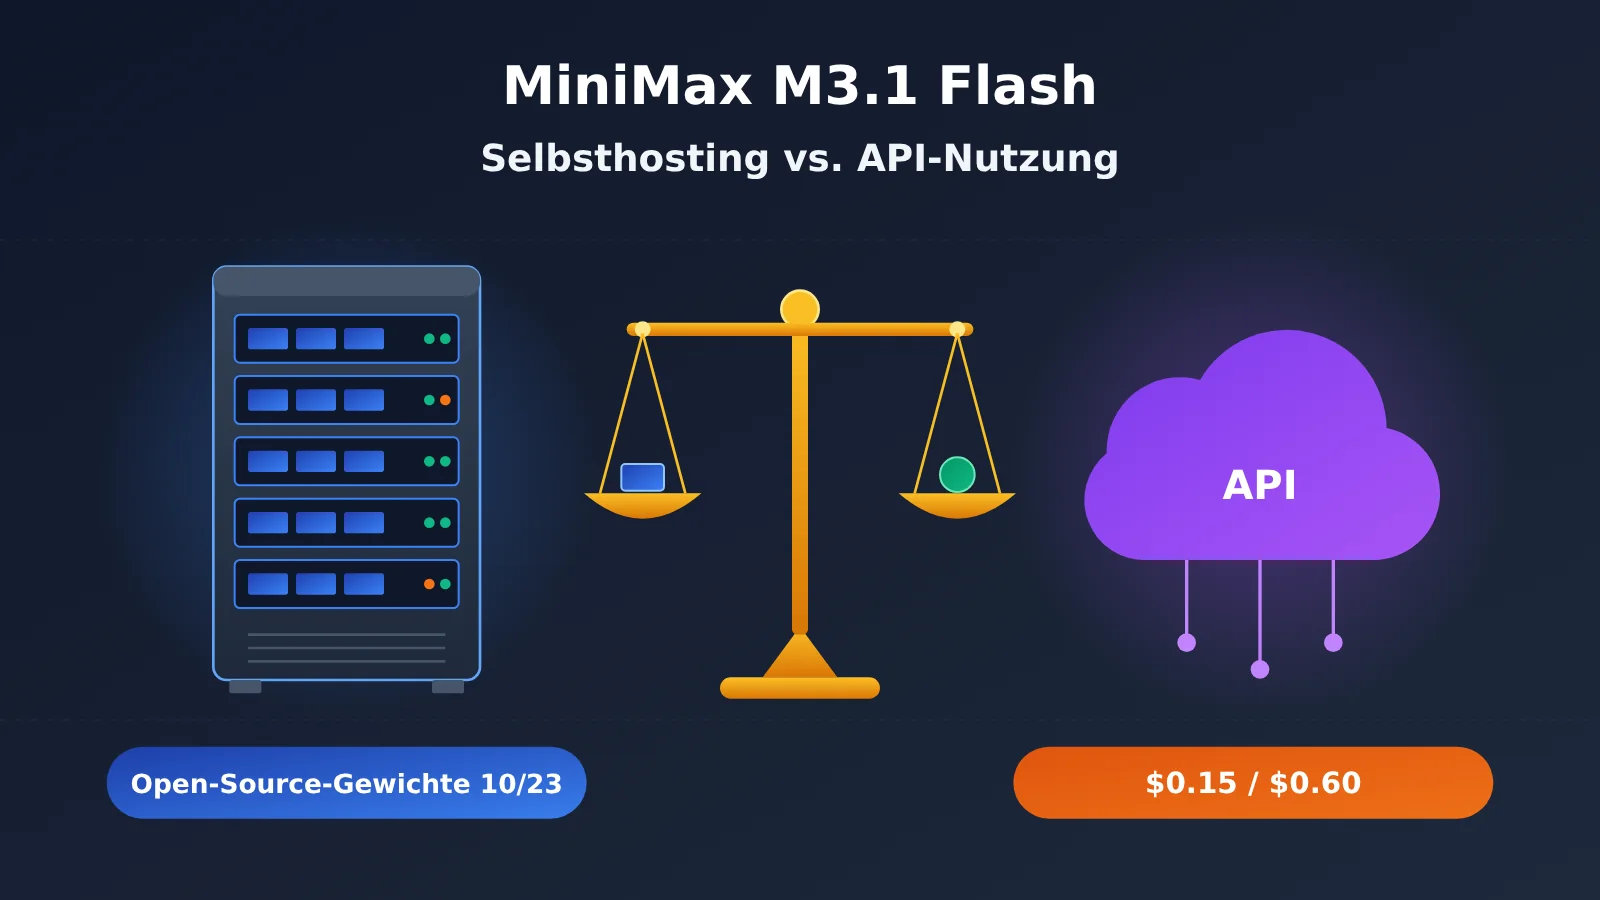
Das Wichtigste vorweg: Für die meisten Einzelentwickler und kleinen Teams ist es deutlich günstiger und einfacher, direkt die API für 0,15 $ pro Million Eingabe-Tokens und 0,60 $ pro Million Ausgabe-Tokens zu nutzen, statt das Modell selbst zu betreiben. Ein selbst gehosteter Betrieb ist nur in drei Fällen eine Überlegung wert: Wenn Daten laut Vorschrift das interne Netzwerk nicht verlassen dürfen, das Anfragevolumen hoch genug ist, um einen Server mit mehreren GPUs dauerhaft auszulasten, oder wenn du das Modell selbst verändern oder feinabstimmen musst.
Dieser Artikel soll nicht von Open Source abraten. Offene Modellgewichte sind für die Branche wertvoll. Aber „herunterladen können“ und „selbst betreiben zu wollen“ sind zwei verschiedene Dinge. Die Veröffentlichungsnachricht zu M3.1 Flash haben wir bereits in einem separaten Artikel behandelt. Hier beantworten wir nur zwei Fragen: Welche Konfiguration ist für den lokalen Betrieb nötig, und was lohnt sich mehr – der Eigenbetrieb oder der API-Aufruf?
Der zentrale Mehrwert: Nach der Lektüre kannst du einschätzen, ob du auf die Gewichte warten solltest und welche Informationen du anschließend zuerst prüfen musst.
Der aktuelle Stand zu den Open-Source-Gewichten von MiniMax M3.1 Flash: Was feststeht und was noch nicht bekannt ist
Zunächst eine Begriffserklärung: Open-Source-Gewichte sind öffentlich bereitgestellte Parameterdateien eines fertig trainierten Modells. Sie können auf den eigenen Server heruntergeladen und dort ausgeführt werden. Das ist nicht dasselbe wie „Open-Source-Code“ und bedeutet auch nicht automatisch, dass das Modell beliebig kommerziell genutzt werden darf. Die zulässige Nutzung hängt von der Lizenz ab.
Zum Veröffentlichungszeitpunkt (22. Oktober 2026) wurden die Gewichte von M3.1 Flash noch nicht offiziell veröffentlicht. In einem Beitrag auf dem offiziellen X-Konto von MiniMax heißt es: „Model weights will arrive on Oct 23“ – die Veröffentlichung ist also für den 23. Oktober geplant. Im offiziellen Blog steht lediglich, dass sie „später“ erscheinen sollen. Laut einem Bericht des RITS der New York University Shanghai gab es außerdem am 20. Oktober noch kein M3.1-Flash-Repository in der Hugging-Face-Organisation von MiniMax.
Um die Verlässlichkeit der Informationen einzuordnen, unterscheidet dieser Artikel drei Kategorien: offizielle Angaben (von MiniMax selbst veröffentlicht), Drittanbieter-Benchmarks (zum Beispiel von Vals AI) und unbekannt/nicht veröffentlicht.
| Information | Aktueller Stand | Informationskategorie |
|---|---|---|
| Veröffentlichung der Gewichte | Laut offiziellem X-Beitrag am 23. Oktober; im offiziellen Blog steht nur „später“ | Offizielle Angaben (geplant, noch nicht umgesetzt) |
| Modellgröße | MoE-Architektur mit insgesamt 428B Parametern, davon etwa 23B aktiviert; wie bei M3 | Offizielle Angaben, über Medienberichte verbreitet |
| Lizenz | Die Lizenz von M3.1 Flash wurde noch nicht bekannt gegeben | Unbekannt/nicht veröffentlicht |
| Hardwareanforderungen für die Bereitstellung | Ein offizieller Bereitstellungsleitfaden für M3.1 Flash liegt noch nicht vor | Unbekannt/nicht veröffentlicht |
| Technischer Bericht | Noch keine Angaben dazu, was sich bei Flash gegenüber M3 geändert hat | Unbekannt/nicht veröffentlicht |
| Vergleichsmodell M3 | Die Gewichte sind seit Juni auf Hugging Face verfügbar und stehen unter einer Community-Lizenz | Offizielle Angaben |
⚠️ Hinweis: Sobald die Gewichte veröffentlicht sind, sind die Lizenzbedingungen, die Dateigröße und die empfohlenen Hardwareanforderungen der offiziellen MiniMax-Modellseite auf Hugging Face zu entnehmen. Von der Community weiterverbreitete quantisierte Versionen wurden nicht offiziell geprüft. Behandeln Sie sie daher nicht als offizielle Konfiguration.
Welche Hardware braucht man für die lokale Bereitstellung von MiniMax M3.1 Flash?
Die offiziellen Hardwareanforderungen für M3.1 Flash wurden noch nicht veröffentlicht. Deshalb spekulieren wir hier nicht über den benötigten Grafikspeicher oder die Anzahl der GPUs. Als Anhaltspunkt dient das Vorgängermodell M3 mit vergleichbarer Größe. Beide Modelle haben insgesamt 428B Parameter und rund 23B aktive Parameter. Anhand des M3 lässt sich also die ungefähre Größenordnung abschätzen.
Was bedeuten die „428B Gesamtparameter und 23B aktive Parameter“ von MiniMax M3.1 Flash?
MoE (Mixture of Experts, Expertenmischung) ist eine Modellarchitektur, bei der das Modell aus vielen Teilnetzen, den sogenannten „Experten“, besteht. Bei jeder Inferenz werden nur einige davon aufgerufen. Die Angabe „rund 23B aktiv“ beschreibt, wie viele Parameter tatsächlich an der Berechnung eines einzelnen Tokens beteiligt sind – dadurch kann das Modell vergleichsweise schnell sein.
Ein Punkt wird dabei leicht missverstanden: Wenige aktive Parameter bedeuten nicht automatisch einen geringen Grafikspeicherbedarf. Alle 428B Parameter müssen in den Grafikspeicher (den dedizierten Speicher der GPUs) geladen werden, damit bei der Inferenz jederzeit beliebige Experten aufgerufen werden können. Das ist einer der Hauptgründe, warum die lokale Bereitstellung großer MoE-Modelle hohe Anforderungen stellt.
Offizielle Bereitstellungsempfehlungen von MiniMax für M3 (nur als grober Anhaltspunkt)
Zunächst einige Begriffe: MXFP8 ist ein 8-Bit-Speicherformat, das die Größe der Modelldateien und den Grafikspeicherbedarf verringern kann. SGLang ist ein Open-Source-Inferenzframework, mit dem sich das Modell als API-Dienst mit OpenAI-kompatibler Schnittstelle bereitstellen lässt. TP (Tensor Parallelism, Tensorparallelisierung) bezeichnet eine Methode, ein Modell auf mehrere Grafikkarten aufzuteilen, die gemeinsam daran arbeiten.
| Modell | Offizielle Referenzkonfiguration | Größe der Gewichte | Status |
|---|---|---|---|
| MiniMax-M3 | 8 × B200, MXFP8-Präzision, OpenAI-kompatible Schnittstelle mit SGLang | MXFP8-Version: ca. 440 GB | Experimental (experimentell) |
| MiniMax-M2.7 | 4 NVIDIA-GPUs mit großem Grafikspeicher, TP 4 | Einheitlicher Mindestbedarf an Grafikspeicher nicht veröffentlicht | Preview (Vorschau) |
| MiniMax-M3.1 Flash | Noch nicht in der offiziellen Bereitstellungsanleitung aufgeführt | Nicht veröffentlicht | Unbekannt/nicht veröffentlicht |
Noch einmal zur Klarstellung: Die M3-Angaben in der Tabelle sind keine offiziellen Anforderungen für M3.1 Flash. Sie zeigen, dass die offizielle Referenzkonfiguration für ein Modell ähnlicher Größe 8 GPUs der Rechenzentrumsklasse vorsieht. Allein die MXFP8-Gewichte belegen etwa 440 GB. Das übersteigt die Möglichkeiten von Gaming-Grafikkarten und gewöhnlichen Workstations bei Weitem. Die vollständige Modellversion zu Hause mit einer oder zwei Gaming-Grafikkarten zu betreiben, ist für Privatpersonen nicht realistisch.
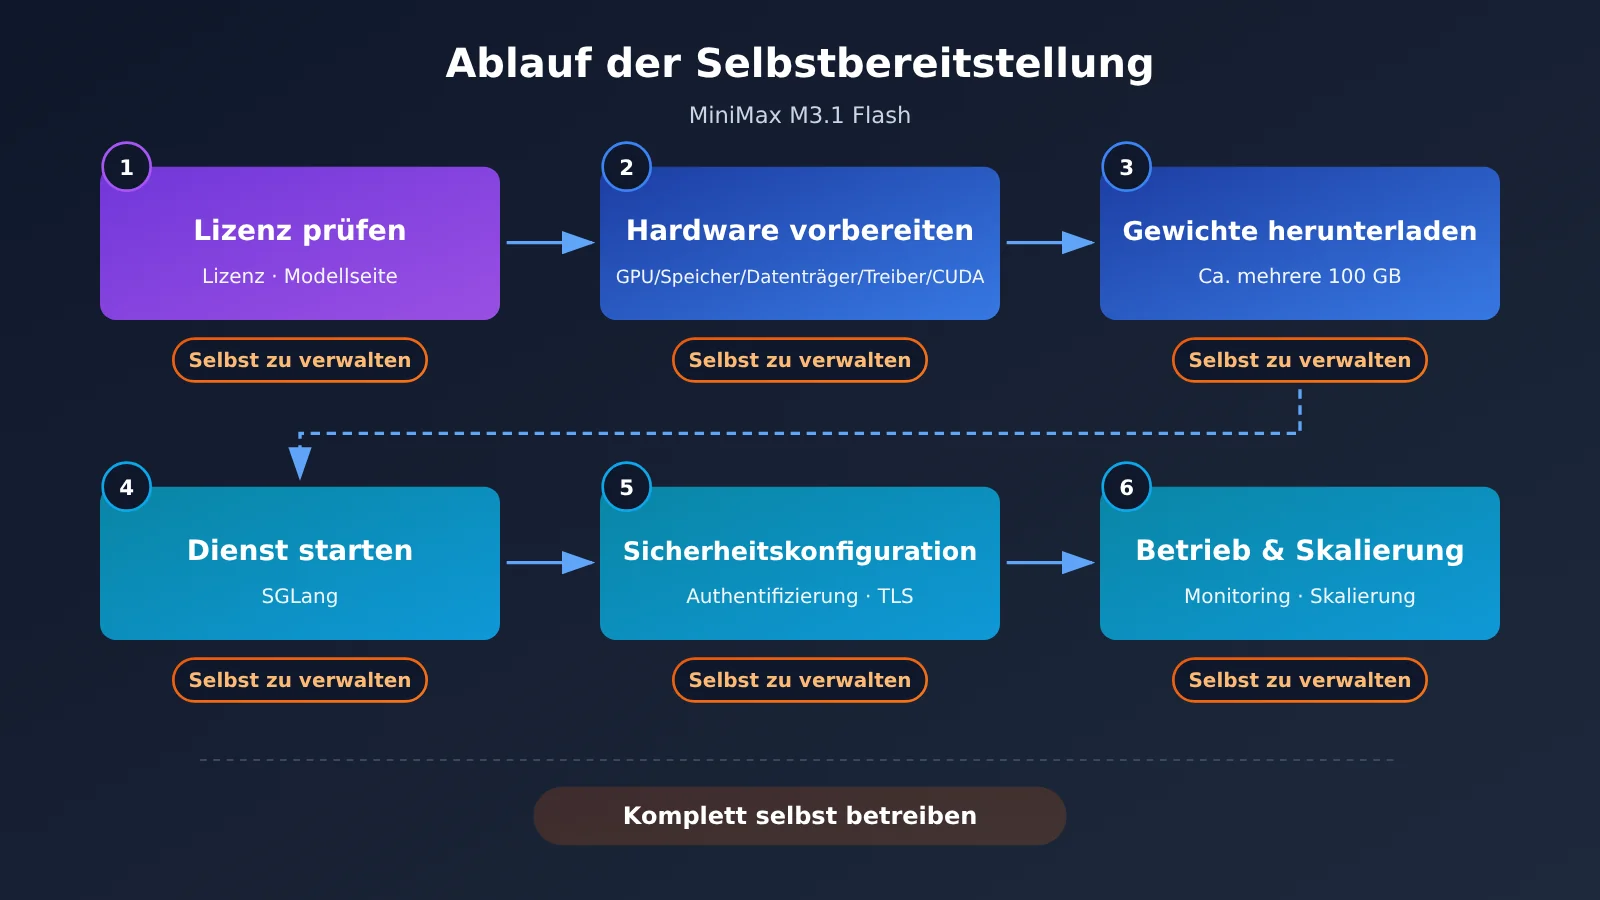
Die offiziellen Bereitstellungsdokumente von MiniMax enthalten außerdem einige Empfehlungen, die für alle Open-Source-Modelle gelten:
- Lizenz und Einsatzbereich zuerst prüfen, um sicherzustellen, dass der geplante Verwendungszweck zulässig ist;
- Hardware anhand der Modellseite vorbereiten – dazu gehören GPU, Arbeitsspeicher, Festplatte, Treiber und CUDA-Version;
- Versionen festlegen: Modell- und Inferenzframework-Version fixieren und nicht automatisch Änderungen an den Branches
mainoderlatestübernehmen; - Für Spiegelserver in China nur die offiziellen Quellen verwenden, die auf der Modellseite aufgeführt sind, damit keine manipulierten Dateien heruntergeladen werden.
MiniMax M3.1 Flash: Selbst hosten oder die API nutzen – was lohnt sich mehr?
Das ist die zentrale Frage dieses Artikels. Die folgende Entscheidungshilfe betrachtet vier Kriterien. Vergleichen Sie einfach Ihre eigene Situation damit.
| Entscheidungskriterium | Eher API nutzen | Eher selbst hosten |
|---|---|---|
| Anforderungen an die Datenkonformität | Die Daten dürfen von einem Cloud-Anbieter verarbeitet werden | Gesetze oder Verträge schreiben vor, dass die Daten das interne Netzwerk nicht verlassen dürfen |
| Aufrufvolumen | Mittleres oder geringes Volumen mit deutlichen Schwankungen | Langfristig hohes Volumen, sodass mehrere GPUs kontinuierlich ausgelastet werden können |
| Betriebskompetenz im Team | Es gibt keine Mitarbeitenden, die sich hauptberuflich um den GPU-Betrieb kümmern | Jemand ist für Cluster, Monitoring und Bereitschaftsdienst verantwortlich |
| Muss das Modell angepasst werden? | Die allgemeinen Funktionen reichen aus | Es sind Fine-Tuning, Änderungen an der Architektur oder umfassende Anpassungen nötig |
Wenn bei den ersten drei Kriterien mindestens zwei Punkte in die linke Spalte fallen, ist die API in der Regel die richtige Wahl.
So berechnen sich die Kosten der MiniMax M3.1 Flash API
Die offiziellen Preise sind festgelegt: 0,15 $ für Eingaben, 0,60 $ für Ausgaben und 0,015 $ für das Lesen aus dem Cache – jeweils pro einer Million Tokens. Für lange Kontexte gibt es keinen Aufpreis. Tokens sind die Abrechnungseinheit für Text beim Modell. Laut offizieller Umrechnung entsprechen etwa 750 englische Wörter rund 1.000 Tokens. Beim Lesen aus dem Cache werden wiederholt gesendete identische Präfixe zu einem niedrigeren Preis berechnet.
Ein Beispiel auf Basis der offiziellen Preise (keine Messung): Bei monatlich 100 Millionen Eingabe-Tokens und 20 Millionen Ausgabe-Tokens ergibt sich eine Gebühr von 100 × 0,15 $ + 20 × 0,60 $ = 27 $. Das ist bereits eine beachtliche Nutzung für Einzelpersonen oder kleine Teams – und kostet einige Dutzend Dollar im Monat.
Für selbst gehostete Modelle sieht die Rechnung anders aus. Orientiert man sich an der M3-Konfiguration mit 8 × B200, verursacht eine solche Maschine laufende Fixkosten – unabhängig davon, ob man sie kauft oder mietet. Auch wenn sie gerade nicht genutzt wird, fallen Kosten an. Damit sich diese Ausgaben rechnen, muss das Aufkommen an Modellaufrufen in der Regel so hoch sein, dass die Maschine dauerhaft stark ausgelastet ist. Die meisten Einzelpersonen und kleinen Teams erreichen das nicht.
Ein Punkt ist wichtig: Der Denkprozess von M3.1 Flash lässt sich nicht deaktivieren. Wenn kein effort-Wert (Denktiefe) übergeben wird, gilt standardmäßig die Stufe max. Auch die Denkinhalte zählen als Ausgabe-Tokens. Daher kann der Ausgabeanteil auf der tatsächlichen Rechnung höher ausfallen als erwartet. Um Kosten zu sparen, können Sie effort auf low oder medium setzen.
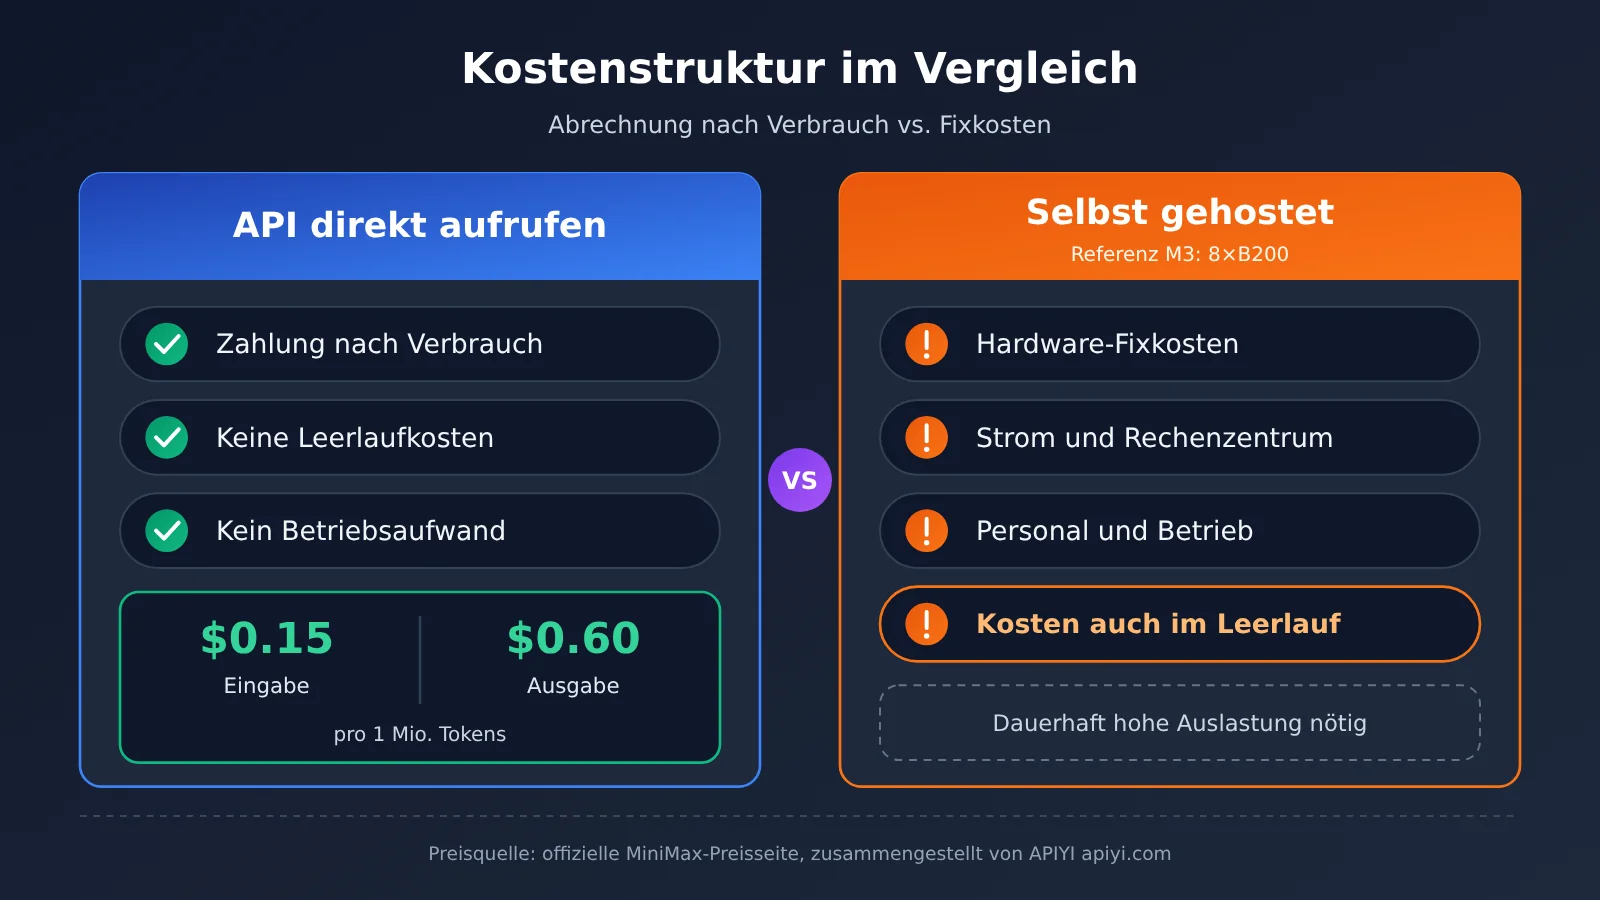
Die Preise in der obigen Grafik stammen von der offiziellen MiniMax-Preisseite und wurden vom technischen Team von APIYI apiyi.com zusammengestellt. Die folgende Tabelle zeigt die offiziellen Preise einiger Modelle, die häufig miteinander verglichen werden:
| Modell | Eingabepreis (pro einer Million Tokens) | Ausgabepreis (pro einer Million Tokens) | Verfügbare Plattformen |
|---|---|---|---|
| MiniMax-M3.1-Flash | 0,15 $ | 0,60 $ | Offizielle MiniMax API, M Plan; ob das Modell über APIYI verfügbar ist, entnehmen Sie bitte der Preisseite |
| MiniMax-M3 (≤512K Eingabe) | 0,30 $ | 1,20 $ | Offizielle MiniMax API, APIYI apiyi.com |
| claude-opus-5-5 | 4 $ | 20 $ | Offizieller Dienst von Anthropic, APIYI apiyi.com |
| claude-opus-5 | 5 $ | 25 $ | Offizieller Dienst von Anthropic, APIYI apiyi.com |
💰 Kostentipp: Wenn Sie die Modelle der MiniMax-Serie gleich ausprobieren möchten, können Sie zunächst MiniMax-M3 über APIYI apiyi.com aufrufen und damit Ihren Ablauf testen. Ob M3.1 Flash über APIYI verfügbar ist, entnehmen Sie bitte der Preisseite. Wir werden das Modell so bald wie möglich aufnehmen.
Was Sie beim Selbst-Hosting von MiniMax M3.1 Flash selbst übernehmen müssen
Die offizielle Dokumentation von MiniMax macht es deutlich: Die offenen Gewichte enthalten nicht die Funktionen der Plattform, etwa Caching und Inhaltssicherheit. Außerdem lauscht der Dienst standardmäßig nur auf dem lokalen Rechner. Bevor Sie sich für das Selbst-Hosting entscheiden, sollten Sie sicherstellen, dass sich jemand um die folgenden Aufgaben kümmert:
- Authentifizierung: Schützen Sie die Schnittstelle mit einem API-Schlüssel, damit niemand sie beliebig aufrufen kann.
- TLS-Verschlüsselung: Wenn der Dienst von außen erreichbar ist, verschlüsseln Sie die Datenübertragung per HTTPS, um sie vor dem Abhören zu schützen.
- Netzwerkisolierung: Beschränken Sie den Zugriff auf den Inferenzdienst auf bestimmte Rechner und Netzbereiche.
- Überwachung und Alarmierung: GPU-Auslastung, Grafikspeicher, Latenz und Fehlerrate müssen überwacht werden.
- Kapazitätsplanung und Skalierung: Halten Sie einen Plan zur Skalierung bereit, bevor sich Anfragen zu Spitzenzeiten in einer Warteschlange stauen.
- Wiederherstellung und Updates: Legen Sie fest, wie Sie nach einem Serverausfall den Betrieb wiederherstellen und neue Versionen schrittweise einführen.
- Inhaltssicherheit: Die Prüfung ein- und ausgehender Inhalte müssen Sie selbst ergänzen.
- Lizenzkonformität: Lesen Sie vor der Bereitstellung, Weiterverbreitung oder kommerziellen Nutzung die vollständige Lizenz und die Nutzungsrichtlinien.
Wenn sich niemand um einen dieser Punkte kümmert, können die eingesparten Tokenkosten durch den zusätzlichen Betriebsaufwand schnell wieder aufgezehrt werden.
Wie leistungsfähig ist MiniMax M3.1 Flash? Angaben des Herstellers und unabhängige Tests im Vergleich
Bevor Sie entscheiden, ob Sie das Modell selbst hosten möchten, sollten Sie sich ein Bild von seiner tatsächlichen Leistungsfähigkeit machen. Die folgende Tabelle ordnet die Angaben nach ihrer Herkunft ein:
| Kennzahl | Ergebnis | Herkunft |
|---|---|---|
| Automation-Bench v1.0.6 | 62,2; Claude Opus 5 erreicht 50,3 | Angabe des Herstellers |
| BankerToolBench | 76,2; gleichauf mit Claude Opus 5 | Angabe des Herstellers |
| Terminal Bench 4.0 | 38,1; Claude Opus 5 erreicht 51,8 | Angabe des Herstellers |
| SWE Refactor Bench | 23,0; Claude Opus 5 erreicht 31,0 | Angabe des Herstellers |
| Inferenzgeschwindigkeit | Im Blog werden im Alltag über 200 TPS und ein P50-Wert von über 170 genannt; auf der Produktseite stehen etwa 150 Tokens pro Sekunde | Angabe des Herstellers (unterschiedliche Angaben) |
| Vals Index | 53,78 %; Platz 15 von 22 Modellen und Platz 5 unter den Modellen mit offenen Gewichten | Unabhängiger Test |
| Vals Terminal-Bench 4.0 | 25,25 %; Platz 22 von 51 Modellen | Unabhängiger Test |
| „Ein Drittel der Kosten von M3“ | Aufgabenbasierte Berechnung; die genaue Methode wurde nicht veröffentlicht | Unbekannt/nicht veröffentlicht |
TPS steht für die Anzahl der pro Sekunde generierten Tokens. Je höher der Wert, desto schneller erscheint die Antwort.
Beim Vergleich mit Claude ist eine Klarstellung wichtig: In der Tabelle von MiniMax dient Claude Opus 5 als Vergleichsmodell, nicht Opus 5.5. Claude Opus 5.5 ist nach wie vor Anthropics leistungsstärkstes Flaggschiffmodell. Der Hersteller hat es nicht Punkt für Punkt mit M3.1 Flash verglichen. Daher lässt sich daraus nicht schließen, dass M3.1 Flash mit Opus 5.5 gleichzieht oder es übertrifft.
Selbst im Vergleich mit Opus 5 schneidet M3.1 Flash bei Aufgaben mit langen Programmierschritten und beim Refactoring, etwa in Terminal Bench und SWE Refactor, deutlich schlechter ab. Auch die unabhängigen Vals-Ergebnisse zeigen Schwächen bei langwierigen Agent-Aufgaben.
Wann Sie MiniMax M3.1 Flash nicht einsetzen und auch nicht überstürzt selbst hosten sollten
In den folgenden Fällen sollten Sie zunächst abwarten:
- Komplexe Planung und umfangreiche Refactorings: Sowohl die Angaben des Herstellers als auch unabhängige Tests zeigen Schwächen bei Aufgaben mit langen Abläufen. Für solche Aufgaben sind Spitzenmodelle wie Claude Opus 5.5 die zuverlässigere Wahl.
- Extrem niedrige Latenz ist entscheidend, tiefes Reasoning aber nicht nötig: Der Denkmodus lässt sich nicht deaktivieren. Selbst auf der Stufe „low“ entsteht zusätzlicher Aufwand durch das Reasoning.
- Ihre Integration verarbeitet M3-
<think>-Tags: Bei M3.1 Flash werden Denkinhalte in einem separaten Feld zurückgegeben. Passen Sie zunächst die bisherige Parsing-Logik an, bevor Sie umstellen. - Die Lizenz ist noch ungeklärt: Vor der Veröffentlichung der Gewichte wurde keine Lizenz bekannt gegeben. Planen Sie für kommerzielle Projekte daher nicht vorsorglich mit einer selbst gehosteten Version.
- Niemand übernimmt den Bereitschaftsdienst: Wenn sich niemand um die Betriebspunkte aus dem vorherigen Abschnitt kümmert, sollten Sie Ihren Geschäftsbetrieb nicht auf einen selbst gehosteten Dienst stützen.
- Sie möchten das vollständige Modell auf einer Consumer-Grafikkarte ausführen: Gemessen an der Größenordnung von M3 ist das unrealistisch. Warten Sie auf offizielle Hardwareangaben und vertrauen Sie keinen quantisierten Versionen aus fragwürdigen Quellen.
MiniMax und Claude Opus 5.5 über APIYI kombinieren
Für die meisten Entwickler ist die praktischere Frage nicht „selbst hosten oder die API nutzen?“, sondern: Wie lassen sich Aufgaben unterschiedlicher Schwierigkeit auf verschiedene Modelle verteilen?
APIYI ermöglicht es, mit einem einzigen Key sowohl ausländische Modelle wie Claude, GPT und Gemini als auch chinesische Modelle wie DeepSeek und MiniMax aufzurufen. Aktuell direkt über APIYI verfügbar sind MiniMax-M3 (mit Unterstützung für die Schnittstellenformate von OpenAI und Anthropic; auch die ClaudeCode-Gruppe ist verfügbar), die MiniMax-M2.7-Serie sowie claude-opus-5-5 und claude-opus-5. Zum Zeitpunkt der Veröffentlichung ist MiniMax-M3.1-Flash noch nicht auf der Preisseite von APIYI aufgeführt. Ob das Modell aufgerufen werden kann, entnehmen Sie bitte der Preisseite.
Eine sinnvolle Aufgabenverteilung sieht so aus:
- Günstige Aufgaben in großen Mengen an MiniMax geben: Datenbereinigung, Zusammenfassungen in großer Zahl, Formatkonvertierungen und einfache Codevervollständigung. Bei hohem Volumen und geringer Schwierigkeit pro Aufgabe lohnt sich ein niedriger Preis besonders.
- Anspruchsvolle Planung und Refactorings Claude Opus 5.5 überlassen: Refactorings über mehrere Dateien hinweg, Architekturentwürfe und die Planung komplexer Agent-Aufgaben kosten pro Aufruf zwar mehr, doch Fehler und Nacharbeiten sind oft noch teurer.
- Mit demselben Key zwischen Modellen wechseln: Ändern Sie einfach den Modellnamen, statt mehrere Konten und API-Endpunkte verwalten zu müssen.
🎯 Technischer Tipp: Führen Sie über APIYI apiyi.com mit demselben Key jeweils einen Test mit MiniMax-M3 und claude-opus-5-5 durch. Vergleichen Sie die Ergebnisse und Kosten anhand Ihrer eigenen Aufgaben – das ist verlässlicher als jeder Benchmark.
Häufig gestellte Fragen
F1: Wann können die Gewichte von MiniMax M3.1 Flash heruntergeladen werden?
Im offiziellen X-Post ist der 23. Oktober als geplanter Termin angegeben. Im offiziellen Blog heißt es lediglich „später“. Zum Zeitpunkt der Veröffentlichung waren die Gewichte noch nicht verfügbar. Maßgeblich ist die offizielle MiniMax-Modellseite auf Hugging Face.
F2: Kann MiniMax M3.1 Flash auf einer Consumer-Grafikkarte ausgeführt werden?
MiniMax hat keine Hardwareanforderungen für M3.1 Flash veröffentlicht. Als offizielle Referenz für das ähnlich große M3 dienen 8 × B200. Die MXFP8-Gewichte sind etwa 440 GB groß – die vollständige Version ist auf einer einzelnen Consumer-Grafikkarte praktisch nicht realistisch.
F3: Darf MiniMax M3.1 Flash nach der Veröffentlichung unter einer Open-Source-Lizenz kommerziell genutzt werden?
Die Lizenz wurde noch nicht veröffentlicht. MiniMax weist darauf hin, dass offene Modellgewichte nicht bedeuten, dass für alle Modelle dieselbe Lizenz gilt. Lesen Sie vor dem Einsatz, der Weiterverbreitung oder der kommerziellen Nutzung die vollständige Lizenz.
F4: Wie kann ich die Modelle von MiniMax jetzt kostengünstig ausprobieren?
Am einfachsten geht das direkt über die API. M3.1 Flash lässt sich über die offizielle MiniMax-API oder ein M-Plan-Abo nutzen. Die aktuellen Monatskosten finden Sie auf der offiziellen Website. Wenn Sie mehrere Modelle mit einem API-Schlüssel verwalten möchten, können Sie zunächst das bereits verfügbare MiniMax-M3-Modell über APIYI auf apiyi.com aufrufen. Ob M3.1 Flash verfügbar ist, entnehmen Sie bitte der Preisseite von APIYI.
F5: Kann MiniMax M3.1 Flash Claude Opus 5.5 ersetzen?
Das sollte man nicht so verstehen. MiniMax hat lediglich einen Vergleich mit Claude Opus 5 veröffentlicht und lag bei Programmieraufgaben mit langen Arbeitsschritten zurück. Sinnvoller ist eine Aufgabenteilung: MiniMax für Aufgaben in größerem Umfang, Opus 5.5 für anspruchsvolle Planung und Refactoring. Über APIYI lässt sich diese Kombination mit nur einem API-Schlüssel nutzen.
MiniMax M3.1 Flash: Die wichtigsten Punkte zu den offenen Gewichten
- Die Gewichte sind noch nicht verfügbar: Die Veröffentlichung ist für den 23. Oktober geplant. Maßgeblich ist die offizielle Modellseite auf Hugging Face.
- Lizenz und Hardwareanforderungen sind noch nicht bekannt: Kaufen Sie nicht voreilig auf Basis von Vermutungen Hardware oder planen Sie den Einsatz.
- Als Größenordnung dient M3: 8 × B200 und rund 440 GB MXFP8-Gewichte – das ist eine Lösung für Rechenzentren.
- Die API ist kostengünstiger: Bei Preisen von 0,15 $/0,60 $ ist die API für die meisten Einzelpersonen und kleinen Teams deutlich unkomplizierter als ein eigener Betrieb.
- Selbstbereitstellung ist nur für wenige Szenarien geeignet: vor allem bei strengen Compliance-Anforderungen, sehr hohem Aufrufvolumen oder wenn das Modell angepasst werden muss.
- Verglichen wird mit Opus 5: Opus 5.5 ist weiterhin Anthropics stärkstes Flaggschiffmodell. Einen detaillierten Vergleich hat das Unternehmen nicht veröffentlicht.
- Kombinierter Einsatz: Mit einem API-Schlüssel bei APIYI apiyi.com MiniMax und Claude Opus 5.5 gemeinsam nutzen.
Zusammenfassung
Die wichtigsten Punkte zu den offenen Gewichten von MiniMax M3.1 Flash:
- Aktueller Stand: Die Gewichte sollen am 23. Oktober veröffentlicht werden. Lizenz und Hardwareanforderungen für die Bereitstellung sind noch nicht bekannt. Maßgeblich ist die offizielle Modellseite.
- Konfiguration: Als Orientierung dient das ähnlich dimensionierte Modell M3. Die offizielle Konfiguration umfasst acht GPUs der B200-Klasse und ist für den Einsatz auf privaten Geräten nicht geeignet.
- Entscheidung: Wägen Sie die vier Faktoren Compliance, Aufrufvolumen, Betriebskapazitäten und Anpassungsbedarf ab. In den meisten Fällen ist der direkte API-Aufruf kostengünstiger.
Sobald die Gewichte verfügbar sind, sollten Sie zuerst die Lizenz und die offiziellen Hardwareangaben prüfen und erst danach über eine Selbstbereitstellung entscheiden. Im praktischen Einsatz ist es sinnvoller, je nach Schwierigkeitsgrad unterschiedliche Modelle für verschiedene Aufgaben zu verwenden. Über APIYI apiyi.com können Sie mit einem API-Schlüssel die Kombination aus der MiniMax-Serie und claude-opus-5-5 testen.
📚 Referenzen
- Offizieller Veröffentlichungsblog von MiniMax: Ankündigung zu M3.1 Flash und offiziell veröffentlichte Leistungsdaten
- Link:
minimax.io/blog/minimax-m31f -
Hinweis: Offizielle Angaben zu Preisen, Geschwindigkeit und den „später verfügbaren“ Gewichten
-
Offizielle Preisseite von MiniMax: Nutzungsabhängige Preise der einzelnen Modelle
- Link:
platform.minimax.io/docs/guides/pricing -
Hinweis: Preisvergleich zwischen M3.1 Flash und M3
-
Offizielle Self-Hosting-Anleitung von MiniMax: Referenzkonfiguration für die Bereitstellung von Open-Source-Modellen
- Link:
platform.minimax.io/docs/guides/local-deploy -
Hinweis: Referenzkonfiguration mit 8 × B200 für M3 und Hinweise zum Self-Hosting
-
Vals-AI-Bewertungsseite: Unabhängige Testergebnisse für M3.1 Flash
- Link:
vals.ai/models/minimax_MiniMax-M3.1-flash -
Hinweis: Platzierung im Vals Index und Punktzahlen in den einzelnen Kategorien
-
Hugging Face – MiniMax-M3: M3-Gewichte und Community-Lizenz
- Link:
huggingface.co/MiniMaxAI/MiniMax-M3 -
Hinweis: Sobald die Gewichte von M3.1 Flash veröffentlicht sind, können Sie sie in derselben Organisation finden
-
SGLang-Dokumentation – MiniMax-M3: Hinweise zur Bereitstellung mit dem Inferenz-Framework
- Link:
docs.sglang.io/cookbook/autoregressive/MiniMax/MiniMax-M3 - Hinweis: Größe und Ausführung der MXFP8-Version von M3
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gern über die Startseite der offiziellen APIYI-Website. Weitere Informationen finden Sie im Dokumentationszentrum unter docs.apiyi.com.