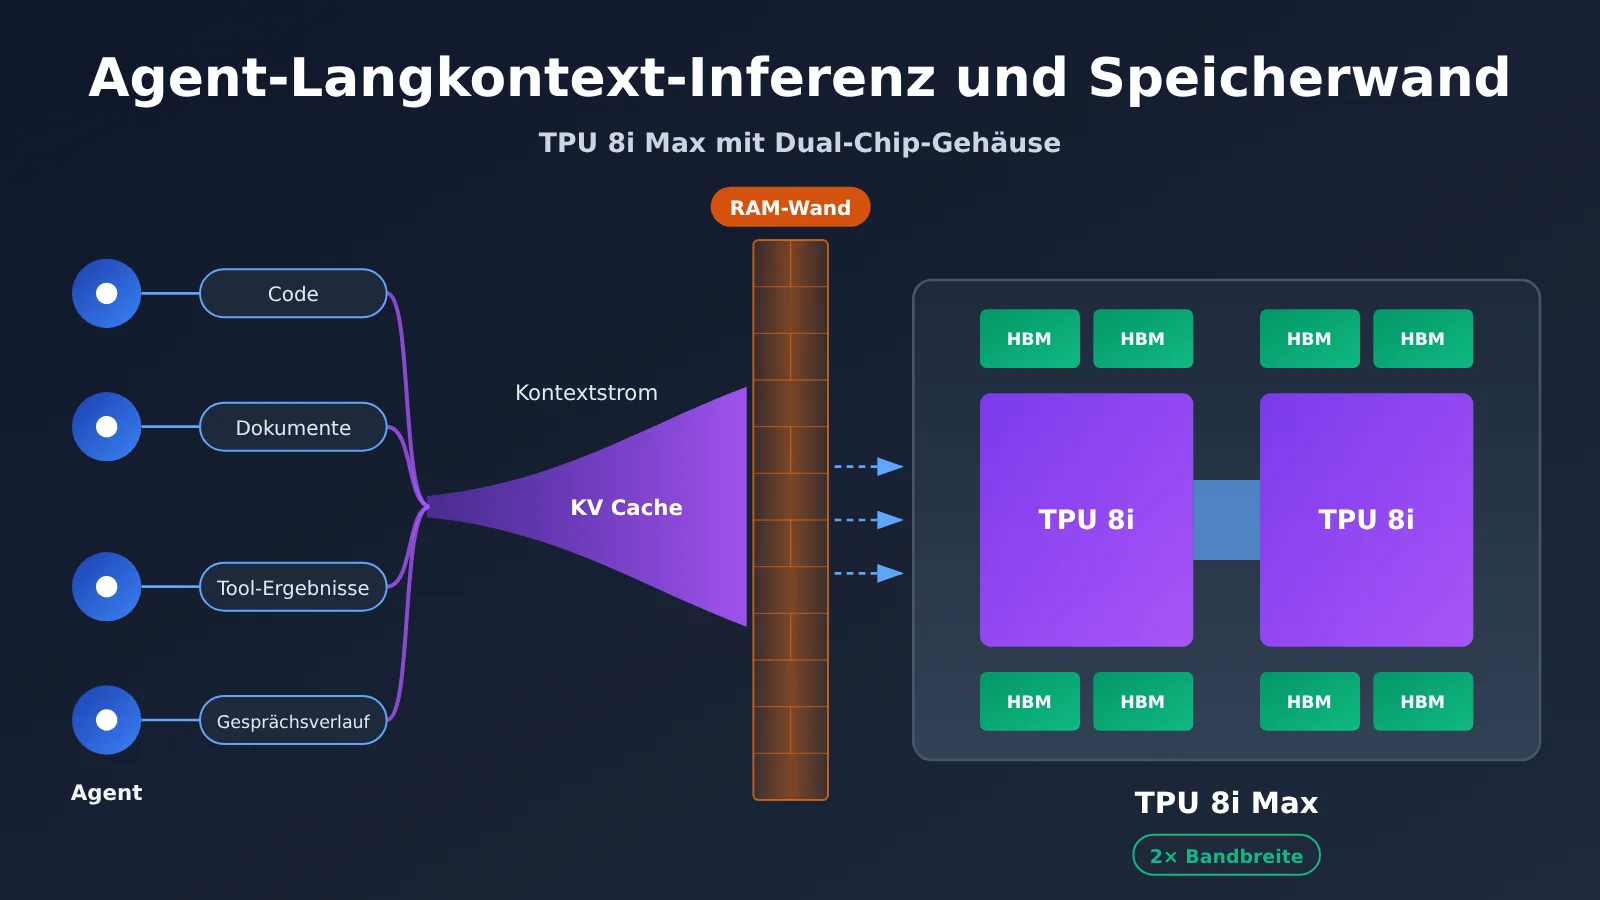
Am 9. November 2026 veröffentlichte Google Cloud zwei neue Systemkonfigurationen der achten TPU-Generation: TPU 8tx und TPU 8i Max. TPU 8i Max vereint zwei TPU-8i-Chips in einem Gehäuse. Rechenleistung, On-Chip-SRAM und HBM-Bandbreite verdoppeln sich gleichzeitig. Das System ist für Szenarien mit langen Kontexten, hoher Parallelität und dem Zusammenspiel mehrerer Agenten bei der Inferenz ausgelegt.
Das ist mehr als eine reine Leistungssteigerung. Die entsprechenden Informationen wurden durch die offizielle Ankündigung von Google, eine zeitgleiche Kooperationsankündigung von AMD und Kurzberichte mehrerer Medien bestätigt. Statt lediglich Chipdaten aufzulisten, zeigt dieser Artikel anhand konkreter Berechnungen zum KV-Cache, worum es geht: Der Engpass bei der Agent-Inferenz verlagert sich von der Frage „Wie schnell kann gerechnet werden?“ zu der Frage, ob die Daten rechtzeitig bei den Recheneinheiten ankommen.
Der zentrale Nutzen: Nach der Lektüre können Sie selbst abschätzen, wie viel Grafikspeicher eine Anfrage mit langem Kontext benötigt, verstehen, wie die Memory Wall entsteht, und beurteilen, was Systemdesigns wie TPU 8i Max für Ihren Agent-Dienst bedeuten.
Die wichtigsten Informationen zu TPU 8i Max und langen Kontexten für Agenten im Überblick
| Information | Details |
|---|---|
| Veröffentlichungsdatum | 9. November 2026 |
| Herausgeber | Google Cloud |
| Produkteigenschaft | Systemkonfiguration der TPU-Generation 8, kein völlig neu entwickelter, eigenständiger Chip |
| Gehäuse | Zwei TPU 8i sind in einem gemeinsamen Gehäuse integriert |
| Offiziell bestätigte Leistungssteigerung | Doppelte Rechenleistung, SRAM-Kapazität und HBM-Bandbreite im Vergleich zur TPU 8i |
| In Medienbriefings genannte technische Daten | 384 GB HBM, 17,2 TB/s HBM-Bandbreite, 768 MB SRAM |
| Zielanwendungen | Lange Kontexte, Inferenz mit hoher Parallelität, Zusammenarbeit mehrerer Agenten, Analyse langer Videos und mehr |
| Verfügbarkeit | Auf der offiziellen Produktseite steht „Coming soon“; Preise und GA-Termin wurden noch nicht bekannt gegeben |
Wichtig ist, dass Google in der Ankündigung bewusst zwischen Chip und System unterscheidet. Die Entwicklung eines Chips dauert Jahre. Eine Systemkonfiguration lässt sich dagegen schneller an neue Arbeitslasten anpassen, indem Gehäuse, Speicher, Netzwerk und Sicherheitskomponenten verändert werden. Die TPU 8i Max ist genau nach diesem Prinzip entstanden: Der Siliziumchip basiert weiterhin auf der TPU 8i; die Änderungen betreffen das Gehäuse und die Systemebene.
Warum Agenten mit langem Kontext mehr Speicher benötigen als gewöhnliche Chats
Gewöhnliche Chats bestehen meist aus „Frage und Antwort“. Der Kontext wächst nur langsam, und nach Ende der Unterhaltung kann der Zustand verworfen werden. Bei Agenten ist das anders: Sie zerlegen ein Ziel in mehrere Teilaufgaben, lesen fortlaufend externe Informationen, rufen Tools auf, denken anhand der Rückmeldungen weiter und speichern ihren Zustand, während sie auf Ergebnisse warten. Die Ergebnisse jedes Schritts werden wieder an den Kontext angehängt – der Kontext wächst also ständig weiter.
Ein Softwareentwicklungs-Agent kann während einer einzigen Aufgabe beispielsweise all diese Inhalte gleichzeitig im Kontext haben:
- Codebasis: Hunderte Quelldateien und ihre Abhängigkeiten
- Projektdokumentation: Architekturbeschreibungen, Schnittstellenvereinbarungen und Programmierstandards
- Bisheriger Gesprächsverlauf: Mehrere Runden mit Rückfragen und Änderungswünschen zu den Anforderungen
- Tool-Ergebnisse: Kompilierungsprotokolle, Testausgaben und Fehler-Stacks
- Ergebnisse von Sub-Agenten: Rückmeldungen einzelner Sub-Agenten, die für Tests, Reviews und Refactoring zuständig sind
Noch entscheidender ist die Parallelität. Wenn ein Haupt-Agent vier Sub-Agenten startet, sind im System gleichzeitig fünf unabhängige Kontexte vorhanden. Jeder dieser Kontexte muss während der Schlussfolgerungen im Speicher gehalten werden. Deshalb zählt Google die „Entwicklung großer Softwareprojekte im Team mehrerer Agenten“ zu den typischen Einsatzszenarien des TPU 8i Max. Wichtig dabei: Googles Verweis auf einen Kontext im Umfang von „Millionen Token“ beschreibt ein angestrebtes Anwendungsszenario und ist keine veröffentlichte, feste Angabe zur maximalen Kontextlänge.
Wie der KV-Cache mit langen Agent-Kontexten linear wächst
Aufgabe des KV-Caches
Beim Generieren jedes neuen Tokens muss der Transformer die Query des aktuellen Tokens mit den Keys aller bisherigen Tokens vergleichen und daraus Aufmerksamkeitswerte berechnen. Anschließend werden die Values der bisherigen Tokens anhand dieser Gewichte summiert. Würden Key und Value bei jedem neuen Token für den gesamten bisherigen Kontext erneut berechnet, würde der Rechenaufwand mit zunehmender Länge stark ansteigen. Der KV-Cache speichert deshalb die bereits berechneten Keys und Values früherer Tokens und verwendet sie wieder – so wird Rechenaufwand gegen Speicherverbrauch getauscht.
Der Preis dafür: Der Cache wächst kontinuierlich mit der Kontextlänge und der Anzahl gleichzeitiger Anfragen. Die folgende Schätzformel entspricht dem Speicherlayout des KV-Caches in vLLM:
M_KV = 2 × L × H_KV × D × B × T × N
| Parameter | Bedeutung | Wert für Llama 3.1 70B |
|---|---|---|
| 2 | Zwei Cache-Bereiche für Key und Value | 2 |
| L | Anzahl der Transformer-Schichten | 80 |
| H_KV | Anzahl der Key/Value-Aufmerksamkeitsköpfe | 8 (GQA) |
| D | Dimension jedes KV-Heads | 128 |
| B | Bytes pro Element | 2 (BF16) |
| T | Anzahl der Tokens pro Anfrage | Je nach Szenario |
| N | Anzahl gleichzeitiger Anfragen | Je nach Szenario |
Rechenbeispiel für den KV-Cache von Llama 3.1 70B
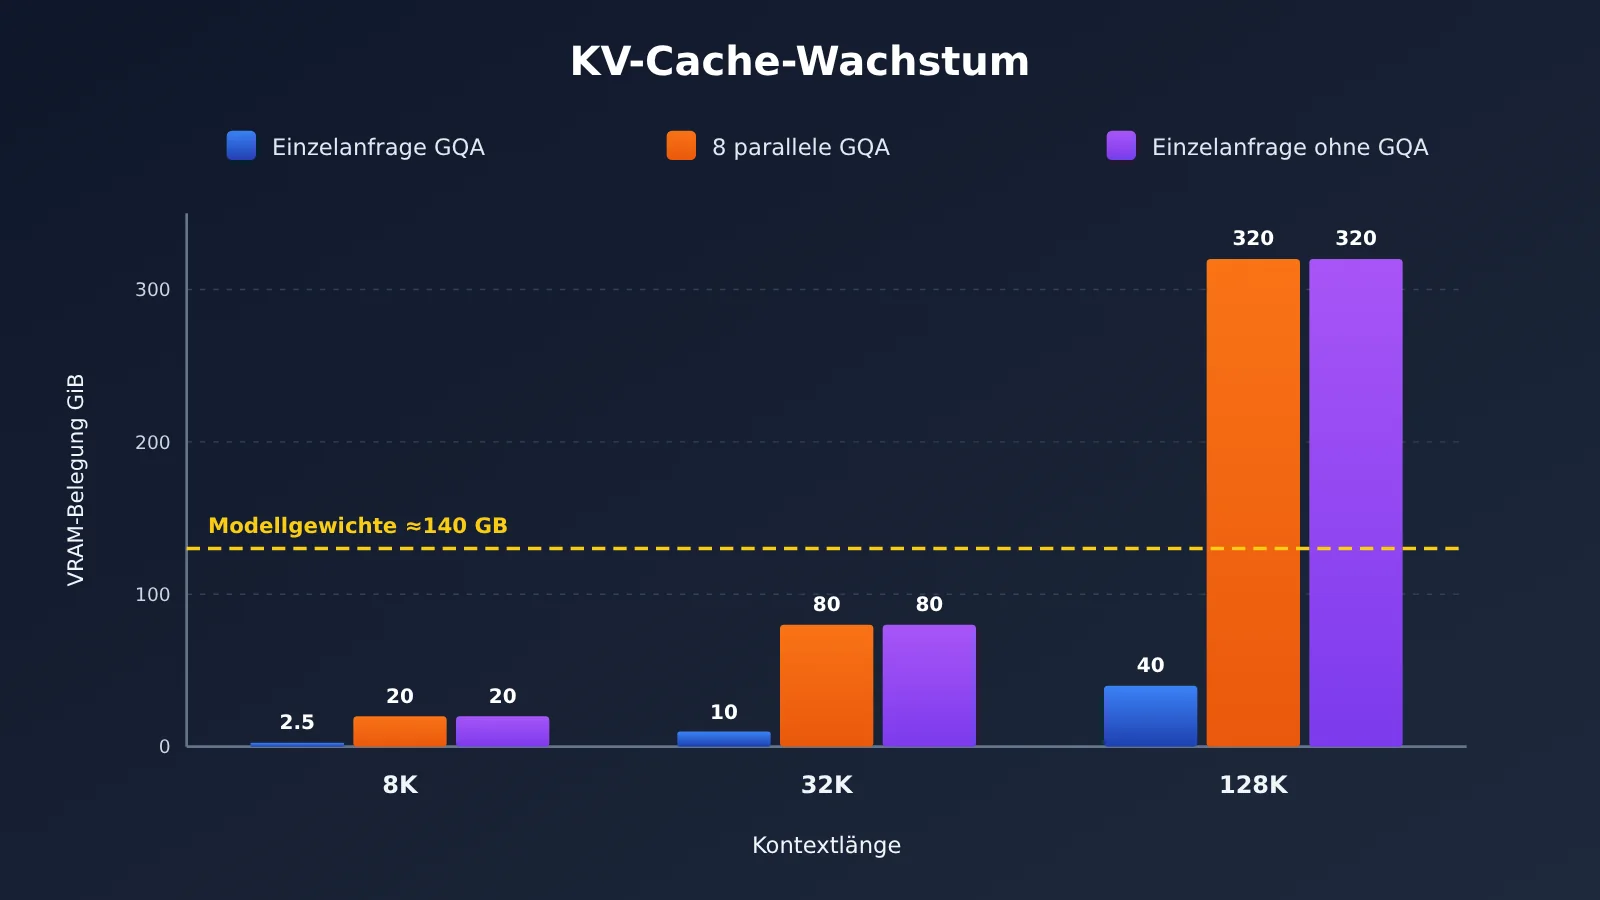
Zuerst berechnen wir den Speicherbedarf für ein einzelnes Token: 2 × 80 × 8 × 128 × 2 = 327.680 Byte, also etwa 320 KiB pro Token. Das wirkt zunächst nicht viel, wächst aber mit der Kontextlänge schnell an.
| Szenario | Kontextlänge | Gleichzeitige Anfragen | Theoretischer KV-Cache |
|---|---|---|---|
| Kurze Aufgabe | 8K | 1 | 2,5 GiB |
| Mittlere Coding-Aufgabe | 32K | 1 | 10 GiB |
| Agent mit langem Kontext | 128K | 1 | 40 GiB |
| Mehrere parallele Agents | 128K | 8 | 320 GiB |
Diese Werte berücksichtigen nur den KV-Cache, nicht die Modellgewichte, den Laufzeit-Arbeitsbereich oder den Speicherbedarf durch Fragmentierung. Zum Vergleich: Allein die Gewichte eines Modells mit 70 Milliarden Parametern benötigen bei Speicherung in BF16 etwa 140 GB. Der KV-Cache für acht gleichzeitige Sitzungen mit jeweils 128K Kontext ist also bereits mehr als doppelt so groß wie die Modellgewichte.
Einfluss von GQA auf den Speicherbedarf des KV-Caches
Llama 3.1 70B hat 64 Attention-Heads, aber nur 8 KV-Heads. Das ist GQA (Grouped-Query Attention): Jeweils 8 Query-Heads teilen sich eine Gruppe aus Key und Value. Bei der Berechnung müssen daher 8 und nicht 64 eingesetzt werden, andernfalls fällt das Ergebnis achtmal zu groß aus.
Ein Gedankenexperiment zeigt den Nutzen von GQA. Würde das Modell Standard-Multi-Head-Attention verwenden und für alle 64 Heads eigene KV-Werte speichern, stiege der KV-Cache für eine einzelne Anfrage mit 128K Kontext von 40 GiB auf 320 GiB. Eine einzige Anfrage würde damit so viel Speicher belegen wie acht gleichzeitige Anfragen mit GQA. MQA reduziert die Zahl der KV-Heads weiter auf 1 und spart dadurch noch mehr Speicher. Dabei muss jedoch der mögliche Einfluss auf die Modellqualität abgewogen werden. Zusätzlich lässt sich der Speicherbedarf durch eine Quantisierung des KV-Caches – etwa von BF16 auf 8 Bit – halbieren. Dafür muss man mögliche Genauigkeitseinbußen prüfen.
Das folgende Skript verwendet die Formel von oben, damit du den KV-Cache-Bedarf deines eigenen Modells für unterschiedliche Kontextlängen und Parallelität schnell abschätzen kannst:
def kv_cache_gib(layers, kv_heads, head_dim, bytes_per_elem, tokens, concurrency=1):
    """Schätzt den KV-Cache anhand von M_KV = 2 × L × H_KV × D × B × T × N in GiB."""
    total = 2 * layers * kv_heads * head_dim * bytes_per_elem * tokens * concurrency
    return total / (1024 ** 3)

# Llama 3.1 70B: 80 Layer, 8 KV-Heads, Dimension 128, BF16
for ctx in (8_192, 32_768, 131_072):
    print(f"{ctx:>7} tokens -> {kv_cache_gib(80, 8, 128, 2, ctx):.1f} GiB")

print("8 并发 x 128K ->", kv_cache_gib(80, 8, 128, 2, 131_072, 8), "GiB")
print("FP8 KV 量化 128K ->", kv_cache_gib(80, 8, 128, 1, 131_072), "GiB")
Was genau ist die Memory Wall beim Schlussfolgern von Agenten mit langen Kontexten?
Kapazität, Bandbreite und SRAM sind drei unabhängige Dimensionen
Ein häufiger Denkfehler bei der Memory Wall ist, „viel Speicher“ und „schneller Speicher“ gleichzusetzen. Tatsächlich umfasst die Speicherarchitektur eines KI-Beschleunigers mindestens drei voneinander unabhängige Kennzahlen:
| Kennzahl | Wofür sie entscheidend ist | Bedeutung für Agenten |
|---|---|---|
| HBM-Kapazität | Wie viele Daten gespeichert werden können | Wie viele Modellgewichte und KV-Caches gleichzeitig vorgehalten werden können – und damit, wie viele Kontexte parallel verarbeitet werden können |
| HBM-Bandbreite | Wie viele Daten pro Zeiteinheit übertragen werden können | Wie schnell Gewichte und KV-Cache bei der Generierung jedes Tokens zu den Rechenkernen gelangen |
| On-Chip-SRAM | Hochgeschwindigkeitsspeicher in unmittelbarer Nähe der Rechenkerne | Ob häufig benötigte Daten auf dem Chip bleiben können, sodass weniger Wartezeit durch wiederholte HBM-Zugriffe entsteht |
HBM ist im Wesentlichen DRAM, das durch mehrlagiges Stapeln und fortschrittliche Packaging-Verfahren parallele Zugriffe mit hoher Bandbreite ermöglicht. SRAM ist schneller und näher an den Recheneinheiten, aber pro Speichereinheit teuer und in der verfügbaren Chipfläche begrenzt. Deshalb setzen moderne Beschleuniger üblicherweise auf eine mehrstufige Speicherhierarchie, statt nur eine bestimmte Speicherart zu maximieren.
Prefill und Decode haben sehr unterschiedliche Datenanforderungen
Die Inferenz eines LLMs besteht aus zwei Phasen. In der Prefill-Phase wird der gesamte Eingabekontext auf einmal verarbeitet und der KV-Cache aufgebaut. Dabei lassen sich viele Tokens parallel berechnen – eine typische rechenintensive Aufgabe. In der Decode-Phase wird die Ausgabe Token für Token erzeugt. Jeder Schritt verarbeitet nur ein neues Token, muss aber sämtliche Gewichte und den kompletten KV-Cache lesen. Der Rechenaufwand ist gering, der Datenverkehr dagegen groß. Decode ist somit eine bandbreitenintensive Aufgabe.
Eine vereinfachte Schätzung veranschaulicht die Belastung durch Decode. Der KV-Cache einer einzelnen Anfrage mit 128K Tokens umfasst etwa 40 GiB (rund 43 GB) und muss für jedes generierte Token vollständig gelesen werden. Bei einer HBM-Bandbreite von etwa 8,6 TB/s pro TPU-8i-Chip dauert allein das Lesen des KV-Caches ungefähr 5 Millisekunden. Bei den 17,2 TB/s der TPU 8i Max liegt die Untergrenze bei etwa 2,5 Millisekunden. Dabei handelt es sich um eine theoretische Untergrenze, bei der das Lesen der Gewichte, die Überlappung mit Berechnungen und die parallele Aufteilung unberücksichtigt bleiben. Sie zeigt jedoch deutlich: Je länger der Kontext, desto stärker wird die Decode-Zeit durch den Datentransfer statt durch die Berechnung bestimmt.
Warum müssen Recheneinheiten auf Daten „warten“?
Wenn ein Rechenkern pro Sekunde wesentlich mehr Operationen ausführen kann, als der Speicher an Daten pro Sekunde bereitstellt, steht die Recheneinheit still und wartet – das ist die Memory Wall. Bei Agenten vergrößern lange Kontexte die pro Decode-Schritt zu lesende Datenmenge, hohe Parallelität erhöht den Umfang des dauerhaft benötigten KV-Caches, und mehrstufiges Schlussfolgern führt dazu, dass der Cache wiederholt gelesen und aktualisiert werden muss. Zusammen sorgen diese Faktoren dafür, dass sich die Erträge einer bloßen Steigerung der Spitzenrechenleistung zunehmend verringern.
🎯 Technischer Tipp: Bevor Sie Ihre Agent-Anwendung bewerten, sollten Sie die Time to First Token (TTFT) und die Ausgabegeschwindigkeit bei unterschiedlichen Kontextlängen messen und beobachten, wie sich die Latenz mit wachsendem Kontext verändert. Über APIYI unter apiyi.com können Sie mit demselben API-Schlüssel zwischen Claude, Gemini, GPT und anderen Modellen wechseln und so deren Leistung bei langen Kontexten vergleichen.
Wie das Dual-Chip-Gehäuse des TPU 8i Max die Speicherbandbreite erhöht
So werden zwei TPU 8i kombiniert
Der TPU 8i Max ist die vierte Systemkonfiguration der TPU-Generation 8. Google hat festgestellt, dass bei mehreren Agents, die gleichzeitig große Codebasen, lange Videos oder komplexe Dokumente verarbeiten, oft nicht die Rechenleistung zum Engpass wird, sondern die Geschwindigkeit, mit der die Chips Daten lesen und austauschen. Die Lösung: Zwei latenzarme TPU 8i werden in einem Gehäuse zusammengeführt. Bei gleicher Stellfläche im Rack kommen so doppelt so viele Siliziumchips zum Einsatz.
| Kennzahl | TPU 8i | TPU 8i Max | Veränderung |
|---|---|---|---|
| Chipgehäuse | Einzelchip | Dual-Chip | — |
| Rechenleistung | Basiswert | 2-fach | Verdoppelt |
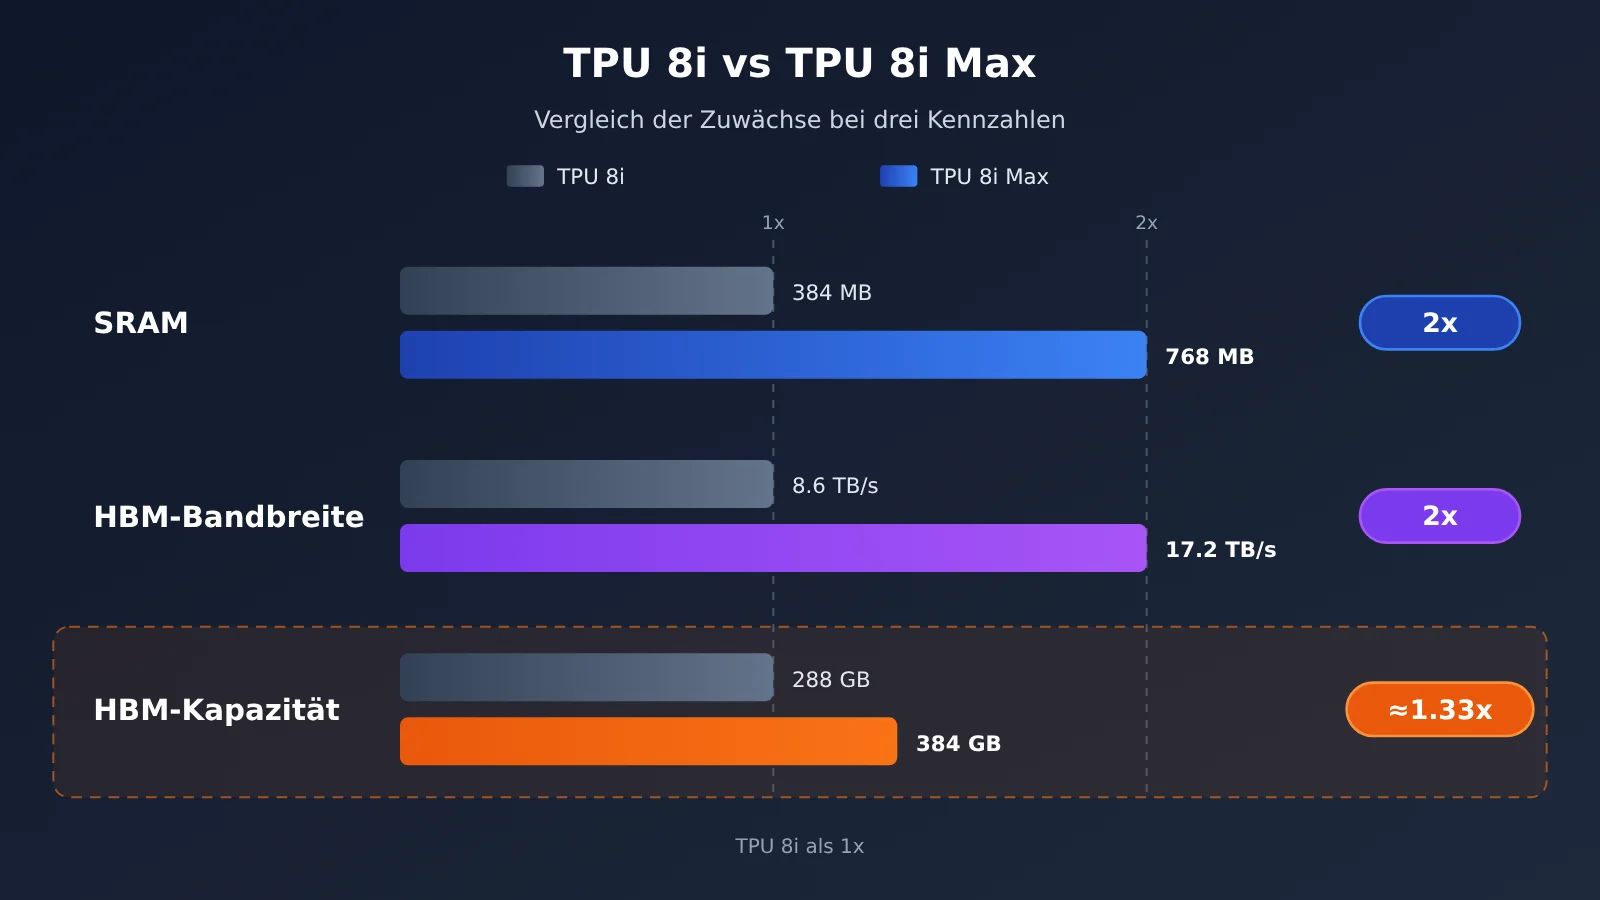
| SRAM auf dem Chip | 384 MB | 768 MB | Verdoppelt |
| HBM-Bandbreite | 8.601 GB/s | 17.200 GB/s | Etwa verdoppelt |
| HBM-Kapazität | 288 GB | 384 GB | Etwa 33 % mehr |
Hinweis: Die Daten zum TPU 8i stammen aus Googles technischem Architekturartikel vom April 2026. Die absoluten Werte des TPU 8i Max wurden in einer Medienmitteilung vom 9. November veröffentlicht. Im offiziellen Ankündigungsartikel werden ausdrücklich die Verdopplung der Rechenleistung, des SRAM und der HBM-Bandbreite bestätigt.
Warum eine gleichmäßige Skalierung sinnvoller ist, als nur die Rechenleistung zu erhöhen
Wird nur die Rechenleistung erhöht, gerät die Decode-Phase noch stärker durch die Bandbreite ins Stocken. Steigt dagegen nur die Bandbreite, können die Recheneinheiten unterversorgt bleiben. Beim TPU 8i Max werden Rechenleistung, SRAM und HBM-Bandbreite in ähnlichem Verhältnis skaliert. So bleibt das Verhältnis von Datendurchsatz zu Rechengeschwindigkeit ungefähr im Gleichgewicht, das dem ursprünglichen Design zugrunde liegt. Durch den verdoppelten SRAM können zudem mehr häufig genutzte Daten auf dem Chip bleiben, was den Zugriff auf den HBM weiter reduziert.
Die HBM-Kapazität steigt nur um etwa 33 %, nicht auf das Doppelte
Dieses Detail wird am leichtesten falsch dargestellt. Die HBM-Bandbreite verdoppelt sich von etwa 8,6 TB/s auf 17,2 TB/s. Die HBM-Kapazität wächst dagegen nur von 288 GB auf 384 GB – also um rund 33 %. Zusammen mit den vorherigen Berechnungen wird die Bedeutung deutlich: Beim TPU 8i Max steht pro Gigabyte Speicher mehr Bandbreite zur Verfügung. Ein gleich großer KV-Cache lässt sich dadurch schneller auslesen. Die Menge an Kontext, die sich gleichzeitig im Speicher halten lässt, wächst jedoch deutlich weniger stark als die Bandbreite.
Anders gesagt: Der zentrale Vorteil des TPU 8i Max besteht nicht darin, die Kontextgrenze eines einzelnen Modells zu verdoppeln. Vielmehr kann das System zahlreiche gleichzeitig verarbeitete Kontexte effizienter unterstützen. Reicht die Kapazität nicht aus, sind weiterhin Softwareverfahren wie das Auslagern des KV-Caches, Quantisierung und die Verteilung auf mehrere Chips nötig.
Speicherarchitektur von GPU und TPU 8i Max im Vergleich
Um die Einordnung der TPU 8i Max besser zu verstehen, können wir die aktuelle Rubin-Architektur von NVIDIA als Vergleich für GPUs heranziehen.
| Merkmal | NVIDIA Rubin GPU | Google TPU 8i Max |
|---|---|---|
| Bezugsgröße | Einzelne GPU | Gehäuse mit zwei TPU-Chips |
| HBM-Kapazität | 288 GB HBM4 | 384 GB HBM (Medienberichten zufolge) |
| HBM-Bandbreite | 22 TB/s | 17,2 TB/s (Medienberichten zufolge) |
| On-Chip-Speicher | Je nach Architekturkonfiguration | 768 MB SRAM (Medienberichten zufolge) |
| Chip-zu-Chip-Verbindung | NVLink 6 | Boardfly-Netzwerk mit niedriger Latenz (TPU-8i-System) |
| Software-Ökosystem | CUDA und gängige Inferenz-Engines | JAX, TorchTPU, vLLM- / SGLang-TPU-Backends |
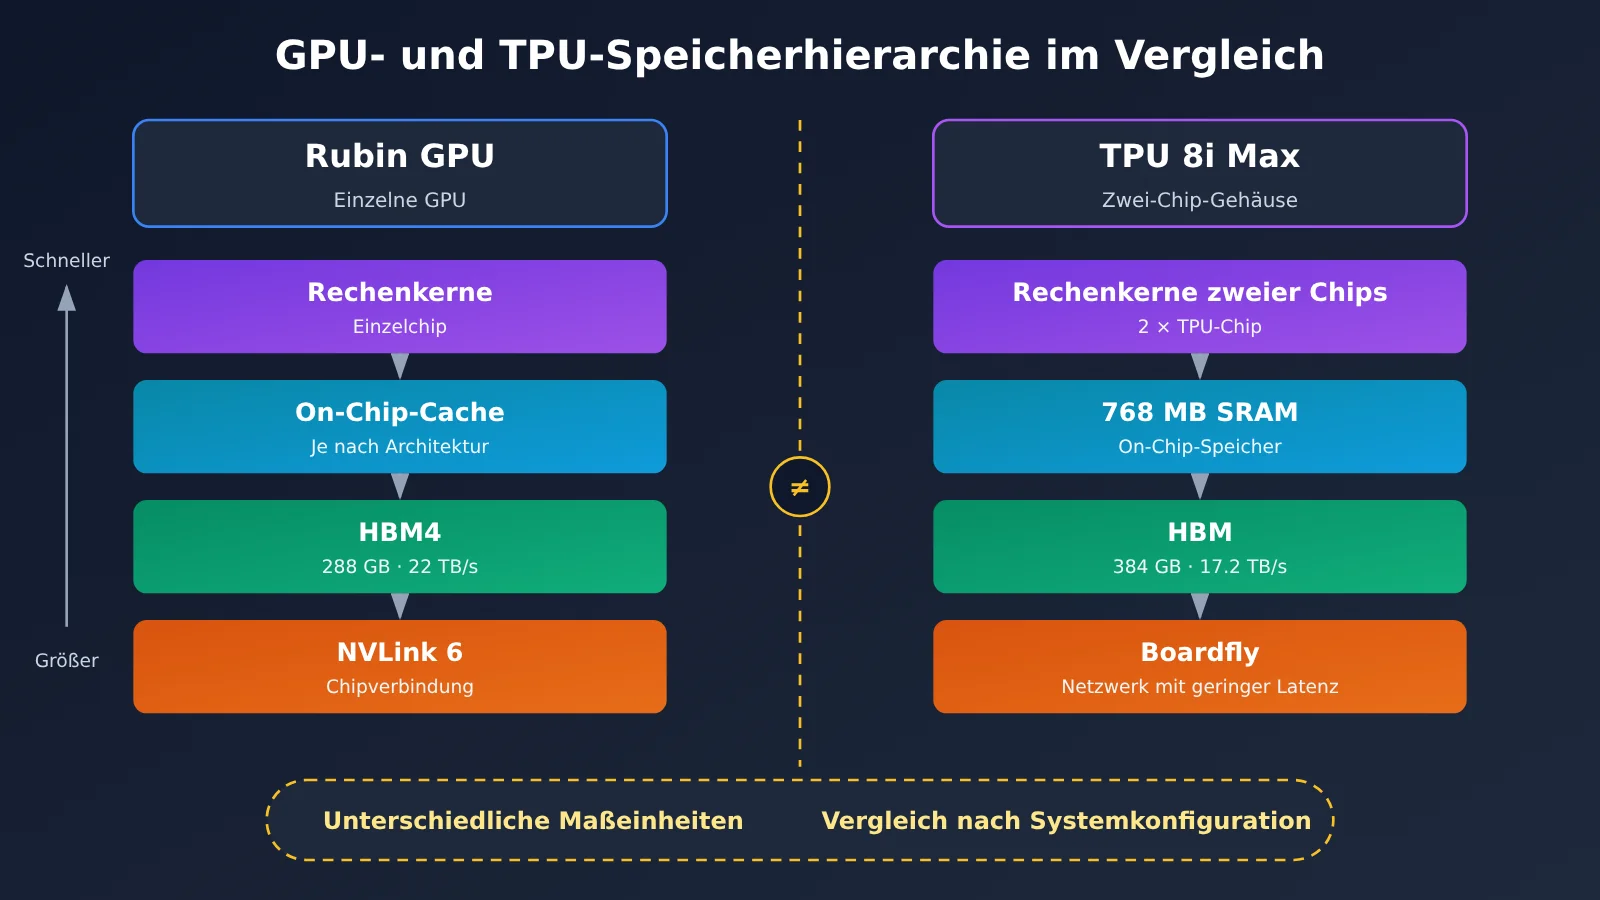
Diese Tabelle eignet sich nicht für eine einfache Rangliste. Die 384 GB und 288 GB beziehen sich auf unterschiedliche Einheiten: einmal auf ein Gehäuse mit zwei Chips, einmal auf eine einzelne GPU. Auch HBM-Generation, Verbindungstechnik, Rechenarchitektur und Systemkonfiguration unterscheiden sich. Bei der Bandbreite liegt die einzelne Rubin-GPU vorn, bei der Kapazität die TPU 8i Max. Beides lässt sich jedoch nicht unabhängig vom jeweiligen Systemmaßstab betrachten.
Entscheidend ist vielmehr, wie viele gleichzeitig aktive Kontexte ein Gesamtsystem bei gleicher Leistungsaufnahme, gleichem Rack-Platzbedarf und gleichen Kosten zuverlässig unterstützen kann – und welchen Durchsatz, welche Latenz und Energieeffizienz es dabei erreicht. Mit Stand vom 10. November 2026 gibt es zur TPU 8i Max noch keine unabhängig überprüfbaren Messergebnisse, die öffentlich zugänglich sind. Für solche Systemvergleiche müssen wir daher auf Daten nach der offiziellen Markteinführung warten.
💡 Empfehlung: Für die meisten Teams, die Agents über eine API entwickeln, ist es nicht nötig, selbst zu entscheiden, ob im Hintergrund GPUs oder TPUs zum Einsatz kommen. Sinnvoller ist es, die Latenz und den Preis der verschiedenen Modelle bei langen Kontexten zu vergleichen. Über die einheitliche Schnittstelle von APIYI unter apiyi.com lassen sich mehrere Modelle parallel mit Eingabeaufforderungen aus dem eigenen Geschäftskontext testen.
Auswirkungen von TPU 8i Max auf die Agentenentwicklung
Kontextfenster, tatsächliche Parallelität und Inferenzlatenz unterscheiden
Das angegebene Kontextfenster eines Modells sagt nur aus, „wie viel theoretisch hineinpasst“. Es bedeutet nicht, dass der Server bei dieser Länge eine bestimmte Anzahl gleichzeitiger Anfragen bewältigen kann – und schon gar nicht, dass die Latenz dabei akzeptabel bleibt. Die Berechnungen oben zeigen bereits: Bei einem Kontext von jeweils 128K unterscheidet sich der KV-Cache-Bedarf für eine Sitzung um den Faktor 8 von dem für acht Sitzungen. Für Entwickler gilt es, drei Kennzahlen getrennt zu betrachten:
- Kontextfenster: der maximale Umfang, den das Modell verarbeiten kann. Es bestimmt, wie viele Informationen sich in einer einzelnen Anfrage unterbringen lassen.
- Tatsächliche Parallelität: wie viele lange Sitzungen die Hardware gleichzeitig aufrechterhalten kann. Sie wird durch die HBM-Kapazität begrenzt.
- Inferenzlatenz: Die TTFT wird von der Rechenlast beim Prefill beeinflusst, die Geschwindigkeit pro Token von der Bandbreite und der Größe des KV-Caches.
Drei zunehmend verbreitete Ansätze zur Entlastung
Hardware ist nur die eine Hälfte der Lösung für die Memory Wall, die andere liegt auf der Softwareebene. Das ebenfalls von Google als Open Source veröffentlichte TPU Sync sowie die TPU-Versionen von vLLM und SGLang setzen auf die folgenden Techniken:
| Technik | Welches Problem sie löst | Nachteile und Hinweise |
|---|---|---|
| KV-Cache-Offloading | Lagert vorübergehend nicht benötigte Caches aus dem HBM in den Hauptspeicher (DRAM), auf SSDs oder in gemeinsamen Speicher aus und überwindet so Kapazitätsgrenzen | Beim Wiederherstellen entstehen Übertragungszeiten; effizientes DMA und asynchrone Übertragung sind wichtig |
| KV-Cache-Quantisierung | Reduziert die Bytezahl pro Element und senkt so direkt den Bedarf an Kapazität und Bandbreite | Die Auswirkungen auf die Genauigkeit müssen bewertet werden |
| Trennung von Prefill und Decode | Verarbeitet das rechenintensive Prefill und das bandbreitenintensive Decode auf unterschiedlichen Knoten | KV-Caches müssen schnell zwischen den Knoten übertragen werden |
| Prefix-Caching | Verwendet identische System-Eingabeaufforderungen und historische Präfixe wieder, um wiederholtes Prefill zu vermeiden | Hängt davon ab, wie häufig sich Anfragen am Anfang gleichen |
Die von Google veröffentlichten Daten zu TPU Sync zeigen, dass sich die Übertragungslatenz des KV-Caches um mehr als 90 % senken lässt. Beim Prefix-Caching mit einem 64K-Kontext sinkt die TTFT um bis zu 90 %. Diese Tests basieren jedoch auf der Ironwood-TPU der siebten Generation. In der GitHub-README werden derzeit v7x und v6e als aktiv validierte Hardware aufgeführt. Die Ergebnisse lassen sich daher nicht direkt auf die TPU 8i Max übertragen.
Auswirkungen auf die tatsächliche Leistung und den Ressourcenverbrauch
Für API-Aufrufer zeigen sich diese Optimierungen auf niedriger Ebene letztlich in zwei Punkten: Bleibt die Latenz bei Anfragen mit langem Kontext stabil, und sinken die Kosten pro Token? Auch auf Anwendungsebene können Sie sich am Prinzip „weniger Speicher belegen“ orientieren: Kürzen Sie System-Eingabeaufforderungen und halten Sie Präfixe stabil, damit der Cache greift. Fassen Sie Tool-Ausgaben zusammen, bevor Sie sie wieder in den Kontext aufnehmen, und geben Sie Sub-Agenten nur die benötigten Ausschnitte statt des gesamten Verlaufs weiter.
Das folgende Beispiel misst mithilfe der Streaming-Ausgabe die Zeit bis zum ersten Token bei unterschiedlichen Kontextlängen. So lässt sich beobachten, wie sich ein wachsender Kontext auf das Prefill auswirkt:
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI-kompatible Schnittstelle
)

def measure_ttft(context: str, model: str = "gpt-4o-mini") -> float:
    start = time.perf_counter()
    stream = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": context + "\n请用一句话总结上文。"}],
        stream=True,
    )
    for chunk in stream:
        if chunk.choices and chunk.choices[0].delta.content:
            return time.perf_counter() - start
    return -1.0

print(f"TTFT: {measure_ttft('示例代码片段 ' * 2000):.2f}s")
Batch-Testcode für mehrere Modelle und Kontextlängen anzeigen
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Mit einem Schlüssel zwischen mehreren Modellen wechseln
)

MODELS = ["gpt-4o-mini", "claude-sonnet-4", "gemini-2.5-flash"]
LENGTHS = [1_000, 5_000, 20_000]  # Anzahl der Wiederholungen; vergrößert den Kontext näherungsweise

def run_once(model: str, repeat: int) -> dict:
    context = "def handler(event):\n    return process(event)\n" * repeat
    start = time.perf_counter()
    first, tokens = None, 0
    try:
        stream = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": context + "\n指出上面代码的潜在问题。"}],
            stream=True,
            max_tokens=200,
        )
        for chunk in stream:
            if chunk.choices and chunk.choices[0].delta.content:
                tokens += 1
                if first is None:
                    first = time.perf_counter() - start
        total = time.perf_counter() - start
        return {"model": model, "repeat": repeat, "ttft": first, "total": total, "chunks": tokens}
    except Exception as e:
        return {"model": model, "repeat": repeat, "error": str(e)}

for m in MODELS:
    for n in LENGTHS:
        print(run_once(m, n))
🚀 Schnelleinstieg: Registrieren Sie sich bei APIYI unter apiyi.com und sichern Sie sich ein kostenloses Testkontingent. Lassen Sie
base_urlim obigen Skript aufhttps://api.apiyi.com/v1eingestellt. So erhalten Sie in wenigen Minuten TTFT-Kurven für mehrere Modelle bei unterschiedlichen Kontextlängen.
Auswirkungen auf die Branche
- Systemanpassungen gewinnen an Tempo: Google bringt mit dem Ansatz „gleicher Chip, unterschiedliche Systeme“ schnell Konfigurationen für spezialisierte Workloads auf den Markt. Das zeigt, dass sich der Wettbewerb bei Beschleunigern von den Kennzahlen einzelner Chips hin zum Systemdesign verlagert.
- Hardware und Software greifen enger ineinander: TPU 8i Max wurde zusammen mit TPU Sync, Agent Compute Engine und einer Inferenz-Engine für TPU vorgestellt. Um die Speicherwand zu überwinden, braucht es sowohl hohe Hardware-Bandbreite als auch eine intelligente Software-Planung.
- Die Kommerzialisierung steht noch am Anfang: Wie 8t, 8i und 8tx ist auch TPU 8i Max mit „Coming soon“ gekennzeichnet. Preise und ein offizieller Verfügbarkeitstermin sind noch nicht bekannt; das tatsächliche Preis-Leistungs-Verhältnis muss sich erst noch zeigen.
Häufig gestellte Fragen (FAQ)
F1: Was ist TPU 8i Max?
TPU 8i Max ist eine am 9. November 2026 von Google vorgestellte Konfiguration des TPU-Systems der achten Generation. Sie vereint zwei TPU 8i in einem einzigen Package. Rechenleistung, On-Chip-SRAM und HBM-Bandbreite sind jeweils doppelt so hoch wie bei der TPU 8i. TPU 8i Max ist vor allem für Inferenz mit langen Kontexten, hoher Parallelität und der Zusammenarbeit mehrerer Agents ausgelegt. Es handelt sich nicht um einen vollständig neu entwickelten Chip.
F2: Hat sich die HBM-Kapazität der TPU 8i Max verdoppelt?
Nein. Laut dem veröffentlichten Medienbriefing steigt die HBM-Kapazität von 288 GB auf 384 GB, also um etwa 33 %. Verdoppelt haben sich hingegen die HBM-Bandbreite (von etwa 8,6 TB/s auf 17,2 TB/s) und der SRAM (von 384 MB auf 768 MB). Kapazität und Bandbreite sind zwei unabhängige Kennzahlen und dürfen nicht verwechselt werden.
F3: Ist TPU 8i Max bereits verfügbar? Was kostet sie?
Am 10. November 2026 ist TPU 8i Max auf der offiziellen Google-Cloud-Produktseite als „Coming soon“ gekennzeichnet. Ein öffentlicher Preis und ein offizielles Datum für die allgemeine Verfügbarkeit (GA) wurden noch nicht bekannt gegeben. Auch unabhängige Leistungstests, die öffentlich überprüft werden können, liegen nicht vor. Als Referenz dienen derzeit nur die offiziellen Angaben von Google und die Kennzahlen aus dem Medienbriefing.
F4: Ermöglicht TPU 8i Max einem einzelnen Modell einen Kontext von einer Million Token?
Google nennt Kontexte im Millionen-Token-Bereich als mögliches Anwendungsgebiet. Das ist jedoch keine offiziell angegebene feste Obergrenze für die Kontextlänge. Wie viel Kontext ein Modell verarbeiten kann, hängt zunächst vom Modell selbst ab. Die Hardware bestimmt, wie viele Anfragen bei dieser Kontextlänge parallel verarbeitet werden können und ob die Latenz akzeptabel bleibt.
F5: Wie können Anwendungsentwickler prüfen, wie sich lange Kontexte auf die Latenz auswirken?
Am einfachsten lässt sich das messen, indem Sie reale Geschäftskontexte unterschiedlicher Länge verwenden und TTFT sowie Ausgabegeschwindigkeit vergleichen:
1. Besuchen Sie APIYI unter apiyi.com, registrieren Sie ein Konto und erhalten Sie einen API-Schlüssel sowie ein kostenloses Testguthaben.
2. Verwenden Sie das Tests skript aus diesem Artikel und setzen Sie `base_url` auf `https://api.apiyi.com/v1`.
3. Testen Sie mit derselben Kontextgruppe mehrere Modelle und vergleichen Sie, wie stark die Latenz mit zunehmender Länge ansteigt.
F6: Welche Einschränkungen haben KV-Cache-Quantisierung und -Offloading?
Quantisierung reduziert unmittelbar den Speicher- und Bandbreitenbedarf, kann aber zu Genauigkeitsverlusten führen. Deshalb sollte sie für die jeweilige Zielaufgabe evaluiert werden. Offloading kann die Grenzen der HBM-Kapazität umgehen, doch beim Wiederherstellen der Daten entsteht Übertragungszeit. Sind die Übertragungen zwischen den Speicherebenen nicht schnell genug, kann die Latenz dadurch sogar steigen. Beide Verfahren müssen auf die Parallelität und die angestrebte Latenz abgestimmt werden.
Agent-Systeme mit langen Kontexten und TPU 8i Max: die wichtigsten Erkenntnisse
- Der Engpass verschiebt sich: Bei der Inferenz von Agent-Systemen geht es zunehmend darum, Rechenleistung und die Versorgung mit Speicherdaten ins Gleichgewicht zu bringen.
- Der KV-Cache wächst linear: Bei Llama 3.1 70B belegt jeder Token etwa 320 KiB. Eine einzelne Anfrage mit 128K Token benötigt rund 40 GiB.
- GQA ist entscheidend: Mit 8 KV-Heads belegt der Cache nur ein Achtel des Speichers, den standardmäßige Multi-Head-Attention benötigt.
- Decode ist bandbreitenintensiv: Für jeden generierten Token muss der gesamte KV-Cache gelesen werden. Bei langen Kontexten bestimmt die Speicherbandbreite daher maßgeblich die Latenz.
- Skalierung in mehreren Bereichen: Bei der TPU 8i Max verdoppeln sich Rechenleistung, SRAM und HBM-Bandbreite gleichzeitig; die HBM-Kapazität steigt dagegen nur um etwa 33 %.
- Auch die Software zählt: Offloading, Quantisierung, die Trennung von Prefill und Decode sowie Prefix-Caching sind die wichtigsten Maßnahmen gegen die Speicherwand.
- Selbst testen: Mit der einheitlichen Schnittstelle von APIYI unter apiyi.com lässt sich die Latenz verschiedener Modelle bei langen Kontexten in der Praxis vergleichen.
Zusammenfassung
Die wichtigsten Punkte zur Speicherwand bei der Inferenz von Agent-Systemen mit langen Kontexten:
- Woher der Druck kommt: Codebasen, Tool-Ergebnisse und Ausgaben von Sub-Agenten sammeln sich laufend an. Kommen mehrere gleichzeitig aktive Agenten hinzu, wächst der KV-Cache entsprechend stark.
- Der Hardware-Ansatz: Die TPU 8i Max setzt nicht einfach nur auf mehr Rechenleistung. Vielmehr werden Rechenleistung, SRAM und HBM-Bandbreite gleichzeitig skaliert, damit Datenversorgung und Berechnungen im Gleichgewicht bleiben.
- Grenzen der Einsatzmöglichkeiten: Die HBM-Kapazität steigt nur begrenzt, und das Produkt ist noch nicht kommerziell verfügbar. Ob sich der Ansatz in der Praxis bewährt, müssen Messungen auf Systemebene zeigen.
Für die meisten Entwickler ist es derzeit sinnvoller, die Kostenstruktur des KV-Caches zu verstehen, das Anwachsen des Kontexts auf Anwendungsebene zu begrenzen und die Latenz sowie die Preise von Modellservices bei langen Kontexten im Blick zu behalten. Mit APIYI unter apiyi.com können Sie mehrere Modelle anhand realer Geschäftsdaten vergleichen. Die Plattform bietet eine OpenAI-kompatible Schnittstelle und ein kostenloses Startguthaben für neue Nutzer.
📚 Quellen
- Google Cloud Blog – Introducing TPU 8tx and TPU 8i Max: Offizielle technische Ankündigung zur Veröffentlichung
- Link:
cloud.google.com/blog/topics/ai-infrastructure/tpu-8tx-and-tpu-8i-max -
Hinweis: Bestätigt das Dual-Chip-Gehäuse sowie die Verdopplung von Rechenleistung, SRAM und HBM-Bandbreite
-
Google Cloud – Inside the eighth-generation TPU: Detaillierte Analyse der TPU-Architektur der achten Generation
- Link:
cloud.google.com/blog/products/compute/tpu-8t-and-tpu-8i-technical-deep-dive -
Hinweis: Ursprüngliche Spezifikationen der TPU 8i und die Boardfly-Netzwerkarchitektur
-
Google Cloud – Introducing TPU Sync: Bibliothek für die Übertragung von KV-Cache und Gewichten
- Link:
cloud.google.com/blog/topics/ai-infrastructure/introducing-tpu-sync-fast-kv-cache-and-weight-transfer-on-tpu -
Hinweis: Mehrstufige Speicherhierarchie und Testergebnisse zum KV-Cache-Offloading (basierend auf Ironwood)
-
Network World – Google targets AI’s next infrastructure bottlenecks: Medienbericht mit einer kurzen Einordnung
- Link:
networkworld.com/article/4245897 -
Hinweis: Absolute Werte zu HBM-Kapazität, Bandbreite und SRAM der TPU 8i Max
-
Google TPU Sync auf GitHub: Open-Source-Repository
- Link:
github.com/google/tpu-sync - Hinweis: Informationen zu unterstützter Hardware und Entwicklungsstatus
Autor: Technisches Team von APIYI
Technischer Austausch: Kontaktieren Sie uns gern über die Startseite der APIYI-Website. Weitere Informationen zur Anbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com