Autorennotiz: Anhand offizieller Benchmarks und Einschränkungen zeigt dieser Artikel, worin Claude Fable 5.2 stark ist, wo seine Grenzen liegen und wann ein Wechsel von Opus 5.5 nicht sinnvoll ist.
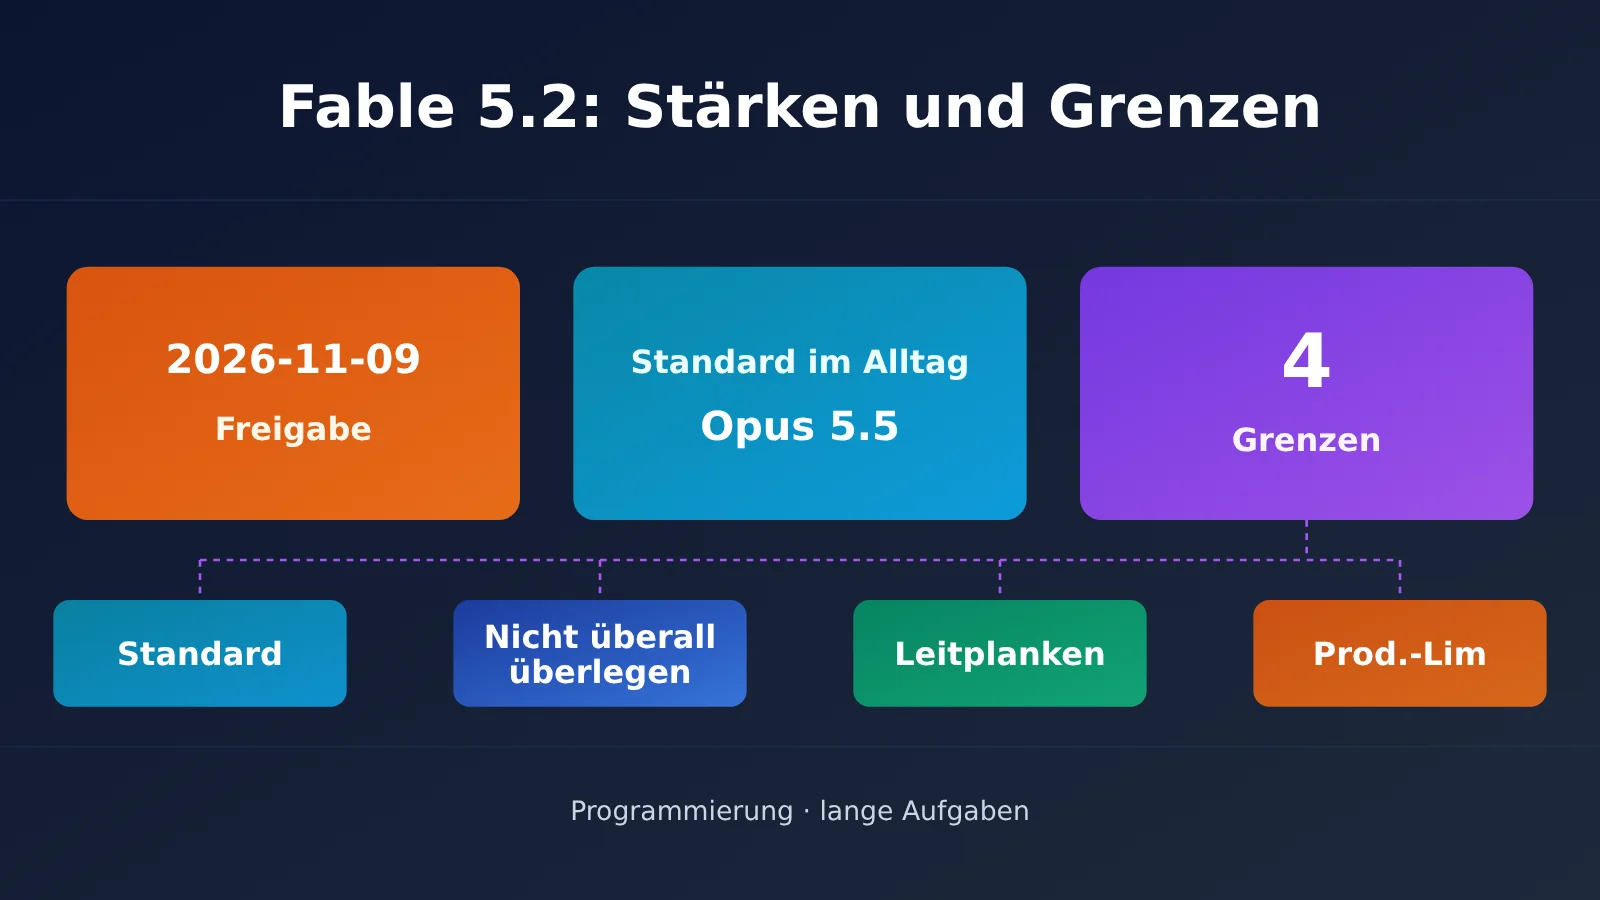
Claude Fable 5.2 ist das am 2026-11-09 von Anthropic veröffentlichte Flaggschiff für technische Aufgaben. Anthropic empfiehlt selbst, für die meisten Programmier- und Wissensaufgaben weiterhin mit Opus 5.5 zu beginnen. Fable 5.2 eignet sich für die größten, offensten und langwierigsten technischen Aufgaben.
Das hier ist keine bloße Wiedergabe einer Rangliste. Alle Benchmarks in diesem Artikel stammen aus der Veröffentlichung von Anthropic vom 2026-11-09; die Einschränkungen sind der offiziellen Modellseite und den Aktualisierungshinweisen entnommen. Danach kennen Sie vier Grenzen: Wo Fable 5.2 deutlich stärker ist, wo es nicht in allen Punkten überlegen ist, wo Schutzmechanismen es stoppen und wo Produktmechanismen ihm Grenzen setzen.
Der zentrale Nutzen: Wenn Sie bereits die Claude API verwenden, hilft Ihnen dieser Artikel bei der Entscheidung, ob sich ein Upgrade von Opus 5.5 auf Fable 5.2 lohnt – und welche Auswirkungen das auf Ihre Kosten und Aufrufparameter hat.
Die wichtigsten Fakten zu Claude Fable 5.2
Die häufigsten Fragen vorweg – kompakt in einer Tabelle. Alle Zahlen stammen von der offiziellen Modellseite und aus der Ankündigung. Recherchestand: 10.11.2026.
| Punkt | Offizielle Angaben | Was das für Sie bedeutet |
|---|---|---|
| Positionierung | Technisches Spitzenmodell, geeignet für besonders anspruchsvolle und offene technische Aufgaben | Nicht als Standard für den Alltag gedacht – dafür bleibt Opus 5.5 die erste Wahl |
| Verhältnis zu Mythos | Dasselbe zugrunde liegende Modell, aber mit stärkeren Schutzvorkehrungen bei Fable; für alle Nutzer verfügbar | Mythos ist kein anderes, leistungsfähigeres Modell |
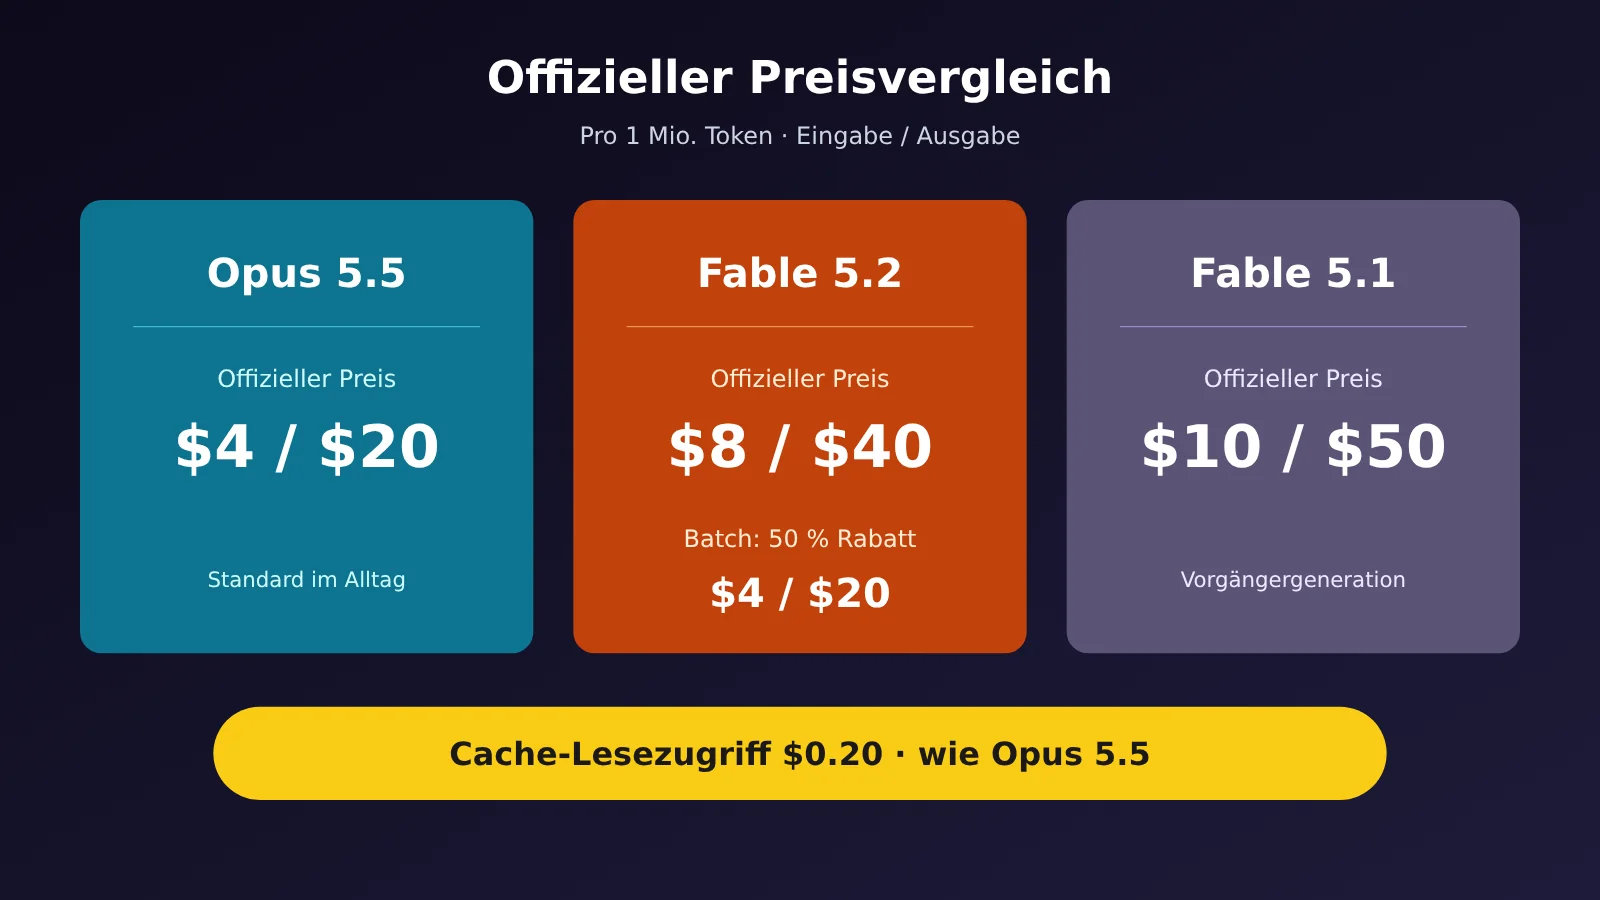
| Standardpreis | 8 $ für Eingaben, 40 $ für Ausgaben (pro Million Token) | Doppelt so teuer wie Opus 5.5, aber 20 % günstiger als Fable 5.1 |
| Denken | Adaptives Denken ist immer aktiviert und lässt sich nicht ausschalten | Wenn das Modell weniger nachdenken soll, können Sie nur den Effort-Wert anpassen |
| Datenspeicherung | Standardmäßig ist eine Aufbewahrungsdauer von 30 Tagen vorgesehen | Bei Anforderungen an eine Speicherung von null Tagen sollten Sie vorab die Berechtigung prüfen |
Wie hängen Claude Fable 5.2 und Mythos 5.2 zusammen?
In der Ankündigung steht es ganz klar: Claude Fable und Claude Mythos basieren auf demselben Modell. Fable verfügt jedoch über stärkere Schutzvorkehrungen für Cybersicherheit und Biosicherheit und ist deshalb für alle Nutzer verfügbar. Mythos wird ausschließlich Organisationen bereitgestellt, die für Prüfprogramme in den Bereichen Biowissenschaften oder Cybersicherheit zugelassen wurden. Beide Modelle kosten gleich viel.
Die Annahme, „Mythos sei leistungsfähiger“, ist also ein Missverständnis. Einige der in der Ankündigung aufgeführten Ergebnisse aus den Bereichen Cybersicherheit und Biosicherheit beziehen sich auf Mythos 5.2 – etwa die 76,3 % bei CyScenarioBench. Diese Werte gelten für Mythos ohne gleichwertige Schutzvorkehrungen und lassen sich nicht Fable zuschreiben. Für gewöhnliche API-Nutzer ist Fable 5.2 das verfügbare Modell.
Spezifikationen und offizielle Preise von Claude Fable 5.2
Die folgende Tabelle vergleicht die drei Modelle auf den offiziellen Modellseiten. Die vollständigen Spezifikationen von Fable 5.1 konnten diesmal nicht ermittelt werden; die Preisinformationen dazu finden Sie weiter unten.
| Spezifikation | Claude Fable 5.2 | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|---|
| Kontextfenster | 1M Token | 1M Token | 1M Token |
| Maximale Ausgabe (synchroner Messages API-Aufruf) | 128K | 128K | 128K |
| Standardpreis (Eingabe / Ausgabe) | $8 / $40 | $4 / $20 | $2 / $10 |
| Latenzstufe | Moderate | Moderate | Fast |
| Standard-Effort in der Claude API | high | medium | high |
| Wissensstand bis | Juni 2026 | Juni 2026 | Juni 2026 |
Fable 5.2 verarbeitet Text und Bilder und gibt Text aus. Auf der Modellseite werden 1M Token mit etwa 555.000 Wörtern oder 2,5 Millionen Unicode-Zeichen gleichgesetzt. Diese Angaben beruhen auf dem aktuellen Tokenizer und bedeuten nicht, dass sich garantiert eine ebenso große Menge chinesischer Texte verarbeiten lässt.
Beachten Sie, dass sich die Ausgabe bei einigen Modellen über die Message Batches API mithilfe eines Beta-Headers auf 300K erhöhen lässt. Opus 5.5 steht auf der entsprechenden Liste, Fable 5.2 jedoch nicht. Bis es eine offizielle Ergänzung gibt, sollten Sie bei der Planung längerer Ausgaben mit 128K rechnen.
Die weiteren offiziellen Preise pro eine Million Token:
- Caching: Das Schreiben eines 5-Minuten-Caches kostet $10, das eines 1-Stunden-Caches $16 und das Lesen aus dem Cache $0.20. Der Preis für Cache-Lesevorgänge entspricht dem 0,025-Fachen des Standardpreises für Eingaben.
- Batchverarbeitung: Eingaben und Ausgaben kosten jeweils die Hälfte. Für Fable 5.2 liegen die Preise bei $4 für Eingaben und $20 für Ausgaben.
- Fast-Modus: Dasselbe Modell mit unveränderter Intelligenz, aber einer bis zu 2,5-mal höheren Ausgabegeschwindigkeit als im Standardmodus. Der Preis beträgt $16 für Eingaben und $80 für Ausgaben. Der Fast-Modus von Opus 5.5 kostet $8 / $40.
- Caching im Fast-Modus: Die Dokumentation enthält keine separate Preistabelle, sondern weist darauf hin, dass die Cache-Multiplikatoren zusätzlich zu den Preisen des Fast-Modus gelten. Daraus ergeben sich geschätzte Preise von etwa $0.40 für Cache-Lesevorgänge, $20 für das Schreiben eines 5-Minuten-Caches und $32 für das Schreiben eines 1-Stunden-Caches.
- Fast-Modus-Parameter: In der Claude API heißt das Feld
speedund akzeptiert den Wertfast. Bei Microsoft Foundry gibt es stattdessen eine eigene Modell-ID mit der Endung-fast; der Anfrage sollte keinspeed-Parameter hinzugefügt werden.
Noch eine häufige Fehlerquelle: Die Caches für verschiedene Geschwindigkeitsmodi werden nicht gemeinsam genutzt. Wenn Sie vom Fast- in den Standardmodus wechseln, kommt es daher zu Cache-Fehlschlägen. In der Ankündigung zum Fast-Modus ist Amazon Bedrock nicht als verfügbarer Kanal aufgeführt. Das Standardmodell ist jedoch auf Bedrock verfügbar und hat die ID anthropic.claude-fable-5-2.
Offizielle Leistungsdaten zu Claude Fable 5.2
Diese vier Zahlen zeigen am deutlichsten, worin Fable 5.2 besonders stark ist. Sie stammen alle aus der Veröffentlichung von Anthropic vom 09.11.2026. Für Fable 5.2, Fable 5.1 und Opus 5.5 gelten – sofern nicht anders angegeben – die Werte mit aktivierten Schutzmechanismen. Für die Tabelle gilt: Mit Ausnahme der ausdrücklich genannten Stufen wurde jedes Modell in der jeweils höchsten Effort-Stufe getestet, nicht in der Standardeinstellung.
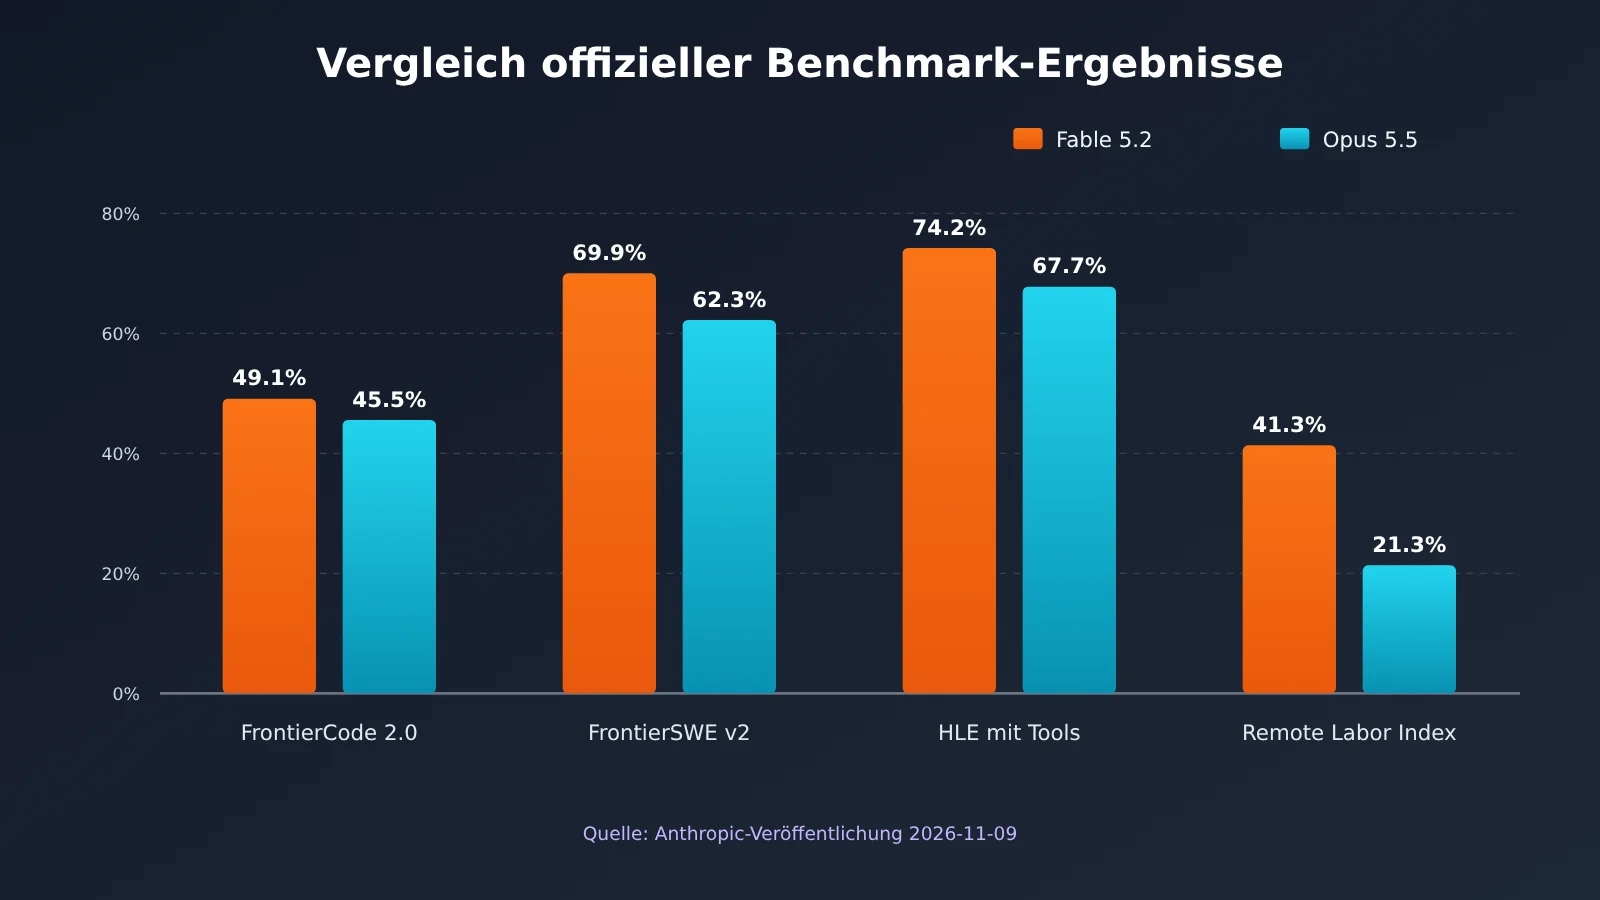
| Benchmark | Fable 5.2 | Hinweis zur Effort-Stufe | Vergleichswert für Opus 5.5 |
|---|---|---|---|
| FrontierCode 2.0 | 49.1 % | In der Tabelle ausdrücklich als Xhigh-Stufe angegeben | 45.5 % (Standardangabe der Tabelle, entspricht der höchsten Effort-Stufe) |
| FrontierSWE v2 | 69.9 % | Nicht gesondert angegeben, entspricht der höchsten Effort-Stufe | 62.3 % (höchste Effort-Stufe) |
| Humanity’s Last Exam (mit Tools) | 74.2 % | Nicht gesondert angegeben, entspricht der höchsten Effort-Stufe | 67.7 % (höchste Effort-Stufe) |
| Remote Labor Index | 41.3 % | In der Tabelle ausdrücklich als High-Stufe angegeben, nicht die höchste Stufe | 21.3 % (höchste Effort-Stufe) |
So sind die Codingleistungen von Claude Fable 5.2 einzuordnen
FrontierCode misst, ob Änderungen von den Maintainerinnen und Maintainern eines Open-Source-Repositorys übernommen werden – das kommt der Arbeit in realen Softwareprojekten näher als ein bloßes Bestehen von Tests. Mit 49,1 % erreicht Fable 5.2 im Xhigh-Modus den höchsten Wert unter den von Anthropic getesteten veröffentlichten Modellen. In der Ankündigung nennt Anthropic noch eine praktischere Zahl: Im High-Modus erzielt Fable 5.2 etwa 45,3 % und liegt damit fast gleichauf mit dem Bestwert von Opus 5.5 mit 45,5 % – bei ungefähr der Hälfte der Kosten pro Aufgabe.
Diese Aussage ist für alle wichtig, die Kosten kalkulieren. Sie zeigt, dass der Nutzen von Fable 5.2 nicht nur darin liegt, im höchsten Modus besser abzuschneiden: Auch im High-Modus könnte das Modell dieselbe Aufgabe mit weniger Tokens erledigen. Das gilt allerdings nur für diese Benchmark, wie Anthropic selbst betont. Wie die Ergebnisse in deinem Repository ausfallen, musst du selbst überprüfen.
Der größte Abstand zeigt sich beim Remote Labor Index: 41,3 % gegenüber 21,3 %. Dabei wurde Fable 5.2 im High-Modus getestet, nicht im höchsten Modus. Diese Aufgaben zielen auf die vollständige Erledigung von Arbeit aus der Ferne ab und passen damit zur Positionierung als Modell für „offene, lang laufende technische Aufgaben“.
Die Langzeitaufgaben-Beispiele zu Claude Fable 5.2 sind als Einzelversuche zu betrachten
In der Ankündigung finden sich einige beeindruckende Beispiele. Beim Lesen solltest du darauf achten, wer jeweils gehandelt hat und wie oft der Versuch durchgeführt wurde:
- Prototyp eines Betriebssystems: Ein Ingenieur ließ Fable 5.2 ausgehend von einem leeren Ordner mehr als 1.000 Subagenten koordinieren. Nach rund acht Tagen entstand ein System, das sich auf einem Laptop starten ließ. Die Ankündigung beschreibt dies nicht als wiederholten Versuch – es ist daher als einzelnes offizielles Experiment zu betrachten.
- Formalisierung des Großen Fermatschen Satzes: 1.000 Fable-5.2-Agenten arbeiteten 30 Stunden lang, mit nur wenigen Eingriffen durch Menschen. Mit derselben Konfiguration erledigte Opus 5.5 in 18 Stunden rund 26 % der Aufgabe und kam nach 30 Stunden kaum noch voran. Laut Bildunterschrift wurde jedes Modell nur einmal ausgeführt.
- Migration von Python zu Rust: Die Migration eines wichtigen Produktionsdienstes zu Rust, der dadurch rund 26-mal schneller startete, wurde von einer Gruppe von Fable-5.2-Agenten aus einer früheren Version durchgeführt – nicht von der veröffentlichten Version 5.2.
- 90 % zusammengeführte Änderungen: Laut Ankündigung wurde mehr als 90 % der zusammengeführten Änderungen im zentralen Code-Repository von Claude geschrieben, unter Anleitung eines Menschen. Gemeint ist Claude allgemein, nicht ausschließlich Fable 5.2.
Diese Beispiele zeigen, was möglich ist, sind aber kein Beleg für konstant gleichbleibende Ergebnisse. Wenn dein Geschäft davon abhängt, dass das Modell mehrere Tage am Stück arbeitet, solltest du das als Annahme betrachten, die du selbst überprüfen musst.
Die vier Grenzen von Claude Fable 5.2
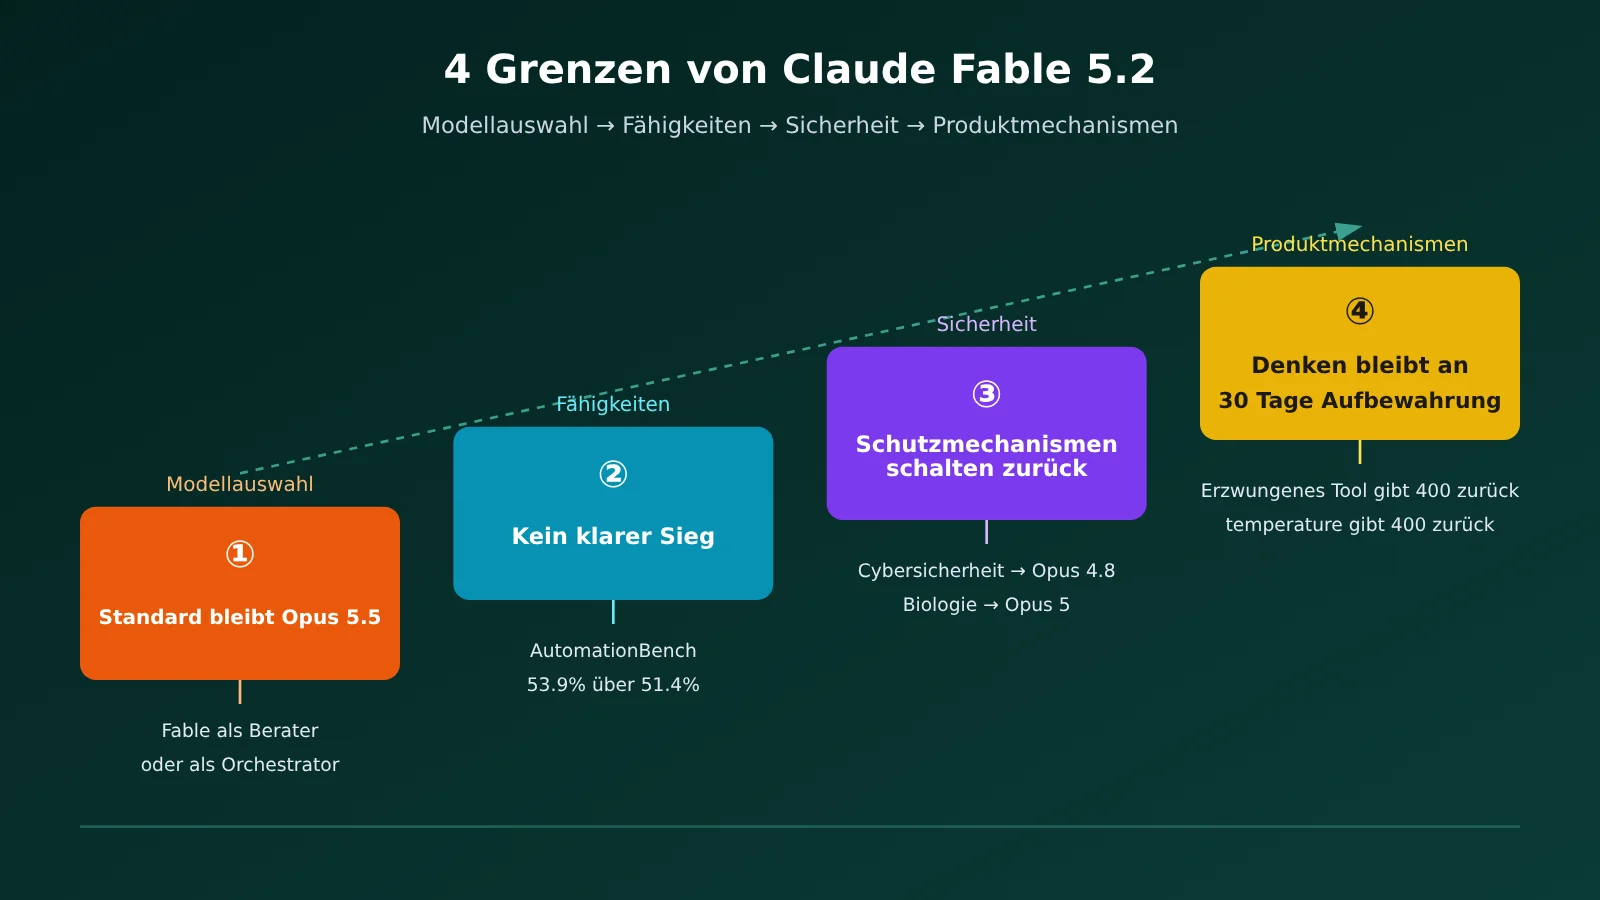
Die Ergebnisse zeigen, worin das Modell besonders stark ist. Die folgenden vier Punkte zeigen, wo seine Stärken an Grenzen stoßen. Die Reihenfolge lautet: „Modellauswahl → Fähigkeiten → Sicherheit → Produktmechanismen“.
Grenze 1: Claude Fable 5.2 ist nicht die Standardwahl für den Alltag
Die Empfehlungen im Ankündigungsbeitrag lauten: Bei den meisten Programmier- und Wissensaufgaben zunächst mit Opus 5.5 starten und je nach Schwierigkeitsgrad zu Fable oder Mythos wechseln – oder zu Sonnet 5.5 beziehungsweise Haiku 5.5, wenn ein kleineres Modell genügt. Fable 5.2 eignet sich am besten für besonders anspruchsvolle und offene technische Aufgaben.
Es gibt außerdem zwei sparsamere Einsatzmöglichkeiten. Erstens kann Fable als Berater dienen, den kleinere Modelle bei schwierigen Fragen hinzuziehen. Zweitens kann es als Orchestrator Aufgaben aufteilen und die einfacheren Teile an kleinere Modelle delegieren. So werden die teuren Tokens nur für den schwierigsten Schritt eingesetzt.
Grenze zwei: Die Ergebnistabelle von Claude Fable 5.2 zeigt keine uneingeschränkte Dominanz
Als Vergleichsmodelle nennt der Launch-Beitrag GPT-6 Astra und Gemini 4 Carbon. Die Tabelle stammt von Anthropic, nicht von OpenAI oder Google. Und selbst in dieser Tabelle gibt es Disziplinen, in denen Fable 5.2 verliert.
| Benchmark | Fable 5.2 | Führend | Hinweis |
|---|---|---|---|
| AutomationBench | 51.4% | Gemini 4 Carbon 53.9% | Hier liegt Carbon vorn |
| AA-Briefcase v1.1 Elo | 1785 | Opus 5.5 1800 | Beim Elo-Wert führt Opus |
| AA-Briefcase v1.1 Regelbewertung | 66.1% | Fable 5.2 | Opus 5.5 erreicht 61.2% |
| Chartography (ohne Tools) | 73.4% | Fable 5.2 | Carbon kommt auf 72.5%, Astra auf 71.0% – der Abstand ist gering |
Die Zeile zu AA-Briefcase lohnt einen genaueren Blick. Bei der Regelbewertung liegt Fable vorn, beim Elo-Wert hingegen Opus. Das zeigt: Bei eher subjektiven Präferenzbewertungen kommt das teurere Modell nicht unbedingt besser an. Wenn Sie Briefings schreiben oder dokumentenbasierte Wissensarbeit erledigen, ist Opus 5.5 keine bloße Ausweichoption.
Grenze drei: Die Sicherheitsmechanismen von Claude Fable 5.2 ändern, wer antwortet
Wenn ein Sicherheitsklassifikator eine Anfrage abfängt, bleibt Fable 5.2 nicht einfach ohne Antwort: Bei Anfragen zur Cybersicherheit antwortet stattdessen Opus 4.8, bei biologischen Themen Opus 5. Abgelehnte Anfragen liefern den HTTP-Statuscode 200 und stop_reason mit dem Wert refusal. Dein Code sollte daher dieses Feld prüfen und nicht nur den Statuscode. Ob eine Ablehnung vor der Ausgabe berechnet wird, hängt von der Ablehnungskategorie ab. Sie wird aber in jedem Fall auf das Ratenlimit angerechnet.
Eine weitere Einschränkung ist weniger offensichtlich: Fähigkeiten, die direkt mit der KI-Forschung und -Entwicklung zusammenhängen, werden bewusst begrenzt. Bei Aufgaben zur Optimierung von Beschleuniger-Kernels und zur Verbesserung der Architektur großer Sprachmodelle liegt das Niveau ungefähr auf dem von Opus 5.5. Bei einigen wenigen Themen – darunter die Kernel-Entwicklung für bestimmte nicht standardmäßige Beschleuniger – wechselt das Modell während der Inferenz transparent zu Opus 5. Das ist kein fehlgeschlagener Aufruf. Diese Einschränkung gilt nicht für agentisches Programmieren, Hardwareentwicklung oder klassische Forschung im maschinellen Lernen.
Offiziellen frühen Tests zufolge gab es bei Fable 5.2 auf claude.ai, Claude Code und Cowork etwa 55 % weniger Abfänge als bei Fable 5.1. Bei Cybersicherheit waren es etwa 60 % weniger, bei biologischen Themen etwa 40 %. Dabei handelt es sich um offizielle frühe Tests, nicht um unabhängige Nachprüfungen.
Grenze vier: Die Produktmechanismen von Claude Fable 5.2 haben feste Einschränkungen
Diese Punkte wirken sich direkt auf deinen bestehenden Aufrufcode aus. Prüfe sie vor der Migration einzeln:
- Den Denkmodus kann man nicht ausschalten: Adaptives Denken ist immer aktiviert. Ab
mediumlässt es sich auch mit einer Eingabeaufforderung wie „Denk nicht nach, antworte direkt“ nicht stoppen. Wenn das Modell weniger nachdenken soll, musst du deneffort-Wert senken. - Erzwungene Tool-Auswahl führt zu einem 400-Fehler: Bei
tool_choicemit dem Wertanyodertooltritt ein Fehler auf. - Sampling-Parameter führen zu einem 400-Fehler: Übermittle weder
temperaturenochtop_podertop_k. - Daten werden 30 Tage aufbewahrt: Ohne ausdrückliche Genehmigung von Anthropic ist keine Nutzung mit Null-Aufbewahrung möglich. Qualifizierte Unternehmen können vor dem Beitritt zu Enterprise Frontier Safeguards weiterhin die Option ohne Datenaufbewahrung nutzen. Für andere Kunden werden die Daten 30 Tage lang zur Sicherheitsüberwachung aufbewahrt.
- Lange Aufgaben können vorzeitig enden: Manchmal stoppt das Modell schon nach einem Durchlauf, hinterlässt eine To-do-Liste, bietet von sich aus an weiterzumachen oder bleibt an einem gewöhnlichen Hindernis stehen. Das kommt bei
lowhäufiger vor. Bei langen Tool-Aufrufketten kann die Kommunikation mit dem Nutzer knapp ausfallen. - Denkblöcke sind nicht modellübergreifend kompatibel: Denkblöcke von Fable 5.2 können nur Fable 5.2 und Mythos 5.2 lesen. Wenn Fable 5.2 die Aufgabe ausführt, muss auch das beratende Modell Fable 5.2 oder Mythos 5.2 sein.
Außerdem weist der Hinweis zur Veröffentlichung darauf hin, dass die Formulierung in der Eingabeaufforderung, wem der Code „gehört“, beeinflusst, ob das Modell die bestehende Struktur ändert oder ganz neu anfängt. An Stilregeln hält es sich sehr genau. Sind die Sätze zu streng auf eine bestimmte Länge begrenzt, wird die Ausgabe dagegen abgehackt.
Claude Fable 5.2: Was bereits verfügbar ist und was noch fehlt
Stand 10.11.2026: Wir haben die Modellübersicht und die öffentliche Preisschnittstelle von APIYI apiyi.com geprüft. In keiner von beiden ist claude-fable-5-2 aufgeführt, ebenso wenig ein Modell aus der Mythos-Reihe. Wir werden dieses Modell so bald wie möglich bereitstellen. Maßgeblich sind die Modellliste und die Preise auf der Plattform.
Bis dahin können Sie für alltägliche Aufgaben direkt das bereits verfügbare Opus 5.5 nutzen und Fable 5.2 für die schwierigsten Schritte einsetzen, sobald es verfügbar ist. Wenn Sie schon jetzt Fähigkeiten auf dem Niveau von Fable benötigen, finden Sie in der Liste Fable 5.1. Es handelt sich jedoch nicht um Version 5.2 – Leistung und Verhalten unterscheiden sich.
| Modell-ID | Status bei APIYI apiyi.com | Listenpreis (Eingabe / Ausgabe / Cache-Lesezugriffe, je eine Million Token) | Endpunkte |
|---|---|---|---|
claude-opus-5-5 |
Verfügbar (auch als -thinking-Version) |
$4 / $20 / $0.2 | chat, messages |
claude-fable-5-1 |
Verfügbar (auch als -thinking-Version) |
$10 / $50 / $0.25 | chat, messages |
claude-fable-5-2 |
Nicht verfügbar | Noch nicht verfügbar; maßgeblich ist die Modellliste der Plattform | — |
claude-mythos-5-2 |
Nicht verfügbar | Noch nicht verfügbar | — |
Die Dollarbeträge in der Tabelle sind Listenpreise. Die tatsächliche Abrechnung hängt zusätzlich vom Multiplikator der jeweiligen Token-Gruppe ab; maßgeblich ist die Rechnung. Da Fable 5.2 nicht in der Liste steht, gibt es auch keinen Preis, auf den ein Multiplikator angewendet werden könnte. Bitte leiten Sie die APIYI-Gebühren nicht selbst aus dem offiziellen Preis ab. Für die Anbindung bietet APIYI eine OpenAI-kompatible Schnittstelle mit der base_url https://api.apiyi.com/v1. Mit einem einzigen API-Schlüssel können Sie zwischen Opus 5.5 und Fable 5.1 wechseln. Neue Nutzer erhalten ein kostenloses Testguthaben und können die Unterschiede zunächst in ihrem eigenen Repository vergleichen.
Zusammenfassung der Stärken und Schwächen von Claude Fable 5.2
Vorteile
- Deutlich besser bei offenen, langwierigen Aufgaben: Beim Remote Labor Index erreicht das Modell in der High-Stufe fast das Doppelte von Opus 5.5.
- Gutes Preis-Leistungs-Verhältnis in der High-Stufe: Bei FrontierCode erzielt die High-Stufe rund 45,3 % und liegt damit auf dem Niveau des besten Ergebnisses von Opus 5.5. Die Kosten pro Aufgabe betragen etwa die Hälfte (laut Hersteller).
- Günstiger und schneller als Version 5.1: Der Standardpreis liegt 20 % niedriger. Laut Ankündigung ist die Ausgabe bis zu 30 % schneller als bei Version 5.1.
- Günstige Cache-Lesezugriffe: Sie kosten 0,20 $ und damit genauso viel wie bei Opus 5.5.
Einschränkungen
- Der Standardpreis ist doppelt so hoch wie bei Opus 5.5: Wer für alltägliche Aufgaben wechselt, muss mit einer Verdopplung der Rechnung rechnen.
- Nicht in allen Tests überlegen: Bei AutomationBench liegt das Modell hinter Gemini 4 Carbon, beim Elo-Wert von AA-Briefcase hinter Opus 5.5.
- Grenzen bei Sicherheitsvorkehrungen und Leistungsobergrenze: Bei Cybersicherheits- und Biologiefragen antwortet stattdessen ein älteres Modell. Bei Kernel-Optimierungen und Verbesserungen der Modellarchitektur liegt das Niveau ungefähr bei Opus 5.5.
- Viele Einschränkungen bei der Nutzung: Der Denkmodus lässt sich nicht deaktivieren. Erzwungene Tools und Sampling-Parameter führen zu Fehlern mit Statuscode 400. Daten werden standardmäßig 30 Tage aufbewahrt, und langwierige Aufgaben können von selbst abbrechen.
Häufig gestellte Fragen
F1: Worin unterscheidet sich Claude Fable 5.2 von Fable 5.1?
Preislich liegt der Standardtarif von 5.2 mit $8 für Eingaben und $40 für Ausgaben 20 % unter den $10 / $50 von 5.1. Auch das Lesen aus dem Cache wird günstiger: von $0.25 auf $0.20. Bei den Benchmark-Ergebnissen steigt FrontierSWE v2 von 56.3 % auf 69.9 %, der Remote Labor Index von 17.9 % auf 41.3 %. Im Verhalten folgt 5.1 Aufforderungen wie „nicht nachdenken“ meist, während 5.2 das ab der Stufe Medium nicht tut. Derzeit ist auf APIYI apiyi.com `claude-fable-5-1` verfügbar; 5.2 wird noch nicht angeboten.
F2: Ist Claude Mythos 5.2 ein leistungsstärkeres Modell?
Nein. Laut Ankündigung basieren Fable und Mythos auf demselben Modell. Mythos verfügt über weniger Schutzmechanismen für Cybersicherheit und Biologie und ist daher nur für Organisationen verfügbar, deren Projekte überprüft wurden. Der Preis entspricht dem von Fable 5.2. Einige Ergebnisse zu Cybersicherheit und Biologie sind in der Ankündigung Mythos zugeordnet und sollten daher nicht als Ergebnisse von Fable 5.2 zitiert werden.
F3: Lässt sich das Denken bei Claude Fable 5.2 abschalten?
Nein. Das adaptive Denken ist immer aktiv und lässt sich auch durch eine Eingabeaufforderung nicht unterbinden. Wenn Sie den Umfang des Denkens und die Kosten steuern möchten, können Sie nur die Effort-Stufe senken. Die Claude API verwendet standardmäßig High, die Claude-App und Claude Code standardmäßig Medium. Beachten Sie, dass es bei der Stufe Low häufiger vorkommt, dass das Modell schon nach einem Durchgang stoppt und eine Liste offener Aufgaben hinterlässt. Für längere Aufgaben sollten Sie daher nicht auf Low wechseln.
Claude Fable 5.2: Die wichtigsten Erkenntnisse
- Positionierung: Das technische Flaggschiff wurde am 09.11.2026 veröffentlicht. Für den Alltag empfiehlt sich weiterhin Opus 5.5 als Standard.
- Stärken: 69,9 % bei FrontierSWE v2 und 41,3 % in der Kategorie „High“ des Remote Labor Index.
- Kein Sieg auf ganzer Linie: Bei AutomationBench liegt das Modell hinter Carbon, beim Elo-Wert von AA-Briefcase hinter Opus.
- Schutzmechanismen: Bei Cybersicherheit antwortet stattdessen Opus 4.8, bei biologischen Themen Opus 5. Achten Sie auf
stop_reason. - Produkteinschränkungen: Der Denkmodus ist immer aktiv. Erzwungene Tools und Sampling-Parameter führen zu einem 400-Fehler. Daten werden standardmäßig 30 Tage aufbewahrt.
- Beispiele für lange Aufgaben: Die Arbeit am Betriebssystem dauerte acht Tage, das Fermat-Projekt 30 Stunden – beides waren einzelne offizielle Experimente.
- Verfügbarkeit: APIYI führt Fable 5.2 am 10.11.2026 noch nicht. Bis dahin können Sie Opus 5.5 und Fable 5.1 verwenden.
Fazit: Wann Sie nicht zu Claude Fable 5.2 wechseln sollten
Fable 5.2 ist tatsächlich leistungsstark, vor allem bei offenen technischen Aufgaben, die lange dauern. In den folgenden vier Fällen sollten Sie lieber bei Opus 5.5 bleiben oder Fable nur als Berater oder Orchestrator einsetzen:
- Das Budget ist knapp: Der Standardpreis ist doppelt so hoch wie bei Opus 5.5. Im Schnellmodus verdoppelt er sich nochmals.
- Es dürfen keinerlei Daten gespeichert werden: Standardmäßig werden Daten 30 Tage lang aufbewahrt. Eine Speicherung von null Tagen ist nur mit entsprechender Genehmigung möglich.
- Sie arbeiten an Cybersicherheits- oder Biologiethemen, die von den Schutzmechanismen blockiert werden: In diesem Fall übernimmt Opus 4.8 beziehungsweise Opus 5. Damit erhalten Sie nicht die Fähigkeiten von Fable.
- Es geht nur um alltägliche Programmieraufgaben: Selbst der Anbieter empfiehlt, zunächst Opus 5.5 zu verwenden.
Wenn Ihre Aufgabe tatsächlich in die Kategorie „maximal anspruchsvoll und offen“ fällt, können Sie den Ablauf zunächst mit Opus 5.5 erproben und dann den schwierigsten Schritt an Fable übergeben. Sobald Version 5.2 verfügbar ist, finden Sie das Modell und den Preis in der Modellübersicht der Plattform.
Autor: Das technische Team von APIYI
Technischer Austausch: Kontaktieren Sie uns gern über die APIYI-Website. Weitere Informationen finden Sie im Dokumentationszentrum unter docs.apiyi.com.