Anmerkung des Autors: Ausgehend von der Kostenstruktur von Inferenzdiensten erklären wir, warum Token-Dienste leicht Verluste erleiden, und liefern eine umsetzbare Checkliste zur Bewertung von Modell-API-Anbietern.
Token wird inzwischen in Livestreams verkauft, doch die Finanzlage von Inferenzanbietern wie SiliconFlow (硅基流动) ist weiterhin alles andere als rosig. In einer anderen Meldung hieß es, ein Unternehmen habe Claude als zu teuer empfunden, sei auf GLM umgestiegen und versorge mit 56 B200-GPUs 2.000 Ingenieure, wobei die KI-Kosten um rund 90 % gesunken seien. Betrachtet man beide Entwicklungen zusammen, zeigt sich: Die Kostenstruktur von Token-Diensten folgt eigenen Gesetzmäßigkeiten. Dieser Artikel geht von der Kostenstruktur von Inferenzdiensten aus, erklärt, warum Token-Dienste Verluste machen, und kommt dann auf die Frage, die Entwickler wirklich beschäftigt: Wie lässt sich beurteilen, ob ein Modell-API-Anbieter verlässlich ist?
Das ist kein weiterer Artikel, der Branchenklatsch deutet. Die Analysen in diesem Beitrag drehen sich durchgehend um technische Variablen: GPU-Abschreibung, Auslastung, den Kostenunterschied zwischen Prefill und Decode, KV-Cache, Cache-Trefferquote und Subventionsstrategien. Nach der Lektüre können Sie sie direkt in der Anbieterbewertung einsetzen.
Der Kernnutzen: Nach dem Lesen dieses Artikels verstehen Sie die Kostenstruktur hinter Token-Preisen und kennen eine sechsdimensionale Methode zur Anbieterbewertung. Außerdem erfahren Sie, wie Sie mit echten Aufrufdaten überprüfen können, ob die Abrechnung transparent ist.
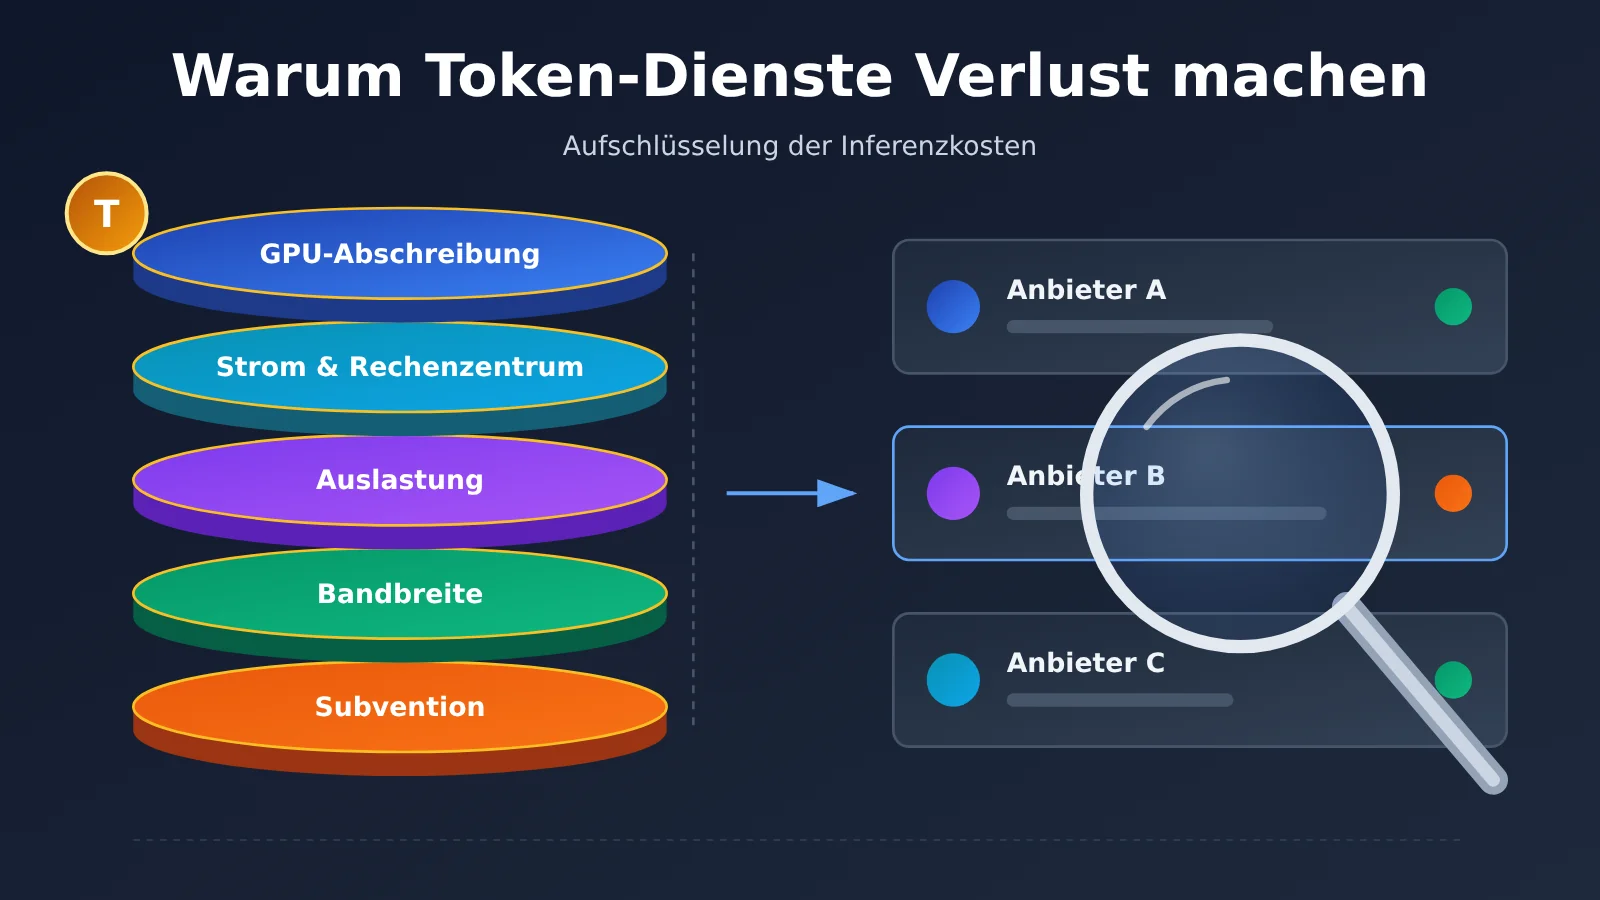
Warum Token-Services Verluste schreiben: Kernpunkte der Inferenzkostenstruktur
Zuerst die Schlussfolgerung: Ein großer Teil der Kosten von Inferenzdiensten sind Fixkosten, während die Einnahmen nach Token-Menge abgerechnet werden. Verbunden werden beide über die „Auslastung“. Ist sie zu niedrig oder wird der Preis durch Wettbewerb bis nahe an die Grenzkosten gedrückt, schreibt das Geschäft rote Zahlen.
| Kostenfaktor | Beschreibung | Auswirkung auf den Token-Preis |
|---|---|---|
| GPU-Investitionsausgaben und Abschreibung | Beschaffung oder Langzeitmiete von High-End-GPUs, über die Nutzungsdauer amortisiert | Fixkosten: Je niedriger die Auslastung, desto höher die Umlage pro Token |
| Rechenzentrum, Strom, Netzwerk | Colocation, Kühlung, Bandbreite, regionsübergreifende Ausfallsicherheit | Halbfixe Kosten, die sich erst mit Skalierung verdünnen lassen |
| GPU-Auslastung | Anteil der Zeit, in der tatsächlich Inferenz läuft, und Sättigung der Batch-Verarbeitung | Zentraler Hebel für Gewinn und Verlust; die Differenz zwischen Spitzen- und Schwachlast frisst direkt die Marge |
| Prefill-/Decode-Struktur | Eingabe wird parallel verarbeitet, Ausgabe Token für Token erzeugt | Ausgabe-Token sind teurer; Szenarien mit langen Ausgaben stehen unter Druck |
| Lange Kontextfenster und KV-Cache | VRAM wird durch Cache belegt und senkt die parallele Kapazität | Anfragen mit langem Kontext reduzieren die Zahl der bedienbaren Nutzer |
| Subventionen und Kundenakquise | Kostenlose Kontingente, Lockangebote, Kanalprovisionen | Kurzfristig mehr Volumen, langfristig niedrigere Bruttomarge |
Detaillierte Betrachtung der Kostenstruktur von Token-Services
Das Missverhältnis zwischen Fixkosten und mengenabhängigen Einnahmen ist der erste Grund. Ein voll ausgestatteter GPU-Server verursacht Abschreibung, Strom- und Rechenzentrumskosten – unabhängig davon, ob Anfragen eintreffen. Nutzer zahlen jedoch nur für tatsächlich verbrauchte Token. Tagsüber müssen in Spitzenzeiten ausreichend Rechenkapazitäten vorgehalten werden, um Latenzen zu garantieren; nachts in Schwachlastzeiten bleiben diese Kapazitäten ungenutzt. Die Kosten der Leerlaufzeiten landen letztlich in den Preisen der Token, die in Spitzenzeiten verkauft werden. Wenn die Preisgestaltung nur die „theoretischen Kosten bei Volllast“ berücksichtigt, fährt der tatsächliche Betrieb fast sicher Verluste.
Der Preiswettbewerb drückt die Stückpreise in Richtung Grenzkosten – das ist der zweite Grund. Die Gewichte von Open-Source-Modellen sind für jeden verfügbar, und viele Inferenzanbieter betreiben dasselbe Modell. Der Spielraum für Differenzierung ist gering, daher wird der Preis zum wichtigsten Wettbewerbsinstrument. Wenn Token in Livestreams mit Rabatten beworben werden, zeigt das, dass solche Produkte nahezu standardisierte Massenware sind. In dieser Situation können Anbieter ihre Fixkosten kaum über Preisaufschläge decken; sie konkurrieren nur noch über Skalierung und Scheduling-Effizienz.
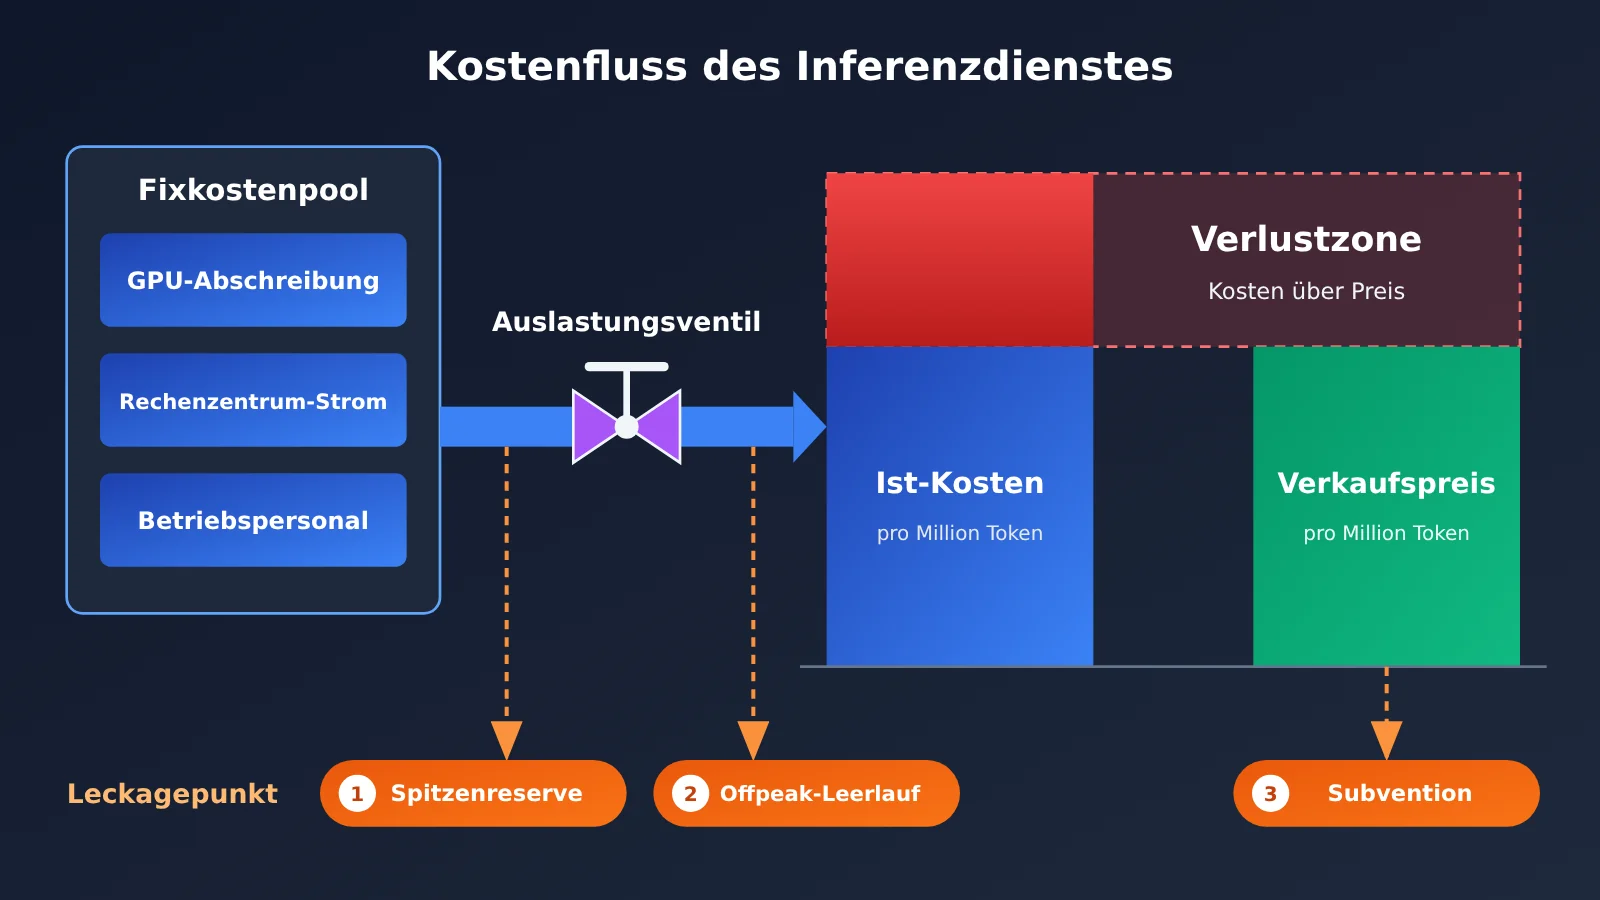
Kostenaufschlüsselung für Inferenzdienste: Wie der Token-Preis berechnet wird
Um zu verstehen, warum Token-Dienste Verluste machen können, muss man eine Inferenzanfrage in zwei Phasen zerlegen. Die einzelnen Phasen verbrauchen unterschiedliche Ressourcen, und entsprechend unterscheiden sich die Abrechnungsgrundlagen. Genau deshalb berechnen viele Anbieter Eingabe, Ausgabe und Cache getrennt.
Prefill und Decode: Warum Ausgabe-Token teurer sind
Eine Anfrage durchläuft zunächst die Prefill-Phase. Das Modell verarbeitet alle Eingabe-Token parallel; das ist rechenintensiv, aber effizient, und die GPU-Rechenleistung wird gut ausgelastet. Danach folgt die Decode-Phase, in der das Modell jeweils nur ein Token generiert und dabei wiederholt den vorherigen KV-Cache liest. Diese Phase ist stärker durch die GPU-Speicherbandbreite begrenzt, sodass die Rechenleistung der GPU schwer vollständig genutzt werden kann.
Daher sind die Stückkosten für Ausgabe-Token bei gleicher Token-Anzahl in der Regel deutlich höher als für Eingabe-Token. Bei den meisten großen Anbietern ist der Ausgabepreis pro Token entsprechend höher als der Eingabepreis. Wenn ein Geschäft hauptsächlich aus langen Ausgaben besteht – etwa Codegenerierung, das Verfassen langer Texte oder mehrrundige Agent-Inferenz –, konzentrieren sich die Kosten auf die Ausgabeseite. Bei der Bewertung von Anbietern sollte man vor allem auf den Ausgabepreis und den Ausgabedurchsatz achten.
KV-Cache und langer Kontext: die unsichtbare GPU-Speicher-Steuer
Die Kosten einer Anfrage mit langem Kontext beschränken sich nicht auf „mehr Eingabe“. Der KV-Cache belegt mit zunehmender Kontextlänge mehr GPU-Speicher, wodurch die Anzahl der Anfragen, die eine Karte gleichzeitig bedienen kann, sinkt. Mit anderen Worten: Ein Nutzer mit sehr langem Kontext kann die Parallelkapazität mehrerer normaler Nutzer beanspruchen. Diese Kosten schlagen sich nicht unbedingt vollständig im Stückpreis nieder; Anbieter können sie nur durch gestaffelte Preisgestaltung, Ratenbegrenzung oder Begrenzung der Kontextlänge ausgleichen.
Cache-Treffer: Kostensenker und Preisfalle zugleich
Prompt-Caching verhindert, dass wiederholte Präfixe erneut berechnet werden; für den getroffenen Teil wird ein niedrigerer Cache-Lesepreis berechnet. Bei Anwendungen wie Agenten oder RAG, bei denen der System-Prompt lang und repetitiv ist, wirkt sich die Cache-Trefferquote deutlich auf die endgültige Rechnung aus. Zu beachten ist, dass Anbieter Cache-Schreiben, Cache-Lesen und Cache-Gültigkeitsdauer unterschiedlich abrechnen; bei manchen muss die Funktion explizit aktiviert werden. Bei der Bewertung sollte unbedingt geprüft werden, ob das zurückgegebene usage-Feld cachebezogene Token-Statistiken enthält.
| Abrechnungsgrundlage | Ressourcenverbrauch | Was bei der Bewertung zu prüfen ist |
|---|---|---|
| Eingabe-Token | Prefill-parallele Berechnung, relativ effizient | Ob nach Kontextlänge gestaffelt abgerechnet wird |
| Ausgabe-Token | Decode generiert Token für Token, begrenzt durch GPU-Speicherbandbreite | Ausgabepreis, Ausgabedurchsatz (Token/s) |
| Cache-Schreiben | Erstmaliges Schreiben in den Cache, einige Plattformen berechnen dies separat | Ob das Schreiben einen Aufpreis kostet und wie lange die Gültigkeitsdauer ist |
| Cache-Lesen | Bei Präfix-Treffer entfallen doppelte Berechnungen | Rabatt für Treffer, ob usage offengelegt wird |
| Reasoning-Token | Interner Denkprozess von Reasoning-Modellen | Ob sie zur Ausgabe zählen und ob das Budget begrenzt werden kann |
💰 Hinweis zur Preisabrechnung: Die obige Tabelle erläutert nur die Abrechnungsdimensionen und enthält keine konkreten Preise. Die in diesem Artikel erwähnten Eingabe- und Ausgabepreise pro Token sowie Cache-Lese- und Schreibpreise der Modelle entnehmen Sie bitte den tatsächlichen Daten auf der APIYI-Preisseite
https://docs.apiyi.com/models. Die Abrechnungsgrundlagen können je nach Modell und Gruppe unterschiedlich sein. Bitte prüfen Sie vor der Bestellung jeden Punkt einzeln.
Selbst gehostete Inferenz vs. API-Aufruf: Wie sich die Token-Kosten berechnen lassen
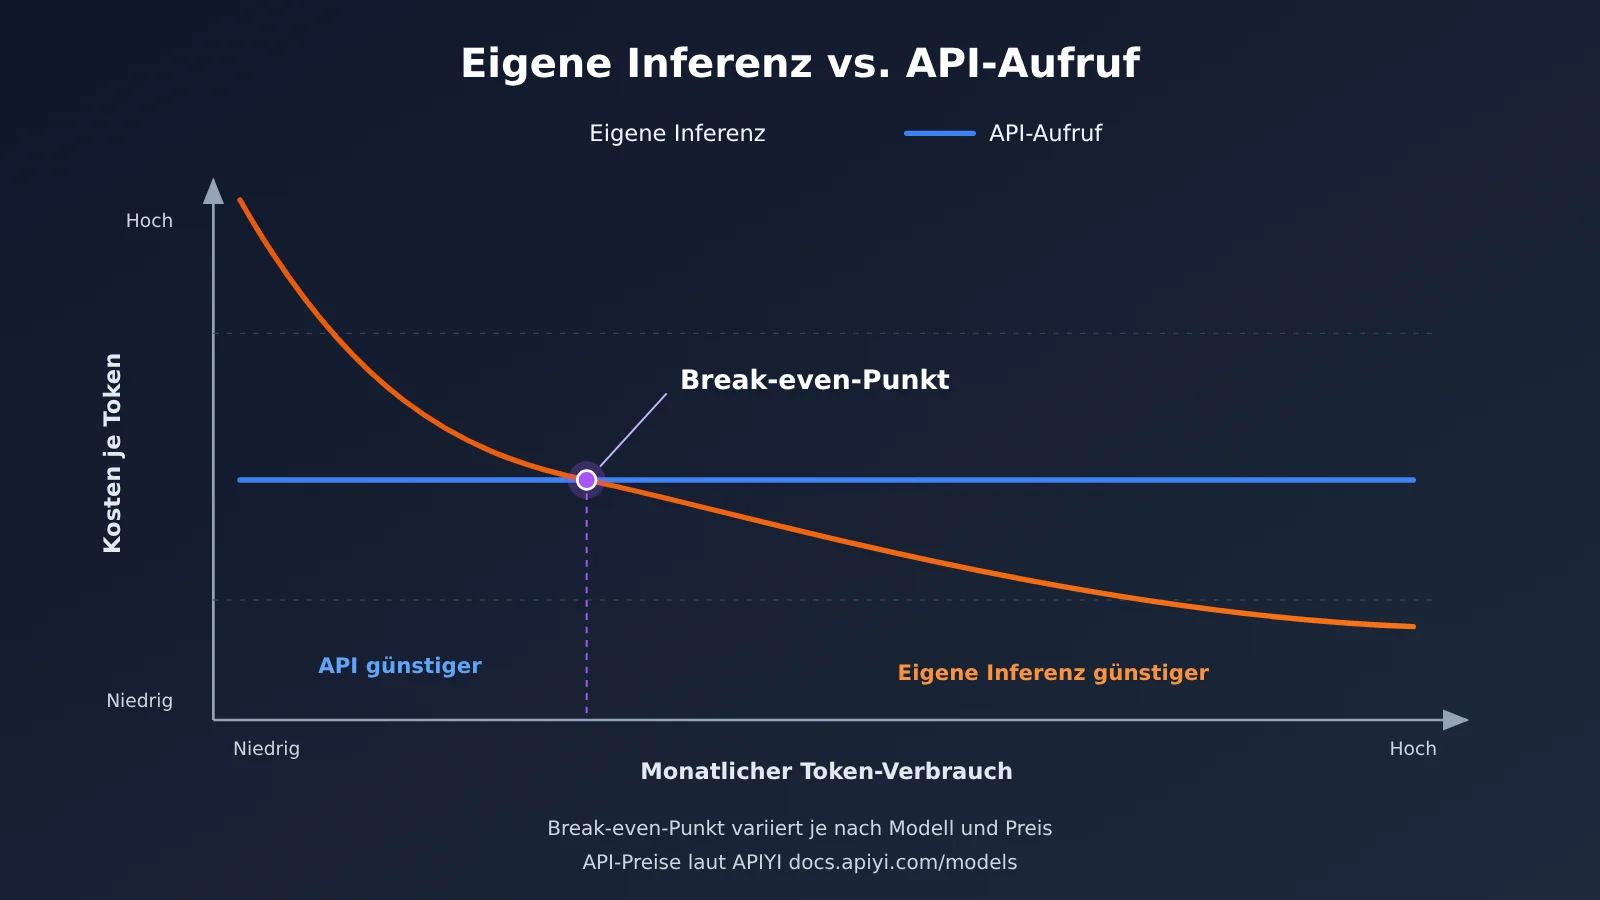
Der Fall „56 B200-Karten versorgen 2.000 Ingenieure und senken die Kosten um rund 90 %“ hat mehrere Voraussetzungen. Die Last des Unternehmens stammt von internen Ingenieuren, das Anfragevolumen ist groß und relativ stabil. Sie konzentriert sich auf die Arbeitszeit und ist gut vorhersagbar. Das Modell wurde durch das Open-Source-Modell GLM ersetzt, das selbst gehostet werden kann. Diese drei Punkte sorgen dafür, dass sich die Fixkosten gut verteilen lassen, und umgehen genau das Auslastungsproblem, das öffentlichen Inferenzanbietern am meisten Kopfschmerzen bereitet.
Umgekehrt bedeutet dieser Fall nicht, dass alle Teams selbst hosten sollten. Wenn das Anfragevolumen klein und schwankend ist oder häufig zwischen mehreren Closed-Source-Modellen gewechselt werden muss, übersteigen die Leerlaufkosten eines eigenen GPU-Clusters schnell die API-Rechnung. Der Wert öffentlicher Inferenzanbieter besteht gerade darin, die Lasten vieler Kunden gegenseitig auszugleichen – Lastspitzen abzufedern und Talzeiten zu füllen –, um eine höhere Gesamtauslastung zu erreichen.
| Lösung | Kostenstruktur | Geeignete Szenarien | Hauptrisiken |
|---|---|---|---|
| Eigener GPU-Cluster | Hohe Fixkosten, niedrige Grenzkosten | Große Teams mit hohem Volumen, stabiler Last und festem Modell | Leerlaufverschwendung, Betriebspersonal, Wertverlust durch neue Hardware-Generationen |
| Offizielle API eines einzelnen Modells | Reine nutzungsbasierte Abrechnung | Geschäfte, die stark von einem bestimmten Closed-Source-Modell abhängen | Wenig Preisoptionen, hohe Wechselkosten, eingeschränkte regionale Verfügbarkeit |
| Multi-Modell-API-Aggregationsplattform | Nutzungsbasierte Abrechnung, einheitliche Schnittstelle | Bedarf an Vergleich, Wechsel und gemischter Nutzung mehrerer Modelle | Abrechnungstransparenz und Stabilität müssen geprüft werden |
| Hybridarchitektur | Häufige Aufgaben selbst gehostet, Long-Tail-Aufgaben über API | Mittlere bis große Geschäftsvolumina mit klarer Modellschichtung | Steigende Architekturkomplexität |
Vergleichsanalyse der Selbsthosting-Variante: Selbsthosting bietet Vorteile bei der Untergrenze der Kosten pro Einheit, setzt aber voraus, dass die Auslastung hoch genug ist und das Team in der Lage ist, Deployment, Quantisierung, Skalierung und Fehlerbehebung zu bewältigen. Die API-Variante hat demgegenüber besser vorhersagbare Kosten pro Einheit und eignet sich eher für Teams mit stark schwankender Last, die mehrere Modelle parallel validieren müssen.
Vergleichsanalyse der Aggregationsplattformen: Offizielle APIs sind bei der schnellen Verfügbarkeit neuer Modelle im Vorteil, aber in den meisten Fällen deckt ein Konto nur die Modelle eines Anbieters ab. Der Vorteil einer Multi-Modell-Aggregationsplattform besteht darin, dass eine Schnittstelle mehrere Modelle anbindet, was A/B-Vergleiche und eine Kostenschichtung erleichtert. Plattformen wie APIYI apiyi.com sind gleichzeitig mit den Schnittstellenformaten von OpenAI und Anthropic kompatibel, sodass sich Modelle mit sehr geringen Änderungen am bestehenden Code wechseln lassen.
Wie man einen Modell-API-Anbieter bewertet: eine 6-Dimensionen-Checkliste für den schnellen Einstieg
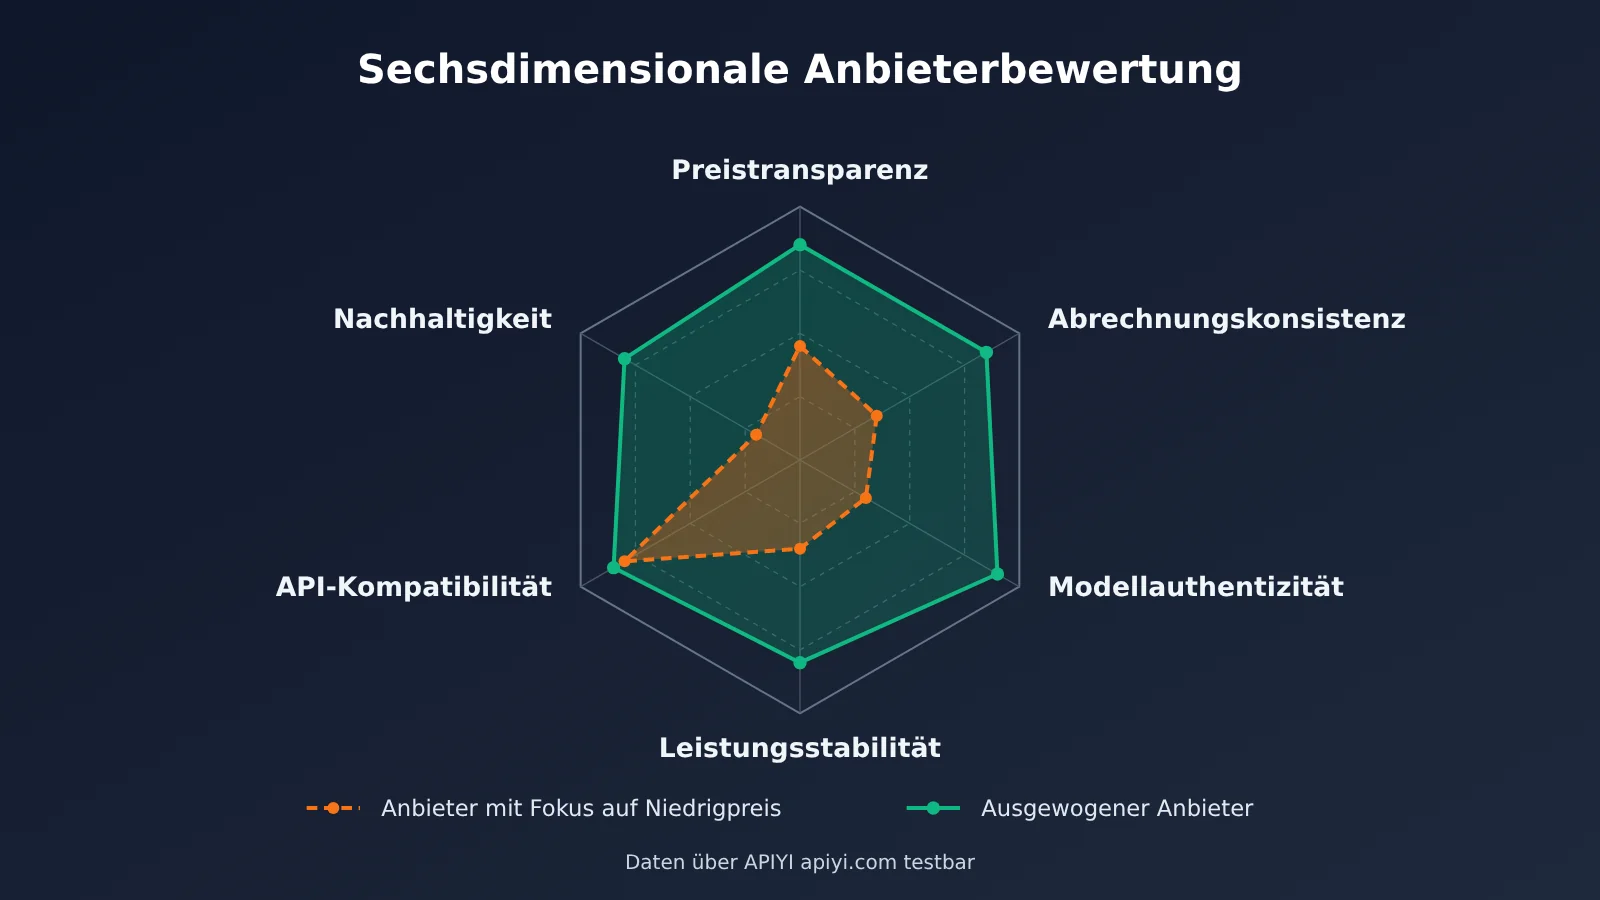
Wenn man die Kostenstruktur verstanden hat, lässt sich daraus eine Schlussfolgerung ableiten: Ein Preis, der dauerhaft unter den Kosten liegt, ist nicht nachhaltig. Anbieter „sparen“ entweder an irgendeiner Stelle oder halten das Ganze eine Zeit lang mit Subventionen am Laufen. Bei der Bewertung eines Anbieters sollte man nicht nur auf den Listenpreis starren, sondern die folgenden 6 Dimensionen gemeinsam betrachten.
| Dimension | Kernfrage | Überprüfungsmethode |
|---|---|---|
| 1. Preistransparenz | Werden Input, Output und Caching jeweils separat ausgewiesen? | Preisliste durchgehen und jeden Posten einzeln mit seiner Berechnungsgrundlage notieren |
| 2. Abrechnungskonsistenz | Stimmt die tatsächliche Abbuchung mit dem usage überein? |
Nach einem kleinen Testlauf die Rechnungsdetails abgleichen |
| 3. Modellauthentizität | Gibt es Downgrades, Vermischungen oder übermäßige Quantisierung? | Mit einem festen Testset die Ausgabequalität vergleichen |
| 4. Leistungsstabilität | Wie stehen es mit Latenz bis zum ersten Token, Durchsatz und Fehlerrate? | Je eine Messung zu Spitzen- und Schwachlastzeiten |
| 5. Schnittstellenkompatibilität | Ist sie mit dem OpenAI- / Anthropic-Format kompatibel? | Test mit dem vorhandenen SDK, nur base_url austauschen |
| 6. Nachhaltigkeit | Liegt der Preis deutlich unter dem vernünftigen Kostenbereich? | Unter Berücksichtigung der Kostenstruktur das Subventionsrisiko einschätzen |
Schritt 1: Über eine kompatible Schnittstelle anbinden und einen minimalen Aufruf durchführen
Der Testablauf lässt sich auch ohne Code gut erklären. Wenn Ihr Projekt bereits das OpenAI SDK verwendet, müssen Sie normalerweise nur zwei Konfigurationen ändern: Ersetzen Sie api_key durch den Schlüssel des Anbieters und base_url durch die Adresse der Schnittstelle des Anbieters. Am Beispiel von APIYI: Für das OpenAI-kompatible Format lautet base_url https://api.apiyi.com/v1, Dialoganfragen laufen über den Pfad /v1/chat/completions, und im Feld model tragen Sie den Namen des Zielmodells ein.
Wenn Ihr Projekt auf dem Anthropic SDK basiert, etwa mit Modellen der Claude-Reihe oder Tools wie Claude Code, können Sie ebenfalls die Adresse der Schnittstelle ersetzen und das native Anthropic-Format über den Pfad /v1/messages verwenden. Konkrete Adressen und Modellnamen entnehmen Sie der APIYI-Dokumentation unter https://docs.apiyi.com. Für einen minimalen Aufruf sollten Sie gleichzeitig die Streaming-Ausgabe über stream aktivieren, damit Sie später die Latenz bis zum ersten Token messen können.
Schritt 2: Abrechnungslogik und usage-Feld prüfen
In der Antwort jedes Aufrufs liefert das OpenAI-Format usage.prompt_tokens und usage.completion_tokens; bei manchen Modellen kommt zusätzlich cached_tokens für Cache-Treffer hinzu. Im Anthropic-Format entsprechen dem input_tokens, output_tokens sowie Felder für Cache-Lesen und Cache-Schreiben. Mit einer einfachen Formel lassen sich die Kosten pro Aufruf schätzen: Anzahl der Eingabe-Tokens mal Eingabepreis plus Anzahl der Ausgabe-Tokens mal Ausgabepreis plus Anzahl der Cache-Lese- und Cache-Schreib-Tokens mal dem jeweiligen Cache-Preis.
Vergleichen Sie den geschätzten Wert mit den Abrechnungsdetails der Plattform; Abweichungen sollten erklärbar sein. Wenn dauerhaft „die Rechnung höher als die aus usage berechnete Summe“ ausfällt oder Cache-Treffer nie in der Abrechnung auftauchen, ist Vorsicht angebracht. Für die bei der Schätzung verwendeten Preise gelten die öffentlich angegebenen Daten auf der APIYI-Preisseite https://docs.apiyi.com/models.
Schritt 3: Leistung, Qualität und Spitzenlast testen
Für Leistungstests sollten drei Kennzahlen erfasst werden: Latenz bis zum ersten Token (TTFT), Ausgabedurchsatz (Token pro Sekunde) und Fehlerrate (Timeouts, 429-Drosselung, 5xx). Führen Sie je eine Testrunde zur Werktagsspitze und zur nächtlichen Nebenzeit durch. Je geringer die Schwankungen, desto besser ist die Kapazitätsplanung des Anbieters. Für Qualitätstests verwenden Sie einen festen Satz von Eingabeaufforderungen, der Code, Reasoning und Langtext abdeckt, und vergleichen Sie die Ausgaben mit offiziellen Kanälen oder anderen Plattformen. So lassen sich leichter Modell-Downgrades oder -Austausch erkennen.
| Testpunkt | Schlüsselparameter / Feld | Akzeptabler Referenzwert |
|---|---|---|
| Latenz bis zum ersten Token | stream aktivieren, Zeit bis zum ersten Chunk erfassen |
Kein allzu großer Unterschied zwischen Spitzen- und Nebenzeit |
| Ausgabedurchsatz | completion_tokens ÷ Generierungsdauer |
Ähnlich wie bei anderen Kanälen desselben Modells |
| Abrechnungsprüfung | Alle usage-Felder × Einzelpreis auf der Preisseite |
Abweichung zur Rechnungsaufstellung erklärbar |
| Cache-Treffer | cached_tokens oder Feld für Cache-Lesevorgänge |
Treffer bei wiederholten Anfragen mit langem Präfix |
| Stabilität | Anzahl 429 / 5xx / Timeouts | Niedrige Fehlerrate und dokumentierte Wiederholungsversuche |
🚀 Schnellstart: Wenn Sie die Kosten und Leistung mehrerer Modelle über dieselbe Schnittstelle vergleichen möchten, können Sie sich zuerst bei APIYI apiyi.com registrieren und Testguthaben erhalten. Die Plattform bietet API-Aufrufe für die in diesem Artikel behandelten gängigen Modelle und ist mit den Schnittstellenformaten von OpenAI und Anthropic kompatibel. Ersetzen Sie einfach
base_urldurchhttps://api.apiyi.com/v1, um mit der Validierung zu beginnen. Die Preise der einzelnen Modelle finden Sie unterhttps://docs.apiyi.com/models.
Häufige Fragen (FAQ)
F1: Warum verlieren Token-Dienste Geld?
Inferenzdienste bestehen überwiegend aus Fixkosten wie GPU-Abschreibung und Rechenzentrumsstrom, während die Erlöse nach Tokenmenge abgerechnet werden. Zu Spitzenzeiten muss Rechenleistung vorgehalten werden, in Schwachlastphasen liegt sie brach – eine dauerhaft hohe Auslastung ist kaum zu halten. Dazu kommen Preiskämpfe durch die Homogenisierung von Open-Source-Modellen und Zuschüsse über kostenlose Kontingente, wodurch der Verkaufspreis leicht unter die Kosten gedrückt wird.
F2: Warum sind Ausgabe-Token in der Regel teurer als Eingabe-Token?
Die Eingabe wird in der Prefill-Phase parallel berechnet, wodurch die GPU sehr effizient genutzt wird. Die Ausgabe wird in der Decode-Phase Token für Token generiert und erfordert wiederholtes Lesen des KV-Cache; sie ist vor allem durch die Speicherbandbreite begrenzt und verursacht so höhere Stückkosten. Bei Anwendungen mit langen Ausgaben sollten Sie daher besonders auf den Ausgabepreis und den Durchsatz achten.
F3: Ist ein selbst betriebenes GPU-Setup immer günstiger als ein API-Aufruf?
Nicht unbedingt. Fälle wie „56 B200 stemmen 2000 Entwickler“ beruhen auf einer großskaligen, stabilen und gut vorhersagbaren internen Last. Teams mit geringem oder stark schwankendem Bedarf haben nach dem Selbstbetrieb oft mit hohem Leerlauf zu kämpfen, wodurch die Stückkosten sogar steigen. Empfehlenswert ist, zunächst über die API eine realistische Nutzungskurve zu ermitteln und erst dann den Break-even-Punkt zu bewerten.
F4: Kann ich API-Anbieter mit besonders niedrigen Preisen nutzen?
Ausprobieren ja, aber mit gründlicher Prüfung. Preise, die deutlich unter einem plausiblen Kostenkorridor liegen, bedeuten meist eines von Folgendem: Zuschüsse, Ratenbegrenzung, Modell-Downgrade oder Abstriche bei der Stabilität. Eine Qualitäts- und Abrechnungsprüfung anhand der 6-Punkte-Checkliste in diesem Artikel ist verlässlicher als der reine Blick auf den Listenpreis.
F5: Wie vergleiche ich die API-Performance mehrerer Modelle kostengünstig?
Empfehlenswert ist eine Multi-Modell-Plattform mit Kompatibilität zu gängigen Schnittstellenformaten für einheitliche Tests:
1. Bei APIYI apiyi.com ein Konto registrieren und einen API-Schlüssel beziehen
2. Gemäß der Dokumentation `https://docs.apiyi.com` eine OpenAI- oder Anthropic-kompatible Schnittstelle konfigurieren
3. Mit einem festen Testset abwechselnd das Feld `model` umschalten und Latenz, Qualität sowie `usage` protokollieren
Mit demselben Code lässt sich so ein Quervergleich durchführen – der Wechselaufwand ist sehr gering.
F6: Wie prüfe ich Cache-Preise? Sind die Maßstäbe auf verschiedenen Plattformen gleich?
Nein. Manche Plattformen berechnen das Schreiben in den Cache separat, andere gewähren nur Rabatte beim Lesen, und auch Gültigkeitsdauer und Aktivierungsweise unterscheiden sich. Beim Aufruf über APIYI gelten für Cache-Lese- und -Schreibpreise die tatsächlichen Daten der Preisseite `https://docs.apiyi.com/models`; gleichen Sie die Abrechnung zusätzlich mit den Cache-Feldern der zurückgegebenen `usage` ab.
F7: Welche Kennzahl wird bei der Bewertung von Anbietern am häufigsten übersehen?
Abrechnungskonsistenz und Stabilität zu Spitzenzeiten. Viele Teams testen nur einmal in der Schwachlastphase und gehen dann live – in der Folge treffen sie zu Spitzenzeiten häufig auf 429 oder Timeouts. Ebenso prüfen viele Teams nie den Zusammenhang zwischen `usage` und Rechnung. Beides sollte fester Bestandteil der Checks vor dem Go-live sein.
Token-Service-Kosten und Bewertung von API-Anbietern: die wichtigsten Erkenntnisse
- Ursache für Verluste: hohe Fixkosten, nutzungsabhängige Erlöse und schwankende Auslastung – diese drei Faktoren passen nicht zusammen und machen Token-Services schnell defizitär
- Ausgabe ist teurer: Das Decoding ist durch die Speicherbandbreite begrenzt; bei langen Ausgaben müssen Sie den Ausgabepreis und den Durchsatz genau im Blick behalten
- Langer Kontext hat versteckte Kosten: Der KV-Cache belegt VRAM und senkt die Parallelität; Anbieter können nur mit Staffelpreisen und Rate Limiting gegensteuern
- Selbstbetrieb hat eine Hürde: Nur große, stabile Lasten amortisieren die GPU-Fixkosten – kleine Teams sollten zuerst die API nutzen
- Bewertung in sechs Dimensionen: transparente Preise, konsistente Abrechnung, echtes Modell, stabile Performance, Schnittstellenkompatibilität, Nachhaltigkeit
- So starten Sie: Über APIYI schnell mit OpenAI- bzw. Anthropic-kompatiblen Formaten testen; Preise gemäß
docs.apiyi.com/models
Fazit: Token-Services aus der Kostenstruktur verstehen und den richtigen Modell-API-Anbieter wählen
Warum Token-Services Verluste machen, liegt letztlich in der Kostenstruktur der Inferenz begründet:
- Kostenseite: GPU-Abschreibung und Rechenzentrumsstrom sind Fixkosten, die Auslastung ist der Hebel für Gewinn und Verlust; Ausgabe-Tokens und langer Kontext treiben die Kosten zusätzlich nach oben
- Erlösseite: Die Homogenisierung von Open-Source-Modellen macht einen Preiskampf unvermeidlich; Subventionen steigern zwar das Volumen, drücken aber die Marge
- Auswahlseite: Ein niedriger Preis bedeutet nicht automatisch ein gutes Geschäft. Bewerten Sie ganzheitlich anhand der sechs Dimensionen transparente Preise, konsistente Abrechnung, echtes Modell, stabile Performance, Schnittstellenkompatibilität und Nachhaltigkeit
Für Entwickler gilt: Statt zu raten, welcher Anbieter wie lange durchhält, sollten Sie mit echten Aufrufdaten arbeiten. Prüfen Sie zuerst mit kleinem Traffic die Abrechnung und vergleichen Sie die Qualität – erst danach entscheiden Sie über Hauptmodell und Ausweichkanal.
Empfohlen: Testen Sie die Ergebnisse schnell über APIYI apiyi.com. Die Plattform bietet API-Aufrufe für die in diesem Artikel behandelten Modelle und ist mit den Schnittstellenformaten von OpenAI und Anthropic kompatibel; die Integrationsdokumentation finden Sie unter https://docs.apiyi.com. Alle Preise für Eingabe, Ausgabe und Caching der Modelle richten sich nach den tatsächlichen Daten auf der Preisseite https://docs.apiyi.com/models.
📚 Referenzen
- 36氪 – Tokens werden mittlerweile sogar in Li Jiaqis Livestream verkauft, warum machen „SiliconFlow“ & Co. dann immer noch Verlust?: Report über die Profitabilitätsprobleme von Inferenz-Anbietern
- Link:
36kr.com/p/4055385238017664 -
Beschreibung: Hintergrund zur Kommerzialisierung von Tokens und zu den Verlusten von Inferenz-Dienstleistern
-
36氪 – Jemand verbrennt 10.000 Dollar pro Monat, findet Claude zu teuer, und dieses Unternehmen steigt auf GLM um: Fallbeispiel zur Kostensenkung durch selbst betriebene Inferenz
- Link:
36kr.com/p/4055383551038595 -
Beschreibung: Ein Fall selbst betriebener Inferenz, bei dem 56 B200 2000 Ingenieure versorgen – hilfreich, um die Kostengrenze zwischen Eigenbetrieb und API zu verstehen
-
APIYI Dokumentationszentrum: API-Anbindung und Modellpreise
- Link:
docs.apiyi.com - Beschreibung: Informationen zur OpenAI-/Anthropic-kompatiblen Anbindung; maßgeblich für die Modellpreise ist
docs.apiyi.com/models
Autor: APIYI Technikteam
Technischer Austausch: Bei Fragen zur Modellauswahl und zur Bewertung von Token-Kosten kontaktieren Sie uns gerne über die offizielle APIYI-Website apiyi.com. Weitere Integrationsunterlagen finden Sie im Dokumentationszentrum unter docs.apiyi.com.