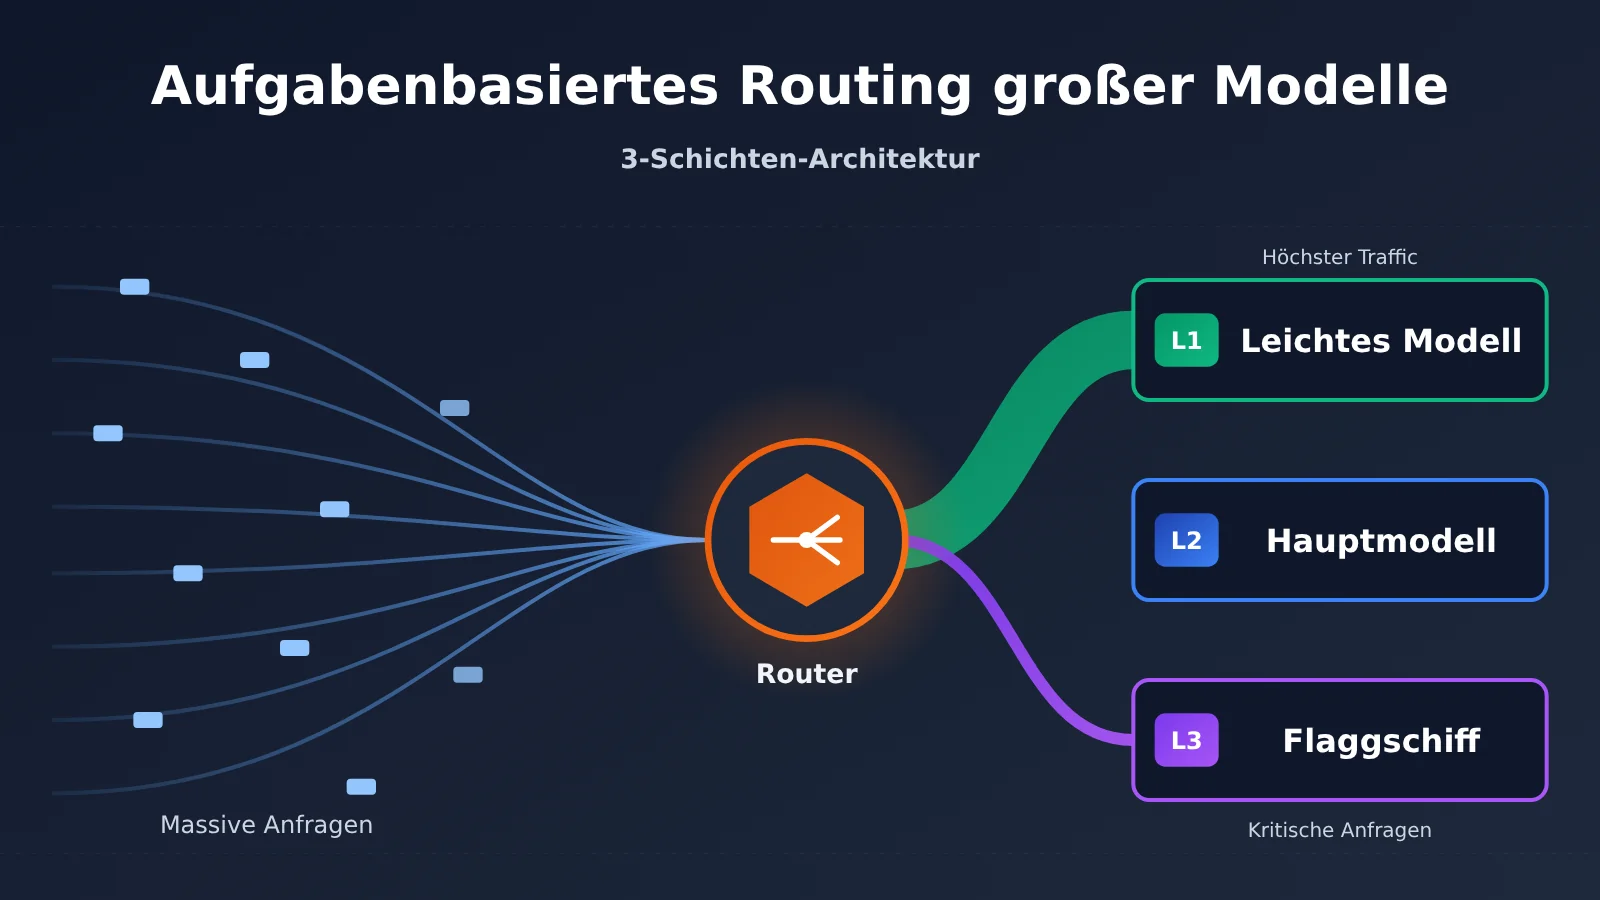
Anmerkung des Autors: Dieser Artikel erklärt anhand von drei Dimensionen – Aufgabenkomplexität, Fehlerkosten und Kontextgröße –, wie Sie große Sprachmodelle nach Aufgaben gestaffelt routen und das Flaggschiffmodell den Anfragen vorbehalten, die es wirklich brauchen.
Der erste Schritt vieler Teams bei der Anbindung großer Sprachmodelle besteht darin, alle Anfragen an das derzeit stärkste Flaggschiffmodell zu schicken. In der Prototypenphase ist das unproblematisch, doch sobald das Anfragevolumen steigt, wächst die Rechnung schnell – obwohl die meisten dieser Anfragen auch von kleineren oder mittleren Modellen erledigt werden könnten. Dieser Artikel zeigt, wie sich das gestaffelte Routing großer Sprachmodelle nach Aufgaben praktisch umsetzen lässt, und hilft Ihnen einzuschätzen, welche Anfragen wirklich ein Flaggschiffmodell verdienen.
Dies ist kein Werbetext für die Behauptung, günstige Modelle seien genauso gut. Flaggschiffmodelle haben bei komplexem Reasoning, mehrstufigen Codeänderungen und risikoreichen Ausgaben weiterhin klare Vorteile. Beim gestaffelten Routing geht es darum, „die richtige Anfrage an das richtige Modell zu geben“, nicht darum, die Kosten um jeden Preis zu drücken.
Der zentrale Nutzen: Nach der Lektüre dieses Artikels haben Sie einen 3-stufigen Kriterienkatalog zur Aufgabeneinstufung, eine Checkliste zur Konfiguration der Routing-Regeln und eine Methode an der Hand, mit der Sie die Routing-Strategie nach dem Go-live datenbasiert kalibrieren.
Die Kernpunkte des aufgabenbasierten Routings großer Sprachmodelle
Bevor wir konkrete Konfigurationen besprechen, stellen wir zunächst einige zentrale Kriterien für hierarchisches Routing vor. Sie bestimmen, auf welcher Ebene eine Anfrage landen sollte, und ob die Routing-Strategie dauerhaft wartbar bleibt.
| Punkt | Beschreibung | Nutzen |
|---|---|---|
| Routing nach Aufgabe statt nach Nutzer | Die Schwierigkeit verschiedener Anfragen desselben Nutzers kann stark variieren; daher sollten die Merkmale der einzelnen Aufgabe als Grundlage für das Routing dienen | Vermeidet Verschwendung, wenn alle VIP-Nutzer über das Flaggschiffmodell laufen |
| Fehlerkosten haben Vorrang vor der Aufgabenschwierigkeit | Auch einfache Aufgaben können ein Flaggschiffmodell oder eine Zweitprüfung erfordern, wenn Fehler schwerwiegende Folgen hätten | Begrenzt das Risiko von Störungen im Produktivbetrieb |
| Standardmäßig mittlere Ebene, je nach Signal hoch- oder herabstufen | Das Hauptmodell fängt den Großteil des Verkehrs auf; nur bei bestimmten Bedingungen wird hoch- oder herabgestuft | Wenige Regeln, leicht zu warten, leicht zurückzurollen |
| Upgrade bei Fehlern | Besteht die Ausgabe eines Modells der unteren Ebene die Prüfung nicht, wird automatisch ein erneuter Versuch auf einer höheren Ebene ausgelöst | Erzielt mit geringen Wiederholungskosten eine bessere Gesamtqualität |
| Mit Daten kalibrieren | Erfolgsquote, Wiederholungsrate und Kosten pro Aufgabe jeder Ebene erfassen und Schwellenwerte regelmäßig anpassen | Die Routing-Strategie bleibt mit jeder Modelliteration wirksam |
Detaillierte Betrachtung des hierarchischen Routings: Warum man nicht alles mit Flaggschiffmodellen erledigen sollte
Die Modelllandschaft im Jahr 2026 macht hierarchisches Routing noch notwendiger. Ein Beispiel aus den öffentlich zugänglichen Informationen in den Referenzunterlagen: OpenAI veröffentlichte am 24. April 2026 GPT-5.5 mit einem Kontextfenster im Millionenbereich; am selben Tag brachte DeepSeek die V4-Serie in den zwei Varianten Pro und Flash heraus, die ebenfalls ein 1M-Kontextfenster unterstützt und deren Gewichte unter der Apache-2.0-Lizenz offen verfügbar sind. Gleichzeitig holen Modelle wie die Claude-Opus-Serie, Gemini 3.1 Pro und Kimi K2.6 bei Coding- und Reasoning-Aufgaben stetig auf.
Wenn die Spitzenmodelle bei gängigen Benchmarks immer näher zusammenrücken, werden die „Kosten pro Aufgabe“ zum entscheidenden Unterscheidungsmerkmal. In Evaluierungsartikeln von Drittanbietern heißt es, dass mehrere Modelle bei Coding-Benchmarks bereits sehr ähnlich abschneiden und dass der eigentliche Unterschied in den Kosten liegt, die für die Erledigung jeder Aufgabe anfallen. Andere Analysen legen dar, dass in Coding-Agent-Szenarien wie Claude Code ein Großteil des Token-Verbrauchs nicht von den allerbesten Modellen verarbeitet werden muss. Das sind alles Perspektiven von Drittanbietern, und die konkreten Anteile hängen vom jeweiligen Geschäft ab. Die Richtung ist aber klar: Flaggschiffmodelle gezielt dort einzusetzen, wo sie den größten Hebel haben, ist wirtschaftlicher, als sie für alles zu verwenden.
Ein weiterer Punkt, der leicht übersehen wird, ist die Latenz. Flaggschiffmodelle denken in der Regel tiefer nach und liefern längere Ausgaben. Bei sofort zu erledigenden Aufgaben wie Klassifizierung, Extraktion und Umschreiben wird die Wartezeit für Nutzer dadurch sogar länger. In den Referenzunterlagen wird erwähnt, dass die Antworten nach der Umstellung von ChatGPT auf GPT-5.5 Instant als Standardmodell deutlich kürzer wurden und die Halluzinationsrate sank. Das zeigt, dass eine schlankere Version für „schnelle Frage, schnelle Antwort“ für die Hersteller selbst eine anerkannte Produktrichtung ist.
So unterteilen Sie das hierarchische Routing großer Sprachmodelle in 3 Aufgabenebenen
Der Kern der Hierarchie besteht darin, für jede Aufgabenart ein Modell zu finden, das „gerade ausreichend“ ist. Die folgende Tabelle zeigt ein allgemeines Aufteilungsschema, das wir in mehreren Projekten zusammengestellt haben. Sie können es je nach Ihrem Geschäftsfall ergänzen oder streichen.
| Ebene | Typische Aufgaben | Entscheidungssignale | Empfohlener Modelltyp |
|---|---|---|---|
| L1 Leichtgewichtsebene | Absichtsklassifizierung, Keyword-Extraktion, Formatkonvertierung, Umschreiben kurzer Texte, einfache Frage-und-Antwort | Kurze Eingabe, feste Ausgabestruktur, klare Validierungsregeln | Modelle der Haiku-, Mini- und Flash-Klasse |
| L2 Hauptebene | Reguläre Dialoge, Dokumentzusammenfassungen, Codegenerierung mittlerer Komplexität, RAG-Fragen und -Antworten | Erfordert ein gewisses Maß an Verständnis und Strukturierungsfähigkeit, Fehler lassen sich jedoch erkennen und korrigieren | Modelle der Sonnet-Klasse, große Open-Source-Modelle mit vielen Parametern, universelle Modelle der Pro-Klasse |
| L3 Flaggschiff-Ebene | Mehrstufiges Reasoning, dateiübergreifende Code-Refaktorierung, Architekturdesign, risikoreiche Ausgaben etwa in Recht oder Finanzen | Mehrstufige Abhängigkeiten, Fehler sind schwer zu erkennen und teuer, Analyse sehr langer Kontexte | Flaggschiffmodelle wie Opus-Klasse, GPT-5.5-Klasse |
So erkennen Sie Aufgaben für die L1-Leichtgewichtsschicht
Das entscheidende Merkmal der L1-Schicht ist, dass „die Ausgabe programmatisch überprüft werden kann“. Bei der Intent-Klassifizierung darf beispielsweise nur eines von festen Labels gewählt werden, bei der JSON-Extraktion lässt sich das Ergebnis per Schema validieren, und bei Formatkonvertierungen kann man die Vollständigkeit der Felder abgleichen. Solange die Prüfregeln streng genug formuliert sind, lassen sich die Fehler der Leichtgewichtsmodelle automatisch abfangen und zur weiteren Behandlung eskalieren.
In den Referenzmaterialien weist ein Vergleichsartikel darauf hin, dass kleine Modelle wie Claude Haiku 4.5 und GPT-5.4 Mini unterschiedliche Schwerpunkte haben: Ersteres schneidet bei der Code-Qualität besser ab, Letzteres ist bei der Geschwindigkeit im Vorteil. Solche Modelle eignen sich für Traffic mit hoher Frequenz und geringer Komplexität und sind im stufenbasierten Routing die wichtigste Quelle für Kosteneinsparungen.
So erkennen Sie Aufgaben für die L2-Hauptschicht
Die L2-Schicht übernimmt den Großteil der Anfragen, die „Denkarbeit erfordern, aber nicht schwierig sind“, und ist auch das empfohlene Standard-Routing-Ziel. Den Standardwert auf die mittlere Ebene zu setzen, hat zwei Vorteile: Erstens wird vermieden, dass eine Fehlklassifizierung durch den Klassifikator viele komplexe Anfragen in die Leichtgewichtsschicht herabstuft; zweitens bleiben die Regeln für Eskalation und Herabstufung einfach.
Die Leistung von Open-Source-Modellen auf dieser Ebene verdient Beachtung. In den Referenzmaterialien kommt eine Bewertung durch Dritte zu dem Schluss, dass DeepSeek V4 Flash bei klar abgegrenzten Coding-Aufgaben nicht weit von V4 Pro entfernt ist und Kimi K2.6 bei gängigen Coding-Benchmarks nur wenige Punkte hinter Claude Opus 4.6 liegt. Das bedeutet: Viele Coding-Aufgaben, die ursprünglich standardmäßig an das Flaggschiffmodell gingen, können zunächst in der Hauptschicht versucht werden.
Wie Sie Aufgaben für die L3-Flaggschiff-Ebene erkennen
Anfragen, die wirklich ein Flaggschiffmodell rechtfertigen, erfüllen in der Regel mindestens zwei der folgenden Bedingungen:
- Lange Argumentationsketten: Mehrstufige Planung und wiederholte Überprüfung von Zwischenergebnissen sind nötig, etwa bei der Lokalisierung komplexer Bugs, bei mathematischen Beweisen oder bei der Terminplanung mit vielen Nebenbedingungen.
- Fehler bleiben leicht verborgen und sind teuer: Die Ausgabe wirkt plausibel, doch Detailfehler sind kaum zu entdecken – zum Beispiel bei der Analyse von Vertragsklauseln, bei finanziellen Berechnungslogiken oder bei sicherheitsrelevantem Code.
- Hohe Anforderungen an die Kontextsynthese: Informationen müssen über mehrere hunderttausend Tokens hinweg abschnittsübergreifend verknüpft werden, statt nur eine einzelne Passage nachzuschlagen.
- Die niedrigeren Ebenen sind bereits gescheitert: Die Ausgabe von L2 hat die Prüfung nicht bestanden, oder der Nutzer hat ausdrücklich zurückgemeldet, dass das Ergebnis unbrauchbar ist.
🎯 Technischer Hinweis: Für分层-Routing müssen Sie mehrere Modellanbieter gleichzeitig anbinden. Wenn Sie mit jedem Anbieter einzeln einen Vertrag schließen und jedes SDK separat integrieren, fressen die Wartungskosten den Nutzen des Routings wieder auf. APIYI apiyi.com bietet API-Zugriff auf die in diesem Artikel behandelten Modellreihen von GPT, Claude, Gemini und DeepSeek und ist gleichzeitig mit den beiden Schnittstellenformaten von OpenAI und Anthropic kompatibel. Beim Modellwechsel müssen Sie in der Regel nur den Parameter für den Modellnamen ändern.
Schnelleinstieg in das hierarchische Routing großer Sprachmodelle
Im Folgenden wird anhand einer Konfigurationscheckliste eine minimal einsatzfähige Lösung für hierarchisches Routing vorgestellt. Dieser Artikel enthält keine Code-Schnipsel; alle wichtigen Konfigurationsparameter werden in Tabellen erläutert. Du kannst die Lösung in dem Framework umsetzen, das du verwendest.
Erster Schritt: Einheitliche Integrationsschicht
Die Voraussetzung für hierarchisches Routing lautet: „Modell wechseln, ohne Code zu ändern“. Es empfiehlt sich, alle Modellanfragen über eine einheitliche Aufruf-Funktion zu leiten. Diese Funktion nimmt nur den Aufgabentyp, den Nachrichteninhalt und einen optionalen Parameter zum Überschreiben der Ebene entgegen; intern entscheidet sie dann anhand der Routing-Regeln, welches Modell tatsächlich aufgerufen wird.
Zur Anbindung: Wenn dein Projekt bereits das OpenAI SDK verwendet, kannst du direkt die Schnittstelle im Chat-Completions-Stil weiterverwenden. Wenn du das Anthropic SDK verwendest, kannst du auch die Schnittstelle im Messages-Stil weiterverwenden. APIYI ist mit beiden Formaten kompatibel. Für die konkrete Zugriffsadresse, die Authentifizierungsmethode und die Liste der Modellnamen sind die Angaben im APIYI-Dokumentationszentrum unter docs.apiyi.com maßgeblich.
Schritt 2: Routing-Regeln konfigurieren
Die folgende Tabelle listet die gängigsten Konfigurationsoptionen einer Routing-Regel auf. Es empfiehlt sich, sie in eine eigene Konfigurationsdatei auszulagern, damit Anpassungen ohne Neustart des Dienstes möglich sind.
| Konfigurationsoption | Bedeutung | Empfohlene Vorgehensweise bei der Wahl |
|---|---|---|
task_type |
Label für den Aufgabentyp, z. B. classify, extract, summarize, code, reason | Wird direkt am Business-Einstiegspunkt gesetzt – das ist stabiler als eine Klassifizierung durch das Modell |
default_tier |
Die Ebene, die greift, wenn keine Regel zutrifft | Sollte auf L2 (Hauptebene) gesetzt werden |
risk_level |
Risikolabel des Geschäftsfalls, unterteilt in low, medium, high | Bei high direkt auf L3 routen oder zusätzliche Prüfschritte einbauen |
context_threshold |
Schwellenwert für die Anzahl der Eingabe-Token, ab dem ein Upgrade ausgelöst wird | Passend zu den Kontextfenstern der einzelnen Modelle und deren Leistung bei langen Texten festlegen |
validator |
Art der Ausgabeprüfung, z. B. JSON-Schema, Regex, Unit-Tests, Review durch ein zweites Modell | In Ebene L1 zwingend erforderlich, in Ebene L2 empfohlen |
max_escalation |
Maximale Anzahl an Upgrades nach fehlgeschlagener Prüfung | Üblicherweise 1 bis 2 Mal, um endlose Wiederholungsversuche zu vermeiden |
tier_model_map |
Das Modell und das Ausweichmodell für jede Ebene | Modellnamen richten sich nach der Modellliste in der APIYI-Dokumentation |
Dritter Schritt: Upgrade- und Downgrade-Logik konfigurieren
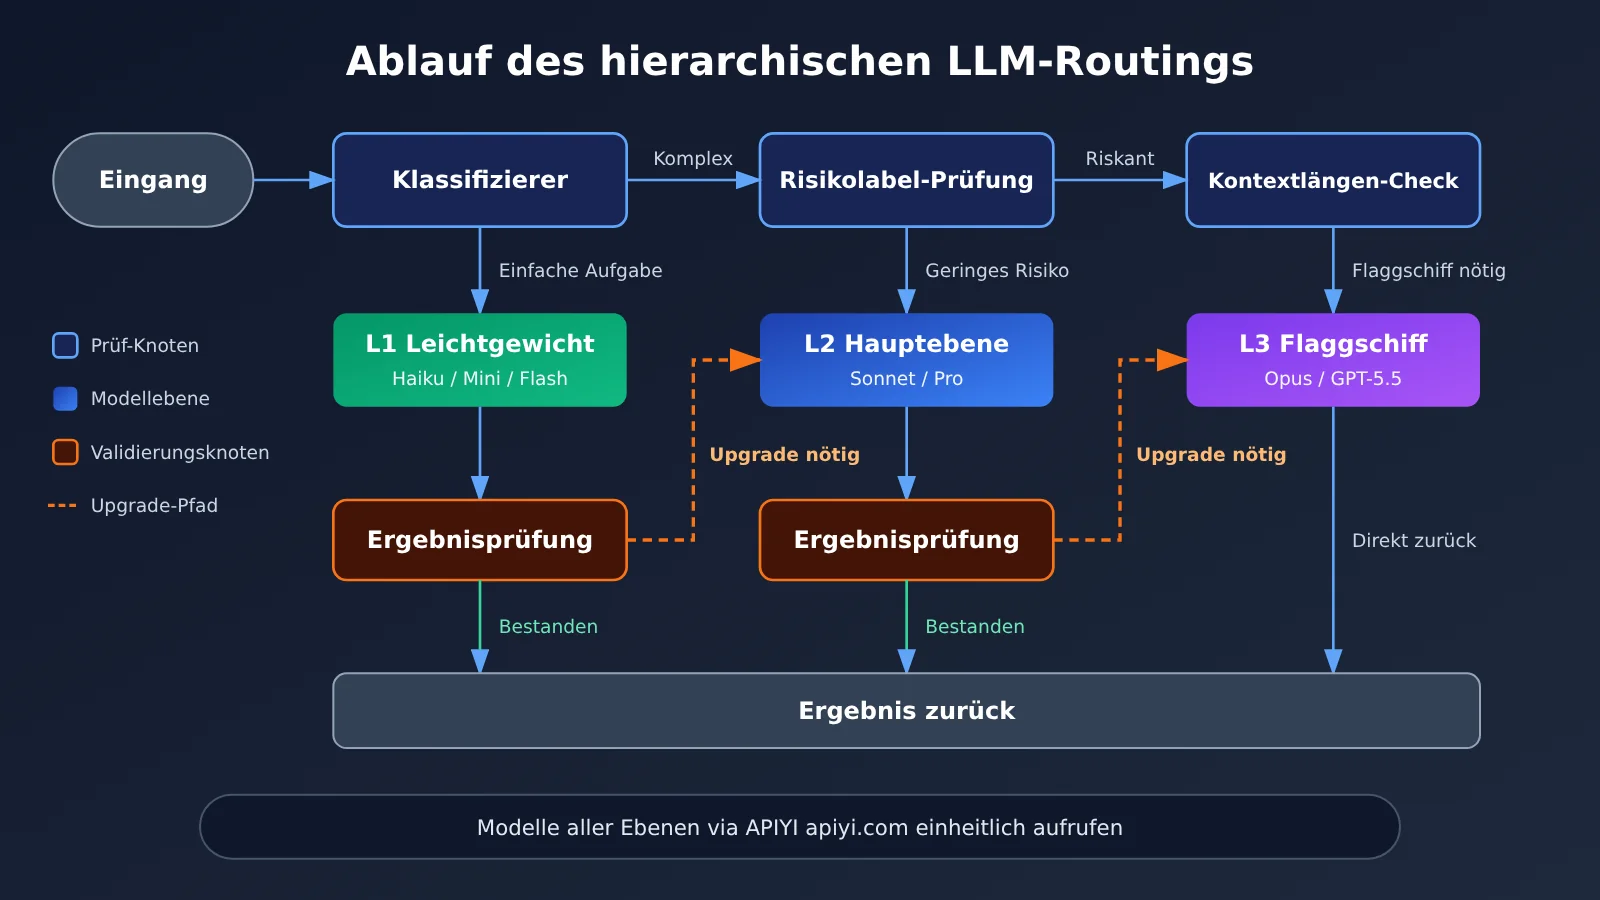
Für die Routing-Regeln empfiehlt sich die folgende Prüfreihenfolge – je weiter oben eine Regel steht, desto höher ihre Priorität:
- Wenn der Aufrufer explizit einen Tier-Override-Parameter angibt, wird direkt die angegebene Stufe verwendet. Das erleichtert Debugging und manuelle Eingriffe.
- Wenn
risk_levelauf high steht, wird auf die L3-Flaggschiff-Stufe geroutet. - Wenn die Eingabelänge
context_thresholdüberschreitet, wird mindestens auf L2 geroutet; je nach Aufgabentyp kann zusätzlich ein Upgrade auf L3 erfolgen. - Anhand von
task_typewird in einer Tabelle nachgeschlagen: Aufgaben wie Klassifikation, Extraktion und Formatkonvertierung werden auf L1 geroutet. - Wenn keine der oben genannten Regeln greift, wird
default_tierverwendet. - Wenn die Ausgabe die Validierung durch
validatornicht besteht, wird eine Stufe höher erneut versucht – bismax_escalationerreicht ist.
Vierter Schritt: Die wichtigsten Kennzahlen pro Stufe erfassen
Nach dem Go-live des Routings sollten mindestens folgende Angaben für jede Anfrage protokolliert werden: Stufe, Modellname, Anzahl der Input- und Output-Token, ob ein Cache-Treffer vorlag, ob ein Upgrade mit Wiederholung erfolgt ist und ob die Validierung bestanden wurde. Diese Daten sind die einzige Grundlage für die spätere Anpassung der Schwellenwerte. Eine Routing-Strategie ohne Logs lässt sich nur nach Gefühl justieren.
🚀 Schnellstart: Es empfiehlt sich, zunächst in einer Testumgebung dieselbe Charge echter Anfragen jeweils über die drei Stufen L1, L2 und L3 laufen zu lassen und Erfolgsquote sowie Kosten pro Aufgabe zu vergleichen. Über APIYI apiyi.com kann man mit demselben Interface zwischen mehreren Modellen wechseln – das erleichtert solche Vergleichsexperimente erheblich.
Vergleich von Flaggschiff- und Hauptmodellen im hierarchischen Routing
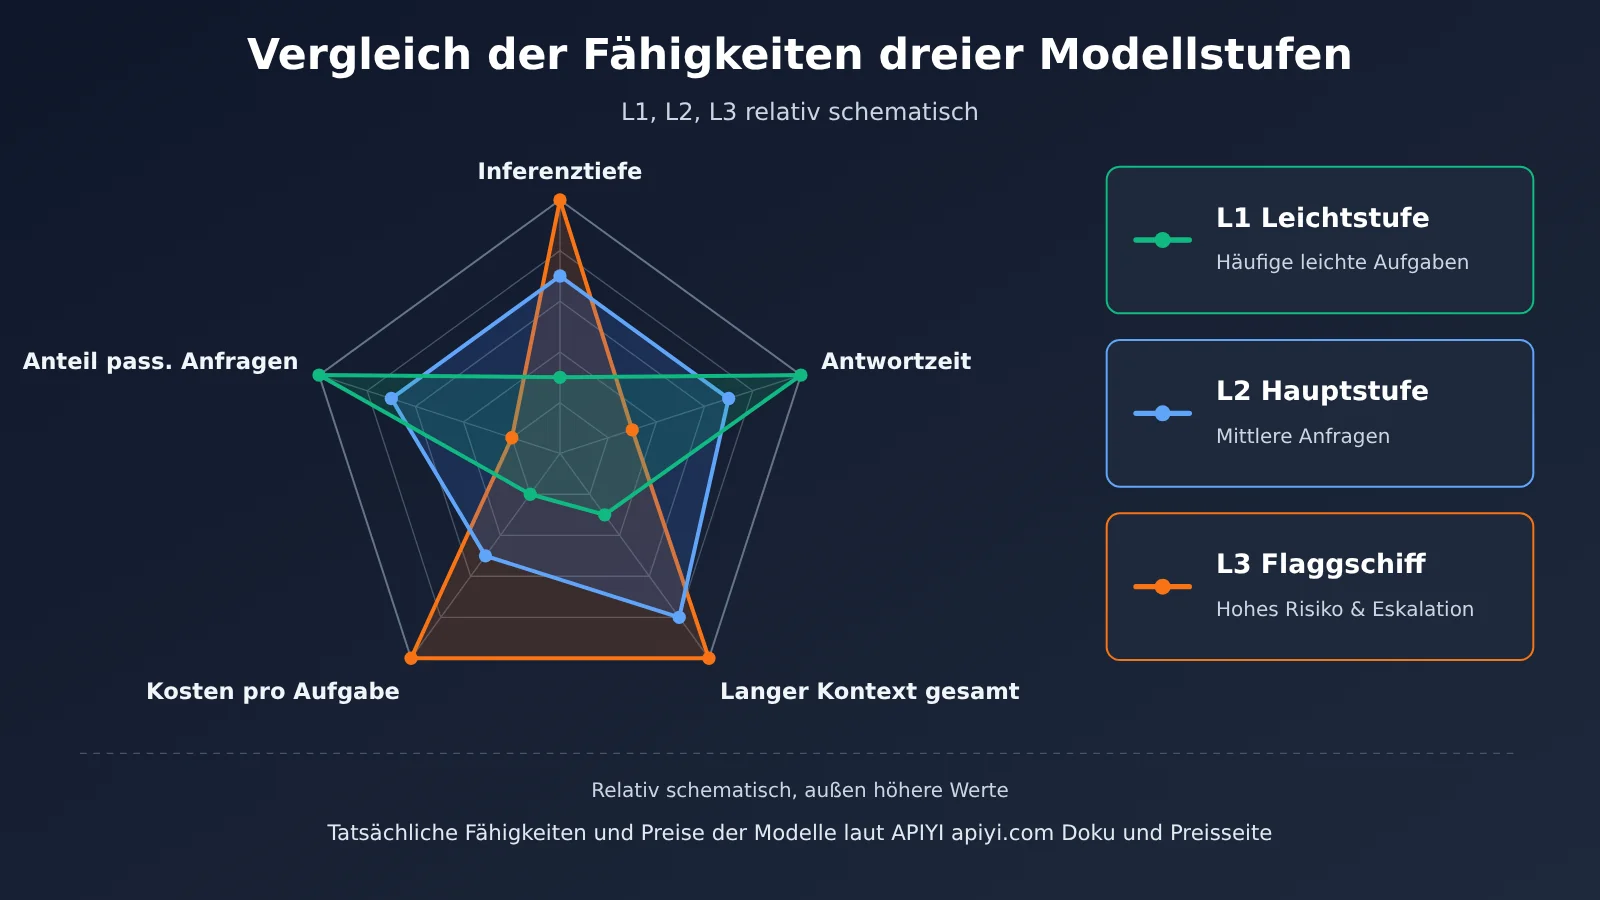
Die folgende Tabelle ordnet die in den Referenzmaterialien genannten gängigen Modelle nach Schichten ein, damit Sie die Kandidaten für jede Schicht auswählen können. Die Positionierungen in der Tabelle stammen aus öffentlich zugänglichen Materialien und Bewertungen von Drittanbietern; die konkrete Leistung kann sich mit Versionsupdates ändern. Es empfiehlt sich, mit den eigenen Geschäftsdaten nachzutesten.
| Modell | Übliche Positionierung | Geeignete Schicht | Verfügbare Plattform |
|---|---|---|---|
| Claude Opus 4.7 / 4.6 | Komplexe Programmierung und mehrstufige Inferenz | L3-Flagschiffschicht | APIYI apiyi.com, offizielle API |
| GPT-5.5 | Universelles Flaggschiff, 1M-Kontext | L3-Flagschiffschicht | APIYI apiyi.com, offizielle API |
| Gemini 3.1 Pro | Inferenz und langer Kontext, herausragendes Preis-Leistungs-Verhältnis | L2 bis L3 | APIYI apiyi.com, offizielle API |
| DeepSeek V4 Pro | Open Source mit vielen Parametern, 1M-Kontext | L2-Hauptschicht | APIYI apiyi.com, offizielle API |
| Kimi K2.6 | Programmierfähigkeit nahe am Flaggschiff | L2-Hauptschicht | APIYI apiyi.com, offizielle API |
| DeepSeek V4 Flash | Kostengünstig, geeignet für Aufgaben mit klaren Grenzen | L1 bis L2 | APIYI apiyi.com, offizielle API |
| Claude Haiku 4.5 / GPT-5.4 Mini | Häufige, leichtgewichtige Aufgaben | L1-Leichtgewichtsschicht | APIYI apiyi.com, offizielle API |
Vergleichsanalyse von Flaggschiff- und Hauptmodellen
Vergleichsanalyse der Flaggschiffmodelle: Flaggschiffmodelle wie Claude Opus und GPT-5.5 bleiben bei mehrstufiger Inferenz, dateiübergreifenden Codeänderungen und der Erkennung versteckter Fehler führend. Allerdings sind ihre Stückpreise und Antwortzeiten deutlich höher; sie für einfache Aufgaben wie Klassifizierung oder Umschreiben einzusetzen, ist eine klare Fehlallokation von Ressourcen. Im Vergleich dazu eignen sich Flaggschiffmodelle am besten für die L3-Schicht, wo sie nur risikoreiche Anfragen und Eskalationen nach Fehlern in niedrigeren Schichten bearbeiten.
Vergleichsanalyse der Open-Source-Hauptmodelle: DeepSeek V4 und Kimi K2.6 schneiden bei routinemäßiger Programmierung und Dokumentenverarbeitung hervorragend ab; Bewertungen von Drittanbietern zeigen, dass der Abstand zu Flaggschiffmodellen bei vielen Aufgaben bereits klein ist. Bei Aufgaben, die langkettige Inferenz erfordern und viele implizite Einschränkungen enthalten, besteht jedoch weiterhin ein Unterschied. Für die meisten Anfragen mittlerer Komplexität bleiben Modelle der Hauptschicht die zuverlässigere und wirtschaftlichere Standardwahl.
💡 Empfehlung zur Auswahl: Welches Modell Sie für jede Schicht wählen, hängt vor allem von Ihrer Aufgabenverteilung und Ihren Qualitätsanforderungen ab. Wir empfehlen, über APIYI apiyi.com mit derselben Stichprobe einen Quervergleich der Kandidatenmodelle durchzuführen und erst dann das Haupt- und das Ausweichmodell für jede Schicht festzulegen.
Kostenkalkulation für hierarchisches Routing
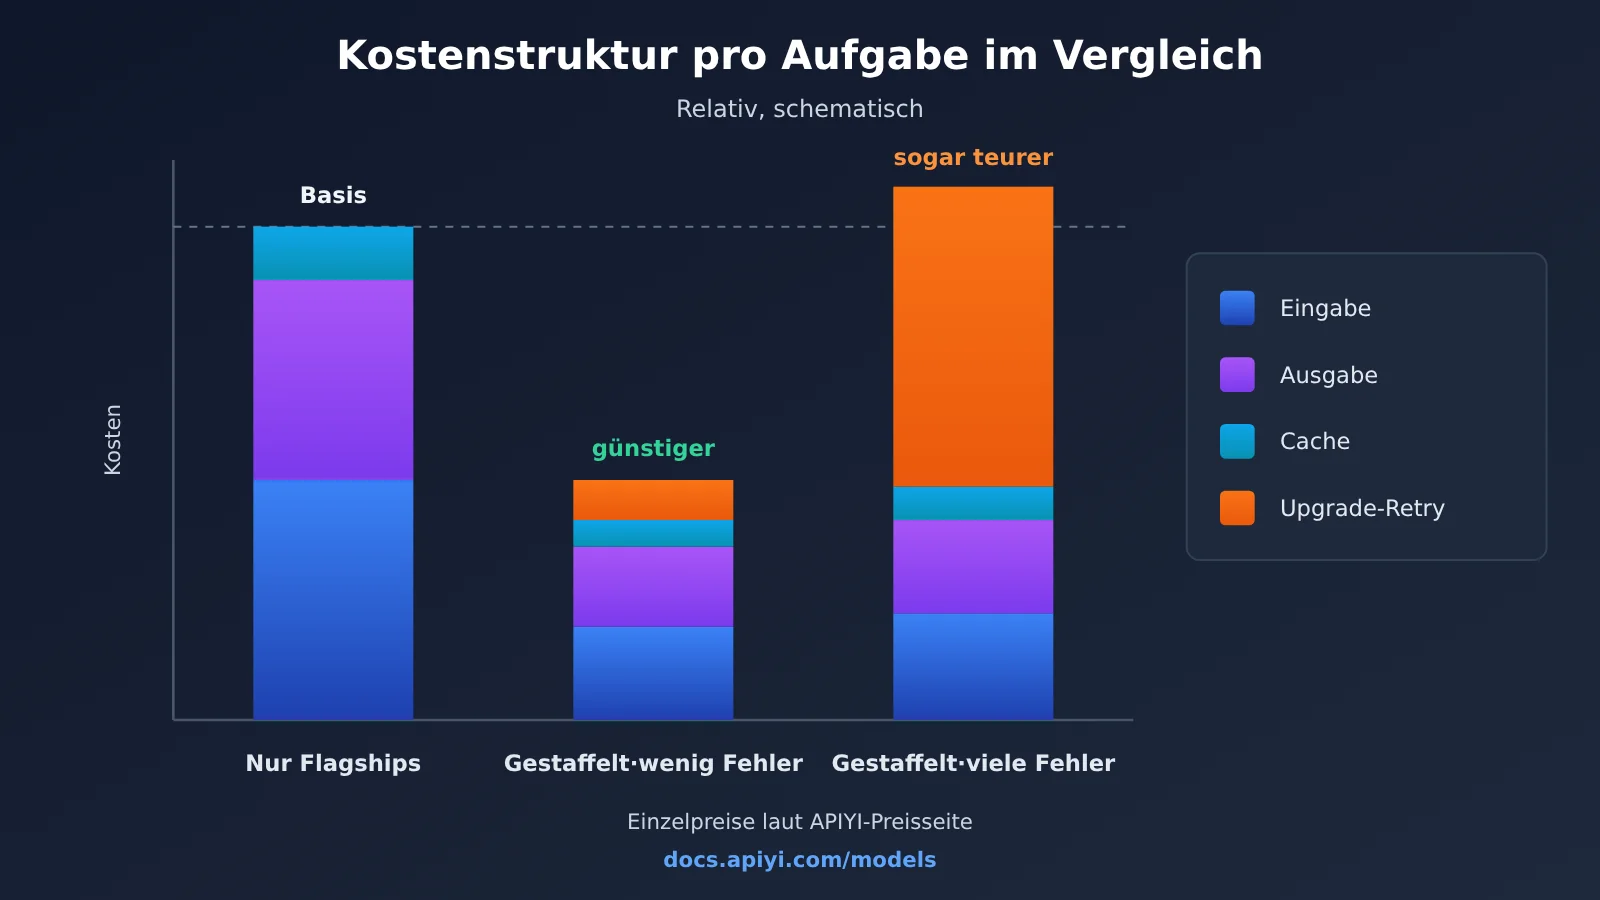
Ob hierarchisches Routing Geld spart, lässt sich nicht anhand des Stückpreises beurteilen, sondern nur über die „Gesamtkosten pro Aufgabe“. Diese setzen sich in der Regel aus mehreren Abrechnungspositionen zusammen – ein einziger Rechenfehler verfälscht das Ergebnis.
| Abrechnungsposition | Beschreibung | Preisgrundlage |
|---|---|---|
| Eingabe-Token | Gesamtmenge aus Eingabeaufforderung, Kontext und Verlaufsnachrichten | Maßgeblich sind die tatsächlichen Daten auf der APIYI-Preisseite docs.apiyi.com/models |
| Ausgabe-Token | Vom Modell erzeugter Inhalt; bei Reasoning-Modellen ggf. inklusive Denk-Token | Maßgeblich sind die tatsächlichen Daten auf der APIYI-Preisseite docs.apiyi.com/models |
| Cache-Lesen | Der Eingabeanteil, der den Prompt-Cache trifft | Maßgeblich sind die tatsächlichen Daten auf der APIYI-Preisseite docs.apiyi.com/models |
| Cache-Schreiben | Der Eingabeanteil, der erstmals in den Cache geschrieben wird – bei manchen Modellen separat abgerechnet | Maßgeblich sind die tatsächlichen Daten auf der APIYI-Preisseite docs.apiyi.com/models |
| Upgrade-Wiederholung | Alle Kosten, die entstehen, wenn eine Aufgabe nach dem Scheitern auf niedrigerer Stufe erneut auf höherer Stufe ausgeführt wird | Kumulativ nach der tatsächlich aufgerufenen Stufe berechnet |
Häufige Denkfehler bei den Kosten pro Aufgabe im hierarchischen Routing
Der erste Denkfehler ist die doppelte Zählung von Cache-Token. In den Referenzmaterialien wird ausdrücklich darauf hingewiesen, beim Berechnen der Cache-Kosten Lesen, Schreiben, normale Eingabe, Ausgabe und Wiederholungen getrennt zu erfassen – sonst landen dieselben Token schnell zweimal in der Rechnung. Der zweite Denkfehler ist das Ignorieren der Upgrade-Kosten: Ist die Fehlerquote der Prüfung auf L1 hoch, kann „erst das günstige Modell probieren“ teurer werden als der direkte Einsatz des Hauptmodells.
Deshalb empfiehlt sich eine einfache Formel, um zu beurteilen, ob eine Aufgabengattung in eine niedrigere Stufe gehört: Kosten der niedrigen Stufe pro Durchlauf plus „Fehlerquote mal Kosten der hohen Stufe pro Durchlauf“. Liegt dieser Wert deutlich unter den Kosten des direkten Einsatzes der hohen Stufe und bleibt die Qualität akzeptabel, eignet sich die Aufgabe für die Verlagerung nach unten. Die konkreten Stückpreise, Cache-Preise und Abrechnungsregeln der einzelnen Modelle entnehmen Sie bitte einheitlich den Echtzeitdaten der APIYI-Preisseite docs.apiyi.com/models – dieser Artikel nennt bewusst keine konkreten Preisangaben.
💰 Kostenoptimierung: Für die Kostenkalkulation lesen Sie am besten direkt auf der APIYI-Preisseite die Eingabe-, Ausgabe- und Cache-Stückpreise der einzelnen Modelle aus und berechnen daraus mit Ihren eigenen Logdaten die Kosten pro Aufgabe. Innerhalb derselben Plattform gelten einheitliche Abrechnungsregeln, was Modellvergleiche deutlich fehleranfälliger macht – äh, viel weniger fehleranfällig macht.
Häufige Fragen (FAQ)
F1: Was bedeutet aufgabenbasiertes Stufen-Routing großer Sprachmodelle?
Dabei werden Anfragen je nach Aufgabentyp, Risikoniveau und Kontextgröße Modellen mit unterschiedlichen Fähigkeits- und Kostenstufen zugewiesen. Einfache Aufgaben gehen an ein leichtgewichtiges Modell, Routineaufgaben an das Hauptmodell, und nur komplexe oder risikoreiche Aufgaben werden an das Flaggschiffmodell übergeben.
F2: Was ist der Unterschied zwischen Stufen-Routing und einem einfachen „Downgrade auf ein günstigeres Modell“?
Ein einfaches Downgrade ist meist ein globaler Austausch, wodurch die Qualität insgesamt sinkt. Beim Stufen-Routing werden Aufgaben unterschiedlich behandelt, und es gibt Prüf- sowie automatische Upgrade-Mechanismen: Schlägt eine Anfrage auf einer niedrigeren Stufe fehl, wird sie von einem stärkeren Modell erneut bearbeitet. So lassen sich Kosten kontrollieren und gleichzeitig die Qualitätsuntergrenze halten.
F3: Müssen die Routing-Strategien nach den neuen Modellveröffentlichungen 2026 neu angepasst werden?
Ja. In der ersten Hälfte von 2026 erscheinen dicht gedrängt neue Versionen wie GPT-5.5, DeepSeek V4 und Claude Opus, und die Fähigkeitsgrenzen zwischen den Stufen verschieben sich schnell. Es empfiehlt sich, nach jedem größeren Modellupdate die Erfolgsquote jeder Stufe mit einem festen Testsatz erneut zu messen und dann zu entscheiden, ob die Stufenzuordnung angepasst werden muss.
F4: Welche Anfragen sollten am ehesten das Flaggschiffmodell nutzen?
Dazu gehören vor allem folgende Kategorien:
– **Dateiübergreifende Code-Refactorings und komplexe Bug-Analyse**: Erfordert das Verständnis der Abhängigkeiten in einem großen Kontext.
– **Ausgaben in risikoreichen Bereichen**: etwa Vertragsprüfung, Abstimmung finanzieller Kennzahlen und Definitionen, Erstellung von Sicherheitsrichtlinien.
– **Reasoning-Aufgaben mit vielen Nebenbedingungen**: etwa komplexe Terminplanung, Abwägung von Lösungsvarianten, mathematische Herleitungen.
– **Anfragen, die auf niedrigeren Stufen bereits fehlgeschlagen sind**: als Upgrade-Fallback.
F5: Wie kann man mit APIs schnell eine Testumgebung für Stufen-Routing aufbauen?
Empfohlen wird eine API-Aggregationsplattform, die mehrere Modelle unterstützt:
1. Besuchen Sie APIYI apiyi.com, registrieren Sie ein Konto und holen Sie sich einen API-Schlüssel.
2. Sehen Sie im Dokumentationszentrum von APIYI unter docs.apiyi.com die Zugangsadresse und die verfügbaren Modellnamen nach.
3. Wählen Sie gemäß der Konfigurationsliste in diesem Artikel je ein Modell für L1, L2 und L3 und vergleichen Sie die Erfolgsquote mit demselben Stichprobensatz.
APIYI ist mit den Schnittstellenformaten von OpenAI und Anthropic kompatibel. Bestehende Projekte lassen sich in der Regel ohne größere Änderungen anbinden.
F6: Verursacht es zusätzliche Kosten, wenn die Aufgabenklassifizierung selbst von einem Modell übernommen wird?
Es entstehen geringe Zusatzkosten. Deshalb sollte man bevorzugt bereits am Geschäftseingang kennzeichnen, zum Beispiel ist der „Einstieg für Kundenservice-Fragen“ standardmäßig eine bestimmte Aufgabenklasse. Nur wenn sich die Aufgabe am Einstieg nicht unterscheiden lässt, sollte ein leichtgewichtiges L1-Modell für die Klassifizierung verwendet werden. Diese Kosten sind meist deutlich niedriger als die Verschwendung durch den falschen Einsatz eines Flaggschiffmodells.
F7: Welche bekannten Einschränkungen hat Stufen-Routing?
Im Wesentlichen drei: Erstens müssen die Regeln laufend gepflegt werden; nach Modellupdates können Schwellenwerte ihre Gültigkeit verlieren. Zweitens erhöhen Upgrade-Wiederholungen die Latenz einiger Anfragen, was bei Szenarien mit extrem hohen Echtzeitanforderungen abgewogen werden muss. Drittens unterscheiden sich die Ausgabestile der Modelle, sodass kundenorientierte Produkte möglicherweise eine einheitliche Nachbearbeitung benötigen. Treten diese Probleme auf, kann man die Standardstufe erhöhen oder die Anzahl der Stufen verringern.
F8: Wo sollte man die Preise für gestaffeltes Routing nachschlagen?
Für die Einzelpreise aller Modelle bei Eingabe, Ausgabe und Cache sowie für die Abrechnungsgrundlage gilt: Maßgeblich sind die tatsächlichen Daten auf der Preisseite von APIYI unter docs.apiyi.com/models. Preise in Artikeln von Drittanbietern können von dem Kanal abweichen, den du tatsächlich nutzt – es ist nicht ratsam, sie direkt für die Budgetplanung heranzuziehen.
Kernpunkte zum taskbasierten Routing von Large Language Models – Key Takeaways
- Die Einordnung richtet sich nach der Aufgabe, nicht nach dem Nutzer: Die Schwierigkeit der Anfragen ein und desselben Nutzers schwankt stark – man sollte sie einzeln beurteilen.
- Die Fehlerkosten sind wichtiger als die Schwierigkeit: Auch einfache, aber riskante Aufgaben rechtfertigen ein Flaggschiffmodell.
- Standardmäßig über die Hauptebene zu routen ist am stabilsten: Die mittlere Ebene fängt auf, Auf- und Abstufung erfolgt signalgesteuert – die Regeln sind einfach und wartbar.
- Die untere Ebene braucht zwingend eine Validierung: Nur programmatisch prüfbare Ausgaben eignen sich für leichte Modelle.
- Kosten als Gesamtsumme pro Aufgabe betrachten: Eingabe, Ausgabe, Cache und Wiederholungsversuche müssen getrennt berechnet werden.
- Nach Modell-Updates erneut testen: 2026 entwickeln sich Modelle schnell – die Ebenenzuordnung muss regelmäßig nachkalibriert werden.
- Eine einheitliche Schnittstelle senkt die Wechselkosten: Über APIYI apiyi.com lassen sich mehrere Modelle mit demselben Interface aufrufen.
Zusammenfassung
Die Kernpunkte beim aufgabenbasierten Routing von Großmodellen nach Stufen:
- Dreistufige Aufteilung: L1 übernimmt leichte, verifizierbare Aufgaben, L2 trägt den Standardverkehr, L3 bekommt ausschließlich komplexe, risikoreiche und eskalierte Anfragen.
- Regelpriorität: Manuelle Überschreibung, Risiko-Tag, Kontextlänge, Aufgabentyp und Standardstufe werden nacheinander geprüft; bei einem Fehlschlag erfolgt automatisch eine Eskalation.
- Datengetrieben: Durchlaufrate, Wiederholungsrate und Kosten pro Aufgabe für jede Stufe erfassen und Schwellenwerte anhand echter Daten statt nach Gefühl anpassen.
Beim Stufenrouting geht es nicht darum, „alles mit dem günstigsten Modell zu erledigen“, sondern die Fähigkeiten der Flaggschiff-Modelle genau dort einzusetzen, wo sie wirklich gebraucht werden. Es empfiehlt sich, mit ein bis zwei häufig auftretenden Aufgaben zu beginnen, die komplette Kette aus „Klassifizierung, Aufruf, Verifikation, Eskalation, Protokollierung“ zum Laufen zu bringen und anschließend schrittweise auf weitere Geschäftsbereiche auszuweiten.
Zur schnellen Validierung des Stufenkonzepts empfehlen wir APIYI unter apiyi.com. Die Plattform bietet eine einheitliche Schnittstelle für mehrere Modelle. Die Hinweise zur Anbindung finden Sie unter docs.apiyi.com, die Preisangaben entnehmen Sie bitte docs.apiyi.com/models.
📚 Referenzen
- Ofox.ai Blog-Artikelliste (April bis Mai 2026): Umfasst Veröffentlichungen und Vergleiche von Modellen wie GPT-5.5, DeepSeek V4, Claude Opus
- Link:
ofox.ai/blog/page/35 -
Hinweis: Enthält Drittanbieter-Analysen zu hybridem Modellrouting, Cache-Kostenberechnung usw.; dieser Artikel zitiert daraus nur die faktischen Informationen
-
Ofox.ai Blog-Artikelliste (Modellveröffentlichungen und Bewertungen): Umfasst GPT-5.5 Instant, Benchmarks gängiger Modelle und Kostenvergleiche pro Aufgabe
- Link:
ofox.ai/blog/page/36 -
Hinweis: Geeignet, um die öffentliche Positionierung der gängigen Modelle im Jahr 2026 zu verstehen
-
Ofox.ai Blog-Artikelliste (kleine und Open-Source-Modelle): Umfasst leichte und Open-Source-Modelle wie Claude Haiku, GPT-5.4 Mini, Llama 4
- Link:
ofox.ai/blog/page/37 -
Hinweis: Geeignet als Referenz bei der Auswahl von Kandidatenmodellen für die Stufen L1 und L2
-
APIYI Dokumentationszentrum: Anbindungsadresse, Schnittstellenformat und Modellnamen
- Link:
docs.apiyi.com -
Hinweis: Bitte vor der Anbindung einer OpenAI- oder Anthropic-kompatiblen Schnittstelle zuerst prüfen
-
APIYI Modellpreisseite: Eingabe-, Ausgabe- und Cache-Abrechnungsdaten der einzelnen Modelle
- Link:
docs.apiyi.com/models - Hinweis: Sämtliche Kostenberechnungen in diesem Artikel basieren auf den tatsächlichen Daten dieser Seite
Autor: APIYI Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI auf apiyi.com. Weitere Anbindungsunterlagen finden Sie im Dokumentationszentrum unter docs.apiyi.com