Hinweis des Autors: Dieser Artikel ordnet den juristischen Suchindex von Astra for Law mit 230 Millionen URLs, die Testergebnisse und die API-Preise anhand offizieller Angaben ein und untersucht, woher die Fachkompetenz des Systems stammt.
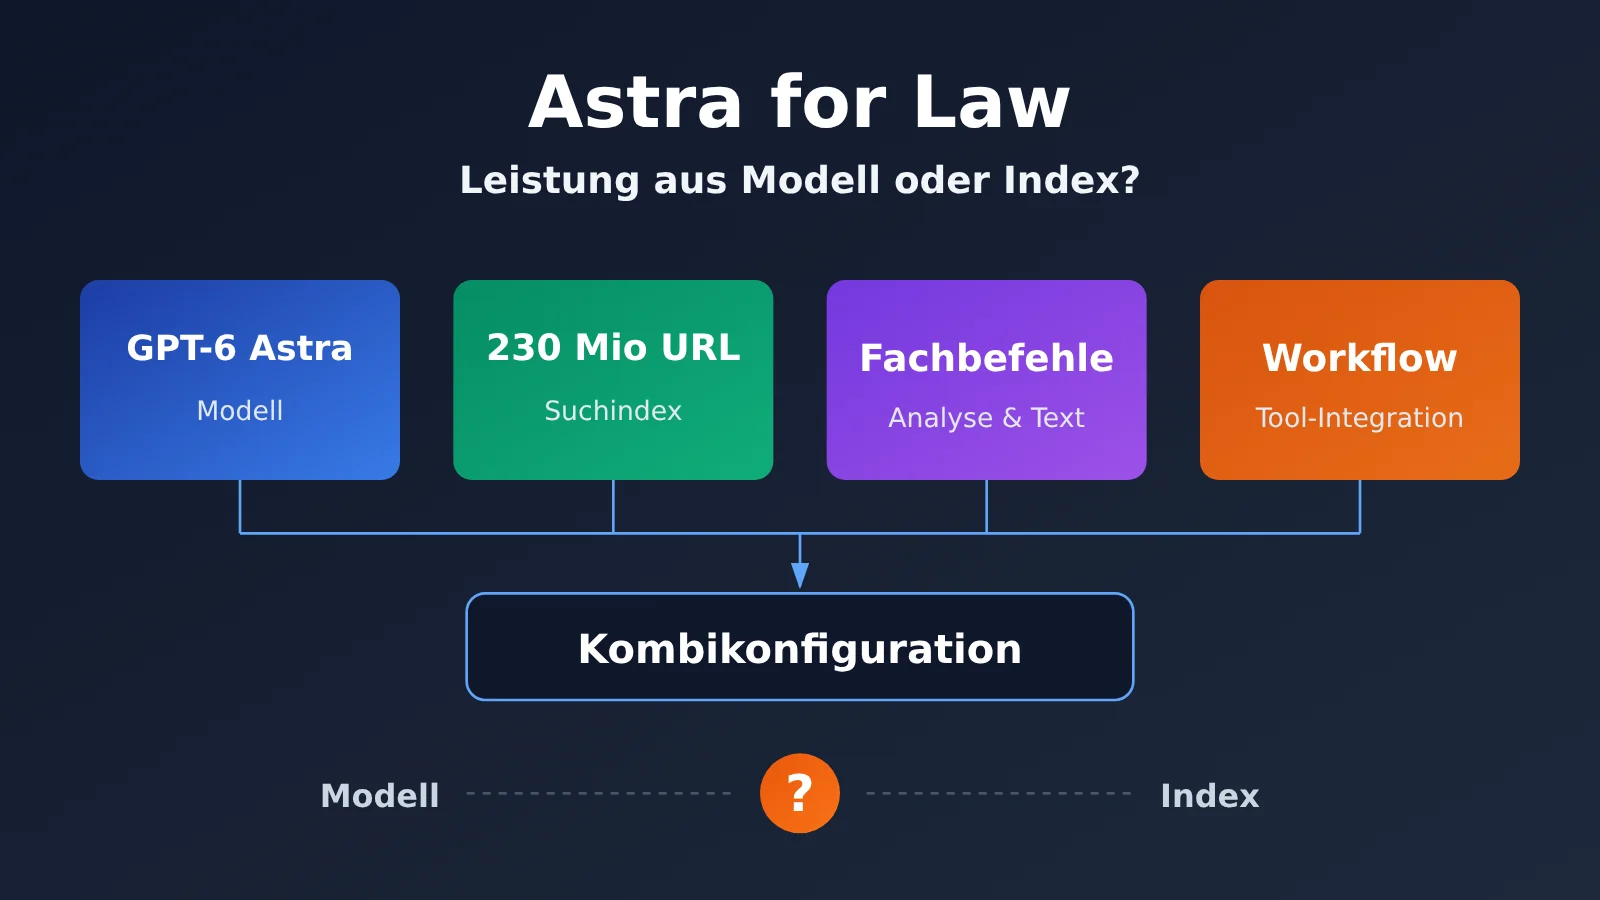
Auf der offiziellen API-Preisseite von OpenAI ist die Konfiguration für den Rechtsbereich gpt-6-astra-law hinzugekommen. Mehrere Technologiemedien berichteten am 31. Oktober 2026 über den Eintrag. Aufmerksamkeit erhielt auch der juristische Suchindex von Astra for Law mit mehr als 230 Millionen URLs. Das wirft eine zentrale Frage auf: Stammt die Fachkompetenz aus dem Modell oder aus dem Index?
Es handelt sich nicht um ein Gerücht: Produktbeschreibung, Indexgröße und Preise lassen sich auf den offiziellen Seiten von OpenAI überprüfen. Die bisher veröffentlichten Daten zeigen allerdings nur, dass die vollständige Konfiguration der allgemeinen Konfiguration überlegen ist. Wie viel des Leistungszuwachses auf das Modell, den Index oder die Anweisungen entfällt, lässt sich daraus noch nicht ableiten.
Darum geht es: In drei Minuten erfahren Sie, woraus Astra for Law besteht, was die wichtigsten Zahlen genau bedeuten und was Entwickler derzeit damit anfangen können.
Astra for Law: Die wichtigsten Fakten zu den 230 Millionen URLs
Zum Stand vom 2. November 2026 lassen sich die öffentlich verfügbaren Informationen wie folgt zusammenfassen. Besonders leicht misszuverstehen ist der API-Status: Die Preise sind zwar bekannt, aber das bedeutet nicht, dass alle Entwickler die API bereits nutzen können.
| Information | Details |
|---|---|
| Veröffentlichungsdatum | 17. September 2026 |
| Anbieter | OpenAI |
| Produktpositionierung | Professionelle KI-Basisplattform für Anwaltskanzleien und Legal-Tech-Unternehmen |
| Technische Bestandteile | GPT-6 Astra, juristischer Suchindex, Anweisungen für juristische Analyse und Texterstellung sowie Integration von Tools und Workflows |
| Indexumfang | Über 230 Millionen URLs, täglich kommen neue Quellen hinzu |
| Zugang | Anfangs über Trusted Access für zugelassene US-Anwaltskanzleien |
| API-Status | Laut offizieller Beschreibung soll die API erst künftig geöffnet werden; ein Termin steht noch nicht fest |
Was der juristische Suchindex von Astra for Law mit 230 Millionen URLs enthält
Der Index umfasst US-amerikanische Rechtsprechung, Gesetze, Verwaltungsvorschriften, Gerichtsregeln und Verwaltungsentscheidungen. OpenAI arbeitet zudem mit der gemeinnützigen Organisation Free Law Project zusammen, um US-Rechtsprechungsdaten von CourtListener in die Rechercheumgebung einzubinden.
Eine URL kann für eine Webseite, ein Schriftstück, einen Datensatz oder anderes juristisches Material stehen. „230 Millionen URLs“ bedeutet also nicht „230 Millionen Gerichtsurteile“. Auch die folgenden Zahlen beziehen sich auf unterschiedliche Datengrundlagen. Sie lassen sich weder voneinander abziehen noch dazu verwenden, die Menge anderer Materialien zu berechnen.
| Zahl | Quelle | Genaue Bedeutung | Nicht zu verwechseln mit |
|---|---|---|---|
| Über 230 Millionen URLs | OpenAI | Umfang des vollständigen juristischen Suchindex | 230 Millionen eigenständige Gerichtsurteile |
| Über 9 Millionen | Free Law Project | Datensätze zu Gerichtsentscheidungen in CourtListener | Gesamter Inhalt des OpenAI-Index |
| Über 2.000 Gerichte | Free Law Project | Gerichte, aus denen CourtListener Daten bezieht | Weltweite Abdeckung von Gerichten |
| Über 99,9 % | Free Law Project | Abdeckung veröffentlichter US-Präzedenzfälle | Vollständigkeit sämtlicher juristischer Materialien |
Auch die inhaltliche Abdeckung hat klare Grenzen: Der Index konzentriert sich derzeit auf US-amerikanische Rechtsmaterialien. Es gibt bislang keine verlässlichen offiziellen Angaben, die eine gleichwertige spezialisierte Abdeckung geltender chinesischer Gesetze und Vorschriften, Gerichtsdokumente und gerichtlicher Auslegungen belegen.
Stammt die Fachkompetenz von Astra for Law vom Modell oder vom juristischen Suchindex?
Die derzeit genaueste Antwort lautet: aus der Kombination beider Komponenten. Ihr jeweiliger Beitrag lässt sich anhand der verfügbaren Daten nicht genau beziffern. OpenAI beschreibt Astra for Law als eine auf GPT-6 Astra basierende Konfiguration für juristische Aufgaben. Den juristischen Suchindex bezeichnet OpenAI ausdrücklich als eines der verfügbaren Tools. Die öffentlichen Angaben betonen Konfiguration, Recherche, Tools und Anweisungen. Ob zusätzlich ein juristisches Fine-Tuning, eine Destillation oder ein separates Training der Modellparameter stattgefunden hat, ist nicht bestätigt.
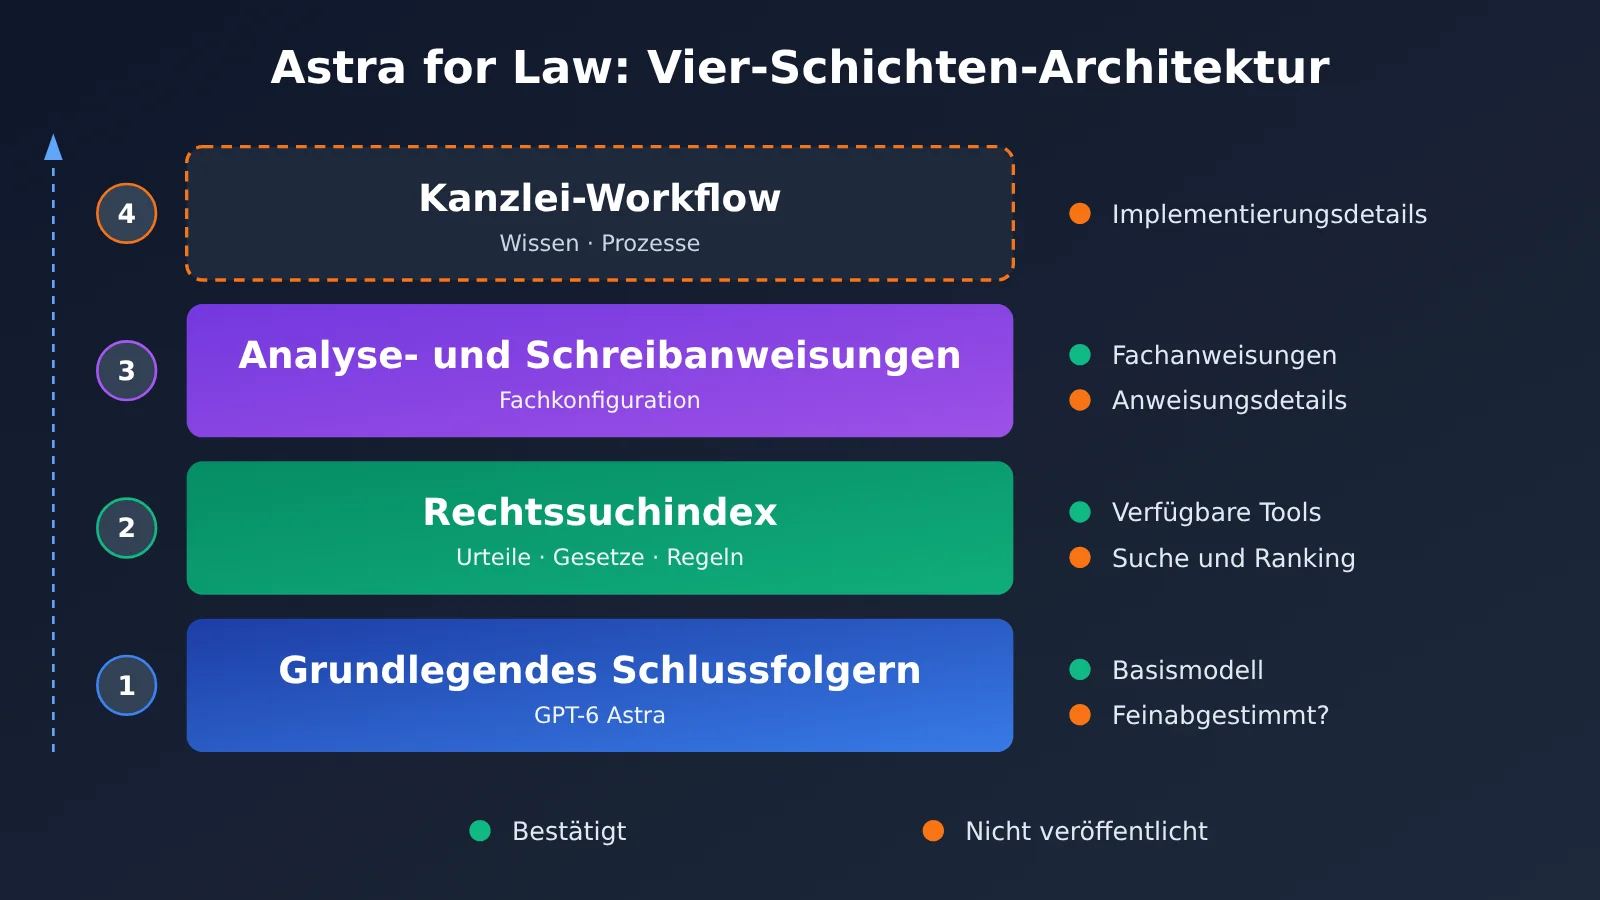
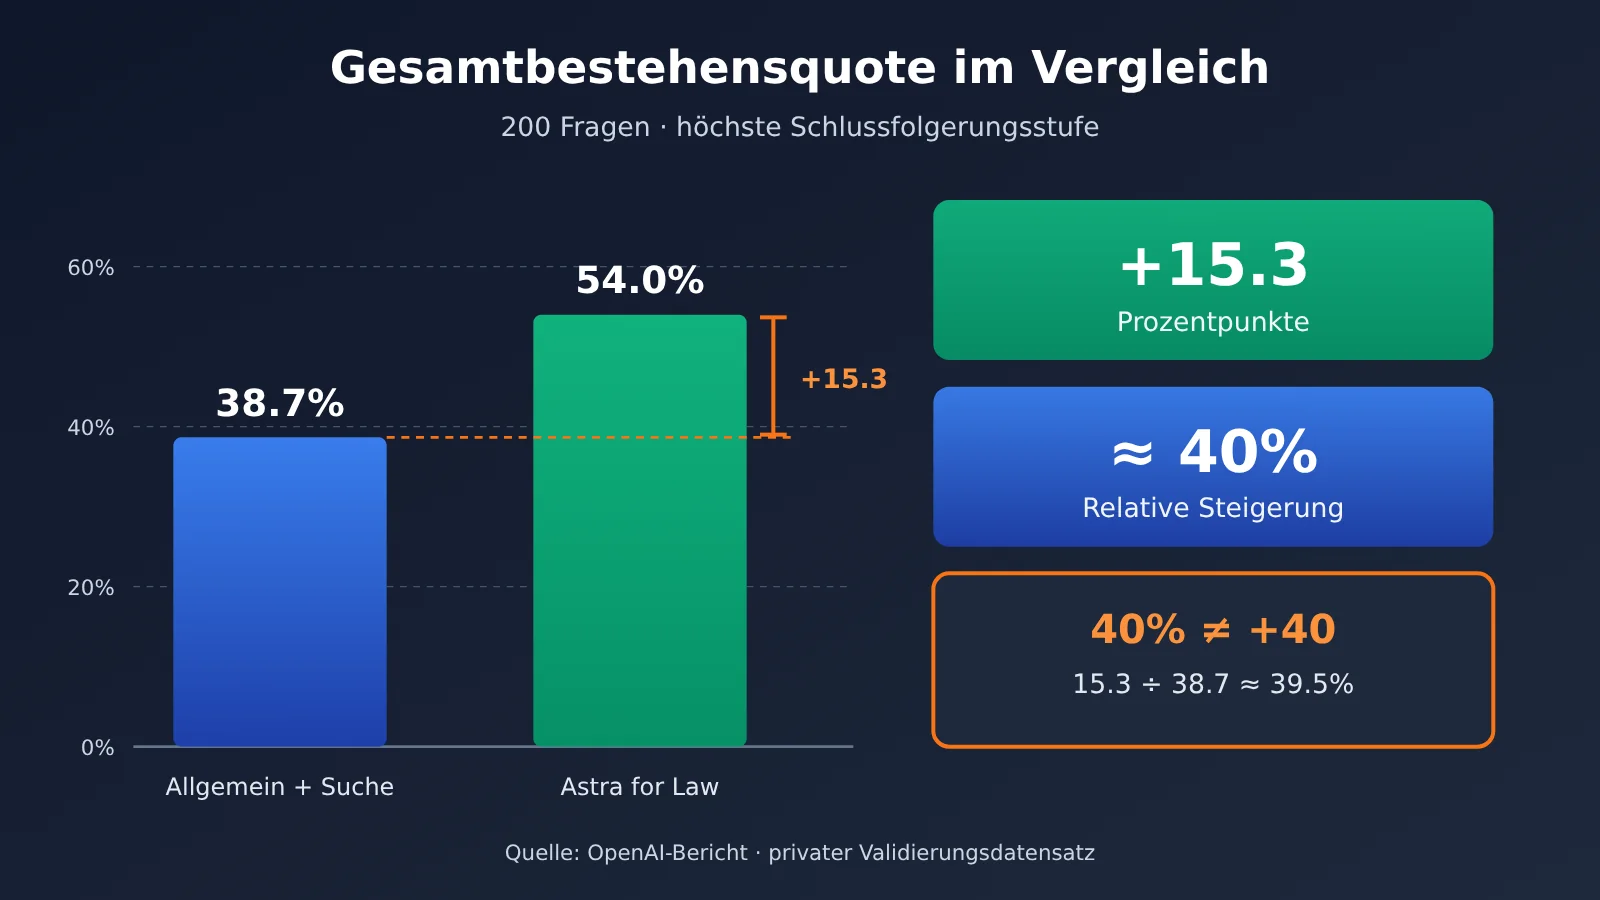
Die aussagekräftigsten Daten stammen aus einem von OpenAI berichteten Test. Darin wurden zwei Konfigurationen bei maximaler Reasoning-Stufe anhand von 200 US-amerikanischen Rechtsrecherchefragen aus dem privaten Validierungsdatensatz von Vals AI Legal Research Bench verglichen.
| Vergleichskriterium | Astra for Law | Allgemeines Astra + Websuche | Unterschied |
|---|---|---|---|
| Bestehensquote bei der Gesamtprüfung auf Korrektheit | 54,0 % | 38,7 % | 15,3 Prozentpunkte höher, relative Steigerung um rund 40 % |
| Anzahl referenzierter Präzedenzfälle bei Fragen zur Rechtsprechung | Mehr | Referenzwert | 24 % mehr |
| Relevante Abschnitte in den richtigen Gerichtsurteilen (bei gleicher Reasoning-Stufe) | Mehr | Referenzwert | Bis zu 54 % mehr |
Aus diesen Ergebnissen lassen sich drei Schlussfolgerungen ziehen:
- Das Basismodell bleibt das Fundament: Das Verstehen, Schlussfolgern und Generieren nach der Recherche hängt von GPT-6 Astra ab. Der Test misst jedoch nicht separat, welchen Beitrag das Modell selbst leistet.
- Die Recherchekennzahlen verbessern sich deutlich: Sowohl die Zahl der Präzedenzfälle als auch die der relevanten Abschnitte deuten auf eine stärkere spezialisierte Recherche hin. Mehr gefundene Fälle bedeuten aber nicht automatisch, dass eine Rechtsauskunft korrekter ist.
- Der Effekt lässt sich keiner einzelnen Komponente zuschreiben: Verglichen wurden vollständige Konfigurationen, bei denen sich Index, Anweisungen und weitere Einstellungen gleichzeitig unterscheiden. Daher lässt sich nicht behaupten, „der juristische Index allein habe eine Verbesserung um 40 % bewirkt“.
Auch die Aussagekraft des Ergebnisses ist klar begrenzt. OpenAI hat es anhand eines privaten Validierungsdatensatzes ermittelt; es handelt sich nicht um eine unabhängige Reproduktion durch Vals AI. Ebenso wenig bedeutet es, dass die Genauigkeit bei Rechtsberatung, der Vorhersage von Prozesserfolgen oder der Vertragsprüfung bei 54 % liegt. Die Ergebnisse allgemeiner Modelle auf der öffentlichen Bestenliste stammen aus anderen Testkonfigurationen und lassen sich deshalb nicht direkt in eine gemeinsame Rangliste einordnen.
Warum die Websuche keinen spezialisierten Index für die Rechtssuche ersetzt
Bei der Rechtsrecherche geht es nicht nur darum, semantisch relevante Texte zu finden. Die Gerichtshierarchie, die Gerichtsbarkeit und die Frage, ob ein Präzedenzfall bindend ist, aufgehoben wurde oder nur noch eingeschränkt gilt, beeinflussen den tatsächlichen Wert einer Rechtsquelle. Derselbe Vertragsstreit kann je nach Rechtsordnung des Bundesstaats zu unterschiedlichen Ergebnissen führen.
Eine gewöhnliche Suche kann relevante Inhalte finden, aber nicht garantieren, dass eine zitierte Rechtsquelle tatsächlich anwendbar ist. Genau dieses Problem sollen ein spezialisierter Rechtsindex und fachliche Anweisungen gemeinsam lösen. Daraus folgt allerdings nicht, dass alle Quellen automatisch auf ihre Gültigkeit geprüft wurden.
🎯 Technischer Tipp: Wenn Sie eine Wissensdatenbank für ein Fachgebiet aufbauen, vergleichen Sie zunächst anhand derselben Fragen drei Konfigurationen: „nur Modell“, „Modell + allgemeine Suche“ und „Modell + spezialisierte Wissensdatenbank“. Über die einheitliche Schnittstelle von APIYI auf apiyi.com können Sie zwischen Modellen wechseln und den Aufwand für wiederholte Integrationen reduzieren.
Wie hängt Astra for Law mit einer klassischen RAG-Architektur zusammen?
Der klassische RAG-Ablauf sieht so aus: Ein Nutzer stellt eine Frage, eine Wissensdatenbank wird durchsucht, relevante Abschnitte werden abgerufen und das Modell erzeugt daraus unter Berücksichtigung des Kontexts eine Antwort. Astra for Law folgt einem ähnlichen Grundgedanken: Beide Ansätze verlassen sich nicht allein auf das Wissen in den Modellparametern. Die Ähnlichkeit beschränkt sich aber auf das Konzept – eine gängige RAG-Lösung lässt sich nicht ohne Weiteres mit der internen Implementierung gleichsetzen.
| Technische Frage | Öffentlicher Kenntnisstand | Korrekte Darstellung |
|---|---|---|
| Wird ein Rechtsuchindex verwendet? | Bestätigt | Er gehört zu den Tools, die Astra for Law aufrufen kann |
| Inhaltstypen des Index | Bestätigt | Fallrecht, Gesetze, Verordnungen, Gerichtsordnungen, Verwaltungsentscheidungen |
| Vektorbasierte oder hybride Suche | Nicht offengelegt | Keine konkrete Lösung behaupten |
| Embedding und Reranking | Nicht offengelegt | Nicht über konkrete Modelle oder Algorithmen spekulieren |
| Chunking-Strategie und Anzahl abgerufener Treffer | Nicht offengelegt | Keine allgemeinen Parameter übertragen |
| Implementierung der Rangfolge nach rechtlicher Autorität | Nicht offengelegt | Nur das Ziel beschreiben, nicht die Umsetzung |
OpenAIs allgemeine File Search verwendet tatsächlich einen Vektorspeicher und kombiniert semantische Suche mit einer Schlüsselwortsuche. Derzeit gibt es jedoch keine öffentlichen Informationen, die bestätigen, dass sie und der Rechtsindex dieselbe technische Grundlage nutzen. Daher lassen sich ihre Parameter nicht direkt auf die Rechtsversion übertragen.
Das Grundmuster juristischer Recherche mit RAG nachbilden
Das folgende Beispiel ruft weder gpt-6-astra-law auf noch kann es den Legal Search Index nachbilden. Es zeigt lediglich ein allgemeines Muster: Grundlagen recherchieren, Quellen eingrenzen und Quellenangaben verlangen. Wählen Sie den Modellnamen anhand der tatsächlich verfügbaren Modelle.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

context = "[DOC-1] 示例资料:此处放入检索到的法律片段"
response = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[
        {"role": "system", "content": "仅依据给定资料回答,并标注来源编号。资料不足时明确说明。"},
        {"role": "user", "content": f"资料:{context}\n问题:该条款有哪些风险?"}
    ]
)
print(response.choices[0].message.content)
Vollständiges Beispiel mit Metadatenfilter anzeigen
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 以下均为虚构演示数据,不是真实法律资料
DOCS = [
    {
        "id": "DOC-1",
        "title": "示例判决 A",
        "jurisdiction": "示例州",
        "year": 2024,
        "text": "示例内容:合同终止条款需要事先书面通知。"
    },
    {
        "id": "DOC-2",
        "title": "示例判决 B",
        "jurisdiction": "其他州",
        "year": 2023,
        "text": "示例内容:合同终止通知可以采用电子方式。"
    }
]


def retrieve(keywords, jurisdiction, top_k=3):
    """按司法辖区过滤,再按关键词命中数和年份排序"""
    candidates = [d for d in DOCS if d["jurisdiction"] == jurisdiction]
    scored = []
    for doc in candidates:
        score = sum(keyword in doc["text"] for keyword in keywords)
        if score > 0:
            scored.append((score, doc["year"], doc))
    scored.sort(key=lambda item: (item[0], item[1]), reverse=True)
    return [item[2] for item in scored[:top_k]]


def answer(question, keywords, jurisdiction):
    docs = retrieve(keywords, jurisdiction)
    if not docs:
        return "未检索到符合司法辖区要求的资料,请人工复核。"

    context = "\n".join(
        f"[{d['id']}] {d['title']}({d['jurisdiction']},{d['year']}):{d['text']}"
        for d in docs
    )
    response = client.chat.completions.create(
        model="gpt-6.1-sol",  # 以平台实际可用模型为准
        messages=[
            {
                "role": "system",
                "content": (
                    "你是法律研究助手。仅依据给定资料回答,并标注来源编号。"
                    "指出不确定性和缺失信息。输出仅供专业人员复核,不构成法律意见。"
                )
            },
            {
                "role": "user",
                "content": f"资料:\n{context}\n\n问题:{question}"
            }
        ]
    )
    return response.choices[0].message.content


print(answer("终止合同是否需要书面通知?", ["合同", "通知"], "示例州"))
Tipp: Über APIYI apiyi.com können Sie kostenloses Testguthaben erhalten und verschiedene Modelle mit eigenen Fragen testen. Prüfen Sie dabei nicht nur, ob die Antworten flüssig klingen, sondern auch, ob die Quellenangaben korrekt und die herangezogenen Grundlagen anwendbar sind.
Auswirkungen der Astra-for-Law-API-Preise auf Entwickler
Die Preise senden ein wichtiges Signal: gpt-6-astra-law kostet pro Token genauso viel wie das Allzweckmodell gpt-6-astra. Einen Aufpreis gibt es derzeit nicht. Die folgende Tabelle zeigt die Tarife im Standardmodus laut offizieller Preisseite. Die Aktionspreise gelten mindestens bis zum 31. Dezember 2026.
| Modell | Eingabe / Mio. Token | Gecachte Eingabe / Mio. Token | Ausgabe / Mio. Token |
|---|---|---|---|
gpt-6-astra-law |
$10 | $1 | $50 |
gpt-6-astra |
$10 | $1 | $50 |
gpt-6.1-sol |
$2 | $0.10 | $10 |
gpt-6.1-terra |
$1 | $0.05 | $5 |
Bei diesen Preisen kosten 100.000 reguläre Eingabe-Token und 10.000 Ausgabe-Token zusammen etwa $1.50. Wenn die gesamte Eingabe für die Cache-Abrechnung infrage kommt, sind es etwa $0.60. Das ist nur eine Beispielrechnung: Mögliche Kosten für Tools, Recherche oder Sonderverarbeitung sind nicht enthalten. Auch wie der Rechtsindex über die API abgerechnet wird, ist noch nicht vollständig geklärt. Man sollte daher nicht davon ausgehen, dass die Recherche kostenlos ist.
💰 Hinweis zu den Kosten: Der Token-Preis der Rechtsversion ist fünfmal so hoch wie der von Sol. Die tatsächlichen Kosten einer Aufgabe hängen aber auch von der Ausgabelänge, den Tool-Aufrufen und der Erfolgsquote ab. Bei begrenztem Budget können Teams den Rechercheablauf zunächst mit vorhandenen Modellen über APIYI apiyi.com testen und dann anhand der Gesamtkosten entscheiden, ob sich ein Upgrade lohnt.
Auswirkungen auf Entwickler
- Andere Schwerpunkte beim Kompetenzaufbau: Im Wettbewerb um spezialisierte KI geht es nicht nur um die Modellauswahl, sondern auch um Datenqualität, die Nachvollziehbarkeit von Quellen und die Gestaltung fachlicher Regeln.
- Die Bewertung muss umfassender werden: Vollständige Konfigurationen sollten anhand desselben Aufgabensatzes verglichen werden. Dazu gehören auch Kennzahlen für die Genauigkeit von Quellenangaben und die Anwendbarkeit im jeweiligen Rechtsraum.
- Spielraum für die Einführung einplanen: Verfügbarkeitstermin, Ratenlimits und Tool-Parameter sind noch nicht bestätigt. Deshalb sollte das Modell vorerst nicht die einzige Abhängigkeit für einen Produktstart sein.
Auswirkungen auf die Legal-AI-Branche
- Der Wettbewerb nimmt weiter zu: Anthropic, Google, Thomson Reuters, Harvey und Legora treiben Produkte oder Funktionen für juristische KI voran.
- Wettbewerb und Zusammenarbeit bestehen nebeneinander: Harvey und Legora sind mögliche Wettbewerber, werden von OpenAI aber auch als künftige API-Kunden genannt.
- Kanzleiwissen bleibt wertvoll: Der Vertragsanalysator von Sullivan & Cromwell nutzt interne Verhandlungsleitfäden und frühere Verträge als Referenz. Das zeigt, dass ein öffentlicher Rechtsindex das Wissen einer Organisation nicht ersetzen kann. Kooperationsbeispiele von Ropes & Gray, Cooley und anderen weisen ähnliche Merkmale auf, können aber nicht alle als Praxistests der finalen API-Version gelten.
Häufig gestellte Fragen (FAQ)
F1: Ist Astra for Law ein eigenständig trainiertes Rechtsmodell?
Dafür gibt es derzeit keine Belege. Offiziell handelt es sich um eine juristische Fachkonfiguration auf Basis von GPT-6 Astra, die einen Rechtsindex, fachspezifische Anweisungen und Werkzeuge umfasst. Ob zusätzlich eine Feinabstimmung oder ein Parametertraining für den Rechtsbereich stattgefunden hat, ist nicht öffentlich bestätigt.
F2: Stehen die 54,0 % für die Genauigkeit der Rechtsberatung?
Nein. Die 54,0 % bezeichnen die Erfolgsquote bei der Gesamtprüfung auf Korrektheit in einem bestimmten Test zur juristischen Recherche. Sie gelten weder für alle rechtlichen Anwendungsfälle noch stehen sie für die Erfolgsquote vor Gericht oder die Genauigkeit bei der Vertragsprüfung. Die Ergebnisse müssen weiterhin von Anwälten geprüft werden.
F3: Kann ich gpt-6-astra-law schon jetzt aufrufen?
Daraus lässt sich nicht schließen, dass normale Entwickler bereits Zugriff haben. Laut offiziellem Hilfe-Center richtet sich das Produkt zunächst an berechtigte US-amerikanische Kanzleien; die API soll künftig verfügbar werden. Dass Modellkennung und Preise öffentlich sind, bedeutet nicht, dass jeder API-Schlüssel Zugriff hat.
F4: Eignen sich die 230 Millionen URLs für chinesische Rechtsfragen?
Das lässt sich derzeit nicht bestätigen. Der Index konzentriert sich ausdrücklich auf US-amerikanische Rechtsquellen. Es gibt keine verlässlichen offiziellen Angaben, die eine gleichwertige Abdeckung des chinesischen Rechts belegen. Für chinesische Anwendungsfälle müssen rechtskonforme lokale Datenquellen eingebunden und separat getestet werden.
F5: Wie lassen sich ähnliche juristische RAG-Lösungen derzeit prüfen?
Das geht in drei Schritten:
1. Bei APIYI auf apiyi.com registrieren und einen API-Schlüssel sowie kostenloses Testguthaben erhalten.
2. Anhand der Beispiele in diesem Artikel eigene, rechtskonforme Rechtsquellen einbinden.
3. Einen Fragenkatalog mit Musterantworten erstellen und verschiedene Modelle und Retrieval-Ansätze vergleichen.
F6: Welche Einschränkungen hat Astra for Law derzeit?
Die wichtigsten Einschränkungen sind der begrenzte Zugang, fehlende öffentliche API-Details und das Fehlen umfangreicher unabhängiger Tests durch Dritte. Auch zu Latenz, Durchsatz, tatsächlicher Fehlerquote und Kosten pro Fall liegen zu wenige Daten vor. Datenschutzkontrollen verhindern zudem weder Halluzinationen noch fehlerhafte Quellenangaben. Verbindliche Schlussfolgerungen müssen daher weiterhin von Menschen überprüft werden. Wer zunächst die Leistung allgemeiner Modelle vergleichen möchte, kann über APIYI auf apiyi.com Tests in kleinem Umfang durchführen.
Astra for Law: Das Wichtigste auf einen Blick
- Was das Produkt ist: Astra for Law ist eine auf juristische Aufgaben zugeschnittene Konfiguration auf Basis von GPT-6 Astra. Dass es sich um ein eigenständiges Modell handelt, ist nicht bestätigt.
- Umfang des Index: Die 230 Millionen beziehen sich auf URLs, nicht auf Gerichtsurteile. Der Schwerpunkt liegt auf US-amerikanischen Rechtsquellen.
- Woher die Fähigkeiten kommen: Die Fachleistung entsteht durch das Zusammenspiel von Modell, Index, Anweisungen und Workflow. Der Beitrag der einzelnen Komponenten lässt sich anhand der verfügbaren Daten nicht genau bestimmen.
- Testergebnisse: Die offiziell gemeldeten Werte von 54,0 % gegenüber 38,7 % entsprechen einer relativen Verbesserung von rund 40 %.
- Preis: Die juristische Version hat dieselben Basisstückpreise wie das allgemeine Astra-Modell. Die Kosten für Recherchetools sind noch nicht vollständig bestätigt.
- API-Status: Die Preise sind öffentlich, aber wann und unter welchen Bedingungen die API für Entwickler allgemein verfügbar sein wird, ist noch offen.
- Umsetzung: Über APIYI auf apiyi.com lässt sich zunächst das allgemeine Modell testen, um die eigene Wissensdatenbank und den Rechercheprozess zu überprüfen.
Fazit: Was die 230 Millionen URLs von Astra for Law zeigen
Zurück zur Ausgangsfrage: Die Fachkompetenz von Astra for Law lässt sich nicht allein dem Modell oder dem Index zuschreiben. Das Modell übernimmt Verständnis, Schlussfolgern und Textgenerierung. Der juristische Suchindex liefert nachvollziehbare Quellen, fachliche Anweisungen geben die Analyse- und Schreibweise vor, und das Wissen der Kanzlei bringt diese Fähigkeiten in den praktischen Workflow ein.
Der offizielle Test zeigt die Vorteile der Gesamtkonfiguration bei bestimmten juristischen Rechercheaufgaben. Er beziffert aber nicht den Beitrag der einzelnen Komponenten. Für Entwickler ist es daher sinnvoller, zunächst eigene Daten-, Recherche- und Evaluierungssysteme aufzubauen und die Informationen zur offiziellen API-Freigabe im Blick zu behalten.
Wenn Sie eine Anwendung mit einer Fachwissensdatenbank planen, können Sie über APIYI auf apiyi.com mehrere Modelle über eine einheitliche Schnittstelle vergleichen und die Machbarkeit Ihres Ansatzes zunächst kostengünstig prüfen.
📚 Quellen und weiterführende Informationen
- OpenAI: Produktankündigung von Astra for Law: Produktpositionierung, Indexumfang, Testergebnisse und Beispiele für Kooperationen
- Link:
openai.com/index/astra-for-law -
Hinweis: Die wichtigste Quelle für die technischen Informationen und offiziellen Testdaten in diesem Artikel
-
OpenAI API-Preisseite: Modellkennung und Tokenpreise für die juristische Konfiguration
- Link:
developers.openai.com/api/docs/pricing -
Hinweis: Hier lassen sich Preise und Aktionszeiträume prüfen. Am besten vor einem Modellaufruf erneut nachsehen
-
OpenAI-Hilfecenter: Astra for Law: Zugangsberechtigung und API-Verfügbarkeit
- Link:
help.openai.com/en/articles/20001528-astra-for-law -
Hinweis: Die erste Anlaufstelle, um zu prüfen, ob der Dienst aktuell genutzt werden kann
-
Free Law Project: Datenabdeckung von CourtListener: Quellen und Umfang der US-amerikanischen Rechtsprechungsdaten
- Link:
wiki.free.law/c/courtlistener/help/data-coverage/case-law -
Hinweis: Hilft dabei, die genaue Bedeutung der Abdeckung von 99,9 % einzuordnen
-
Vals AI Legal Research Bench: Testmethoden und öffentliche Bestenliste für die juristische Recherche
- Link:
www.vals.ai/benchmarks/legal_research -
Hinweis: Eine hilfreiche Grundlage, um Bewertungskriterien für juristische KI zu entwickeln
-
Technische Dokumentation zu OpenAI File Search: Funktionsweise des allgemeinen Tools für die Dateisuche
- Link:
developers.openai.com/api/docs/guides/tools-file-search -
Hinweis: Kann als technische Referenz für RAG dienen, beschreibt aber nicht die interne Implementierung des juristischen Index
-
Reuters: Bericht über OpenAIs Einstieg in den Rechtsbereich: Hintergrund zum Wettbewerb auf dem Markt für juristische KI
- Link:
www.reuters.com/legal/litigation/openai-launches-legal-focused-ai-platform-escalating-race-law-firm-users-2026-09-17 - Hinweis: Hilft dabei, die Wettbewerbssituation in der Branche zu verstehen
Autor: Das Technikteam von APIYI
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI. Weitere Informationen finden Sie im Dokumentationszentrum unter docs.apiyi.com.