Anmerkung des Autors: Ergebnisse auf öffentlichen Bestenlisten lassen sich durch gezielte Optimierung in die Höhe treiben. Dieser Artikel erklärt, wie Benchmaxing entsteht, stellt fünf Glaubwürdigkeitschecks vor und zeigt in vier Schritten, wie sich aus eigenen Aufgaben ein privater Testsatz erstellen lässt.
Das Fazit vorweg: Bestenlisten sind ein guter Ausgangspunkt für die Recherche, sollten aber nicht direkt zur Modellauswahl herangezogen werden. Auf Gesamtbestenlisten liegen führende Modelle oft nur wenige Punkte auseinander. Schon ein kleiner Unterschied kann genügen, um die Spitze neu zu besetzen. Bei so knappen Abständen kann die gezielte Optimierung auf Testaufgaben das Ranking beeinflussen. Dieses Phänomen wird als Benchmaxing bezeichnet.
Entscheidend für die Auswahl ist, wie sich die Kandidaten bei Ihren eigenen Geschäftsaufgaben schlagen. Dieser Artikel erstellt kein Modellranking und urteilt nicht darüber, wer „schummelt“. Er behandelt drei Fragen: Wie erkennt man möglicherweise überhöhte Ergebnisse? Wie erstellt man aus echten Tickets einen kleinen privaten Testsatz? Und welche wichtigen Kennzahlen decken Bestenlisten möglicherweise gar nicht ab?
Was ist Benchmaxing? 3 Gründe für überhöhte Benchmark-Ergebnisse
Laut einem Artikel von MindStudio vom 01.11.2026 bezeichnet Benchmaxing das Training oder die Feinabstimmung eines Modells mit dem Ziel, bei bekannten Benchmarks hohe Punktzahlen zu erzielen – statt seine allgemeinen Fähigkeiten zu verbessern. Typisch ist: Das Modell glänzt auf Bestenlisten, schneidet aber bei neuen Aufgaben, die dieselbe Fähigkeit prüfen, deutlich schlechter ab.
| Ursache | Wie es dazu kommt | Hinweise |
|---|---|---|
| Aufgaben landen in den Trainingsdaten | Benchmark-Aufgaben oder sehr ähnliche Varianten gelangen absichtlich oder unabsichtlich in die Trainingsdaten | Hohe Punktzahl bei Originalaufgaben, schlechtere Ergebnisse bei umformulierten Aufgaben |
| Feinabstimmung auf Aufgabentypen | Das Modell wird gezielt auf die bevorzugten Formate und Schlussfolgerungsmuster eines bestimmten Benchmarks optimiert | Auffällig gutes Ergebnis auf nur einer Bestenliste, durchschnittliche Leistungen auf anderen |
| Öffentliche Aufgaben sind lange im Umlauf | Aufgaben werden in Foren und Blogs diskutiert und gelangen schließlich in die aus dem Web gesammelten Trainingsdaten | Je älter ein öffentlich zugänglicher Benchmark ist, desto näher liegen die Ergebnisse an der Sättigungsgrenze |
Benchmaxing muss nicht böswillig sein
Der Originalartikel betont ausdrücklich, dass keine dieser drei Ursachen böse Absicht voraussetzt. Ein Labor kann tatsächlich glauben, die allgemeinen Schlussfolgerungsfähigkeiten zu verbessern, während es das Modell in Wirklichkeit zu stark auf einige bekannte Aufgabentypen spezialisiert. Je länger ein Benchmark öffentlich zugänglich ist, desto weniger misst er die tatsächlichen Fähigkeiten – und desto mehr ähnelt er einer Probeprüfung, die das Modell bereits im Voraus absolviert hat.
Bei der Beurteilung zählen deshalb die Belege, nicht die Motive. Entscheidend ist, ob sich das Ergebnis auf neue Aufgaben übertragen lässt – nicht, ob jemand womöglich absichtlich gehandelt hat.
Warum benchmaxing entsteht: Veröffentlichungsrhythmus und Benchmark-Narrative
Punktzahlen sind für KI-Labore der einfachste Weg, Investoren, Entwicklern und der Öffentlichkeit Fortschritte zu zeigen – ohne sich einer vollständigen unabhängigen Prüfung öffnen zu müssen. Eine Zahl wie „59 Punkte im Gesamtindex“ lässt sich leicht in eine Pressemitteilung aufnehmen und mit der Punktzahl eines Konkurrenzmodells vergleichen. Je einfacher die Zahl, desto größer der Druck, gezielt darauf hin zu optimieren.
Ein zweiter Faktor ist der Veröffentlichungsrhythmus. Laut demselben MindStudio-Artikel erreichte ein Modell der Google-Gemini-Reihe im Artificial Analysis Index 50 Punkte. Etwa einen Monat später kam ein Nachfolgemodell desselben Unternehmens auf 59 Punkte und übernahm die Spitzenposition. Für diese Angaben gibt es derzeit nur diese eine Quelle; sie wurden für diesen Artikel nicht unabhängig überprüft. Der Ausgangsartikel will damit zeigen: Zwischen Modellversionen liegen nur Wochen, an der Spitze entscheiden wenige Punkte. Da erscheint jedes Mittel attraktiv, das einen Vorsprung verschaffen kann.
Vor dem Blick auf die Rangliste: Fakten einordnen
Wer Punktzahlen zitiert, sollte zuerst klären, um welche Art von Aussage es sich handelt. Die folgende Tabelle zeigt das anhand der Beispiele aus diesem Artikel:
| Art der Angabe | Beispiel aus diesem Artikel | Einordnung |
|---|---|---|
| Offizielle Eigenangabe / mündliche Prognose | Musk sagt, Grok 5 könnte bei Humanity’s Last Exam „nahezu die volle Punktzahl“ erreichen; für Grok 4 nennt er rund 52 % im Textteil des Tests | Prognose und Eigenangabe, keine unabhängigen Testergebnisse |
| Unabhängiger Test durch Dritte | Der Artificial Analysis Index fasst Tests zu logischem Denken, Programmierung, Naturwissenschaften und Mathematik zusammen | Als Anhaltspunkt geeignet; das Datum der Abfrage sollte angegeben werden |
| Bericht eines einzelnen Mediums | Indexwert und Terminal-Bench-Ergebnis von Grok 4.7 sowie die Veränderung von 50 auf 59 Punkte bei Gemini | Nur MindStudio als Quelle, nicht unabhängig überprüft |
| Unbekannt | Der genaue Zeitpunkt und Umfang der Umstellung von Artificial Analysis auf nicht öffentliche Testaufgaben | Maßgeblich sind die offiziellen Angaben; dieser Artikel stellt dazu keine Vermutungen an |
Laut MindStudio liegt Grok 4.7 sowohl im unabhängigen Gesamtindex als auch bei Terminal-Bench hinter den führenden Modellen. Der Ausgangsartikel nimmt diese „Lücke zwischen öffentlichen Erwartungen und unabhängigen Tests“ zum Anlass für eine genauere Betrachtung. Er stellt ausdrücklich klar, dass dies nicht bedeutet, xAI sei problematischer als andere Anbieter. Auch dieser Artikel verwendet den Vergleich nur in diesem Sinne und zieht daraus keine weiteren Schlussfolgerungen.
5 Signale für die Glaubwürdigkeit von Benchmark-Ergebnissen
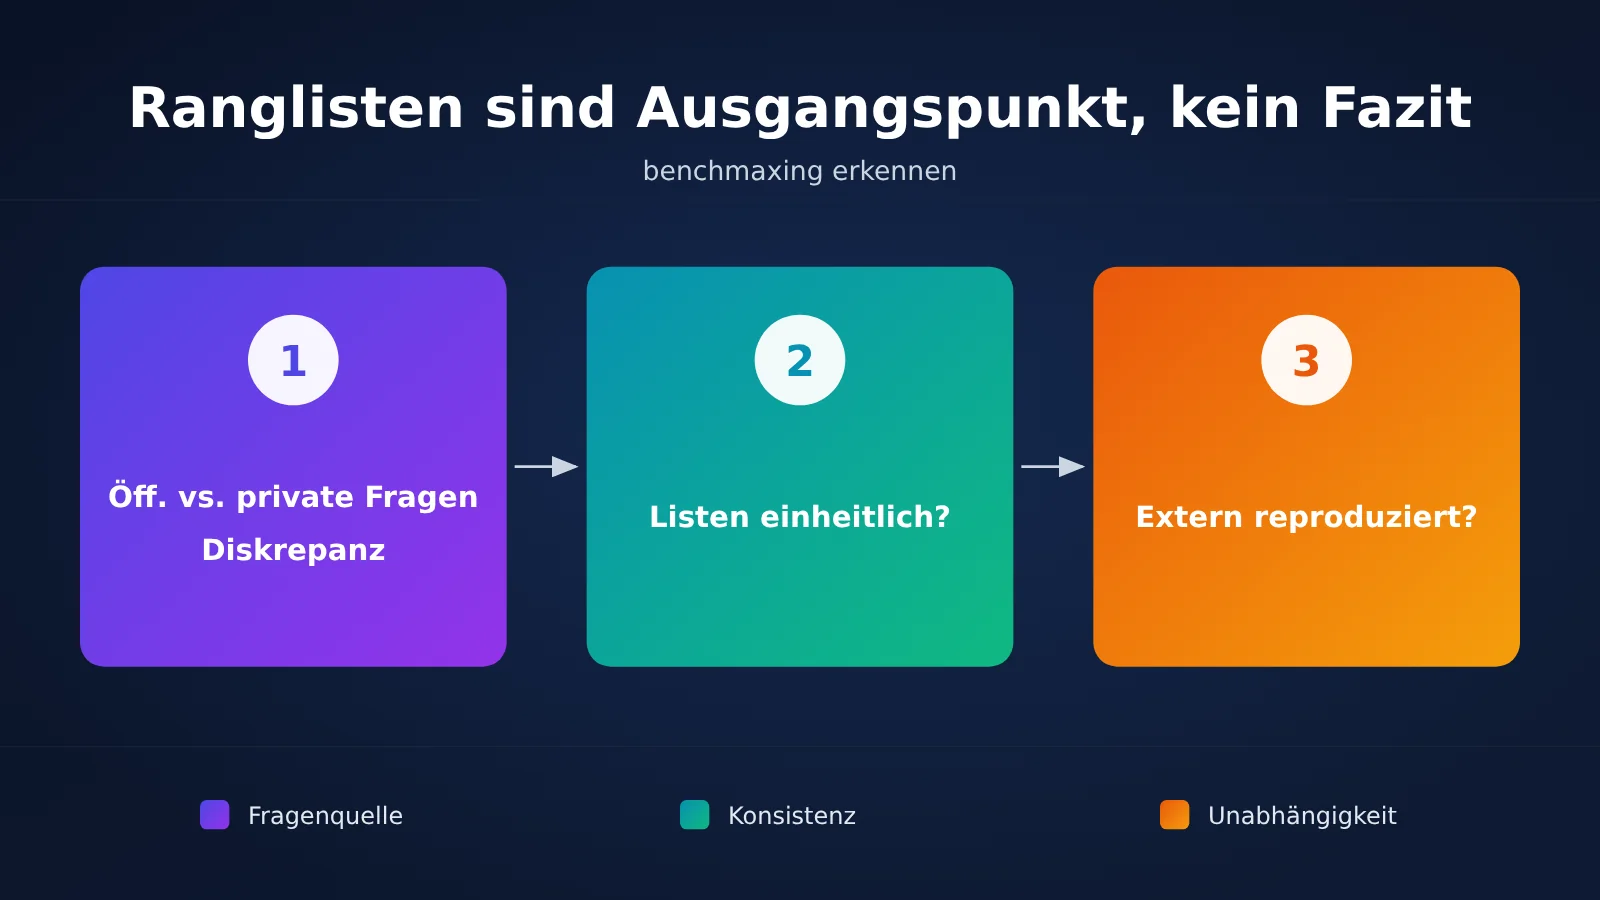
Unabhängige Evaluierungsstellen setzen auf eine einfache Gegenmaßnahme: Sie veröffentlichen die Aufgaben nicht. Sind die Aufgaben nie öffentlich zugänglich, kann niemand gezielt darauf trainieren. Laut MindStudio sind Einrichtungen wie Artificial Analysis bereits zu privaten Aufgaben übergegangen. Die Abweichung zwischen Ergebnissen bei öffentlichen und neuen privaten Aufgaben derselben Fähigkeitskategorie gilt als eines der aussagekräftigsten Signale für Benchmaxing.
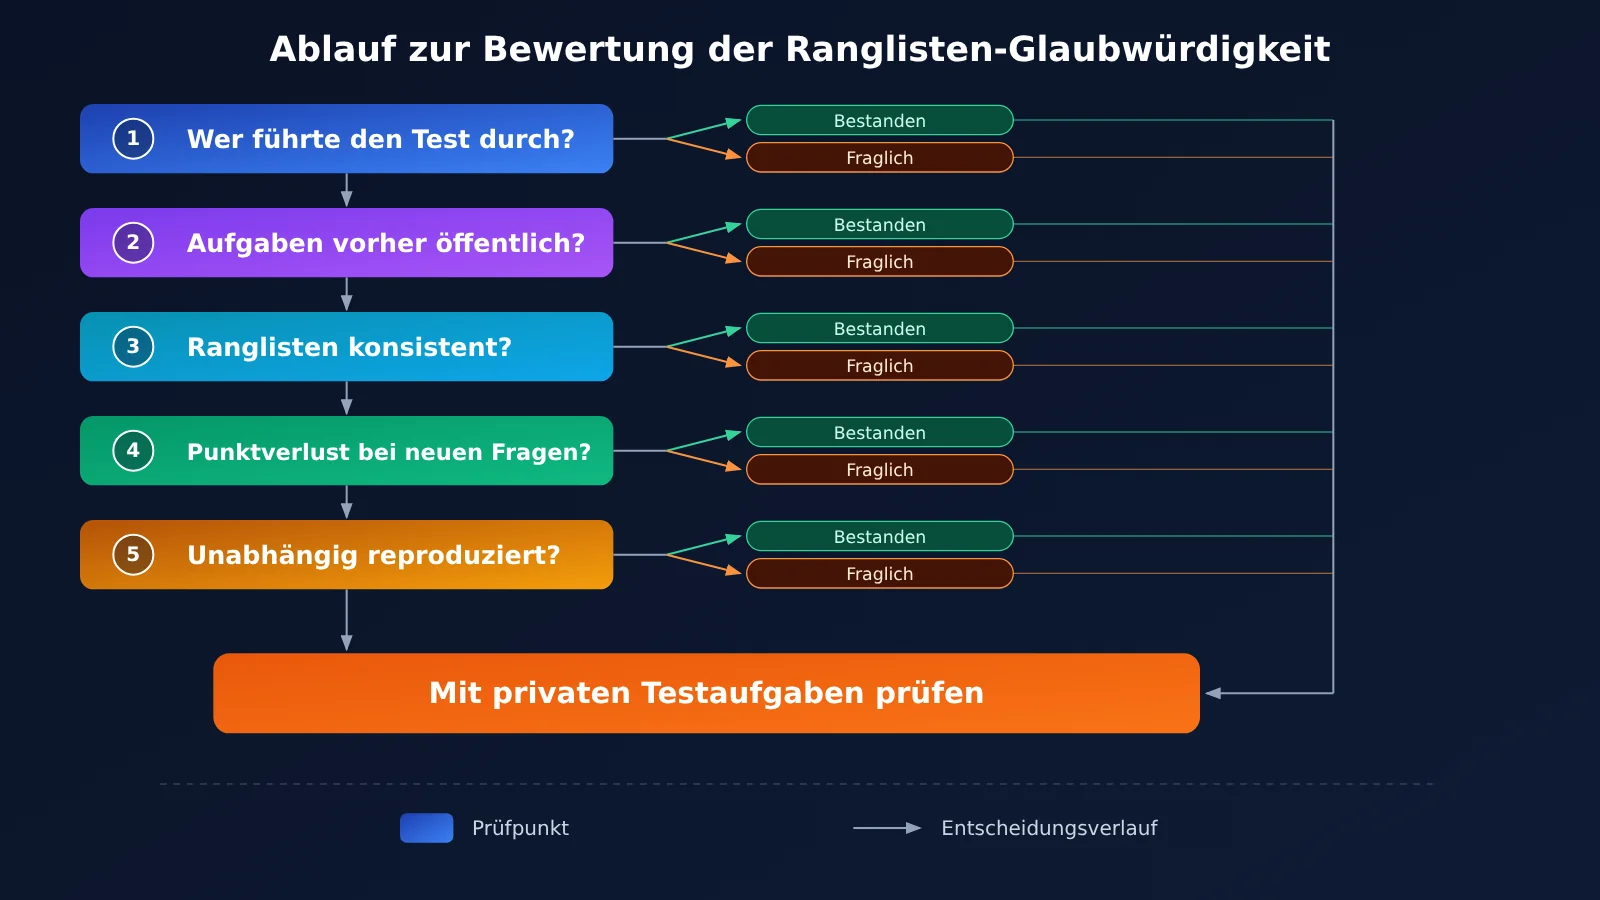
Aus den Empfehlungen des Originalartikels lässt sich die folgende Checkliste mit fünf Punkten ableiten:
| Nr. | Prüfpunkt | So prüfen Sie es | Positives Signal | Warnsignal |
|---|---|---|---|---|
| 1 | Wer hat den Test durchgeführt? | Prüfen, ob das Ergebnis aus einem technischen Bericht des Herstellers oder von einer unabhängigen Evaluierungsseite stammt | Unabhängige Durchführung durch Dritte | Nur Herstellerangaben |
| 2 | Waren die Aufgaben öffentlich? | Prüfen, ob der Benchmark vor dem Stichtag der Trainingsdaten des Modells veröffentlicht wurde | Private Aufgaben oder erst nach dem Training veröffentlichte Aufgaben | Seit Jahren öffentlich verfügbare Aufgaben |
| 3 | Sind die Ergebnisse über mehrere Ranglisten hinweg konsistent? | Mehrere Benchmarks etwa für logisches Schlussfolgern, Programmieren und Mathematik vergleichen | Ähnliche Platzierungen auf verschiedenen Ranglisten | Auffällig gutes Ergebnis auf nur einer Rangliste |
| 4 | Sinkt die Punktzahl bei anderen Aufgaben für dieselbe Fähigkeit? | Öffentliche und private Datensätze sowie Originalaufgaben und umformulierte Aufgaben vergleichen | Nur geringer Unterschied nach Aufgabenwechsel | Deutlicher Rückgang nach Aufgabenwechsel |
| 5 | Gibt es Reproduktionen durch Dritte? | Nach unabhängigen Reproduktionsberichten suchen und die Evaluierungseinstellungen prüfen | Reproduktion durch mehrere Stellen, transparente Einstellungen | Nicht reproduzierbar oder Einstellungen nicht öffentlich |
Warum ein Gesamtindex schwerer zu manipulieren ist
Der Originalartikel sieht den Wert des Artificial Analysis Index darin, dass er verschiedene Testarten zu einer Punktzahl zusammenfasst. Ein Modell kann zwar auf einen einzelnen Test überangepasst werden. Deutlich schwieriger ist es aber, gleichzeitig Tests für logisches Schlussfolgern, Programmieren, Naturwissenschaften und Mathematik zu optimieren – zumal einige Aufgaben nicht öffentlich sind. Deshalb kann Punkt 3, die Konsistenz über mehrere Ranglisten hinweg, stärker gewichtet werden.
Eigene Aufgaben evaluieren: In vier Schritten zum privaten Aufgabensatz
So sauber eine Bestenliste auch ist: Sie prüft immer die Aufgaben anderer. Für die endgültige Modellauswahl brauchen Sie einen eigenen privaten Aufgabensatz. Der entscheidende Vorteil: Kein KI-Labor hat diese Aufgaben jemals gesehen.
| Schritt | Was ist zu tun? | Konkretes Vorgehen | Ergebnis |
|---|---|---|---|
| ① Beispiele sammeln | Aufgaben aus dem realen Betrieb auswählen | Echte Support-Tickets, Fehlerfälle aus Produktionslogs und Dialoge zu Kundenbeschwerden sammeln; nach Aufgabentyp gruppieren und mit 20–50 Beispielen pro Kategorie beginnen | Rohdatensatz mit Labels |
| ② Abnahmekriterien festlegen | Definieren, was als „gut genug“ gilt | Wenn möglich, eindeutig prüfbare Ausgaben verwenden, etwa JSON-Felder, Klassifizierungslabels oder bestandene Unit-Tests; offene Antworten anhand eines Bewertungsrasters beurteilen und einen festen Anteil manuell prüfen | Bewertungsskript und Bewertungsraster |
| ③ Mehrere Modelle testen | Modelle unter gleichen Bedingungen vergleichen | Dieselbe Eingabeaufforderung, dieselben Parameter und dieselbe bewertende Person oder dieselben Bewertungsregeln verwenden; Punktzahl, Latenz und Tokenverbrauch erfassen | Vergleichstabelle |
| ④ Regelmäßig aktualisieren | Verhindern, dass der Aufgabensatz zum nächsten Übungstest wird | Monatlich neue Fehlerfälle ergänzen und Aufgaben entfernen, bei denen alle Modelle die volle Punktzahl erreichen; einen Teil als Hold-out-Set zurückhalten und nicht zur Parameteroptimierung verwenden | Versionierter Aufgabensatz |
Auswahl und Abnahmekriterien für einen eigenen Testsatz
Bei der Auswahl sind fehlgeschlagene Fälle wertvoller als erfolgreiche. Gespräche, in denen Nutzer nachfragen mussten, ein Mensch übernehmen musste oder die schlecht bewertet wurden, zeigen die Unterschiede zwischen den Modellen besonders deutlich. Die Abnahmekriterien sollten vor dem Test feststehen – sonst ist die Versuchung groß, sie nachträglich an die Ergebnisse anzupassen.
Was „ausreichend“ bedeutet, sollte sich in Zahlen ausdrücken lassen. Zum Beispiel: „Die Genauigkeit bei der strukturierten Extraktion von Feldern erreicht einen bestimmten Schwellenwert“ oder „Bei einer manuellen Stichprobe der Kundenservice-Antworten werden keine sachlichen Fehler gefunden“. Wie groß die Stichprobe ausfällt, hängt vom Risiko ab: Bei risikoreichen Anwendungen kann sie größer sein, bei risikoarmen Aufgaben steht die automatische Bewertung im Vordergrund.
Wie sich Variablen beim Modellvergleich kontrollieren lassen
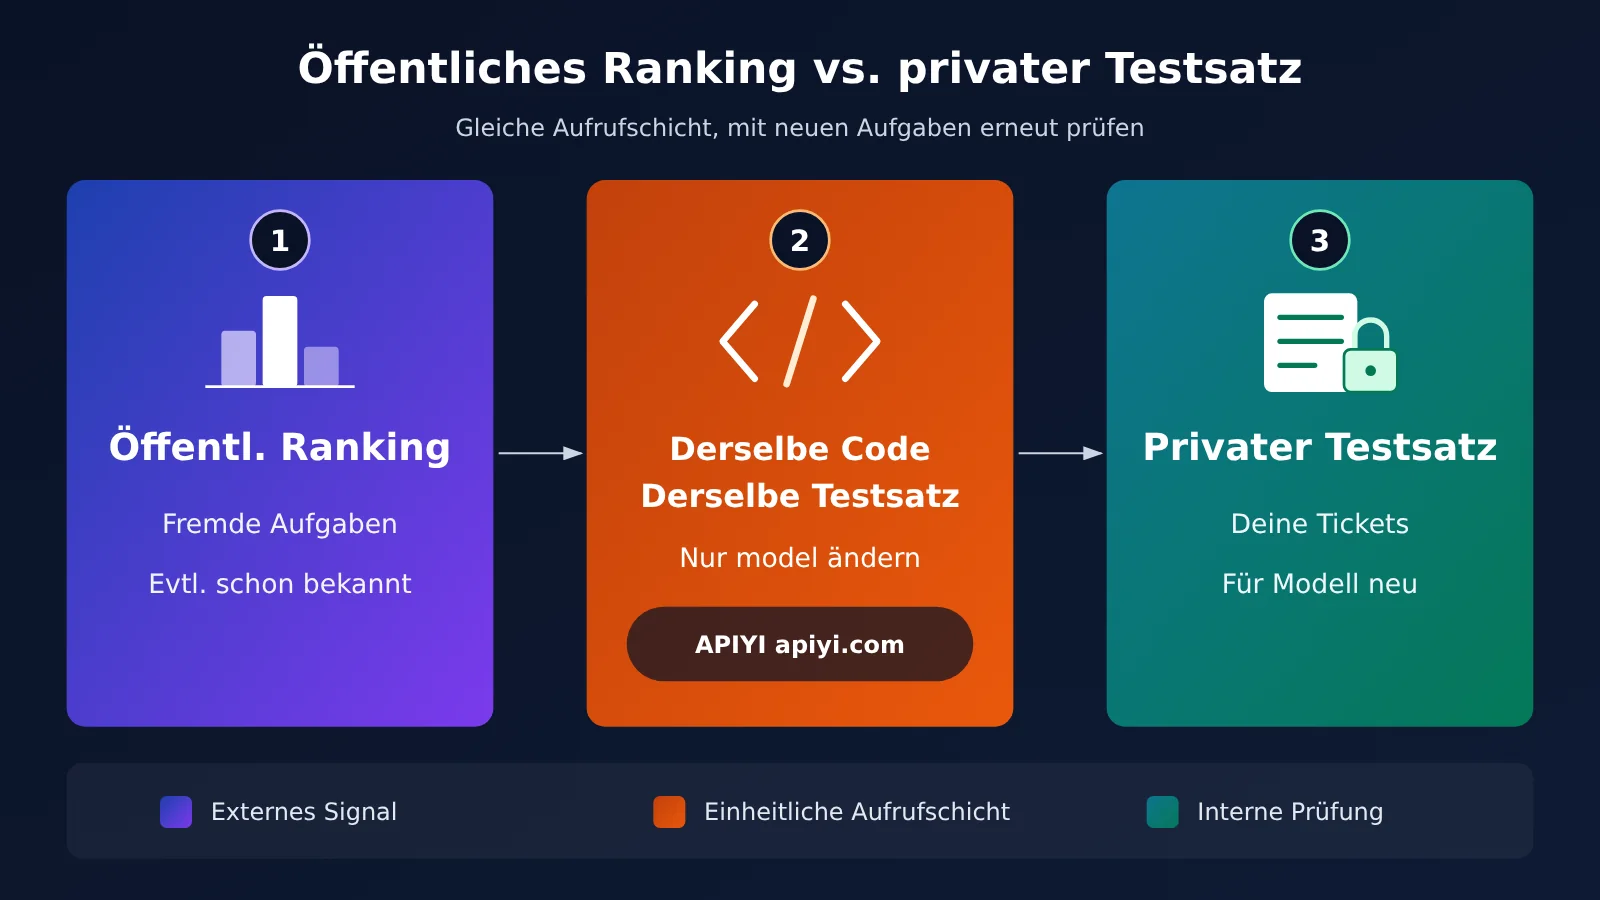
Ein häufiges Problem beim direkten Vergleich: Die Bedingungen sind nicht gleich. Für Modell A wird eine sorgfältig optimierte Eingabeaufforderung verwendet, für Modell B eine Standardformulierung. Besser ist es, denselben Code und denselben Testsatz zu verwenden und nur den Modellnamen auszutauschen.
Stammen die Kandidaten von verschiedenen Anbietern, kann die Pflege mehrerer SDKs aufwendig werden. APIYI ist mit dem OpenAI-Format kompatibel: Mit einem Token lassen sich Modelle verschiedener Anbieter aufrufen. Beim Wechsel wird nur der Parameter model geändert. So lässt sich derselbe Testsatz mit einem einzigen Evaluierungsskript ausführen. Die Konfiguration im Überblick:
- Offizielles Python-SDK von OpenAI: Bei der Initialisierung des Clients
base_urlaufhttps://api.apiyi.com/v1setzen und unterapi_keyden Plattform-Token eintragen - Modellwechsel in der Evaluierungsschleife: Nur das Feld
modeländern; die Modellnamen stehen in der Modellliste von APIYI auf apiyi.com - Sampling-Parameter festlegen: Für alle Modelle
temperature=0und denselben Wert fürmax_tokenssetzen, um den Einfluss des Zufalls zu verringern - Verbrauch erfassen: Das Feld
usagein der Antwort auslesen und den Token-Verbrauch jedes Modells für den gesamten Testsatz zusammenfassen
🚀 Schnellstart: Wählen Sie zunächst 3–4 Modelle aus, die in den Bestenlisten weit oben stehen und die fünf oben genannten Prüfungen bestanden haben. Rufen Sie sie über APIYI auf apiyi.com nacheinander mit demselben Token auf. So erhalten Sie an einem Nachmittag erste Vergleichsergebnisse für 50 echte Support-Tickets.
Vermeiden Sie, selbst auf Ihren Testkatalog zu optimieren
Auch der eigene Testkatalog kann zum Ziel von Benchmaxing werden. Wenn Sie die Eingabeaufforderung so lange anpassen, bis ein Modell bei genau diesen 50 Aufgaben die volle Punktzahl erreicht, unterscheidet sich das im Kern nicht vom Optimieren auf Bestenlisten. Dagegen helfen einige Maßnahmen:
- Testsatz zurückhalten: Sperren Sie etwa ein Drittel der Aufgaben. Nutzen Sie für die Anpassung nur den Entwicklungssatz und treffen Sie die endgültige Entscheidung anhand des zurückgehaltenen Testsatzes.
- Eingabeaufforderung einfrieren: Sobald der offizielle Vergleich beginnt, wird die Eingabeaufforderung unter einer Versionsnummer eingefroren. Bei jeder Änderung werden alle Modelle erneut getestet.
- Neue Aufgaben aufnehmen: Ergänzen Sie den Testkatalog bei jeder Aktualisierung um aktuelle Fälle, in denen Modelle gescheitert sind. So entwickelt er sich mit den Anforderungen Ihres Geschäfts weiter.
Wann Sie nicht nur auf Bestenlisten schauen sollten
Selbst wenn die Punktzahlen einer Bestenliste vollständig verlässlich sind, erfassen sie möglicherweise nicht das, worauf es Ihnen ankommt. In den folgenden Fällen sind Bestenlisten höchstens eine Orientierung:
| Szenario | Warum die Bestenliste nicht ausreicht | Ergänzende Tests |
|---|---|---|
| Spezialisierte Nischenaufgaben | Branchenbegriffe, interne Formate und weniger verbreitete Sprachen kommen in allgemeinen Benchmarks selten vor | Ein privater Testkatalog aus echten Geschäftsdaten |
| Tool-Aufrufe und Agents | Die Zuverlässigkeit mehrstufiger Aufrufe und die korrekte Formatierung von Parametern lassen sich mit einzelnen Fragen und Antworten nicht messen | Erfolgsquote bei Ende-zu-Ende-Aufgaben und Formatfehlerquote bei Funktionsaufrufen |
| Kosten und Latenz | Bestenlisten bewerten nur die Fähigkeiten, nicht die Kosten pro Anfrage oder die Zeit bis zum ersten Token | Token-Verbrauch und Antwortzeit für die Aufgaben im Testkatalog erfassen |
| Stabilität | Ein einzelner Testlauf zeigt keine Schwankungen im laufenden Betrieb | Dieselben Aufgaben mehrfach ausführen und die Konsistenz der Ergebnisse prüfen |
Eine praktische Faustregel: Sobald die Fähigkeiten ausreichen, zählen vor allem Preis-Leistungs-Verhältnis und Stabilität. Das erst- und das drittplatzierte Modell einer Bestenliste erfüllen in Ihrem Testkatalog möglicherweise beide die Anforderungen. Dann ist das Modell mit geringerer Latenz und besser kalkulierbaren Kosten oft die passendere Wahl. Über den einheitlichen Zugang von APIYI unter apiyi.com können Sie Fähigkeiten, Antwortzeit und Verbrauch nebeneinander in einer Ergebnistabelle vergleichen.
Häufige Fragen (FAQ)
F1: Ist Benchmaxing gleichbedeutend mit Schummeln?
Nein. Aufgaben können durch Webcrawler unbeabsichtigt in die Trainingsdaten gelangen. Auch bei der Optimierung auf bestimmte Aufgabentypen kann das Team überzeugt sein, damit die Schlussfolgerungsfähigkeit zu verbessern. Entscheidend ist, ob die Ergebnisse bei neuen Aufgaben stabil bleiben – über die Motive lässt sich daraus nichts ableiten.
F2: Wann sind Ranglisten-Ergebnisse weiterhin zuverlässig?
Die Ergebnisse sind weiterhin aussagekräftig, wenn die Aufgaben nicht öffentlich sind oder erst nach dem Stichtag der Trainingsdaten erschienen, die Tests unabhängig von Dritten durchgeführt wurden, mehrere Ranglisten zu ähnlichen Ergebnissen kommen und diese reproduziert wurden. Ein Index, der verschiedene Tests zusammenfasst, lässt sich schwerer gezielt verbessern als ein einzelner Benchmark.
F3: Wie viele Aufgaben braucht eine private Testsammlung mindestens?
Dafür gibt es keinen einheitlichen Standard. Erfahrungsgemäss reichen zunächst 20–50 echte Beispiele pro Aufgabentyp, um deutliche Unterschiede zu erkennen. Sind die Unterschiede gering, können Sie weitere Aufgaben hinzufügen und dabei einen separaten Testsatz zurückhalten.
F4: Wie lassen sich Modelle verschiedener Anbieter mit demselben Code vergleichen?
Am einfachsten geht das über eine OpenAI-kompatible Schnittstelle. Nachdem Sie über APIYI auf apiyi.com ein Token bezogen haben, setzen Sie `base_url` auf die Plattformadresse und ändern in der Schleife nur den Parameter `model`. So können Sie die Modelle mit derselben Aufgabensammlung direkt vergleichen. Welche Modelle verfügbar sind, entnehmen Sie der Modellliste der Plattform.
F5: Erreicht Grok 5 bei Humanity’s Last Exam nahezu die volle Punktzahl?
Zum Zeitpunkt dieses Artikels ist das eine öffentliche Prognose von Elon Musk, kein Testergebnis. Sollte dieser Wert künftig tatsächlich erreicht werden, empfiehlt sich eine Prüfung anhand der 5-Punkte-Checkliste – insbesondere der Leistung bei neuen, nicht öffentlichen Aufgaben, die dieselbe Fähigkeit testen. Prüfen Sie zusätzlich mit einer eigenen Aufgabensammlung über APIYI auf apiyi.com, ob sich das Modell für Ihren Anwendungsfall eignet.
Benchmaxing und Tests mit eigenen Aufgaben: Das Wichtigste
- Definition: Benchmaxing bedeutet, gezielt auf bekannte Testaufgaben zu optimieren. Dadurch fallen die Ergebnisse auf Bestenlisten besser aus, als es den tatsächlichen Fähigkeiten entspricht.
- Ursachen: Testaufgaben gelangen in Trainingsdaten, Modelle werden auf bestimmte Aufgabentypen feinabgestimmt oder öffentliche Aufgaben kursieren über längere Zeit. Keine dieser Ursachen setzt böse Absicht voraus.
- Das wichtigste Warnsignal: Die Punktzahl sinkt, wenn dieselbe Fähigkeit mit neuen Aufgaben geprüft wird.
- 5 Prüffragen: Wer hat den Test durchgeführt? Waren die Aufgaben öffentlich zugänglich? Sind die Ergebnisse über mehrere Bestenlisten hinweg konsistent? Sinkt die Punktzahl bei neuen Aufgaben? Gibt es eine unabhängige Reproduktion?
- Eigener Aufgabensatz in 4 Schritten: Beispiele auswählen, Abnahmekriterien festlegen, mehrere Modelle testen und den Aufgabensatz regelmäßig aktualisieren. Ein zurückgehaltener Testsatz schützt vor Überanpassung an die eigenen Aufgaben.
- Einheitlicher Modellaufruf: Über die OpenAI-kompatible Schnittstelle von APIYI apiyi.com lässt sich das Modell durch Ändern des Parameters
modelwechseln.
Fazit: Bestenlisten sind ein Ausgangspunkt, kein Ergebnis
Sie können heute mit drei Dingen anfangen. Erstens: Gehen Sie die Bestenlisten, die für Sie relevant sind, anhand der fünf Prüffragen durch und halten Sie jeweils die Art der Fakten und das Datum der Quelle fest. Zweitens: Wählen Sie 50 fehlgeschlagene Fälle aus den Logs des letzten Monats aus und legen Sie die Abnahmekriterien fest, bevor Sie die Modelle testen. Drittens: Testen Sie 3–4 Modellkandidaten mit demselben Code und denselben Parametern. Erfassen Sie dabei Ergebnisse, Latenz und Verbrauch.
Für den direkten Vergleich mehrerer Modelle können Sie über APIYI apiyi.com ein einziges Token verwenden. Aktualisieren Sie den Aufgabensatz anschließend einmal im Monat. Ihre Modellwahl sollte auf Ihren eigenen Aufgaben beruhen – nicht auf den Testfragen anderer.
📚 Quellen
- MindStudio: What Is Benchmaxing? Why AI Labs Are Hiding Test Questions(2026-11-01)
- Link:
mindstudio.ai/blog/ai-benchmark-maxing-private-tests -
Inhalt: Definition und Ursachen von Benchmaxing, der Trend zu nicht öffentlichen Testfragen sowie die einzige Quelle für die im Artikel genannten Daten zu Gemini und Grok
-
Offizielle Website von Artificial Analysis: unabhängige Modellbewertungen und Gesamtindizes
- Link:
artificialanalysis.ai - Hinweis: Für Zeitpunkt und Umfang des Umstiegs auf nicht öffentliche Testfragen sind die offiziellen Angaben massgeblich.
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns über die Startseite von APIYI unter apiyi.com. Weitere Informationen zur Integration finden Sie im Dokumentationszentrum unter docs.apiyi.com.