Hinweis des Autors: Die angekündigten Fähigkeiten von Gemini 4 Neon, GPT-6.2 Astra und Claude Fable 5.2, die APIYI-Katalogpreise und die Aufruf-Endpunkte werden in drei getrennten Spalten geprüft. So kannst du bei der Auswahl danach entscheiden, ob Reasoning-Tiefe, Coding-Agenten oder der Langkontext-Preis pro Einheit für dich wichtiger sind.
Im November 2026 haben drei Anbieter innerhalb von zehn Tagen nacheinander neue Modelle veröffentlicht: Anthropic brachte am 9. November Claude Fable 5.2 heraus, Google kündigte am 18. November Gemini 4 Neon an, und GPT-6.2 Astra ist ebenfalls in der Gesamtpreisliste von APIYI aufgetaucht. Der häufigste Fehler bei der Auswahl besteht darin, die Ranglisten der drei Anbieter, die Preise der drei Anbieter und drei unterschiedliche Schnittstellen zu einer einzigen Schlussfolgerung darüber zu vermischen, welches Angebot am günstigsten ist.
Dieser Artikel ist keine Rangliste. Die Ranglisten stammen aus unterschiedlichen Quellen, die Preistarife sind unterschiedlich und auch die Endpunktformate unterscheiden sich. Sie zwanghaft auf einen einzigen Score herunterzubrechen, führt nur zu falschen Entscheidungen. Dieser Artikel prüft die drei Modelle in drei getrennten Spalten: die offiziell oder in Ankündigungen genannten Leistungsdaten, den APIYI-Katalogpreis auf apiyi.com (geprüft am 2026-11-20) und den Endpunkt, den jedes Modell verwenden sollte.
Der Kernnutzen: Nach dem Lesen dieses Artikels kannst du selbst entscheiden, welches Modell du zuerst testen solltest – je nachdem, ob dir bei dieser konkreten Aufgabe Reasoning-Tiefe, Coding-Agenten oder der Langkontext-Preis pro Einheit wichtiger ist – und du weißt, über welche Schnittstelle jedes Modell aufgerufen wird.
Die Kernpunkte von Gemini 4 Neon, GPT-6.2 Astra und Claude Fable 5.2
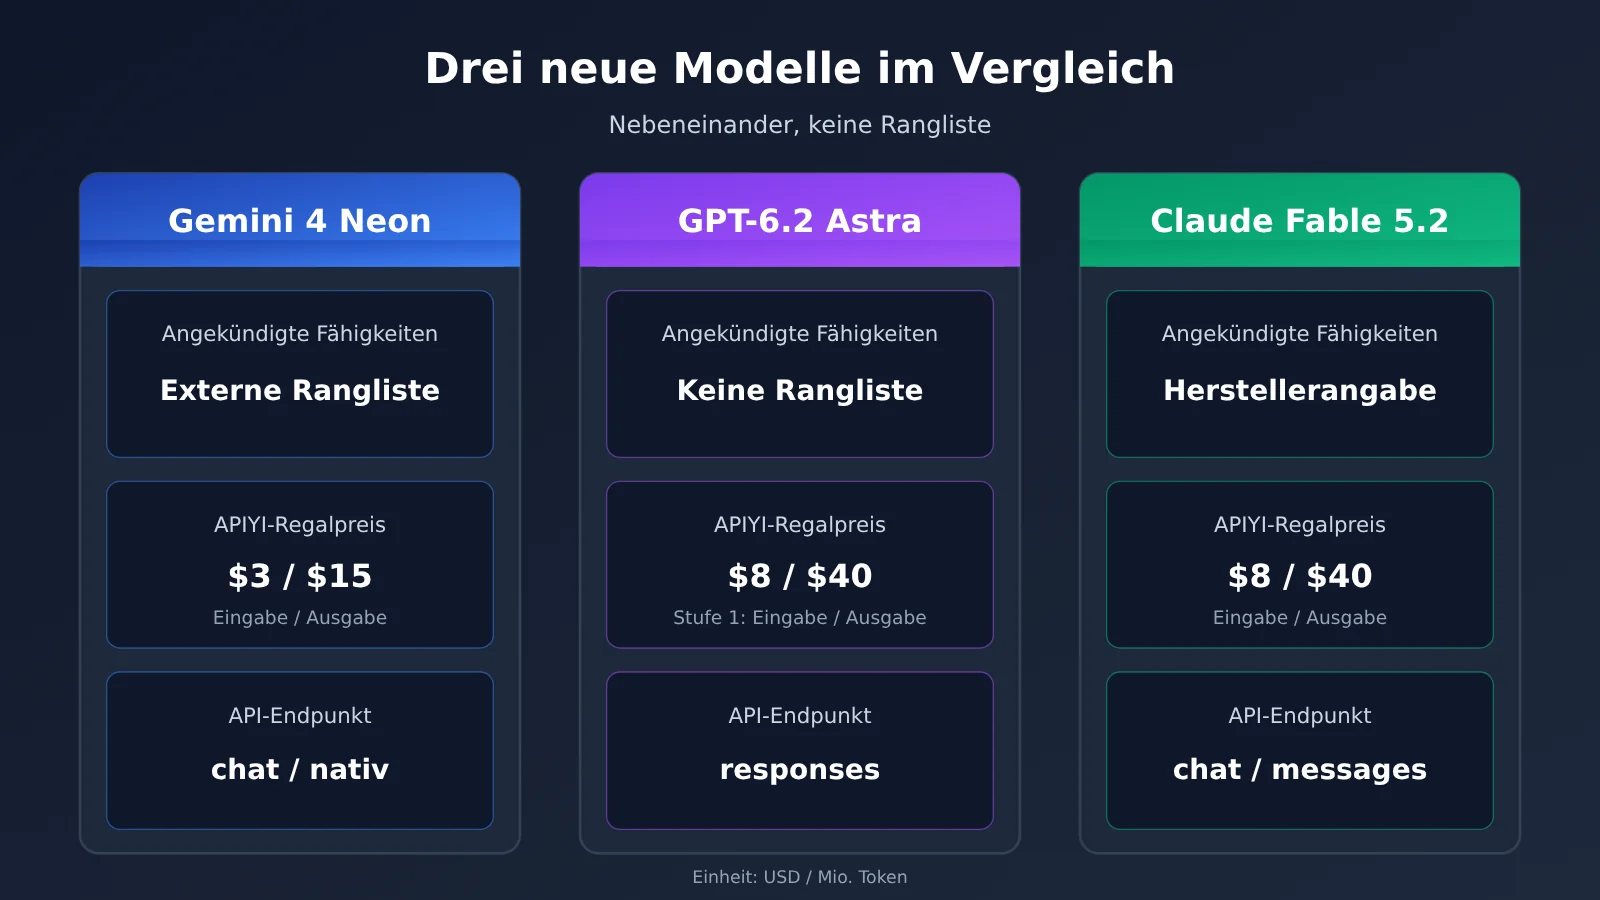
Zuerst eine Tabelle zum Schnelllesen. Die drei Zeilen stammen aus drei unterschiedlichen Arten von Quellen; die Tabelle stellt sie nur nebeneinander, sie addiert sie nicht über die Spalten hinweg.
| Dimension | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| Datenquelle der Leistungsangaben | Drittanbieter-Rankings, die Google in der Ankündigung zitiert (Artificial Analysis, Vals) | Die Referenzmaterialien enthalten keine Ranking-Zahlen aus der Ankündigung | Anthropic-Ankündigung, wiedergegeben im APIYI-Changelog (FrontierCode 2.0 usw.) |
| APIYI-Listenpreis (USD pro Million Token) | Eingabe 3, Cache-Lesen 0.15, Ausgabe 15 |
Erste Stufe Eingabe 8, Cache-Lesen 0.4, Ausgabe 40, für lange Kontexte gibt es eine weitere Stufe |
Eingabe 8, Cache-Lesen 0.2, Ausgabe 40 |
| Empfohlener Endpunkt | chat oder natives Gemini-Format | responses (empfohlen), chat wird ebenfalls unterstützt | chat oder messages |
| Kontext | 1 Million Token | 272000 Token als Grenze der Preisstufe | 1M Kontext, maximal 128K Ausgabe |
Die Prüfpunkte der drei Modelle im Detail
In der Spalte „Leistung“ sind die drei Modelle nicht auf derselben Basis gemessen. Die Daten von Gemini 4 Neon sind Drittanbieter-Rankings, die Google in seiner Ankündigung zitiert; die Daten von Claude Fable 5.2 sind Anthropic-Veröffentlichungen, wiedergegeben im APIYI-Changelog; für GPT-6.2 Astra gibt es in diesem Referenzmaterial keine entsprechenden Ranking-Zahlen. Unterschiedliche Rankings, unterschiedliche Testsets – man kann den Vals-Index-Prozentwert von Neon nicht mit dem FrontierCode-Prozentwert von Fable auf derselben Achse vergleichen.
Die Preisspalte wirkt am anschaulichsten, aber auch hier darf man nicht nur die Zahlen vergleichen. Die Cache-Lesepreise, die Stufen für lange Kontexte und die Abrechnung im Thinking-Modus unterscheiden sich bei allen drei Modellen; was eine Aufgabe tatsächlich kostet, hängt vom Verhältnis von Eingabe zu Ausgabe, von der Cache-Trefferrate und davon ab, ob die Stufengrenze überschritten wird. Die Endpunkt-Spalte wiederum entscheidet direkt darüber, wie der Code geschrieben wird – ein falscher Endpunkt führt zu inkompatiblen Parametern oder fehlenden Funktionen.
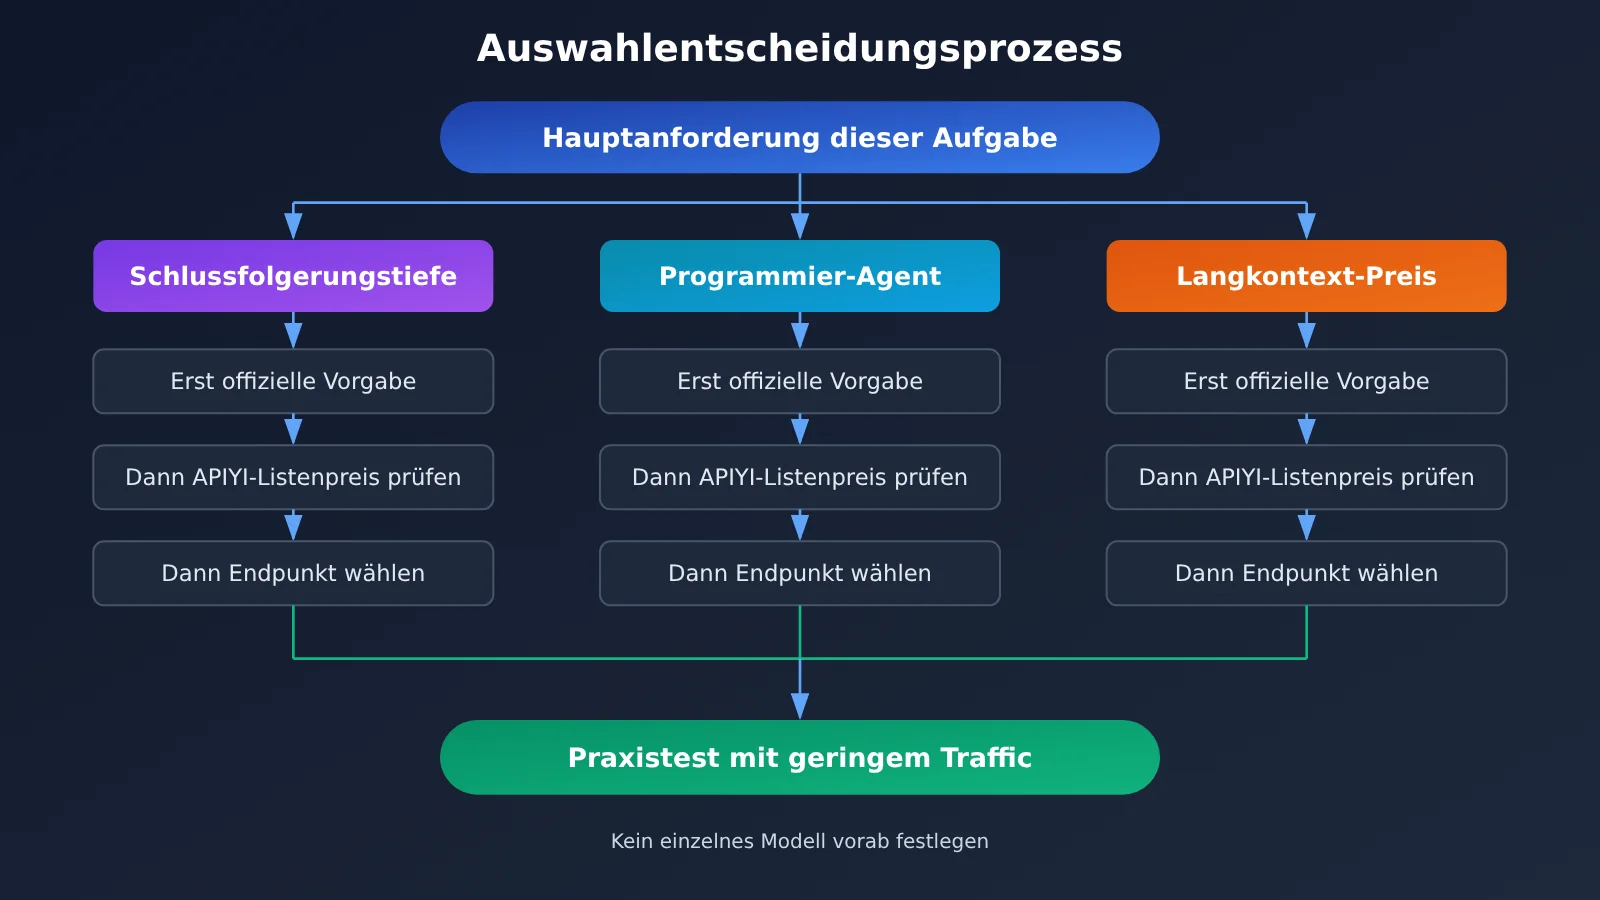
Leistungsunterschiede von Gemini 4 Neon, GPT-6.2 Astra und Claude Fable 5.2 (zitierte Herstellerangaben)
Dieser Abschnitt fasst ausschließlich Fähigkeitsinformationen zusammen, die in Herstellerankündigungen oder in Wiedergaben davon auftauchen. Keine der folgenden Angaben stammt aus eigenen Messungen von APIYI – bitte beim Zitieren die Quellenangabe beibehalten.
| Modell | Datenpunkt | Wert | Art der Quelle |
|---|---|---|---|
| Gemini 4 Neon | Artificial Analysis Intelligence Index (xhigh) | 61, Gesamtrang 3 | Von Google in der Ankündigung zitierte Dritt-Rangliste |
| Gemini 4 Neon | Vals Index | Rang 2, 70,9 % | Von Google in der Ankündigung zitierte Dritt-Rangliste |
| Claude Fable 5.2 | FrontierCode 2.0 | von 32,4 % auf 49,1 % gesteigert | Wiedergabe der Ankündigung (APIYI-Changelog) |
| Claude Fable 5.2 | Generierungsgeschwindigkeit | bis zu 30 % schneller | Wiedergabe der Ankündigung (APIYI-Changelog) |
| GPT-6.2 Astra | Öffentliche Ranglisten | in den Referenzmaterialien nicht angegeben | — |
Wie die Reasoning-Ranglisten von Gemini 4 Neon zu lesen sind
In der Ankündigung von Google vom 18.11.2026 werden 61 Punkte im Artificial Analysis Intelligence Index auf der Stufe xhigh und Gesamtrang 3 genannt, außerdem Rang 2 im Vals Index mit einem Score von 70,9 %. Beide sind übergreifende Indizes, die vor allem allgemeines Reasoning und Wissensaufgaben messen. Zu beachten ist, dass xhigh die höchste Reasoning-Intensitätsstufe ist – die Leistung bei alltäglichen Aufrufen mit niedrigeren Stufen muss nicht mit diesem Wert übereinstimmen.
Wie die Coding-Daten von Claude Fable 5.2 zu lesen sind
Der Kernwert für Claude Fable 5.2 ist die Steigerung bei FrontierCode 2.0 von 32,4 % in der vorherigen Generation auf 49,1 % – ein Benchmark, der auf Coding-Aufgaben ausgerichtet ist. Gleichzeitig nennt die Ankündigung eine bis zu 30 % schnellere Generierung, zusammen mit einem Kontextfenster von 1M und maximal 128K Ausgabe. Das passt eher zu Coding-Agent-Szenarien, die lange Codebasis-Eingaben und lange Patch-Ausgaben benötigen. FrontierCode und Vals messen unterschiedliche Fähigkeiten; zwischen den beiden Zahlenreihen gibt es keine Umrechnungsbeziehung.
Wie die Fähigkeiten von GPT-6.2 Astra zu prüfen sind
Die diesbezüglichen Referenzmaterialien enthalten keine Ranglistendaten aus Ankündigungen zu GPT-6.2 Astra, daher bleibt diese Zelle leer und es wird nichts vermutet. Wenn Ihre Aufgabe klare Anforderungen an die Fähigkeiten von Astra stellt, ist es der solidere Weg, mit eigenen Geschäftsbeispielen einen kleinen Vergleichstest mit geringem Traffic durchzuführen, statt Ranglisten anderer Modelle analog zu übertragen.
Preisüberprüfung für Gemini 4 Neon, GPT-6.2 Astra und Claude Fable 5.2 (APIYI-Regalpreise)
Die Preise in diesem Abschnitt wurden am 2026-11-20 bei APIYI apiyi.com überprüft. Es gibt zwei Quellen: die Modell-Gesamtübersicht (aktualisierte Fassung vom 2026-11-19 10:59 UTC+8) und die Preis-API (Version shell-api-modelmak-v1). Alle Einheiten sind US-Dollar pro Million Token.
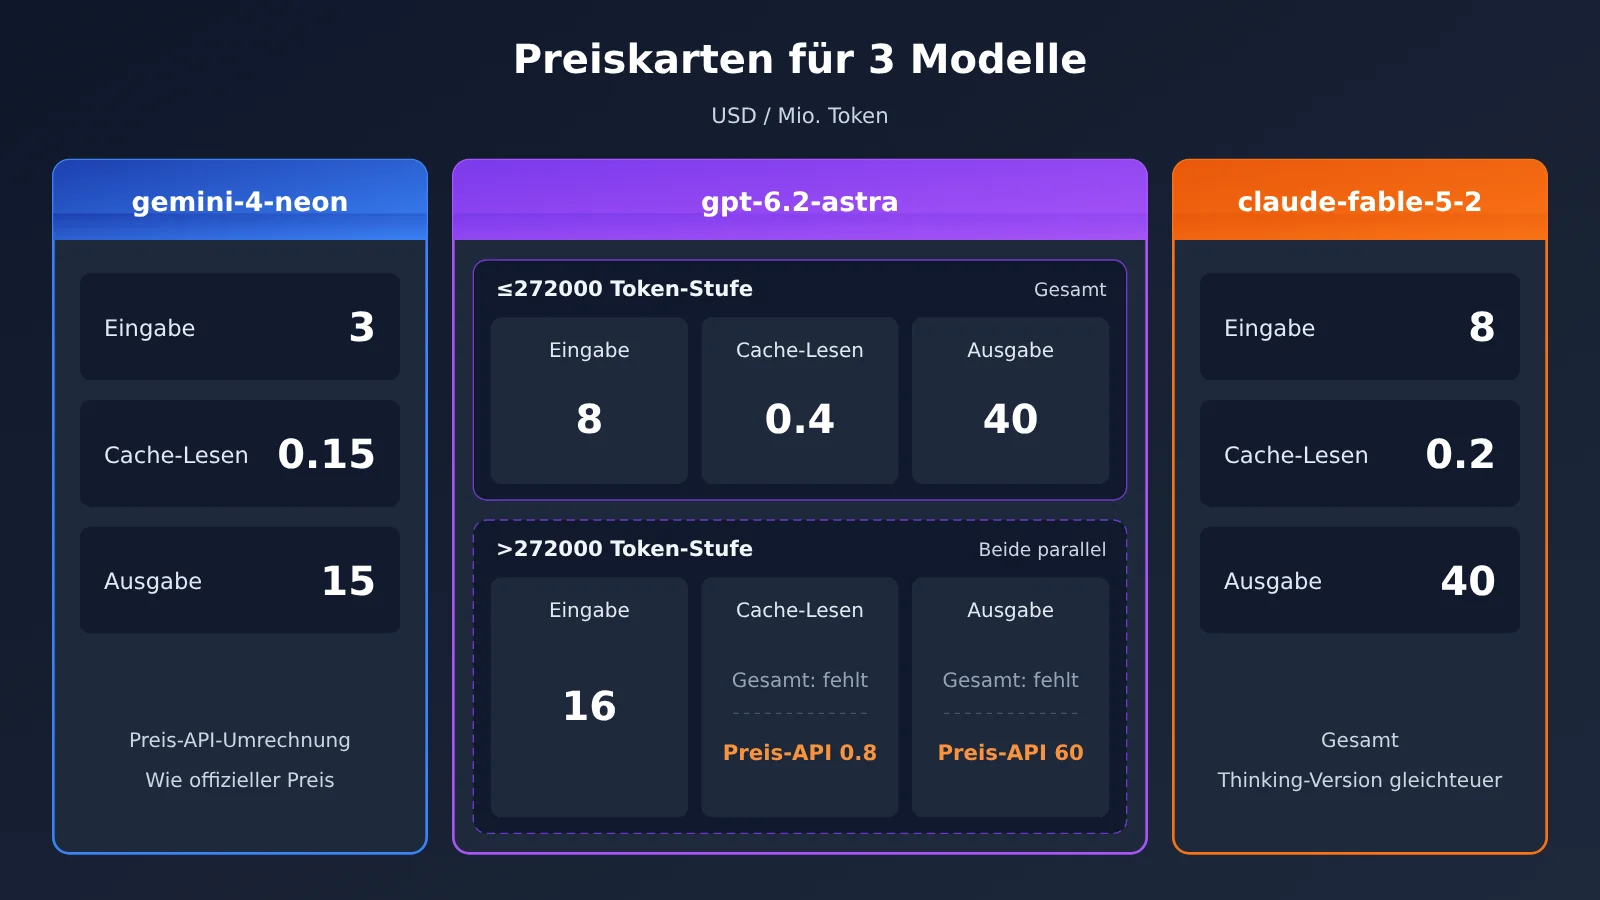
| Modell-ID | Eingabe | Cache-Lesen | Ausgabe | Datenquelle |
|---|---|---|---|---|
gemini-4-neon |
3 |
0.15 |
15 |
Über die Preis-API umgerechnet, identisch mit dem von Google offiziell angegebenen Preis |
gpt-6.2-astra (erste Stufe) |
8 |
0.4 |
40 |
Gesamtübersicht |
gpt-6.2-astra (>272000 Token) |
16 |
In der Gesamtübersicht nicht angegeben / Preis-API 0.8 |
In der Gesamtübersicht nicht angegeben / Preis-API 60 |
Gesamtübersicht und Preis-API nebeneinander |
claude-fable-5-2 |
8 |
0.2 |
40 |
Gesamtübersicht |
claude-fable-5-2-thinking |
8 |
0.2 |
40 |
Gesamtübersicht |
Wie die Multiplikatoren der Preis-API in US-Dollar umgerechnet werden
Die Preis-API von APIYI gibt Preise über Multiplikatoren an, wobei vereinbart ist: Ein model_ratio von 1 entspricht 2 US-Dollar pro Million Token für die Eingabe. Am Beispiel von gemini-4-neon: model_ratio ist 1.5, die Eingabe kostet also 1.5 × 2 = 3; completion_ratio ist 5, die Ausgabe folglich 3 × 5 = 15; cache_ratio ist 0.05, das Lesen aus dem Cache demnach 3 × 0.05 = 0.15. Das umgerechnete Ergebnis deckt sich exakt mit dem Listenpreis, den Google am 2026-11-18 bekannt gegeben hat – zur Kontrolle können Sie diese Formel also direkt selbst anwenden.
Warum die Langkontext-Stufen von GPT-6.2 Astra an zwei Stellen stehen
GPT-6.2 Astra zieht die Stufengrenze bei 272000 Token. Die Übersichtstabelle nennt den Preis der ersten Stufe sowie 16 für die Eingabe oberhalb von 272000 Token, lässt aber den Ausgabepreis dieser Stufe offen; die Preis-API hingegen gibt an, dass oberhalb von 272000 Token die Ausgabe mit 60 und das Lesen aus dem Cache mit 0.8 berechnet wird. Beide Informationen bleiben nebeneinander stehen, und dieser Artikel fasst sie nicht zu einer einzigen Zahl zusammen. Wenn Ihre Anfragen regelmäßig die Grenze von 272000 Token überschreiten, sollten Sie sich besser an dem Ergebnis orientieren, das die Preis-API beim jeweiligen Aufruf zurückliefert.
Preisreduzierung bei Claude Fable 5.2
Laut dem APIYI-Update vom 2026-11-10 hat Anthropic die Eingabe- und Ausgabepreise für Claude Fable 5.2 auf 8 bzw. 40 festgelegt – 20 % niedriger als bei 5.1. Das Cache-Lesen liegt bei 0.2. claude-fable-5-2 und claude-fable-5-2-thinking haben in der Übersichtstabelle denselben Preis. Bei der Wahl der Thinking-Version müssen Sie den Einzelpreis also nicht separat umrechnen. Die durch den Denkprozess erzeugten Ausgabe-Tokens werden jedoch in der Nutzung ausgewiesen.
Preisreferenz innerhalb der Gemini-4-Serie
Wenn Sie innerhalb der Gemini-4-Serie abwägen, können Sie die Listenpreise der folgenden Modelle als Orientierung heranziehen. Der Preis für gemini-4-carbon entspricht Googles Einführungspreis bis 2026-11-30. Google hat bekannt gegeben, dass ab dem 1. Dezember der Standardpreis bei 4 für die Eingabe und 20 für die Ausgabe liegt. Ob der Listenpreis dann angepasst wird, entnehmen Sie bitte der Übersichtstabelle des jeweiligen Tages.
| Modell-ID | Eingabe | Cache-Lesen | Ausgabe | Hinweis |
|---|---|---|---|---|
gemini-4-carbon |
2 |
0.1 |
10 |
Entspricht Googles Einführungspreis (bis 2026-11-30) |
gemini-4-hydrogen |
1.5 |
0.075 |
7.5 |
— |
gemini-4-argon |
2 |
0.1 |
10 |
Preis in der Übersichtstabelle |
API-Endpunkte für Gemini 4 Neon, GPT-6.2 Astra und Claude Fable 5.2
Die empfohlenen Endpunkte der drei Modelle unterscheiden sich – es gibt keinen einzigen Code, der alle drei abdeckt. Einheitlich ist nur die base_url: Beim Aufruf über APIYI tragen Sie immer https://api.apiyi.com/v1 ein und wählen anschließend je nach Modell den passenden Pfad und das passende Anfrageformat.
| Modell | Empfohlener Endpunkt | Alternativer Endpunkt | Umsetzungshinweise |
|---|---|---|---|
| Gemini 4 Neon | chat (OpenAI-kompatibel /chat/completions) |
Gemini-natives Format | Projekte mit vorhandenem OpenAI-SDK nutzen chat; wenn Gemini-native Parameter benötigt werden, das native Format verwenden |
| GPT-6.2 Astra | responses (/responses) |
chat (/chat/completions) |
responses empfohlen, im Request-Body das Feld input verwenden; bei chat das Feld messages |
| Claude Fable 5.2 | chat (/chat/completions) |
messages (Anthropic-Messages-Format) | Wenn Anthropic-native Funktionen benötigt werden, messages verwenden; die Thinking-Variante über claude-fable-5-2-thinking |
Warum für GPT-6.2 Astra responses empfohlen wird
responses ist das neue Schnittstellenformat von OpenAI und bildet mehrstufige Zustände, Tool-Aufrufe und ähnliche Funktionen vollständiger ab. Deshalb wird für Astra dieser Endpunkt bevorzugt empfohlen. Der chat-Endpunkt ist weiterhin verfügbar und eignet sich für Projekte, die bereits über viel Code im chat-Format verfügen und vorerst nicht refaktorieren möchten. Die Request-Body-Felder der beiden Endpunkte unterscheiden sich – beim Migrieren also nicht nur den Modellnamen ändern.
Warum Neon und Fable jeweils zwei Einstiegspunkte haben
Gemini 4 Neon und Claude Fable 5.2 unterstützen beide sowohl den OpenAI-kompatiblen chat-Endpunkt als auch das native Format des jeweiligen Herstellers. Der Vorteil des chat-Endpunkts: Der Code kann mit anderen Modellen ein gemeinsames SDK teilen. Der Vorteil des nativen Formats: Herstellerspezifische Parameter lassen sich nutzen. Wenn es in Ihrem Anwendungsfall nur um gewöhnliche Konversation und Generierung geht, ist der chat-Endpunkt in der Regel bereits ausreichend.
Schnellstart mit Gemini 4 Neon, GPT-6.2 Astra und Claude Fable 5.2
Wie in diesem Artikel gefordert, gibt es hier keinen allgemeinen Codeblock, sondern die wichtigsten Parameter werden pro Modell aufgelistet. Die gemeinsame Konfiguration für alle drei Modelle: api_key enthält den Key, den man im APIYI-Backend erhält, base_url wird auf https://api.apiyi.com/v1 gesetzt.
- Gemini 4 Neon aufrufen: Das OpenAI SDK auf die oben genannte base_url zeigen lassen,
chat.completions.createaufrufen,modelaufgemini-4-neonsetzen undmessagesdas Konversationsarray übergeben; werden native Parameter benötigt, stattdessen eine Anfrage im nativen Gemini-Format verwenden. - GPT-6.2 Astra aufrufen: Derselbe SDK-Client ruft
responses.createauf,modelwird aufgpt-6.2-astragesetzt, der Inhalt der Eingabeaufforderung wird überinputübergeben; wenn alter Code weiterverwendet wird, kann auchchat.completions.createverwendet werden. - Claude Fable 5.2 aufrufen: In normalen Szenarien
chat.completions.createaufrufen,modelaufclaude-fable-5-2setzen; wenn tiefgehendes Nachdenken erforderlich ist, aufclaude-fable-5-2-thinkingwechseln; wenn native Anthropic-Parameter benötigt werden, auf das messages-Format umsteigen. - Nutzung erfassen: Nach jedem Aufruf die zurückgegebenen Token-Zahlen für Eingabe, Ausgabe und Cache notieren – diese werden später bei der Berechnung der Kosten pro Aufgabe benötigt.
🚀 Schnellstart: Am besten zuerst bei APIYI apiyi.com das kostenlose Testguthaben für neue Nutzer abholen und mit demselben Satz an Geschäftsbeispielen alle drei Modelle durchlaufen lassen. Ein einziger API Key genügt, um zwischen den drei Modellen zu wechseln; die Abrechnung erfolgt nach Verbrauch, sodass sich Wirkung und Kosten unter realer Last gut vergleichen lassen.
Szenario-Empfehlungen: getrennt nach den Anforderungen dieser Aufgabe
Der Ausgangspunkt bei der Modellwahl ist nicht die Frage „Welches Modell ist das beste?“, sondern was bei dieser einen Aufgabe am wichtigsten ist. Im Folgenden finden Sie für drei typische Anforderungen jeweils die Spalte mit den Informationen, die Sie zuerst prüfen sollten.
Szenarien, bei denen die Reasoning-Tiefe im Vordergrund steht
- Komplexe Analysen und mehrstufiges Reasoning: Prüfen Sie zuerst die in der Gemini-4-Neon-Ankündigung zitierten Daten von Artificial Analysis und Vals Index; beachten Sie, dass die 61 Punkte ein Ergebnis der Stufe xhigh sind.
- Aufgaben, die eine hohe Reasoning-Stufe erfordern: Claude Fable 5.2 hat eine eigene Modell-ID
claude-fable-5-2-thinking, die sich zum gleichen Stückpreis wie die Version ohne Thinking im Vergleich testen lässt. - Wenn Sie GPT-6.2 Astra benötigen: In den Referenzmaterialien gibt es keine Benchmark-Daten dazu; am besten direkt mit eigenen Geschäftsbeispielen verifizieren.
Szenarien, bei denen Coding-Agenten im Vordergrund stehen
- Lange Codebasis-Eingaben, lange Patch-Ausgaben: Die in der Claude-Fable-5.2-Ankündigung wiedergegebenen Verbesserungen bei FrontierCode 2.0 und die Ausgabegrenze von 128K sind brauchbare Anhaltspunkte.
- Starke Tool-Aufrufe und viel Zustand über mehrere Turns: Der von GPT-6.2 Astra empfohlene responses-Endpunkt ist besser geeignet, diese Art von Interaktion zu tragen; die Art der Anbindung ist dabei selbst ein Bewertungspunkt.
- Bestehender OpenAI-kompatibler Code: Alle drei Modelle lassen sich über den chat-Endpunkt ansprechen, die Migrationskosten bleiben dadurch relativ überschaubar.
Szenarien, bei denen der Preis pro Token bei langem Kontext im Vordergrund steht
- Dauerhaft sehr lange Eingaben: Prüfen Sie zuerst, ob eine Anfrage die Grenze von 272000 Token bei GPT-6.2 Astra überschreitet; oberhalb dieser Grenze gilt ein anderer Stückpreis.
- Hohe Cache-Trefferquote: Der Stückpreis für Cache-Lesevorgänge unterscheidet sich bei den drei Modellen deutlich; bei Anwendungen mit hoher Cache-Trefferquote sollten Sie diesen Preis separat in die Kalkulation einbeziehen.
- Kontext im 1M-Bereich: Gemini 4 Neon und Claude Fable 5.2 sind beide mit einem Kontext im Bereich von 1 Million Token angegeben, doch die Preise für Ein- und Ausgabe unterscheiden sich; rechnen Sie daher mit Ihrem eigenen Verhältnis von Eingabe zu Ausgabe.
Entscheidungsempfehlung: die drei Spalten getrennt prüfen, dann mit wenig Traffic verifizieren
Die Informationen aus den drei Spalten getrennt zu prüfen, ist der einfachste Weg, Fehleinschätzungen bei der Auswahl zu vermeiden. Die Spalte „Fähigkeiten“ sagt nur etwas darüber aus, „wie ein Modell in einem bestimmten Ranking auf einem bestimmten Niveau abschneidet“, die Spalte „Preis“ nur über „den Stückpreis pro Million Token“ und die Spalte „Endpunkt“ nur darüber, „wie der Code zu schreiben ist“. Aus keiner dieser Spalten allein lässt sich ableiten, „welches Modell für diesen konkreten Auftrag das richtige ist“.
Praktischer ist es, zuerst die Kosten pro Aufgabe zu berechnen: Schätzen Sie anhand der typischen Anfragen aus Ihrem Geschäftsbereich die Token-Zahlen für Eingabe, Ausgabe und Cache und multiplizieren Sie diese jeweils mit dem entsprechenden Stückpreis der drei Modelle. Bei GPT-6.2 Astra müssen Sie zusätzlich prüfen, ob die Grenze von 272000 Token überschritten wird. Messen Sie anschließend die Qualität mit derselben Stichprobe und betrachten Sie Kosten und Qualität gemeinsam – statt nur auf das Ranking oder nur auf den Stückpreis zu schauen.
💡 Auswahlempfehlung: Welches Modell Sie wählen, hängt von der Struktur Ihrer Aufgabe und Ihren Qualitätsanforderungen ab. Empfohlen wird, über APIYI apiyi.com mit einem einheitlichen Key einen Vergleich der drei Modelle mit wenig Traffic durchzuführen, die Kosten anhand des tatsächlichen Verbrauchs zu kalkulieren und erst dann das Hauptmodell und das Ausweichmodell festzulegen.
Häufig gestellte Fragen (FAQ)
Q1: Was sind Gemini 4 Neon, GPT-6.2 Astra und Claude Fable 5.2?
Alle drei sind neue Generationen großer Sprachmodelle, die rund um November 2026 erschienen sind: Gemini 4 Neon wurde von Google am 18. November 2026 angekündigt, Claude Fable 5.2 von Anthropic am 9. November veröffentlicht, und GPT-6.2 Astra ist bereits in der APIYI-Preisübersicht aufgeführt. Die drei Modelle unterscheiden sich in Leistungsumfang, Abrechnungsmodell und Endpunktformat.
Q2: Lassen sich die Benchmark-Werte der drei Modelle direkt vergleichen?
Nein. Die Daten für Gemini 4 Neon stammen aus den in der Google-Ankündigung zitierten Artificial Analysis und Vals Index; die Daten für Claude Fable 5.2 stammen aus dem in der Ankündigung wiedergegebenen FrontierCode 2.0. Beide messen unterschiedliche Fähigkeiten; für GPT-6.2 Astra liegen in den vorliegenden Materialien keine Benchmark-Daten vor. Zwischen verschiedenen Benchmarks gibt es keine Umrechnungsbeziehung.
Q3: Wann wurden die drei Modelle veröffentlicht?
Laut dem APIYI-Changelog vom 10. November 2026 veröffentlichte Anthropic Claude Fable 5.2 am 9. November; Google veröffentlichte am 18. November 2026 die Ankündigung zu Gemini 4 Neon. Die Preise in diesem Artikel wurden am 20. November 2026 geprüft; die zugrunde liegende Preisübersicht wurde am 19. November 2026 um 10:59 Uhr (UTC+8) aktualisiert.
Q4: Wie hoch ist der Ausgabepreis von GPT-6.2 Astra nach mehr als 272000 Token genau?
Die beiden Quellen formulieren es unterschiedlich: In der APIYI-Preisübersicht steht, dass die Eingabe nach mehr als 272000 Token `16` beträgt, ein Ausgabepreis wird dort aber nicht genannt. Die Preis-API gibt an, dass bei mehr als 272000 Token die Ausgabe mit `60` und der Cache-Lesevorgang mit `0.8` berechnet werden. In diesem Artikel werden beide Angaben nebeneinandergestellt; für die tatsächliche Abrechnung sollte die Preis-API zum Zeitpunkt des Aufrufs maßgeblich sein.
Q5: Wie lassen sich diese drei Modelle schnell über die API aufrufen?
Empfohlen wird die einheitliche Anbindung über eine Multi-Modell-Plattform:
1. Besuchen Sie APIYI apiyi.com, legen Sie ein Konto an und erhalten Sie einen API-Schlüssel sowie ein kostenloses Testkontingent.
2. `base_url` einheitlich auf `https://api.apiyi.com/v1` setzen.
3. Endpunkt je nach Modell wählen: Neon über chat oder das native Gemini-Format, Astra über responses (alternativ über chat), Fable über chat oder messages.
Mit nur einem API-Schlüssel können Sie zwischen allen drei Modellen wechseln, was den Vergleich anhand derselben Stichprobe erleichtert.
Q6: Wie lassen sich die Katalogpreise von APIYI selbst überprüfen?
Sie können sich die Modellübersicht und die Preis-API von APIYI apiyi.com gemeinsam ansehen. Die Preis-API verwendet Multiplikatoren: Ein `model_ratio` von 1 entspricht einem Eingabepreis von 2 USD pro Million Token; die Ausgabe entspricht der Eingabe multipliziert mit `completion_ratio`, der Cache-Lesevorgang entspricht der Eingabe multipliziert mit `cache_ratio`. Für `gemini-4-neon` ergeben sich daraus beispielsweise Eingabe 3, Ausgabe 15 und Cache-Lesevorgang 0.15.
Q7: Muss man für die Thinking-Variante von Claude Fable 5.2 extra bezahlen?
`claude-fable-5-2` und `claude-fable-5-2-thinking` haben in der Preisübersicht denselben Stückpreis: Eingabe 8, Cache-Lesevorgang 0.2, Ausgabe 40. Der Stückpreis bleibt gleich, aber der Denkprozess erzeugt zusätzliche Ausgabe-Token, sodass die tatsächlichen Kosten je nach Nutzung variieren.
Q8: Welche Einschränkungen sollte man bei diesen drei Modellen beachten?
– **Leistungsdaten**: Die Daten zu Neon und Fable stammen aus Ankündigungen und sind zitiert oder wiedergegeben, keine unabhängigen Messungen; für Astra fehlen öffentliche Benchmark-Daten.
– **Preisstaffelung**: Astra hat eine Staffelgrenze bei 272000 Token; die beiden Quellen geben sie unterschiedlich an.
– **Gültigkeit der Preise**: Das Modell `gemini-4-carbon` aus derselben Serie entspricht Googles Einführungspreis bis zum 30. November; ab Dezember gilt Googles Standardpreis mit Eingabe 4 und Ausgabe 20.
– **Endpunktunterschiede**: Für die drei Modelle werden unterschiedliche Endpunkte empfohlen; bei einer Migration reicht es nicht, nur den Modellnamen zu ändern.
Gemini 4 Neon, GPT-6.2 Astra und Claude Fable 5.2: die wichtigsten Punkte
- Drei Spalten getrennt betrachten: Angekündigte Fähigkeiten, APIYI-Shop-Preis und Aufruf-Endpunkt stehen jeweils für sich; daraus wird keine einzige Gesamtnote.
- Unterschiedliche Benchmark-Grundlagen: Neon verweist auf Artificial Analysis und Vals, Fable auf FrontierCode; die Werte sind nicht direkt vergleichbar.
- Neon-Preise lassen sich selbst nachprüfen: Die Raten der Preis-API ergeben umgerechnet Eingabe 3, Cache-Lesen 0.15, Ausgabe 15.
- Bei Astra auf die Staffelung achten: Bei mehr als 272000 Token Eingabe liegt der Eingabepreis bei 16; der Ausgabepreis fehlt in der Gesamtübersicht, die Preis-API nennt 60.
- Fable hat einheitliche Stückpreise: Standard- und Thinking-Version liegen beide bei Eingabe 8, Cache-Lesen 0.2 und Ausgabe 40.
- Unterschiedliche Endpunkte: Neon nutzt chat oder den nativen Endpunkt, Astra empfiehlt responses, Fable nutzt chat oder messages.
- Einstieg: Über APIYI apiyi.com mit einem einzigen API-Schlüssel alle drei Modelle anbinden und mit derselben Stichprobe bei geringem Volumen vergleichen.
Zusammenfassung
Beim Vergleich von Gemini 4 Neon, GPT-6.2 Astra und Claude Fable 5.2 kommt es vor allem darauf an, drei Arten von Informationen nicht miteinander zu vermischen:
- Spalte „Fähigkeiten“: Betrachten Sie ausschließlich die in den Ankündigungen zitierten Ranglisten und Einstufungen. Die Datengrundlage von Neon und Fable ist nicht dieselbe; Astra muss separat überprüft werden.
- Spalte „Preis“: Maßgeblich ist der APIYI-Katalogpreis. Achten Sie auf den Stückpreis für Cache-Lesevorgänge, die 272000-Token-Staffelung bei Astra und die Abweichungen zwischen den beiden Quellen.
- Spalte „Endpunkte“: Die empfohlenen Endpunkte der drei Modelle unterscheiden sich jeweils. Die base_url ist einheitlich
https://api.apiyi.com/v1; Pfad und Request-Body werden je Modell separat geschrieben.
Klären Sie zunächst, ob bei dieser Entscheidung eher Reasoning-Tiefe, Coding-Agent oder der Stückpreis für langen Kontext im Mittelpunkt steht, prüfen Sie dann die entsprechende Spalte und validieren Sie abschließend mit echten Beispielen und geringem Traffic. Empfohlen: Fordern Sie über APIYI apiyi.com ein kostenloses Kontingent an und führen Sie den Vergleichstest der drei Modelle mit demselben Key durch.
📚 Referenzen
-
APIYI-Modellübersicht: Modell-IDs und Katalogpreise (in diesem Artikel geprüfter Stand: aktualisiert am 2026-11-19 10:59 UTC+8)
- Link:
docs.apiyi.com/models.md - Beschreibung: Abfrage der gestaffelten Stückpreise für Modelle wie
gpt-6.2-astraundclaude-fable-5-2
- Link:
-
APIYI-Preis-API: Echtzeitpreise auf Basis von Multiplikatoren (Version
shell-api-modelmak-v1)- Link:
api.apiyi.com/api/pricing - Beschreibung: Mit
model_ratio,completion_ratioundcache_ratiolassen sich die USD-Stückpreise berechnen
- Link:
-
Google Gemini 4 Neon-Ankündigung: veröffentlicht am 2026-11-18
- Beschreibung: Enthält den Listenpreis, ein 1M-Kontextfenster sowie zitierte Daten von Artificial Analysis und Vals Index
-
APIYI-Änderungsprotokoll (2026-11-10): gibt die Veröffentlichungsinformationen zu Anthropic Claude Fable 5.2 wieder
- Beschreibung: Enthält Preisanpassungen, FrontierCode-2.0-Daten, ein 1M-Kontextfenster und 128K-Ausgabe
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gern über die Startseite der APIYI-Website, um weitere Materialien zur Modellintegration und Preisprüfung zu erhalten