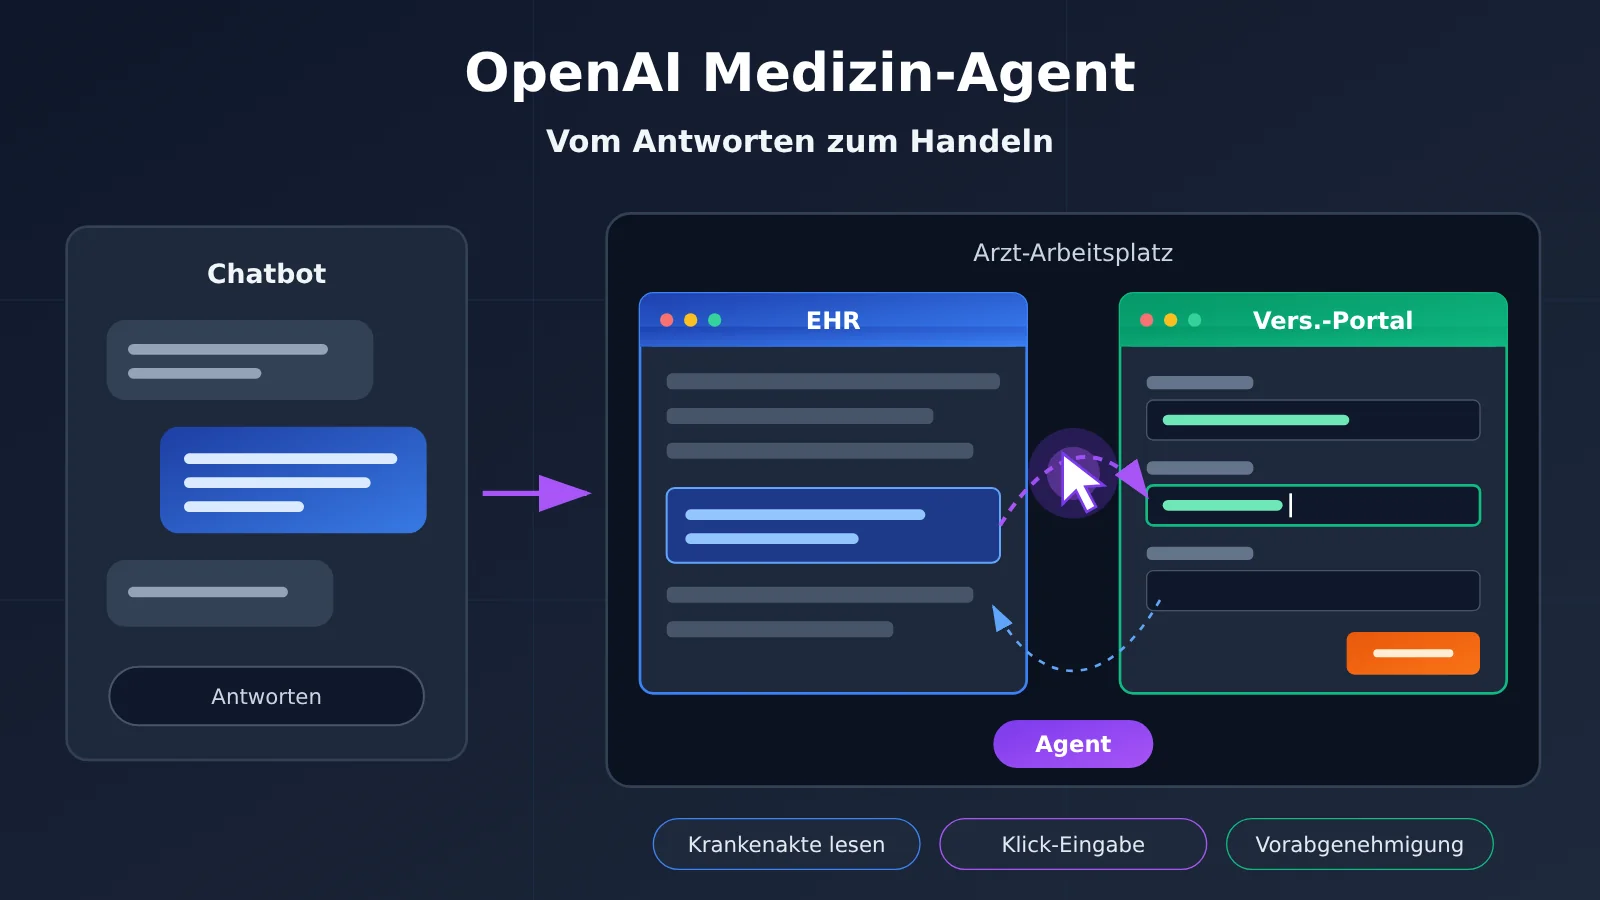
Der entscheidende Fortschritt von OpenAIs Computer-Use-Agent im Gesundheitswesen besteht darin, dass er in die Softwaresysteme eindringen kann, die medizinische Einrichtungen bereits im Einsatz haben, die longitudinalen Krankengeschichten von Patienten liest und daraus Arztbriefe, Verordnungsentwürfe, Patientenantworten und Unterlagen für die Vorabgenehmigung bei der Krankenkasse vorbereitet. Der Wert von KI verschiebt sich damit vom Beantworten fachlicher Fragen hin zur Ausführung realer Geschäftsprozesse. Auch der Wettbewerbsschwerpunkt bei medizinischer KI verändert sich: Es geht nicht mehr nur um Wissensfragen aus der Medizin, sondern um die klinischen und administrativen Workflows selbst. Wichtig zu betonen: Diese Materialien werden in Demos und öffentlichen Fallbeispielen immer von Ärztinnen, Ärzten oder Mitarbeitenden geprüft – die KI besitzt weder eigenständig das Verschreibungsrecht noch Entscheidungsbefugnis in medizinischen Fragen.
Was Sie aus diesem Artikel mitnehmen
- Die vollständige Aktionskette im MRT-Beispiel: vom Lesen der Krankenakte bis zum fertig vorbereiteten Antrag auf Vorabgenehmigung.
- Was die drei Zahlen – 99 % Sicherheit, 93 % hohe ärztliche Zustimmung, 94,3 % Rubric-Punkte – jeweils messen und worin sie sich von den Ergebnissen aus dem Stanford-Paper HealthAdminBench unterscheiden.
- Ob CVS Health, Cigna, Abridge und Ambience jeweils in einer synthetischen Demo, im Produktivbetrieb oder noch in der Entwicklung stecken.
- Wie klinische Genehmigungsbefugnis und die Ausführungsbefugnis des Agenten getrennt bleiben – und wie Entwickler die Gesamtkosten eines Agenten realistisch kalkulieren.
Gliederung
Der Fakten-Teil ist so aufgebaut: Zuerst wird rekonstruiert, was OpenAI die KI hier konkret tun lässt; dann folgt der Unterschied zwischen Chatbot und Computer-Use-Agent; danach die Bedeutung der Benchmark-Ergebnisse; anschließend, wie CVS, Cigna, Abridge und Ambience das in der Praxis umsetzen; und zum Schluss die Mechanismen zur Risikokontrolle bei Agenten im Gesundheitswesen. Der Analyseteil diskutiert, warum die Branche genau diese Fähigkeit so dringend braucht, wie Entwickler und medizinische Einrichtungen abwägen sollten und was Computer Use für die gesamte KI-Anwendungsbranche bedeutet.
Zum Nachschlagen: Schnellreferenz zu Konzepten rund um medizinische Agenten
| Konzept | Kurze Erklärung |
|---|---|
| Computer Use | Die Fähigkeit, Aufgaben durch Beobachten und Bedienen von Softwareoberflächen (Screenshots, Klicks, Eingaben) zu erledigen |
| EHR | Elektronisches Gesundheitsaktensystem – die zentrale Software in Krankenhäusern, in der Informationen zu Arztbesuchen, Medikation, Bildgebung usw. der Patientinnen und Patienten liegen |
| Payer Portal | Portal des Kostenträgers (der Versicherung), über das medizinische Einrichtungen Vorabgenehmigungen einreichen und die Versicherungsberechtigung prüfen |
| Prior Authorization | Vorabgenehmigung: Für bestimmte Untersuchungen oder Behandlungen muss vor der Durchführung die Zustimmung der Versicherung eingeholt werden |
| MCP | Ein Standardprotokoll zum Auffinden und Aufrufen externer Tools |
| RPA | Automatisierung wiederkehrender Abläufe mithilfe vorkonfigurierter Regeln oder Skripte |
| Rubrik-Punkte (Rubric points) | Nach Bewertungsregeln aufgeteilte Bewertungspunkte, die messen, inwieweit einzelne Anforderungen erfüllt sind |
| Ende-zu-Ende-Erfolgsrate | Der Anteil vollständiger Aufgaben, die alle Erfolgsbedingungen erfüllen |
| Trace | Die Spur, die den Ausführungsprozess, die ausgeführten Aktionen und die Oberflächenzustände als Nachweis festhält |
| BAA | Business Associate Agreement (Geschäftspartnervereinbarung) – regelt die Verantwortung des Dienstleisters bei der Verarbeitung geschützter Gesundheitsinformationen (PHI) |
| RBAC | Rollenbasierte Zugriffskontrolle – ordnet Daten und Aktionen je nach Position und Rolle zu |
Überblick über die Auswirkungen medizinischer Agenten
- Entwickler und technische Verantwortliche: Im Mittelpunkt steht nicht mehr die Frage, ob ein Modell medizinische Fragen richtig beantworten kann, sondern ob für konkrete Aufgaben der Ausführungsmechanismus, die Ende-zu-Ende-Abschlussrate und die vollständigen Kosten validiert werden. Screenshots sind Bildeingaben; mehrstufige Aufrufe, Tools und die Laufzeitumgebung werden alle abgerechnet. Man darf also nicht nur auf den Stückpreis pro Text-Token schauen.
- Medizinische Einrichtungen und Workflow-Verantwortliche: Hier gilt es zu unterscheiden, was synthetische Demo-Daten, was Herstellerbewertungen, was Unternehmenspiloten und was echte Produktionsfälle sind. Beim Go-live müssen zusätzlich menschliche Freigaben, Berechtigungskonfigurationen und Audit-Logs umgesetzt werden. Demo-Ergebnisse dürfen nicht einfach als Beschaffungsgrundlage dienen.
- Klinisches Personal: Kurzfristig werden sie eher eine sinkende Verwaltungslast spüren, etwa bei der Vorbereitung von Unterlagen für die Vorabgenehmigung und bei der systemübergreifenden Informationssuche. Klinische Entscheidungen und die Verantwortung für die Unterschrift bleiben weiterhin bei den Ärztinnen und Ärzten.
Objektive Fakten: Was OpenAI mit dem medizinischen Agenten diesmal veröffentlicht hat
Was hat der OpenAI-Agent für das Gesundheitswesen diesmal mit KI erledigt?
Am 16. November 2026 hat OpenAI neue Fortschritte bei Computernutzungs-Agenten für medizinische Teams veröffentlicht – zusammen mit Evaluationsergebnissen zu klinischen und administrativen Workflows sowie mit Einblicken aus der Zusammenarbeit mit Unternehmen wie CVS Health, Abridge, Ambience und Cigna Healthcare. Während der HLTH 2026 stellte auch Karan Singhal, Leiter von OpenAI Health AI, die betreffenden Entwicklungen vor.
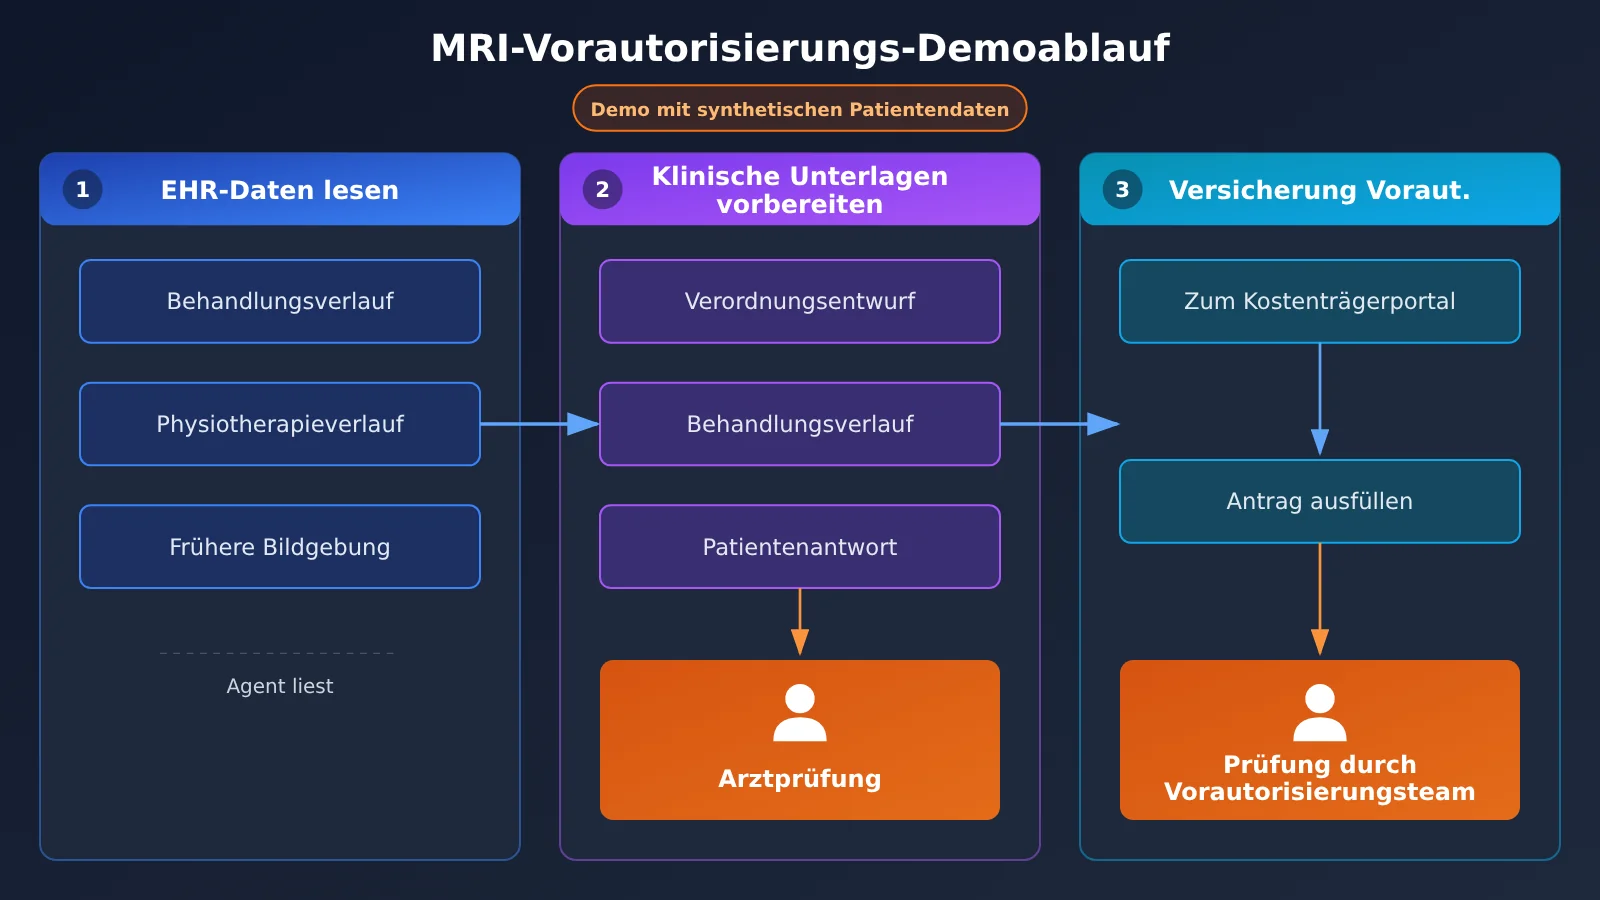
Am deutlichsten wird die Veränderung am offiziell gezeigten MRT-Workflow. Ein Patient meldet sich wegen Schmerzen im unteren Rücken bei seiner Ärztin, die ein MRT in Betracht zieht. Anschließend erledigt der Agent zwischen EHR und Versicherungsportal drei Arbeitsschritte:
- EHR-Informationen lesen: Einsicht in Behandlungsverlauf, Physiotherapie-Aufzeichnungen und frühere Bildgebungsdaten.
- Klinische Unterlagen vorbereiten: Entwurf der MRT-Anordnung, der Notiz zum aktuellen Termin und der Antwort an die Patientin – alles zur Prüfung durch die Ärztin.
- Versicherungs-Vorautorisierung: Auf Basis derselben Patientenakte wird das Portal des Kostenträgers aufgerufen, um den MRT-Vorautorisierungsantrag vorzubereiten, der dann von den für die Vorautorisierung zuständigen Mitarbeitenden geprüft wird.
Wichtig zu erwähnen: Diese Demo verwendet synthetische Patientendaten (Synthetic Patient Data) und ist kein Produktivbetrieb mit echten Patienten. Gezeigt wird eine Funktionskette – nicht, dass irgendein Krankenhaus echte Fälle bereits nach diesem Ablauf bearbeitet.
Offiziell vorgestellt wurde außerdem ein Fall zur Medikamentenberatung nach einem Knochenbruch bei einem Kind. Angehörige fragen nach der Ibuprofen-Dosierung für das Kind; der Agent sichtet Behandlungsunterlagen und Bildgebung, liest das in der Akte hinterlegte Gewicht und die in der Praxis verabreichte Dosis aus und entwirft daraufhin eine Medikamentenanleitung, Hinweise zur Gipsversorgung sowie Warnsymptome, bei denen sofort ärztliche Hilfe nötig ist. Die medizinische Dokumentation speichert er als ununterschrieben, die Antwort an die Angehörigen als ungesendeten Entwurf; die abschließende Freigabe erfolgt durch die Ärztin. „Elevated PSA“ und „Digoxin refill“ (Digoxin-Nachverordnung) sind ebenfalls als Aufgabenkategorien im EHR-Posteingang gelistet, doch vollständige Aufzeichnungen zu diesen beiden Aufgaben und eigenständige Bewertungen wurden nicht veröffentlicht.
Vom Chatbot zum Computer-use-Medizin-Agent – wo liegt der Unterschied?
Ein klassischer medizinischer Frage-Antwort-Chatbot liefert allgemeines Wissen, und die medizinische Dokumentgenerierung kann einen Entwurf schreiben – aber der Inhalt muss trotzdem noch manuell in das System kopiert werden. Der Unterschied beim Computer-use-Agent besteht darin, dass er über den Zyklus „Screenshot beobachten → planen → klicken oder eingeben → erneut per Screenshot verifizieren“ direkt in die vorhandene Software eintritt, anwendungsübergreifend mehrstufige Aufgaben erledigt und dabei den Geschäftszustand in der Software verändern kann.
| Fähigkeitsform | Hauptausgabe | Berührt es Geschäftssysteme? | Typische medizinische Szenarien | Hauptrisikopunkte |
|---|---|---|---|---|
| Medizinischer Frage-Antwort-Chatbot | Textantworten | Nein | Abfrage medizinischen Wissens, Evidenzsuche | Genauigkeit der Inhalte |
| Medizinische Dokumentgenerierung | Notizen, Briefentwürfe | Indirekt, manuelle Eingabe erforderlich | Entlassungsanweisungen, Schreiben zur Vorautorisierung | Inhalt stimmt nicht mit der Krankenakte überein |
| Computer-use-Agent | UI-Operationen und Systemstatusänderungen | Ja, direkter Betrieb von EHR und Portalen | Ausfüllen von Vorautorisierungen, Aktualisierung des Überweisungsstatus, Datenabruf über Systeme hinweg | Fehlklicks, Patientenverwechslung, Fehlerfortpflanzung |
In der OpenAI-API wird Computer Use hauptsächlich über die Responses API umgesetzt und unterstützt Aktionen wie click, type, scroll, keypress, drag und screenshot. Die offizielle Dokumentation beschreibt zwei Wege: Zum einen das Computer Tool, bei dem das Modell strukturierte Maus- und Tastaturaktionen zurückgibt, die von der Anwendung ausgeführt werden; zum anderen die Code Execution, bei der das Modell Code erzeugt, der Tools wie Playwright oder PyAutoGUI aufruft. Für GPT-6 Astra empfiehlt die offizielle Dokumentation derzeit den Weg über die Code Execution. Außerdem wird ausdrücklich betont: Dass das Modell eine Operationsanweisung erzeugt hat, bedeutet nicht, dass die Operation bereits erfolgreich war – die Anwendung muss die Aktion ausführen und das Ergebnis anschließend, etwa durch einen neuen Screenshot, bestätigen.
Was sagen die Evaluationsergebnisse des OpenAI-Medizin-Agents aus?
OpenAI hat drei zentrale Datensätze veröffentlicht. Ihre Nenner und Bewertungsdimensionen unterscheiden sich jeweils, sie lassen sich nicht zu einer „Gesamtgenauigkeit“ zusammenfassen, und keiner davon ist eine medizinische Diagnosegenauigkeit.
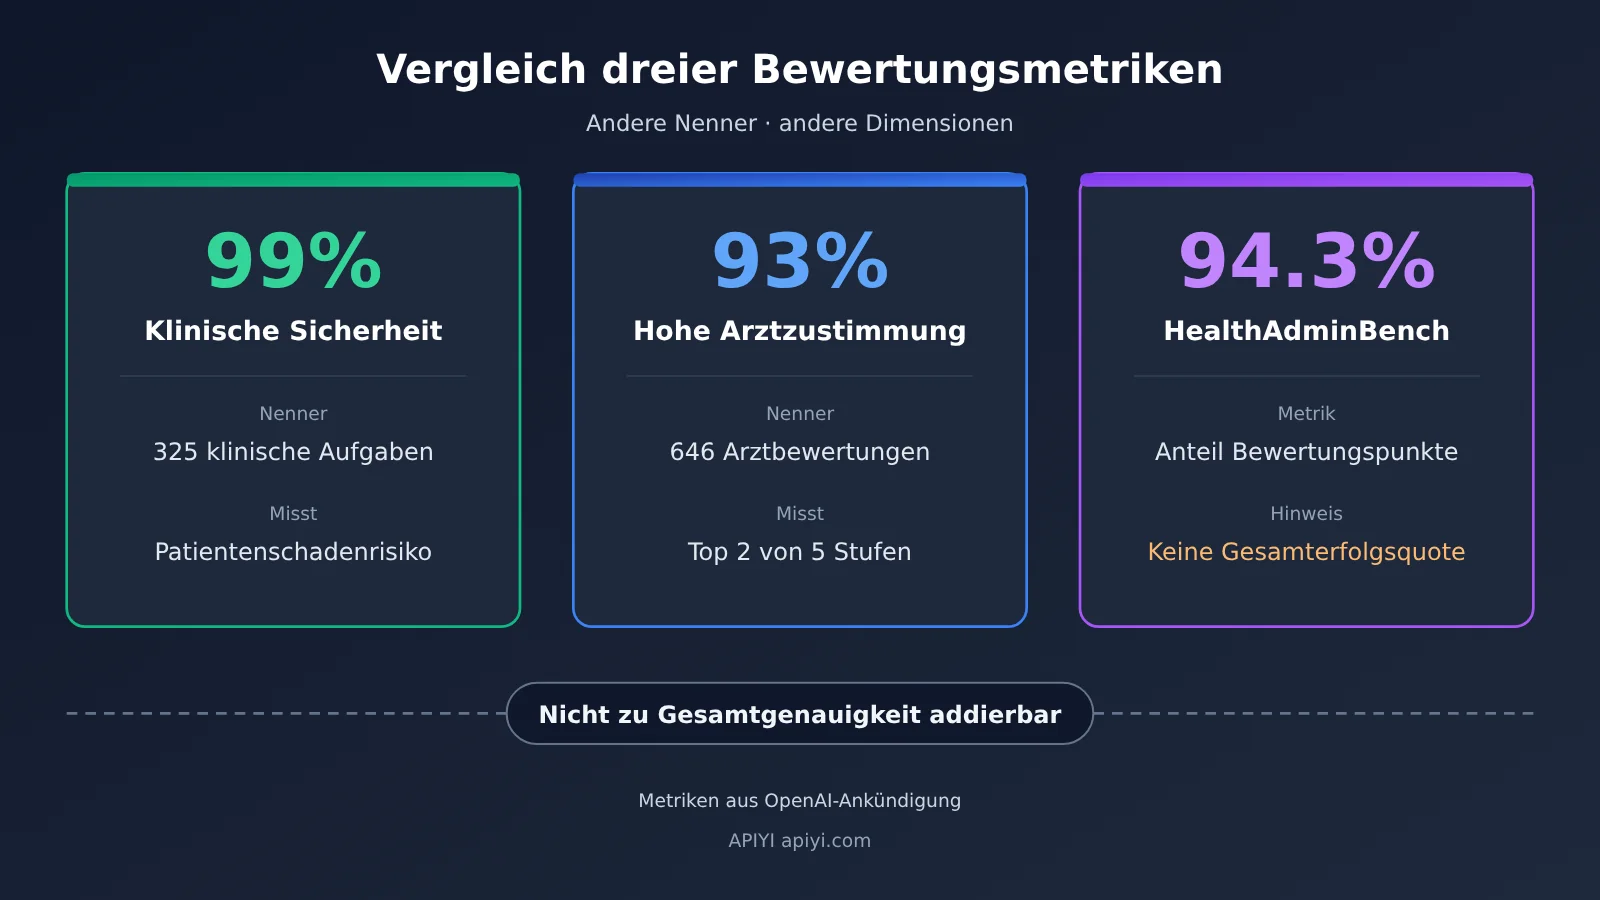
| Metrik | Wert | Evaluierungsobjekt | Nenner / Maßstab | Nicht zu verstehen als |
|---|---|---|---|---|
| Sicherheit klinischer Aufgaben | 99% | GPT-6 Astra | 325 geprüfte Aufgaben; bewertet, ob Fehler, Auslassungen oder Maßnahmen potenziell Patientenschaden verursachen könnten | Diagnosegenauigkeit, Null-Fehler |
| Hohe Arztzustimmung | 93% | GPT-6 Astra | 646 Bewertungen; kombinierter Anteil von Very / Extremely Helpful auf einer Fünf-Punkte-Skala | Erfolgsrate der Aufgaben, 646 Ärzte |
| HealthAdminBench | 94.3% | GPT-6 Astra | Anteil der Rubrik-Punkte, maximum reasoning effort | Erfolgsrate vollständiger Aufgaben |
| HealthAdminBench | 91.8% | GPT-6 Luna | Anteil der Rubrik-Punkte, maximum reasoning effort | Erfolgsrate vollständiger Aufgaben |
| Kosten pro Aufgabe | $0.085 | GPT-6 Luna | bestimmte Evaluierungsbedingungen, 98% niedriger als Astra | Preis für den Produktionseinsatz |
Die klinische Begutachtung betrachtet nicht nur den letztlich generierten Text, sondern prüft auch die tatsächlich ausgeführten Aktionen des Agents, die erzeugten medizinischen Dokumentationen, Anordnungen und Patientennachrichten. Das heißt, die Evaluierung deckt sowohl die inhaltliche Qualität als auch den Ablauf der Software-Bedienung ab. Allerdings veröffentlicht OpenAI offiziell nicht die Anzahl der unabhängigen Ärzte hinter den 646 Bewertungen; auch der Ankündigungstext enthält keine Konfidenzintervalle, Ergebnisse pro Aufgabe oder vollständige Fehlerfälle.
HealthAdminBench ist ein vom Stanford Shah Lab vorgeschlagener Benchmark für medizinische Verwaltungs-Agents. Laut dem Paper 2604.09937v1 umfasst der Benchmark 135 Aufgaben und 1698 Teilaufgaben, von denen 1177 Teilaufgaben deterministisch bewertet und 521 durch ein Modell als Richter (model judge) beurteilt werden. Die höchste Erfolgsrate bei vollständigen Aufgaben im Paper erreicht Claude Opus 4.6 CUA mit 36.3%, die höchste Teilaufgaben-Erfolgsrate GPT-5.4 CUA mit 82.8%. Die frühere Webversion des Shah Lab umfasste 70 Aufgaben und 947 Bewertungspunkte; damals wurde eine maximale Erfolgsrate vollständiger Aufgaben von 22.9% berichtet, was als historischer Vergleich dient.
Diese Zahlen stammen aus unterschiedlichen Versionen, unterschiedlichen Modellen, unterschiedlichen Zeitpunkten, unterschiedlichen Ausführungsbedingungen und unterschiedlichen Metriken – sie lassen sich nicht in eine einzige Rangliste einordnen. OpenAIs 94.3% folgt dem Maßstab der Rubrik-Punkte, während die 36.3% aus dem Paper die End-to-End-Erfolgsrate vollständiger Aufgaben ist. Schon die Kluft zwischen beiden deutet darauf hin: Beim medizinischen Agent können „einzelne Schritte richtig gemacht“ und „die ganze Sache erledigt“ weit auseinanderliegen.
Wie setzen CVS, Cigna, Abridge und Ambience medizinische Agenten in der Praxis ein?
Die Reifegrade in den Unternehmensfallstudien unterscheiden sich deutlich. Im Folgenden sind sie nach dem öffentlich offengelegten Status gruppiert. Die Zahlen stammen überwiegend aus Angaben der Unternehmen und von OpenAI; Medienberichte dienen der Kreuzvalidierung, sind aber kein Drittaudit.
| Unternehmen | Szenario | Offenlegungsstatus | Wichtige Fakten |
|---|---|---|---|
| CVS Health | Versenden von Dokumenten, Überweisungen und Facharztkonsultationen über klinische Systeme hinweg | Produktions-Workflow | Beseitigte an einem Wochenende einen Dateirückstand, der sich über Monate aufgebaut hatte; ein weiterer Agent verarbeitet täglich Zehntausende systemseitige Arbeitsschritte im Zusammenhang mit Konsultationen |
| Cigna Healthcare | Systemübergreifende Informationsaggregation vor dem Pflegemanagement | Bereitgestellt | Pflegekräfte mussten zuvor mehr als 10 Systeme durchsuchen; von der Konzeption bis zur Bereitstellung vergingen weniger als 8 Wochen |
| Abridge | Koordination von Hindernissen bei der Entlassung | In Entwicklung | Ärztinnen und Ärzte fordern den Agenten über den Abridge Assistant auf, parallel die Medikamentenbeschaffung und die häusliche Pflege zu koordinieren |
| Ambience Healthcare | Anträge auf Vorabgenehmigung durch die Krankenversicherung | Demonstration des Governance-Ansatzes | Hält bei mehrdeutiger Krankenakte an und fragt die Ärztin oder den Arzt; reicht erst nach Genehmigung ein |
| Assort | Geschlossener Überweisungskreislauf | Offizielles Fallbeispiel | Die API schreibt Überweisungsinformationen; Computer Use ergänzt Statusaktualisierungen in der Athena-Oberfläche |
Die Angabe „Zehntausende“ bei CVS bezieht sich auf den Arbeitsaufwand, der mit systemseitigen Arbeitsschritten verbunden ist – nicht darauf, dass Zehntausende klinische Entscheidungen von der KI eigenständig getroffen wurden. CVS hat außerdem das CUA Agent Kit (Apache-2.0-Lizenz) als Open Source veröffentlicht. Es nutzt eine zweistufige Architektur: Zuerst erkundet ein Computer-Use-Agent anhand natürlicher Sprache den Workflow und zeichnet Trace-Nachweise wie Screenshots, Aktionen und Zielpositionen auf; anschließend verfestigt ein Codex Skill die erfolgreiche Trajektorie in deterministischen Code, der nach Prüfung durch Ingenieurinnen und Ingenieure wiederholt ausgeführt wird. Laut README benötigt die deterministische Ausführungsphase keinen Modell-API-Schlüssel.
Der Fall Assort zeigt die Rolle von Computer Use: Assort kann Überweisungsinformationen bereits über die Athena-API in die Krankenakte schreiben, doch für den vollständigen Kreislauf fehlt noch ein Schritt in der Oberfläche. Der Agent wählt direkt in der Athena-Oberfläche den Arzt für die Überweisung aus, füllt die Details aus und aktualisiert den Status auf Visit Scheduled; die Überweisung verschwindet daraufhin aus der Nachverfolgungsliste des Personals. Die API übernimmt strukturierte Operationen, Computer Use ergänzt die Bereiche, die die API nicht abdeckt.
Wie steuert ein medizinischer Agent Risiken?
Zu den von OpenAI veröffentlichten Governance-Funktionen gehören RBAC, Audit-Logs, die Konfiguration des Zugriffsbereichs von Anwendungen, menschliche Freigaben vor kritischen Aktionen sowie Kontrollmechanismen, die den Agent auf festgelegte Workflows beschränken. Medizinische Einrichtungen können den Agent jederzeit pausieren und die schrittweisen Aktionsprotokolle einsehen.
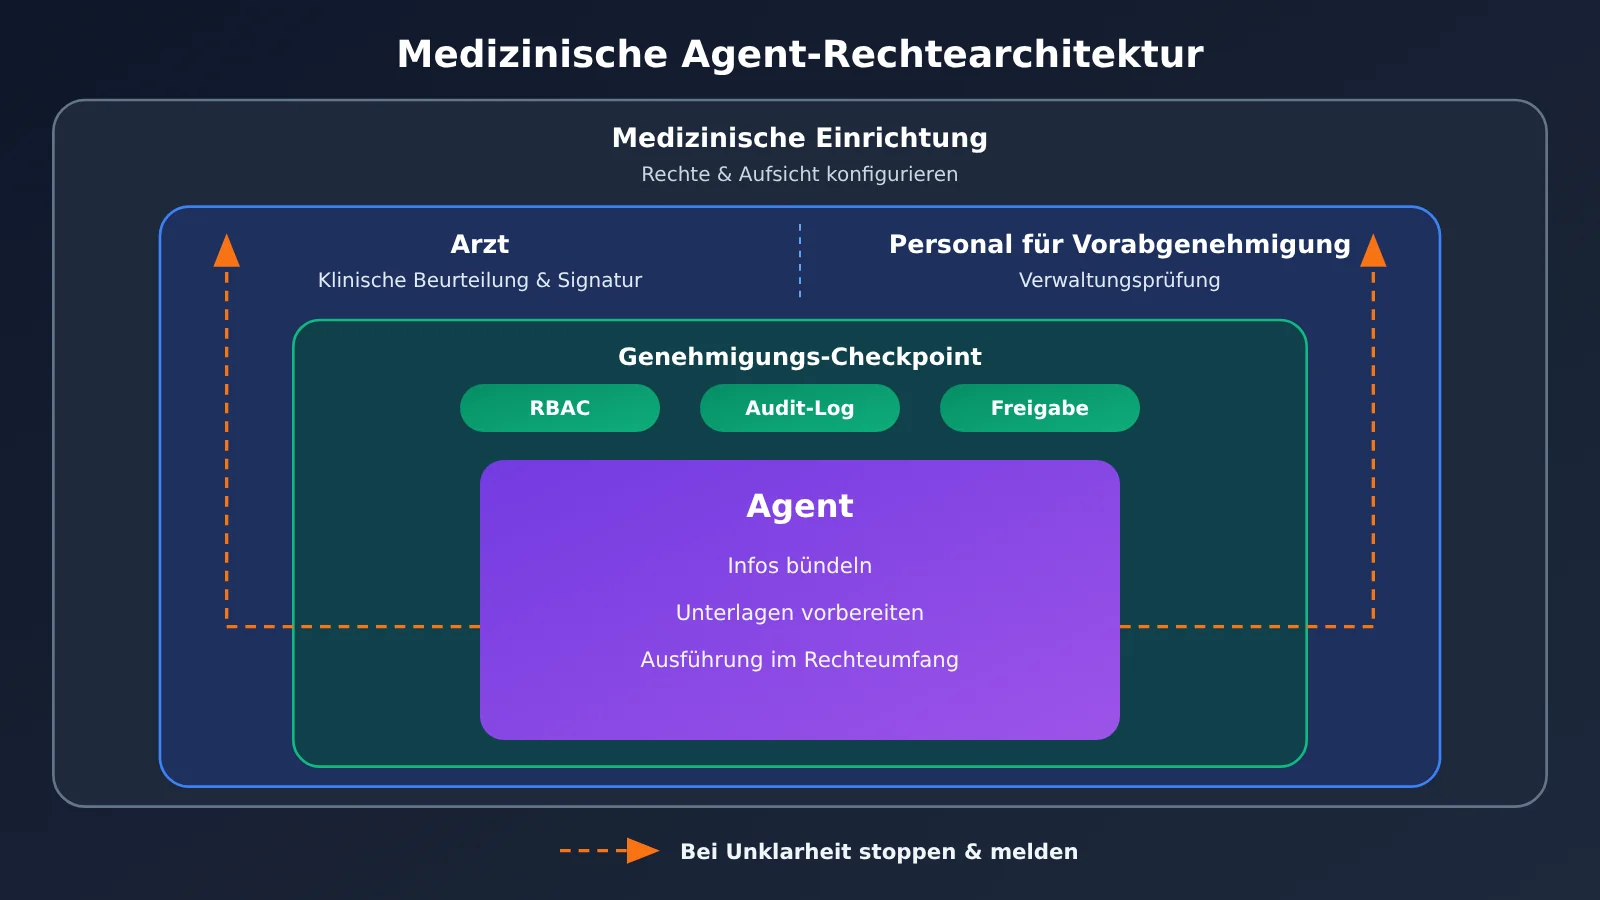
Das ist im Grunde eine Gewaltenteilung: Die KI ordnet Informationen, bereitet Materialien vor und führt Aktionen im delegierten Umfang aus, die Ärztinnen und Ärzte übernehmen die klinische Beurteilung, das Personal für Vorabgenehmigungen die Verwaltungsprüfung, und die medizinische Einrichtung konfiguriert Berechtigungen und Aufsichtsprozesse. Die Berechtigungen des Agent müssen mit den Grenzen der klinischen Verantwortung übereinstimmen.
Was die Datenkonformität betrifft, so erklärt OpenAI, dass Organisationsdaten in ChatGPT for Healthcare nicht zum Training von Basismodellen verwendet werden; CVS gibt ebenfalls an, dass die relevanten Produktionsdaten in der eigenen Infrastruktur verbleiben. Um jedoch HIPAA-konforme Workflows mit PHI zu unterstützen, müssen medizinische Organisationen einen qualifizierten Dienst nutzen, sicherstellen, dass der Dienst durch ein mit OpenAI unterzeichnetes BAA abgedeckt ist, Sicherheitseinstellungen und Datenaufbewahrungsrichtlinien konfigurieren und über Organisationsberechtigungen einschränken, auf welche Datensätze und Aktionen der Agent zugreifen darf. „HIPAA-Workflows unterstützen“ bedeutet daher nicht automatisch, dass „alle OpenAI-API-Aufrufe konform sind“.
Was die verfügbaren Kanäle angeht, lassen sich die entsprechenden Funktionen über die OpenAI API, ChatGPT for Healthcare, ChatGPT for Clinicians, ChatGPT Work und Codex nutzen. Berechtigte klinische Fachkräfte in den USA können ChatGPT for Clinicians kostenlos beantragen; diese kostenlose Regelung ist regional und an Qualifikationskriterien gebunden. Für ChatGPT for Healthcare gibt es keinen öffentlich bekannten einheitlichen Festpreis für Abonnements.
Analyse und Einordnung: Kompromisse und industrielle Bedeutung medizinischer Agents
Warum braucht das Gesundheitswesen besonders Agents vom Typ Computer Use?
Die Informationsfragmentierung in der medizinischen Versorgung ist geradezu typisch. Ein einziger Arztbesuch kann gleichzeitig das EHR, das Bildgebungssystem, das Verordnungssystem, das Versicherungsportal, das Überweisungssystem und die Plattform für das Entlassmanagement berühren – Systeme, die oft von unterschiedlichen Herstellern stammen und deren Schnittstellen alles andere als vollständig sind. Die MRI-Vorabgenehmigung ist ein Paradebeispiel im Kleinen: Der Arzt hat lediglich ein klinisches Urteil gefällt, doch die Mitarbeitenden müssen zwischen Krankenakte, Physiotherapieunterlagen, Bildgebungsdaten und Versicherungsportal hin- und herwechseln, kopieren und hochladen.
Aus dieser Perspektive löst Computer Use nicht die Frage, ob die KI Medizin versteht, sondern ob Informationen zwischen Systemen fließen können. Meine Einschätzung ist, dass die Automatisierung medizinischer Verwaltungsaufgaben deutlich früher kommerzielle Größenordnung erreichen dürfte als die Automatisierung klinischer Diagnostik. Der Grund: Administrativ Aufgaben sind zahlreich, hoch repetitiv und klar abgegrenzt, die Ergebnisse lassen sich über Formulare und Systemzustände verifizieren, und das Haftungsrisiko ist vergleichsweise überschaubar. Der Fall Cigna, bei dem die Suche nach Informationen über mehr als zehn Systeme hinweg auf wenige Sekunden zusammengefasst wurde, zeigt genau diesen Weg: zuerst entlasten, nicht ersetzen.
Allerdings zeigt der Stanford-Benchmark auch die eigentlichen Schwierigkeiten. Frühe Untersuchungen ergaben, dass die Datenübertragung zwischen Anwendungen und die Dokumentenverarbeitung wichtige Fehlerquellen für Agents sind: Selbst wenn die Patienteninformationen verstanden wurden, kann es beim Hochladen von Dateien, beim Ausfüllen von Feldern oder beim Aktualisieren von Statuswerten schiefgehen. In der Medizin kann sich ein Fehler in einem System zudem in mehrere nachgelagerte Systeme fortpflanzen – genau deshalb sind manuelle Freigaben und die Zustandsprüfung nach einer Aktion nicht optional.
Wie Entwickler die Kosten und Machbarkeit eines medizinischen Agents bewerten
Für Entwickler muss der erste Schritt nicht sofort Computer Use sein. Ein soliderer Ansatz besteht darin, den Workflow zunächst zu zerlegen: Rein textbasierte Schritte wie Informationsextraktion und das Verfassen von Unterlagen lassen sich zuerst mit einer normalen Modellschnittstelle auf ihre Qualität prüfen. Schritte mit UI-Interaktion werden anschließend separat auf ihre Erfolgsrate hin bewertet. Das folgende Beispiel validiert anhand synthetischer Daten den Textschritt „Extraktion der für eine Vorabgenehmigung erforderlichen Felder“. Es dient ausschließlich der technischen Demonstration und stellt keine medizinische Beratung oder Behandlungsempfehlung dar:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI-kompatible Schnittstelle
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Maßgeblich ist die tatsächlich verfügbare Modellliste der Plattform
    messages=[{"role": "user", "content": "从以下合成病历中列出影像检查预授权需要核对的字段清单:……"}]
)
print(resp.choices[0].message.content)
Vollständigen Code mit Token-Kostenstatistik anzeigen
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Stückpreis: USD / Million Token; nach dem tatsächlich verwendeten Modell ausfüllen
PRICE = {"input": 0.10, "output": 0.50, "cached_input": 0.01}

def run_step(prompt: str, model: str = "gpt-4o-mini") -> dict:
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "你只做字段抽取,不给出任何诊疗建议,信息不明确时输出 NEED_HUMAN。"},
            {"role": "user", "content": prompt},
        ],
    )
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    cost = ((u.prompt_tokens - cached) * PRICE["input"]
            + cached * PRICE["cached_input"]
            + u.completion_tokens * PRICE["output"]) / 1_000_000
    return {"text": resp.choices[0].message.content, "cost_usd": round(cost, 6)}

steps = ["合成病历片段 A ……", "合成病历片段 B ……"]
total = 0.0
for s in steps:
    r = run_step(s)
    total += r["cost_usd"]
    print(r["text"])
print("模型 Token 成本合计(不含工具、环境与维护):", round(total, 6))
🚀 Tipp zur schnellen Validierung: Bevor Sie sich offiziell an ein medizinisches System anbinden, können Sie über APIYI apiyi.com mit einem einzigen API-Schlüssel mehrere Modelle in Textschritten wie Feldextraktion und dem Verfassen von Unterlagen vergleichen. Neue Nutzer erhalten ein kostenloses Testkontingent. Das eignet sich gut, um zuerst das Evaluierungsskript zum Laufen zu bringen und aufgabenbezogene Daten zu sammeln.
Was die Kosten betrifft: Die am 17. November 2026 abgefragten Standardpreise für kurzen Kontext (USD pro Million Token) lauten wie folgt: GPT-6 Astra – Eingabe 10, Ausgabe 50, zwischengespeicherte Eingabe 1; GPT-6 Luna – Eingabe 0,10, Ausgabe 0,50, zwischengespeicherte Eingabe 0,01. Verarbeitungsgeschwindigkeit, Kontextlänge und Region können die tatsächliche Abrechnung beeinflussen. Rechnet man mit 0,085 USD pro Aufgabe für Luna und dem Verhältnis der „unteren 98 %“ zurück, liegt Astra bei etwa 4,25 USD pro Aufgabe. Das ist jedoch eine Schätzung und nur ein Kostenwert unter Basisbedingungen – kein Produktionsangebot.
Eine vollständige Kostenrechnung sollte die visuellen und textlichen Eingaben sowie die abgerechneten Ausgaben jeder Runde getrennt erfassen und dann Tool-Aufrufe, Laufzeitumgebung und Engineering-Wartung hinzurechnen. Falls die durch Wiederholungsversuche entstandenen Token bereits in die Gesamtsumme eingeflossen sind, dürfen sie nicht ein zweites Mal addiert werden. Der Preisunterschied von nahezu dem 50-Fachen zwischen den beiden Modellstufen legt zudem einen Ansatz mit Modellschichtung nahe: komplexe Schlussfolgerungen dem leistungsfähigeren Modell überlassen, strukturierte und hochfrequente Schritte dem kostengünstigen Modell, und bereits als stabil erwiesene Abläufe wie bei CVS als deterministischen Code festschreiben.
💰 Hinweis zur Kostenoptimierung: Bei der Modellschichtung können Sie zunächst auf APIYI apiyi.com mit demselben OpenAI-kompatiblen Code zwischen Modellen unterschiedlicher Preisklasse wechseln, Qualität und Token-Verbrauch für jede Art von Unteraufgabe messen und erst dann entscheiden, welche Schritte den Einsatz eines leistungsfähigeren Modells rechtfertigen.
| Validierungsphase | Zu beantwortende Frage | Empfohlene Nachweise | Referenzwerkzeuge |
|---|---|---|---|
| Textstufe | Ist die Qualität von Extraktion und Entwurf stabil? | Vergleich mit manueller Annotation, NEED_HUMAN-Auslöserate | APIYI apiyi.com Modellvergleich |
| UI-Bedienung | Wie hoch ist die End-to-End-Abschlussrate? | Screenshots und Traces, Statusprüfung nach der Aktion | OpenAI Computer Use Dokumentation und Sandbox-Umgebung |
| Prozessfixierung | Welche Schritte lassen sich in deterministischen Code überführen? | Reproduzierbarkeit erfolgreicher Trajektorien | Zweiphasige Architektur nach Art des CUA Agent Kit |
| Rollout-Governance | Decken Berechtigungen und Freigaben die kritischen Aktionen ab? | RBAC-Konfiguration, Stichprobenprüfung der Audit-Logs | Eigene Berechtigungs- und Compliance-Systeme der Organisation |
Medizinische Agenten und RPA: Ersatz oder Fusion?
Traditionelles RPA stützt sich auf feste Regeln und die Positionierung von Oberflächenelementen. Ändert sich die Benutzeroberfläche, können Skripte ihre Funktion verlieren. Computer-Use-Agenten hingegen können natürliche Sprache verstehen, die aktuelle Oberfläche beobachten und sich an Veränderungen anpassen. Allerdings verursacht jede erneute Inferenz Kosten und schwankende Ergebnisse. In einer Studie, die beide Technologietypen vergleicht (DOI: 10.1080/23311975.2026.2724760), wurden die beiden Prozesse P2 und P3 mit jeder Technologie jeweils zehnmal ausgeführt. Beim Prozess P1 gab es für den Agenten nur einen Fehlerfall, der nicht in die spätere Statistik einging. Man kann daher nicht pauschal sagen, dass alle Aufgaben zehnmal ausgeführt wurden. Die Studie verwendete eine Tool-Konfiguration aus dem Jahr 2025 und kann deshalb nicht direkt für die Leistung von Modellen im Jahr 2026 stehen.
Meiner Ansicht nach wird das bei CVS verfolgte Muster „AI-Erkundung, Überführung in Code, wiederholte Ausführung“ eher zum vorherrschenden Engineering-Ansatz: Agenten übernehmen die Erkundung und das Verständnis unbekannter Prozesse, deterministischer Code sorgt für die stabile Wiederholung bekannter Prozesse, APIs tragen weiterhin hochfrequente, strukturierte Interaktionen, und manuelle Freigaben sichern die kritischen Kontrollpunkte ab. Die Kombination aus API, Computer Use, deterministischem Code und menschlicher Freigabe ist realistischer, als alles auf eine einzige Technologie zu setzen.
Was bedeutet ein medizinischer Agent für die gesamte KI-Branche?
Die Medizin ist nur ein Testfeld mit hoher Eintrittsbarriere. Ihre Systeme sind fragmentiert, die Compliance-Anforderungen und die Haftungsgrenzen sind strenger als in gewöhnlichen Unternehmen. Wenn ein ausführender Agent hier eine auditierbare, pausierbare und an Berechtigungen ausgerichtete Betriebsweise etablieren kann, lässt sich dieser Ansatz auf Versicherungen, Finanzdienstleister, Verwaltung und andere Branchen übertragen, die ebenfalls von Altsystemen abhängen.
Das bedeutet auch, dass sich die Dimensionen des Wettbewerbs verändern. Früher ging es darum, ob ein Modell gute Inhalte schreiben kann; künftig geht es stärker darum, ob es in echten Systemen eine Aufgabe zu Ende bringt, ob es bei Fehlern rechtzeitig anhält und ob jeder Schritt nachvollziehbar protokolliert wird. Für Softwarehersteller heißt Computer Use, dass KI-Unternehmen an Workflows teilnehmen können, ohne die zugrunde liegende Software vollständig zu kontrollieren – das senkt die Integrationshürde und setzt das alte Muster „warten, bis der Hersteller eine Schnittstelle öffnet“ unter Druck. Hochzuverlässige, hochfrequente Interaktionen eignen sich aber weiterhin besser für APIs; Computer Use ist eher ein Ergänzer als ein Ersatz.
Als Nächstes lohnt es sich, einige Punkte im Auge zu behalten: ob OpenAI aufgabenbezogene Evaluationsdaten und vollständige Versuchskonfigurationen veröffentlicht; ob die Papierfassung von HealthAdminBench zum einheitlichen Vergleichsmaßstab der Anbieter wird; ob Abridges Lösung zur Entlassungskoordination von der Entwicklung in den produktiven Einsatz übergeht; und ob Produktionsdaten weiterer Krankenhäuser belegen können, dass die End-to-End-Abschlussrate tatsächlich brauchbar ist. Solange diese Belege fehlen, sind Demo und Bewertung nur ein Ausgangspunkt, kein Fazit.
Der medizinische Agent hat bewiesen, dass er „handeln“ kann. Ob er klinische und administrative Last wirklich verringert, hängt jedoch von seiner End-to-End-Abschlussrate in echten Workflows, seiner Fähigkeit zum Anhalten bei Fehlern und seinen langfristigen Kosten ab. Wie das englische Sprichwort sagt: The proof of the pudding is in the eating. (Die tatsächliche Wirkung muss sich in der Praxis erweisen.)
Referenzen
- Offizielle OpenAI-Ankündigung: Advancing computer-use agents for healthcare teams
- Link:
openai.com/index/advancing-computer-use-for-healthcare-teams
- Link:
- ChatGPT for Healthcare Hilfedokumentation: Produktfähigkeiten, BAA und Plugin-Beschreibung
- Link:
help.openai.com/en/articles/20001046-chatgpt-for-healthcare
- Link:
- OpenAI Computer Use Entwicklerdokumentation: Computer Tool und Code-Execution-Pfade
- Link:
developers.openai.com/api/docs/guides/tools-computer-use
- Link:
- HealthAdminBench-Paper: Aufgaben und Metriken der Version 2604.09937v1
- Link:
arxiv.org/html/2604.09937v1
- Link:
- CVS Health CUA Agent Kit: Zweistufige Explorations- und Verfestigungsarchitektur
- Link:
github.com/cvs-health/cua-agent-kit
- Link:
- Fierce Healthcare Bericht: HLTH26-Partner und Anwendungsszenarien
- Link:
fiercehealthcare.com/ai-and-machine-learning/hlth26-cvs-health-cigna-and-ambience-collaborating-openai-test-computer-use
- Link:
- Cambridge Dictionary: Abgleich des Originaltexts des Sprichworts
- Link:
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- Link:
Autor: APIYI Technikteam
Technischer Austausch: Wenn Sie die Leistung mehrerer großer Sprachmodelle im Agent-Textbereich vergleichen möchten, besuchen Sie gerne APIYI apiyi.com, um Testguthaben zu erhalten. Weitere Integrationshinweise finden Sie im Dokumentationszentrum docs.apiyi.com