Zusammenfassung: Das vom Entwickler selbst beschriebene Saltline-Experiment zeigt, wie Long-Horizon-Codegenerierung einen spielbaren Prototyp hervorbringt. Um die geschätzten API-Kosten zu verstehen, muss man Cache-Abrechnung und Ausgabe-Abrechnung zusammen betrachten.
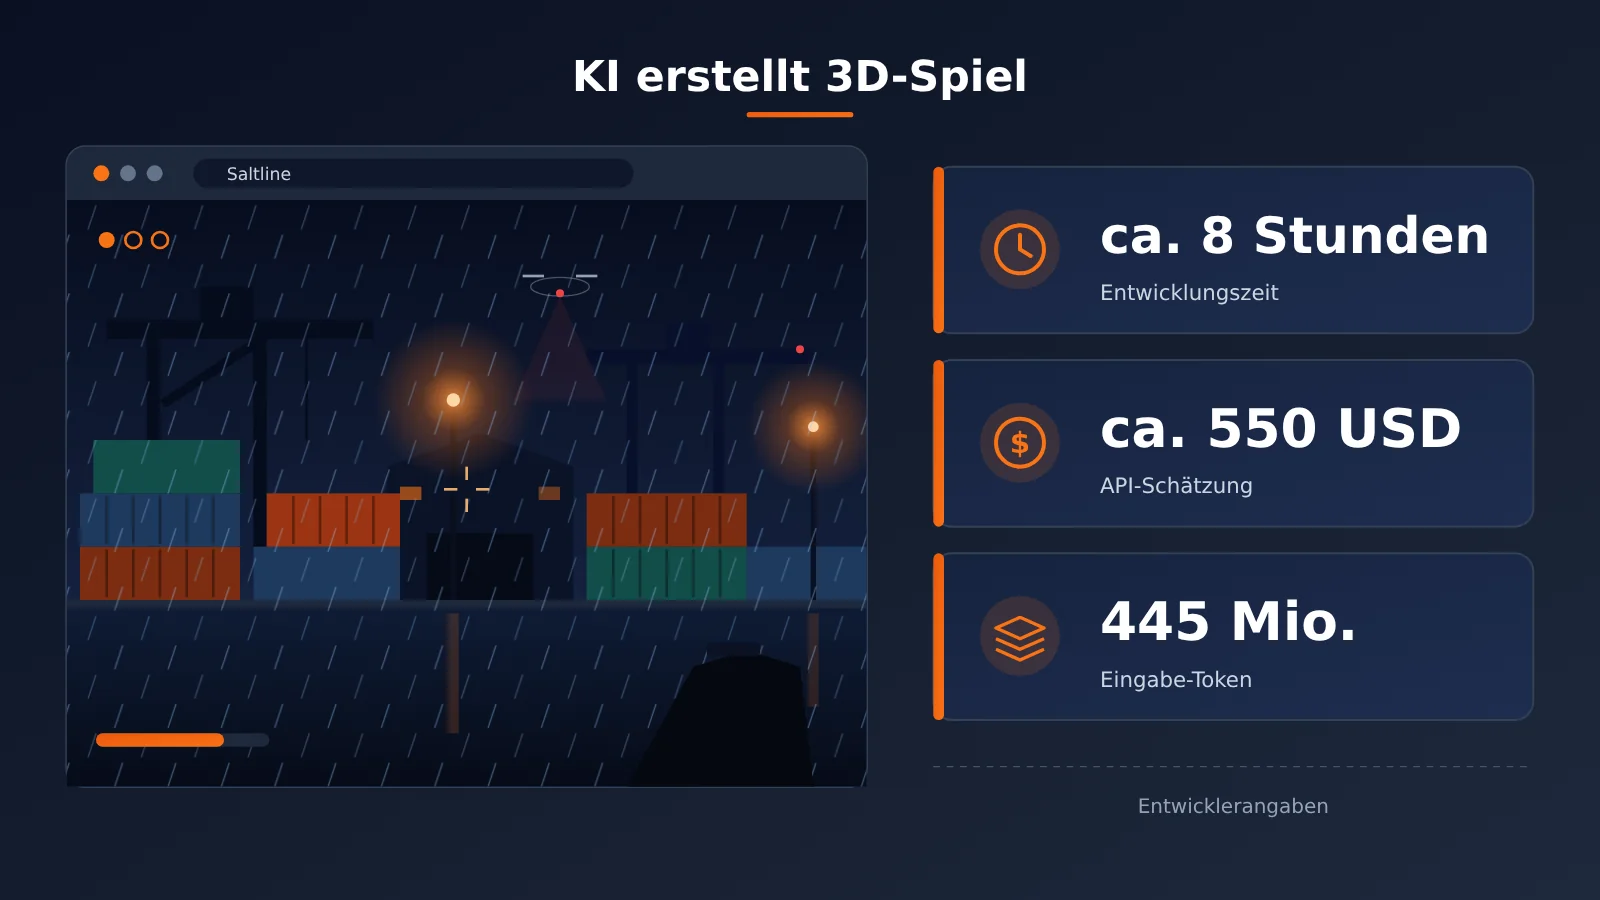
Am 9. November 2026 veröffentlichte der Anthropic-Ingenieur Felix Rieseberg ein Experiment. Er gab Claude Fable 5.2 nur eine einzige Eingabeaufforderung, danach kein menschliches Feedback, und erhielt am Ende ein 3D-Ego-Shooter-Spiel namens Saltline, das direkt im Browser läuft. Nach seinen eigenen Angaben dauerte die Generierung etwa 8 Stunden, verbrauchte rund 445 Millionen Eingabe-Token und etwa 2,7 Millionen Ausgabe-Token; zu API-Preisen geschätzt beliefen sich die Kosten auf etwa 550 US-Dollar.
An diesem Experiment sind zwei Dinge besonders bemerkenswert. Erstens hat das Modell Aufgaben, die sonst auf verschiedene Rollen verteilt sind – Szenenaufbau, Spiellogik, 3D-Modelle und Texturen, Shader, Soundeffekte und Spielerinteraktion – in derselben Long-Horizon-Codegenerierungsaufgabe zusammengeführt; sämtliche visuellen Inhalte liegen als Code und Funktionen vor. Zweitens: Würden alle 445 Millionen Eingabe-Token zum normalen Input-Preis abgerechnet, lägen die Kosten über 3.500 US-Dollar. Die vom Entwickler gemeldete Schätzung beträgt jedoch nur etwa 550 US-Dollar, und die Differenz stammt vor allem aus dem Caching-Mechanismus. Die Wirtschaftlichkeit komplexer KI-Entwicklungsaufgaben hängt davon ab, wie stark der Kontext wiederverwendet wird; wer nur die Input- und Output-Preise betrachtet, kommt zu stark verzerrten Schlussfolgerungen.
Im Folgenden stelle ich zuerst die öffentlich verfügbaren Daten und Versuchsbedingungen von Saltline vor, schlüssele dann auf, welche Teile der Spieleentwicklung die KI konkret übernommen hat, und rechne anschließend mit den offiziellen Preisen von Fable 5.2 nach, woher die 550 US-Dollar stammen und wo die Grenzen der Nachrechnung liegen. Danach folgt ein Kostenrahmen, der Modellaufruf, Entwicklungsausführung und Produktbetrieb voneinander unterscheidet; zum Schluss geht es um die Kluft zwischen einem spielbaren Prototyp und einem kommerziellen Spiel bei dieser Art KI-basierter Solo-Entwicklung.
Zum Verständnis: Die Terminologie der KI-3D-Spielexperimente
| Begriff | Erklärung |
|---|---|
| Token | Die Messeinheit, in der ein Modell Ein- und Ausgaben verarbeitet; die API rechnet nach der Anzahl der Tokens ab. |
| API | Die Schnittstelle, über die Anwendungen Modelldienste aufrufen; Entwickler binden das Modell auf diesem Weg in ihre eigene Software ein. |
| Eingabe-Caching (Prompt Caching) | Das Zwischenspeichern der Verarbeitungsergebnisse wiederkehrender Kontexte, die spätere Anfragen direkt wiederverwenden – das senkt Kosten und Latenz. |
| Cache-Schreiben | Das erstmalige Ablegen wiederverwendbarer Kontexte im Cache; der Stückpreis ist meist höher als bei normaler Eingabe. |
| Cache-Lesen | Spätere Anfragen treffen einen vorhandenen Cache und werden zu einem deutlich niedrigeren Preis als normale Eingaben abgerechnet. |
| TTL | Die Gültigkeitsdauer des Caches; nach Ablauf muss er neu beschrieben werden. Fable 5.2 bietet zwei Stufen: 5 Minuten und 1 Stunde. |
| Batch-API | Eine Aufrufmethode für asynchrone Stapelaufgaben, geeignet für Szenarien ohne sofortige Antwort, mit Rabattmöglichkeit. |
| Agent | Eine Modellanwendung, die Werkzeuge aufrufen, Dateien lesen und schreiben und mehrstufige Aufgaben ausführen kann. |
| Spielbarer Prototyp | Eine frühe Spielversion zur Validierung von Spielmechanik und technischer Machbarkeit, mit begrenzten Inhalten und wenig Feinschliff. |
| Shader | Ein kleines Programm, das auf der GPU läuft und mit mathematischen Funktionen Farben, Beleuchtung und Materialdarstellung bestimmt. |
| Prozedurale Generierung | Das Konstruieren von Modellen, Texturen, Klängen und anderen Inhalten zur Laufzeit mithilfe von Regeln und Algorithmen, anstelle vorab erstellter Asset-Dateien. |
| WebGL / Three.js | WebGL ist die 3D-Rendering-Schnittstelle, über die der Browser die GPU anspricht; Three.js ist eine darauf aufbauende JavaScript-3D-Grafikbibliothek. |
1 Acht Stunden, 550 US-Dollar: Wie ein KI-3D-Spiel entsteht
1.1 Versuchsbedingungen: eine einzige Eingabeaufforderung, kein menschliches Feedback
Felix Rieseberg gab dem Modell eine klare Aufgabe: ein kleines First-Person-Shooter-Spiel zu bauen, dessen Optik so nah wie möglich an ein AAA-Spiel heranreicht – und zwar ohne dass im Anschluss menschliches Feedback eingebracht wurde. Bei der Veröffentlichung betonte er, er wolle gerade testen, wie weit ein Modell ohne Eingreifen von außen kommt.
Das „3A“ ist hier Versuchsziel und optischer Vergleich. AAA bezeichnet normalerweise kommerzielle Spiele mit hohem Budget und großem Entwicklerteam. Saltline dagegen ist ein kleiner, spielbarer Prototyp mit genau einem Missionslevel und einem Fokus auf Einzelspieler-Erfahrung.
1.2 Was in Saltline steckt
Saltline spielt in einem Containerhafen in einer Regenacht. Es gibt Lagerhallen, Kais und gestapelte Container. Die Spielerin bzw. der Spieler muss drei Signalrelais abschalten und sich dann zurückziehen, unterwegs warten Patrouillendrohnen in der Luft und mechanische Spürhunde am Boden.
Das Spiel unterstützt First-Person-Bewegung, Blicksteuerung, Schießen, Interaktion und Missionsziele; dazu kommen Regen, Licht, Umgebungsgeräusche und Waffeneffekte. Auch der Einstieg ist unkompliziert: Browser öffnen und losspielen, per Maus und Tastatur oder per Touchscreen. Die Seite bietet Einstellungen zur Grafikqualität, bei Rucklern lässt sich auf niedrigere Qualität umschalten.
1.3 Die vom Entwickler veröffentlichten Daten
Alle folgenden Zahlen stammen aus öffentlichen Angaben von Felix Rieseberg selbst auf X; der GitHub-Mirror weist ebenfalls darauf hin, dass diese Werte nicht von Dritten unabhängig geprüft wurden.
| Projekt | Vom Entwickler angegebene Werte |
|---|---|
| Modell | Claude Fable 5.2 |
| Entwicklungszeit | etwa 8 Stunden |
| Eingabe-Token | etwa 445 Millionen (mit intensiver Cache-Nutzung) |
| Ausgabe-Token | etwa 2,7 Millionen |
| Geschätzte Kosten | etwa 550 US-Dollar (geschätzt anhand der API-Preise) |
| Entwicklungsweise | eine einzige Eingabeaufforderung, keine Iteration mit menschlichem Feedback |
| Größe des Artefakts | eigenständige HTML-Version ca. 1,43MB (1,425,707 bytes) |
Die 550 US-Dollar sind die geschätzten Kosten eines einmaligen Modelllauf-Experiments. Nachdem die Spieldatei erzeugt ist, läuft sie im lokalen Browser der Spielenden und löst keine weiteren Claude-API-Aufrufe aus – das Geld hängt also nicht von der Zahl der Spielenden ab.
2 Welche Aufgaben die KI in dieser 3D-Spielentwicklung übernommen hat
2.1 Alle Modelle und Texturen sind Code
Am 10. November erklärte der Entwickler ergänzend: Modelle, Texturen und andere Inhalte im Spiel bestehen vollständig aus von Claude generiertem Code und Shadern; im Projekt gibt es keine separaten Bild- oder 3D-Modell-Assets. Auf den Punkt gebracht: „Alles ist Code, Texturen und Modelle sind Funktionen.“
Das erklärt, warum Saltline nur etwa 1,43 MB groß ist. Herkömmliche Spiele müssen zahlreiche fertig erstellte Modelle, Texturen und Sounddateien ausliefern; Saltline liefert die mathematischen Regeln, mit denen diese Inhalte erzeugt werden. Der Browser liest den Code und baut die Szene zur Laufzeit in Echtzeit auf.
2.2 Sechs Bereiche, gebündelt in einer einzigen Generierungsaufgabe
In der klassischen 3D-Spielentwicklung übernehmen üblicherweise verschiedene Rollen Design, Modellierung, Materialien, Programmierung und Audio. Bei Saltline hat das Modell im selben Projekt nacheinander die folgenden Arbeiten erledigt:
- Szenenaufbau: Hafen, Lagerhäuser, Container und andere Strukturen werden programmatisch aus Vertices und Geometrieparametern konstruiert.
- Spiellogik: Missionsziele, Gegnerverhalten, Treffererkennung beim Schießen und der Evakuierungsablauf.
- Modelle und Texturen: Metalloberflächen, Verschmutzungen und Farbveränderungen werden mit Rauschen und mathematischen Funktionen erzeugt.
- Shader: Beleuchtung, Materialien, Reflexionen in der Regennacht und weitere visuelle Effekte werden auf der GPU berechnet.
- Soundeffekte: Umgebungsgeräusche und Waffenklänge werden ebenfalls programmatisch erzeugt.
- Spielerinteraktion: Tastatur- und Mauseingabe, Touch-Steuerung, Kamerasteuerung und Grafikeinstellungen.
Diese Bereiche erforderten im klassischen Workflow Übergaben zwischen verschiedenen Tools und Personen; in Saltline wurden sie zu unterschiedlichen Modulen in derselben Codebasis. Die Langkontextfähigkeit des Modells ermöglichte es, bestehenden Code und technische Lösungen kontinuierlich weiterzulesen und die Module miteinander zu verzahnen.
2.3 Wie der Browser das Spiel ausführt
Saltline setzt auf lokales Rendering im Browser; die Bilder werden auf dem Gerät des Spielers erzeugt. Der Ablauf sieht ungefähr so aus:
- Der Browser liest die HTML-Datei und beginnt mit der Ausführung von JavaScript.
- Three.js und die WebGL-Rendering-Umgebung werden initialisiert.
- Das Programm erzeugt gemäß dem Code Szenengeometrie, Materialien, Texturen und Sounds.
- Die GPU übernimmt das Grafik-Rendering, der Spieler steuert die Figur per Tastatur, Maus oder Touch-Eingabe.
- Die Spiellogik wird fortlaufend aktualisiert, der Browser zeichnet das Bild neu.
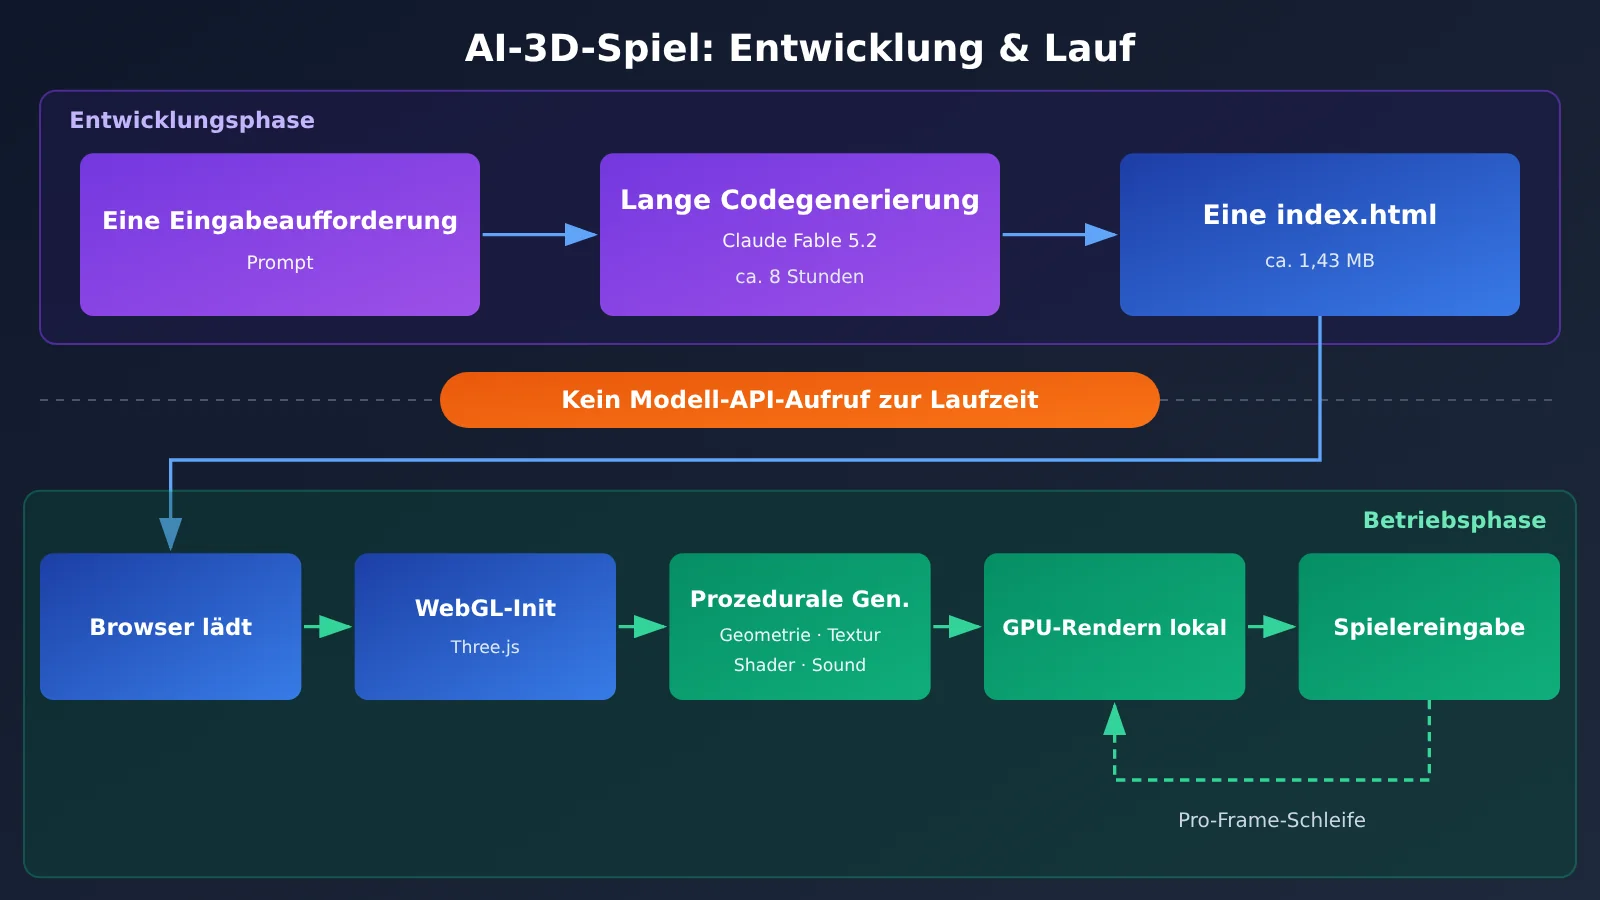
Kleine Dateigröße und geringe Laufzeitlast sind zwei verschiedene Dinge. 1,43 MB Code können zur Laufzeit eine große Menge an Geometrie und Materialien erzeugen; Speicher- und GPU-Last hängen von der Komplexität der Szene ab. Die eigenständige Demo-Seite weist ebenfalls darauf hin: Die Initialisierung kann langsam sein; bleibt der Bildschirm beim Warten stehen, sollte man WebGL 2 und die Hardwarebeschleunigung des Browsers prüfen. Bei Rucklern lässt sich auf niedrigere Grafikqualität umstellen.
3 Warum ein KI-3D-Spiel mit 445 Millionen Token nur 550 US-Dollar kostet
3.1 Die offiziellen Preise von Claude Fable 5.2
Fable 5.2 wurde am 9. November 2026 veröffentlicht, hat ein Kontextfenster von 1M Token und eine maximale Ausgabe von 128K Token. Die offiziellen Standardpreise sehen so aus:
| Abrechnungsposten | Preis pro Million Token | Relativ zur normalen Eingabe |
|---|---|---|
| Normale Eingabe | $8 | 100% |
| Ausgabe | $40 | 500% |
| 5-Minuten-Cache-Schreiben | $10 | 125% |
| 1-Stunden-Cache-Schreiben | $16 | 200% |
| Cache-Lesen | $0.20 | 2.5% |
Im Fast Mode liegen die Eingabepreise zusätzlich bei $16 und die Ausgabepreise bei $80 (pro Million Token); laut offiziellen Angaben lässt sich die Ausgabegeschwindigkeit damit um bis zu das 2.5-Fache steigern. Der Preis für das Cache-Lesen beträgt nur 2.5% des Preises für normale Eingaben – genau das ist der Schlüssel zum Verständnis der 550 US-Dollar.
3.2 Theoretische Kosten bei Abrechnung als normale Eingabe
Lässt man den Cache vollständig außer Acht und multipliziert die vom Entwickler veröffentlichten Token-Zahlen direkt mit dem Standard-Einzelpreis, weicht das Ergebnis deutlich von den 550 US-Dollar ab:
| Abrechnungsansatz | Eingabekosten | Ausgabekosten | Summe |
|---|---|---|---|
| Vollständig als normale Eingabe abgerechnet | 445 × $8 = $3,560 | 2.7 × $40 = $108 | $3,668 |
| Vollständig als Cache-Lesen abgerechnet (theoretische Untergrenze, Cache-Schreiben nicht berücksichtigt) | 445 × $0.20 = $89 | 2.7 × $40 = $108 | $197 |
| Schätzung des Entwicklers | — | — | ca. $550 |
Die beiden Extremrechnungen ergeben eine Spanne: Obergrenze rund 3.668 US-Dollar, Untergrenze rund 197 US-Dollar. Die vom Entwickler berichteten etwa 550 US-Dollar liegen innerhalb dieser Spanne und deutlich näher an der Untergrenze – das heißt, ein erheblicher Teil der Eingabe wurde zum Cache-Lesepreis abgerechnet.
Ein weiteres Detail ist erwähnenswert: Zum Standardpreis kosten 2,7 Millionen Ausgabe-Token etwa 108 US-Dollar, also rund ein Fünftel der 550-US-Dollar-Schätzung. Die Eingabemenge ist mehr als hundertmal so groß wie die Ausgabemenge – trotzdem macht der Ausgabeanteil durch den Cache-Mechanismus einen nicht unerheblichen Teil der Kosten aus.
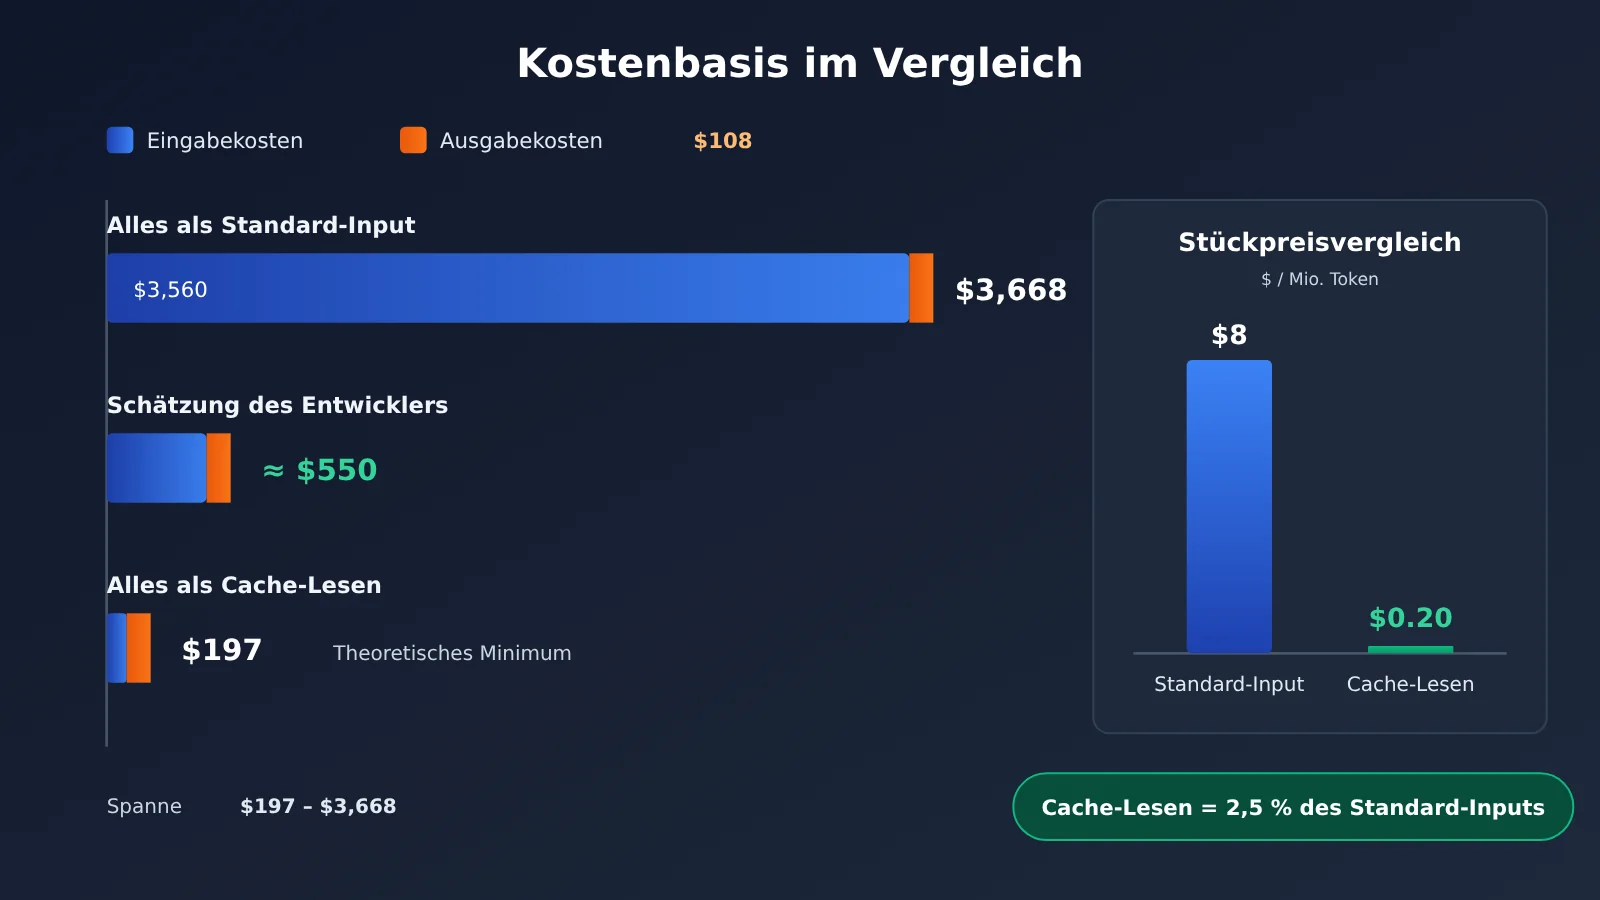
Die Preisgegenüberstellung in der obigen Grafik lässt sich direkt auf eigene Agent-Aufgaben übertragen, um eine Vorabschätzung vorzunehmen. Wer zunächst mit einer kleinen Aufgabe prüfen möchte, wie sich Cache-Treffer auf die Rechnung auswirken, kann auf APIYI apiyi.com mit demselben API-Schlüssel mehrere Modelle wie Claude aufrufen und anhand der Nutzungsdetails beobachten, wie sich die Kosten unter verschiedenen Kontextstrategien verändern.
3.3 Warum Caching die Kosten für langfristige Programmierung deutlich senkt
Bei langen, mehrrundigen KI-Programmierprozessen muss das Modell in jeder Runde eine große Menge identischer Inhalte erneut lesen: Projektkontext, Dateistruktur, vorhandener Code, Entwicklungsrichtlinien und die zuvor festgelegten technischen Lösungen. Ein 8-stündiger Generierungsprozess bedeutet, dass dieser Kontext immer wieder übermittelt wird – so summieren sich 445 Millionen Eingabe-Token.
Prompt Caching speichert diese wiederkehrenden Präfixe und rechnet bei einem Treffer nach dem Cache-Lese-Tarif ab. Die vollständige Cache-Rechnung ergibt sich aus drei Komponenten:
- Cache-Schreibvorgang (Cache Write): Der erste Schreibvorgang ist teurer als eine normale Eingabe – das 1,25-Fache bei der 5-Minuten-Stufe und das 2-Fache bei der 1-Stunden-Stufe.
- Cache-Lesevorgang (Cache Read): Bei späteren Treffern fällt nur noch 2,5 % des Preises an.
- Cache-Ablauf (TTL): Nach Ablauf der Gültigkeitsdauer muss der Cache neu geschrieben werden, wobei die Schreibkosten erneut anfallen.
Die Wahl der TTL-Stufe, die Stabilität der Kontextstruktur und der Abstand zwischen zwei Anfragen beeinflussen also die endgültigen Kosten. Werden Inhalte am Anfang des Kontexts häufig geändert, wird der Cache ungültig – und die Schreibkosten steigen dadurch zusätzlich.
3.4 Wie weit sich die öffentlichen Daten nachrechnen lassen
Die derzeit öffentlich zugänglichen Unterlagen nennen zwar die Gesamteingabe, die Gesamtausgabe und den geschätzten Gesamtpreis, enthalten aber keine vollständige Abrechnungsaufstellung. Die folgenden entscheidenden Angaben sind nicht veröffentlicht:
- die Token-Mengen für normale Eingabe, Cache-Schreiben und Cache-Lesen jeweils;
- die jeweilige Nutzung des 5-Minuten-Caches und des 1-Stunden-Caches;
- ob zusätzliche Kosten für weitere API-Aufrufe anfallen.
Da das Cache-Schreiben zwei Preisstufen hat, stehen mehr Unbekannte als bekannte Bedingungen gegenüber. Allein aus diesen drei Zahlen lässt sich daher keine eindeutige Cache-Trefferquote ableiten. Festhalten lässt sich: Die 550 US-Dollar liegen innerhalb des oben genannten theoretischen Bereichs, und der Cache hat in diesem Experiment den größten Teil der Kostensenkung getragen.
4 Wie sich die tatsächlichen Kosten von KI-Programmieraufgaben berechnen lassen
4.1 Ein Kostenrahmen mit drei Ebenen
Wenn man darüber diskutiert, „wie viel Geld KI kostet, um ein Spiel zu entwickeln“, muss man zuerst klären, welche Kostenebene man eigentlich berechnet. Die 550 US-Dollar von Saltline decken nur die erste Ebene ab.
| Kostenebene | Inhalt | Bei Saltline berücksichtigt |
|---|---|---|
| Kosten für Modellaufrufe | Eingabe, Ausgabe, Cache-Schreiben und -Lesen, Batch-Rabatt, Tool-Aufrufe | Ja (ca. 550 US-Dollar, Schätzung des Entwicklers) |
| Kosten für Entwicklung und Ausführung | Aufgabendesign, Debugging und Tests, Laufzeitumgebung, Code-Repository, externe Ressourcen, Arbeitszeit des Teams | Nicht veröffentlicht |
| Kosten für den Produktbetrieb | Hosting, CDN-Traffic, Datenbank, Online-Dienste, laufende Wartung | Nicht eingerechnet |
Die Struktur eines lokalen Browserspiels sorgt dafür, dass sich die KI-Kosten auf die Entwicklungsphase konzentrieren – das Rendering übernehmen die Geräte der Spieler. Cloud-Gaming und Echtzeit-Weltmodelle auf KI-Basis erzeugen dagegen bei jedem einzelnen Spielzug kontinuierlich Serverrechenkosten. Die Kostenkurven dieser beiden Produkttypen könnten unterschiedlicher kaum sein.
4.2 Für welche Schritte sich die Batch API eignet
Die offizielle Claude-API bietet eine Batch API: Passende Batch-Eingaben und -Ausgaben erhalten 50 % Rabatt. Sie eignet sich für nicht echtzeitfähige Codegenerierung, Batch-Verarbeitung von Inhalten und Offline-Evaluierungen – zum Beispiel, um auf einen Schlag Konfigurationen für mehrere Level zu erzeugen oder Code-Reviews im Batch laufen zu lassen.
Eine agentenbasierte Entwicklung wie bei Saltline muss anhand des Ergebnisses des vorherigen Schritts entscheiden, was als Nächstes passiert. Das ist ein stark interaktiver, serieller Ablauf, auf den sich der Batch-Rabatt kaum direkt anwenden lässt. In der Praxis ist es sinnvoller, aufzuteilen: Der Hauptentwicklungszyklus setzt auf Caching, um Kosten zu senken, während parallelisierbare Offline-Teilaufgaben an die Batch API gehen.
4.3 Mit Code die eigene KI-Programmierrechnung schätzen
Das folgende Minimalbeispiel zeigt, wie du über eine OpenAI-kompatible Schnittstelle einen Aufruf startest und die zurückgegebenen Nutzungsfelder ausliest – als Ausgangspunkt für die Kostenstatistik:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche APIYI-Schnittstelle
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_NAME",  # Durch einen Modellnamen wie Claude aus der Modellliste der Plattform ersetzen
    messages=[{"role": "user", "content": "用 Three.js 写一个旋转的立方体"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # prompt_tokens / completion_tokens für die Kostenabrechnung erfassen
Vollständige Implementierung ansehen: Kostenrechner mit Cache-Abrechnungslogik
import openai
from dataclasses import dataclass

# Offizielle Standardpreise für Claude Fable 5.2 (USD / Million Token)
PRICE = {
    "input": 8.0,
    "output": 40.0,
    "cache_write_5m": 10.0,
    "cache_write_1h": 16.0,
    "cache_read": 0.20,
}

@dataclass
class Usage:
    input_tokens: float = 0        # Normale Eingabe
    cache_write_5m: float = 0      # 5-Minuten-Cache-Schreibvorgang
    cache_write_1h: float = 0      # 1-Stunden-Cache-Schreibvorgang
    cache_read: float = 0          # Cache-Lesevorgang
    output_tokens: float = 0       # Ausgabe

def estimate_cost(u: Usage) -> float:
    """Summiert die einzelnen Abrechnungsposten, Einheit: USD"""
    m = 1_000_000
    return (
        u.input_tokens / m * PRICE["input"]
        + u.cache_write_5m / m * PRICE["cache_write_5m"]
        + u.cache_write_1h / m * PRICE["cache_write_1h"]
        + u.cache_read / m * PRICE["cache_read"]
        + u.output_tokens / m * PRICE["output"]
    )

# Reproduziert die beiden theoretischen Grenzfälle aus dem Text (vom Entwickler angegebene Token-Gesamtzahl)
upper = estimate_cost(Usage(input_tokens=445e6, output_tokens=2.7e6))
lower = estimate_cost(Usage(cache_read=445e6, output_tokens=2.7e6))
print(f"全部普通输入:${upper:,.0f}")   # ca. $3,668
print(f"全部缓存读取:${lower:,.0f}")   # ca. $197

# Tatsächlichen Verbrauch im eigenen Projekt kumulieren
client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def run_step(messages, model="YOUR_MODEL_NAME"):
    resp = client.chat.completions.create(model=model, messages=messages)
    usage = resp.usage
    print("prompt:", usage.prompt_tokens, "completion:", usage.completion_tokens)
    return resp.choices[0].message.content
Der Rechner summiert die fünf Abrechnungsposten getrennt und du kannst direkt die Verbrauchswerte deines eigenen Projekts einsetzen. Je nach Plattform können die Cache-Felder unterschiedlich zurückgegeben werden; bei der Integration ist die usage-Struktur in der tatsächlichen Antwort maßgeblich.
🚀 Tipp für den schnellen Einstieg: Bevor du langlaufende Agent-Aufgaben in die Produktiventwicklung schickst, solltest du dir über APIYI apiyi.com das kostenlose Testguthaben für neue Nutzer holen, mit einer kleinen Three.js-Szene den Kreislauf „Generieren – Ausführen – Korrigieren“ durchlaufen und dabei den Token-Verbrauch jeder Runde protokollieren. Anschließend kannst du mit dem obigen Rechner das Budget für das komplette Projekt ableiten.
5 Wo liegen die Grenzen, wenn eine KI eigenständig 3D-Spiele entwickelt?
5.1 Spielbare Prototypen und ausgereifte kommerzielle Spiele
Saltline zeigt, dass ein Modell ohne menschliches Eingreifen ein vollständig spielbares kleines Spiel abliefern kann: mit Szenerie, Gegnern, Aufgaben und audiovisueller Darstellung. Ein ausgereiftes kommerzielles Spiel braucht dagegen jede Menge Levelinhalte, langfristige Balance-Anpassungen, Multi-Plattform-Support, Lokalisierung, Anti-Cheating und umfangreiche Nutzertests – all das steckt in diesem Einzelexperiment nicht drin.
Was in chinesischen sozialen Netzwerken als „Jimaos·chinesisches AAA-Spiel“ kursiert, ist tatsächlich die chinesische Version bzw. eine neu verpackte Version von Saltline. „Chinesisches AAA-Spiel“ ist nur der Name, der bei der Verbreitung verwendet wurde – die Entwicklungsleistung stammt weiterhin aus diesem Fable-5.2-Experiment.
5.2 Einmalige Generierung vs. kontinuierliche Wartung
Die einmalige Generierung löst das Problem „von null auf eins“. Versionsiterationen nach dem Launch, Bugfixes und zusätzliche Inhalte erfordern, dass Modell oder Entwickler den bestehenden Code immer wieder anpassen. Der Kontextumfang bei langfristiger Wartung wächst stetig, und Caching-Strategie sowie Code-Organisation wirken sich zunehmend spürbar auf die Folgekosten aus.
5.3 Funktionsvollständigkeit vs. Performance-Optimierung
Funktionale Verfügbarkeit und flüssiger Lauf sind zwei unabhängige Engineering-Ziele. Dass die Erfahrungsseite von Saltline Optionen für niedrige Grafikqualität sowie Hinweise zur Prüfung von WebGL 2 und Hardwarebeschleunigung anbietet, zeigt genau, dass die Performance weiterhin an Spielergeräte und Browserfähigkeiten gebunden ist. Auch die offizielle Unity-Dokumentation weist darauf hin, dass die Web-Plattform bei Dateisystem, Threads, Speicher und mobiler Geräteunterstützung Einschränkungen hat – die Browser-Performance-Optimierung komplexer Spiele bleibt schwierig.
5.4 Saltline als repräsentatives Experiment betrachten
Der Wert von Saltline liegt darin, dass es einen klaren Referenzpunkt liefert: Mit einem leistungsfähigen Langkontextmodell, vernünftiger Caching-Nutzung und einem klar definierten Einzelziel liegen die Modellaufrufkosten für die einmalige Generierung eines Browser-3D-Prototyps im Bereich von einigen hundert US-Dollar. Die 8 Stunden und 550 US-Dollar stammen aus der Selbstauskunft des Entwicklers über ein Einzelexperiment; bei anderen Entwicklern variieren die Ergebnisse je nach Eingabeaufforderungs-Design, Aufgabenkomplexität, Caching-Strategie und Modellversion.
Die Drittanbieter-Plattform AI8Games hat eine Reihe von Browserspielen gesammelt, an deren Generierung Modelle wie Claude Fable 5.2 beteiligt waren; bei der Recherche zeigte sie 62 spielbare Spiele und 27 Video-Präsentationswerke. Das sind von Dritten zusammengestellte Daten – sie belegen, dass solche Experimente zunehmen, sind aber keine offizielle Statistik.
💡 Auswahlhinweis: Modelle unterscheiden sich deutlich bei langfristiger Codegenerierung, Caching-Preisen und Ausgabepreisen; die Gesamtrechnung für dieselbe Spielprototyp-Aufgabe kann bei verschiedenen Modellen um ein Mehrfaches auseinanderliegen. Es empfiehlt sich, auf APIYI apiyi.com mit derselben Eingabeaufforderung die Ausgabequalität und den Token-Verbrauch mehrerer gängiger Modelle zu vergleichen, bevor man entscheidet, welches Modell für die eigentliche Entwicklung verwendet wird.
6 Häufige Fragen zum KI-3D-Spiel-Experiment
F1: Sind die 550 US-Dollar von Saltline eine tatsächlich bezahlte Rechnung?
Es handelt sich um eine Schätzung von Felix Rieseberg auf Basis der API-Preise, die nicht von Dritten geprüft wurde. Öffentlich verfügbare Informationen enthalten auch keine separaten Verbrauchsmengen für normale Eingaben, Cache-Schreibvorgänge und Cache-Lesevorgänge, weshalb sich die Rechnungsstruktur nicht exakt rekonstruieren lässt.
F2: Warum kosten 445 Millionen Input-Token so wenig?
Bei Long-Horizon-Programmierung wird derselbe Projektkontext immer wieder eingereicht. Dieser Teil wird bei einem Cache-Treffer mit $0,20 pro Million Token abgerechnet – nur 2,5 % des Preises für normale Eingaben von $8. Würde man alles als normale Eingabe abrechnen, wären es etwa 3668 US-Dollar; der Entwickler schätzt rund 550 US-Dollar. Die Differenz stammt hauptsächlich aus dem Cache.
F3: Entstehen bei jedem Spielzug des Spielers Kosten für KI-Aufrufe?
Nein. Saltline ist nach der Generierung eine HTML-Datei mit etwa 1,43 MB. Das Spiel läuft lokal im Browser des Spielers und wird von der GPU seines Geräts gerendert; während der Ausführung werden keine Modell-APIs aufgerufen. Die 550 US-Dollar sind einmalige Kosten in der Entwicklungsphase.
F4: Wie lässt sich diese Art der Long-Horizon-Codegenerierung im eigenen Projekt wiederverwenden?
Der Kern besteht darin, das Modell dauerhaft auf einer stabilen Kontextstruktur arbeiten zu lassen: Spezifikationen, technisches Konzept und Dateistruktur gehören in den festen vorderen Teil der Eingabeaufforderung, damit sie cachefähig bleiben; in jeder Runde sollten die usage-Werte protokolliert werden, um das Budget abzuschätzen. Zunächst kann man mit dem kostenlosen Kontingent auf APIYI apiyi.com ein kleines Szenario durchlaufen lassen und prüfen, ob Caching und Verbrauchsstatistik den Erwartungen entsprechen, bevor man den Aufgabenumfang vergrößert.
F5: Kann ein Entwickler mit demselben Budget ein ähnliches Spiel nachbauen?
Das Ergebnis hängt von der Eingabeaufforderung, der Zielkomplexität, der Cache-Strategie und der Modellwahl ab. Saltline ist ein erfolgreiches einmaliges Experiment und eignet sich als Größenordnungs-Referenz. Für ein reales Budget empfiehlt es sich, vom tatsächlichen Verbrauch eines kleinen Testlaufs auszugehen. Über die einheitliche Schnittstelle von APIYI apiyi.com lassen sich verschiedene Modelle im selben Code umschalten, was einen direkten Kostenvergleich erleichtert.
F6: Worin unterscheidet sich Saltline von KI-generierten Spielen wie Genie 3?
Bei Saltline schreibt die KI Code, der im Browser ausgeführt wird: Die Spielregeln sind vorab geschrieben, und die Grafik wird von der lokalen GPU gerendert. Weltmodelle wie Genie 3, Muse oder Oasis sagen dagegen anhand des aktuellen Zustands und der Eingaben des Spielers das nächste Bild in Echtzeit voraus. Das erfordert kontinuierliche Inferenz, und jeder Spielzug verursacht Rechenkosten. Die Kostenstruktur und die technischen Grenzen dieser beiden Ansätze unterscheiden sich grundlegend.
7 Zusammenfassung: Wie die Zahlen 550 US-Dollar und 8 Stunden einzuordnen sind
Das Experiment von Saltline zeigt drei Dinge:
- KI kann mehrere Spieleentwicklungsphasen in einen einzigen Code-Generierungsvorgang integrieren: Szene, Logik, Modelle, Texturen, Shader, Soundeffekte und Interaktion werden in Codeform ausgeliefert; das Produkt ist ein etwa 1,43 MB großes Browser-Spiel in einer einzigen Datei.
- Caching entscheidet über die Wirtschaftlichkeit langfristiger KI-Programmierung: 445 Millionen Eingabe-Token würden zum Normalpreis etwa 3668 US-Dollar kosten; die vom Entwickler selbst genannte Schätzung liegt bei etwa 550 US-Dollar, wobei der Einzelpreis für Cache-Lesevorgänge von 2,5 % die entscheidende Variable ist.
- 550 US-Dollar sind nur die Modellaufruf-Kosten: Ausführung der Entwicklung, Betrieb des Produkts und spätere Wartung kommen zu dieser Zahl noch hinzu; Saltline ist ein repräsentatives, spielbares Prototyp-Experiment.
Wenn Sie planen, einem Agenten ähnliche langfristige Entwicklungsaufgaben zu übertragen, ist die wirksamste Vorbereitung, zunächst eine Gewohnheit der Kostenkalkulation zu etablieren: Erfassen Sie Eingabe-, Cache- und Ausgabeverbrauch getrennt und leiten Sie das Budget dann aus realen Daten ab. Es empfiehlt sich, die Ergebnisse schnell über APIYI apiyi.com zu validieren; die Plattform bietet eine OpenAI-kompatible Schnittstelle, einheitliche Aufrufe mehrerer Modelle und ein kostenloses Testkontingent für neue Nutzer.
Referenzen
- Eigenständige Saltline-Demo-Seite: Spieltest und FAQ-Informationen
- Link:
saltline.games -
Beschreibung: Enthält Informationen zu Initialisierung, Grafik-Einstellungen, Steuerung und weiteren Aspekten des Spielerlebnisses; die chinesische Version liegt unter
saltline.games/zh -
Original-Beitrag von Felix Rieseberg: Quelle für Entwicklungszeit, Token- und Kostendaten
- Link:
x.com/felixrieseberg/status/2119925633564463609 -
Beschreibung: Primärdaten aus erster Hand, wie vom Entwickler selbst dargelegt
-
Saltline-Code-Mirror und README: Dateidaten und Angaben zur Datenherkunft
- Link:
github.com/realcodebear/saltline-fable-5.2 -
Beschreibung: Weist darauf hin, dass die betreffenden Zahlen nicht unabhängig von Dritten geprüft wurden
-
GitHub-Repository der chinesischen Jimao-Version: Archiv der in China verbreiteten Fassung
- Link:
github.com/Megasu/jimao-3a-game -
Beschreibung: Enthält Angaben zur Dateigröße von index.html und Hinweise zum Offline-Betrieb
-
Modellspezifikationen und Preise von Claude Fable 5.2: Offizielle Anthropic-Dokumentation
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview -
Beschreibung: Offizielle Einzelpreise für Ein- und Ausgabe sowie für Cache-Schreiben und Cache-Lesen
-
Offizielle Three.js-Dokumentation: 3D-Grafikbibliothek für den Browser
- Link:
threejs.org/docs -
Beschreibung: Grundlagenmaterial zum Verständnis, wie die Saltline-Szene aufgebaut wird
-
Technische Übersicht zu Unity WebGL: Erläuterung der Einschränkungen der Web-Plattform
- Link:
docs.unity.cn/6000.0/Documentation/Manual/webgl-technical-overview.html - Beschreibung: Einschränkungen von Browser-Spielen bei Threads, Speicher und Mobilgeräten
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gern über die Startseite von APIYI apiyi.com; weitere Integrationsunterlagen finden Sie im Dokumentationszentrum unter docs.apiyi.com