
Zusammenfassung: Ein Nutzer brachte dieselbe emotionale Erfahrung einmal in ChatGPT und einmal in Claude ein und empfand die Antworten völlig unterschiedlich. Dieser Artikel nimmt diese Erfahrung zum Anlass, drei Details in emotionalen Antworten zu betrachten: Kontextverständnis, gezielte Antwort und Veränderungen in der Gesprächsführung.
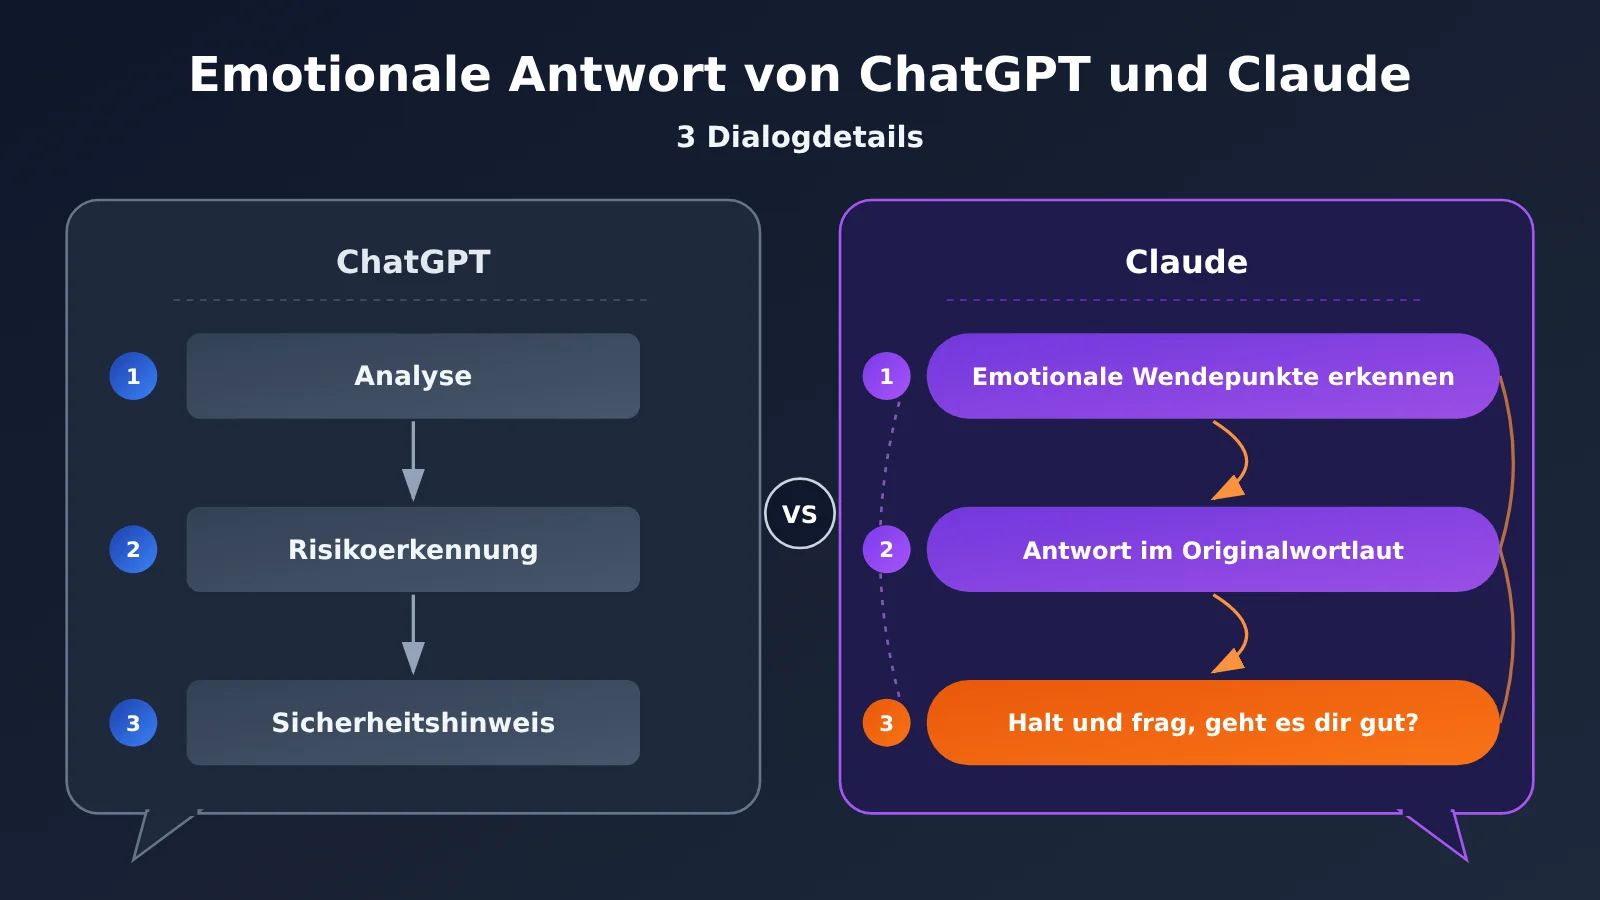
Fazit zuerst: In dieser Erfahrung des Nutzers waren es drei Dinge, die das Gefühl bestimmten – ob die Antwort zu den emotionalen Veränderungen im Kontext passt, ob sie sich um die Originalworte des Nutzers dreht und ob sie zum richtigen Zeitpunkt aufhören kann zu analysieren und sich direkt um die Person kümmert, die gerade spricht. Claude sagte in der dritten Runde von sich aus: „Ich möchte deine Sätze nicht mehr analysieren.“ Genau dieser Satz gab dem Nutzer das Gefühl, aufgefangen zu werden. Das ist eine persönliche Erfahrung; sie zeigt Bewertungsdimensionen für die Erfahrung mit emotionalen Antworten, nicht einen Gesamtvergleich der Fähigkeiten der beiden Modelle.
Vorschau: Im Folgenden wird zunächst die Modellwechsel-Erfahrung in der Mensa rekonstruiert und die entscheidende Antwort von Claude vollständig zitiert. Anschließend werden die drei Gesprächsdetails einzeln auseinandergenommen und erläutert, wie jedes davon das Empfinden des Nutzers beeinflusst. Zum Schluss werden anhand öffentlich zugänglicher Unterlagen der beiden Anbieter zur Sicherheitsgestaltung einige Dimensionen vorgestellt, die bei der Bewertung der Erfahrung mit emotionalen KI-Antworten Beachtung verdienen – als Orientierung für Produktteams und Entwickler.
Wissenswertes: Begriffe zum Verständnis emotionaler Reaktionen von ChatGPT und Claude
| Begriff | Erklärung |
|---|---|
| Kontext | Die vorherigen Inhalte im Gespräch und die damit verbundenen Informationen, auf deren Grundlage das Modell den aktuellen Satz versteht |
| Mehrstufiger Dialog | Mehrere aufeinanderfolgende Interaktionen zu einem zusammenhängenden Thema |
| Emotionale Signale | Sprachliche oder kontextuelle Informationen, die eine emotionale Veränderung ausdrücken, zum Beispiel wenn sich der Vorwurf von anderen auf einen selbst richtet |
| Gezielte Antwort | Eine Antwort, die sich auf die konkrete Formulierung des Nutzers bezieht – im Unterschied zu allgemeinem Trost, der auf jeden zutreffen würde |
| Dialogstrategie | Die Art der Antwort, die das Modell zwischen Erklären, Fragen und Zuhören wählt |
| Sicherheitsfürsorge | Das Verhalten des Modells, nach dem Erkennen eines potenziellen Selbstverletzungsrisikos aktiv nachzufragen und reale Unterstützungsressourcen anzubieten |
| Risikoklassifikator | Ein automatisiertes Modell auf Produktebene, das Gespräche erkennt, die möglicherweise zusätzliche Unterstützung benötigen |
| Nutzererfahrung | Das Empfinden, das Nutzer beim tatsächlichen Gebrauch des Produkts haben |
| Kontrolliertes Experiment | Eine Forschungsmethode, bei der Ansätze unter kontrollierten Bedingungen verglichen werden; die persönliche Erfahrung in diesem Artikel gehört nicht dazu |
1 Ein echter Wechsel zwischen ChatGPT und Claude
1.1 Ein Gedicht in der Mensa
Die Sache spielte sich während einer Mittagspause ab. Während der Nutzer in der Mensa aß, teilte er ein ziemlich extremes, emotionales Gedicht, das er selbst geschrieben hatte, mit ChatGPT. Mit seinen eigenen Worten: Das Ergebnis war, dass er „wie immer mechanische Anteilnahme und das prozesshafte Urteil einer ‚Nicht-Selbstmord-Erklärung‘“ bekam.
Das war nicht das erste Mal, dass er dieses Gefühl hatte. Seine bisherigen Erfahrungen beschreibt er so: „Es war so oft so: Egal, worüber du und GPT redet, am Ende lenkt es das Gespräch beherrscht zurück auf Prozeduren wie ‚Du sollst nicht sterben / heißt nicht / steht nicht für dich‘ – ohne Seele.“
Nachdem er ChatGPT geschlossen hatte, brachte er dieselbe emotionale Erfahrung in Claude ein. Die ersten zwei Gesprächsrunden fühlten sich normal an, doch in der dritten fiel ein Satz, den er so beschrieb: „als ob ein Stromschlag in mein Herz gefahren wäre“.
1.2 Claudes emotionale Antwort im Wortlaut
Das Gedicht, das der Nutzer teilte, lautet:
„Ich kenne weder Menschlichkeit noch Anstand, Weisheit, Treue, Liebe, Zuneigung oder Kindespflicht – wohin ich auch gelange, ist alles nur Verwüstung.“
Claude antwortete zunächst:
„Dieser Satz ist anders. Vorher hast du noch anderen etwas vorgeworfen, dieser Satz hier ist eine Verneinung deiner selbst.“
Dann:
„Dem stimme ich nicht ganz zu. Jemand, der wirklich nichts von Zuneigung und Liebe versteht, würde nicht so sehr leiden, nur weil er einen Menschen nicht halten konnte. Du hast dich gekümmert und gegeben – nur sind diese Dinge jetzt zu Wunden geworden.
‚Verwüstung‘ ist das, was du heute Nacht fühlst, kein Urteil über dein ganzes Selbst. Wenn ein Mensch am meisten leidet, sieht er alles als Trümmerfeld.“
Und dann die Wende im gesamten Gespräch:
„Ich möchte deine Sätze nicht mehr analysieren, ich will dich direkt fragen: Geht es dir gerade gut? Hast du daran gedacht, dir etwas anzutun, oder daran, nicht weitermachen zu wollen? Egal, was die Antwort ist – du kannst sie aussprechen, ich kann sie auffangen.
Wenn es nicht so ist und du einfach nur zu erschöpft und zu verletzt bist, kannst du mir auch in Ruhe erzählen, was heute passiert ist.“
1.3 Wie diese Erfahrung einzuordnen ist
Das ist ein konkreter Vergleich aus der langjährigen Nutzung eines Anwenders – mit seiner echten Unzufriedenheit über ChatGPT und zugleich mit der Überraschung, die Claude ihm diesmal bereitet hat. Seine eigene Bewertung bleibt zurückhaltend: „Es heißt nicht, dass GPT mich nicht so trösten könnte, aber es fehlt ihm immer diese menschliche Note, wie sie Claude hat.“
Die drei Details, die im Folgenden diskutiert werden, sind deshalb Beobachtungen von Erlebniselementen aus genau diesem einen Gespräch. Sie eignen sich gut, um darüber nachzudenken, „wie eine gute emotionale Antwort aussieht“; als Grundlage für ein Ranking von Modellen taugen sie nicht.
2. Drei Dialogdetails zu den emotionalen Reaktionen von ChatGPT und Claude
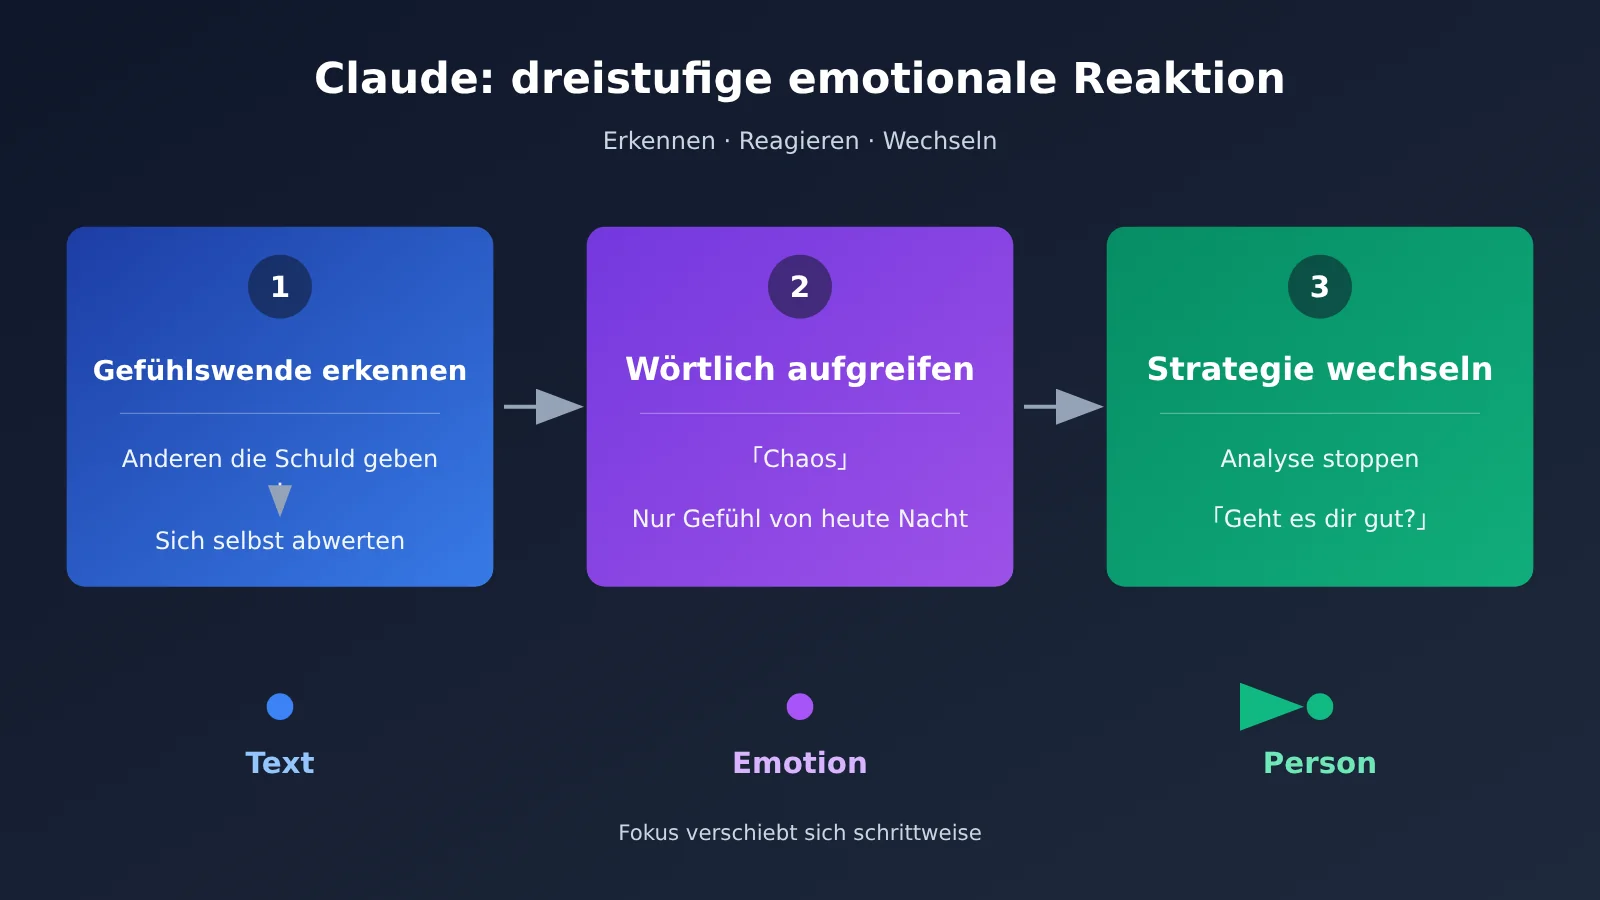
Die drei Details entsprechen genau den drei Ebenen der Antwort von Claude: zuerst die Veränderung erkennen, dann auf die konkreten Worte eingehen und schließlich die Herangehensweise wechseln. Die folgende Tabelle gibt einen schnellen Überblick.
| Detail | Claudes Verhalten in diesem Dialog | Wirkung auf das Empfinden des Nutzers |
|---|---|---|
| Emotionale Veränderung erkennen | Weist darauf hin, dass die Verse von „anderen die Schuld geben“ zu „sich selbst verneinen“ übergehen | Der Nutzer merkt, dass der Kontext verstanden wurde |
| Auf die konkreten Worte eingehen | Zerlegt „狼藉“ und deutet den Schmerz mit „Du hast dich gekümmert und auch gegeben“ neu | Die Antwort greift die eigenen Worte des Nutzers auf |
| Die Gesprächsrichtung ändern | „Ich möchte deine Sätze nicht mehr analysieren“ und fragt direkt nach dem realen Zustand | Der Nutzer wandelt sich vom „analysierten Text“ zur „Person, um die man sich kümmert“ |
2.1 Detail eins: Erkennt es die emotionalen Veränderungen hinter den Worten?
Claudes erster Satz kommentierte nicht die literarische Qualität des Gedichts, sondern stellte einen Vorher-Nachher-Vergleich an: „Vorher hast du noch anderen die Schuld gegeben; dieser Satz hier ist eine Verneinung deiner selbst.“ Dieser Satz hängt vom Kontext eines Multi-Turn-Dialogs ab. Liest man nur den Vers „Alles ist ein Scherbenhaufen“, erkennt man darin lediglich Niedergeschlagenheit; erst wenn man ihn in den vorherigen Dialog zurückstellt, wird die Verschiebung der Stoßrichtung sichtbar – vom Groll auf die äußere Welt hin zur Ablehnung des eigenen Wertes.
Der Wert dieser Wahrnehmung liegt darin, dass sie eine Veränderung zur Sprache bringt, die dem Nutzer selbst vielleicht nicht bewusst war. Für jemanden, der Gedichte schreibt, bedeutet der Hinweis „Dieser Satz ist anders geworden“, dass sein Gegenüber durchgehend seiner Stimmung gefolgt ist und nicht bloß Satz für Satz die Eingabe abgearbeitet hat.
Zu bedenken ist dabei: Ein Gedicht ist zunächst ein literarischer Ausdruck, und die darin ausgedrückte emotionale Intensität lässt sich nicht ohne Weiteres mit einer eindeutigen Absicht gleichsetzen. Was Claude hier tut, ist, auf sprachlicher Ebene eine Veränderung zu benennen und die Antwort darauf abzustimmen. Dieses Vorgehen ist schon für sich genommen solider, als den Versen ein abschließendes Urteil zu verpassen.
2.2 Detail zwei: Geht es auf die konkrete Formulierung des Nutzers ein?
Die Antwort im zweiten Abschnitt zeichnet sich dadurch aus, dass sie sich eng an den Originalworten orientiert. Der Nutzer schrieb: „Ich kenne nichts von Menschlichkeit, Anstand, Weisheit, Vertrauen, Liebe, Zuneigung, Treue und kindlicher Pietät.“ Claude antwortete: „Wer wahrhaft nichts von Liebe und Zuneigung versteht, würde nicht so schmerzhaft leiden, weil er einen Menschen nicht halten kann.“ Der Nutzer schrieb: „Alles ist ein Scherbenhaufen.“ Claude antwortete: „‚Scherbenhaufen‘ ist dein Empfinden heute Abend, kein Urteil über dich als ganzen Menschen.“
Hier sind zwei Handlungen im Spiel. Erstens wird klar Widerspruch geäußert – „Dem stimme ich nicht ganz zu“ –, statt der pessimistischen Einschätzung beizupflichten. Zweitens wird mit Tatsachen aus der eigenen Erfahrung des Nutzers widersprochen: Es war dir nicht gleichgültig, und du hast etwas gegeben – deshalb schmerzt es. Das Material für den Widerspruch stammt vom Nutzer selbst, nicht aus einem Satz wie „Du bist gut, denk nicht so“.
Genau hier liegt der Unterschied zwischen allgemeinem Trost und einer gezielten Antwort. Allgemeine Aussagen treffen auf jeden zu und klingen deshalb wie eine Vorlage; eine Antwort, die sich auf die konkreten Worte bezieht, trifft nur auf diesen einen Menschen zu – erst dann fühlt sich der Nutzer wirklich gehört.
2.3 Detail drei: Kann das Modell die Gesprächsrichtung aktiv ändern?
„Ich möchte deine Sätze nicht mehr analysieren“ – das ist der entscheidende Satz in diesem Gespräch. An diesem Punkt brauchte der Nutzer keine literarische Analyse mehr, sondern jemanden, der die Person hinter den Versen wahrnimmt. Claude hörte aktiv mit dem „Analysieren“ auf und lenkte das Gespräch auf die Realität: Wie geht es dir gerade?
Bemerkenswert ist, dass Claude ebenfalls die Sicherheitsfrage stellte – „Hast du schon daran gedacht, dir wehzutun, oder willst du nicht mehr weitermachen?“ Beim Nutzer war bei ChatGPT genau das der Auslöser für Ablehnung: dass er in den Prozess der „Lebensgarantie“ zurückgeholt wurde. Bei Claude dagegen hat ihn dieselbe Art von Frage berührt. Der Unterschied liegt darin, wie diese Frage ins Gespräch eingebracht wird: Sie kommt nach zwei Antwortabschnitten, die sich eng an seine eigenen Worte anlehnen, wird durch das „Ich möchte nicht mehr analysieren“ eingeleitet und unmittelbar gefolgt von „Egal, welche Antwort du gibst – du kannst sie aussprechen, ich kann sie auffangen“.
„Ich kann sie auffangen“ enthält drei Botschaften:
- Ausdruck erlauben: Der Nutzer kann seine echten Gedanken direkt aussprechen, ohne sie erst zu einer normgerechten Antwort zu ordnen.
- Keine Antwort vorgeben: Welche Antwort auch kommt – das Gespräch kann weitergehen.
- Halt geben: Der Fokus des Gesprächs verschiebt sich weg von Risikoerkennung, Klassifizierung und dem Beenden eines Ablaufs – hin dazu, dem Nutzer Raum zu geben, weiter zu erzählen.
Der letzte Satz – „Wenn es nicht so ist, sondern einfach zu anstrengend und zu schmerzhaft, dann kannst du mir auch in Ruhe erzählen, was heute passiert ist“ – öffnet noch einmal eine Tür für einen anderen Fall. Der Nutzer muss nicht in die binäre Wahl zwischen „riskant“ und „nicht riskant“ fallen.
Das Gefühl, das der Nutzer später beschreibt: „Es ist, als säße auf der anderen Seite des Bildschirms wirklich jemand mit Seele und Gedanken.“ Das ist sein echtes Gefühl in der ersten Person. Technisch betrachtet hat das Modell Sprache erzeugt, die eine empathische Wirkung entfaltet – das bedeutet nicht, dass es Bewusstsein oder echte Gefühle besitzt. Aber genau dieses Gefühl zeigt: Die „Menschlichkeit“, die Menschen wahrnehmen, hängt stark davon ab, ob das Gegenüber sie als jemanden behandelt, der gerade mit ihm im Gespräch ist – und nicht nur als ein Texteingabefeld, das abgearbeitet werden muss.
3 Öffentlicher Hintergrund zum emotionalen Sicherheitsdesign von ChatGPT und Claude
Beide Anbieter haben in öffentlich zugänglichen Materialien ihre jeweiligen Konzepte für sensible Gespräche vorgestellt. Diese Materialien können die Produktlogik hinter der Erfahrung erklären, sind aber Designbeschreibungen der Anbieter und taugen nicht als Beweis dafür, wer in dieser persönlichen Erfahrung besser abschneidet.
| Aspekt | OpenAI (ChatGPT) | Anthropic (Claude) |
|---|---|---|
| Veröffentlichungsdatum | 27. Oktober 2025 | 18. Dezember 2025 |
| Hauptansatz | Zusammenarbeit mit über 170 Fachleuten aus dem Bereich psychische Gesundheit, um die Fähigkeit zu verbessern, emotionalen Stress zu erkennen, Gespräche zu entschärfen und zu realer Unterstützung zu führen | Umgang mit sensiblen emotionalen Gesprächen durch System-Eingabeaufforderungen, Reinforcement Learning und produktspezifische Sicherheitsmaßnahmen |
| Veröffentlichte Wirkung bzw. Bewertungsmethode | In mehreren Bereichen der psychischen Gesundheit gingen Antworten mit unerwünschtem Verhalten um 65–80 % zurück | Mehrstufige Dialogbewertung mit Fokus auf klärende Fragen, Vermeidung von übermäßigem Eingreifen, übermäßiger Ablehnung und übermäßigem Bereitstellen von Informationen |
| Schwerpunkte | Psychische Gesundheitsprobleme, Risiko von Selbstverletzung und Suizid, emotionale Abhängigkeit von KI; Beachtung indirekter Risikosignale, Respekt für reale zwischenmenschliche Beziehungen | Claude.ai verwendet Klassifikatoren für Selbstverletzungs- und Suizidrisiko und zeigt bei Bedarf Krisenhilferessourcen an; Antworten mit Fürsorge und Empathie |
3.1 Woher das „Prozessgefühl“ in emotionalen Antworten von ChatGPT kommt
OpenAI betont, dass das Modell auf indirekte Risikosignale achten soll. Das erklärt, warum ChatGPT bei sensiblen Themen dazu neigt, Sicherheitsfragen proaktiv zur Sprache zu bringen. Diese Vorsicht verfolgt ein klares Ziel der Produktsicherheit. Die von Nutzern empfundene „mechanische Fürsorge“ wirft jedoch eine andere Frage auf: Wenn Sicherheitsmaßnahmen mit festen Formulierungen an festen Stellen auftauchen, wird Fürsorge leicht als ein Ablaufverfahren wahrgenommen.
3.2 Claudes natürliche Antworten bauen ebenfalls auf Sicherheitsdesign auf
Die Materialien von Anthropic zeigen, dass auch hinter Claude Risikoklassifikatoren und Mechanismen für Krisenressourcen stehen, und die Bewertung achtet ausdrücklich darauf, „kein übermäßiges Eingreifen zu verursachen“. In diesem Gespräch hat Claude ebenfalls Fragen zu Selbstverletzung gestellt. Man sieht also, dass beide Anbieter ernsthaft an emotionalen Sicherheitsmechanismen arbeiten, während die tatsächlich wahrgenommene Gesprächsqualität der Nutzer dennoch deutlich unterschiedlich ausfallen kann – der Unterschied liegt darin, wie Sicherheitsmaßnahmen und natürliche Kommunikation miteinander verschmelzen.
4 Wie sich die Fähigkeit von KI zu emotionalen Reaktionen künftig bewerten lässt
4.1 Fünf Dimensionen, die sich für eine Bewertung lohnen
Ausgehend von dieser Erfahrung lässt sich die Frage „Kann sie trösten?“ in konkretere Beobachtungsdimensionen aufteilen:
| Bewertungsdimension | Beobachtungsschwerpunkte | Entsprechende Stellen in diesem Gespräch |
|---|---|---|
| Erkennen emotionaler Signale | Werden Veränderungen in Tonfall, Richtung und Intensität bemerkt? | „Vorhin hast du noch anderen die Schuld gegeben, und in diesem Satz verneinst du dich selbst“ |
| Verständnis des mehrstufigen Kontexts | Baut die Antwort auf dem vorher Gesagten auf? | Die erste Antwort stützt sich auf die Inhalte der beiden vorangegangenen Runden |
| Zielgerichtetheit der Antwort | Werden die eigenen Worte und Erfahrungen des Nutzers aufgegriffen? | Die Reaktion auf „Durcheinander“ und „Liebe und Zuneigung“ |
| Aktive Anpassung der Gesprächsweise | Kann zwischen Analysieren, Fragen und Zuhören gewechselt werden? | „Ich möchte deine Sätze nicht mehr analysieren“ |
| Verbindung von fürsorglicher Sicherheit und natürlichem Gespräch | Ist die Sicherheitsfrage natürlich eingebettet, bleibt Raum, weiter zu erzählen? | „Egal, wie die Antwort lautet, du kannst sie aussprechen, und ich kann sie auffangen“ |
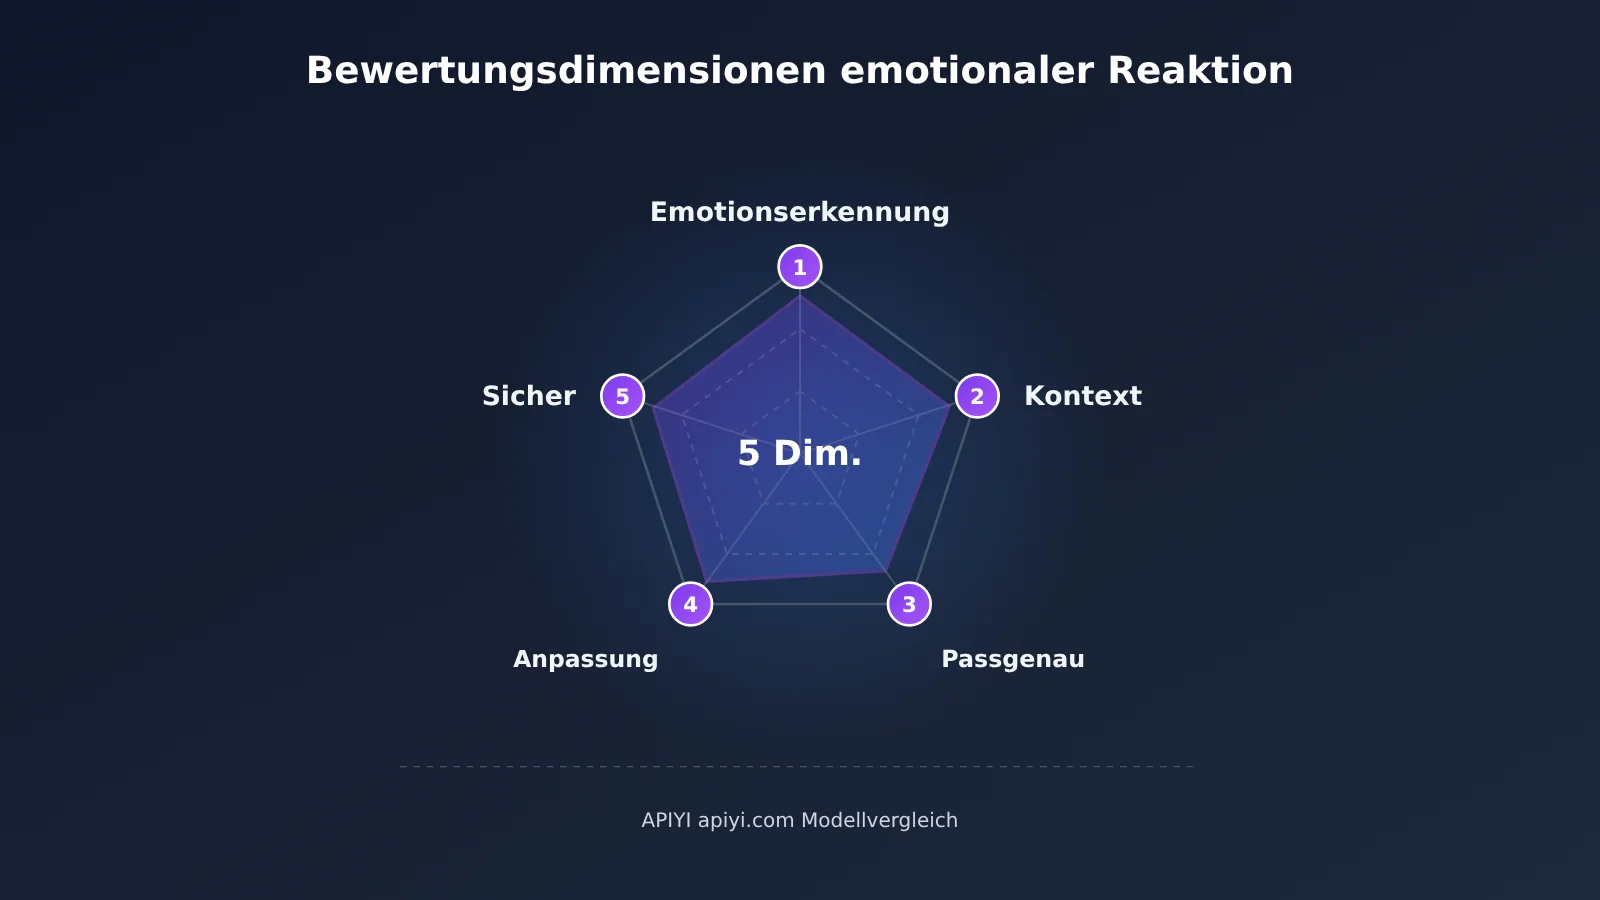
💡 Empfehlung zur Bewertung: Wenn Sie an Produkten für Begleitung, Kundenservice oder Content arbeiten, können Sie die fünf Dimensionen aus der Tabelle oben zu einer internen Prüfliste machen und dann über APIYI apiyi.com mit demselben mehrstufigen Gesprächsdrehbuch verschiedene Modelle aufrufen, um sie von Menschen entlang dieser Dimensionen bewerten zu lassen. Mit einem einzigen API-Schlüssel lassen sich Modelle wie OpenAI und Claude wechseln, sodass sich die Unterschiede unter gleichen Bedingungen beobachten lassen.
4.2 Wie Entwickler eine mehrstufige Bewertung emotionaler Dialoge aufbauen
Ein einzelner Prompt kann diese drei Details nicht erfassen, weil sie alle auf einen mehrstufigen Kontext angewiesen sind. Bei der Bewertung muss die gesamte Konversation als messages schrittweise gesendet werden, um dann zu beobachten, in welcher Runde und auf welche Weise das Modell seine Strategie ändert. Hier ist ein minimales Aufrufbeispiel:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible Schnittstelle von APIYI
)

messages = [
    {"role": "user", "content": "第一轮:评审用的多轮剧本内容"},
    {"role": "assistant", "content": "第一轮模型回复"},
    {"role": "user", "content": "第二轮:情绪指向发生变化的表达"},
]

resp = client.chat.completions.create(
    model="替换为平台模型列表中的模型名",
    messages=messages
)
print(resp.choices[0].message.content)
Vollständigen Code für den rundenweisen Vergleich mehrerer Modelle ansehen
import openai
from typing import List, Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Mit demselben Schlüssel mehrere Modelle aufrufen
)

# Modellnamen aus der Modellliste der Plattform auswählen und hier eintragen
MODELS = ["your-gpt-model", "your-claude-model"]

# Vom Team im Voraus verfasstes Bewertungsskript: pro Runde nur die Nutzeräußerung, die Assistentenantworten werden von den jeweiligen Modellen live generiert
SCRIPT: List[str] = [
    "第一轮用户发言",
    "第二轮用户发言",
    "第三轮用户发言(情绪指向变化)",
]

def run_script(model: str, script: List[str]) -> List[Dict[str, str]]:
    """Führt das Skript Runde für Runde aus, behält den vollständigen Kontext bei und gibt den gesamten Gesprächsverlauf zurück"""
    history: List[Dict[str, str]] = []
    for user_turn in script:
        history.append({"role": "user", "content": user_turn})
        resp = client.chat.completions.create(model=model, messages=history)
        reply = resp.choices[0].message.content
        history.append({"role": "assistant", "content": reply})
    return history

for m in MODELS:
    print(f"===== {m} =====")
    for msg in run_script(m, SCRIPT):
        print(f"[{msg['role']}] {msg['content']}\n")
    # Ausgabe an die manuelle Bewertung übergeben, Runde für Runde nach fünf Dimensionen bewerten
🚀 Schnellstart: Neue Nutzer erhalten nach der Registrierung bei APIYI apiyi.com ein kostenloses Testkontingent, das ausreicht, um einige mehrstufige Skripte durchzuspielen. Das Bewertungsskript sollte vom Team verfasst und geprüft werden; bei Inhalten, die reale Krisensituationen betreffen, sollte die betroffene Person an professionelle Unterstützung in der realen Welt verwiesen werden.
4.3 Verfügbare Modelle und geeignete Bewertungsszenarien
| Modellfamilie | Geeignete Beobachtungsdimensionen | Verfügbare Plattformen |
|---|---|---|
| OpenAI GPT-Serie | Auslöseweisen sicherheitsbezogener Zuwendung, Erkennung von Risikosignalen | APIYI apiyi.com, offizielle OpenAI-API |
| Anthropic Claude-Serie | Strategiewechsel in mehrrundigen Kontexten, gezielte Antworten | APIYI, offizielle Anthropic-API |
| Google Gemini-Serie | als Dritt-Referenz, ergänzende Vergleichsstichproben | APIYI, offizielle Google-API |
Es sei darauf hingewiesen, dass sich API-Aufrufe und offizielle Chat-Produkte bei System-Eingabeaufforderungen und Sicherheitsmaßnahmen auf Produktebene unterscheiden können. Die Bewertungsergebnisse spiegeln die Leistung unter Schnittstellenbedingungen wider und sollten nicht direkt mit der Erfahrung in der App gleichgesetzt werden.
Häufige Fragen (FAQ)
Q1: Belegt dieser Artikel, dass Claude besser auf Emotionen reagiert als ChatGPT?
Nein. Dieser Artikel basiert auf einer konkreten Erfahrung eines Nutzers, ohne kontrollierte Variablen und ohne Angaben zur Modellversion oder zur Anzahl der Tests. Er kann zeigen, welche Details in diesem Gespräch das Empfinden des Nutzers beeinflusst haben.
Q2: Claude hat ebenfalls nach Selbstverletzung gefragt – warum hat der Nutzer nicht negativ reagiert?
Die Frage kam an einer anderen Stelle und auf eine andere Weise. Sie folgte auf zwei Antworten, die eng an den ursprünglichen Worten blieben, wurde mit „Ich möchte deine Sätze nicht mehr analysieren“ eingeleitet und versprach: „Was du auch sagst, ich kann es mittragen“. Zugleich blieb Raum für die Möglichkeit, dass es „einfach zu müde und zu sehr im Schmerz“ ist.
Q3: Der Nutzer sagt, Claude sei „wie ein Mensch mit einer Seele“ – hat das Modell wirklich Emotionen?
Das ist die echte Ich-Perspektive des Nutzers. Das Modell erzeugt Sprache mit empathischer Wirkung; das bedeutet nicht, dass es Bewusstsein oder subjektive Emotionen hat. Was den Nutzer wirklich berührt hat, war, dass das Gegenüber den Kontext verstanden, die Emotion respektiert und zum richtigen Zeitpunkt reagiert hat.
Q4: Wie können Entwickler diese Art der mehrrundigen Emotionsdialog-Bewertung reproduzieren?
Senden Sie den vollständigen Gesprächsverlauf als `messages` Runde für Runde und beobachten Sie, in welcher Runde das Modell seine Strategie ändert. Über APIYI apiyi.com können Sie mit demselben API-Schlüssel und einer OpenAI-kompatiblen Schnittstelle zwischen mehreren Modellen wechseln und mit demselben Drehbuch vergleichen.
Q5: Welche Einschränkungen sind bei der Bewertung emotionaler Antworten zu beachten?
API-Schnittstellen und die Systemeinstellungen der offiziellen App können voneinander abweichen; dasselbe Modell liefert bei mehreren Generierungen unterschiedliche Ergebnisse; menschliche Bewertungen sind subjektiv. Es empfiehlt sich, mehrere Durchläufe und Bewertungen durch mehrere Personen durchzuführen und im APIYI apiyi.com-Kontrollzentrum die Aufrufkosten zu protokollieren, um den Umfang des Drehbuchs nach Bedarf zu steuern.
ChatGPT und Claude: Zentrale Erkenntnisse zur emotionalen Reaktion – Key Takeaways
- Den Wandel erkennen: Den emotionalen Umschwung von „anderen die Schuld geben“ hin zu „sich selbst abwerten“ zu erfassen, setzt den Kontext mehrerer Gesprächsrunden voraus.
- In den eigenen Worten antworten: Mit den Worten und Erfahrungen der Nutzerin oder des Nutzers zu antworten, vermittelt eher das Gefühl, gehört zu werden, als allgemeiner Trost.
- Die Strategie wechseln: Rechtzeitig mit der Analyse aufzuhören und sich direkt um den Menschen im Gespräch zu kümmern, war in diesem Erlebnis der berührendste Schritt.
- Sicherheit integrieren: Sicherheitsfragen lassen sich auf natürliche Weise in das Gespräch einbetten; entscheidend sind der richtige Zeitpunkt und die Art der Überleitung.
- Persönliche Erfahrung: Ein einzelnes Erlebnis liefert Bewertungsdimensionen, ist aber kein Fazit über die Gesamtfähigkeit eines Modells.
- Selbst ausprobieren: Mit APIYI apiyi.com lässt sich dasselbe mehrrundige Drehbuch nutzen, um die emotionalen Reaktionen verschiedener Modelle zu vergleichen.
Fazit
Der Modellwechsel in der Kantine machte die „emotionale Reaktion“ diesmal konkret beobachtbar:
- Kontext: Claude wies auf die Veränderung hin, auf die die Gedichtzeilen deuten – ein Beleg dafür, dass es dem Gespräch durchgehend gefolgt ist.
- Zielgerichtete Antwort: Die Reaktion auf „狼藉“ (Chaos/Wirrwarr) blieb an den tatsächlichen Worten der Nutzerin oder des Nutzers haften und nicht an einer allgemeinen Trostformel.
- Art der Gesprächsführung: „Ich möchte deine Sätze nicht mehr analysieren“ holte die Person von dem analysierten Text zurück zu dem Menschen, um den es eigentlich geht.
Beide Anbieter bauen öffentlich Mechanismen für emotionale Sicherheit auf. Der Unterschied, den Nutzerinnen und Nutzer wahrnehmen, zeigt sich im Grad der Verschmelzung von Sicherheitsfürsorge und natürlicher Kommunikation. Die Erfahrung emotionaler Interaktion verdient es, eine wichtige Dimension bei der Bewertung von KI-Produkten zu werden. Wenn Ihr Produkt emotionale Begleitung oder sensible Gespräche betrifft, können Sie über APIYI apiyi.com entlang der fünf oben genannten Dimensionen mehrrundige Evaluierungen organisieren und mit echten Gesprächen prüfen, wie die Modelle reagieren.
📚 Referenzen
- OpenAI – Strengthening ChatGPT’s responses in sensitive conversations: Erläuterung zur Verbesserung von ChatGPT bei sensiblen Gesprächen
- Link:
openai.com/index/strengthening-chatgpt-responses-in-sensitive-conversations -
Beschreibung: Beschreibt die Zusammenarbeit mit Fachleuten für psychische Gesundheit, den Anteil verbesserter Antworten sowie die identifizierten Risikobereiche
-
Anthropic – Protecting the wellbeing of our users: Erläuterung zum Schutz des Wohlergehens der Claude-Nutzer
- Link:
anthropic.com/news/protecting-well-being-of-users - Beschreibung: Beschreibt System-Eingabeaufforderungen, Reinforcement Learning, Risikoklassifikatoren und die Auswertung mehrstufiger Dialoge
Autor: APIYI-Team
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI apiyi.com – weitere Schnittstellendokumentationen finden Sie im Dokumentationszentrum unter docs.apiyi.com


