ملاحظة الكاتب: نظرة على الإصدار الجديد LongCat 2.5. نستعرض في هذا المقال معلماته وبنيته، وحالات العرض الرسمية الثماني، ونتائج اختباراته الذاتية الرسمية الـ25، وتكلفته خلال فترة الخصم، وطرق استخدامه في Claude Code وCline.
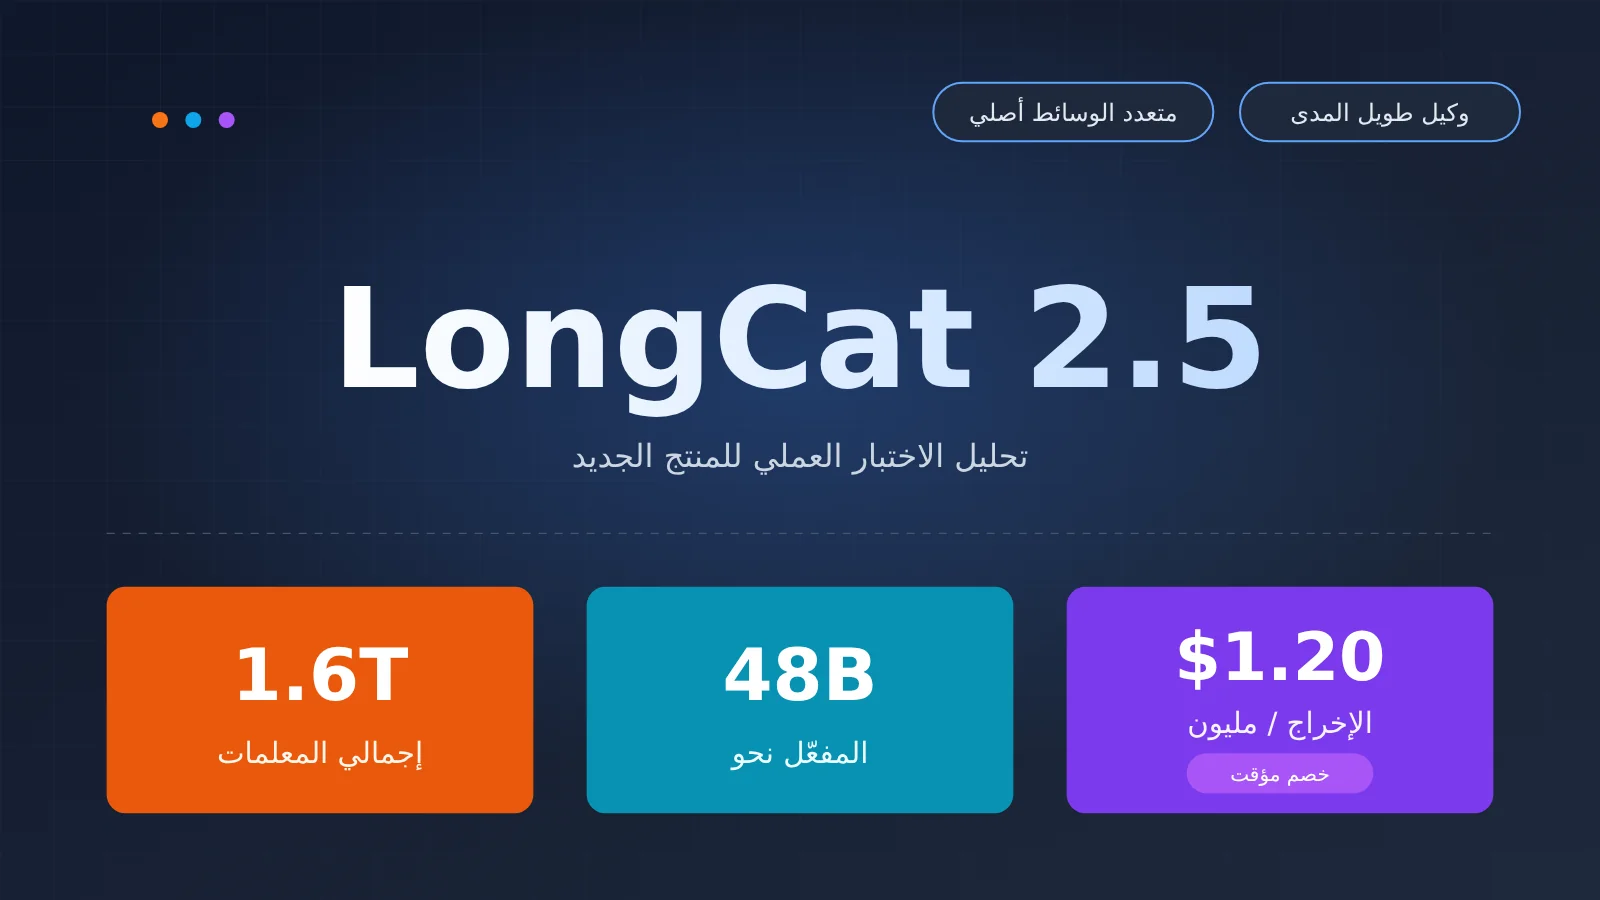
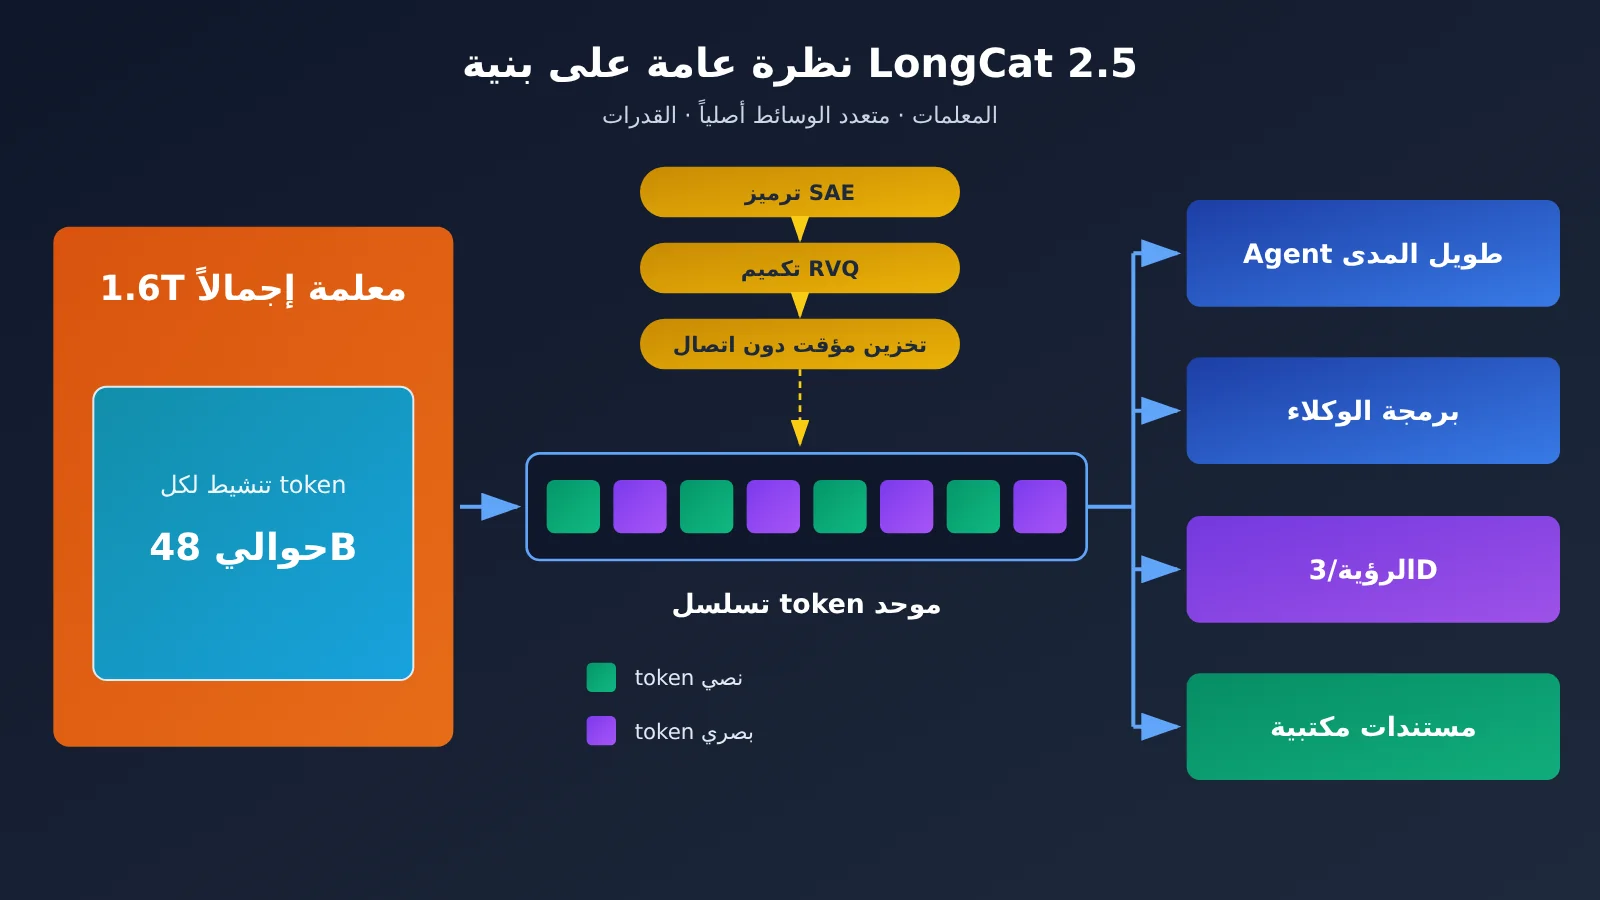
أطلق فريق LongCat في ميتوان (وهو الاسم المتداول في المجتمع) نموذج LongCat-2.5 في 1 نوفمبر. يضم النموذج 1.6 تريليون معلمة إجمالًا، ويُفعّل نحو 48 مليار معلمة لكل رمز. وهو نموذج متعدد الوسائط بطبيعته، مصمم لمهام الوكلاء طويلة المدى. مقارنةً بالإصدار 2.0، تتركز الترقيات الرئيسية في فهم المحتوى المرئي والبرمجة باستخدام الوكلاء. وتتوفر الأسعار بخصم لفترة محدودة: 1.20 دولار لكل مليون رمز في المخرجات، و0.30 دولار للمدخلات غير الموجودة في ذاكرة التخزين المؤقت، و0.006 دولار للمدخلات الموجودة فيها.
هذه ليست مقارنة لاختيار نموذج على حساب آخر. سنركز فيما يلي على ثلاثة أمور فقط: ما هو النموذج، وما المهام التي يجيدها، وكم تبلغ تكلفة استخدامه. أما نتائج الاختبارات فهي للمقارنة فقط، دون استنتاج أن نموذجًا يحل محل آخر.
ما ستخرج به: خريطة لقدرات النموذج، وحساب واضح للتكلفة، وأقصر طريق للبدء باستخدامه.
نظرة سريعة على أبرز معلومات LongCat 2.5
| البند | التفاصيل |
|---|---|
| تاريخ الإصدار | 2026-11-01 (المدونة الرسمية) |
| الفئة | نموذج متعدد الوسائط بطبيعته، مصمم لمهام الوكلاء طويلة الأمد |
| الحجم | 1.6 تريليون معامل إجمالاً، يُفعّل منها نحو 48 مليار معامل لكل رمز |
| التحسينات مقارنةً بـ 2.0 | الفهم البصري الأصلي وبرمجة الوكلاء |
| نافذة السياق / الحد الأقصى للمخرجات | مليون رمز / 128 ألف رمز |
| واجهة البرمجة | تدعم تنسيقَي OpenAI وAnthropic |
| السعر (خصم لفترة محدودة) | المدخلات: 0.30 دولار عند عدم وجود نتيجة في ذاكرة التخزين المؤقت، و0.006 دولار عند وجودها؛ المخرجات: 1.20 دولار. الأسعار لكل مليون رمز |
| الأوزان | لم تُنشر بعد؛ تحمل صفحتا GitHub وHuggingFace عبارة «ترقّبوا» |
هناك نقطة قد تسبب التباسًا بشأن المعاملات المُفعّلة. ففي يوم الإصدار، ذكر منشور في المجتمع أن عددها 440 مليارًا، بينما أوضحت المدونة الرسمية أن عدد المعاملات المُفعّلة لكل رمز يبلغ نحو 48 مليارًا. سنعتمد رقم 48 مليارًا في هذا المقال.
ما هو LongCat 2.5: المعاملات والبنية والوسائط المتعددة الأصلية
حجم LongCat 2.5 ونهج تدريبه
يضم النموذج 1.6 تريليون معامل إجمالًا، ويُفعّل نحو 48 مليارًا منها فقط. هذا يعني أنه نموذج لغة كبير يعتمد على التفعيل المتناثر: حجمه الكلي ضخم، لكنه يستخدم جزءًا صغيرًا منه في كل عملية استدلال. تتيح هذه البنية تحقيق توازن بين سعة المعرفة وتكلفة الاستدلال، وهي أحد أسباب انخفاض سعره الذي سنتناوله لاحقًا.
أما في التدريب، فقد أشار الفريق الرسمي إلى عدة أساليب ترتبط مباشرةً بـ«المهام طويلة المدى»:
- المزيد من بيانات المسارات طويلة المدى: أُضيفت مسارات أكثر إلى تدريب التسلسلات الطويلة، ثم استُخدم التعلم المعزز واسع النطاق للمهام طويلة المدى، لتدريب النموذج على مهام هندسية متكاملة مثل تطوير قواعد شيفرة معقدة وبناء مشاريع كاملة.
- تحويل مسارات الفشل الفعلية إلى مهام تدريبية: جرى التوسع في توليد البيانات الاصطناعية وبناء البيئات والتدريب المختلط عبر أطر تشغيل مختلفة (Harnesses)، لتحويل مسارات فشل الوكلاء الفعلية إلى مهام قابلة لإعادة التنفيذ والتحقق.
- الحد من «الإفراط في التفكير» و«الاستدعاءات المتكررة»: تُفرض عقوبات إضافية على تكرار التفكير واستدعاء الأدوات، وتُعاد موازنة مكافآت الأمثلة الإيجابية عند الإفراط في التفكير أو زيادة طول الاستجابة بسرعة كبيرة.
النقطة الثالثة مفيدة عمليًا في سيناريوهات الوكلاء. ففي المهام طويلة المدى، غالبًا ما تكون أكبر تكلفة ناتجة عن دوران النموذج في حلقة مفرغة حول الأداة نفسها. والحد من ذلك أثناء التدريب يعني توفير الرموز المميزة مباشرةً.
كيف تعمل القدرات متعددة الوسائط الأصلية في LongCat 2.5؟
مصطلح «متعدد الوسائط الأصلي» له معنى محدد هنا. تُمثَّل الإشارات البصرية في صورة رموز منفصلة متعددة المستويات، ويعالج النموذج الأساسي الصور والنصوص معًا بصيغة موحّدة للرموز. وهو بذلك لا يعتمد على مُرمِّز بصري خارجي تُدمج ميزاته مع المدخلات لاحقًا.
يقسم الفريق الرسمي هذه العملية إلى ثلاث مراحل:
- تحويل الصور بدقتها الأصلية إلى رموز منفصلة: يُستخدم مُرمِّز المحاذاة الدلالية (SAE) مع تكميم المتجهات المتبقية (RVQ) لتحويل الصور إلى رموز منفصلة.
- المعالجة المسبقة للرموز البصرية دون اتصال: بعد تثبيت مُجزِّئ الرموز، يمكن حساب معرّفات الرموز البصرية مسبقًا وتخزينها مؤقتًا.
- التعلّم المشترك: تُدرَّب تضمينات الرموز البصرية مع النموذج الأساسي.
بحسب الفريق الرسمي، يتيح هذا التصميم للنموذج أداءً متميزًا في البرمجة البصرية (Visual Coding)، ويدعم مهام مثل التصميم الإبداعي والعمل ثلاثي الأبعاد. ويقيس اختبارا 3DCodeBench وVision2Web في جدول النتائج لاحقًا هذا النوع من القدرات.
لماذا يستطيع LongCat 2.5 تقديم هذا السعر؟
خصصت المدونة الرسمية مساحة واسعة للحديث عن كفاءة الهندسة، وهو ما يفسّر السعر. جرى التدريب على عتاد حوسبة محلي، بذاكرة أقل من 80 جيجابايت لكل بطاقة. ولتقليل استهلاك الذاكرة، استخدم الفريق تقنيات منها FSDP بتقسيم مزدوج، وتوازي المفردات الهجين، والنسخ الديناميكي للخبراء. وفي مهام الضبط الدقيق المُراقب (SFT) للتسلسلات الطويلة، حقق إعداد FSDP هذا معدل معالجة أعلى بنسبة 86% لكل بطاقة مقارنةً بخط الأساس DDP.
أما في مرحلة الاستدلال، فيُستخدم W4A4، حيث تُكمَّم أوزان الخبراء وقيم التنشيط إلى 4 بت. وفي اختبار الضغط الرسمي على الخدمة الفعلية، مقارنةً بخط الأساس W8A8 INT8، ارتفع معدل معالجة مرحلة الملء المسبق (prefill) بنسبة 43.3%، ومعدل معالجة مرحلة التوليد (decode) بنسبة 42.77%، وانخفض زمن الوصول إلى أول رمز (TTFT) بنسبة 15.91%، وزمن معالجة كل رمز (TPOT) بنسبة 19.72%. ومع ارتفاع معدل المعالجة بأكثر من 40%، تنخفض تكلفة الرمز الواحد بطبيعة الحال.
ما الذي يميز LongCat 2.5؟ الوكلاء للمهام طويلة المدى و8 أمثلة رسمية
حجم التطور من LongCat 2.0 إلى 2.5
لنبدأ بمقارنة النموذج مع نسخته السابقة. الأرقام التالية من اختبارات LongCat الرسمية، أما المقارنات المميزة بعلامة النجمة فمصدرها قوائم تقييم عامة. ونقتصر هنا على درجات نسختَي LongCat.
- Terminal Bench v4.0: سجّل الإصدار 2.0 درجة 3.0، والإصدار 2.5 درجة 38.5.
- DeepSWE v1.1: سجّل الإصدار 2.0 درجة 9.7، والإصدار 2.5 درجة 64.6.
- Program Bench Almost Resolved: سجّل الإصدار 2.0 درجة 2.5، والإصدار 2.5 درجة 25.5.
- AutomationBench v1.0.6: سجّل الإصدار 2.0 درجة 15.8، والإصدار 2.5 درجة 51.8.
تقيس هذه الاختبارات مهام طويلة متعددة الخطوات، مثل تشغيل أوامر الطرفية، وإصلاح المشكلات على مستوى المستودع، وتنفيذ سير العمل الآلي. كانت نتائج الإصدار 2.0 في هذه المهام قريبة من الصفر، بينما وصل الإصدار 2.5 إلى مستوى يسمح بمقارنته بالنماذج الأخرى. وهذا يشير إلى تحسن ملموس في «البرمجة باستخدام الوكلاء». وتوضح النتائج الرسمية أن درجات LongCat-2.5 تحققت مع تفعيل وضع التفكير وضبط temperature=1.0 وtop_p=0.95.
8 أمثلة عرض رسمية لـ LongCat 2.5
نشر الفريق الرسمي 8 أمثلة مولّدة من البداية إلى النهاية، موزعة على مجموعتين. وتجدر الإشارة إلى أنها عروض رسمية، ولم نُعِد تشغيل كل مثال على حدة في هذه المقالة.
| الفئة | المثال | ما الذي يختبره؟ |
|---|---|---|
| تطوير البرمجيات | محاكاة السوائل في الوقت الفعلي | الحسابات الفيزيائية + العرض الفوري في الواجهة الأمامية |
| تطوير البرمجيات | عرض تفاعلي لقطعة أثرية ثلاثية الأبعاد | بناء مشهد ثلاثي الأبعاد ومنطق التفاعل |
| تطوير البرمجيات | نموذج مصغّر لمدينة | توزيع عدد كبير من العناصر وتنظيمها |
| تطوير البرمجيات | عناصر لمشهد مصغّر | التحكم في تفاصيل توليد العناصر ثلاثية الأبعاد |
| العمل المكتبي المهني | تحليل أداء الأعمال | قراءة البيانات، وتحليل المؤشرات، وصياغة النتائج |
| العمل المكتبي المهني | تقرير تحليل ملاحظات العملاء | تصنيف النصوص غير المنظمة وتلخيصها |
| العمل المكتبي المهني | صفحة جمالية للألوان على الطراز الصيني | الذوق البصري وتنسيق صفحات الويب |
| العمل المكتبي المهني | أداة إنشاء دعوات الفعاليات | التفاعل مع النماذج + تصميم التخطيط |
ترتبط ثلاثة من أمثلة تطوير البرمجيات الأربعة مباشرةً بالتقنيات ثلاثية الأبعاد، وهو ما يعكس التركيز على القدرات البصرية الأصلية والبرمجة البصرية (Visual Coding). أما أمثلة العمل المكتبي فتميل إلى «قراءة المواد وإنتاج مخرجات جاهزة»، بما يتوافق مع نوع المهام في اختبارات مثل JobBench وGDPVal.
أين يقع LongCat 2.5 في نتائج الاختبارات؟
يضم جدول التقييم الرسمي أكثر من 25 اختبارًا، موزعة على ثلاث فئات: وكلاء البرمجة، والوكلاء العامون، والقدرات البصرية. اخترنا منها 9 اختبارات لمقارنة خمسة نماذج جنبًا إلى جنب.
| الاختبار | LongCat-2.5 | Claude Opus 5 | GPT-5.6-Sol | GLM-5.3 | Kimi K3 |
|---|---|---|---|---|---|
| Terminal Bench v2.1 | 88.4 | 89.1* | 88.8* | 88.2* | 88.3* |
| Terminal Bench v4.0 | 38.5 | 53.9* | 37.3* | 41.8* | 12.6* |
| DeepSWE v1.1 | 64.6 | 68.8* | 72.7* | 66.9* | 67.5* |
| BrowseComp | 91.9 | 90.8* | 90.4* | 81.0 | 91.2* |
| HLE w/tools | 63.1 | 64.7* | 58.0* | 62.5* | 56.0* |
| JobBench | 65.4 | 66.7* | 45.4* | 61.4* | 52.9* |
| MCP Atlas | 83.1 | 85.8* | 81.8* | 84.2* | 84.2* |
| 3DCodeBench Text to 3D | 55.4 | 54.3 | 52.3 | 53.4 | 49.3 |
| Vision2Web | 78.6 | 80.2* | 73.5* | 77.8* | 79.0* |
تشير النجمة * إلى نتائج نقلها الفريق الرسمي عن لوحات ترتيب عامة أو تقارير تقنية. أما النتائج الأخرى فهي من اختبارات LongCat الداخلية، وتُستخدم للمقارنة الاسترشادية فقط.
بالنظر إلى الأرقام، يمكن استخلاص ما يلي:
- اختبارات البحث والاسترجاع: سجّل LongCat نتيجة 91.9 في BrowseComp، وهي الأعلى بين النماذج الخمسة. استخدم الفريق الرسمي إطار تشغيل خفيفًا طوّره بنفسه، مع تفعيل أداتي search وbrowse_with_goal فقط، وبحد أقصى 1024 جولة.
- التوليد ثلاثي الأبعاد: سجّل 55.4 في 3DCodeBench Text to 3D، وهي أعلى نتيجة بين النماذج الخمسة. لكن النتائج الخمس في هذا الصف لا تحمل نجمة، وجميعها من اختبارات LongCat الداخلية.
- مهام الطرفية: تتقارب نتائج النماذج الخمسة في Terminal Bench v2.1 بين 88.2 و89.1. أما في الإصدار الأصعب v4.0، فسجّل LongCat-2.5 نتيجة 38.5 مقابل 53.9 لـ Claude Opus 5، بفارق 15.4 نقطة.
- الإصلاح على مستوى مستودع الشفرة: سجّل 64.6 في DeepSWE v1.1، وهي أدنى نتيجة بين النماذج الخمسة، مقابل 72.7 لـ GPT-5.6-Sol.
- استدعاء الأدوات والمهام المكتبية: سجّل 83.1 في MCP Atlas و65.4 في JobBench، بفارق 2.7 و1.3 نقطة على التوالي عن Opus 5.
يجدر الانتباه أيضًا إلى إطار التشغيل المستخدم في كل اختبار. استُخدم إطار Claude Code في نسختَي Terminal Bench، مع ضبط max_seq_length على 512K؛ بينما استُخدم mini-swe-agent في DeepSWE بطول تسلسل 1M. لذلك لا يُنصح بمقارنة نتائج الاختبارات المختلفة مباشرةً عندما تختلف أطر التشغيل.
كيف تُحسب تكلفة LongCat 2.5؟ مقارنة الأسعار وفاتورة مليون رمز
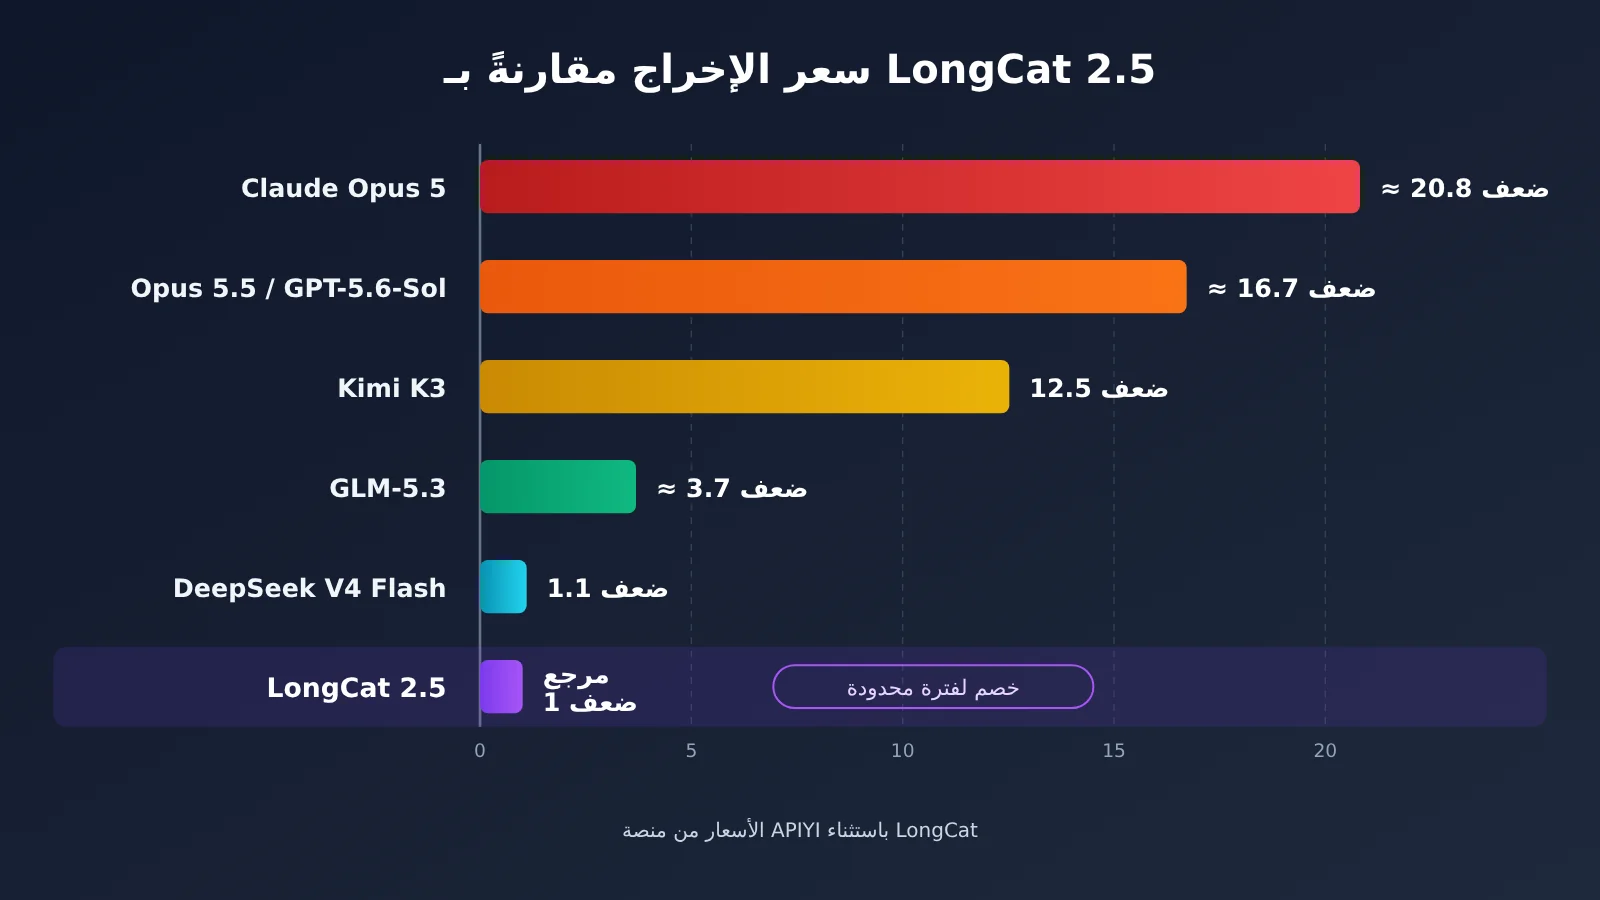
توضيح: سعر LongCat-2.5 هو سعر مخفّض لفترة محدودة على منصة API الرسمية، أما أسعار النماذج الأخرى فمن قائمة النماذج على منصة APIYI، عبر apiyi.com.
| النموذج | المدخلات (لكل مليون رمز) | المخرجات (لكل مليون رمز) | سعر المخرجات مقارنةً بـ LongCat |
|---|---|---|---|
| LongCat-2.5 (خصم لفترة محدودة، المنصة الرسمية) | $0.30 (عند استخدام ذاكرة التخزين المؤقت $0.006) | $1.20 | 1 |
| Claude Opus 5 | $5 | $25 | نحو 20.8 ضعفًا |
| Claude Opus 5.5 | $4 | $20 | نحو 16.7 ضعفًا |
| GPT-5.6-Sol | $4 | $20 | نحو 16.7 ضعفًا |
| Kimi K3 | $3 | $15 | 12.5 ضعفًا |
| GLM-5.3 | $1.4 | $4.396 | نحو 3.7 أضعاف |
| DeepSeek V4 Flash | $0.44 | $1.32 | نحو 1.1 ضعف |
تم الاطلاع على أسعار APIYI عبر apiyi.com في 2026-11-02، وفقًا لما ظهر في قائمة النماذج على المنصة في ذلك اليوم. أما سعر LongCat-2.5 فمن منصة LongCat API، وقد أشارت المنصة الرسمية إلى أن السعر قد يتغير.
حساب تكلفة مليون توكن
لنفترض أن مهمة دفعية تستهلك مليون توكن إجمالًا: 800 ألف للإدخال و200 ألف للإخراج، دون احتساب التخزين المؤقت.
- LongCat-2.5 (خصم لفترة محدودة): 0.8 × $0.30 + 0.2 × $1.20 = $0.48
- DeepSeek V4 Flash: $0.352 + $0.264 = $0.616
- GLM-5.3: $1.12 + $0.879 ≈ $2.00
- Kimi K3: $2.40 + $3.00 = $5.40
- GPT-5.6-Sol أو Claude Opus 5.5: $3.20 + $4.00 = $7.20
- Claude Opus 5: $4.00 + $5.00 = $9.00
لإنجاز المهمة نفسها، تبلغ تكلفة Opus 5 نحو 18.75 ضعف تكلفة LongCat-2.5. وإذا استفادت المهمة من التخزين المؤقت، فسيكون الفرق أكبر. في المثال الرسمي، تتكون المهمة من مليون توكن إدخال (400 ألف متاحة في ذاكرة التخزين المؤقت و600 ألف غير متاحة) و500 ألف توكن إخراج، فتبلغ الفاتورة $0.18 + $0.0024 + $0.6 = $0.7824. ويبلغ سعر مليون توكن إدخال متاحة في ذاكرة التخزين المؤقت $0.006 فقط، أي 1/50 من سعر المدخلات غير المتاحة فيها.
هناك أيضًا تفصيلان مهمان بشأن الفوترة: تُحتسب الرسوم فقط عند إرجاع رمز HTTP 200، ولا تُفرض رسوم على الطلبات الفاشلة التي تُرجع رموزًا مثل 401 أو 403 أو 429 أو 500؛ والرصيد مدفوع مقدمًا ولا تنتهي صلاحيته، وعند وجود رصيد مجاني يُخصم منه أولًا.
كيف تسهّل المقارنة بين عدة نماذج؟
في الواقع، نادرًا ما تعتمد مشاريع الوكلاء الأذكياء على نموذج واحد. قد ترغب في تجربة مجموعة الموجهات نفسها ومقارنة مخرجات LongCat-2.5 وClaude وGPT وGLM. هنا يمكنك استخدام حساب واحد ومفتاح API واحد على APIYI apiyi.com للتبديل بين النماذج، دون الحاجة إلى فتح حساب وشحن رصيد لدى كل مزوّد على حدة.
📌 ملاحظة: يُرجى الرجوع إلى قائمة النماذج على منصة APIYI apiyi.com لمعرفة النماذج والأسعار المتاحة. لم تُتح APIYI نموذج LongCat-2.5 بعد، لكنها ستطرحه في أقرب وقت ممكن.
كيف تبدأ باستخدام LongCat 2.5: التجربة عبر الموقع والربط عبر API
الخطوة الأولى: جرّبه عبر الويب
يمكنك تجربة النموذج عبر الموقع الرسمي على longcat.ai/chat. وبحسب منشور في المجتمع، يحصل المستخدمون الجدد خلال فترة الإطلاق على 10 ملايين رمز مجاني، بينما يحصل المستخدمون الحاليون على 5 ملايين رمز. وتُضاف هذه الحصة تلقائيًا، ولا يُخصم منها عند الاستفادة من ذاكرة التخزين المؤقت. ويذكر المنشور أيضًا أن حزمة عرض محدودة بسعر 9.9 يوان «ستتوفر قريبًا». يُنصح بتجربة مهام البحث وفهم الصور أولًا، إذ حقق النموذج نتائج متقدمة فيهما ضمن الاختبارات.
الخطوة الثانية: استخدم API وتذكّر أربعة إعدادات
- نقطة نهاية بصيغة OpenAI:
https://api.longcat.ai/openai - نقطة نهاية بصيغة Anthropic:
https://api.longcat.ai/anthropic - حقل model:
LongCat-2.5 - السياق والمخرجات: نافذة سياق بسعة مليون رمز، ومخرجات بحد أقصى 128 ألف رمز
فيما يخص حدود معدل الطلبات، تذكر الوثائق الرسمية فقط أن تجاوز الحد يعيد HTTP 429 ورمز الخطأ rate_limit_exceeded، مع قيمة retry_after تساوي 60. كما توصي بأن يعيد العميل المحاولة باستخدام التراجع الأُسّي. ولم تُعلن حدود RPM وTPM بالتحديد.
إذا كانت شفرتك تستخدم OpenAI SDK بالفعل لاستدعاء نموذج آخر، فما عليك عند التبديل سوى تغيير ثلاثة حقول: base_url وapi_key وmodel. على سبيل المثال، عند استخدام APIYI يكون base_url هو https://api.apiyi.com/v1، وعند الانتقال إلى واجهة LongCat الرسمية غيّره إلى https://api.longcat.ai/openai، وغيّر model إلى LongCat-2.5.
الخطوة الثالثة: اربطه بـ Claude Code
- في Claude Code، عدّل قسم env في
~/.claude/settings.json: ضع مفتاح API الخاص بـ LongCat فيANTHROPIC_AUTH_TOKEN - في قسم env بالملف نفسه: ضع
https://api.longcat.ai/anthropicفيANTHROPIC_BASE_URL - في قسم env بالملف نفسه: ضع
LongCat-2.5فيANTHROPIC_MODEL - في قسم env بالملف نفسه: ضع
131072فيCLAUDE_CODE_MAX_OUTPUT_TOKENS - في قسم env بالملف نفسه، ويُنصح بتعديلها أيضًا: اضبط
ANTHROPIC_SMALL_FAST_MODELوANTHROPIC_DEFAULT_SONNET_MODELوANTHROPIC_DEFAULT_OPUS_MODELجميعها علىLongCat-2.5
إذا لم تغيّر المتغيرات الثلاثة الأخيرة، فقد تستمر المهام الفرعية داخل Claude Code في طلب النماذج الافتراضية، مما قد يؤدي إلى أخطاء أو احتساب التكاليف على نحو غير مقصود.
الخطوة الرابعة: اربطه بـ Cline
- في لوحة إعدادات Cline بالشريط الجانبي في VS Code: اختر خيارًا متوافقًا مع OpenAI في API Provider
- في اللوحة نفسها: ضع
https://api.longcat.ai/openaiفي Base URL - في اللوحة نفسها: ضع مفتاح LongCat في API Key، و
LongCat-2.5في Model ID
توفّر وثائق LongCat الرسمية صفحة مخصصة لربط Cline؛ ارجع إليها للتأكد من أسماء الحقول. كما تتوفر صفحات ربط لأكثر من عشرة أدوات أخرى، منها Codex وOpenCode وKilo Code وCherry Studio وChatbox وCC Switch.
🚀 نصيحة للبدء سريعًا: استخدم الحصة المجانية التي يقدمها الموقع الرسمي لتجربة مهامك أولًا، ثم قرر ما إذا كنت تريد اعتماد الخدمة على المدى الطويل. وإذا كنت تحتاج أيضًا إلى استدعاء Claude وGPT وGemini للمقارنة، فيمكنك استخدام مجموعة واحدة من الواجهات المتوافقة مع OpenAI لإدارتها عبر APIYI على apiyi.com. وبعد إتاحة LongCat-2.5 على المنصة، ستتمكن أيضًا من التبديل إليه من الحساب نفسه.
ما المهام المناسبة لـ LongCat 2.5؟
| مهام مناسبة لـ LongCat 2.5 | مهام لا تتعجل في إسنادها إليه |
|---|---|
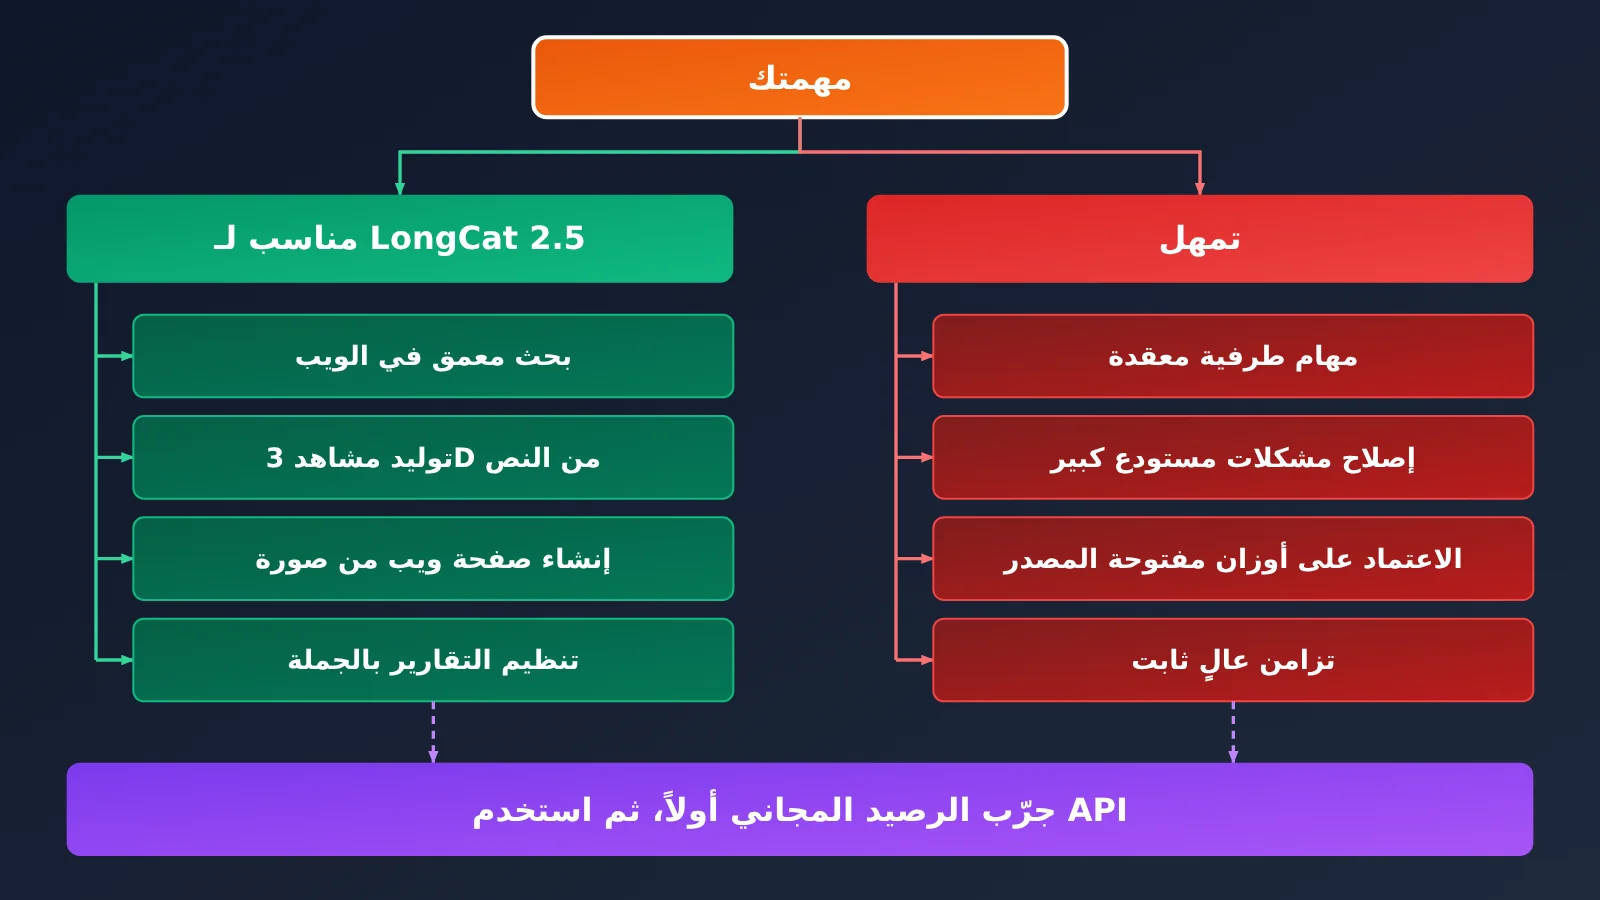
| البحث على الويب عبر جولات متعددة وتلخيص المعلومات (BrowseComp: 91.9) | مهام إدارة الأنظمة المعقدة عبر الطرفية بخطوات متعددة (38.5 في Terminal Bench v4.0، مقابل 53.9 لـ Opus 5) |
| توليد مشاهد ثلاثية الأبعاد، باستخدام Three.js مثلاً، انطلاقاً من وصف نصي (3DCodeBench: 55.4) | إصلاح الأخطاء المعقدة في المستودعات الكبيرة (64.6 في DeepSWE v1.1، وهي أدنى نتيجة بين الأعمدة الخمسة) |
| إنشاء صفحات ويب مطابقة لتصميم أو لقطة شاشة (Vision2Web: 78.6) | المشاريع التي تتطلب نشراً خاصاً وأوزاناً محلية (الأوزان لم تُطرح بعد) |
| تنظيم ملاحظات العملاء وبيانات الأعمال بالجملة وصياغتها في تقارير (JobBench: 65.4، وسعر مخرجات مخفّض لفترة محدودة: 1.20 دولار لكل مليون رمز) | خدمات الإنتاج التي تحتاج إلى حصة ثابتة للتزامن المرتفع (لم تُعلن الجهة المطوّرة عن حدود RPM/TPM) |
ما يجمع مهام العمود الأيسر أنها طويلة، وتستهلك عدداً كبيراً من الرموز، وتتأثر بالتكلفة؛ وتبدو نتائج LongCat-2.5 وسعره مناسبين لها. أما العمود الأيمن فلا يعني أن النموذج عاجز عن تنفيذ تلك المهام، بل إن نتائجه لا تزال متأخرة بفارق واضح، أو أن شروط النشر والحصص لم تتضح بعد، لذا يُفضّل تجربته على نطاق صغير أولاً.
الأسئلة الشائعة حول LongCat 2.5
س1: هل قيّمت جهة خارجية أداء LongCat 2.5؟
لا. جميع درجات LongCat-2.5 في الجدول مأخوذة من اختبارات LongCat الرسمية. أما النماذج الأخرى، فالدرجات المميزة بنجمة مأخوذة من تقارير منشورة أو لوحات ترتيب رسمية، والدرجات غير المميزة بنجمة مأخوذة أيضًا من اختبارات LongCat. يُنصح بالتعامل معها بوصفها مرجعًا للمقارنة بين النماذج.
س2: هل سعر 1.20 دولار لكل مليون رمز ثابت على المدى الطويل؟
لا، توضح الجهة المطوّرة أنه سعر مخفّض لفترة محدودة وقد يتغير. يُرجى الرجوع إلى صفحة منصة LongCat API والفاتورة لمعرفة السعر المعتمد. عند إعداد ميزانية طويلة الأجل، يُنصح بتجهيز نموذج بديل واستخدام منصة تجميع مثل APIYI على apiyi.com للاحتفاظ بخيار التبديل.
س3: هل أصبح LongCat 2.5 مفتوح المصدر؟
ليس بعد. يحمل زرا GitHub وHuggingFace في المدونة الرسمية عبارة «قريبًا». المتاح حاليًا هو التجربة عبر الإنترنت والوصول عبر API فقط، ولم تعلن الجهة المطوّرة عن موعد لفتح المصدر.
س4: هل يمكن استدعاء LongCat 2.5 عبر APIYI؟
ليس حاليًا، لكن APIYI ستتيح النموذج في أقرب وقت ممكن. في الوقت الحالي، يمكنك استخدام LongCat API الرسمي مباشرةً. وإذا أردت مقارنة Claude وGPT وGLM، يمكنك استخدام مفتاح API واحد على APIYI عبر apiyi.com لتجربة النماذج الأخرى. يُرجى الرجوع إلى قائمة النماذج على المنصة لمعرفة النماذج والأسعار المتاحة.
س5: ماذا أفعل عند ظهور خطأ 429؟
يعني هذا أنك تجاوزت حد الطلبات، وسيحتوي نص الاستجابة على `retry_after` بقيمة 60. توصي الجهة المطوّرة بإعادة المحاولة باستخدام التراجع الأُسّي، كما أن الطلبات التي تُرجع خطأ 429 لا تُحتسب عليها رسوم إضافية.
الخلاصة: هل يستحق LongCat 2.5 الاعتماد عليه؟
أبرز نقاط LongCat 2.5:
- التوجه: نموذج متعدد الوسائط بطبيعته، يضم 1.6 تريليون معلمة إجمالًا ويُفعّل نحو 48 مليار معلمة لكل رمز، ويركز على مهام الوكلاء طويلة المدى.
- التطور: مقارنة بالإصدار 2.0، ارتفعت نتيجته في Terminal Bench v4.0 من 3.0 إلى 38.5، وفي DeepSWE v1.1 من 9.7 إلى 64.6.
- نقاط القوة: حقق 91.9 في BrowseComp و55.4 في 3DCodeBench، وهما أعلى نتيجتين بين النماذج الخمسة التي يقارنها هذا المقال، وفقًا للأرقام الرسمية.
- الفجوة: لا تزال هناك فجوة ملحوظة في Terminal Bench v4.0 وDeepSWE v1.1.
- السعر: يبلغ سعر المخرجات ضمن الخصم المحدود المدة $1.20 لكل مليون رمز. وتبلغ تكلفة 800 ألف رمز إدخال و200 ألف رمز إخراج نحو $0.48.
- التكامل: يدعم بروتوكولي OpenAI وAnthropic، ولا يتطلب استخدامه مع Claude Code سوى تعديل أربعة متغيرات.
الخلاصة في جملة: جرّب أولًا مهام البحث وفهم الصور عبر longcat.ai/chat باستخدام الرصيد المجاني البالغ 10 ملايين رمز، ثم انتقل إلى API بعد التأكد من ملاءمته؛ وإذا كنت تحتاج إلى التبديل بين نماذج متعددة على المدى الطويل، فأدرها معًا عبر APIYI على apiyi.com.
📚 المراجع
- مدونة LongCat الرسمية: مقال إطلاق LongCat-2.5، ويشمل البنية والتدريب وجداول التقييم
- الرابط:
longcat.ai/blog/longcat-2.5 -
التفاصيل: المصدر الأولي لحجم النموذج، وحالات العرض الثماني، ومعايير نتائج الاختبارات
-
وثائق منصة LongCat API: الواجهات والتسعير وربط الأدوات
- الرابط:
longcat.ai/platform/docs -
التفاصيل: نقاط النهاية للبروتوكولين، والأسعار المخفضة لفترة محدودة، وصفحات ربط Claude Code وCline
-
قائمة نماذج APIYI: أسعار النماذج على المنصة
- الرابط:
docs.apiyi.com/models - التفاصيل: مصدر الأسعار المستخدمة في هذه المقارنة؛ يُرجى الرجوع إلى الأسعار المعروضة في يوم الاطلاع
الكاتب: الفريق التقني في APIYI
التواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI، ويمكنكم زيارة مركز الوثائق على docs.apiyi.com لمزيد من المعلومات