أُطلق gemini-4-argon في 13 أكتوبر 2026، وسرعان ما واجه كثير من المطورين الخطأ 429 بعد بدء استخدامه: فبمجرد زيادة عدد الطلبات المتزامنة، تظهر الأخطاء، وأحيانًا يفشل طلب واحد بمفرده. قد يظن كثيرون في البداية أن «حدّ التزامن في AI Studio منخفض جدًا»، لكن هذا الاستنتاج غالبًا غير صحيح. في هذا المقال، سنشرح آلية تحديد المعدل الفعلية لـ gemini-4-argon على AI Studio، ونقدّم حلولًا عملية للخطأ 429.
هذا ليس مقالًا عامًا آخر يكتفي بالقول: «أضف إعادة المحاولة وستُحل المشكلة». سنبدأ بتوضيح حقيقة مهمة: لم تنشر Google حتى الآن حدًا موحدًا وثابتًا لعدد الطلبات المتزامنة في gemini-4-argon، لذا فإن الأرقام المتداولة على الإنترنت، مثل «10 طلبات متزامنة» أو «50 طلبًا متزامنًا»، لا تستند إلى معلومات مؤكدة.
الفائدة الأساسية: بعد قراءة هذا المقال، ستتمكن من التمييز بين أربعة أسباب للخطأ 429: حدّ الطلبات في الدقيقة (RPM)، وحدّ الرموز في الدقيقة (TPM)، وحدّ الاستهلاك خلال فترة زمنية، وسعة الخدمة لدى المزوّد. كما ستتعرّف إلى الطرق العملية لتطبيق التراجع الأسي وتحديد المعدل، وإلى كيفية تجاوز عنق الزجاجة الذي تفرضه حصة المشروع الواحد في AI Studio، عبر قناة APIYI apiyi.com المخصّصة للتزامن العالي.
النقاط الأساسية حول gemini-4-argon
يلخّص الجدول التالي خلاصة المقال، ثم تتناول الأقسام اللاحقة كل نقطة بالتفصيل.
| النقطة | التوضيح | الفائدة |
|---|---|---|
| لا يوجد حد أقصى ثابت ومعلن لعدد الطلبات المتزامنة | لم تنشر Google حدًا موحدًا للتزامن في gemini-4-argon؛ ويعتمد تقييد المعدل على مؤشرات مثل RPM وTPM وRPD | تجنّب تخطيط السعة استنادًا إلى رقم غير دقيق |
| RPM لا يساوي التزامن | يعتمد عدد الطلبات قيد التنفيذ على متوسط زمن الاستجابة، وليس على عدد الطلبات في الدقيقة وحده | تقدير احتياجات التزامن بدقة |
| تُحتسب الحدود على مستوى المشروع | إنشاء عدة مفاتيح ضمن المشروع نفسه لا يمنحك حصصًا مضاعفة | تجنّب إضاعة الوقت في التبديل بين المفاتيح |
| حد استهلاك خلال 10 دقائق | يبلغ الحد 10 دولارات في Tier 1، و50 دولارًا في Tier 2، و200 دولار في Tier 3 | تفسير ظهور الخطأ 429 رغم عدم تجاوز RPM |
| التعامل مع 429 على مراحل | افحص الاستجابة الأصلية أولًا، ثم خفّض المعدل، واستخدم التراجع الأسي، وبدّل القناة، وارفع الحصة عند الحاجة | حل المشكلة تدريجيًا حسب الأولوية |
| قناة APIYI لدعم التزامن المرتفع | تدعم APIYI على apiyi.com التزامن المرتفع في gemini-4-argon؛ ولا حاجة للقلق بشأن تقييد المعدل عند أقل من 500 RPM | خيار مباشر للأعمال الصغيرة والمتوسطة |
لماذا لا يعني الخطأ 429 بالضرورة تجاوز حد التزامن؟
يربط كثير من المطورين بين الخطأ 429 و«ارتفاع التزامن»، لكن التزامن ليس مؤشرًا مستقلًا في منظومة تقييد المعدل لدى Google. قد يكون سبب 429 RESOURCE_EXHAUSTED تجاوز عدد الطلبات في الدقيقة، أو عدد رموز الإدخال في الدقيقة، أو عدد الطلبات اليومية، أو حد الإنفاق المتحرك خلال 10 دقائق، أو حتى نقص السعة لدى مزوّد الخدمة في بداية إطلاق نموذج جديد.
لم يمضِ على إطلاق gemini-4-argon سوى أقل من أسبوع، وما تزال الموارد لدى مزوّد الخدمة تتوسع تدريجيًا. لذلك، قد يُرفض الطلب مؤقتًا بسبب نقص السعة حتى لو كانت حصتك كافية تمامًا. ابدأ دائمًا عند تشخيص الخطأ 429 بتحديد نوع الحد الذي تم تجاوزه، بدلًا من خفض التزامن عشوائيًا.
ما حد التزامن في gemini-4-argon على AI Studio؟
الإجابة المباشرة: لا يوجد رقم موحد وثابت ومعلن. لكل مشروع على AI Studio حصصه الفعلية الخاصة بـRPM وTPM وRPD في gemini-4-argon. وتتغير الأرقام بحسب مستوى Tier وحالة المشروع، لذا تحقّق منها في لوحة التحكم.
أنواع الحدود الخمسة في AI Studio
يمكن تلخيص آلية تحديد المعدل الرسمية لدى Google في الجدول التالي. وقد يؤدي تجاوز أي حد منها إلى ظهور الخطأ 429.
| مؤشر الحد | معناه | هل قد يؤدي إلى الخطأ 429؟ |
|---|---|---|
| RPM | عدد الطلبات في الدقيقة | نعم |
| TPM | عدد رموز الإدخال في الدقيقة | نعم |
| RPD | عدد الطلبات يوميًا | نعم |
| معدل الإنفاق | قيمة الإنفاق على API ضمن نافذة متحركة مدتها 10 دقائق | نعم |
| سعة الخدمة الفعلية | الموارد المتاحة لدى Google | ممكن |
انتبه إلى البند الأخير: نقص السعة حالة لا يمكنك حلها بتعديل الإعدادات؛ ويمكن تخفيف أثرها فقط بخفض حجم الزيارات، أو تأخير إعادة المحاولة، أو التبديل إلى قناة أخرى.
العلاقة بين RPM والتزامن
يشير RPM إلى «إجمالي عدد الطلبات خلال دقيقة»، بينما يشير التزامن إلى «عدد الطلبات قيد التنفيذ في اللحظة نفسها». ويرتبط المؤشران بزمن الاستجابة. لنأخذ مشروعًا بحد 60 RPM كمثال توضيحي للحساب فقط، ولا يمثّل هذا الحصة الفعلية لـArgon:
- إذا كان متوسط زمن الاستجابة 5 ثوانٍ، فسيكون متوسط عدد الطلبات قيد التنفيذ نظريًا نحو 5.
- إذا كان متوسط زمن الاستجابة 30 ثانية، فسيكون متوسط عدد الطلبات قيد التنفيذ نظريًا نحو 30.
- قد يؤدي إرسال 60 طلبًا دفعة واحدة إلى تقييد مؤقت أو إلى بلوغ حد السعة، حتى إن لم يتجاوز إجمالي الطلبات خلال الدقيقة الحد المسموح به.
غالبًا ما يغفل المطورون عن الحالة الثالثة. فكثير من نصوص اختبار الضغط ترسل الطلبات كلها دفعة واحدة، وهذا التدفق المفاجئ أكثر عرضة لتفعيل تقييد المعدل من التدفق المنتظم، حتى لو كان الحجم الإجمالي ضمن الحدود المسموحة تمامًا.
كيفية التحقق من الحصة الفعلية لـgemini-4-argon في لوحة التحكم
افتح صفحة حدود المعدل في Google AI Studio على aistudio.google.com/usage، ثم انتقل إلى علامة التبويب الخاصة بحدود المعدل. ويمكنك أيضًا الوصول إليها عبر وثائق Google الرسمية لتحديد المعدل على ai.google.dev/gemini-api/docs/rate-limits. اختر المشروع المطلوب وgemini-4-argon للاطلاع على قيم RPM وTPM وRPD الفعلية ومستوى Tier الحالي.
توضح Google صراحةً أن الحدود تُحتسب على مستوى المشروع، لا على مستوى مفتاح API. وهذا يعني أن إنشاء أي عدد من المفاتيح ضمن المشروع نفسه لن يمنحك حصة مضاعفة؛ لذا لن تنجح فكرة التوسع عبر «التبديل بين مفاتيح متعددة» على AI Studio.
خمسة أسباب شائعة لظهور أخطاء 429 في gemini-4-argon
بعد فهم مؤشرات حدود الاستخدام، لننتقل إلى الحالات التي يواجهها المستخدمون فعليًا. تغطي الأسباب الخمسة التالية معظم بلاغات أخطاء 429 في gemini-4-argon.
- ارتفاع معدل الطلبات اللحظي: قد تؤدي المهام المجمّعة أو نصوص اختبار الضغط إلى إرسال عدد كبير من الطلبات دفعة واحدة، ما يسبب ذروة تتجاوز قدرة التحمل اللحظية لـ RPM.
- بلوغ الحد الأقصى لـ TPM: يؤدي إدخال سياق طويل أو مستندات كبيرة إلى استهلاك الرموز بسرعة؛ لذلك قد تصطدم الطلبات بحد TPM قبل أن يرتفع عددها كثيرًا.
- بلوغ حد الإنفاق خلال 10 دقائق: هذا الحد هو الأسهل في الإغفال، لذا سنوضحه بالتفصيل أدناه.
- استنفاد حصة RPD اليومية: إذا بدأت أخطاء 429 بالظهور بعد تشغيل الخدمة لبعض الوقت، فغالبًا ما يشير ذلك إلى استنفاد الحصة اليومية.
- عدم كفاية سعة الخدمة upstream: قد تكون الموارد محدودة عند إطلاق نموذج جديد، فتُرفض الطلبات حتى لو كانت الحصة كافية.
سبب يسهل إغفاله: حد الإنفاق خلال 10 دقائق
وفقًا للوثائق الرسمية من Google، التي حُدّثت في 15 أكتوبر 2026، لكل مستوى حساب حد أقصى للاستهلاك ضمن نافذة متحركة مدتها 10 دقائق.
| مستوى الحساب | حد الإنفاق كل 10 دقائق |
|---|---|
| Tier 1 | $10 |
| Tier 2 | $50 |
| Tier 3 | $200 |
على سبيل المثال، إذا بلغ إنفاق حساب Tier 1 ما مجموعه $10 خلال 10 دقائق، فقد يُرجع 429 RESOURCE_EXHAUSTED حتى لو لم يتجاوز RPM أو TPM حدودهما. وبما أن gemini-4-argon من الجيل الجديد، فقد تكون تكلفة الاستدعاء الواحد أعلى من تكلفة النماذج الأقدم. كما أن الطلبات ذات السياق الطويل قد ترفع منحنى الإنفاق بسرعة، وهذا من الأسباب الشائعة لظهور تحديد المعدل رغم أن عدد الطلبات ليس كبيرًا.
وتجدر الإشارة أيضًا إلى أن حصة Argon Batch API المذكورة في وثائق Google هي حصة الرموز لقائمة انتظار المعالجة المجمّعة، ولا يمكن استخدامها باعتبارها حصة تزامن لواجهة API الفورية.
كيف تحدد مصدر أخطاء 429 في gemini-4-argon؟
تختلف الأسباب الجذرية باختلاف الأعراض؛ لذا فإن فحص الاحتمالات المناسبة أكثر كفاءة من تعديل الإعدادات عشوائيًا.
| العَرَض | ما ينبغي فحصه أولًا | طريقة المعالجة |
|---|---|---|
| تكرار أخطاء 429 فور زيادة التزامن | معدل الطلبات اللحظي، وRPM، وسعة الخدمة upstream | اختبر الأداء تدريجيًا مع توزيع الطلبات بالتساوي؛ فثبات التزامن لا يعني ثبات RPM |
| بدء ظهور أخطاء 429 بعد التشغيل لبعض الوقت | حد الإنفاق خلال 10 دقائق، وRPD، وتراكم استهلاك TPM | راجع منحنى الإنفاق ومقدار الحصة اليومية المستخدمة |
| ظهور أخطاء 429 مع طلب واحد أو تزامن منخفض جدًا | عدم كفاية سعة الخدمة upstream، أو تقييد الحساب أو المشروع | راجع الاستجابة الأصلية، وفكّر في تبديل القناة |
| ظهور أخطاء 429 في عدة مفاتيح API في الوقت نفسه | انتماء المفاتيح إلى المشروع نفسه ومشاركتها الحصة | خفّض إجمالي حركة المرور في المشروع، أو استخدم قناة لها حصة مستقلة |
أهم معلومتين عند استكشاف المشكلة هما: مستوى حسابك في AI Studio، سواء أكان Tier 1 أم 2 أم 3؛ ومحتوى الخطأ الأصلي لرمز 429، ولا سيما error.message وerror.details وRetry-After في ترويسة الاستجابة. تساعد هاتان المعلومتان غالبًا على التمييز بين ثلاثة أسباب: انخفاض حصة الحساب، أو ارتفاع حركة الطلبات، أو محدودية إمداد Google بالنموذج الجديد Argon. ولكل حالة حل مختلف تمامًا.
حل مشكلة 429 في gemini-4-argon بخطوات عملية
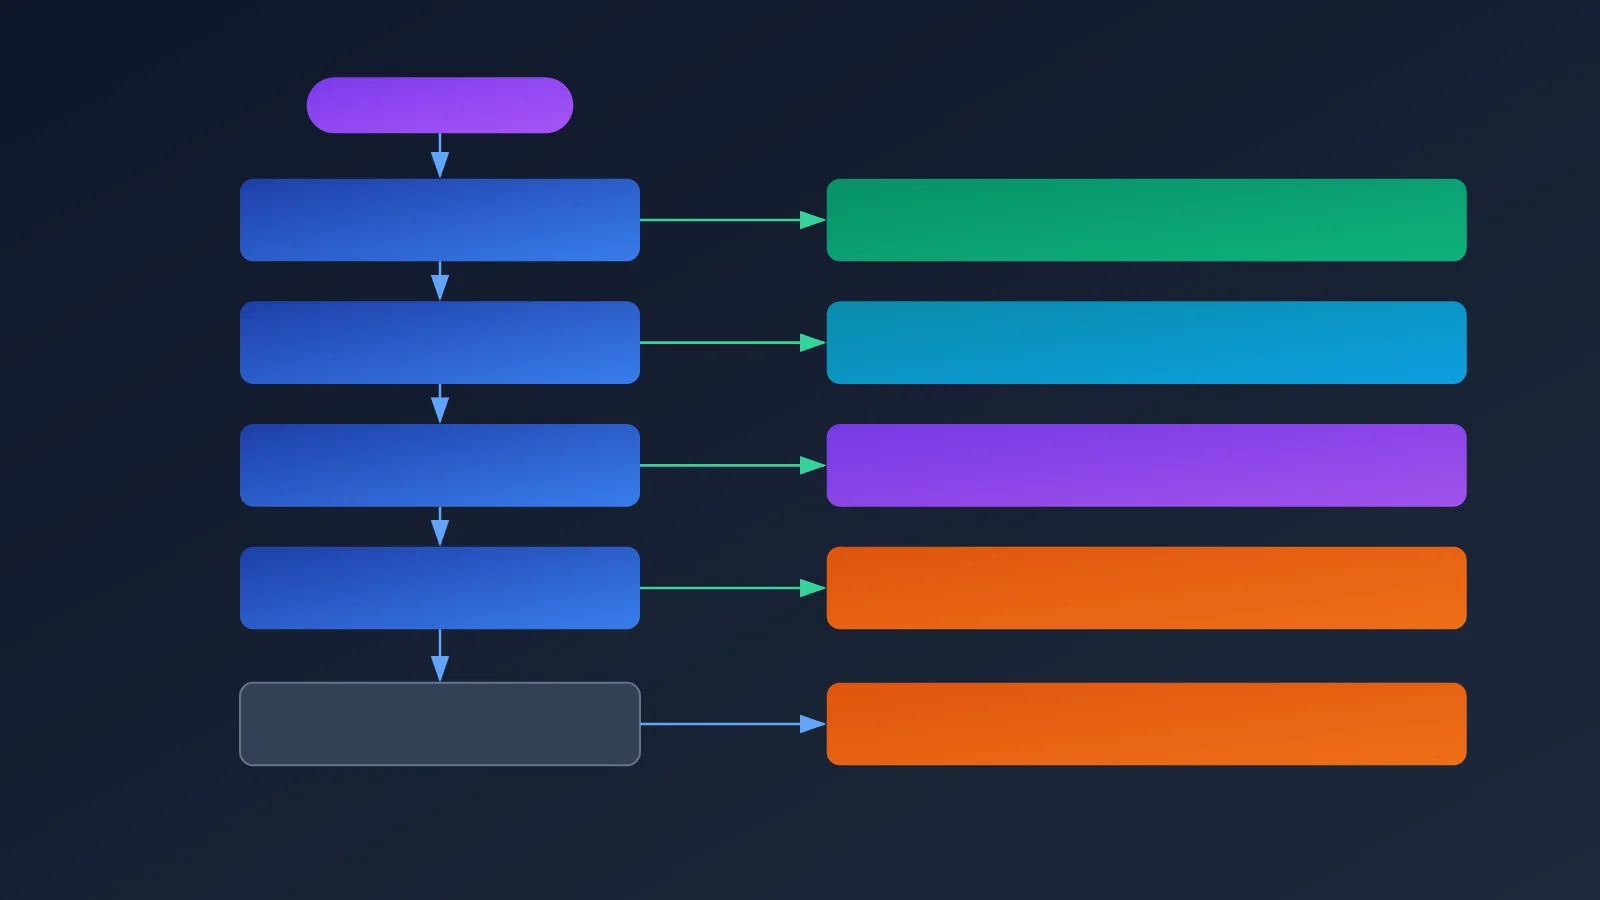
فيما يلي الإجراءات مرتبة حسب أولوية التنفيذ. يجب تنفيذ إجراءات P0 أولًا، أما P2 فتندرج ضمن التخطيط طويل الأجل.
| الأولوية | الإجراء | الغرض |
|---|---|---|
| P0 | فحص استجابة 429 الأصلية وقيمة Retry-After |
تحديد سبب تقييد المعدل بدقة |
| P0 | ضبط حدود RPM وTPM ومعدل الاستهلاك لكل مشروع | تجنب تجاوز الحصة باستمرار |
| P0 | إعادة المحاولة عند 429 مع التراجع الأُسّي وإضافة تذبذب عشوائي | الحد من آثار التقييد المفاجئ |
| P1 | التحويل تلقائيًا عند 429 إلى قناة سليمة ذات حصة مستقلة | رفع معدل النجاح |
| P1 | الترقية إلى Tier أعلى أو طلب زيادة الحصة من Google | زيادة السعة على المدى الطويل |
| P2 | تقييم Vertex AI أو قنوات أخرى معتمدة رسميًا | توسيع الموارد المتاحة |
الخطوة الأولى: افهم استجابة 429 الأصلية
لا تكتفِ برؤية رمز الحالة ثم أعد المحاولة. اطبع نص الخطأ كاملًا ورؤوس الاستجابة، وركّز خصوصًا على error.message وerror.details وRetry-After. إذا حدّد المزوّد مدة الانتظار، فاتبعها أولًا بدلًا من تخمين فترة انتظار من عندك.
الخطوة الثانية: طبّق تحديد المعدل على العميل
اضبط RPM عند 70% إلى 80% من الحد الظاهر في لوحة التحكم، وأدر TPM بشكل منفصل، وراقب كذلك قيمة الاستهلاك خلال 10 دقائق. يوفّر ترك هامش احتياطي مساحة للتعامل مع ذروة الحركة وتقلبات الخدمة من الجهة المزوّدة. تقتصر قيود المعدل لدى فرق كثيرة على عدد الطلبات، وتتجاهل الرموز والتكلفة؛ لذلك تُرفض طلباتها باستمرار رغم أنها «لم تتجاوز حد RPM».
الخطوة الثالثة: استخدم التراجع الأُسّي مع التذبذب العشوائي
توصي Google رسميًا باستخدام التراجع الأُسّي عند ظهور 429، كأن يكون الانتظار 1 ثم 2 ثم 4 ثم 8 ثوانٍ، مع إضافة تذبذب عشوائي لتجنب إعادة عدد كبير من الطلبات في اللحظة نفسها، ما قد يؤدي إلى ازدحام ثانٍ. أعد المحاولة مرتين أو ثلاثًا كحد أقصى، والتزم أولًا بمدة إعادة المحاولة التي يعيدها المزوّد.
الخطوة الرابعة: بدّل القناة إذا استمرت أخطاء 429
إذا استمر المشروع نفسه في إرجاع 429، فلا تواصل إعادة المحاولة عليه، لأن ذلك سيزيد تقييد المعدل. الإجراء الصحيح هو خفض حجم الحركة أو التحويل إلى قناة سليمة ذات حصة مستقلة. وهنا تظهر فائدة الخدمات التجميعية: عند استخدام APIYI عبر apiyi.com، يمكن توزيع الطلبات على قنوات متعددة ذات حصص مستقلة، بدلًا من تحميل مشروع واحد على AI Studio كامل الضغط.
الخطوة الخامسة: رقِّ إلى Tier أعلى أو اطلب زيادة الحصة
على المدى الطويل، لا بد من معالجة نقص السعة بترقية مستوى الحساب أو طلب زيادة الحصة من Google. بعد الترقية إلى Tier أعلى، سترتفع حدود RPM وTPM، كما قد يزيد حد الاستهلاك خلال 10 دقائق من 10 دولارات إلى 50 دولارًا أو حتى 200 دولار. لكن زيادة الحصة تحتاج إلى وقت وسجل إنفاق، لذلك غالبًا ما لا تتم بالسرعة اللازمة لمواكبة موعد إطلاق الخدمة.
الخطوة السادسة: قيّم القنوات الأخرى المعتمدة رسميًا
إذا استمر نمو حجم الخدمة، يمكنك تقييم Vertex AI أو قنوات أخرى معتمدة رسميًا لتوسيع الموارد المتاحة. كما أن العمل عبر قنوات متعددة طريقة موثوقة للحد من مخاطر الاعتماد على نقطة واحدة.
نصائح لاختبار الضغط عند إضافة قناة جديدة
عند إضافة قناة جديدة لـ Argon، يُنصح بالبدء باختبار الضغط باستخدام تزامن يتراوح بين 5 و10. انتبه إلى أن هذا مجرد إعداد أولي للاختبار، وليس حدًا رسميًا للتزامن. بعد ذلك، زد الحمل تدريجيًا وعلى مراحل، مع توزيع الطلبات بالتساوي في كل مرحلة. وسجّل معدل أخطاء 429 وRPM الفعلي وTPM والاستهلاك خلال 10 دقائق ومدة الطلب، كلًّا بحسب المورّد ومشروع Google والنموذج. انتقل إلى المرحلة التالية بعد التأكد من استقرار الأداء.
بدء سريع مع gemini-4-argon: الاستدعاء عبر APIYI
بعد أن استعرضنا الجوانب النظرية، لننتقل إلى الشيفرة. توفر APIYI واجهة متوافقة مع OpenAI؛ وكل ما عليك فعله هو استبدال base_url لاستدعاء gemini-4-argon.
مثال مبسط
تكفي الشيفرة التالية، التي تتجاوز 10 أسطر بقليل، لتنفيذ استدعاء:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

response = client.chat.completions.create(
    model="gemini-4-argon",
    messages=[{"role": "user", "content": "用一句话解释什么是 429 限流"}]
)
print(response.choices[0].message.content)
عرض الشيفرة الكاملة: استدعاءات متزامنة مع التراجع الأُسّي والتذبذب العشوائي وRetry-After
import random
import time
from concurrent.futures import ThreadPoolExecutor

import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

MAX_RETRIES = 3       # 最多重试 2-3 次
BASE_DELAY = 1.0      # 指数退避起点:1、2、4、8 秒


def call_argon(prompt: str) -> str:
    """调用 gemini-4-argon,429 时指数退避并优先遵循 Retry-After"""
    for attempt in range(MAX_RETRIES + 1):
        try:
            resp = client.chat.completions.create(
                model="gemini-4-argon",
                messages=[{"role": "user", "content": prompt}],
                max_tokens=512,
            )
            return resp.choices[0].message.content
        except openai.RateLimitError as e:
            if attempt == MAX_RETRIES:
                return f"Error after retries: {e}"
            # 优先使用上游返回的 Retry-After
            retry_after = None
            try:
                retry_after = float(e.response.headers.get("Retry-After"))
            except (AttributeError, TypeError, ValueError):
                pass
            delay = retry_after if retry_after else BASE_DELAY * (2 ** attempt)
            delay += random.uniform(0, 0.5)  # 随机抖动,避免集体重试
            print(f"429,第 {attempt + 1} 次重试,等待 {delay:.1f}s")
            time.sleep(delay)
        except Exception as e:
            return f"Error: {e}"


if __name__ == "__main__":
    prompts = [f"请用一句话介绍第 {i} 种限流策略" for i in range(10)]
    # 并发度从 5 起步压测,不是官方上限
    with ThreadPoolExecutor(max_workers=5) as pool:
        for result in pool.map(call_argon, prompts):
            print(result)
بدء سريع: نوصي بالتسجيل عبر APIYI على apiyi.com والحصول على مفتاح API، ثم تشغيل الشيفرة أعلاه مباشرة للتحقق من أداء استدعاء gemini-4-argon. توفر المنصة واجهة موحدة متوافقة مع OpenAI، فلا حاجة إلى طلب عدة مشاريع من Google وإدارتها بنفسك.
تنفيذ مبسط لتحديد المعدل على العميل
إلى جانب إعادة المحاولة، الأهم هو «تجنب الاصطدام بالجدار». يوضح المثال التالي محدِّدًا بسيطًا للمعدل يعتمد على فكرة دلو الرموز، ويمكنه تنظيم وتيرة الطلبات لتجنب ذرواتها المفاجئة:
import threading
import time


class RateLimiter:
    """按目标 RPM 匀速放行请求,避免瞬时尖峰"""

    def __init__(self, rpm: int):
        self.interval = 60.0 / rpm
        self.lock = threading.Lock()
        self.next_time = time.monotonic()

    def wait(self):
        with self.lock:
            now = time.monotonic()
            if now < self.next_time:
                time.sleep(self.next_time - now)
            self.next_time = max(now, self.next_time) + self.interval


limiter = RateLimiter(rpm=300)  # 按后台限额的 70%-80% 设置

# 在每次调用前执行:
# limiter.wait()
ضع محدِّد المعدل عند مدخل دالة الاستدعاء، واجمعه مع إعادة المحاولة بعد التراجع المذكورة أعلاه، لتحصل على طبقتين من الحماية: تحديد استباقي للمعدل وتراجع تفاعلي.
قناة التزامن العالي gemini-4-argon من APIYI
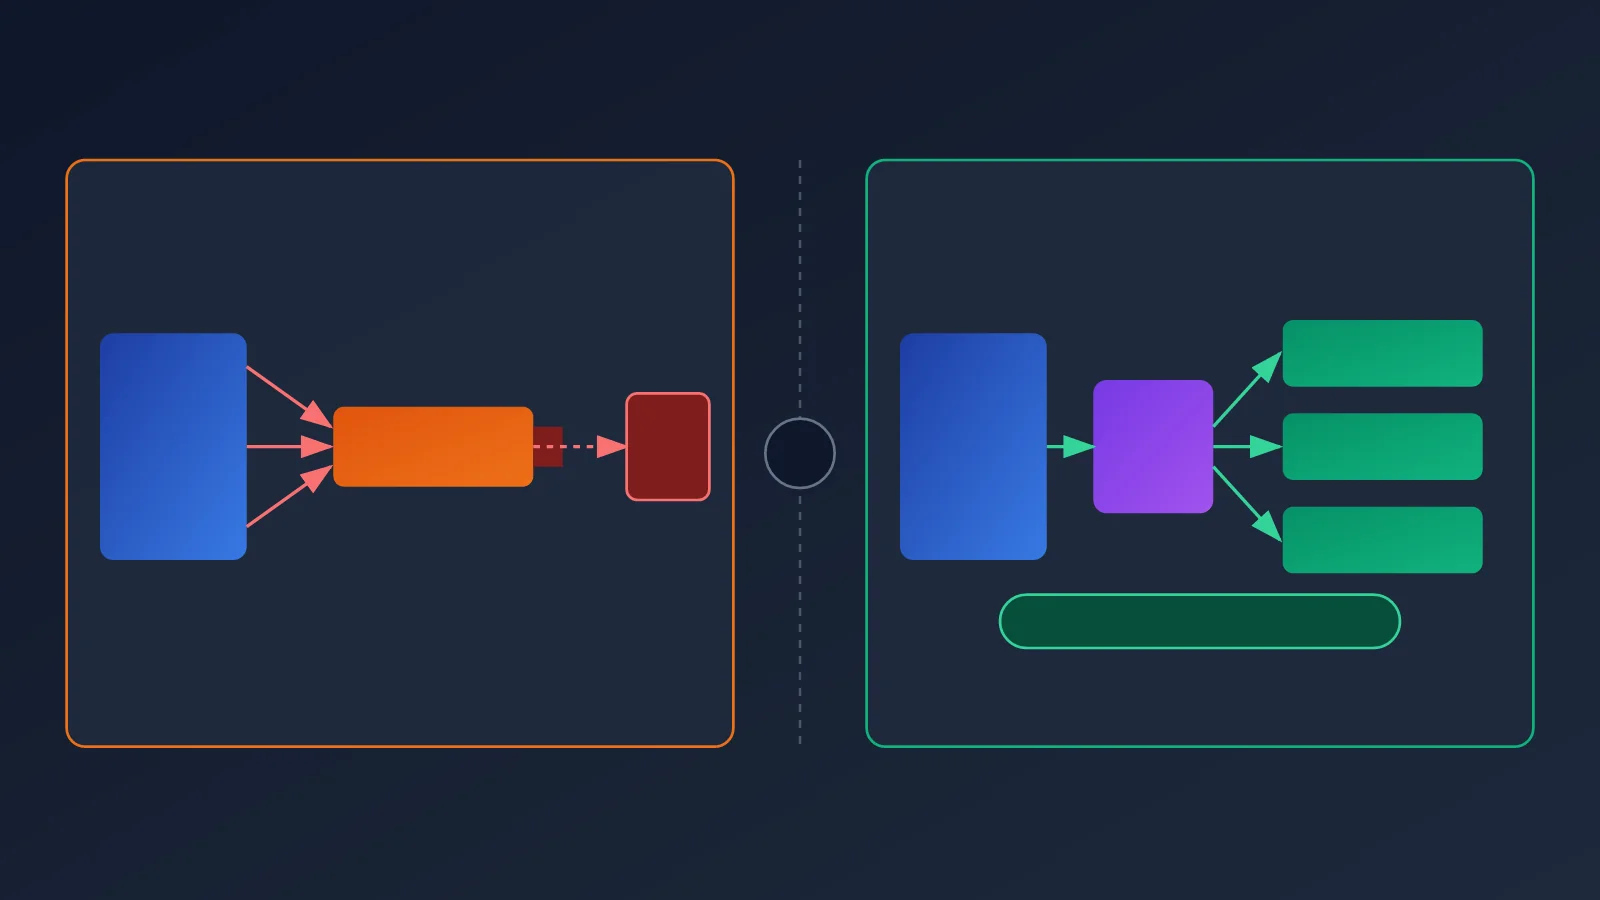
تكمن مشكلة الاتصال المباشر بـ AI Studio في أن حصة كل مشروع ثابتة، كما تواجه حسابات Tier 1 حدًا أقصى للاستهلاك قدره 10 دولارات خلال 10 دقائق. أما خدمات تجميع واجهات API، فيمكنها توزيع حركة المرور على قنوات متعددة، لكل منها حصة مستقلة، والتبديل تلقائيًا إلى قناة سليمة إذا استمرت أخطاء 429 في إحدى القنوات.
تدعم APIYI apiyi.com حاليًا gemini-4-argon مع التزامن العالي. وعند معدل أقل من 500 RPM، لن تحتاج إلى القلق بشأن تقييد المعدل، ويمكنك البدء باستخدامه مباشرةً. هذا المعدل كافٍ لتلبية الاحتياجات اليومية لمعظم التطبيقات متوسطة وصغيرة النطاق، والأدوات الداخلية، وسير العمل الآلي، واختبارات الضغط. لذلك لن تضطر إلى الانشغال بمستويات Tier أو حصص المشاريع أو نافذة الاستهلاك التي تمتد لعشر دقائق.
| جانب المقارنة | الاتصال المباشر بـ AI Studio | الاستدعاء عبر APIYI |
|---|---|---|
| الجهة التي تُحتسب عليها الحصة | مشروع واحد، وتتشارك المفاتيح المتعددة الحصة نفسها | حصص مستقلة لقنوات متعددة، وجدولة تديرها المنصة |
| التعامل مع أخطاء 429 | تنفيذ التراجع وإعادة المحاولة والتبديل بنفسك | تعطي المنصة الأولوية للتبديل إلى قناة سليمة، ويكفي أن يحتفظ العميل بآلية أساسية لإعادة المحاولة |
| قيود حدود الاستهلاك | يخضع لحد الاستهلاك خلال 10 دقائق وفق مستوى Tier | لا حاجة لإدارة مستويات حساب Google بنفسك |
| طريقة التكامل | يلزم طلب مشروع وضبط مستوى Tier | واجهة موحدة متوافقة مع OpenAI؛ يكفي استبدال base_url |
| حجم الاستخدام المناسب | حركة مرور منخفضة أو مستوى Tier مرتفع | لا حاجة للقلق بشأن تقييد المعدل عند أقل من 500 RPM |
🎯 نصيحة تقنية: إذا كان معدل الذروة في استخدامك أقل من 500 RPM، يمكنك استدعاء gemini-4-argon مباشرةً عبر APIYI apiyi.com والتركيز على منطق التطبيق. أما إذا كنت تتوقع أن يتجاوز الاستخدام هذا المعدل، فننصحك بإجراء اختبارات ضغط تدريجية والتنسيق مسبقًا مع المنصة لترتيب السعة اللازمة.
حتى عند استخدام قناة ذات تزامن عالٍ، من الأفضل الإبقاء على التراجع الأسي وضبط مهلات زمنية مناسبة لدى العميل. فقد تحدث تقلبات في الشبكة أو اضطرابات قصيرة لدى الخدمة الوسيطة، وتساعد آلية إعادة المحاولة الجيدة على إبقاء خدمتك مستقرة حتى في الظروف الصعبة.
الأسئلة الشائعة
س1: ما الحد الفعلي للتزامن في gemini-4-argon على AI Studio؟
لم تعلن Google عن حد موحّد وثابت للتزامن. وتتحدد القيود الفعلية وفقًا لحدود RPM وTPM وRPD للمشروع، إلى جانب حد الإنفاق خلال 10 دقائق. لمعرفة الحدود، انتقل إلى صفحة Rate Limits في AI Studio، ثم اختر المشروع والنموذج المعنيين. أما الأرقام المحددة المتداولة على الإنترنت، فلا تستند إلى مصدر رسمي، لذا لا يُنصح بالاعتماد عليها عند تخطيط السعة.
س2: هل يؤدي إنشاء مزيد من مفاتيح API إلى زيادة حصة gemini-4-argon؟
لا. توضح Google أن القيود تُحتسب على مستوى المشروع، لا على مستوى مفتاح API، ولذلك تتشارك المفاتيح المتعددة ضمن المشروع نفسه الحصة ذاتها. للحصول على حصة مستقلة فعلًا، يلزم استخدام مشاريع Google مختلفة أو خدمة تجميع متعددة القنوات مثل APIYI apiyi.com.
س3: لماذا أتلقى الخطأ 429 رغم أنني لم أتجاوز حدود RPM وTPM؟
السبب الأكثر شيوعًا هو بلوغ حد الإنفاق خلال 10 دقائق: 10 دولارات في Tier 1، و50 دولارًا في Tier 2، و200 دولار في Tier 3. كذلك، قد يؤدي نقص السعة لدى مزوّد الخدمة في بداية إطلاق نموذج جديد إلى رفض طلبات لم تتجاوز الحصة. يُنصح أيضًا بفحص `error.details` في نص الخطأ الأصلي للتأكد من السبب.
س4: ما الطريقة المناسبة لإعادة المحاولة عند ظهور الخطأ 429؟
استخدم التراجع الأسي، مثل الانتظار لمدة 1 ثم 2 ثم 4 ثم 8 ثوانٍ، مع إضافة تأخير عشوائي، وأعد المحاولة مرتين أو ثلاثًا كحد أقصى. واحرص على اتباع قيمة `Retry-After` الواردة في ترويسة الاستجابة أولًا. إذا استمر ظهور الخطأ 429 في المشروع نفسه، فخفّض حركة المرور أو انتقل إلى قناة ذات حصة مستقلة بدلًا من مواصلة إعادة المحاولة.
س5: كيف أستدعي gemini-4-argon بسرعة عبر APIYI؟
1. سجّل حسابًا على APIYI apiyi.com واحصل على مفتاح API.
2. اضبط `base_url` في الشفرة على `https://api.apiyi.com/v1`.
3. عيّن اسم النموذج إلى `gemini-4-argon`، ثم شغّل الشفرة النموذجية الواردة في هذه المقالة.
يدعم APIYI الاستدعاءات المتزامنة الكثيفة لـ gemini-4-argon. ولا حاجة للقلق بشأن تحديد معدل الطلبات عند البقاء دون 500 RPM، ما يجعله مناسبًا للاختبار السريع والإطلاق على نطاق صغير أو متوسط.
س6: هل سأواجه الخطأ 429 بعد استخدام APIYI؟
في نطاق الاستخدام المعتاد الذي يقل عن 500 RPM، لا داعي للقلق كثيرًا بشأن تحديد معدل الطلبات. لكن أي خدمة لدى مزوّد الخدمة قد تشهد تقلبات مؤقتة، لذا يُنصح بالإبقاء على آلية أساسية لإعادة المحاولة باستخدام التراجع الأسي. وإذا كان حجم حركة المرور في نشاطك التجاري سيتجاوز هذا النطاق، فأجرِ أولًا اختبار ضغط تدريجيًا، وتواصل مع المنصة عبر APIYI apiyi.com لتأكيد السعة.
س7: هل يمكن الاستناد إلى حصة Batch API لتقدير التزامن الفوري؟
لا. حصة Argon Batch API الواردة في وثائق Google هي حصة رموز لمهام قائمة انتظار المعالجة الدفعية دون اتصال بالإنترنت. وهي تختلف عن قيود التزامن وRPM في واجهة API الفورية، ولا يمكن تطبيق إحداهما على الأخرى.
أهم النقاط حول الخطأ 429 في gemini-4-argon
- لا يوجد حد ثابت للتزامن: لم تعلن Google عن حد موحّد للتزامن في gemini-4-argon؛ والمرجع هو الحصة الفعلية في لوحة التحكم.
- RPM لا يساوي التزامن: يعتمد التزامن على مدة معالجة الطلب، وتكون ذروة حركة المرور أكثر عرضة لتفعيل تحديد المعدل من الحركة المنتظمة.
- تُحتسب القيود على مستوى المشروع: لا تؤدي زيادة مفاتيح API إلى توسيع الحصة؛ إذ تتشارك المشاريع الحصة نفسها.
- انتبه إلى حد الإنفاق خلال 10 دقائق: يبلغ هذا الحد 10 دولارات في Tier 1، و50 دولارًا في Tier 2، و200 دولار في Tier 3. وقد يظهر الخطأ 429 حتى دون تجاوز RPM.
- استخدم التراجع وحدّد المعدل وبدّل القناة عند الحاجة: طبّق التراجع الأسي مع تأخير عشوائي، وانتقل إلى قناة ذات حصة مستقلة إذا استمر ظهور الخطأ 429.
- التعامل مع التزامن الكثيف أسهل: يدعم APIYI apiyi.com التزامن الكثيف في gemini-4-argon، ولا حاجة للقلق بشأن تحديد معدل الطلبات عند البقاء دون 500 RPM.
الخلاصة
لا يرجع تكرار أخطاء 429 عند استخدام gemini-4-argon في AI Studio إلى «انخفاض التوازي» بحد ذاته، بل إلى تداخل عدة قيود، تشمل RPM وTPM وRPD ومعدل الاستهلاك خلال 10 دقائق، إلى جانب سعة المنبع المحدودة للنموذج الجديد. لذلك ينبغي التعامل مع المشكلة على مراحل: ابدأ بفهم الاستجابة الأصلية، ثم طبّق تحديدًا استباقيًا للمعدل، واستخدم التراجع الأسي مع التذبذب العشوائي. وإذا استمرت أخطاء 429، فبدّل القناة. أما على المدى الطويل، فوسّع السعة بالترقية إلى Tier أعلى أو بإضافة قنوات مخوّلة.
للمطورين الذين يريدون تقليل عناء التعامل مع الحصص، قد يكون استخدام قناة تجميع خيارًا عمليًا أكثر. نوصي بالاستعانة بـ APIYI عبر apiyi.com لاختبار النتائج بسرعة. تدعم المنصة استدعاءات gemini-4-argon بالتوازي على نطاق واسع، ويمكنك استخدامها بثقة ما دام RPM أقل من 500. جرّبها بنفسك.
المراجع
- صفحة الاستخدام وحدود المعدل في Google AI Studio: للاطلاع على قيم RPM وTPM وRPD ومستوى Tier على مستوى المشروع
- الرابط:
aistudio.google.com/usage -
ملاحظة: اختر المشروع وgemini-4-argon للاطلاع على الحصة الفعلية
-
وثائق حدود المعدل في Gemini API: آليات تحديد المعدل الرسمية وإرشادات التعامل مع أخطاء 429
- الرابط:
ai.google.dev/gemini-api/docs/rate-limits - ملاحظة: تتضمن حدود الاستهلاك خلال 10 دقائق وإرشادات التراجع الأسي
الكاتب: فريق APIYI
للنقاش التقني: يسعدنا أن تشاركوا تجاربكم في تشخيص أخطاء 429 عند استخدام gemini-4-argon في التعليقات. ويمكنكم الاطلاع على مزيد من مواد الربط في مركز وثائق APIYI على docs.apiyi.com