الملخص: تمنح Google Decisions API درجات مباشرة للخيارات الثابتة، من دون توليد نص. ويستخدم هذا المقال الأسعار المعلنة لتقدير تكلفتها في مهام التصنيف والمراجعة والتوجيه، ويشرح حدود استخدامها بالاستناد إلى بيانات رسمية وبيانات طرف ثالث.
الخلاصة أولاً: أصدرت Google في 11 نوفمبر 2026 Gemini Decisions API (معرّف النموذج gemini-decision-1). وتستطيع في طلب واحد إنجاز 1 إلى 1,000 قرار مستقل على المدخلات نفسها. سعر الإدخال 0.10 دولار لكل مليون توكن، ولا توجد رسوم على توكنات الإخراج التوليدية. ووفق الأسعار المعلنة، فإن فحص مستند بحجم 10K توكن مقابل 1,000 قاعدة يكلّف نحو 1/20 من Gemini 3.5 Flash-Lite، أي وفر نظري بنسبة 94.9%. وعند تصنيف 1,000 رسالة مرة واحدة لكل رسالة، يبلغ الوفر النظري 73.1%. وتعطي اختبارات Google الرسمية ميزة تكلفة تبلغ نحو 4.7 أضعاف، بينما تبلغ هذه الميزة في قياس مستقل من طرف ثالث، لكل سؤال، نحو 1.5 ضعف. المهام التي تقتصر على التصنيف والمراجعة والتوجيه، ويمكن حصر إجابتها مسبقًا ضمن خيارات ثابتة، هي الأنسب لخفض التكلفة باستخدام هذه الواجهة.
يشرح الجزء التالي أولاً آلية عمل هذه الواجهة وأنواع القرارات الثلاثة، ثم يستخدم صيغًا قابلة لإعادة الحساب لتقدير تكلفة ثلاث حالات أعمال نموذجية، ويوضح الفجوة بين “نحو 5 أضعاف” التي تذكرها Google والقياس الفعلي من طرف ثالث. بعد ذلك، وبالرجوع إلى بيانات السرعة التي نشرتها Google وتقييم Artificial Analysis المستقل، يناقش ما إذا كانت الدقة تلبي متطلبات الإنتاج. وأخيرًا يعرض أبسط مثال للاستدعاء، وجدول اختيار، وقائمة فحص التكلفة قبل الإطلاق.
للتعرف: المعرفة المسبقة بالمصطلحات
| المصطلح | الشرح |
|---|---|
| Decisions API | واجهة قرارات أطلقتها Google، تُعطي النتيجة والاحتمال مباشرةً لخيارات محددة |
| Gemini Decision 1 | النموذج المتخصص الذي يدعم هذه الواجهة، ومعرّف النموذج هو gemini-decision-1 |
| Token | الوحدة الأساسية لمعالجة النموذج والفوترة؛ إذ تُحوَّل النصوص والصور وغيرها إلى Tokens |
| Shared Input | المدخل المشترك بين جميع القرارات داخل الطلب الواحد |
| Closed-set Decision | قرار يكون نطاق إجاباته محددًا مسبقًا، مثل «نعم/لا» أو «اختيار واحد من A/B/C» |
| noul | قرار ثنائي، يُعيد احتمال «Yes» |
| choice | اختيار عنصر واحد من 2–255 خيارًا محددًا مسبقًا |
| score | تقييم وفق مستويات مرتبة محددة مسبقًا، وتكون النتيجة قيمة متوقعة موزونة |
| Confidence | تقدير النموذج لاحتمال صحة النتيجة التي اختارها |
| Single Forward Pass | يحسب النموذج درجات الخيارات في تمرير حسابي واحد، دون توليد النص حرفًا بحرف |
| Context Window | إجمالي المحتوى الذي يمكن أن يستوعبه الطلب الواحد، وهو 262,144 Token لهذا النموذج |
| TPM / RPM | عدد الـ Tokens / الطلبات القابلة للمعالجة في الدقيقة، وهو سقف الإنتاجية |
1 ما الذي أصدرته Google: واجهة Gemini Decisions API المخصّصة للإجابة عن أسئلة الصح والخطأ
1.1 الفارق بين Gemini Decision 1 والنماذج التوليدية التقليدية
أُتيح Gemini Decisions API في 11 نوفمبر 2026 عبر Gemini Developer API v1beta، ونقطة نهاية REST الخاصة به هي POST https://generativelanguage.googleapis.com/v1beta/decisions. وتتمثل وظيفته الأساسية في إصدار أحكام احتمالية على خيارات محدَّدة مسبقًا، ثم إرجاع نتيجة الحكم واحتمال كل خيار ودرجة الثقة وعدد الـ Tokens المستهلكة. وتشمل المدخلات المدعومة النصوص والصور والصوت والفيديو وملفات PDF.
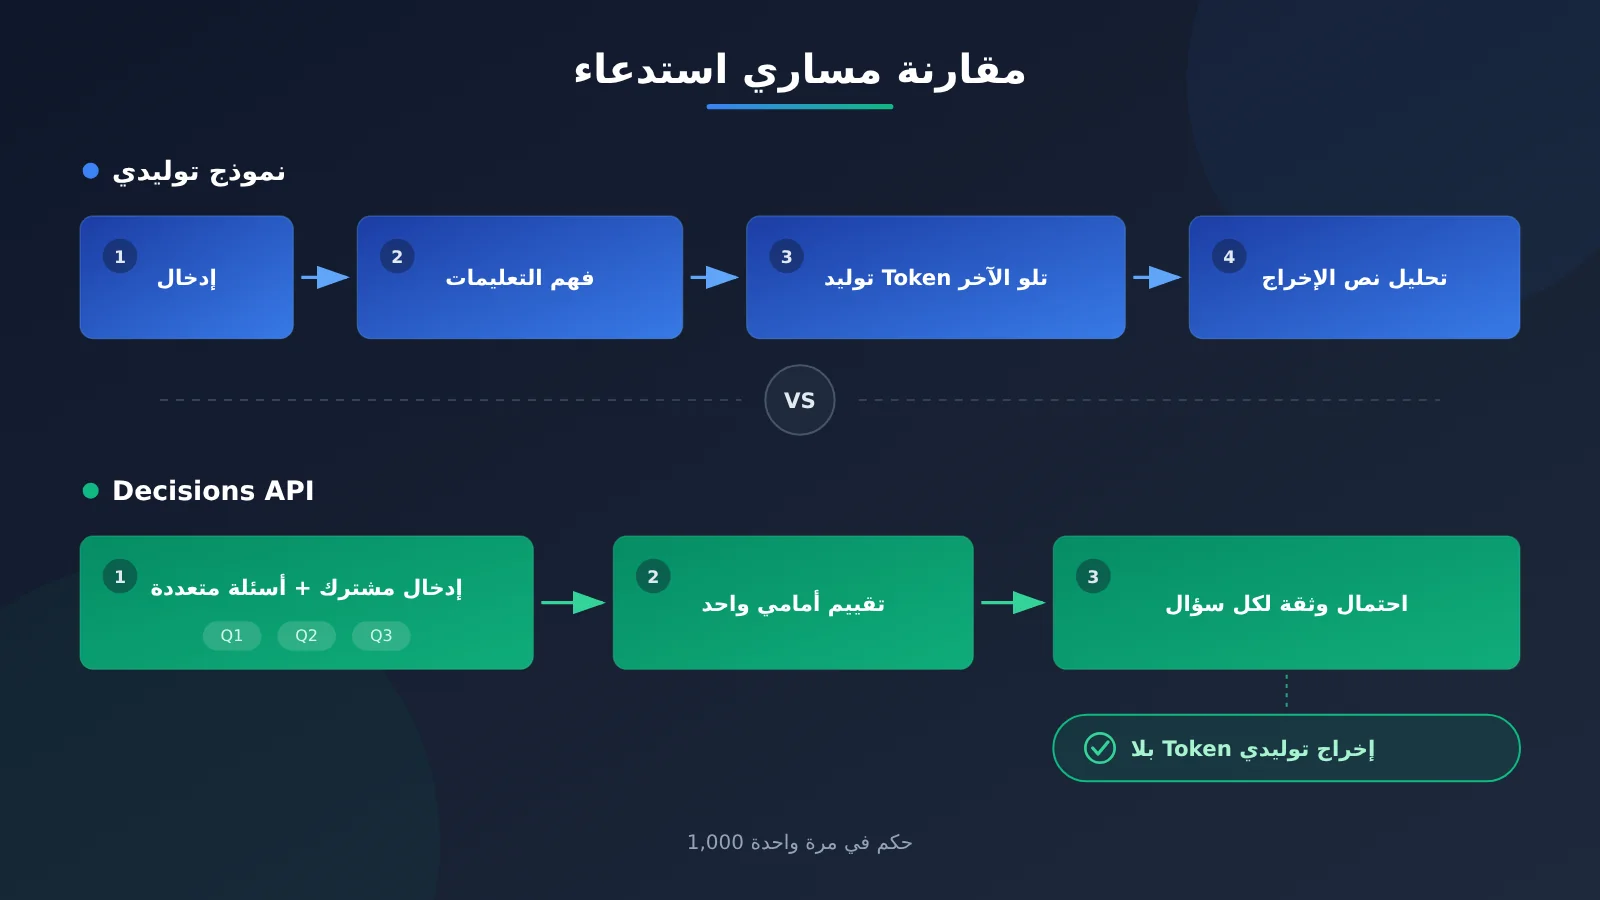
تسير النماذج التوليدية التقليدية في مهام التصنيف على هذا النحو: تقرأ المحتوى، وتفهم التعليمات، ثم تولّد إجابة Tokenًا بعد آخر، ويبقى على المطوّر أن يحلّل هذه الإجابة. أما Decisions API فتغيّر المسار: تقرأ المحتوى المشترك، ثم تمنح درجة مباشرة لكل خيار من الخيارات المعدّة مسبقًا لكل سؤال. ومهام مثل التصنيف والمراجعة وتوجيه الطلبات لا تحتاج إلا إلى وسم واحد أو إلى إجابة «نعم/لا»، أما توليد إجابة طويلة فيستهلك تكلفة إخراج ويُبطئ الاستجابة. والاستغناء عن هذه الخطوة هو مصدر خفض التكلفة وزمن التأخير.
1.2 أنماط الحكم الثلاثة في Decisions API والمهام التي تغطيها
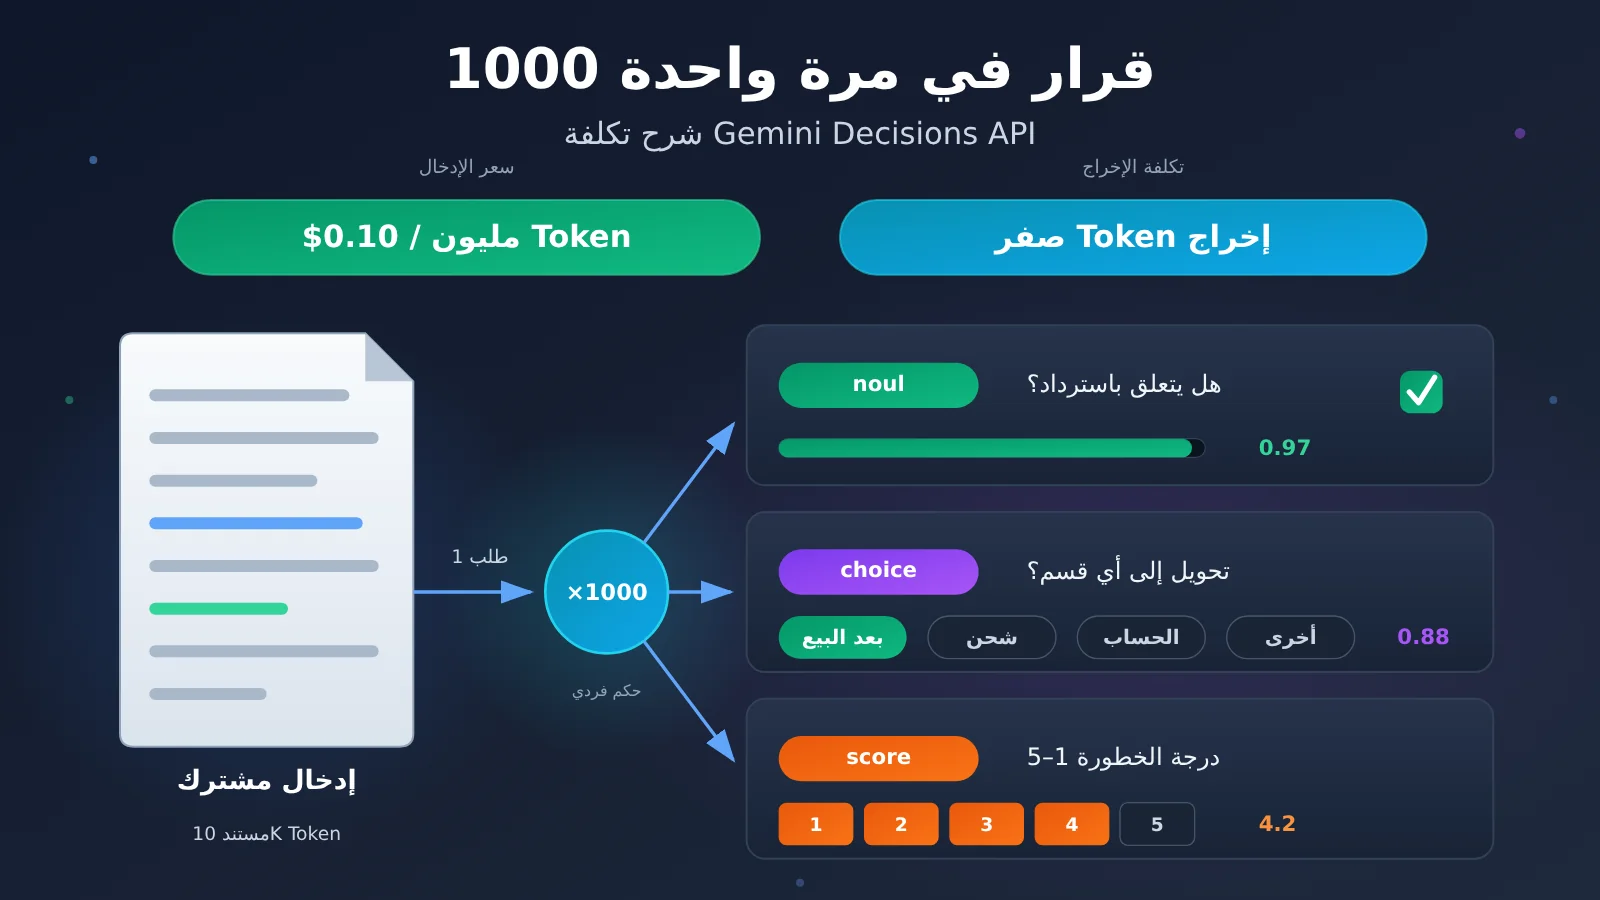
لنأخذ رسالة من عميل إلى خدمة الدعم مثالًا: «السماعة التي اشتريتها الأسبوع الماضي لا يصدر طرفها الأيسر أي صوت، وقدّمت طلب استرداد قبل ثلاثة أيام ولم يردّ عليّ أحد، وإن لم يُعالج الأمر سأقدّم شكوى إلى المنصة». ويمكننا في الطلب نفسه أن نطرح ثلاثة أسئلة مستقلة عن هذه الرسالة الواحدة.
| نوع الحكم | مثال على السؤال | ما يُرجعه | مهام نموذجية |
|---|---|---|---|
| noul | هل تتعلق هذه الرسالة باسترداد المبلغ؟ | احتمال «Yes»، مثل 0.97 | هل المحتوى مخالف، هل يُذكر السعر، هل يحتاج إلى تصعيد المراجعة |
| choice | إلى أي قسم يجب تحويلها: خدمة ما بعد البيع / الشحن / الحساب / أخرى؟ | اختيار «خدمة ما بعد البيع» مع احتمالات كل خيار | توزيع تذاكر الدعم، تصنيف المقالات، اختيار أدوات الـ Agent |
| score | ما درجة خطورة الشكوى من 1 إلى 5؟ | القيمة المتوقعة الموزونة المحسوبة من احتمالات كل درجة، مثل 4.2 | الصلة، الخطورة، ترتيب أولوية العملاء المحتملين |
يدعم choice من 2 إلى 255 خيارًا، ويدعم score من 2 إلى 255 درجة. وما يُرجعه score هو القيمة المتوقعة المحسوبة من احتمالات كل درجة، لذا يمكن استخدامه مباشرة في الترتيب أو في ضبط العتبات، دون الحاجة إلى استخراج درجة من نص تقييم.
2 ما مقدار التوفير الفعلي في تكلفة Google Decisions API؟ حسابات لثلاث حالات أعمال
2.1 لماذا يقلل الإدخال المشترك من استهلاك الـ Token
تتسم بنية تسعير Decisions API بثلاث خصائص: لا يُحتسب الإدخال المشترك إلا مرة واحدة في الطلب الواحد؛ وتُحتسب تعليمات كل سؤال بحد ذاتها كرموز إدخال؛ ولا يترتب على نتائج القرار أي رسوم إخراج توليدي. وللمقارنة، يبلغ السعر القياسي الرسمي لـ Gemini 3.5 Flash-Lite 0.30 دولار لكل مليون Token إدخال، و2.50 دولار لكل مليون Token إخراج (التسعير الرسمي بتاريخ 13 نوفمبر 2026).
لنفترض أن S هو عدد الـ Token في نسخة واحدة من الإدخال المشترك، وQ عدد الأسئلة المستقلة المرتبطة بهذا الإدخال، وTq متوسط عدد الـ Token لكل سؤال، وTo متوسط عدد رموز الإخراج لكل سؤال في النموذج التوليدي، وN عدد نسخ الإدخال. ووفق افتراض مبسّط مفاده أن «الـ Token القابلة للفوترة في الإدخال متساوية بين الواجهتين»:
تكلفة Decisions API   C_D = N × (S + Q×Tq) × 0.10 / 1,000,000
تكلفة Flash-Lite      C_F = N × [ (S + Q×Tq) × 0.30 + Q×To × 2.50 ] / 1,000,000
نسبة التوفير          = (1 − C_D / C_F) × 100%
هذا نموذج حسابي الغرض منه فهم الآلية، ولم تقدم Google نسبة توفير ثابتة. ولكل من الواجهتين ترميز تعليمات وتكاليف تنسيق خاص بهما، وتُحدد التكلفة الفعلية وفق الـ Token القابلة للفوترة التي تعيدها كل واجهة.
2.2 من قرار واحد إلى 1,000 قرار: كيف تتغير التكلفة
الجدول التالي مثال نظري مشتق من الأسعار المعلنة، ولم يخضع لاختبار حمل فعلي. في السيناريو ①، جميع القرارات الـ1,000 تخص المستند نفسه؛ فهي 1,000 سؤال مستقل يُطرح على إدخال واحد، وهذا حمل مختلف تمامًا عن «تحليل 1,000 مستند، مرة واحدة لكل مستند».
| سيناريو العمل | الافتراضات الرئيسية | Decisions API | Flash-Lite | التوفير النظري |
|---|---|---|---|---|
| ① فحص مستند واحد مقابل 1,000 قاعدة | المستند 10K Token، وكل قاعدة 20 Token، ويُخرج Flash-Lite 20 Token لكل قاعدة، ويُدمج الجانبان في طلب واحد | $0.003 | $0.059 | 94.9% |
| ② تصنيف 1,000 رسالة، مرة واحدة لكل رسالة | كل رسالة 300 Token، وتعليمات القرار 50 Token، ويُخرج Flash-Lite 10 Token | $0.035 | $0.130 | 73.1% |
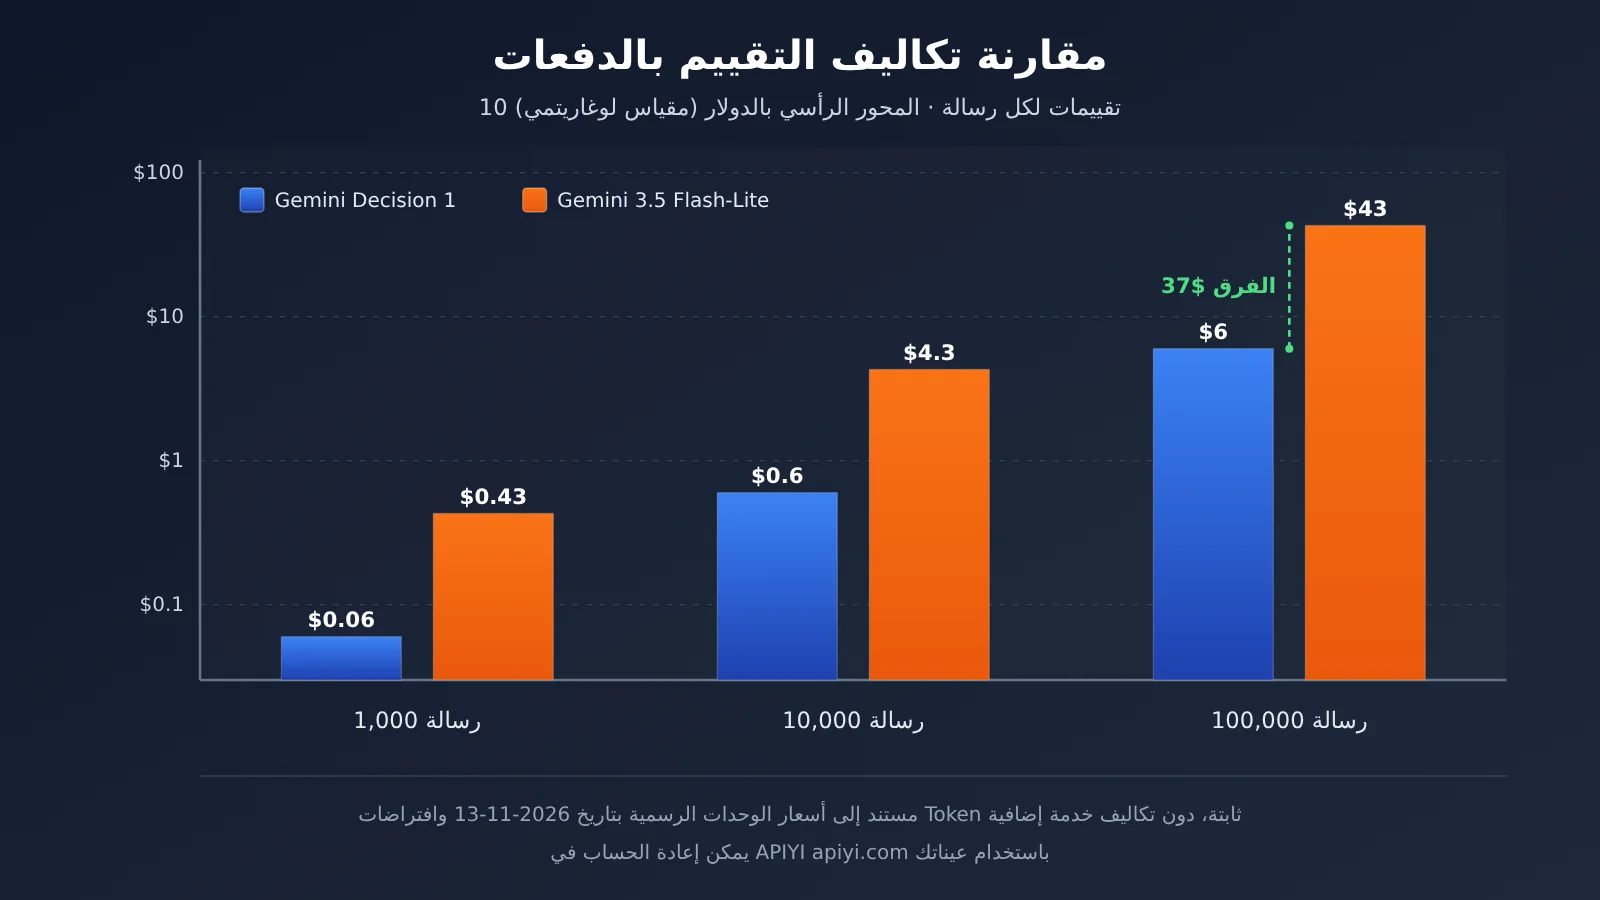
| ③ إجراء 10 قرارات لكل رسالة من 1,000 رسالة | كل رسالة 300 Token، وكل قرار 30 Token، ويُخرج Flash-Lite 10 Token لكل قرار، وطلب واحد لكل رسالة | $0.060 | $0.430 | 86.0% |
توضح السيناريوهات الثلاثة أمرين. في السيناريو ②، كل طلب يحمل سؤالًا واحدًا فقط، ومع ذلك يبقى التوفير النظري 73.1%، ومصدره انخفاض سعر الإدخال إلى الثلث وعدم وجود تكلفة للإخراج. أما في ① و③ فالتوفير أعلى لأن الإدخال المشترك يُوزَّع على عدة أسئلة، في حين يحتاج Flash-Lite إلى توليد إخراج لكل سؤال.
وبتوسيع النطاق وفق معاملات السيناريو ③: عند معالجة 100 ألف رسالة بما مجموعه مليون قرار، تكون تكلفة استدعاء النموذج لدى Decisions API هي 6 دولارات، ولدى Flash-Lite هي 43 دولارًا، أي فرق 37 دولارًا. هذا الرقم يشمل رسوم استدعاء النموذج فقط، ولا يدخل فيه إعادة المحاولة، ولا المراجعة البشرية بعد التصنيف الخاطئ، ولا الترقية إلى نموذج أقوى، ولا تكاليف النقل والتخزين وإعادة الهندسة.
إذا أردت إعادة الحساب باستخدام عينات من عملك، يمكنك أولًا تمرير المجموعة نفسها من البيانات إلى نموذج توليدي، وتسجيل Token الإدخال والإخراج الفعليين، ثم تعويض ذلك في المعادلة أعلاه. يتيح APIYI apiyi.com استدعاء Gemini وGPT وClaude وغيرها من النماذج التوليدية المتعددة بمفتاح واحد، مما يسهّل بناء خط الأساس هذا للتكلفة بسرعة.
2.3 لماذا لا تُعدّ «حوالي 5 أضعاف» التي تذكرها Google إجابةً عامة
أعلنت Google عند الإطلاق أن تكلفة Decision 1 في الاختبارات الرسمية تبلغ نحو 1/4.7 من تكلفة Gemini 3.5 Flash-Lite. لكن قدّم RanThis، وهو مختبِر مستقل، في 12 نوفمبر 2026 مجموعة أرقام أخرى بالاعتماد على استدعاءات API حقيقية: 100 رسالة بالإنجليزية و20 رسالة بالفيتنامية، مع حكم ثنائي واحد فقط في كل طلب.
- الدقة: من بين 100 حكم بالإنجليزية، أصاب Decision 1 في 99 حالة، وأصاب Flash-Lite في 98 حالة.
- التكلفة: كانت التكلفة التقديرية لكل ألف حكم بالإنجليزية $0.0113 و$0.0166 على التوالي، أي إن Decision 1 أقل بنحو 32%، بفارق يقارب 1.5 مرة.
- زمن الاستجابة: كان وسيط زمن الاستجابة للطلب الواحد 0.18 ثانية و0.58 ثانية على التوالي.
- استهلاك Token: يُحتسب لـ Decision 1 في المتوسط نحو 113 Token إدخال لكل طلب، بينما يُحتسب لـ Flash-Lite نحو 47 Token إدخال زائد Token إخراج واحد.
سبب الفرق واضح: إن تكلفة التعليمات والتنسيق الخاصة بواجهة Decisions نفسها تضاعف أكثر من مرة عدد Tokens الإدخال المحتسبة، مما يلغي جزءًا من ميزة سعر الوحدة. وحين تكون المدخلات قصيرة جدًا، ويُطرح سؤال واحد فقط في كل مرة، ولا يحتاج النموذج التوليدي إلا إلى إخراج Token واحد، يكون التوفير في أدنى مستوياته. وعندما دمج RanThis 10 أسئلة من البريد الإلكتروني نفسه في طلب Decision 1 واحد، وقارن ذلك بـ 10 طلبات Flash-Lite منفصلة، اتسع الفارق ليصل إلى نحو 5.4 أضعاف؛ لكن Flash-Lite في هذه المقارنة لم يقم بالدمج نفسه، لذا فإن المقارنة تجمع بين طريقتين مختلفتين في إرسال الطلبات.
لذلك، فإن المتغيرات التي تؤثر في التوفير الفعلي هي: طول المدخل المشترك، وعدد الأسئلة في كل مدخل، وطول إخراج النموذج التوليدي، وما إذا كان الطرفان قد قاما بدمج الطلبات، والتكلفة الثابتة الخاصة بالواجهة نفسها. تأتي اشتقاقات المعادلات ومعايير الأداء الرسمية والقياسات العملية من طرف ثالث من ظروف مختلفة، لذا ينبغي تقييمها كل على حدة عند اختيار النموذج.
3 إنجاز 1,000 حكم في طلب واحد: ما العمل الذي تناسبـه Decisions API فعلاً؟
3.1 مراجعة المستندات: مادة واحدة تُطابَق مع قواعد متعددة
أفضل ما يُستفيد من ميزة “المدخل المشترك” هو حالة “مادة طويلة + قواعد متعددة”. فعقد أو وثيقة مناقصة أو دليل منتج يحتاج إلى مقارنة بندًا بندًا مع قائمة امتثال: هل يتضمن شرط جزائي؟ هل ينص على نقل البيانات إلى خارج البلاد؟ هل تتجاوز دورة الدفع 60 يومًا؟ هل تنقصه خانة تاريخ التوقيع؟ وكلما طالت المادة وزاد عدد القواعد، توزّع المدخل المشترك على عدد أكبر من المهام، وهو بالضبط الهيكل الذي ينتج عنه الادّعاء النظري بتحقيق 94.9% من التوفير في السيناريو ①.
ميزة أخرى لهذا النوع من المهام هي أن النتائج قابلة للوضع في جدول مباشرة. فكل قاعدة تقابلها قيمة noul واحدة، تعيد احتمالاً ودرجة ثقة، ويمكن للبرنامج أن يصنّفها وفق حدود محددة إلى “مقبول / مرفوض / بانتظار المراجعة”، فلا يرى المراجع البشري إلا البنود التي تحتاج إلى تدقيق.
3.2 توجيه الوكيل وتصنيف المحتوى
يحتاج الوكيل في كل خطوة إلى تحديد الإجراء التالي: هل يحتاج إلى بحث على الإنترنت؟ هل يشغّل شفرة برمجية؟ هل يحوّل المهمة إلى أداة أخرى؟ هذه الأحكام خياراتها ثابتة، وتُستدعى بتكرار عالٍ، وحساسة لزمن الاستجابة، لذا تناسبها أداة choice لإنجازها دفعة واحدة. والاستخدامات الداخلية التي أعلنتها Google تتركّز هنا أيضًا: يستخدمها Gemini Notebook لاختيار النموذج ومستوى التفكير وفق طبيعة السؤال، ما يخفّض زمن استجابة الاستعلامات العادية بنسبة تصل إلى 40%؛ ويستخدمها Google Search لفحص أدوات MCP أمنيًا والتعرف على المحتوى العدائي؛ ويستخدمها CC لاختيار ردّ سريع من أكثر من 200 رمز Emoji مرشح. هذه بيانات Google نفسها، أما النتائج الفعلية لدى المطورين الخارجيين فتتوقف على أحمالهم الخاصة.
وسير عمل إنتاج المحتوى هو سيناريو ممتد آخر. فبعد جمع خبر تقني عن الذكاء الاصطناعي، يحتاج النظام إلى تحديد ما إذا كان حدثًا جديدًا، وهل يهم المطورين، وهل يتعلق بأسعار API، وهل له مصدر رسمي، وهل يصلح لكتابة درس تعليمي، ثم إعطاء درجة لقيمة المحتوى. هذه الشروط الستة مستقلة عن بعضها، ويمكن وضعها في طلب Decisions واحد لإتمام الفرز، ثم تُسلّم الموضوعات التي تعبر الفرز إلى نموذج توليدي للبحث والكتابة والتحرير. هذا مثال على تصميم حل مبني على قدرات الواجهة. ويمكن في مرحلة التوليد اللاحقة التبديل بين النماذج حسب الحاجة عبر APIYI على apiyi.com، لمقارنة جودة الكتابة والتكلفة.
3.3 الحدود الثلاثة لـ 1,000 سؤال
- يجب أن تكون الأسئلة مستقلة عن بعضها. فلا تستطيع الأحكام داخل الطلب الواحد قراءة نتائج بعضها. أما العمليات ذات الاعتماد التسلسلي، مثل “احكم أولاً هل هو شكوى، ثم صنّفها بحسب نوع الشكوى”، فيجب أن يجمع البرنامج نتائجها، وأن يرسل طلبًا جديدًا عند الحاجة.
- تتشارك 1,000 سؤال نافذة سياق بسعة 262,144 Token. فالمدخل المشترك وجميع الأسئلة يشتركون في هذه النافذة، وكلما طالت تعليمات كل سؤال، قلّت المادة التي يمكن استيعابها.
- بيانات زمن الاستجابة المنخفض الرسمية تغطي الطلبات الصغيرة فقط. النطاق الذي كان زمن الاستجابة فيه شبه ثابت في اختبارات Google هو 1–100 سؤال لكل طلب، وسياق لا يتجاوز 16K Token. أما مع 1,000 سؤال وسياق قريب من الحد الأقصى، فيلزم قياس زمن الاستجابة بنفسك.
4 ما بعد السعر المنخفض: هل تستطيع Gemini Decisions API تلبية متطلبات الدقة والسرعة في بيئة الإنتاج؟
4.1 بيانات السرعة والتطبيقات الداخلية التي أعلنتها Google
أعلنت Google أن متوسط زمن الحساب الوسيط للنموذج يتراوح بين 50–100 ms، وأن التأخير من طرف إلى طرف يتراوح بين 150–250 ms، وكانت شروط الاختبار هي 1–100 سؤال في كل مرة وسياق لا يتجاوز 16K توكن. وتشير هذه الأرقام إلى أنه نموذج مناسب للاستخدام في المسارات الفورية، مثل توجيه كل خطوة من خطوات الـ Agent أو التصنيف اللحظي لرسائل المستخدم. كما أن التأخير الوسيط البالغ 0.18 ثانية الذي قاسه RanThis على سؤال واحد يقع أيضًا قريبًا من هذا النطاق.
4.2 ماذا تخبرنا اختبارات الطرف الثالث
نتائج الإصدار الأولي من Decision Index v2.1 التابع لـ Artificial Analysis، محسوبة بمزيج من الدرجات الخام والمهام الفعلية. والتكاليف الواردة في الجدول أدناه هي التكلفة المختلطة لمهام هذا الاختبار المعياري، وهي تختلف في طريقة الحساب عن «سعر المليون توكن».
| نموذج القرار | الدرجة الإجمالية | زمن كل مهمة | التكلفة التقديرية لكل مليون مهمة | نسبة الإجابة الصحيحة على 15 بندًا في AA-Paperclip |
|---|---|---|---|---|
| Drex Max v1.1 | 72.62 | 283 ms | $103 | 63% |
| TypeSafe Jev 1.14 | 66.23 | 92 ms | $156 | 35.5% |
| Gemini Decision 1 | 65.98 | 211 ms | $345 | 33% |
| GPT-6 Luna (Decisions) | 60.25 | 206 ms | $339 | — |
هناك معلومتان جديران بالانتباه. أولًا، سعر التوكن في Gemini Decision 1 منخفض، لكن التكلفة التقديرية لكل مليون مهمة في توزيع المهام هذا أعلى من Drex Max وJev، ما يوضح أن طريقة الطلب وبنية المهام تغيّران الجدوى الاقتصادية النهائية. ثانيًا، في اختبار مستندات AA-Paperclip، بلغت نسبة المستندات التي أنجز فيها Decision 1 كل بنود التقييم الـ 15 مرة واحدة وبشكل صحيح 33%. إن إنجاز عدة أحكام دفعة واحدة يقلل التكلفة، لكن دقة كل بند على حدة تظل بحاجة إلى تحقق مستقل.
4.3 استخدام درجة الثقة لمنع التنفيذ التلقائي للأخطاء
درجة الثقة هي تقدير احتمالي يقدمه النموذج لنتيجته الخاصة، ويمكن استخدامها في تحديد النتائج التي تُنفَّذ تلقائيًا وتلك التي تُحال إلى عنصر بشري. ويُستحسن عند الإطلاق اعتماد ثلاثة إجراءات:
- تحديد عتبة لدرجة الثقة: مثلًا، إذا كانت درجة الثقة في قرار الاسترداد أقل من 0.85 فيُحوَّل الأمر إلى موظف بشري، ولا يتم وضع الوسم أو إحالة الطلب تلقائيًا إلا فوق العتبة.
- إضافة خيار
otherإلىchoice: عندما لا تناسب أي خيار، سيختار النموذج أحدها على أي حال؛ وإضافة «أخرى / لا يمكن التحديد» توقف جزءًا من المدخلات الخارجة عن النطاق، ويمكن أيضًا إضافةnoulمنفصل للتحقق من النطاق. - الاحتفاظ بقيود برمجية للعمليات عالية المخاطر: مبالغ الاسترداد، وحظر الحسابات، والحجب لأغراض الامتثال — إلى جانب حكم النموذج، يجب أن تكون هناك قواعد ثابتة ومراجعة بشرية.
5 كيف يستخدم المطورون Gemini Decisions API وكيف يختارونه؟
5.1 كيف ترسل أول طلب
تتطلب الوثائق الرسمية إصدار Python google-genai SDK 3.2 أو أحدث، مع دعم JavaScript SDK وREST أيضًا، ويحتاج الاتصال إلى مفتاح API من Google AI Studio. المثال التالي مُجمَّع وفق بنية الحزمة الرسمية، ويقوم على الخبر نفسه بإنشاء حكم ثنائي وحكم تصنيفي في آن واحد، لكنه لم يُتحقق منه فعليًا باستدعاء حقيقي في هذا المقال؛ لذا يُرجى الرجوع إلى دليل المطور الرسمي فيما يخص أسماء الحقول.
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    # المدخل: مدخل مشترك تستخدمه جميع الأسئلة، ويُحتسب مرة واحدة فقط
    input="Google released a new AI API with official pricing and developer documentation.",
    # الأسئلة: أحكام مستقلة عن بعضها، واسم المفتاح هو معرّف السؤال
    questions={
        "has_api_pricing": {
            "type": "noul",
            "instructions": "Does this news mention API pricing?",
        },
        "category": {
            "type": "choice",
            "instructions": "Which news category fits best?",
            "criteria": {
                "model": "An AI model launch",
                "api": "An API or developer tool",
                "business": "Business or finance news",
            },
        },
    },
)

print(result.answers)  # نتيجة كل سؤال، مع احتمال كل خيار ودرجة الثقة
print(result.usage)    # استخدام الرموز المفوترة، وعليه يُعتمد في حساب التكلفة
وظائف الحقول الأربعة الرئيسية كالتالي: يضع input المحتوى المشترك، ويضع questions الأسئلة المستقلة (ولطريقة كتابة تعريفات المستويات في نوع score راجع الدليل الرسمي)، ويقرأ answers نتائج الأحكام والاحتمالات، ويقرأ usage الرموز المفوترة. عند حساب التكلفة يجب دائمًا الاعتماد على القيمة الفعلية من usage، فقد أوضح القسم 2.3 أن التكلفة الثابتة للواجهة تؤثر تأثيرًا ملحوظًا على تكلفة السؤال الواحد.
ولإجراء مقارنة في التكلفة، نحتاج أيضًا إلى خط أساس من نموذج توليدي. يستخدم المثال التالي واجهة متوافقة مع OpenAI عبر APIYI لاستدعاء Flash-Lite وإتمام التصنيف نفسه، مع تسجيل استخدام الرموز:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI المتوافقة مع OpenAI
)

resp = client.chat.completions.create(
    model="gemini-3.5-flash-lite",  # اعتمد الاسم الفعلي في قائمة نماذج المنصة
    messages=[{
        "role": "user",
        "content": "News: Google released a new AI API with official pricing.\n"
                   "Q1 mentions API pricing? Answer yes/no.\n"
                   "Q2 category: model/api/business. Answer one word each line."
    }],
    max_tokens=10,
)
print(resp.choices[0].message.content)
print(resp.usage)  # رموز الإدخال والإخراج، تُعوَّض في معادلة القسم 2.1
عرض نص برمجي للمقارنة الدفعية: حساب تكلفة الواجهتين على دفعة العينات نفسها
import openai

PRICE_IN, PRICE_OUT = 0.30, 2.50   # السعر القياسي الرسمي لـ Flash-Lite، بالدولار لكل مليون توكن
DECISION_IN = 0.10                 # سعر الإدخال في Decision 1، ولا يتم احتساب الإخراج

gen_client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def flash_lite_cost(samples, questions, model="gemini-3.5-flash-lite"):
    """اجمع كل أسئلة كل عينة في طلب توليدي واحد، ثم راكم التكلفة الفعلية المحتسبة"""
    total = 0.0
    for text in samples:
        prompt = text + "\n" + "\n".join(
            f"Q{i+1}: {q} Answer briefly." for i, q in enumerate(questions)
        )
        r = gen_client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
            max_tokens=10 * len(questions),
        )
        total += (r.usage.prompt_tokens * PRICE_IN
                  + r.usage.completion_tokens * PRICE_OUT) / 1_000_000
    return total

def decision_cost(usage_input_tokens_list):
    """مرّر توكنات الإدخال من usage التي يعيدها Decisions API في كل مرة، واحسب التكلفة الإجمالية"""
    return sum(t * DECISION_IN for t in usage_input_tokens_list) / 1_000_000
🚀 نصيحة للبدء السريع: ابدأ باختيار 200–500 عينة حقيقية من أعمالك، وشغّل النموذج التوليدي للحصول على دقة خط الأساس واستهلاك التوكنات، ثم قارنها بحقل
usageفي Decisions API. يوفر APIYI apiyi.com واجهة متوافقة مع OpenAI وحصة تجريبية مجانية للمستخدمين الجدد، وهي مناسبة لإنجاز اختبار خط الأساس هذا بسرعة.
5.2 متى تختار Decisions API ومتى تواصل استخدام النماذج التوليدية
| نوع المهمة | الحل الموصى به | السبب |
|---|---|---|
| مراجعة مستند طويل واحد مقابل قواعد متعددة | Decisions API | مشاركة المدخلات تُخفّف التكلفة، والأحكام مستقلة عن بعضها |
| توجيه أدوات Agent واختيار النموذج | Decisions API | الخيارات ثابتة، وزمن الاستجابة منخفض |
| فحص أمان المحتوى والانتهاكات | Decisions API | شروط noul متعددة ومستقلة، ويمكن استخدام درجة الثقة للفرز |
| تصنيف تذاكر خدمة العملاء ووسوم ما بعد البيع في التجارة الإلكترونية | Decisions API | مجموعة وسوم ثابتة |
| تصفية المواضيع وتقييم أولوية العملاء المحتملين | Decisions API | مناسب لـ score بمقياس محدد مسبقًا |
| التلخيص وإعادة الصياغة والكتابة | نموذج توليدي | يحتاج إلى إخراج لغة طبيعية |
| البحث المعقد والاستدلال وطرح أفكار جديدة | نموذج توليدي | يحتاج إلى استدلال مفتوح |
| العمليات التي تعتمد فيها الأحكام على ترتيب متسلسل | تنسيق برمجي + طلبات متعددة، أو نموذج توليدي | الأسئلة داخل الطلب الواحد لا يمكن أن تشير إلى بعضها |
يمكن للإخراج المنظم من النماذج التوليدية (JSON Schema) أن يقيّد الإجابة في صيغة ثابتة أيضًا، لكنه يظل يولّد المحتوى Tokenًا بعد Token ويُحاسَب على أساس الإخراج، ولا تُتاح الاحتمالات إلا بعد معالجة إضافية. أما Decisions API فيعيد مباشرة احتمال كل خيار ودرجة الثقة به، دون احتساب تكلفة للإخراج، والثمن هو أنه لا يمكنه الإجابة إلا عن أسئلة تكون خياراتها محددة مسبقًا.
5.3 ما التكاليف الأخرى التي يجب حسابها قبل الإطلاق؟
إلى جانب سعر الوحدة، تؤثر البنود التالية مباشرةً في “التكلفة الإجمالية لكل قرار صحيح”:
- تكلفة Token الفعلية: اعتمد على
usageكمصدر مرجعي؛ في حالات المدخلات القصيرة وسؤال واحد، تكون نسبة التكاليف الثابتة هي الأعلى. - حدود الطلبات: الطبقة المجانية هي 200 RPM و50,000 TPM و10,000 RPD؛ والطبقة المدفوعة Tier 1 هي 1,500 RPM ومليون TPM و50,000 RPD. غالبًا ما تصل الطلبات ذات السياق الطويل إلى حد TPM أولاً.
- غياب التخزين المؤقت والمعالجة بالدفعات: لا يدعم Context Caching أو Batch API أو الاستنتاج Flex/Priority؛ وعند إعادة استخدام المستند الطويل نفسه، لن تستفيد من خصم التخزين المؤقت.
- قيود الميزات: لا يمكن تضمين محتوى وسائط في تعليمات السؤال، ولا يمكن تمرير سجل المحادثة الكامل أو كتل التفكير أو استدعاء الأدوات مباشرةً؛ ويجب أولاً تحويل المحادثات متعددة الأدوار إلى إدخال نصي.
- الأخطاء والمراجعة البشرية: نسبة إحالة الحالات منخفضة الثقة إلى موظف بشري، وتكلفة إعادة العمل بعد الخطأ، ينبغي احتسابهما ضمن تكلفة الوحدة.
- شروط معالجة البيانات: قد تُستخدم بيانات الطبقة المجانية لتحسين منتجات Google، ويُظهر جدول التسعير الرسمي أن الطبقة المدفوعة لا تُستخدم لهذا الغرض. قبل معالجة مستندات العملاء، تأكد من الطبقة التي تستخدمها.
- التعديلات الهندسية: إعادة صياغة الموجهات التوليدية كأسئلة noul / choice / score، وإنشاء عتبات ومنطق احتياطي، كل ذلك يتطلب استثمارًا في التطوير.
إذا كنت تخطط للاتصال عبر منصة API تابعة لطرف ثالث، فيجب التأكد مما إذا كانت المنصة تدعم نقطة النهاية المخصصة /v1beta/decisions؛ فالمنصات التي تدعم Chat Completions فقط لا تستطيع استدعاء Decisions API مباشرةً. قبل الاستخدام على APIYI apiyi.com، يمكنك أولاً مراجعة قائمة النماذج ونقاط النهاية في مركز التوثيق، أو التواصل مع المنصة للتأكد من الدعم.
6 الخاتمة: يمكن إسناد مهام التصنيف والمراجعة والتوجيه إلى Gemini Decisions API
بالعودة إلى السؤال الوارد في العنوان، يمكن تلخيص الاستنتاجات في ثلاث نقاط:
- المهام ذات الخيارات الثابتة تستحق أن تُمنح الأولوية في Decisions API. ووفقًا للأسعار المعلنة، يبلغ التوفير النظري في تصنيف سؤال واحد نحو 73%، ويبلغ التوفير النظري عند مراجعة ألف قاعدة في الوثيقة الطويلة نفسها نحو 95%؛ أما الميزة المقاسة لدى طرف ثالث لسؤال واحد فتبلغ نحو 32%.
- بنية «مدخل واحد، أسئلة مستقلة متعددة» هي الأكثر إمكاناتٍ لخفض التكلفة. إذ يُحتسب المدخل المشترك مرة واحدة فقط، وكلما زاد عدد الأسئلة وطول المدخل وطول مخرجات النموذج التوليدي، اتسعت الفجوة.
- المعيار النهائي هو التكلفة الإجمالية لكل قرار صحيح في بيئة الإنتاج. سعر وحدة الـToken وحد 1000 سؤال هما نقطة البداية، لكن نسبة الدقة، ونسبة العنصر البشري بعد فرز الثقة، والحدود القصوى، والتكاليف الهندسية تحدد جميعًا العائد الفعلي.
المسار الأكثر أمانًا هو: أولًا بناء خط أساس للنموذج التوليدي باستخدام عينات حقيقية، ثم مقارنة usage والدقة على Decisions API، وفصل تصميم طبقة الحكم عن طبقة التوليد. ويمكن إتمام اختيار نموذج طبقة التوليد ومقارنة تكاليفه عبر APIYI apiyi.com باستخدام واجهة موحدة.
📚 المراجع
- دليل مطوّر Google Gemini Decisions API وجدول التسعير: قدرات الواجهة وقيودها وحدود المعدل والأسعار الرسمية
- الرابط:
ai.google.dev -
التفاصيل: معرّفات النماذج، أنواع الأسئلة، نافذة السياق، حدود المعدل، وطريقة استخدام SDK
-
مقال إعلان من المدونة الرسمية لـ Google: تاريخ النشر وبيانات زمن الاستجابة وحالات استخدام داخلية
- الرابط:
blog.google -
التفاصيل: زمن حسابي يتراوح بين 50–100 مللي ثانية، ميزة تكلفة تبلغ نحو 4.7 أضعاف، وحالات مثل Gemini Notebook
-
نقطة نهاية REST لواجهة Gemini Decisions API
- الرابط:
generativelanguage.googleapis.com/v1beta/decisions -
التفاصيل: نقطة النهاية الرسمية للاستدعاء عبر REST
-
Artificial Analysis Decision Index v2.1: تقييم نماذج القرار من طرف ثالث
- الرابط:
artificialanalysis.ai -
التفاصيل: الدرجات المركّبة، زمن تنفيذ المهام، تكلفة كل مليون مهمة، ونسبة الإجابات الصحيحة الكاملة في AA-Paperclip
-
اختبار مستقل من RanThis (2026-11-12): اختبار صغير الحجم مبني على استدعاءات حقيقية
- التفاصيل: مقارنة تكلفة السؤال الواحد وزمن الاستجابة واستهلاك الـ Token، وكذلك نتائج دمج عدة أسئلة في طلب واحد
المؤلف: فريق APIYI التقني
للتواصل التقني: نرحب بتواصلك معنا عبر الصفحة الرئيسية لـ APIYI على apiyi.com، ولمزيد من مواد التكامل يمكنك زيارة مركز الوثائق على docs.apiyi.com