في 9 نوفمبر 2026، أعلنت Google Cloud عن تكوينين جديدين لأنظمة الجيل الثامن من TPU: TPU 8tx وTPU 8i Max. يدمج TPU 8i Max شريحتي TPU 8i في حزمة واحدة، ما يضاعف في الوقت نفسه قدرة الحوسبة وذاكرة SRAM المدمجة على الشريحة وعرض نطاق HBM. ويستهدف هذا النظام سيناريوهات الاستدلال التي تتطلب سياقًا طويلًا وتوازيًا عاليًا وتعاونًا بين عدة وكلاء.
هذا الإعلان لا يقتصر على تكديس قدرات الحوسبة. فقد أكدت المعلوماتَ الإعلاناتُ الرسمية من Google، وإعلانُ التعاون المتزامن من AMD، إلى جانب تقارير موجزة من عدة وسائل إعلام. لا يسرد هذا المقال مواصفات الشرائح، بل يستخدم حسابات عملية لذاكرة KV Cache لتوضيح أمر واحد: يتحول عنق الزجاجة في استدلال الوكلاء من «سرعة الحساب» إلى «قدرة البيانات على الوصول إلى وحدات الحوسبة في الوقت المناسب».
الفائدة الأساسية: بعد قراءة هذا المقال، ستتمكن من تقدير مقدار ذاكرة الفيديو التي يحتاج إليها طلب ذو سياق طويل، وفهم أسباب ظهور جدار الذاكرة، وتحديد ما يعنيه تصميم أنظمة مثل TPU 8i Max لخدمة الوكلاء لديك.
لمحة سريعة عن أبرز المعلومات حول TPU 8i Max والسياقات الطويلة للوكلاء
| بند المعلومات | التفاصيل |
|---|---|
| تاريخ الإعلان | 9 نوفمبر 2026 |
| الجهة المُعلنة | Google Cloud |
| طبيعة المنتج | تكوين نظام للجيل الثامن من TPU، وليس شريحة مستقلة بتصميم جديد بالكامل |
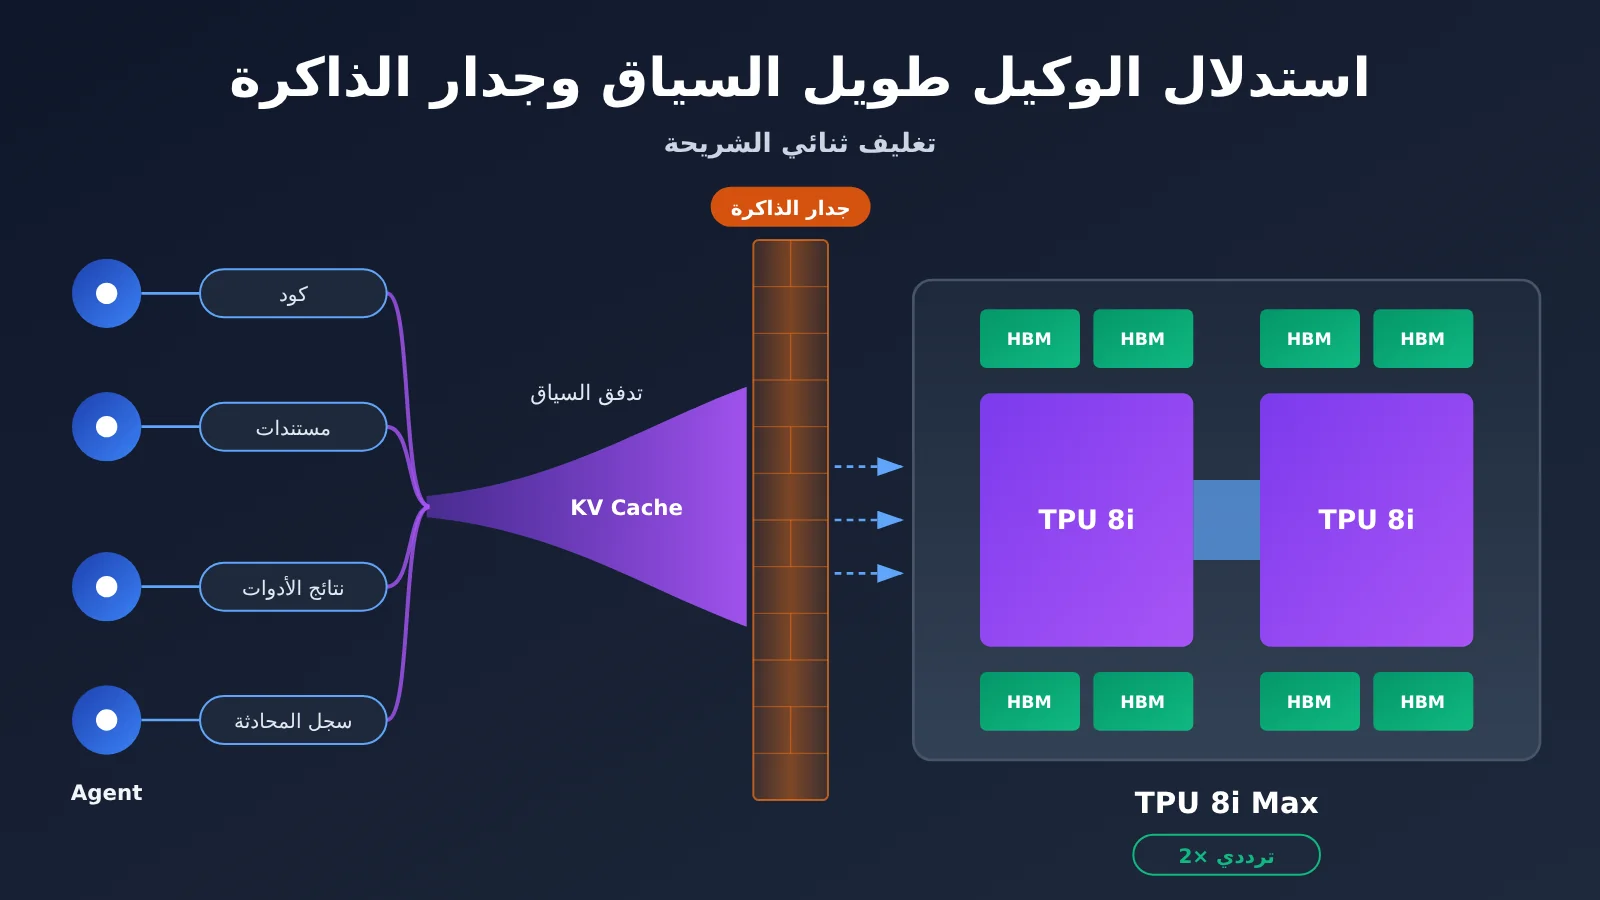
| طريقة التغليف | دمج شريحتين من TPU 8i في حزمة واحدة |
| التحسينات المؤكدة رسميًا | ضعف القدرة الحاسوبية وسعة SRAM وعرض نطاق HBM مقارنةً بـ TPU 8i |
| المواصفات التي كُشف عنها في إحاطة إعلامية | 384 GB من HBM، وعرض نطاق HBM يبلغ 17.2 TB/s، و768 MB من SRAM |
| حالات الاستخدام المستهدفة | السياقات الطويلة، والاستدلال عالي التوازي، وتعاون الوكلاء المتعددين، وتحليل الفيديوهات الطويلة وغيرها |
| حالة التوفر | تشير صفحة المنتج الرسمية إلى «Coming soon» (قريبًا)، ولم يُعلن بعد عن الأسعار أو موعد التوافر العام (GA) |
من المهم التأكيد أن Google تميّز عمدًا في إعلانها بين الشريحة (chip) والنظام (system). فدورة تصميم الشرائح تُقاس بالسنوات، بينما يمكن تكييف تكوين النظام بسرعة أكبر ليناسب أعباء العمل الجديدة، عبر تعديل التغليف والذاكرة والشبكات ومكوّنات الأمان. ويجسّد TPU 8i Max هذه الفكرة: إذ يستخدم شريحة TPU 8i نفسها، فيما تتركز التغييرات على مستوى التغليف والنظام.
لماذا يستهلك السياق الطويل في الوكلاء ذاكرة أكبر من الدردشة العادية
تسير الدردشة العادية غالبًا وفق نمط «سؤال وجواب»، لذلك ينمو السياق ببطء، ويمكن التخلص من حالة المحادثة بعد انتهائها. أما الوكيل، فيقسّم الهدف إلى مهام فرعية، ويواصل قراءة المصادر الخارجية واستدعاء الأدوات والاستدلال بناءً على الملاحظات، مع الاحتفاظ بحالته أثناء انتظار النتائج. وتُضاف مخرجات كل خطوة إلى السياق، فيزداد حجمه باستمرار.
لنأخذ وكيلًا لتطوير البرمجيات مثالًا. فقد يحمل في أثناء تنفيذ مهمة واحدة كل ما يلي:
- قاعدة الشيفرة: مئات الملفات المصدرية وعلاقات التبعيات بينها
- وثائق المشروع: شرح البنية، ومواصفات الواجهات، ومعايير كتابة الشيفرة
- سجل المحادثة: جولات متعددة من توضيح متطلبات المستخدم وملاحظاته على التعديلات
- نتائج الأدوات: سجلات البناء، ومخرجات الاختبارات، ومكدسات الأخطاء
- مخرجات الوكلاء الفرعيين: النتائج التي يعيدها كل وكيل فرعي مسؤول عن الاختبار أو المراجعة أو إعادة الهيكلة
والأهم من ذلك هو التوازي. فعندما ينشئ وكيل رئيسي 4 وكلاء فرعيين، يكون لدى النظام 5 سياقات مستقلة في الوقت نفسه. ويجب أن يبقى كل سياق في الذاكرة أثناء الاستدلال، وهذا ما يفسر إدراج Google «تطوير مشروعات برمجية كبيرة بالتعاون بين عدة وكلاء» ضمن السيناريوهات النموذجية لـ TPU 8i Max. تجدر الإشارة إلى أن «السياق الذي يصل حجمه إلى مليون رمز» الذي ذكرته Google هو وصف لسيناريو التطبيق المستهدف، وليس مواصفة معلنة وثابتة للحد الأقصى لحجم السياق.
كيف تنمو ذاكرة KV Cache خطيًا مع طول سياق الوكيل
دور ذاكرة KV Cache
عندما يُولّد Transformer رمزًا جديدًا، يستخدم Query الخاص بالرمز الحالي لحساب درجات الانتباه مع مفاتيح Key لجميع الرموز السابقة، ثم يستخدم الأوزان الناتجة لحساب مجموع مرجّح لقيم Value الخاصة بالرموز السابقة. ولو أُعيد حساب Key وValue لجميع الرموز السابقة عند توليد كل رمز جديد، لتضخّم حجم العمليات الحسابية سريعًا مع ازدياد طول السياق. لذلك تحفظ آلية KV Cache قيم Key وValue المحسوبة للرموز السابقة، ثم تعيد استخدامها؛ أي إنها تستبدل الحسابات باستهلاك الذاكرة.
لكن هذه الذاكرة تواصل النمو مع ازدياد طول السياق وعدد الطلبات المتزامنة. ويتوافق التقدير التالي مع تخطيط ذاكرة KV Cache في vLLM:
M_KV = 2 × L × H_KV × D × B × T × N
| المعامل | المعنى | القيمة في Llama 3.1 70B |
|---|---|---|
| 2 | نسختا التخزين المؤقت لـ Key وValue | 2 |
| L | عدد طبقات Transformer | 80 |
| H_KV | عدد رؤوس الانتباه لـ Key/Value | 8 (GQA) |
| D | بُعد كل رأس KV | 128 |
| B | عدد البايتات لكل عنصر | 2 (BF16) |
| T | عدد الرموز في كل طلب | يتغير حسب السيناريو |
| N | عدد الطلبات المتزامنة | يتغير حسب السيناريو |
مثال على حساب ذاكرة KV Cache في Llama 3.1 70B
لنحسب أولًا استهلاك رمز واحد: 2 × 80 × 8 × 128 × 2 = 327,680 بايت، أي نحو 320 KiB لكل رمز. قد يبدو هذا الرقم صغيرًا، لكنه يتضخم بسرعة عند ضربه في طول السياق.
| السيناريو | طول السياق | عدد الطلبات المتزامنة | ذاكرة KV Cache النظرية |
|---|---|---|---|
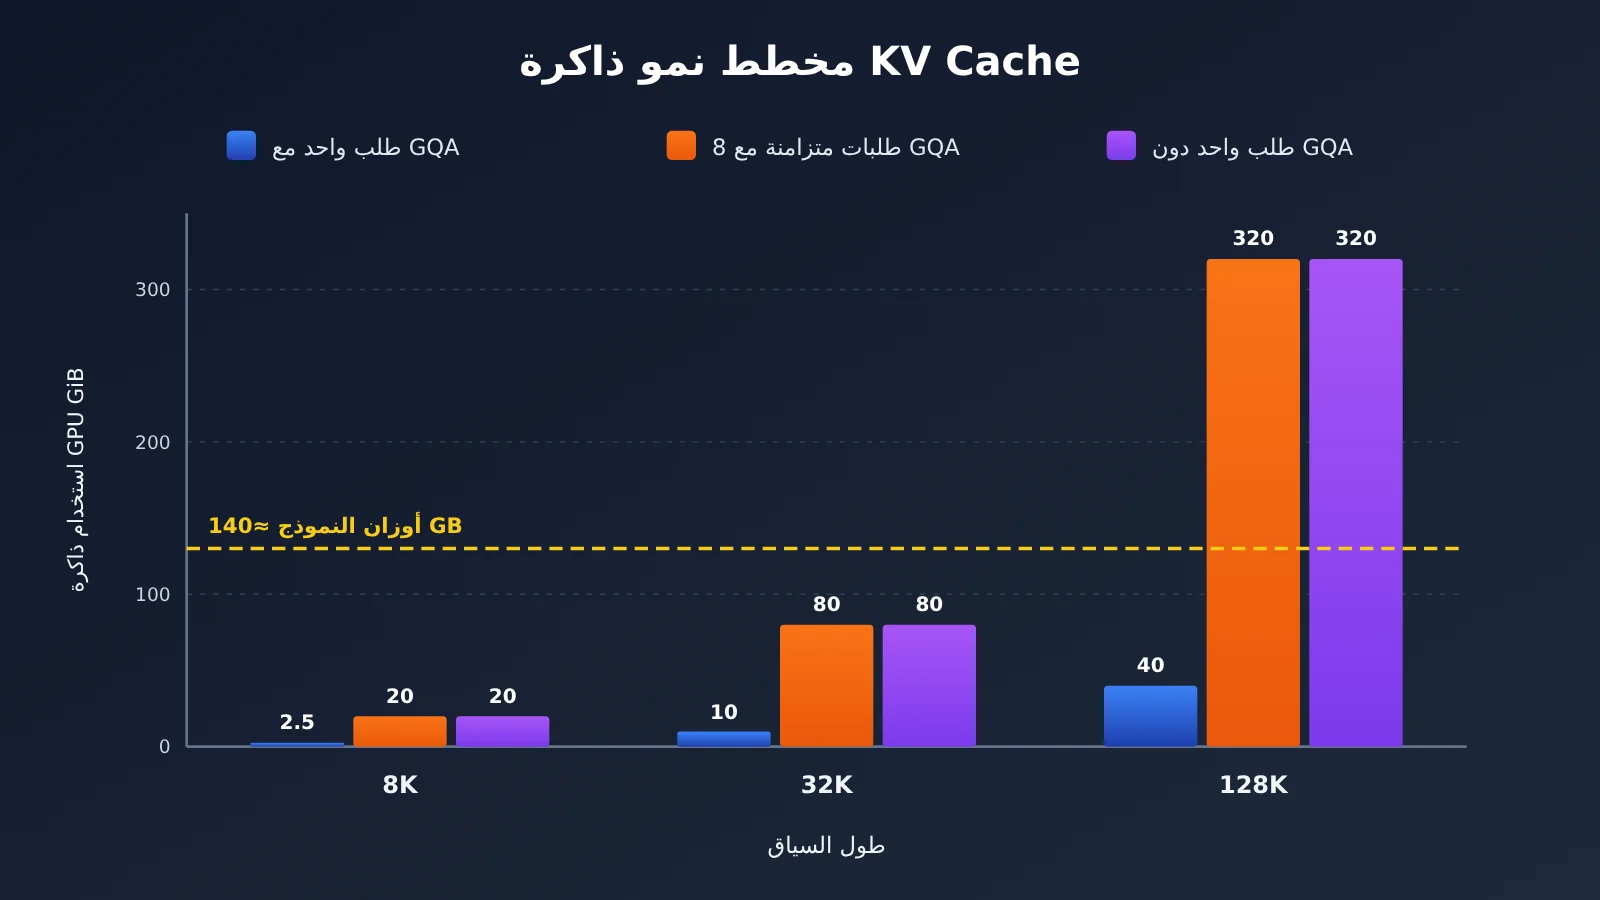
| مهمة قصيرة | 8K | 1 | 2.5 GiB |
| مهمة برمجية متوسطة | 32K | 1 | 10 GiB |
| وكيل بسياق طويل | 128K | 1 | 40 GiB |
| عدة وكلاء يعملون بالتوازي | 128K | 8 | 320 GiB |
تقتصر هذه الحسابات على ذاكرة KV Cache، ولا تشمل أوزان النموذج أو مساحة العمل وقت التشغيل أو النفقات الناتجة عن تجزئة الذاكرة. وللمقارنة، يحتاج تخزين أوزان نموذج يضم 70 مليار مُعامل بتنسيق BF16 إلى نحو 140 GB. وهذا يعني أن ذاكرة KV Cache اللازمة لثماني جلسات متزامنة، طول سياق كل منها 128K، تتجاوز ضعف حجم أوزان النموذج.
تأثير GQA في استهلاك ذاكرة KV Cache
يحتوي Llama 3.1 70B على 64 رأس انتباه، لكنه يستخدم 8 رؤوس KV فقط. وهذا هو مفهوم GQA (الانتباه ذي الاستعلامات المجمّعة): تشترك كل 8 رؤوس Query في مجموعة واحدة من Key/Value. عند الحساب، يجب استخدام العدد 8 لا 64، وإلا فستكون النتيجة أكبر بثمانية أضعاف.
تُظهر تجربة افتراضية مضادة للواقع قيمة GQA بوضوح. فلو استخدم النموذج انتباهًا متعدد الرؤوس تقليديًا، مع الاحتفاظ بـ KV مستقل لكل واحد من الرؤوس الـ64، لارتفع حجم KV Cache لطلب واحد بطول 128K من 40 GiB إلى 320 GiB؛ أي إن طلبًا واحدًا سيستهلك كامل الذاكرة المطلوبة لسيناريو GQA ذي 8 طلبات متزامنة. أما MQA فيقلّص عدد رؤوس KV إلى رأس واحد، ما يوفر مزيدًا من الذاكرة، لكن ينبغي موازنة ذلك مع أثره في جودة النموذج. ويمكن أيضًا تكميم KV Cache، مثل خفض الدقة من BF16 إلى 8 بت، لتقليل الاستهلاك إلى النصف، مع ضرورة تقييم خسارة الدقة الناتجة عن ذلك.
يمكنك إعادة استخدام الصيغة السابقة مباشرةً عبر هذا البرنامج النصي لتقدير حجم KV Cache لنموذجك بسرعة، باختلاف طول السياق وعدد الطلبات المتزامنة:
def kv_cache_gib(layers, kv_heads, head_dim, bytes_per_elem, tokens, concurrency=1):
    """تقدير KV Cache بالصيغة M_KV = 2 × L × H_KV × D × B × T × N، بوحدة GiB"""
    total = 2 * layers * kv_heads * head_dim * bytes_per_elem * tokens * concurrency
    return total / (1024 ** 3)

# Llama 3.1 70B: 80 طبقة، و8 رؤوس KV، وبُعد 128، وBF16
for ctx in (8_192, 32_768, 131_072):
    print(f"{ctx:>7} tokens -> {kv_cache_gib(80, 8, 128, 2, ctx):.1f} GiB")

print("8 并发 x 128K ->", kv_cache_gib(80, 8, 128, 2, 131_072, 8), "GiB")
print("FP8 KV 量化 128K ->", kv_cache_gib(80, 8, 128, 1, 131_072), "GiB")
ما المقصود بجدار الذاكرة في استدلال الوكلاء ذوي السياق الطويل؟
السعة وعرض النطاق وذاكرة SRAM ثلاثة أبعاد مستقلة
من أكثر الأخطاء شيوعًا عند الحديث عن جدار الذاكرة الخلط بين «كبر الذاكرة» و«سرعتها». في الواقع، يتضمن نظام الذاكرة في مسرّعات الذكاء الاصطناعي ثلاثة مقاييس مستقلة على الأقل:
| المقياس | ما الذي يحدده؟ | أهميته للوكلاء |
|---|---|---|
| سعة HBM | كمية البيانات التي يمكن تخزينها | مقدار أوزان النماذج وذاكرة KV Cache التي يمكن الاحتفاظ بها في الوقت نفسه، أي عدد السياقات المتزامنة التي يمكن دعمها |
| عرض نطاق HBM | كمية البيانات التي يمكن نقلها في وحدة زمنية | مدى سرعة نقل الأوزان وذاكرة KV Cache إلى أنوية المعالجة عند توليد كل رمز |
| ذاكرة SRAM على الشريحة | وحدة التخزين السريعة الأقرب إلى أنوية المعالجة | إمكانية إبقاء البيانات كثيرة الاستخدام على الشريحة لتقليل زمن الانتظار الناتج عن الوصول المتكرر إلى HBM |
تعتمد HBM أساسًا على تكديس طبقات متعددة والتغليف المتقدم لتحقيق وصول متوازٍ بدرجة عالية إلى ذاكرة DRAM. أما SRAM فهي أسرع وأقرب إلى وحدات المعالجة، لكن تكلفة كل وحدة من سعتها مرتفعة ومساحتها المادية محدودة. ولهذا تعتمد المسرّعات الحديثة عمومًا على مستويات متعددة من الذاكرة، بدلًا من التركيز على زيادة سعة نوع واحد منها فقط.
تختلف احتياجات البيانات في مرحلتي Prefill وDecode اختلافًا كبيرًا
ينقسم استدلال نماذج اللغة الكبيرة (LLM) إلى مرحلتين. في مرحلة Prefill، يُعالَج سياق الإدخال كاملًا دفعة واحدة، وتُنشأ ذاكرة التخزين المؤقت KV. ويمكن حساب عدد كبير من الرموز بالتوازي، لذا تُعد هذه المرحلة مهمة كثيفة الحسابات بالدرجة الأولى. أما في مرحلة Decode، فتُولَّد رموز الإخراج واحدًا تلو الآخر. وفي كل خطوة، يُعالَج رمز جديد واحد فقط، مع ضرورة قراءة جميع الأوزان وذاكرة التخزين المؤقت KV كاملة؛ لذلك يكون حجم الحسابات صغيرًا، بينما يكون حجم نقل البيانات كبيرًا، ما يجعلها مهمة كثيفة الاعتماد على النطاق الترددي.
يمكن تقدير حجم الضغط الذي تواجهه مرحلة Decode من خلال حساب تقريبي مثالي. فذاكرة التخزين المؤقت KV لطلب واحد بسياق 128K تبلغ نحو 40 GiB (قرابة 43 GB)، ويجب قراءتها كاملة مع كل رمز يُولَّد. وباستخدام نطاق ترددي لذاكرة HBM يبلغ نحو 8.6 TB/s لشريحة TPU 8i واحدة، يستغرق مجرد قراءة ذاكرة التخزين المؤقت KV نحو 5 مللي ثوانٍ. أما مع TPU 8i Max، الذي يوفر نطاقًا تردديًا يبلغ 17.2 TB/s، فيبلغ الحد الأدنى نحو 2.5 مللي ثانية. وهذه مجرد حدود نظرية دنيا، إذ تتجاهل قراءة الأوزان، وتداخل العمليات الحسابية، والتقسيم المتوازي. لكنها تكفي لتوضيح أن زيادة طول السياق تجعل نقل البيانات، لا الحسابات، العامل الأبرز في زمن مرحلة Decode.
لماذا «تنتظر» وحدات الحوسبة وصول البيانات؟
عندما تتجاوز كمية العمليات التي تستطيع نواة الحوسبة إنجازها في الثانية بكثير كمية البيانات التي تستطيع الذاكرة توفيرها في الثانية، تتوقف وحدة الحوسبة عن العمل وتنتظر. وهذه هي «جدار الذاكرة». بالنسبة إلى الوكلاء، يزيد السياق الطويل كمية البيانات التي يجب قراءتها في كل خطوة من خطوات فك الترميز، كما يؤدي التزامن العالي إلى زيادة حجم ذاكرة KV Cache التي يجب إبقاؤها في الذاكرة، في حين تتطلب جولات الاستدلال المتعددة إعادة قراءة الذاكرة المؤقتة وتحديثها مرارًا. ومع اجتماع هذه العوامل، تتراجع تدريجيًا الفائدة الإضافية من رفع القدرة الحاسوبية القصوى وحدها.
🎯 نصيحة تقنية: قبل تقييم تطبيق الوكيل لديك، يُنصح بقياس زمن الوصول إلى الرمز الأول (TTFT) وسرعة الإخراج عمليًا باستخدام أطوال سياق مختلفة، لملاحظة كيفية تغير زمن الوصول مع زيادة طول السياق. ومن خلال APIYI apiyi.com، يمكنك التبديل بين نماذج مثل Claude وGemini وGPT باستخدام مفتاح API واحد، ما يسهّل مقارنة أداء النماذج المختلفة مع السياقات الطويلة.
كيف توسّع حزمة TPU 8i Max ثنائية الشريحة نطاق تردّد الذاكرة
كيف يعمل TPU 8i Max بشريحتين؟
يُعدّ TPU 8i Max رابع تكوين للأنظمة ضمن الجيل الثامن من TPU. لاحظت Google أن عنق الزجاجة عند معالجة عدة وكلاء في الوقت نفسه لقواعد شيفرة كبيرة أو مقاطع فيديو طويلة أو مستندات معقدة لا يكون غالبًا في القدرة الحاسوبية، بل في سرعة قراءة البيانات وتبادلها بين الشرائح. وكان الحل دمج شريحتي TPU 8i منخفضتي زمن الاستجابة في حزمة واحدة، مع وضع ضعف كمية السيليكون ضمن المساحة نفسها في الرف.
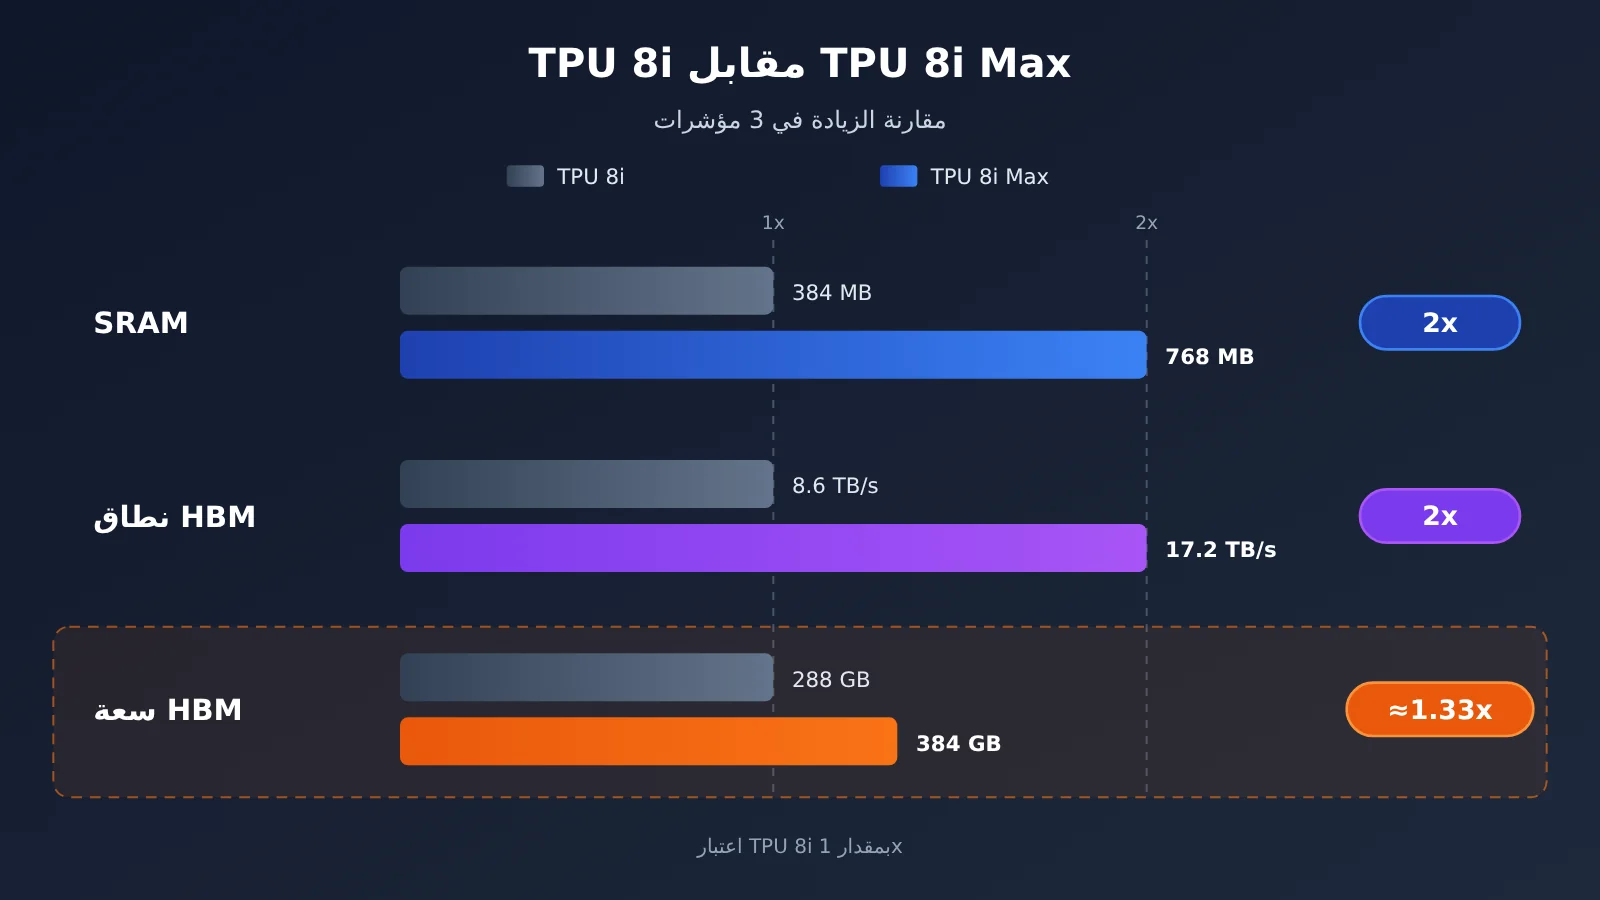
| المؤشر | TPU 8i | TPU 8i Max | مقدار التغيير |
|---|---|---|---|
| تغليف الشرائح | شريحة واحدة | شريحتان | — |
| القدرة الحاسوبية | القيمة الأساسية | ضعف القيمة الأساسية | تضاعفت |
| ذاكرة SRAM على الشريحة | 384 MB | 768 MB | تضاعفت |
| عرض نطاق HBM | 8,601 GB/s | 17,200 GB/s | تضاعف تقريبًا |
| سعة HBM | 288 GB | 384 GB | زيادة بنحو 33% |
ملاحظة: تستند بيانات TPU 8i إلى مقال تقني عن البنية نشرته Google في أبريل 2026. أما القيم المطلقة لـTPU 8i Max، فمصدرها تقرير إعلامي صدر في 9 نوفمبر. وأكد متن المقال الرسمي صراحةً تضاعف القدرة الحاسوبية وذاكرة SRAM وعرض نطاق HBM.
لماذا يكون التوسّع المتوازن أكثر فائدة من زيادة القدرة الحاسوبية وحدها؟
إذا زادت القدرة الحاسوبية وحدها، فسيصبح عنق الزجاجة في مرحلة فك الترميز أكثر ارتباطًا بعرض النطاق الترددي. وإذا زاد عرض النطاق وحده، فقد لا تستفيد وحدات الحوسبة من كامل قدرتها. يوسّع TPU 8i Max القدرة الحاسوبية وذاكرة SRAM وعرض نطاق HBM بنسب متقاربة، ليحافظ تقريبًا على التوازن الأصلي بين سرعة توفير البيانات وسرعة الحوسبة. كما أن مضاعفة سعة SRAM تُبقي مزيدًا من البيانات كثيرة الاستخدام على الشريحة، فتقلل الحاجة إلى نقلها ذهابًا وإيابًا من ذاكرة HBM.
سعة HBM زادت بنحو 33% فقط، لا إلى الضعف
هذه من أسهل التفاصيل التي قد تُذكر خطأً. فعرض نطاق HBM تضاعف، من نحو 8.6 TB/s إلى 17.2 TB/s، لكن السعة ارتفعت من 288 GB إلى 384 GB، أي بنحو 33% فقط. وفي ضوء الحسابات السابقة، يتضح معنى ذلك: يوفر TPU 8i Max عرض نطاق أكبر لكل GB من الذاكرة، لذا يقرأ ذاكرة KV Cache بالحجم نفسه بسرعة أعلى؛ لكن الزيادة في حجم السياق الذي يمكنه استيعابه في الوقت نفسه أقل بكثير من زيادة عرض النطاق.
بعبارة أخرى، لا تكمن القيمة الأساسية لـ TPU 8i Max في مضاعفة الحد الأقصى لسياق نموذج واحد، بل في تمكين النظام من استيعاب عدد كبير من السياقات المتزامنة ومعالجتها بكفاءة أكبر. وعندما لا تكفي السعة، تظل هناك حاجة إلى أساليب برمجية مثل تفريغ KV Cache، والتكميم، وتقسيم العمل على عدة شرائح.
مقارنة بنية الذاكرة بين GPU وTPU 8i Max
لفهم موقع TPU 8i Max، يمكن استخدام أحدث بنية Rubin من NVIDIA مرجعًا لمقارنة وحدات GPU.
| البُعد | وحدة NVIDIA Rubin GPU | Google TPU 8i Max |
|---|---|---|
| وحدة القياس | وحدة GPU واحدة | حزمة تضم شريحتي TPU |
| سعة HBM | 288 GB HBM4 | 384 GB HBM (بحسب ما نشرته وسائل الإعلام) |
| نطاق HBM الترددي | 22 TB/s | 17.2 TB/s (بحسب ما نشرته وسائل الإعلام) |
| الذاكرة المدمجة على الشريحة | تختلف حسب إعداد البنية | 768 MB SRAM (بحسب ما نشرته وسائل الإعلام) |
| الربط بين الشرائح | NVLink 6 | شبكة Boardfly منخفضة التأخير (ضمن منظومة TPU 8i) |
| منظومة البرمجيات | CUDA ومحركات الاستدلال الشائعة | JAX وTorchTPU والواجهات الخلفية لـ vLLM / SGLang على TPU |
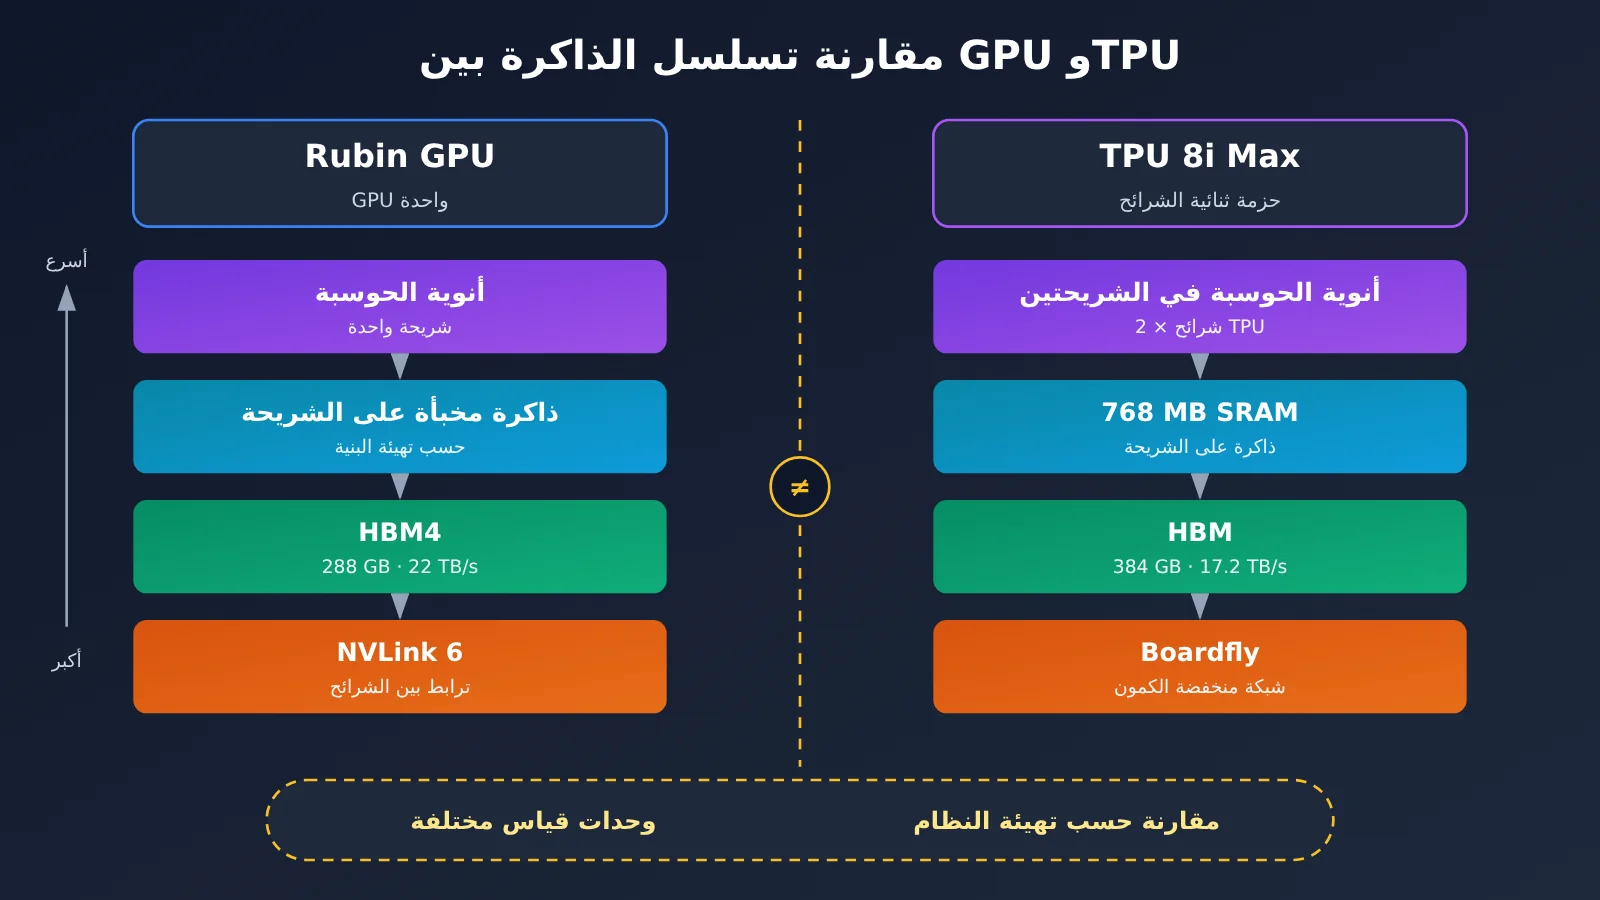
لا يصح استخدام هذا الجدول لترتيب الأجهزة ببساطة. فالمقارنة بين 384 GB و288 GB هي بين حزمة تضم شريحتين ووحدة GPU واحدة، كما تختلف الأجهزة في جيل HBM وطريقة الربط وبنية الحوسبة وإعداد النظام الكامل. ومن حيث النطاق الترددي وحده، تتفوق وحدة Rubin الواحدة؛ ومن حيث السعة وحدها، تتفوق TPU 8i Max. لكن لا يمكن مناقشة أيٍّ من هذين الجانبين بمعزل عن حجم النظام.
الأهم هو مقارنة عدد سياقات الاستخدام المتزامنة والفعّالة التي يستطيع النظام بأكمله دعمها باستقرار، إلى جانب معدل النقل وزمن الاستجابة وكفاءة الطاقة عند الحفاظ على هذه السياقات، وذلك في ظل استهلاك الطاقة نفسه ومساحة الرف والتكلفة نفسها. وحتى 10 نوفمبر 2026، لا تتوفر نتائج اختبارات مستقلة لـTPU 8i Max يمكن التحقق منها علنًا؛ لذا علينا انتظار بيانات ما بعد طرحه التجاري لإجراء مثل هذه المقارنة على مستوى النظام.
💡 نصيحة للاختيار: بالنسبة إلى معظم الفرق التي تبني وكلاء عبر API، لا تحتاجون إلى اختيار ما إذا كانت البنية التحتية تعمل على GPU أم TPU بأنفسكم. والأجدى عمليًا هو مقارنة زمن الاستجابة وسعر النماذج المختلفة عند استخدام سياق طويل. يمكنكم اختبار عدة نماذج بالتوازي عبر الواجهة الموحدة في APIYI apiyi.com، ومقارنتها باستخدام موجهات من تطبيقاتكم الفعلية.
تحليل تأثير TPU 8i Max على مطوري الوكلاء
التمييز بين نافذة السياق والتوازي الفعلي وزمن الاستدلال
توضح نافذة السياق المُعلنة للنموذج فقط «الحد النظري لكمية المعلومات التي يمكن استيعابها»، لكنها لا تعني أن الخادم يستطيع دعم عدد معين من الجلسات المتزامنة عند هذا الطول، ولا تضمن أن يكون زمن الاستجابة مقبولًا. وقد أوضحت الحسابات السابقة أن ذاكرة التخزين المؤقت لـ KV تختلف بمقدار 8 أضعاف بين جلسة واحدة و8 جلسات، حتى عند استخدام نافذة سياق بطول 128K. لذلك، ينبغي للمطورين النظر إلى المؤشرات الثلاثة كلٌّ على حدة:
- نافذة السياق: أقصى نطاق يمكن للنموذج معالجته، وتحدد كمية المعلومات التي يمكن إدخالها في استدعاء واحد.
- قدرة التوازي الفعلية: عدد الجلسات الطويلة التي يمكن إبقاؤها نشطة في الوقت نفسه على أجهزة محددة، وهي مقيدة بسعة HBM.
- زمن الاستدلال: يتأثر TTFT بحجم الحسابات اللازمة لمرحلة Prefill، بينما تتأثر سرعة توليد الرموز واحدًا تلو الآخر بعرض النطاق الترددي وحجم ذاكرة التخزين المؤقت لـ KV.
ثلاث تقنيات للتخفيف من المشكلة تنتشر حاليًا
الأجهزة ليست سوى نصف الحل لمشكلة جدار الذاكرة؛ أما النصف الآخر فيكمن في البرمجيات. وتتمحور الأدوات التي أتاحتها Google مفتوحة المصدر في الفترة نفسها، مثل TPU Sync وإصدارات TPU من vLLM وSGLang، حول التقنيات التالية:
| التقنية | المشكلة التي تعالجها | التكلفة أو ما ينبغي الانتباه إليه |
|---|---|---|
| تفريغ ذاكرة KV Cache | نقل ذاكرة التخزين المؤقت غير المستخدمة مؤقتًا من HBM إلى ذاكرة DRAM في الجهاز المضيف أو SSD أو التخزين المشترك، لتجاوز حدود السعة | يستغرق استعادتها وقتًا بسبب النقل، ويتطلب استخدام DMA فعّالًا ونقلًا غير متزامن |
| تكميم KV Cache | تقليل عدد البايتات لكل عنصر، ما يخفض مباشرةً استهلاك السعة وعرض النطاق الترددي | يتطلب تقييم أثره في الدقة |
| فصل Prefill عن Decode | توزيع Prefill، كثيف العمليات الحسابية، وDecode، كثيف استهلاك عرض النطاق الترددي، على عُقد مختلفة | يتطلب نقل KV Cache بسرعة بين العُقد |
| التخزين المؤقت للبادئة (Prefix Caching) | إعادة استخدام موجهات النظام والبادئات السابقة المتطابقة لتجنب تكرار Prefill | يعتمد على مدى تكرار بادئات الطلبات |
تُظهر البيانات التي نشرتها Google أن TPU Sync يمكنه خفض زمن نقل KV Cache بأكثر من 90%، وأن التخزين المؤقت للبادئات في سياق بطول 64K يمكنه خفض TTFT بنسبة تصل إلى 90%. لكن هذه الاختبارات أُجريت على الجيل السابع من Ironwood TPU، كما أن الأجهزة التي تسردها صفحة README على GitHub حاليًا بوصفها أجهزة خضعت للتحقق الفعلي هي v7x وv6e؛ لذلك لا يمكن اعتبار هذه النتائج أداءً مباشرًا لـ TPU 8i Max.
الأثر الفعلي في الأداء وتكلفة الموارد
بالنسبة إلى مستخدمي واجهات API، تنعكس هذه التحسينات على مستوى البنية التحتية في نقطتين أساسيتين: مدى استقرار زمن الاستجابة للطلبات ذات السياق الطويل، ومدى انخفاض التكلفة المحسوبة بحسب عدد الرموز. ويمكنك الاستفادة من فكرة «تقليل استهلاك الذاكرة» في تطبيقك أيضًا: اختصر موجه النظام وحافظ على ثبات بادئته للاستفادة من التخزين المؤقت، ولخّص مخرجات الأدوات قبل إعادتها إلى السياق، ولا تمرّر إلى الوكيل الفرعي إلا الأجزاء التي يحتاج إليها بدلًا من سجل المحادثة كاملًا.
يقيس المثال التالي زمن الوصول إلى أول رمز باستخدام الإخراج المتدفق عند أطوال مختلفة للسياق، ما يتيح ملاحظة أثر زيادة السياق في مرحلة المعالجة المسبقة للإدخال (Prefill):
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة متوافقة مع OpenAI من APIYI
)

def measure_ttft(context: str, model: str = "gpt-4o-mini") -> float:
    start = time.perf_counter()
    stream = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": context + "\n请用一句话总结上文。"}],
        stream=True,
    )
    for chunk in stream:
        if chunk.choices and chunk.choices[0].delta.content:
            return time.perf_counter() - start
    return -1.0

print(f"TTFT: {measure_ttft('示例代码片段 ' * 2000):.2f}s")
عرض شيفرة الاختبار الدفعي لعدة نماذج وأطوال
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # مفتاح واحد للتبديل بين نماذج جهات متعددة
)

MODELS = ["gpt-4o-mini", "claude-sonnet-4", "gemini-2.5-flash"]
LENGTHS = [1_000, 5_000, 20_000]  # عدد مرات تكرار المقطع، لزيادة السياق بصورة تقريبية

def run_once(model: str, repeat: int) -> dict:
    context = "def handler(event):\n    return process(event)\n" * repeat
    start = time.perf_counter()
    first, tokens = None, 0
    try:
        stream = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": context + "\n指出上面代码的潜在问题。"}],
            stream=True,
            max_tokens=200,
        )
        for chunk in stream:
            if chunk.choices and chunk.choices[0].delta.content:
                tokens += 1
                if first is None:
                    first = time.perf_counter() - start
        total = time.perf_counter() - start
        return {"model": model, "repeat": repeat, "ttft": first, "total": total, "chunks": tokens}
    except Exception as e:
        return {"model": model, "repeat": repeat, "error": str(e)}

for m in MODELS:
    for n in LENGTHS:
        print(run_once(m, n))
🚀 ابدأ بسرعة: سجّل عبر APIYI على apiyi.com لتحصل على رصيد مجاني للاختبار. اترك قيمة
base_urlفي الشيفرة أعلاه كما هي:https://api.apiyi.com/v1، وستتمكن خلال دقائق من الحصول على منحنيات TTFT لعدة نماذج وعند أطوال مختلفة للسياق.
التأثير في القطاع
- تسريع التخصيص على مستوى الأنظمة: يوضح طرح Google سريعًا تهيئات موجهة لأعباء عمل متخصصة، باستخدام نهج «الشريحة نفسها، والأنظمة المختلفة»، أن المنافسة في مجال المسرّعات تنتقل من مواصفات الشريحة الواحدة إلى تصميم الأنظمة.
- التكامل بين البرمجيات والأجهزة يصبح معيارًا أساسيًا: أُعلن عن TPU 8i Max إلى جانب TPU Sync وAgent Compute Engine ومحرك استدلال بإصدار مخصص لـTPU. وهذا يبيّن أن معالجة جدار الذاكرة تتطلب الجمع بين عرض نطاق الأجهزة وجدولة البرمجيات.
- التسويق التجاري لا يزال في مراحله الأولى: مثل TPU 8t و8i و8tx، يحمل TPU 8i Max حالة «قريبًا»، من دون إعلان سعر أو موعد رسمي للتوافر، لذا لا تزال جدواه الفعلية من حيث التكلفة والأداء بحاجة إلى التحقق.
الأسئلة الشائعة
س1: ما هو TPU 8i Max؟
TPU 8i Max هو تكوين من الجيل الثامن لأنظمة TPU، أطلقته Google في 9 نوفمبر 2026. يدمج شريحتي TPU 8i في حزمة واحدة، ويوفر ضعف قدرة الحوسبة وذاكرة SRAM المدمجة ونطاق تردّد HBM مقارنةً بـ TPU 8i. ويستهدف بشكل أساسي الاستدلال مع سياقات طويلة، وتزامن مرتفع، وتعاون عدة وكلاء. وهو ليس شريحة جديدة مصممة من الصفر.
س2: هل تضاعفت سعة HBM في TPU 8i Max؟
لا. وفقًا لما ورد في الإحاطة الإعلامية، ارتفعت سعة HBM من 288 GB إلى 384 GB، أي بنحو 33%؛ أما ما تضاعف فهو نطاق تردّد HBM (من نحو 8.6 TB/s إلى 17.2 TB/s) وذاكرة SRAM (من 384 MB إلى 768 MB). السعة ونطاق التردّد مؤشّران مستقلان، ولا ينبغي الخلط بينهما.
س3: هل يمكن استخدام TPU 8i Max الآن؟ وما سعره؟
حتى 10 نوفمبر 2026، كانت صفحة المنتج الرسمية على Google Cloud تصف TPU 8i Max بأنه «قريبًا»، من دون الإعلان عن سعر متاح للجمهور أو موعد رسمي للتوافر العام. كما لا توجد اختبارات أداء مستقلة يمكن التحقق منها علنًا. والبيانات المتاحة حاليًا تقتصر على تصريحات Google الرسمية ومواصفات الإحاطة الإعلامية.
س4: هل يتيح TPU 8i Max لنموذج واحد التعامل مع سياق يبلغ مليون Token؟
تدرج Google السياقات التي تصل إلى مليون Token ضمن الاستخدامات المستهدفة، لكن ذلك لا يعني أن هناك حدًا أقصى ثابتًا ومعلنًا لطول السياق. يعتمد طول السياق الذي يمكن للنموذج معالجته أولًا على النموذج نفسه؛ أما الأجهزة فتحدد عدد الطلبات المتزامنة التي يمكن خدمتها عند هذا الطول، وما إذا كان زمن الاستجابة مقبولًا.
س5: كيف يمكن لمطوري التطبيقات التحقق من تأثير السياق الطويل في زمن الاستجابة؟
الطريقة الأبسط هي قياس TTFT وسرعة الإخراج باستخدام سياقات واقعية من أطوال مختلفة:
1. سجّل حسابًا على APIYI عبر apiyi.com للحصول على مفتاح API ورصيد مجاني للاختبار.
2. استخدم سكربت الاختبار الوارد في هذه المقالة، واضبط `base_url` على `https://api.apiyi.com/v1`.
3. بدّل بين عدة نماذج باستخدام مجموعة السياقات نفسها، وقارن معدل زيادة زمن الاستجابة مع ازدياد طول السياق.
س6: ما قيود تكميم KV Cache وتفريغه؟
يقلل التكميم مباشرةً استهلاك الذاكرة ونطاق التردّد، لكنه قد يؤدي إلى انخفاض الدقة، لذا ينبغي تقييمه على المهام المستهدفة. أما التفريغ فيتجاوز قيود سعة HBM، لكن استعادة البيانات تستغرق وقتًا لنقلها. وإذا لم يكن النقل بين مستويات التخزين سريعًا بما يكفي، فقد يؤدي ذلك إلى زيادة زمن الاستجابة. ويتطلب كلا الخيارين ضبط الإعدادات بما يتناسب مع حجم التزامن وأهداف زمن الاستجابة.
النقاط الأساسية حول السياق الطويل للوكلاء وTPU 8i Max
- انتقال موضع الاختناق: ينتقل الاستدلال لدى الوكلاء من التركيز على زيادة القدرة الحاسوبية إلى تحقيق التوازن بين الحوسبة وتوفير بيانات الذاكرة.
- نمو خطي لذاكرة KV Cache: يحتاج Llama 3.1 70B إلى نحو 320 KiB لكل رمز؛ ويستهلك طلب واحد بسياق طوله 128K نحو 40 GiB.
- أهمية GQA: مع 8 رؤوس KV، لا يتجاوز استهلاك الذاكرة المؤقتة ثُمن استهلاك الانتباه متعدد الرؤوس القياسي.
- فك الترميز يستهلك النطاق الترددي: يجب قراءة ذاكرة KV Cache كاملةً مع كل رمز جديد؛ لذلك يصبح النطاق الترددي العامل الحاسم في زمن الاستجابة عند استخدام سياق طويل.
- توسّع متزامن: تتضاعف القدرة الحاسوبية وذاكرة SRAM وعرض نطاق HBM في TPU 8i Max، بينما لا تزيد سعة HBM إلا بنحو 33%.
- البرمجيات مهمة أيضًا: يُعدّ الإخراج إلى الذاكرة، والتكميم، وفصل مرحلتي الملء المسبق وفك الترميز (Prefill/Decode)، والتخزين المؤقت للبادئات من أهم وسائل تخفيف ضغط الذاكرة.
- البدء بالاختبار: يمكن استخدام الواجهة الموحّدة من APIYI على apiyi.com لاختبار زمن الاستجابة للسياق الطويل عبر نماذج متعددة.
الخلاصة
أهم النقاط المتعلقة بجدار الذاكرة في استدلال الوكلاء ذوي السياق الطويل:
- مصدر الضغط: تتراكم قواعد الشيفرة ونتائج الأدوات ومخرجات الوكلاء الفرعيين باستمرار، ومع تشغيل عدة وكلاء بالتوازي، يتضخم حجم ذاكرة KV Cache.
- نهج الأجهزة: لا يقتصر TPU 8i Max على زيادة القدرة الحاسوبية، بل يوسّع الحوسبة وذاكرة SRAM وعرض نطاق HBM بالتزامن، للحفاظ على التوازن بين توفير البيانات والحوسبة.
- حدود الاستخدام: الزيادة في سعة HBM محدودة، والمنتج لم يُطرح تجاريًا بعد؛ لذا ينبغي التحقق من قيمته الفعلية عبر اختبارات على مستوى النظام.
بالنسبة إلى معظم المطورين، فإن النهج العملي الآن هو فهم بنية تكلفة ذاكرة KV Cache، والحد من تضخم السياق على مستوى التطبيق، ومتابعة تغيّرات زمن الاستجابة للسياقات الطويلة وأسعار خدمات النماذج. نوصي باستخدام APIYI على apiyi.com لمقارنة أداء عدة نماذج في التعامل مع السياقات الطويلة، استنادًا إلى بيانات أعمال حقيقية. وتوفر المنصة واجهة متوافقة مع OpenAI ورصيدًا مجانيًا للمستخدمين الجدد.
📚 المراجع
- مدونة Google Cloud – تقديم TPU 8tx وTPU 8i Max: الإعلان التقني الرسمي عن هذا الإصدار
- الرابط:
cloud.google.com/blog/topics/ai-infrastructure/tpu-8tx-and-tpu-8i-max -
ملاحظة: يؤكد التغليف ثنائي الشريحة ومضاعفة أداء الحوسبة وعرض نطاق SRAM وHBM
-
Google Cloud – نظرة معمّقة على الجيل الثامن من TPU: تحليل تفصيلي لبنية الجيل الثامن من TPU
- الرابط:
cloud.google.com/blog/products/compute/tpu-8t-and-tpu-8i-technical-deep-dive -
ملاحظة: المواصفات الأصلية لـTPU 8i وبنية شبكة Boardfly
-
Google Cloud – تقديم TPU Sync: مكتبة لنقل ذاكرة KV المؤقتة والأوزان
- الرابط:
cloud.google.com/blog/topics/ai-infrastructure/introducing-tpu-sync-fast-kv-cache-and-weight-transfer-on-tpu -
ملاحظة: بنية الذاكرة متعددة المستويات وبيانات اختبارات تفريغ ذاكرة KV المؤقتة (استنادًا إلى Ironwood)
-
Network World – Google تستهدف اختناقات البنية التحتية التالية للذكاء الاصطناعي: تغطية إعلامية موجزة
- الرابط:
networkworld.com/article/4245897 -
ملاحظة: الأرقام المطلقة لسعة HBM وعرض نطاقها وذاكرة SRAM في TPU 8i Max
-
مستودع Google TPU Sync على GitHub: مستودع مفتوح المصدر
- الرابط:
github.com/google/tpu-sync - ملاحظة: معلومات عن توافق الأجهزة وحالة التطوير
المؤلف: فريق APIYI التقني
للتواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI. ويمكنكم الاطلاع على مزيد من مواد الربط في مركز التوثيق على docs.apiyi.com