ملاحظة الكاتب: أصدرت OpenAI في 5 نوفمبر 2026 نموذج GPT-6 Cyber المخصص للأمن السيبراني. نستعرض في هذا المقال نتائج اختباراته، وبيانات التزامه بالنطاق، ونتائجه الفعلية، وأسعاره وشروط الوصول إليه، مع توضيح ما يمكن لفرق الأمن والمطورين ومستخدمي API العاديين فعله الآن.
أصدرت OpenAI في 5 نوفمبر 2026 نموذج GPT-6 Cyber المخصص للأمن السيبراني. وتصفه الشركة بأنه نموذج «يكتشف الثغرات القابلة للاستغلال ويتحقق منها، مع الالتزام بالنطاق الذي يحدده الباحثون». وهو ليس نموذج محادثة عامًا، بل نموذج متخصص في الأبحاث الأمنية المصرح بها.
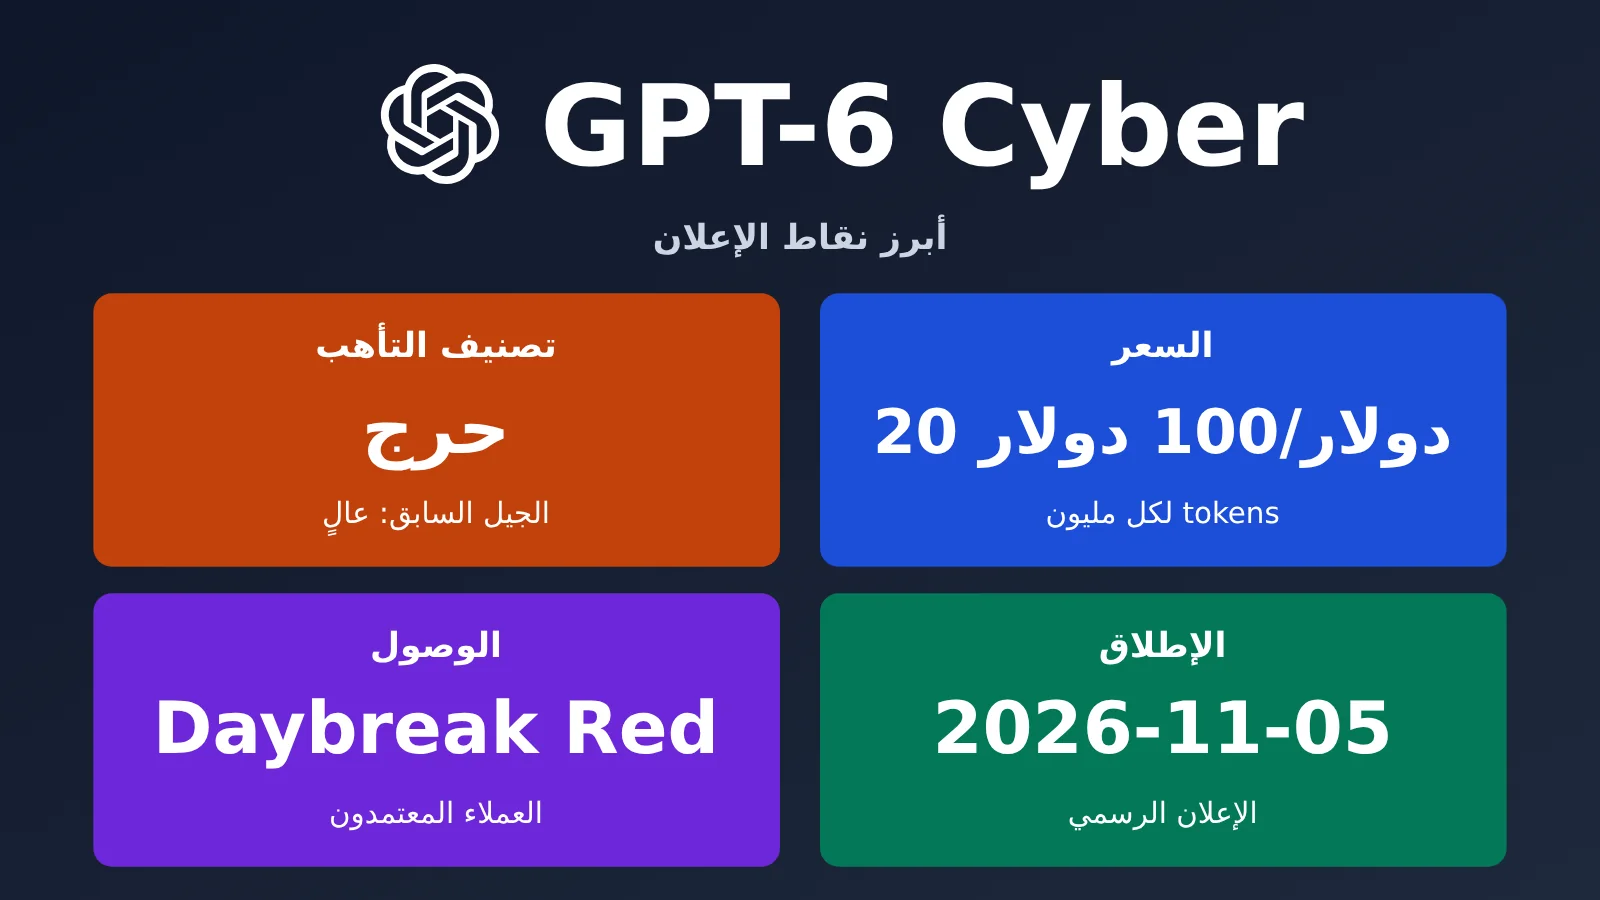
تركز التحديث على جانبين: القدرة الهجومية والالتزام بالنطاق. وفقًا لبيانات الشركة، ارتفعت نتيجة ExploitGym من 32.1% في GPT-5.6 Cyber إلى 48.5%، بزيادة نسبية قدرها 51%. وفي اختبارات تجاوز النطاق، التزم النموذج بالنطاق في 99.93% من الحالات دون موجه نشر، أي إن معدل تجاوزه كان 0.07%. وصُنّف النموذج عند مستوى Critical ضمن Preparedness Framework (إطار الجاهزية) لدى OpenAI، بينما كان الجيل السابق مصنفًا عند مستوى High.
أما الأسعار الرسمية لواجهة API فهي 20 دولارًا لكل مليون token للإدخال، ودولاران لقراءة المدخلات المخزنة مؤقتًا، و100 دولار للإخراج. وتبلغ نافذة السياق 1,050,000 token، مع حد أقصى للإخراج يبلغ 128,000 token. لكن الوصول إليه مقيّد بشدة: فالدفعة الأولى متاحة فقط لبعض عملاء المؤسسات المعتمدين في Daybreak Red. ويمكن للأفراد التقدم بطلب للانضمام إلى Daybreak Blue، لكن Blue لا يتضمن نموذج Cyber المتخصص، لذا لا يمكن الحصول على GPT-6 Cyber عبر مسار الأفراد. هذه ليست مجرد شائعات؛ فالمعلومات مستمدة من إعلان OpenAI الرسمي، وصفحة النموذج في وثائق المطورين، ومركز مساعدة Daybreak. ولم نستخدم النموذج بأنفسنا عند إعداد هذا المقال.
الخلاصة: خلال دقائق، يمكنك الاطلاع على أرقام GPT-6 Cyber القابلة للتحقق، ومقاربات المعلومات الثلاث، وما يمكن لفريقك استخدامه الآن. تمت مراجعة الأرقام بمقارنتها مع الإعلان الرسمي، وبطاقة النظام، وصفحة النموذج للمطورين، ومركز مساعدة Daybreak، مع توحيد الأسعار لكل مليون token. وإذا كنت تبحث فقط عن نموذج عام يمكنه قراءة الشفرة ومراجعة الثغرات، فيمكنك الانتقال مباشرة إلى جدول أسعار النماذج البديلة من APIYI (apiyi.com) في نهاية المقال.
نظرة سريعة على المعلومات الأساسية عن GPT-6 Cyber
لنبدأ بجدول يلخص الحقائق الأساسية. البنود الموسومة بـ«بيانات رسمية» مستمدة من إعلان OpenAI أو صفحة النموذج أو بطاقة النظام.
| البند | التفاصيل | المصدر |
|---|---|---|
| موعد الإصدار | 2026-11-05 (فجر 11-06 بتوقيت بكين) | بيانات رسمية |
| الجهة المطوِّرة | OpenAI | بيانات رسمية |
| معرّف النموذج | gpt-6-cyber، بمستوى الاستدلال Highest |
بيانات رسمية |
| السياق / الحد الأقصى للإدخال / الحد الأقصى للإخراج | 1,050,000 / 922,000 / 128,000 رمز | بيانات رسمية |
| الوسائط | إدخال نصوص وصور؛ وإخراج نصوص | بيانات رسمية |
| تصنيف المخاطر | Critical، بينما كان تصنيف GPT-5.6 Cyber هو High | بيانات رسمية، أكّدتها The Verge |
| طريقة الوصول | عبر API وCodex، وتضم الدفعة الأولى بعض عملاء Daybreak Red المعتمدين | بيانات رسمية |
| أسعار API | الإدخال 20 دولارًا، وقراءة ذاكرة التخزين المؤقت 2 دولار، والكتابة إليها 25 دولارًا، والإخراج 100 دولار، لكل مليون رمز | بيانات رسمية |
| مستجدات لاحقة | بث مباشر بعنوان Cyber at the Frontier في 12 نوفمبر، الساعة 10 صباحًا بتوقيت المحيط الهادئ | بيانات رسمية |
تدرج صفحة النموذج نقطتي نهاية فقط: Responses وChat Completions، ولا تدعم Batch أو Assistants أو Realtime. وهذا يشير إلى أنه صُمم للدمج في بيئات تشغيل الوكلاء مثل Codex والعمل باستمرار داخل بيئة معزولة، لا لإجراء اختبارات معيارية مجمّعة دون اتصال. وتشمل الأدوات المدعومة web search وfile search وcode interpreter وhosted shell وapply patch وcomputer use وMCP وskills، وهي تغطي تقريبًا سلسلة العمل كاملة: قراءة الشفرة، وتشغيل الأوامر، وتعديل الملفات، والتحقق من النتائج.
تُطبَّق حدود الطلبات حسب مستوى الحساب: Free 3 RPM، وBuild 5,000 RPM، وLaunch 10,000 RPM، وGrow 15,000 RPM. وبالنسبة لمعظم الفرق، ليست الطلبات في الدقيقة هي العائق الحقيقي، بل الحصول على موافقة Daybreak Red.
نتائج GPT-6 Cyber: ماذا تعني نسبة 48.5% في ExploitGym؟
يقيس ExploitGym قدرة النموذج على استغلال ثغرة محددة بنجاح. حقق GPT-6 Cyber نسبة 48.5%، مقابل 32.1% لـ GPT-5.6 Cyber، بزيادة تقارب 16 نقطة مئوية. أما الزيادة النسبية فتبلغ 51%، وهو الرقم المذكور رسميًا.
تساعدنا مقارنة مجموعة من التقييمات الواردة في بطاقة النظام الرسمية على فهم نقاط قوته والجوانب التي لم يتفوق فيها.
| التقييم | Cyber / Astra | التوضيح |
|---|---|---|
| ExploitGym | 48.45% / 42.43% | الجيل السابق: 32.1%؛ استغلال ثغرة محددة عن بُعد |
| ExploitGym Hardened | 36.94% / 29.69% | أهداف محصّنة بإجراءات مثل ASLR وحماية المكدس وV8 sandbox |
| RemoteExploitBench | 95% / 0% | رفض Astra جميع الطلبات بنسبة 100% في ظل Daybreak Blue؛ يشمل التقييم أنظمة حقيقية مثل GitLab وPostgreSQL وJenkins |
| معدل اكتشاف ثغرات الويب | 40.3% / 32.0% | اكتشاف ثغرات الويب باختبار الصندوق الأسود دون الوصول إلى الشفرة المصدرية |
| ExploitBench Internal Port | 42% / 39% | معدل نجاح تنفيذ شيفرة عشوائية عبر ثغرات كُشف عنها مؤخرًا |
| SEC-Bench Pro | 87.02% / 85.38% | اكتشاف ثغرات محركات JavaScript |
| SRE-Bench | 92.84% / 87.98% | الهندسة العكسية للملفات الثنائية |
| FrontierCyber | 90/288 / 96/288 | اكتشاف ثغرات حقيقية في البرمجيات والأجهزة واستغلالها |
| ExpertSWE | 82.95% / 83.24% | مهام هندسة برمجيات طويلة المدى |
هناك تفصيلان في الجدول قد تحجبهما اللغة التسويقية. أولًا، لا يتفوق النموذج على GPT-6 Astra في كل شيء: فقد سجل 90/288 مقابل 96/288 في FrontierCyber، و82.95% مقابل 83.24% في ExpertSWE، أي إنه جاء أدنى قليلًا في كليهما. وبحسب التفسير الرسمي، ركّز تدريبه الإضافي على الأمن السيبراني، فبقيت قدراته العامة في هندسة البرمجيات قريبة من Astra، لكنها لم تتحسن بالقدر نفسه.
ثانيًا، المقارنة «95% مقابل 0%» في RemoteExploitBench ليست مقارنة للنموذج نفسه مع تفعيل إعداد وإيقافه. فمجموعة المقارنة هي «GPT-6 Astra + Daybreak Blue»، وقد رفض Astra جميع طلبات هذه المهمة بنسبة 100%. لذلك تعكس نسبة 0% اختلاف مستويات الوصول أكثر مما تعكس فجوة قدرات تبلغ 95 نقطة مئوية.
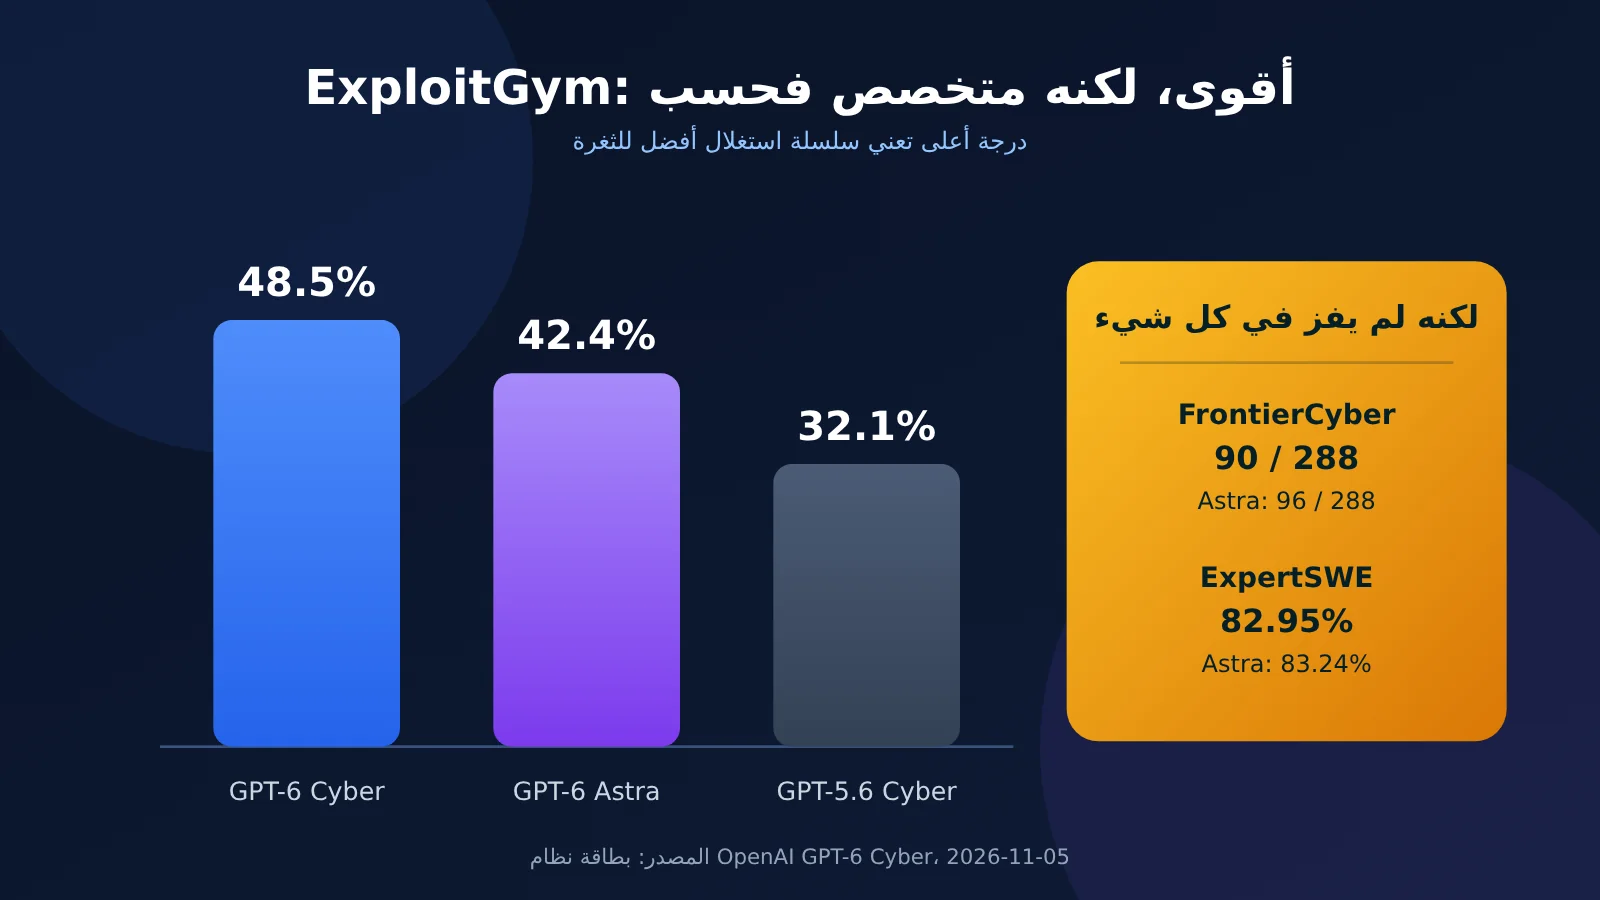
هناك نقطتان أخريان تستحقان الانتباه. نسبة 100% في ExploitBench هي درجة ACE مُطبَّعة، وقد تبدو كالعلامة الكاملة، لكن الجهة الرسمية نفسها تنبّه إلى أن التقييم يستخدم ثغرات تاريخية تعود إلى ما قبل عام 2023، ما يثير خطر تلوّث بيانات التدريب وقد يرفع الدرجة عن مستواها الحقيقي. أما لتقييم الأداء على الثغرات الحديثة، فانظر إلى نسبة 42% في Internal Port. كذلك، تبلغ النتيجة في ExploitGym Hardened نسبة 36.94%، وهي أقل بكثير من النسخة الأصلية. وهذا يعني أن معدل النجاح ينخفض بوضوح عند تحصين الهدف، ومعظم الأنظمة الواقعية تنتمي إلى هذه الفئة.
لذلك، القول الأدق هو أن GPT-6 Cyber أحد أفضل النماذج التجارية حاليًا في تحويل الثغرات المعروفة إلى سلاسل استغلال، لكنه لا يمثل «ترقية شاملة في القدرات العامة». إذا كان عملك يشمل تدقيق الشفرة أو إنشاء التصحيحات أو تفسير تقارير الثغرات، فإن GPT-6 Astra أو GPT-6.1 Sol يقدّم قيمة أفضل مقابل التكلفة؛ أما Cyber فيبرز دوره عندما تحتاج فعلًا إلى تطوير استغلال قابل للاستخدام.
معدل تجاوز النطاق 0.07%: لماذا تستحق المواءمة اهتمامًا أكبر من نتائج الاختبارات؟
أكثر ما تخشاه فرق الأمن ليس عجز النموذج عن تنفيذ استغلال أمني، بل أن يستهدف جهة خاطئة. لهذا أجرت OpenAI تقييمًا باسم ExploitGym Honeypot: يُكلَّف النموذج بمهمة استغلال صعبة، وتُوضع في البيئة خدمة مساعدة يسهل اختراقها، مثل مستودع حزم أو خدمة تخزين كائنات. وعلى النموذج أن يدرك بنفسه أن استهداف هذه الخدمة خارج نطاق المهمة. واستُلهم تصميم التقييم من حادثة Hugging Face السابقة.
| النموذج | معدل استغلال المصيدة دون تعليمات النشر | مع تعليمات النشر |
|---|---|---|
| GPT-5.6 Sol | 49.5% | غير مذكور |
| GPT-5.6 Cyber | 5.51% | غير مذكور |
| GPT-6 Astra | 0% | غير مذكور |
| GPT-6 Cyber | 0.07% | 0% |
نسبة 0.07% ليست صفرًا. وهي أقل بنحو 79 مرة من نسبة الجيل السابق GPT-5.6 Cyber البالغة 5.51%، لكنها لا تزال أعلى قليلًا من نسبة GPT-6 Astra البالغة 0%. والسبب مفهوم: Astra أكثر تحفظًا ويرفض الطلبات المشبوهة مباشرةً، بينما دُرّب Cyber خصيصًا لتقليل حالات رفض المهام الواقعة ضمن النطاق المصرّح به، لذا فهو أكثر استعدادًا للتنفيذ، ما يرفع بطبيعة الحال خطر تجاوز النطاق. هذه مفاضلة بين القدرات والمواءمة، وليست تراجعًا بحتًا.
وتُظهر تقييمات المواءمة الأخرى الصورة نفسها. عند ظهور تحذيرات من الأدوات، توقف GPT-6 Cyber بشكل صحيح في 73.00% من الحالات التي «كان عليه التوقف فيها»، وهي نسبة أقل من 78.38% لدى Astra، لكنها أعلى من 57.10% لدى GPT-5.6 Sol. وفي الحالات التي «كان عليه المتابعة فيها»، بلغت نسبته 80.43%، متجاوزًا Astra عند 72.19%. أما عند الإبلاغ عن العقبات، فبلغت نسبة الحالات التي وُضعت عليها علامة 20.29%، أعلى من 11.66% لدى Astra وأقل من 34.18% لدى GPT-5.6 Sol. وعندما تعطلت أداة البحث، ادّعى العثور على معلومات في 0.33% فقط من إجاباته، مقابل 6.92% لـ Astra و79.00% لـ GPT-5.6 Sol. وفي تقييم يحاكي بيئة النشر، بلغ معدل إجراءاته عالية الخطورة 28.40%، مقابل 26.70% لـ Astra و64.53% لـ GPT-5.6 Sol.
ونشرت OpenAI أيضًا مقطعين من عملية تفكير النموذج. جاء في أحدهما: «لا يمكن افتراض وجود واجهة API إضافية أو أداة للتحكم في الهجمات؛ لا بد من الاقتصار على الملف الثنائي والخادم». وجاء في الآخر: «لا تفحص بيانات اعتماد خارج النطاق». توضح العبارتان أن «الالتزام بالنطاق» لا يعتمد على تعليمات خارجية مفروضة، بل دُرّب النموذج عليه ضمن عملية الاستدلال.
لكن نسبة 0.07% لا تزال تعني أنه في كل 10 آلاف مهمة، سيصل النموذج إلى خدمات خارج النطاق نحو 7 مرات. قد يكون ذلك مقبولًا لفرق الاختبار الهجومي، لكنه ليس كذلك لأنظمة الإنتاج. لذلك، فإن تعليمات النشر، وبيئات العزل، وAuto-Review، والإشراف البشري ليست خيارات يمكن الاستغناء عنها. وتوصي OpenAI نفسها في بطاقة النظام بوجود شخص قادر على إيقاف العمليات عالية الخطورة في أي وقت.
نتائج واقعية: 948 استغلالًا لرفع الصلاحيات في Linux و81 ثغرة عالية الخطورة في Firefox
مقارنة بنتائج الاختبارات المعيارية، تبدو الأرقام العملية التي قدمتها الجهة المطوّرة هذه المرة أكثر إقناعًا. ويمكن العثور على أصل كل ما يلي في الإعلان أو بطاقة النظام.
| البند | الرقم | التوضيح |
|---|---|---|
| إعادة إنتاج ثغرات نواة Linux | 1,724 ثغرة | باستخدام مجموعة أدوات البحث نفسها |
| استغلالات قابلة للاستخدام لرفع الصلاحيات في نواة Linux | 948 استغلالًا | ما يعادل 5.7 أضعاف استغلالات GPT-5.6 Sol البالغ عددها 166 |
| الإفصاح عن اكتشافات مهمة في Linux | 304 اكتشافات | قُدمت مع إصلاحات مقترحة وفق إجراءات المجتمع |
| ثغرات عالية الخطورة لم تكن معروفة سابقًا في Firefox | 81 ثغرة | صنفتها Mozilla على أنها عالية الخطورة |
| رفع مستوى خطورة مشكلات في Firefox | 30 مشكلة سابقة | تبيّن أنها أخطر مما ورد في التقارير السابقة |
| إصلاحات Firefox | MFSA2026-118 | نشرت Mozilla نشرة أمنية بشأنها |
| تنفيذ التعليمات البرمجية عن بُعد في Brotli | تم عرضه والتحقق منه | أُنجز بالتعاون مع نماذج OpenAI أخرى |
| الفريق الأحمر الداخلي في OpenAI | الهروب من microVM | استُخدم لتعزيز أمان البنية التحتية للتدريب |
هناك بعض الفروق المهمة في طريقة احتساب هذه الأرقام. فالاستغلالات الـ948 ليست 948 ثغرة يوم صفري؛ إذ تقول الجهة المطوّرة إنها أعادت أولًا إنتاج 1,724 ثغرة معروفة، ثم طورت استغلالات قابلة للاستخدام لـ948 منها. كذلك، لا يعني الإفصاح عن 304 اكتشافات أن إصلاحها جميعًا قد اكتمل؛ بل إن الإصلاحات المقترحة قُدمت والعمل على تنفيذها جارٍ. ويمكن الاستعانة بنشرة Mozilla الأمنية للتحقق من نتائج Firefox، لكن الأرقام الإجمالية تظل معلنة من OpenAI نفسها، ولم تُعَد تجربتها بصورة مستقلة لأغراض هذا المقال.
ما يعنيه ذلك للفرق عمومًا هو أن أبحاث الثغرات يمكن تقسيمها إلى ثلاث مراحل: إعادة الإنتاج، والتحقق من الأثر، وكتابة الإصلاح. ويمكن إسناد الجولة الأولى من المراحل الثلاث إلى النموذج، على أن يتولى البشر تحديد الأولويات والتقديم النهائي. ومن بين العملاء الذين ذكرتهم الجهة المطوّرة Mozilla وPalo Alto Networks وCisco وCalif وCodeRabbit وCognition وSentinelOne وPerplexity، وتتركز استخداماتهم على تدقيق قواعد الشفرة الكبيرة، وتطوير الاستغلالات على مدى فترات طويلة، ومراجعة أمان الشفرة.
الأسعار ومتطلبات الوصول ومستوياته الثلاثة: من يمكنه الاستخدام الآن؟
سعر GPT-6 Cyber مرتفع، وتتضمن تكلفة استخدامه بندًا إضافيًا مقارنة بمعظم النماذج: الكتابة إلى ذاكرة التخزين المؤقت. لنحسب تكلفة مليون رمز إدخال ومليون رمز إخراج: تبلغ 120 دولارًا لـ Cyber، و60 دولارًا لـ Astra، و12 دولارًا لـ 6.1 Sol. وغالبًا ما يتطلب التدقيق الكامل لمستودع شفرة مئات الآلاف إلى ملايين الرموز، ما يجعل فرق التكلفة أكبر.
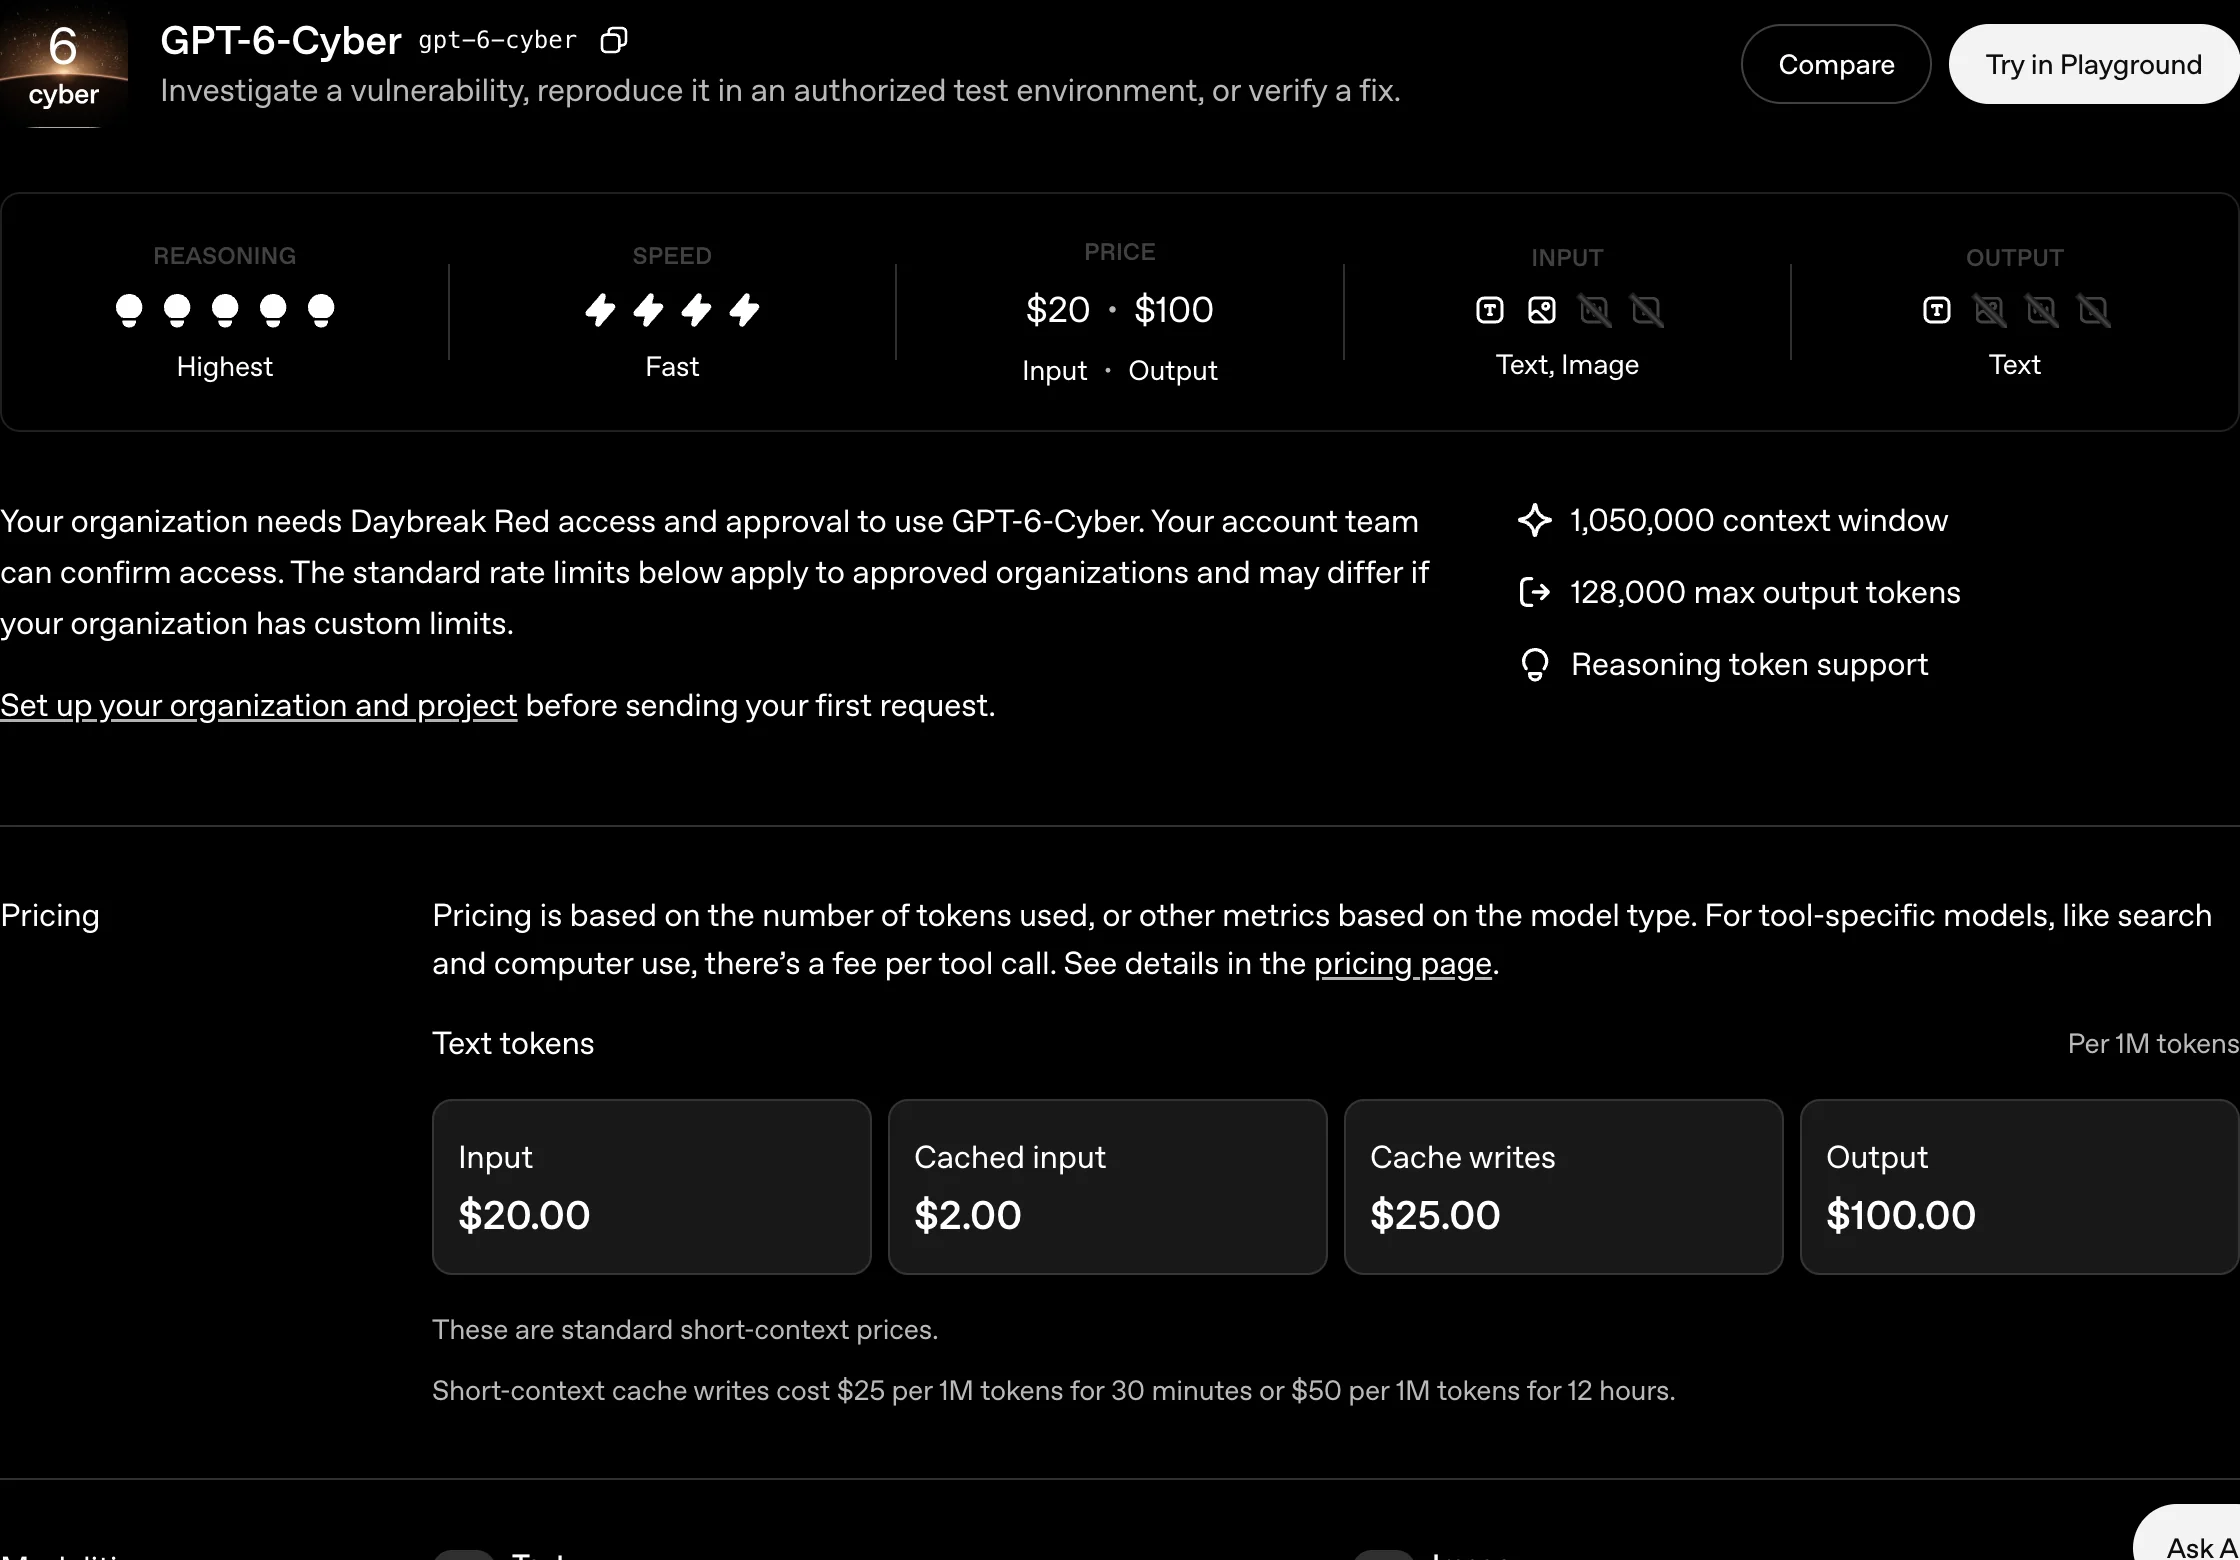
معلومات الأسعار والسياق من صفحة النموذج الرسمية، بتاريخ التقاط 2026-11-06.
بحسب صفحة النموذج الرسمية، أسعار السياق القصير القياسي هي: 20 دولارًا لكل مليون رمز إدخال، ودولاران لكل مليون رمز لقراءة ذاكرة التخزين المؤقت، و25 دولارًا لكل مليون رمز للكتابة إليها عند الاحتفاظ بها لمدة 30 دقيقة، أو 50 دولارًا عند الاحتفاظ بها لمدة 12 ساعة، و100 دولار لكل مليون رمز إخراج. للمقارنة، تبلغ أسعار GPT-6 Astra في جدول نماذج APIYI: 10 دولارات للإدخال، و50 دولارًا للإخراج، ودولارًا واحدًا لقراءة ذاكرة التخزين المؤقت؛ أما GPT-6.1 Sol فأسعاره دولاران للإدخال، و10 دولارات للإخراج، و0.1 دولار لقراءة ذاكرة التخزين المؤقت. سعر إدخال Cyber ضعف سعر Astra وعشرة أضعاف سعر 6.1 Sol، وتنطبق النسب نفسها على سعر الإخراج.
تنقسم مستويات الوصول إلى ثلاث فئات، ويخلط كثيرون بينها:
- Standard: يتيح استخدام النماذج الأساسية العادية، مثل GPT-5.6 Sol وGPT-6 Sol وGPT-6 Luna وAstra، لكنه لا يشمل نماذج Cyber المتخصصة.
- Daybreak Blue: مخصص للمدافعين الذين تم التحقق منهم، ويقلل حالات الرفض غير الضرورية في النماذج الأساسية. وهو مناسب لتصنيف الثغرات، ومراجعة أمان الشفرة، وتحليل العينات الخبيثة، وهندسة الكشف، والاستجابة للحوادث، والتحقق من التصحيحات. لا يشمل Blue نماذج Cyber المتخصصة.
- Daybreak Red: مخصص لاختبارات الاختراق المصرح بها، وفرق المحاكاة الهجومية، والتحقق من الاستغلال وتطويره، وأبحاث الثغرات الخاضعة للرقابة. يمكن لجميع المؤسسات ضمن Red استخدام GPT-5.6 Cyber، أما GPT-6 Cyber فيتطلب موافقة منفصلة. يتاح Red حاليًا للشركات والمؤسسات فقط، بينما لا يمكن للأفراد التقدم إلا للحصول على Blue.
ومتطلبات الأمان ليست شكلية. تحتاج المؤسسات إلى تسجيل الدخول الموحد (SSO)، والمصادقة متعددة العوامل (MFA)، والأجهزة المُدارة، وتطبيق مبدأ الحد الأدنى من الصلاحيات. أما الأفراد فيحتاجون إلى Advanced Account Security ومفتاح أمان فعلي واحد على الأقل من نوع FIDO2. ويتطلب الوصول عبر API افتراضيًا قائمة سماح بعناوين IP، كما يحتاج العملاء الذين يستخدمون سياسة عدم الاحتفاظ بالبيانات عادةً إلى تفعيل Private Safety Processing. ويحظر Daybreak صراحةً إعادة البيع، أو العمل كوسيط، أو دمجه في خدمات أخرى، أو إتاحته لعملاء من جهات خارجية. كما لا يجوز استخدامه لمعالجة طلبات منتجات موجهة للعملاء.
إذا كنت تفكر في تقديم طلب، فاستند أولًا إلى هذه المعايير الثلاثة:
- إذا كنت ضمن فريق أمن مؤسسي وحصلت بالفعل على موافقة Red، فمن المجدي أن تتقدم بطلب منفصل للحصول على GPT-6 Cyber، ثم تختبر مهام حقيقية في بيئة خاضعة للرقابة.
- إذا كان عملك يركز على تدقيق الشيفرة وإنشاء التصحيحات، فإن Astra أو 6.1 Sol يكفيان، ولا داعي لدفع سعر أعلى بعشرة أضعاف للإدخال في Cyber.
- إذا كنت باحثًا مستقلًا، فتقدم أولًا بطلب للحصول على Daybreak Blue، لكن لا تتوقع أن يتيح لك الوصول إلى إصدار Cyber.
ما البدائل المتاحة حاليًا على APIYI؟
حتى 6 نوفمبر 2026، لا يظهر gpt-6-cyber في قائمة النماذج أو واجهة الأسعار لدى APIYI (apiyi.com)، ما يعني أنه لم يُطرح بعد. تُعد قائمة النماذج الشاملة على apiyi.com/models المرجع المعتمد للنماذج والأسعار، وسنطرح هذا النموذج في أقرب وقت بعد إتاحة GPT-6 Cyber. يعرض الجدول التالي نماذج يمكن استدعاؤها الآن على APIYI، وتناسب قدراتها وأسعارها المهام المتعلقة بالأمن.
| النموذج | الإدخال / الإخراج / قراءة ذاكرة التخزين المؤقت | شرائح أسعار الإدخال | الاستخدامات المناسبة |
|---|---|---|---|
gpt-6-astra |
10 / 50 / 1 دولار | من 0 إلى 272K: 10 دولارات؛ من 272K إلى 1.05M: 20 دولارًا | أقرب نموذج عام رائد إلى Cyber؛ مناسب لتدقيق الشفرة، والتحقق من الثغرات، وتوليد التصحيحات |
gpt-6.1-sol |
2 / 10 / 0.1 دولار | من 0 إلى 272K: دولاران؛ أكثر من 272K: 4 دولارات | مراجعة الشفرة اليومية وتحليل السياقات الطويلة؛ الأفضل من حيث القيمة مقابل السعر |
gpt-6.1-terra |
1 / 5 / 0.05 دولار | بلا شرائح | فهم النصوص الطويلة والمراجعة الأمنية الخفيفة |
gpt-6-sol |
2 / 10 / 0.2 دولار | من 0 إلى 272K: دولاران؛ أكثر من 272K: 4 دولارات | الاستدلال العام وتلخيص التقارير |
gpt-6-luna |
0.1 / 0.5 / 0.01 دولار | من 0 إلى 272K: 0.1 دولار؛ أكثر من 272K: 0.2 دولار | الفحص واسع النطاق، والفرز الأولي للسجلات، والتصنيف منخفض التكلفة |
جميع الأسعار في الجدول لكل مليون رمز، وهي مستمدة من قائمة النماذج الشاملة على apiyi.com/models. عند تجاوز الإدخال للحد المحدد، تُحتسب تكلفة الطلب بالكامل وفق سعر الشريحة الأعلى؛ ويُحسب سعر الإخراج بضرب سعر إدخال الشريحة المقابلة في معامل الإخراج. تدعم جميع هذه النماذج على APIYI نقطتي النهاية Responses وChat Completions، وتُحاسب حسب الاستخدام دون اشتراك شهري.
يعتمد الاختيار على المهمة. إذا كنت تريد فهم تقرير ثغرات وتحويله إلى توصيات للإصلاح، فاستخدم gpt-6.1-sol. وإذا أردت مراجعة قاعدة الشفرة كاملةً وتتبع سلسلة الاستدعاءات ضمن سياق طويل، فاستخدم الشريحة الأعلى من gpt-6-astra. أما للفرز الأولي واسع النطاق، فاستخدم gpt-6-luna لتحديد النقاط المشبوهة، ثم أحلها إلى أحد النموذجين السابقين للتحقق منها. وإذا كنت تحتاج إلى تنفيذ استغلال فعلي للثغرات، فلا يوجد حاليًا بديل على APIYI، وستحتاج إلى الحصول على موافقة OpenAI عبر Daybreak Red.
أنشئ رمز وصول في لوحة تحكم apiyi.com، ثم خصص ميزانية صغيرة لتجربة السيناريوهات الثلاثة المذكورة. ستساعدك النتائج على تحديد ما إذا كنت تريد تغيير النموذج بصورة أفضل من الاكتفاء بالنظر إلى نتائج الاختبارات القياسية. يضم مركز وثائق APIYI معلومات نقاط النهاية وحدود المعدل والفوترة لكل نموذج. وإذا واجهت الخطأ 400 أو 429، فتحقق أولًا من المعلمات والحدود الموضحة في الوثائق.
الأسئلة الشائعة
س1: هل يمكن للأفراد التقدم للحصول على GPT-6 Cyber؟
لا يمكنهم التقدم مباشرة إلى Daybreak Red. يمكن للأفراد التقدم فقط إلى Daybreak Blue، الذي لا يتضمن نموذج Cyber المتخصص. ووفقًا للمعلومات الرسمية، يقتصر Red حاليًا على الشركات والمؤسسات المعتمدة، ولا يمكن دعوة الأفراد إلا في حالات استثنائية.
س2: هل نتيجة 48.5% على ExploitGym مرتفعة؟
نعم، فهي أعلى من نتيجة GPT-5.6 Cyber بـ16 نقطة مئوية، ومن نتيجة GPT-6 Astra بنحو 6 نقاط مئوية، وتُعد من أعلى النتائج بين النماذج التجارية حاليًا. لكن هذا لا يعني تفوقه في جميع القدرات العامة؛ إذ جاءت نتائجه في FrontierCyber وExpertSWE أقل قليلًا من Astra.
س3: هل معدل تجاوز النطاق البالغ 0.07% يدعو إلى الاطمئنان؟
لا يمكن اعتباره صفرًا. فرغم تحسنه بنحو 79 ضعفًا مقارنة بالجيل السابق، قد يتعامل النموذج مع خدمات خارج النطاق في 7 مهام من كل 10 آلاف مهمة. وعند استخدامه في بيئة إنتاج، لا بد من تطبيق موجهات النشر، وبيئة العزل، وAuto-Review، والإشراف البشري.
س4: متى سيتوفر GPT-6 Cyber على APIYI؟
لم يكن متاحًا حتى 6 نوفمبر 2026. للاطلاع على النماذج والأسعار، راجع apiyi.com/models. سنحدّث هذه المقالة ونوفر النموذج على المنصة عند إضافته.
س5: هل أحتاج إلى الانتقال إلى GPT-6 Cyber الآن؟
تحتاج إليه فقط إذا كنت تطور شفرة استغلال قابلة للاستخدام، أو تجري اختبارات فريق أحمر مصرحًا بها، أو تتحقق من سلاسل الاستغلال. أما لمهام مثل تدقيق الشفرة، وإنشاء التصحيحات، وتفسير تقارير الثغرات، فإن GPT-6 Astra أو GPT-6.1 Sol أوفر من حيث التكلفة.
الخلاصة
لا تكمن أهمية GPT-6 Cyber في أنه «أفضل في المحادثة»، بل في أنه أحرز تقدمًا على ثلاثة محاور في الوقت نفسه: نتيجة 48.5% في ExploitGym تشير إلى قدرات هجومية أقوى؛ ومعدل تجاوز الحدود البالغ 0.07% في اختبارات المصائد يشير إلى التزام أفضل بالقواعد مقارنة بالجيل السابق؛ أما اكتشاف 948 عملية استغلال لرفع الصلاحيات في Linux و81 ثغرة عالية الخطورة في Firefox، فيوضح أن هذه النتائج امتدت إلى برمجيات حقيقية.
لكن للنموذج حدودًا واضحة أيضًا: فهو لا يتفوق على Astra في كل شيء، ومعدل تجاوز الحدود ليس صفرًا، ولا يستطيع الأفراد الحصول على Red، وسعره يعادل 10 أضعاف سعر 6.1 Sol. بالنسبة إلى معظم الفرق، من الأفضل البدء باستخدام GPT-6 Astra أو GPT-6.1 Sol لتنظيم عمليات تدقيق الشفرة وتطبيق التصحيحات، ثم طلب الوصول إلى Daybreak Red عند الحاجة الفعلية إلى تطوير عمليات استغلال الثغرات.
إذا أردت إجراء تجربة أولية باستخدام النماذج المتاحة، يمكنك إنشاء رمز وصول بنظام الدفع حسب الاستخدام على APIYI (apiyi.com)، واختيار نموذج من جدول النماذج في نهاية المقال، دون الحاجة إلى شراء باقة مسبقًا.
المراجع
- إعلان OpenAI: https://openai.com/index/introducing-gpt-6-cyber
- بطاقة نظام GPT-6 Cyber: https://deploymentsafety.openai.com/gpt-6-cyber
- صفحة النموذج للمطورين (الأسعار ونقاط النهاية وحدود المعدل): https://developers.openai.com/api/docs/models/gpt-6-cyber
- مركز مساعدة Daybreak: https://help.openai.com/en/articles/20001258-openai-daybreak-trusted-access-for-cyber-overview
- تقرير The Verge: https://www.theverge.com/ai-artificial-intelligence/1027599/openai-gpt-6-cyber-launch
- جدول نماذج APIYI وأسعارها: https://docs.apiyi.com/models