ملاحظة الكاتب: نستعرض بنية Router + Worker ذات الطبقتين في DeepSeek Super-agent، وكيف تفصل بين التنسيق العام والتنفيذ المستقل، ومتى يجدر بالمطورين اعتماد تصميم مشابه في أنظمة الوكلاء لديهم.
إذا كنت تفتح أربع أو خمس نوافذ لوكلاء برمجة في الوقت نفسه، فستواجه مشكلة عملية: نافذة تصلح خطأً في تسجيل الدخول، وأخرى تراجع عملية ترحيل قاعدة البيانات، وثالثة تنتظر نتائج التكامل المستمر (CI). عليك أن تتذكر ما تفعله كل نافذة، وأيها ينتظر ردك، وأي المهام يرتبط بعضها ببعض. صحيح أن النماذج أصبحت أكثر قدرة على العمل باستقلالية، لكن عبء إدارة هذه الجلسات يقع على عاتق الإنسان.
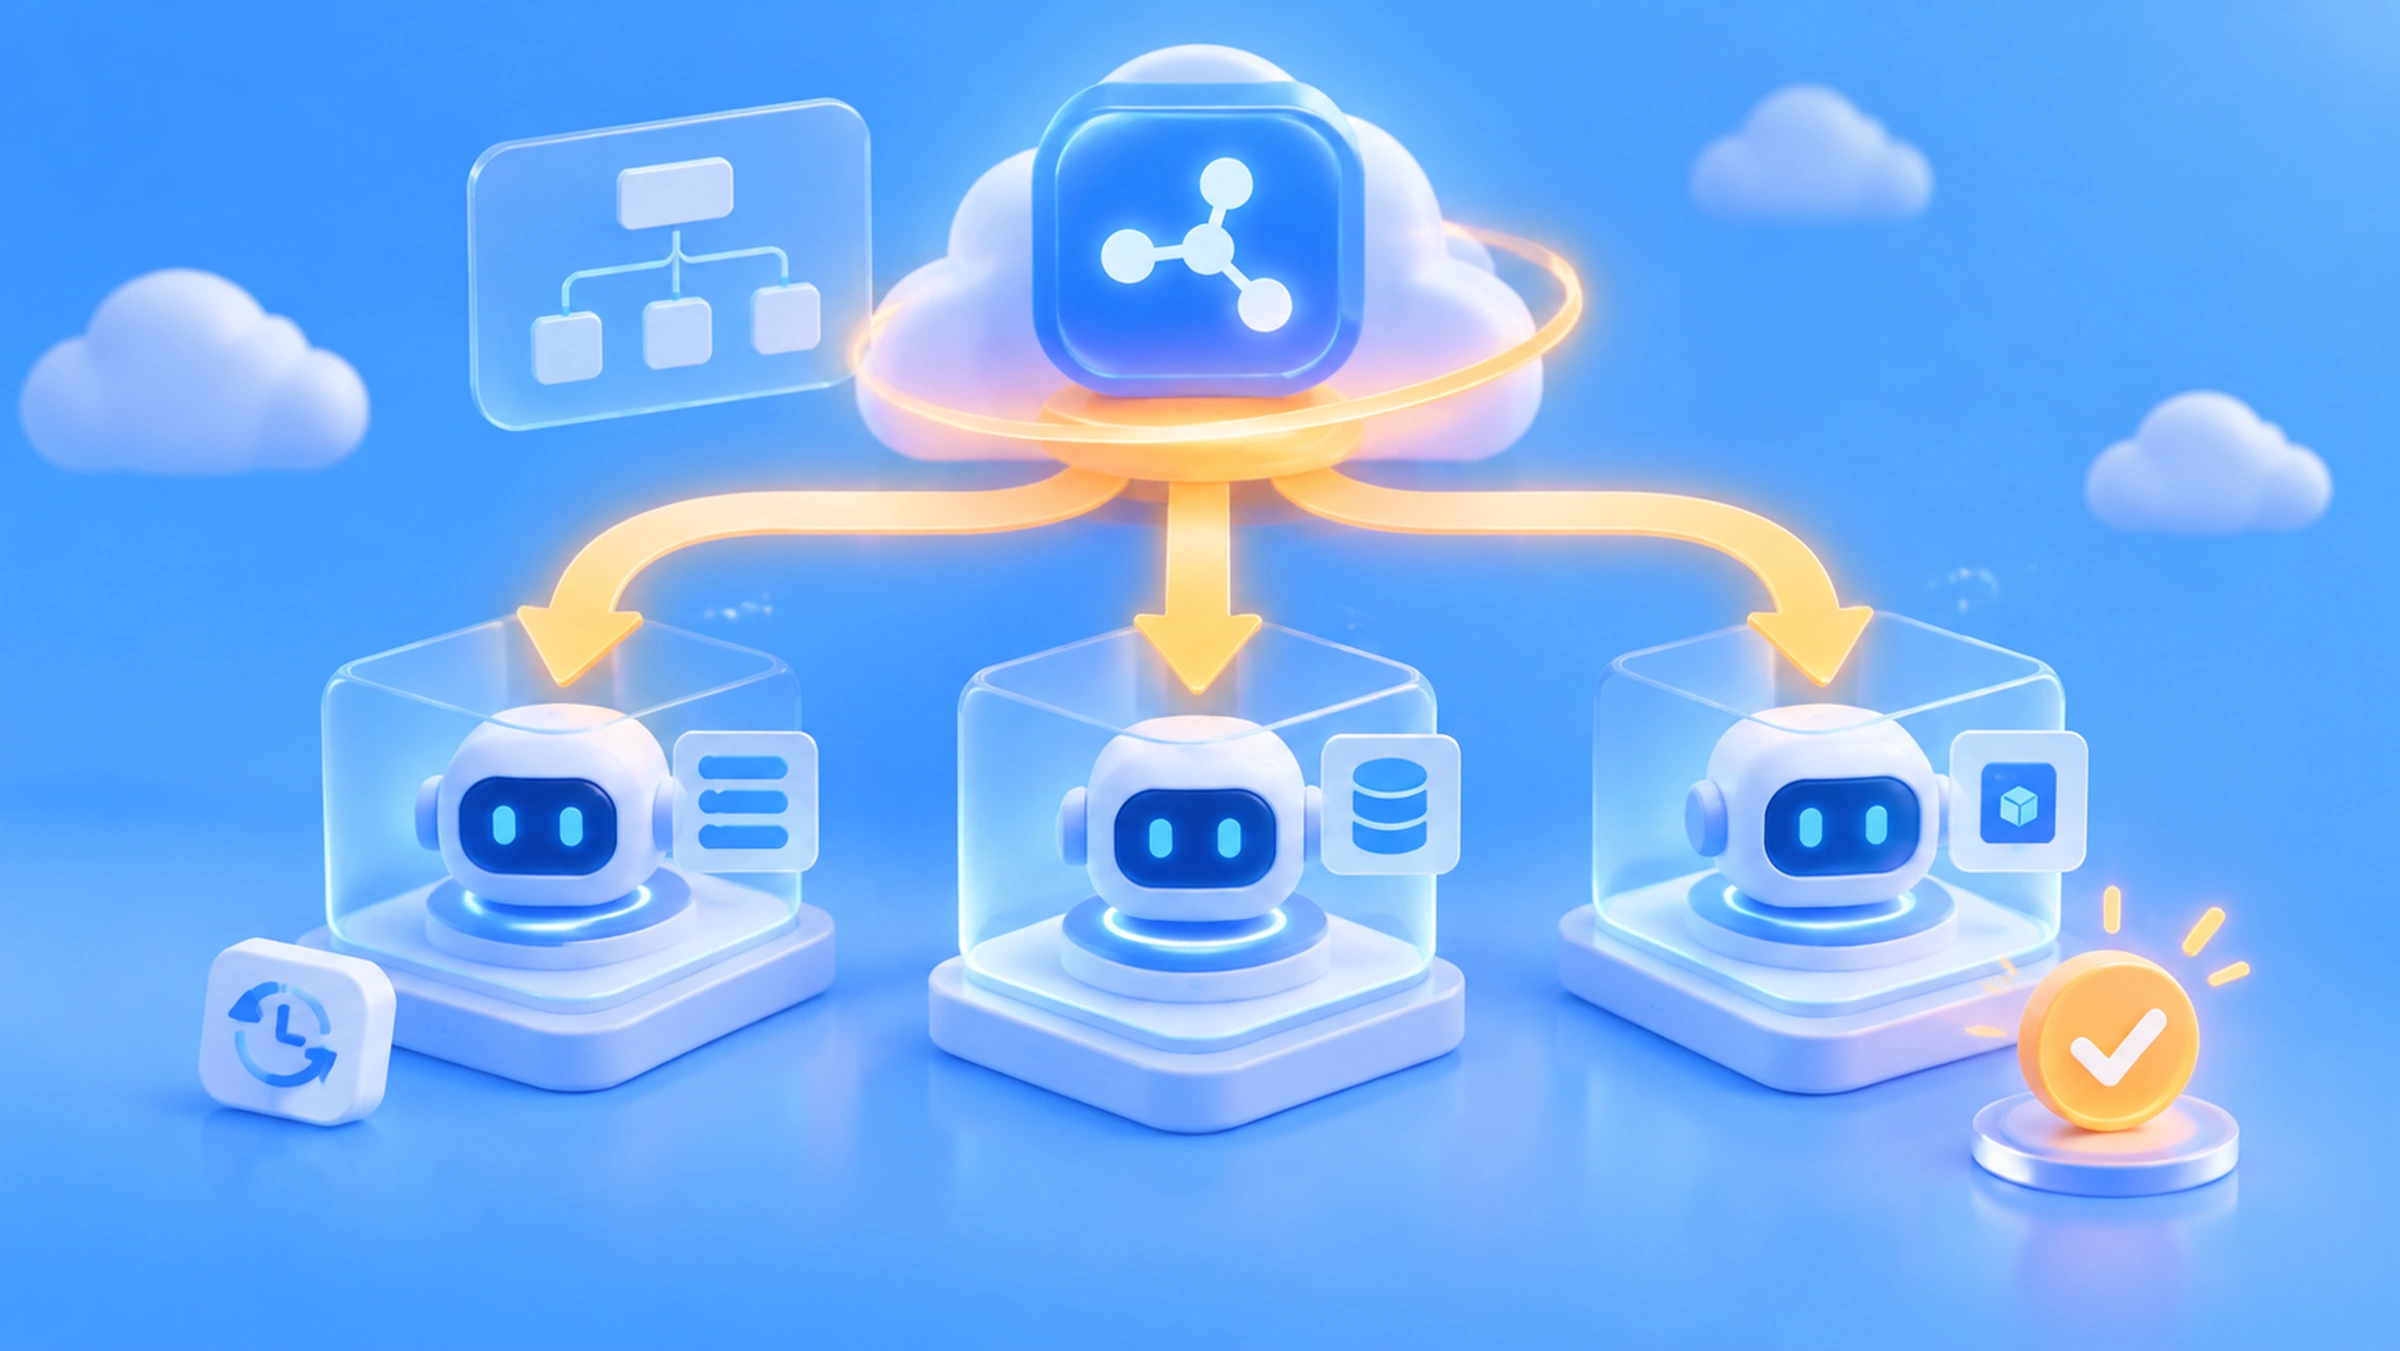
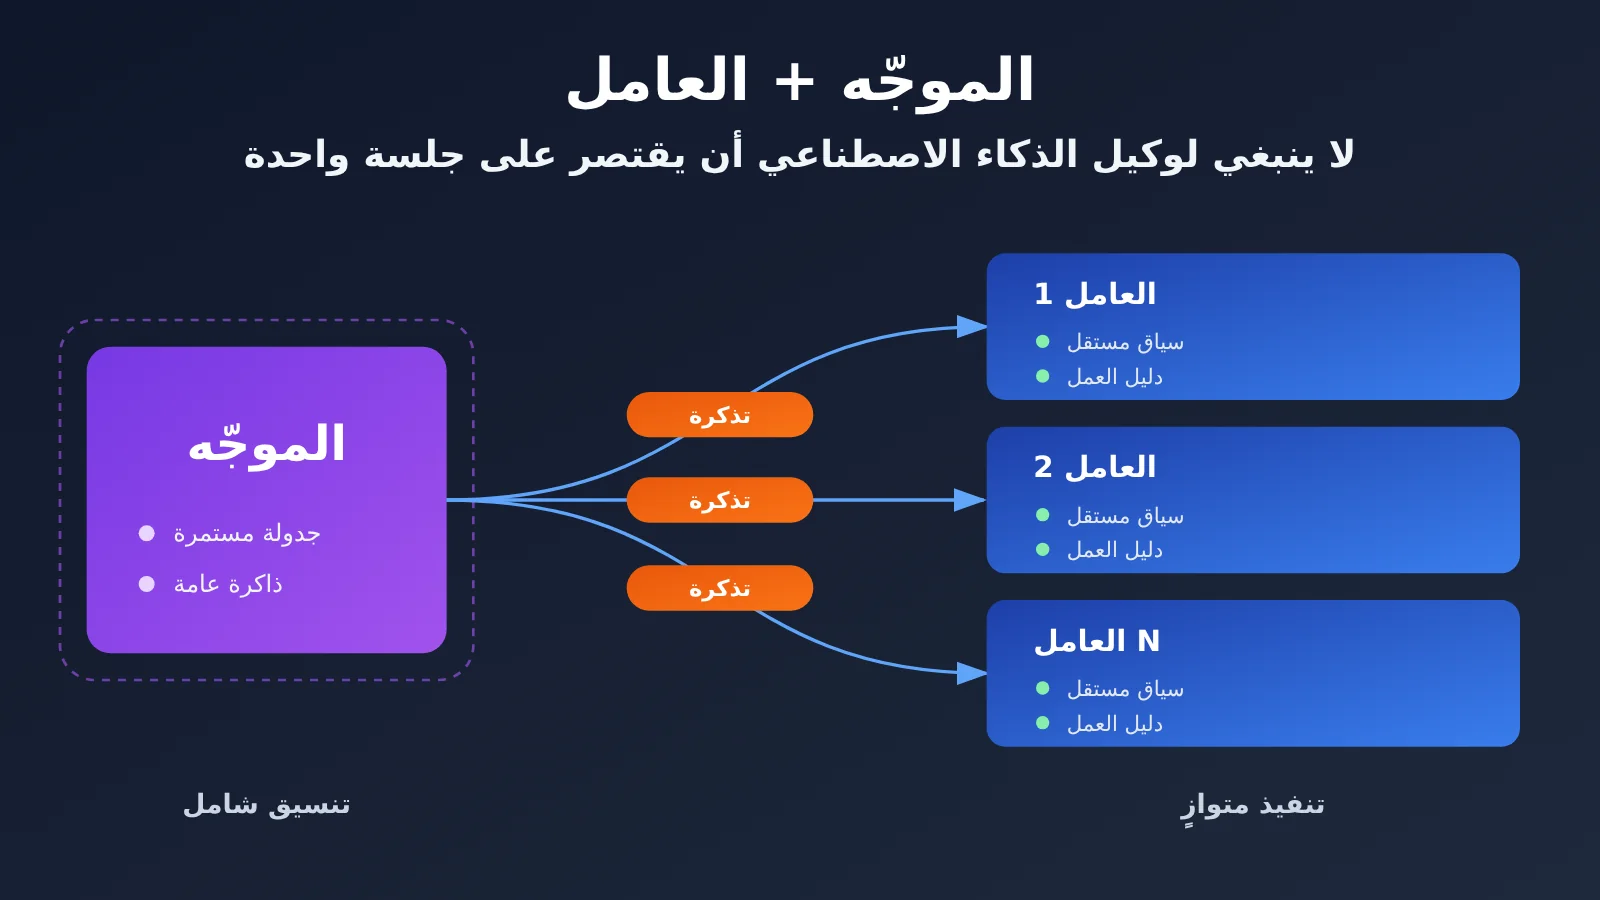
في 31 أكتوبر 2026، نشر فريق DeepSeek Harness المقال التقني «استكشاف تصميم Super-agent: نحو أنظمة وكلاء أكثر استقلالية»، وأتاح النموذج الأولي البحثي dsh-superagent-prototype مفتوح المصدر بموجب ترخيص MIT. وأبرز ما في التصميم هو بنية Router + Worker ذات الطبقتين، حيث يتولى Router دائم التشغيل التنسيق العام، بينما تتولى عدة وحدات Worker معزولة تنفيذ المهام المحددة.
الأمر ليس مجرد حيلة لجعل نموذج ذكاء اصطناعي واحد يؤدي مهام أكثر في الوقت نفسه. تتمثل فكرة Super-agent في فصل التنسيق العام عن التنفيذ المستقل على مستوى بنية النظام، لتخفيف عبء إدارة الجلسات المتعددة عن الإنسان. يتناول هذا المقال دافع التصميم، وآلياته الأساسية، وبيانات التجارب الرسمية، وما يعنيه لاستدعاءات API وإدارة التكلفة، وفق تسلسل: «المشكلة، ثم الآلية، ثم الأدلة، ثم القيمة الهندسية».
الفائدة الأساسية: بعد قراءة المقال، ستفهم المشكلة التي تعالجها بنية Router + Worker ذات الطبقتين، وستتمكن من تحديد متى يجدر بك اعتماد تصميم مشابه في نظام الوكلاء الخاص بك.
نظرة سريعة على Router + Worker
قبل التعمق في البنية، لنتعرف على الحقائق الأساسية لهذا الإصدار. من المهم التأكيد أن ما أتاحته DeepSeek كمصدر مفتوح هو نموذج بحثي أولي، وليس منتجًا تجاريًا رسميًا أو نموذجًا أساسيًا جديدًا.
| البند | التفاصيل |
|---|---|
| موعد الإصدار | 31 أكتوبر 2026 (نُشرت المقالة التقنية ومستودع GitHub في اليوم نفسه) |
| الجهة المطوّرة | فريق DeepSeek Harness |
| اسم المشروع | dsh-superagent-prototype، يستخدم TypeScript بشكل أساسي، ومرخّص بموجب MIT |
| طبيعة المشروع | نموذج بحثي أولي، وليس منتجًا تجاريًا رسميًا، ويعتمد على DeepSeek Harness للتشغيل |
| البنية الأساسية | بنية من طبقتين: Router للتنسيق العام وWorker للتنفيذ في بيئة معزولة |
| الإمكانات المدعومة حاليًا | مراقبة مستودع GitHub واحد، والتكامل الاختياري مع Feishu، وإدارة التذاكر، وجلسات Worker المستقلة، وإنشاء طلبات السحب (PR) |
| اهتمام المجتمع | نحو 8900 نجمة و898 عملية Fork حتى 2 نوفمبر (الأرقام تتغير باستمرار) |
حددت الجهة المطوّرة أربع خصائص مستهدفة لـ Super-agent: الاستمرارية (Continuous) في السياق عبر القنوات، والإنتاجية (Productive) عبر تنفيذ مهام متعددة بالتوازي، والمبادرة (Proactive) بالاستجابة للأحداث ضمن حدود الصلاحيات الممنوحة، والمواظبة (Persistent) بالبقاء متصلًا والتعافي من بعض الأعطال. هذه أهداف تصميمية، ولا تعني أن النموذج الأولي مفتوح المصدر يحققها جميعًا بالفعل.
لماذا لا ينبغي لوكيل الذكاء الاصطناعي الاكتفاء بجلسة واحدة
يرى فريق DeepSeek أن عائق أدوات البرمجة بالذكاء الاصطناعي يتحول من «قدرات النموذج» إلى «انتباه الإنسان». ووفقًا لملاحظات الفريق اليومية، يستطيع الشخص عادةً متابعة نحو 3 إلى 5 جلسات نشطة للوكلاء بفعالية. هذا تقدير مستند إلى خبرة الفريق، وليس إحصاءً عامًا واسع النطاق، لكنه يصف بدقة ما يشعر به كثير من المطورين.
المفاضلة بين جلسة واحدة وجلسات متعددة
لكل من النهجين الشائعين عيوب جوهرية. وقد طُرحت بنية Router + Worker للجمع بين «استمرارية السياق العام» و«القدرة على المعالجة المتوازية في الخلفية».
| أسلوب البنية | المزايا | المشكلة الأساسية |
|---|---|---|
| جلسة واحدة لجميع الأعمال | استمرارية السياق العام بطبيعتها | تداخل معلومات المهام؛ استدعاءات الأدوات طويلة التنفيذ تعيق المهام الجديدة؛ التقيد بحلقة ReAct واحدة |
| جلسة مستقلة لكل مهمة | تنفيذ متوازٍ وعزل للسياق | غياب الذاكرة العامة؛ اضطرار الشخص لتذكر العلاقات بين المهام؛ تشتت المحادثات والإشعارات بين نوافذ متعددة |
| بنية Router + Worker ذات الطبقتين | مركزية الحالة العامة مع عزل سياق التنفيذ | استهلاك أكبر لموارد الاستدلال، واحتمال أن يصبح Router عنق زجاجة |
مشكلة الجلسة الواحدة هي «الازدحام»، أما مشكلة الجلسات المتعددة فهي «التشتت». فالنهج الأول يحمّل نافذة سياق واحدة الخطوات الوسيطة لجميع المهام، بينما ينقل الثاني عبء التنسيق بالكامل إلى الإنسان. وتقوم فكرة DeepSeek على إضافة دور مخصص على مستوى النظام يتولى «تذكر الصورة العامة»، ليتمكن المنفذون من التركيز على التنفيذ.
كيف تعمل بنية Router + Worker ذات الطبقتين؟
Router: طبقة التنسيق والجدولة العامة
يمثل Router طبقة منطقية تعمل باستمرار. وفي استكشاف البنية الحالي لدى الفريق الرسمي، يُنفَّذ أساسًا من خلال جلسة نموذج لغة كبير (LLM Session) دائمة، لكنه لا يقتصر بالضرورة على جلسة نموذج واحدة من الناحية المفاهيمية. وتتركز مسؤولياته على الإدارة لا التنفيذ:
- استقبال رسائل المستخدم والأحداث الخارجية من GitHub وIM وCI وغيرها؛
- متابعة الروابط بين المهام على مستوى النظام وتحديد ما إذا كان يلزم إنشاء مهمة جديدة؛
- التحقق من الصلاحيات وإسناد المهام إلى Worker، مع تنسيق العمل بين المهام؛
- تجميع المعلومات المطلوب تقديمها للبشر، واسترجاع سياق المهام القديمة عند الحاجة.
ومن التفاصيل المهمة أن الفريق الرسمي يرى أن Router يمكن أن يعمل حتى من دون أداة Bash. فعدم تكليفه بتنفيذ مهام برمجية معقدة بنفسه يمنع تعطله بسبب استدعاءات الأدوات طويلة المدة. كذلك، لا تحتاج مهامه دائمًا إلى أقوى نموذج استدلال؛ فقد يكفي نموذج أخف للتفاعل وتوزيع المهام، وهو ما يدعم تقنيًا فكرة «استخدام نماذج مختلفة لأدوار مختلفة».
Worker: طبقة تنفيذ المهام في بيئات مستقلة
يتولى Worker تنفيذ العمل الفعلي. في النموذج الأولي المتاح للعامة، تقابل كل تذكرة (Ticket) جلسة تنفيذ واحدة (Executor Session)، ولكل تذكرة دليل عمل مستقل. ويعدّل Worker الشفرة ويشغّل الاختبارات ويتعامل مع الملاحظات اللاحقة ضمن الصلاحيات الممنوحة له، ثم يُعد تقريرًا (Report) عند الانتهاء. وعندما يلزم اتخاذ قرار بشري، يضبط حالة Attention، وتُسلَّم النتيجة عبر القناة الأصلية، مثل طلب سحب على GitHub.
سياق النموذج لكل Worker مستقل عن سياقات العمال الآخرين، ما يحل مشكلة اختلاط الخطوات الوسيطة للمهام المتعددة في نافذة واحدة. لكن تجدر الإشارة إلى أن استقلال الجلسات والأدلة لا يعني وجود عزل أمني قوي. وتوضح وثائق النشر الرسمية أن Worker ينفّذ الأوامر افتراضيًا بهوية مستخدم نظام التشغيل الخاص بالمشغّل.
كيف تمر مشكلة GitHub بمراحل Router + Worker؟
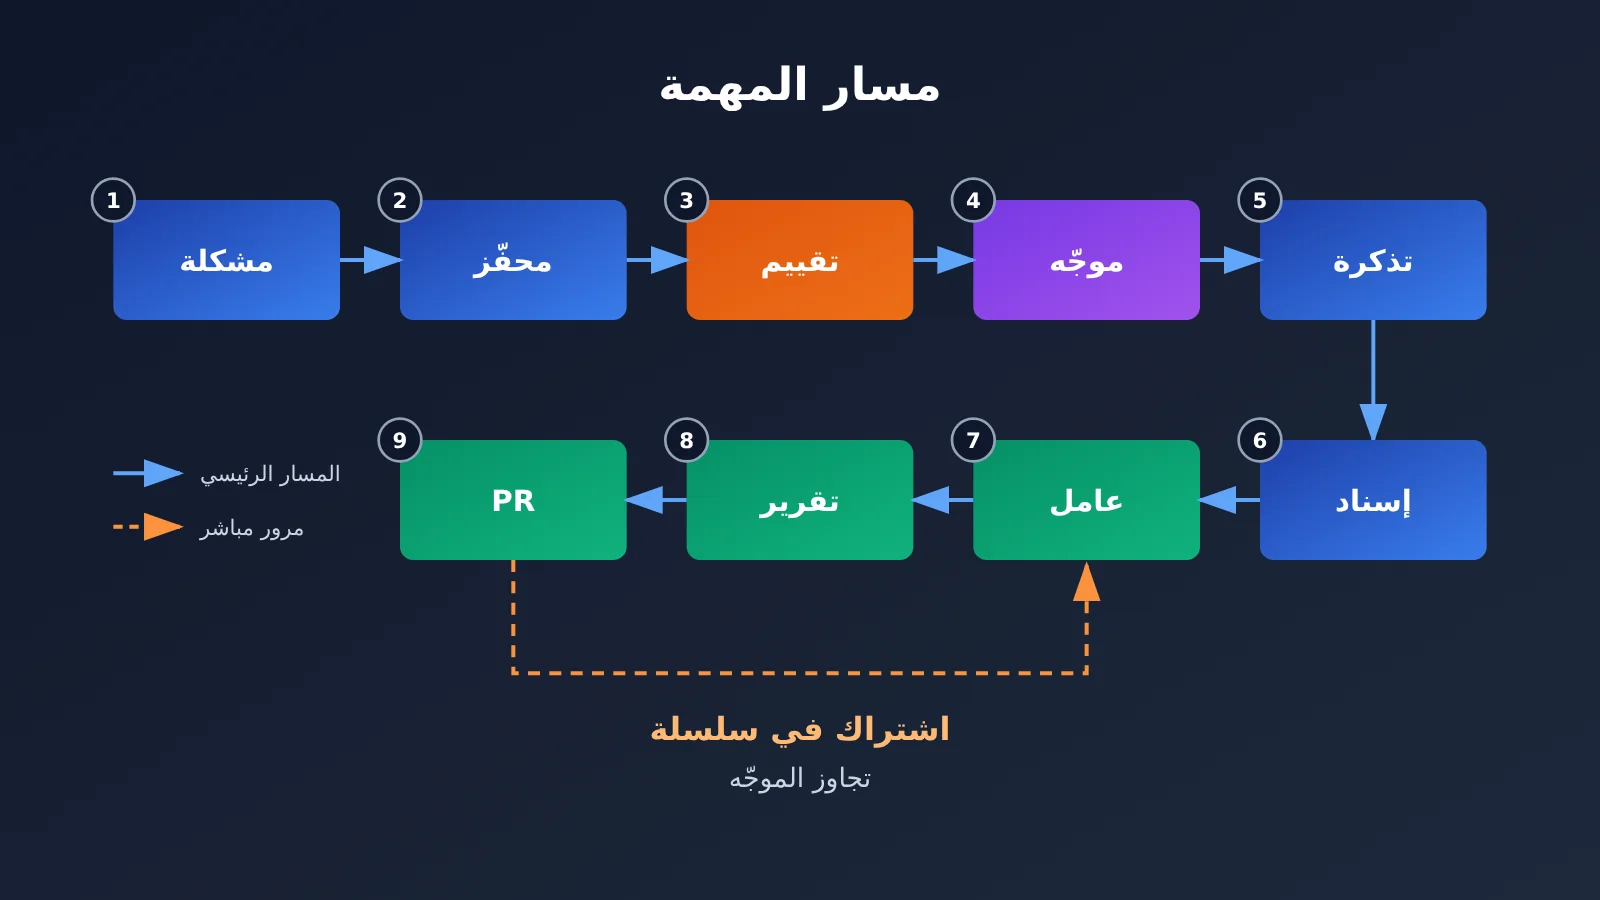
وفقًا لنموذج المجال (Domain Model) في التنفيذ مفتوح المصدر، يمكن تلخيص مسار المهمة كما يلي: Source → Trigger → Eval → Decision → Ticket → Assignment → Executor → Report. لنأخذ مثالًا على مستخدم مخوّل يطلب إصلاح خلل في مشكلة على GitHub:
- يستقبل GitHub Source تعليقًا على المشكلة ويُنشئ Trigger؛
- يطبّق النظام أولًا قواعد محددة للتحقق من الصلاحيات، ثم يقرر النموذج ما إذا كان الطلب يستوفي قواعد قبول المهام؛
- يقبل Router المهمة وينشئ Ticket تسجّل نطاق المهمة والتفويض الممنوح لها (Mandate)؛
- ينشئ النظام Assignment للتذكرة ويسندها إلى Worker المناسب؛
- ينفّذ Executor الإصلاح في دليل وجلسة مستقلين؛
- يبلّغ Worker عن التقدم أو يقدّم النتيجة، وينشئ طلب سحب (PR)؛
- يسلّم النظام النتيجة للمستخدم عبر سلسلة المناقشة الأصلية في المشكلة أو طلب السحب.
إذا قدّم المستخدم لاحقًا ملاحظات على طلب السحب، يمكن ربط الرسالة الجديدة بالمهمة الأصلية تلقائيًا. ولا يحتاج المستخدم إلى البحث مجددًا عن «جلسة الوكيل التي كانت تتولى هذا العمل»؛ وهذا مثال عملي على تخفيف البنية ذات الطبقتين لعبء الإدارة على البشر.
أربعة تصميمات أساسية لـ Router + Worker
البنية ذات الطبقتين ليست سوى الهيكل الأساسي؛ أما ما يجعلها عملية فهو مجموعة من التصميمات الهندسية الموجهة، يعالج كل منها مشكلة محددة:
| التصميم | المشكلة الهندسية التي يعالجها | الآلية الأساسية |
|---|---|---|
| التوصيل المباشر عبر الاشتراك في Thread | مرور جميع الرسائل اللاحقة عبر Router يثقل العقدة المركزية | يشترك Worker في Thread المسؤول عنه، فتصل إليه الأحداث ذات الصلة مباشرةً |
| المعالجة الدفعية في Router | معالجة Router للأحداث واحدًا تلو الآخر أثناء التدفق المفاجئ تحدّ من الإنتاجية | دمج أحداث Trigger المتراكمة أثناء الاستدلال في دفعة واحدة للتحليل |
| Inline & Spill | نافذة السياق محدودة، وإدراج المحتوى كاملًا مكلف | وضع المعلومات الحديثة والضرورية في النافذة، والاحتفاظ بملخص ومؤشر للقراءة للمحتوى الطويل |
| الاسترجاع المتسلسل | صعوبة استعادة معلومات المهام السابقة | تتبّع العلاقات بين Trigger وThread وTicket وWorker تدريجيًا |
التوصيل المباشر عبر الاشتراك في Thread: تقليل إعادة التوزيع بواسطة Router
لنفترض أن Worker A مسؤول عن طلب سحب (PR). عندها يمكن توجيه التعليقات اللاحقة على الطلب ونتائج التكامل المستمر (CI) إليه مباشرةً بحسب Thread الذي تنتمي إليه، دون أن يضطر Router إلى اتخاذ قرار جديد لكل رسالة مرتبطة. وهذا مثال واضح على إبعاد القرارات المتكررة منخفضة القيمة عن العقدة المركزية.
لكن للتوصيل المباشر حدودًا واضحة للصلاحيات. تنص وثائق التفويض الرسمية على أن رسائل الاشتراك يمكن أن توفر سياقًا، لكنها لا توسّع نطاق تفويض Ticket الأصلي (Mandate). وإذا طلب تعليق لاحق تنفيذ عمل جديد خارج نطاق التفويض، فعلى Worker إحالته مجددًا إلى النظام لإعادة تقييمه. وهذا مهم للحماية من التعليمات التي تتجاوز الصلاحيات في التعليقات الخارجية.
المعالجة الدفعية في Router: التعامل مع التدفق المفاجئ للأحداث
أثناء تنفيذ Router لجولة استدلال، تتراكم أحداث Trigger الجديدة مؤقتًا، ثم تُحلّل معًا في دفعة واحدة خلال الجولة التالية. وبذلك يتحول «استدعاء النموذج مرة لكل رسالة» إلى «معالجة عدة رسائل في كل جولة استدلال»، ما يوزّع تكلفة الاستدلال على عدد أكبر من القرارات عند كثافة الأحداث.
Inline & Spill والاسترجاع المتسلسل: التعامل مع السياق كذاكرة تخزين مؤقت
تتعامل DeepSeek مع نافذة السياق بوصفها ذاكرة تخزين مؤقت. تعني Inline وضع المعلومات الحديثة التي يُرجّح استخدامها مباشرةً داخل النافذة، مثل أحدث التعليقات على المهمة الحالية، وأسطر الشفرة ذات الصلة، والأجزاء المحيطة الضرورية. أما Spill فتعني إبقاء المحتوى الطويل أو قليل الاستخدام خارج النافذة، مع الاحتفاظ بملخص ومعرّفات الارتباط ووسيلة للوصول إليه، كما في حالة النقاشات التاريخية الطويلة. ولا حاجة إلى إدراج الرسائل التاريخية غير المرتبطة في كل مرة.
ومن هنا يأتي مفهوم Chain of Recall، أو الاسترجاع المتسلسل: يستطيع النموذج تتبّع العلاقات بين الكائنات بالترتيب Trigger → Thread → Ticket → Worker لاستعادة المعلومات السابقة تدريجيًا عند الحاجة. وهذا أوفر في استخدام السياق من «إدراج السجل الكامل في كل مرة»، وأقرب إلى فكرة الاستعلام عن قاعدة بيانات باستخدام الفهارس. لكن الجهة المطوّرة تقرّ بأن الاحتفاظ بالذاكرة عبر أشهر أو لفترات أطول لا يزال مشكلة غير محلولة.
تحليل بيانات تجربة Router + Worker
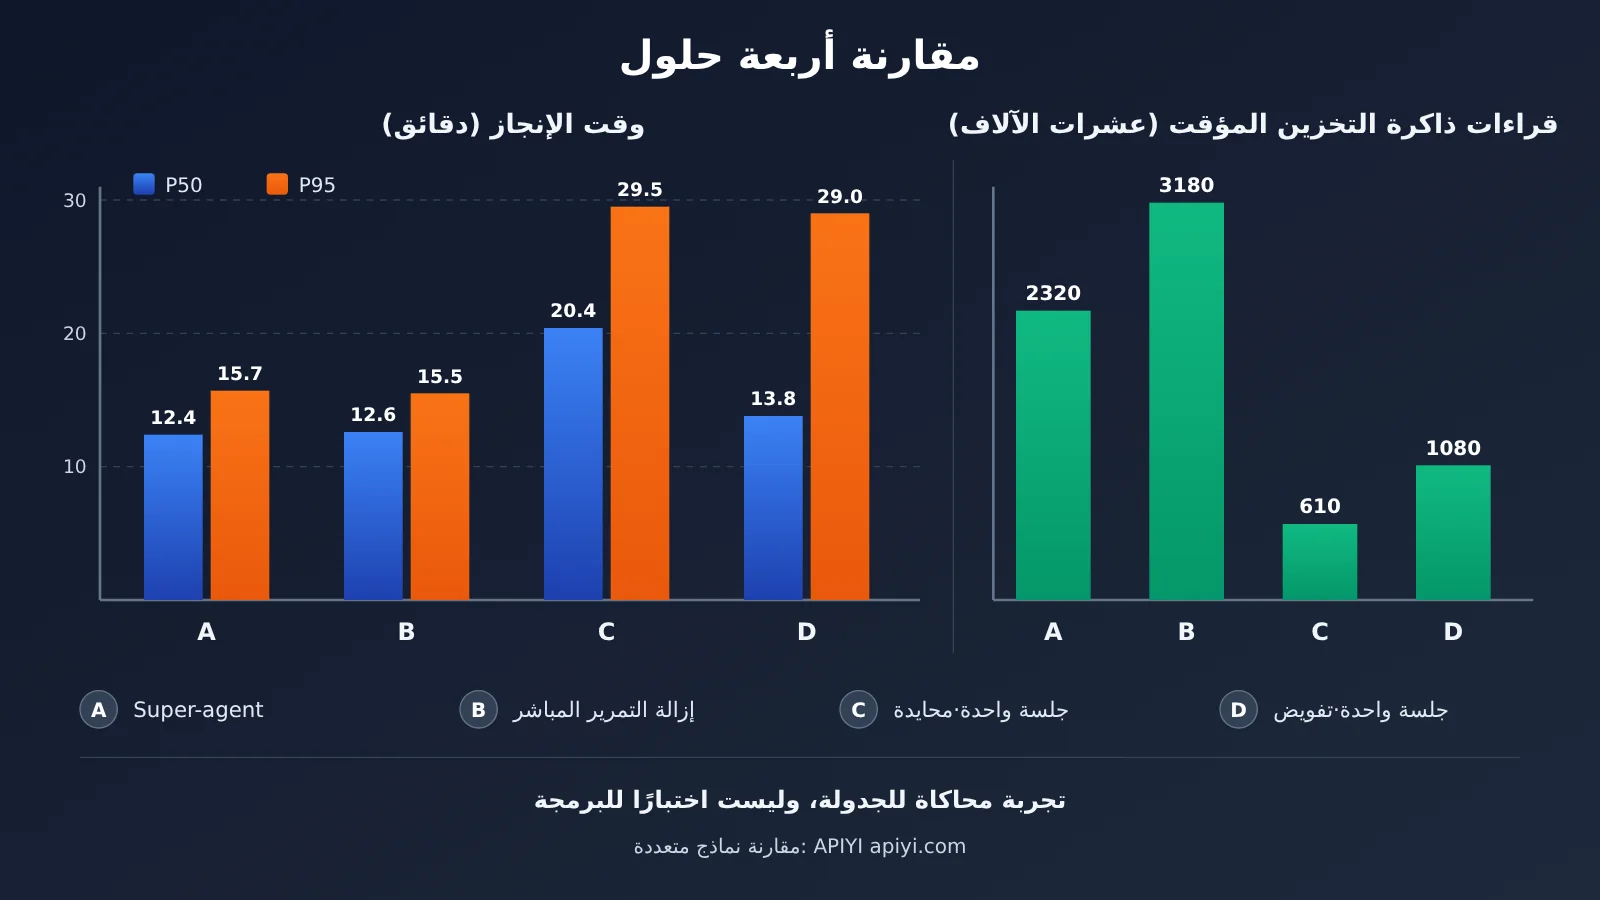
أجرت DeepSeek مجموعة من التجارب الأولية بأحمال عمل اصطناعية. تضمنت كل محاكاة نحو 300 رسالة، منها نحو 20 طلب عمل، بينما توزعت البقية بين محادثات عادية وملاحظات لاحقة وطلبات إلغاء ورسائل CI. وأُجريت كل تجربة 5 مرات. استُبدلت مهام البرمجة بأدوات محاكاة تستغرق وقتًا، لذا تقيس هذه البيانات أداء نظام الجدولة، لا جودة توليد الشفرة.
مقارنة الجدولة من البداية إلى النهاية
| الخيار | وقت الإنجاز عند P50 | وقت الإنجاز عند P95 | رموز Token المقروءة من ذاكرة التخزين المؤقت في التجربة الواحدة |
|---|---|---|---|
| Super-agent | 12.4 دقيقة | 15.7 دقيقة | نحو 23.2 مليون |
| Super-agent، مع إزالة التمرير المباشر للاشتراكات | 12.6 دقيقة | 15.5 دقيقة | نحو 31.8 مليون |
| Session واحدة + Subagent، بموجه محايد | 20.4 دقيقة | 29.5 دقيقة | نحو 6.1 مليون |
| Session واحدة + Subagent، مع إعطاء الأولوية للتفويض | 13.8 دقيقة | 29.0 دقيقة | نحو 10.8 مليون |
مقارنةً بخيار الجلسة الواحدة ذي الموجه المحايد، انخفض وقت إنجاز Super-agent عند P50 بنحو 39%، وعند P95 بنحو 47%. أما مقارنةً بخيار الجلسة الواحدة الذي يعطي الأولوية للتفويض، فكانت الأفضلية عند P50 طفيفة، لكن أوقات الإنجاز الطويلة عند P95 كانت أقصر بوضوح. بعبارة أخرى، تتمثل أكبر فائدة للبنية ذات الطبقتين في تقليل الوقت الذي تستغرقه أبطأ المهام.
في المقابل، كانت قراءة Super-agent من ذاكرة التخزين المؤقت تعادل نحو 3.8 أضعاف خيار الجلسة الواحدة ذي الموجه المحايد. فهو يستخدم عددًا أكبر من الجلسات المتوازية وموارد الاستدلال للحصول على أوقات إنجاز أقصر وأكثر استقرارًا. لكن هذا لا يعني أن التكلفة الإجمالية تزيد 3.8 أضعاف؛ فالتكلفة الفعلية تعتمد أيضًا على سعر النموذج، ومعدل الاستفادة من ذاكرة التخزين المؤقت، ورموز Token العادية للإدخال والإخراج، واختيار نماذج Router وWorker، واستدعاءات الأدوات. ولم يُعلن رسميًا بعد متوسط تكلفة API لطلبات العمل الحقيقية.
تستحق تجربة إزالة التمرير المباشر للاشتراكات نظرة أقرب أيضًا. بعد إزالته، زاد عدد القرارات التي يتعين على Router معالجتها بنحو 30%، وزادت رموز Token المقروءة من ذاكرة التخزين المؤقت بنحو 37%، بينما بقي وقت الإنجاز شبه ثابت. والخلاصة أن التمرير المباشر للاشتراكات يقلل أساسًا استدعاءات النموذج وتكاليف السياق لدى Router في هذا الاختبار، بدلًا من زيادة السرعة مباشرةً.
اختبار الضغط لمعالجة Router الدفعية
في هذه الاختبارات، يستخدم Router نموذجًا حقيقيًا، بينما يستخدم Worker نموذجًا محاكيًا:
| المؤشر | كثافة أحداث منخفضة | كثافة أحداث مرتفعة |
|---|---|---|
| معدل وصول الأحداث | نحو حدث واحد في الدقيقة | نحو 40 حدثًا في الدقيقة |
| متوسط حجم الدفعة | 1.0 | 2.8 |
| مدة طلب النموذج الواحد | 2.5 ثانية | 3.9 ثانية |
| متوسط وقت الاستدلال لكل قرار | 6.4 ثانية | 1.6 ثانية |
مع ارتفاع كثافة الأحداث، أصبح الطلب الواحد أبطأ، لكن متوسط وقت الاستدلال لكل قرار انخفض، ما يشير إلى أن المعالجة الدفعية حسّنت الإنتاجية الفعلية. وكان الاستنتاج الرسمي متحفظًا: عند حجم الفريق الحالي، يكفي Router واحد في الوقت الراهن، لكن لا يعني ذلك أن بإمكان نظام Router واحد معالجة عدد غير محدود من الرسائل.
تأثير Router + Worker على المطورين
تقسيم النماذج: نموذج خفيف للـ Router واختيار نموذج الـ Worker حسب المهمة
أبرز ما نستفيده هندسيًا من البنية ذات الطبقتين هو أن الأدوار المختلفة لا تحتاج إلى استخدام النموذج نفسه. تتركز مهام الـ Router على التصنيف والتوزيع والتلخيص، لذا يناسبه نموذج سريع ومنخفض التكلفة. أما الـ Worker فيختار نموذجًا ذا قدرة استدلال أقوى بحسب تعقيد المهمة. ويدعم النموذج الأولي أيضًا تحديد مزوّد النموذج والنموذج لكل من الـ Router والـ Worker على حدة.
فيما يلي مثال مبسط يستخدم واجهة متوافقة مع OpenAI لتمكين الـ Router من اتخاذ قرار التوزيع:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口,一个 Key 切换多家模型
)

ROUTER_MODEL = "your-fast-cheap-model"   # 替换为控制台中可用的轻量模型名

resp = client.chat.completions.create(
    model=ROUTER_MODEL,
    messages=[{"role": "user", "content": "判断这条 Issue 评论是否需要新建 Ticket:修复登录页 500 错误"}]
)
print(resp.choices[0].message.content)
عرض مثال برمجي لاستدعاء النماذج في طبقتي Router وWorker
import json
import openai
from typing import Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 角色与模型分层:模型名请替换为你实际可用的模型
ROLE_MODELS: Dict[str, str] = {
    "router": "your-fast-cheap-model",
    "worker_simple": "your-mid-tier-model",
    "worker_complex": "your-strong-reasoning-model",
}

usage_log = []  # 按 Ticket 记录 Token 消耗

def call(role: str, ticket_id: str, prompt: str) -> str:
    resp = client.chat.completions.create(
        model=ROLE_MODELS[role],
        messages=[{"role": "user", "content": prompt}],
    )
    u = resp.usage
    usage_log.append({
        "ticket": ticket_id, "role": role,
        "input": u.prompt_tokens, "output": u.completion_tokens,
    })
    return resp.choices[0].message.content

def router_dispatch(ticket_id: str, event: str) -> str:
    prompt = (
        "你是任务调度器,只做分类,不执行任务。"
        "输出 JSON:{\"accept\": bool, \"complexity\": \"simple\"|\"complex\"}\n"
        f"事件:{event}"
    )
    decision = json.loads(call("router", ticket_id, prompt))
    if not decision["accept"]:
        return "ignored"
    role = "worker_complex" if decision["complexity"] == "complex" else "worker_simple"
    return call(role, ticket_id, f"在授权范围内处理任务:{event}")

print(router_dispatch("T-001", "CI 失败:单元测试 test_login 超时"))
print(usage_log)
🎯 نصيحة تقنية: عند بناء بنية وكلاء متعددة الطبقات، يُنصح أولًا باستخدام مفتاح API واحد عبر APIYI على apiyi.com لاختبار أداء النماذج الخفيفة ونماذج الاستدلال القوية في دورَي Router وWorker. بعد ذلك، حدّد الإعداد النهائي لتتجنب استخدام أغلى نموذج في جميع الأدوار.
ضبط التكاليف: المحاسبة حسب كل Ticket بدلًا من الاكتفاء بالإجمالي
تُظهر التجارب الرسمية أن البنية ثنائية الطبقات تستهلك موارد استدلال أكثر، لذا تحتاج إدارة التكلفة إلى مستوى أدق من المتابعة. ومن الممارسات المفيدة:
- تسجيل الرموز لكل Ticket: افصل بين تكلفة قرارات Router وتكلفة تنفيذ Worker لتحديد أنواع المهام الأعلى تكلفة؛
- التفريق بين أنواع النفقات: احسب تكاليف النماذج والأدوات، مثل البحث وجلب صفحات الويب، وبيئة التنفيذ كلًا على حدة؛
- متابعة إصابات ذاكرة التخزين المؤقت: تأتي الحصة الأكبر من رموز Super-agent من قراءات ذاكرة التخزين المؤقت، وقد يكون الفرق كبيرًا بين سعر القراءة عند الإصابة وسعرها عند عدم الإصابة. فعلى سبيل المثال، يبلغ الفرق بين السعرين في أسعار DeepSeek الرسمية عشرات الأضعاف؛
- تقليل القرارات غير الضرورية: استفد من فكرة الاشتراك المباشر لتوجيه الأحداث اللاحقة إلى Worker المسؤول مباشرةً، بدلًا من تكرار توزيعها عبر Router.
💰 تحسين التكاليف: يعني تشغيل عدة Workers بالتوازي أن عدد الاستدعاءات قد يتضاعف. وباستخدام APIYI على apiyi.com لاستدعاء نماذج من مزودين مختلفين بنظام الدفع حسب الاستخدام، يمكنك مقارنة التكاليف الفعلية للأدوار والنماذج المختلفة في فاتورة واحدة، مما يسهّل تحسين التكاليف على مستويات مختلفة.
متى يستحق اعتماد Router + Worker؟
ليس التعقيد هدفًا بحد ذاته في البنية ثنائية الطبقات. يمكن الاستعانة بالمعايير التالية:
- مناسب للاعتماد: عند وجود عدة مهام مستقلة في الوقت نفسه، مثل إصلاح خطأ في التذكرة A، ومراجعة ترحيل في التذكرة B، ومعالجة CI في التذكرة C، مع ورود الأحداث من قنوات متعددة والحاجة إلى الاستجابة المستمرة؛
- يمكن تأجيله: إذا كان عدد المهام قليلًا، أو كانت شديدة الترابط، أو كان العمل يدور أساسًا حول تقسيم مهمة معقدة واحدة، فإن وكيلًا واحدًا أو فريق وكلاء تقليديًا يكون أقل استهلاكًا للموارد؛
- تحتاج البنية التحتية إلى استكمال أولًا: إذا لم يكن عزل الصلاحيات، ومعالجة تعارضات تعديل الملفات، وسجلات احتساب التكلفة لكل مهمة جاهزًا بعد، فقد يؤدي التسرع في تنفيذ المهام بالتوازي إلى زيادة المخاطر بدلًا من تقليلها.
من المهم أيضًا ملاحظة أن Router + Worker يركز على جانب مختلف عن فريق الوكلاء التقليدي. فعادةً ما يقسم فريق الوكلاء مهمة معقدة واحدة بين أدوار مثل البحث والبرمجة والاختبار، بينما يركز Router في نظام Super-agent على التنسيق بين مهام مستقلة متعددة، من دون التعمق في التفاصيل التقنية لكل منها. ووفقًا للتوضيح الرسمي، يمكن الوصول إلى بنية مشابهة إذا اقتصرت الجلسة الرئيسية لفريق وكلاء تقليدي على توحيد التفاعل وتوزيع المهام؛ فالبنية ثنائية الطبقات ليست مفهومًا حصريًا لـ DeepSeek.
حدود بنية Router + Worker وحدود النموذج الأولي
من السهل عند تحليل مثل هذه البنى الخلط بين المخطط الكامل في مقال التصميم والوظائف المتاحة فعليًا في النموذج الأولي مفتوح المصدر. لذا من المهم التمييز وفقًا للمصادر بين ما يلي:
- ما يدعمه النموذج الأولي بالفعل: مراقبة مستودع GitHub واحد، والاتصال الاختياري بـ Feishu، وإدارة التذاكر، وجلسات ومجلدات مستقلة لكل Worker، وإنشاء طلبات سحب (PR)، وعرض المهام التي تحتاج إلى تدخل بشري في لوحة الإدارة، ومواصلة العمل بناءً على الرسائل اللاحقة؛
- ما ورد في التصميم دون إثبات اكتمال تنفيذه: الإدارة التلقائية لمستودعات متعددة، والتشغيل السحابي المستمر على مستوى الإنتاج، وبيئات العمل عبر الأجهزة، والإصلاح الذاتي المستقل الكامل باستخدام Watchdog. أما حلقة ReAct غير المتزامنة فقد نُفذت في Harness، لكنها لم تُفعّل افتراضيًا بعد؛
- حدود المبادرة الذاتية: تستخدم المهام المستنتجة وضع
observeافتراضيًا، فتُسجّل دون تنفيذها؛ كما أن الدمج التلقائي لطلبات السحب معطّل افتراضيًا.
لا تزال هناك عدة تحديات معترف بها علنًا على مستوى البنية. أولها توسيع Router واحد؛ إذ يكتفي الفريق الرسمي بالقول إنه مناسب لحجم الفريق الحالي، دون إجابة بعد عن كيفية تقسيم العمل على نطاق أكبر. والثاني هو الذاكرة طويلة الأمد؛ فآليتا Inline & Spill والاسترجاع المتسلسل تعالجان سياق المدى القصير والمتوسط، لكن الذاكرة الممتدة عبر أشهر لم تُحل بعد. والثالث هو حدود الصلاحيات؛ إذ يعمل Router وWorker بالإعدادات الافتراضية في وضع danger-full-access، وينفذان المهام افتراضيًا بهوية مستخدم النظام الذي يشغّلهما، ولذلك يوصي الفريق الرسمي باستخدام مستخدم نظام مستقل. كما أُدرج حقن الموجهات عبر التعليقات الخارجية وإدارة بيانات الاعتماد ضمن المشكلات التي لم تُحل بعد. وظهر في المجتمع أيضًا تقرير تدقيق خارجي للشيفرة المصدرية يستهدف commit محددًا، لكن عملية الهجوم الكاملة لم يُعَد إنتاجها بشكل مستقل، لذا لا يمكن التعامل معها إلا بوصفها خطرًا محتملًا.
وتؤكد التجارب العملية للمجتمع أن المشروع لا يزال نموذجًا أوليًا: فقد نجح أحد المستخدمين في تنفيذ العملية كاملة، من Issue إلى PR، بعد استنساخ جديد للمستودع واتباع SETUP.md. لكنه أبلغ أيضًا عن مشكلات في التعرف على عمليات Node.js 24، وفوات رسائل بسبب تأخر إشعارات GitHub، وفشل تأكيدات الاختبارات عندما تكون لغة النظام الصينية.
الأسئلة الشائعة FAQ
س1: ما هي بنية Router + Worker ذات الطبقتين؟
هي البنية الأساسية لـ DeepSeek Super-agent: يعمل Router كطبقة تنسيق عامة ودائمة، تستقبل الأحداث وتحافظ على ترابط المهام وتوزّع العمل؛ بينما يعمل Worker كطبقة تنفيذ معزولة، حيث تُنجز كل تذكرة (Ticket) في جلسة (Session) ودليل مستقلين. الفكرة الأساسية هي الفصل بين التنسيق العام والتنفيذ المستقل.
س2: ما الفرق بين Router + Worker وفريق الوكلاء التقليدي متعدد الوكلاء؟
عادةً ما يوزّع فريق الوكلاء التقليدي مهمة معقدة على أدوار مثل البحث والبرمجة والاختبار. أما Router + Worker فيركّز أكثر على التنسيق بين مهام مستقلة عن بعضها، من دون أن يتعمق Router في تفاصيل كل مهمة. وإذا اقتصرت الجلسة الرئيسية في الفريق التقليدي على توحيد التفاعل وتوزيع العمل بين المهام، فيمكن أن تتكوّن بنية مشابهة ذات طبقتين.
س3: هل تثبت التجربة الرسمية أن Super-agent يرفع كفاءة البرمجة بنسبة 47%؟
لا. استخدمت التجربة أدوات برمجة محاكاة، وشُغّل كل أسلوب 5 مرات فقط. كما قاست زمن إكمال جدولة المهام، لا جودة الشفرة أو القدرة على البرمجة. وانخفاض المئين 95 (P95) بنحو 47% يعني فقط أن أزمنة الجدولة الطويلة كانت أقصر في ظل حمل العمل الاصطناعي هذا. ولا يمكن تعميم النتيجة على كفاءة البرمجة الفعلية أو استخدامها لمقارنة قدرات البرمجة مع Claude Code وCodex.
س4: هل يوفّر Router + Worker المال؟
ليس بالضرورة. في التجربة الاصطناعية الرسمية، كان حجم قراءات ذاكرة التخزين المؤقت لدى Super-agent نحو 3.8 أضعاف حجمها في أسلوب الجلسة الواحدة المحايد؛ أي إنه يستخدم موارد أكثر مقابل السرعة والاستقرار. وتكمن فرصة خفض التكلفة في توزيع النماذج بحسب الدور: استخدام نموذج خفيف لـ Router، واختيار نموذج Worker بحسب درجة التعقيد. ويمكن عبر APIYI apiyi.com اختبار التكلفة الفعلية لتركيبات النماذج المختلفة باستخدام واجهة موحدة، ثم اختيار الأنسب.
س5: كيف أتحقق سريعًا من توزيع النماذج بين Router وWorker في مشروعي؟
نقترح اتباع الخطوات التالية:
1. سجّل حسابًا في APIYI apiyi.com للحصول على مفتاح API ورصيد اختبار مجاني؛
2. استخدم الشفرة الواردة في هذا المقال، واضبط base_url على `https://api.apiyi.com/v1`؛
3. اضبط نموذجًا مختلفًا لكل من Router وWorker، وسجّل استهلاك الرموز (Token) لكل تذكرة (Ticket) وقارن النتائج.
وتعني الواجهة المتوافقة مع OpenAI أن تبديل النموذج لا يتطلب سوى تعديل المعامل model.
س6: هل يمكن استخدام النموذج الأولي مفتوح المصدر مباشرةً في بيئة إنتاج مؤسسية؟
لا يُنصح حاليًا باستخدامه مباشرةً في بيئة الإنتاج. فهو نموذج أولي بحثي، ويعمل Worker افتراضيًا بهوية المشغّل وصلاحيات مرتفعة، كما أنه لا يدعم GitHub Enterprise Server. وأبلغ المجتمع أيضًا عن عيوب، مثل فقدان بعض الإشعارات، ومشكلات أمنية محتملة. والأفضل استخدامه للتحقق من تصميم سير العمل في بيئة معزولة.
أبرز النقاط في بنية Router + Worker
- الفكرة الأساسية: الـSuper-agent بنية نظام تتجاوز النموذج نفسه، وما أُتيح مفتوح المصدر هو نموذج بحثي أولي، وليس منتجًا تجاريًا؛
- جوهر المشكلة: انتقل عنق الزجاجة من قدرات النموذج إلى انتباه الإنسان؛ فالجلسة الواحدة قد «تختنق»، بينما تتسبب الجلسات المتعددة في تشتت العمل؛
- فصل المسؤوليات: يتولى Router التنسيق العام فقط، وقد يُستغنى حتى عن تزويده بأداة Bash، بينما ينفذ كل Worker مهامه بصورة مستقلة في جلسة معزولة؛
- الآليات الأساسية: يخفف التمرير المباشر للاشتراكات عبء اتخاذ القرارات عن Router، وتوزع المعالجة الدفعية تكلفة الاستدلال، بينما تتعامل آلية Inline & Spill مع السياق بوصفه ذاكرة تخزين مؤقت؛
- حدود البيانات: أظهرت تجارب الجدولة انخفاضًا في زمن إكمال المهام المتأخرة، مقابل استهلاك أكبر للرموز، لكنها لا تقيس القدرة على البرمجة؛
- طريقة البدء: يمكن استخدام واجهة APIYI الموحدة على apiyi.com لإعداد نماذج مختلفة لكل دور، وإدارة التكلفة بحسب التذكرة (Ticket).
الخلاصة
استخدمت DeepSeek بنية Router + Worker للإجابة عن سؤال: «لماذا لا ينبغي أن يقتصر وكيل الذكاء الاصطناعي على جلسة واحدة؟»
- قيمة البنية: تفصل بين التنسيق العام والتنفيذ المستقل، بحيث يحتفظ النظام بالعلاقات بين المهام بدلًا من أن يضطر الإنسان إلى تذكرها؛
- التصميم الهندسي: تعالج آليات التمرير المباشر للاشتراكات، والمعالجة الدفعية، وInline & Spill، والاسترجاع المتسلسل، على التوالي، مشكلات الحمل على المركز، والتعامل مع الارتفاع المفاجئ في الطلب، وسعة السياق، واسترجاع السجل السابق؛
- نظرة واقعية: تثبت التجارب وجود مفاضلة بين كفاءة الجدولة واستهلاك الموارد، لكن قابلية توسيع Router واحد، والذاكرة طويلة الأمد، وعزل الصلاحيات، لا تزال تحديات تنتظر الحل.
إذا كان نظامك يحتاج بالفعل إلى معالجة عدة مهام مستقلة في الوقت نفسه، فتستحق البنية ذات الطبقتين التجربة. أما إذا كانت المهام قليلة ومركزة، فقد يظل الوكيل الواحد خيارًا أكثر اقتصادية. وأيًا كانت البنية، فإن توزيع الأدوار على نماذج بمستويات مختلفة وتتبع تكلفة كل مهمة عنصران أساسيان للتحكم في التكاليف.
يمكنك استخدام APIYI على apiyi.com لاختبار أداء النماذج المختلفة سريعًا في دورَي Router وWorker. وتوفر المنصة واجهة متوافقة مع OpenAI، وفوترة حسب الاستخدام، ورصيدًا مجانيًا للمستخدمين الجدد للتجربة.
📚 المراجع
- مقال DeepSeek الرسمي عن البنية: استكشاف تصميم Super-agent: نحو أنظمة وكلاء أكثر استقلالية
- الرابط:
x.com/DeepSeekHarness/article/2116857257245987236 -
الوصف: المصدر الأصلي للبنية ذات الطبقتين، والوحدات الخمس، وبيانات التجارب، والمسائل التي لم تُحل بعد
-
مستودع DeepSeek الرسمي على GitHub: dsh-superagent-prototype
- الرابط:
github.com/deepseek-ai/dsh-superagent-prototype -
الوصف: حالة المشروع، والشفرة المصدرية، والترخيص، ونطاق الاستخدام الحالي
-
وثيقة نموذج المجال مفتوح المصدر: كائنات المهام ونموذج سير العمل
- الرابط:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/001-domain.md -
الوصف: تعريف المفاهيم الأساسية مثل Source وTrigger وTicket وAssignment
-
وثيقة التفويض والاشتراك: قواعد التفويض (Mandate) والاشتراك في سلاسل المحادثات (Thread)
- الرابط:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/002-authorization.md -
الوصف: التوضيح الرسمي بأن الاشتراك في الرسائل لا يوسّع نطاق التفويض
-
وثيقة النشر: التبعيات والحسابات وإرشادات الأمان
- الرابط:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/006-deployment.md -
الوصف: وضع التشغيل بصلاحيات مرتفعة والتوصية باستخدام حساب نظام مستقل
-
التسعير الرسمي لـ DeepSeek API: أسعار النماذج والأدوات
- الرابط:
api-docs.deepseek.com/quick_start/pricing - الوصف: الفرق بين أسعار البيانات الموجودة في ذاكرة التخزين المؤقت وغير الموجودة فيها، ومرجع لتقدير التكاليف
الكاتب: الفريق التقني في APIYI
للتواصل التقني: تواصلوا معنا عبر الصفحة الرئيسية لموقع APIYI على apiyi.com لمناقشة بنية الوكلاء وممارسات استدعاء النماذج المتعددة. وللمزيد من الموارد، تفضلوا بزيارة مركز التوثيق على docs.apiyi.com