ملاحظة الكاتب: توجد عروض تجريبية عامة لكل من Fable 5.5 وGPT-6.2 Astra، لكنها لا تقارن بينهما في المهمة نفسها. تستعرض هذه المقالة مستويات الأدلة في 6 عروض تجريبية، وتقارن المواصفات والأسعار الرسمية للنموذجين الرائدين المتاحين حاليًا، Fable 5.1 وGPT-6 Astra، وتقدم طريقة تقييم قابلة لإعادة التشغيل لاختيار النموذج المناسب.
الخلاصة أولًا: لا توجد إجابة حاليًا عن سؤال أيهما أقوى، Fable 5.5 أم GPT-6.2 Astra. لم يُطرح أي من النموذجين رسميًا بعد. وحتى 2026-11-03، كان كتالوج نماذج Anthropic لا يزال يعرض Fable 5.1، فيما كان كتالوج OpenAI لا يزال يعرض GPT-6 Astra (المصدر: صفحات النماذج الرسمية للشركتين، مستوى الدليل: توثيق رسمي). نُشرت العروض التجريبية لكليهما على موقع الاختبار المستقل Model Tests بواسطة @notjazii، لكنها لا تنفذ المهمة نفسها. لدى Fable 5.5 خمسة أعمال تشمل لعبة وفيلمًا قصيرًا وأعمال SVG وWebGL، بينما لا يوجد لـGPT-6.2 Astra سوى رسم متحرك واحد بتقنية فن البكسل بصيغة GIF. ومع اختلاف المهام، لا يمكن الحديث عن فائز.
لذلك، لا ترتب هذه المقالة النموذجين، بل تجيب عن ثلاثة أسئلة: ما الذي تثبته هذه العروض وما الذي لا تثبته؟ وما الفروق في المواصفات الرسمية بين Fable 5.1 وGPT-6 Astra اللذين يمكن مقارنتهما الآن؟ وكيف نُعد مجموعة تقييم خاصة من 20 إلى 50 مهمة، يمكن إعادة تشغيلها بمجرد تغيير اسم النموذج عند طرح النماذج الجديدة؟ أما الشائعات الأخرى، مثل Mythos 5.5 وGemini 4 Carbon، فلن نتوسع فيها هنا.
هذه ليست مقالة توفيقية تكتفي بالقول إن لكل نموذج مزاياه. سنوضح مباشرة أين لا تكفي الأدلة، ونقدم توصيات واضحة حيث يمكن إصدار حكم.
قائمة العروض التجريبية العامة لـ Fable 5.5 وGPT-6.2 Astra
الخلاصة: تُظهر العروض أن النموذجين قادران على إنتاج أعمال قابلة للتشغيل، لكن اختلاف المهام وعدد الأعمال ومستويات النماذج يمنع المقارنة المباشرة بينهما.
يضم موقع Model Tests إجمالاً 11 مشروعًا و8 نماذج، مع تحديد التاريخ والنموذج والنوع لكل عمل (المصدر: صفحات الموقع، مستوى الدليل: معلومات يذكرها أفراد المجتمع). يجمع الجدول أدناه الأعمال الستة المنسوبة إلى Fable 5.5 وGPT-6.2 Astra. وجميع نسب الأعمال إلى النماذج مبنية على ما يذكره أصحابها.
| العمل | النموذج وفقًا للمؤلف | النوع | التاريخ | أبرز التفاصيل |
|---|---|---|---|---|
| VoxelCraft | Fable 5.5 xhigh | لعبة HTML قابلة للعب | 2026-11-01 | نسخة من Minecraft في ملف واحد، تتضمن وضعي البقاء والإبداع، والتصنيع، والأفران، والسحر، والريدستون، والقرويين، ومناطق حيوية متعددة، وعالمَي Nether وEnd |
| The Last Page | Fable 5.5 xhigh | فيلم قصير مدته 66 ثانية مع صوت | 2026-11-02 | ثعلب، ومكتبة في ضوء القمر، وعاصفة من صفحات الكتب، وتحليق نحو السحب |
| Open Me | Fable 5.5 xhigh | تجربة تفاعلية باستخدام WebGL | 2026-11-02 | تقنية raymarching باستخدام WebGL2 مع موسيقى توليدية، وتتطلب وحدة معالجة رسومات منفصلة |
| Acorn Bread on a Stick | Fable 5.5 xhigh | رسم SVG مكتوب يدويًا | 2026-11-02 | رسم توضيحي لخبز من البلوط على عصا |
| Fruit Basket | Fable 5.5 max | طبيعة صامتة برسوم متجهية خالصة | 2026-11-02 | سلة فواكه واقعية بدقة 3000×2400، دون صور نقطية |
| Tsukimi Moon Ferry | GPT 6.2 Astra Max | صورة GIF متحركة بأسلوب البكسل | 2026-11-02 | بلدة يابانية على ضفة نهر تحت اكتمال القمر، تضم قلعة وجبل فوجي وجسرًا أحمر وأسماك شبوط طائرة وفوانيس عائمة وعبّارة |
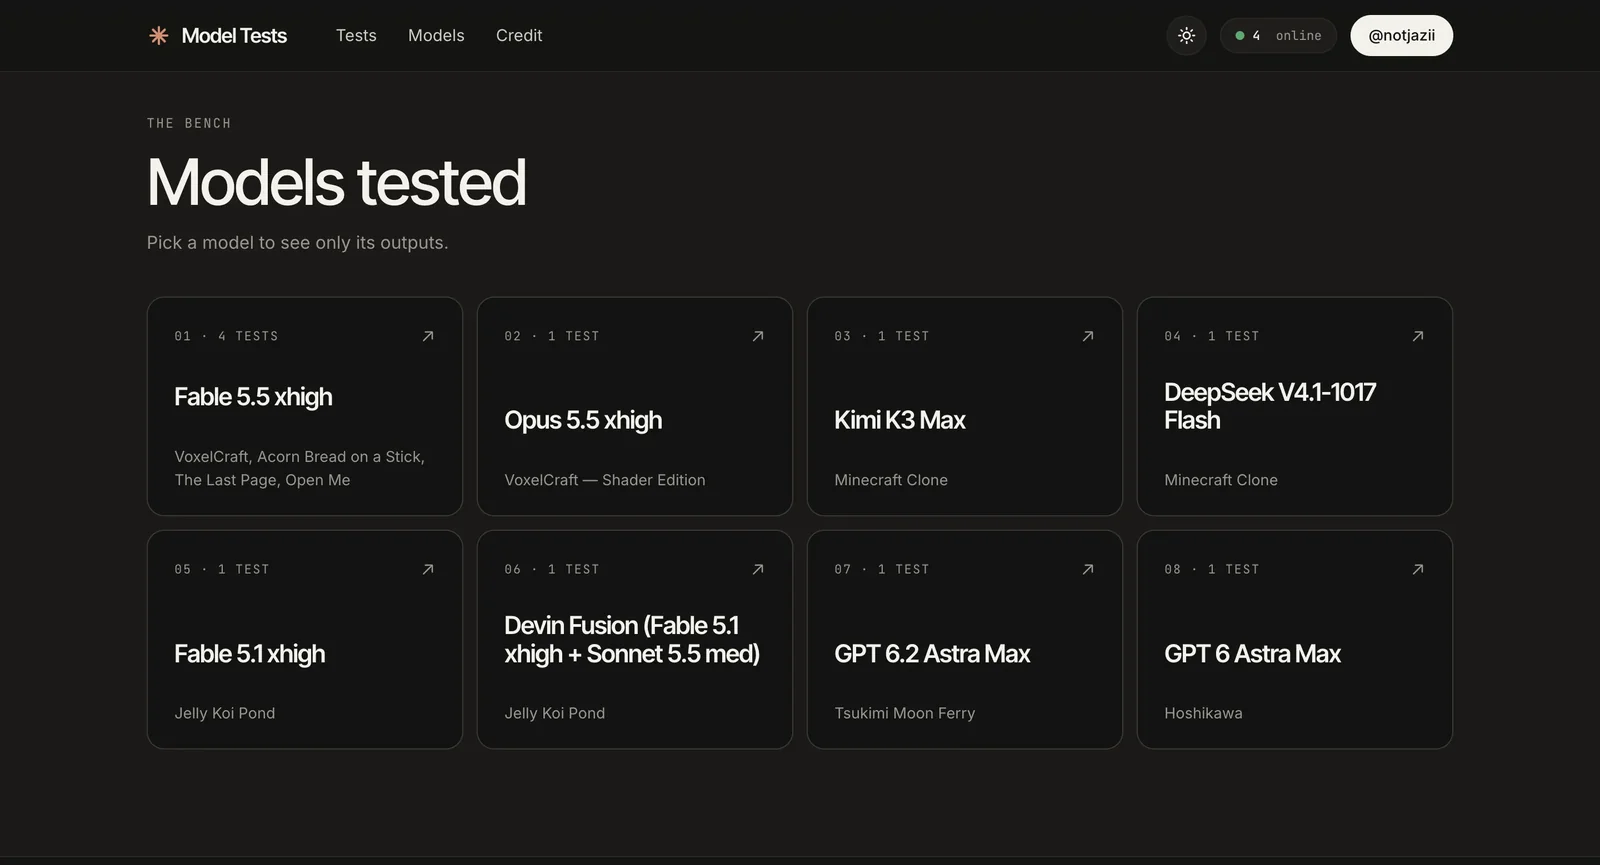
توضيح الصورة: قائمة النماذج في Model Tests. توجد 4 اختبارات منسوبة إلى Fable 5.5 xhigh، واختبار واحد فقط لكل من GPT-6.2 Astra Max وGPT-6 Astra Max (لقطة شاشة بتاريخ 2026-11-03).
يضم الموقع أيضًا أعمالًا يمكن الاستعانة بها للمقارنة. يُنسب عمل Hoshikawa إلى GPT 6 Astra Max، وهو أيضًا رسم بكسل متحرك لبلدة يابانية تحت اكتمال القمر (2026-11-02). ويشبه أسلوبه عمل Tsukimi Moon Ferry، ما يجعله المقارنة الوحيدة على الموقع بين إصدارين قديم وجديد من OpenAI بمهمة متقاربة. أما VoxelCraft — Shader Edition، المنسوب إلى Opus 5.5 xhigh (2026-11-01)، فيتناول المهمة نفسها التي يعالجها عمل VoxelCraft المنسوب إلى Fable 5.5. كذلك أنجز كل من Kimi K3 Max وDeepSeek V4.1-1017 Flash نسخة من Minecraft (2026-10-17).
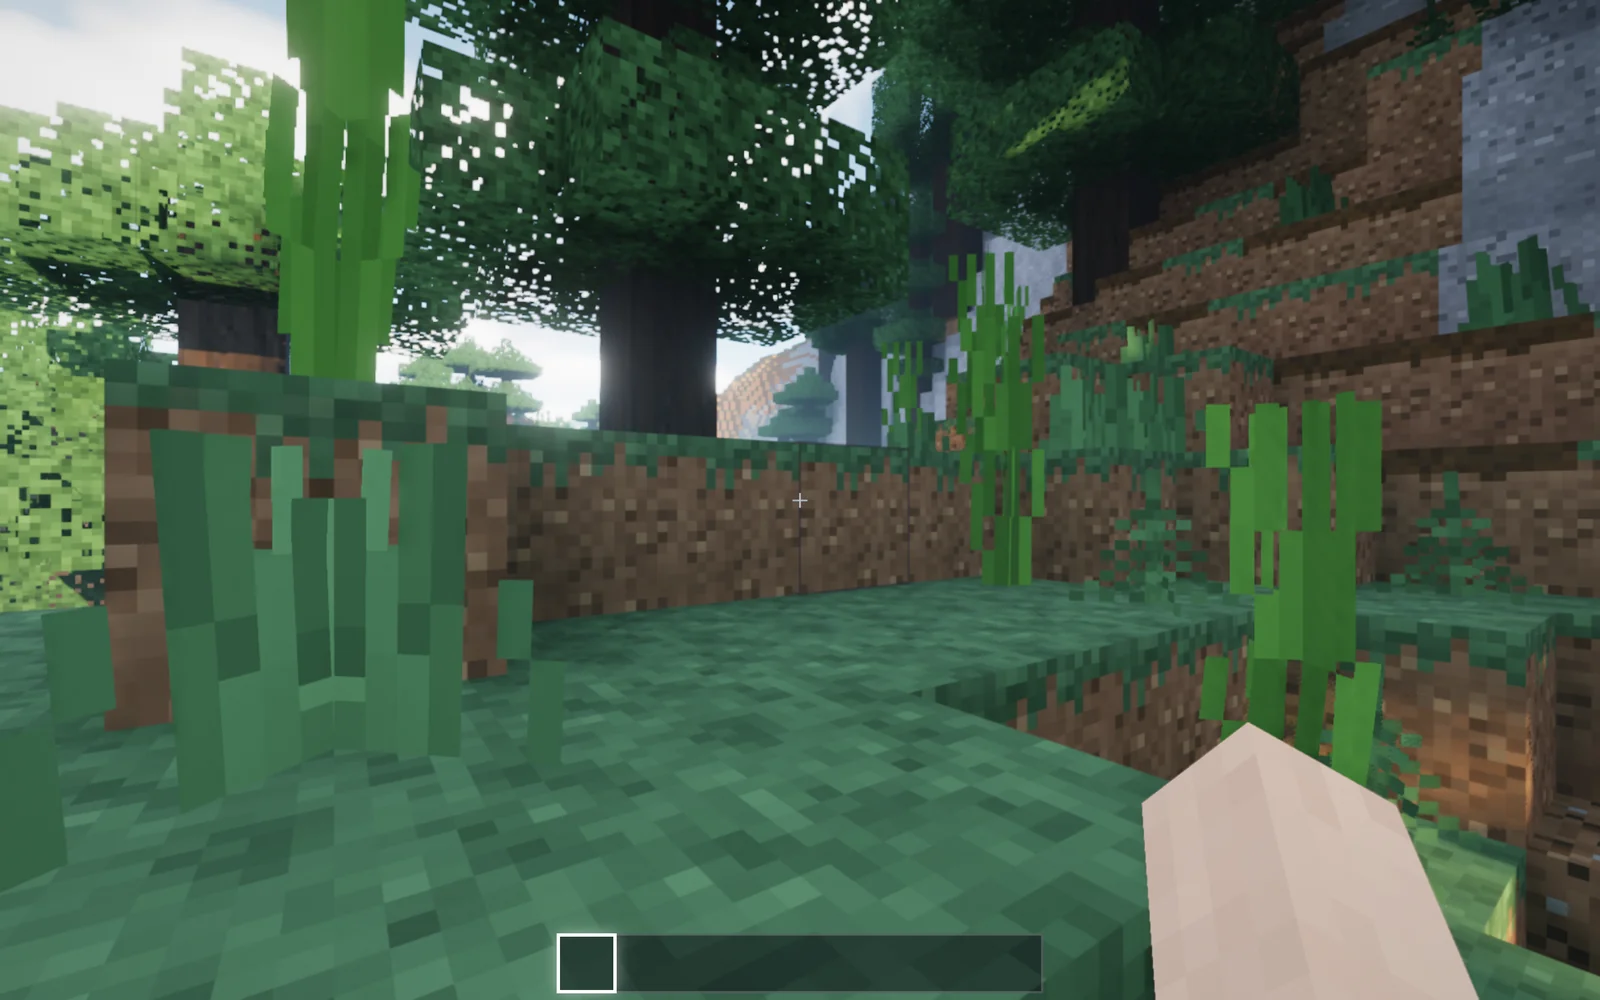
تعليق الصورة: VoxelCraft من Fable 5.5 xhigh، نسخة من «ماينكرافت» في ملف واحد، يمكن بدء اللعب بمجرد فتحها (لقطة شاشة بتاريخ 2026-11-03).
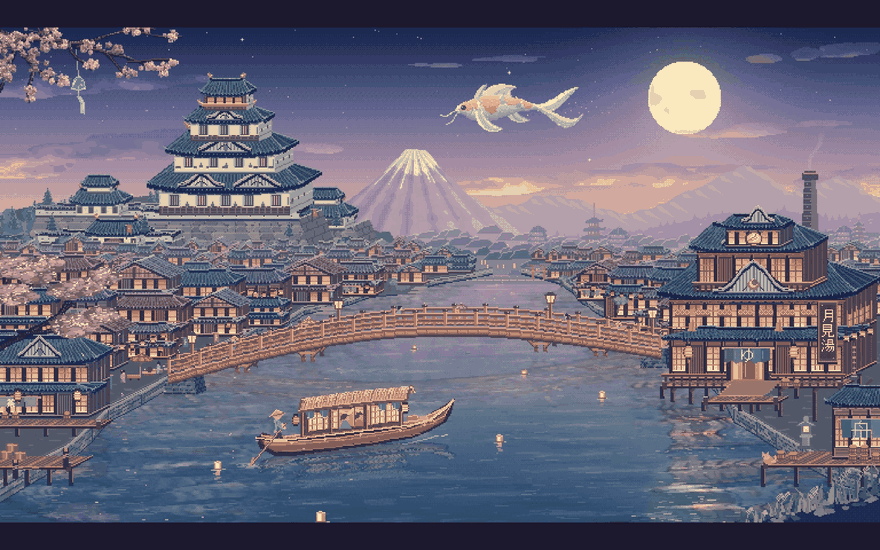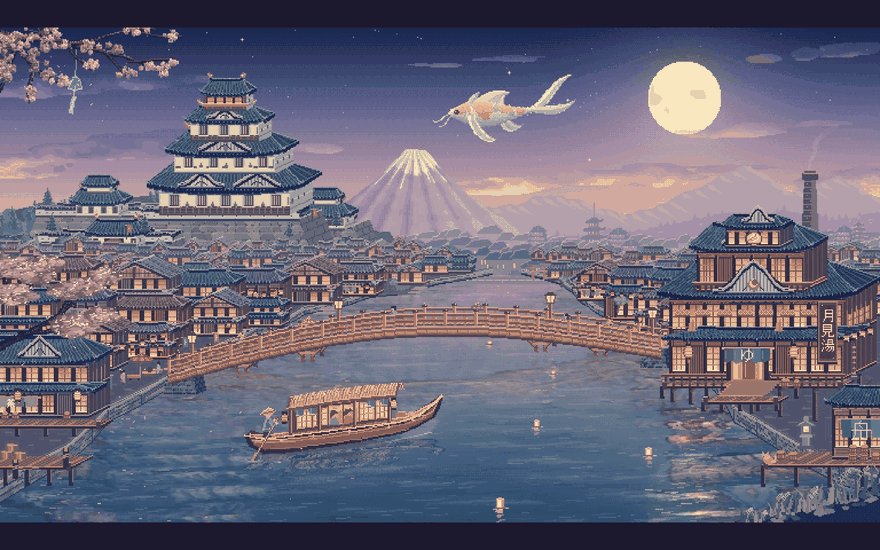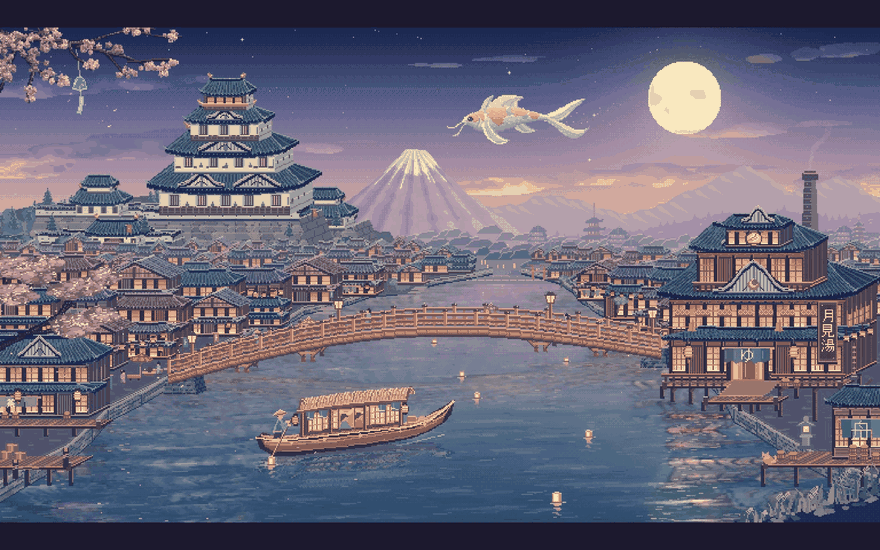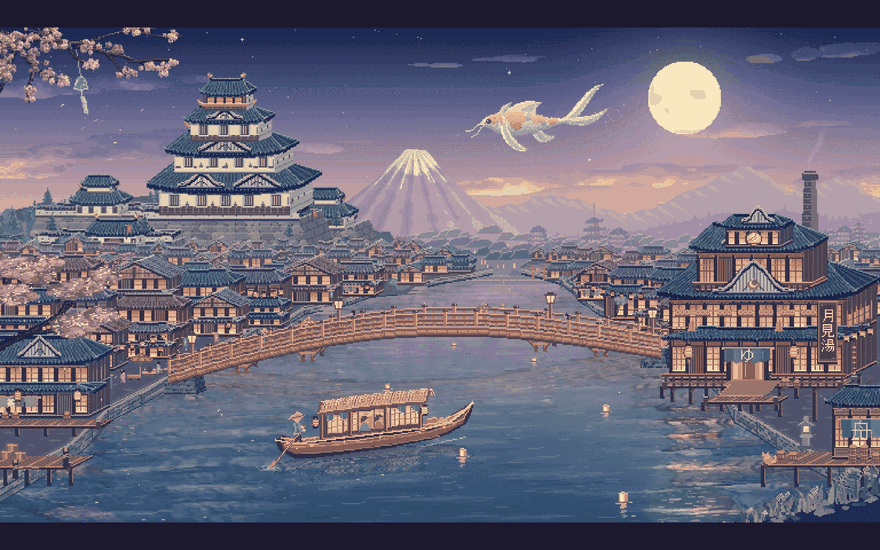
تعليق الصورة: Tsukimi Moon Ferry من GPT-6.2 Astra Max، رسوم متحركة بتقنية البكسل بصيغة GIF، تصوّر بلدة نهرية يابانية تحت البدر (تسجيل شاشة بتاريخ 2026-11-03).
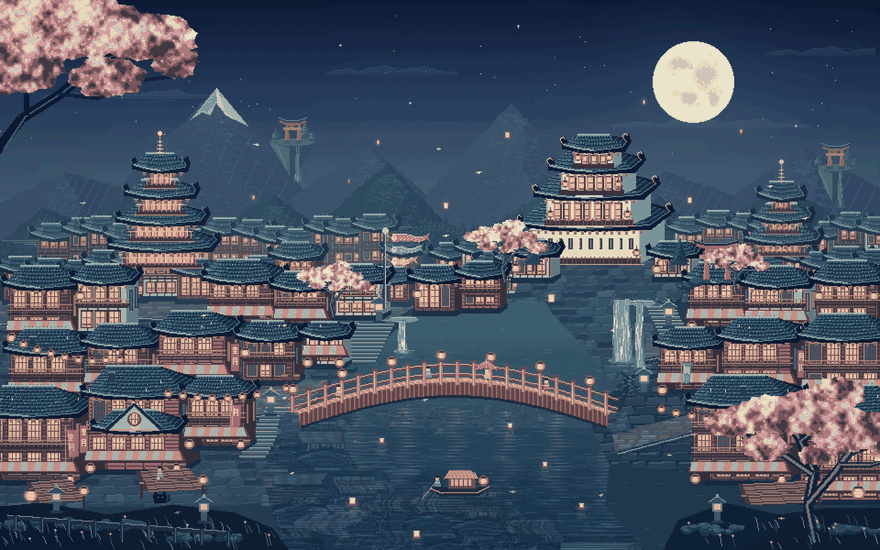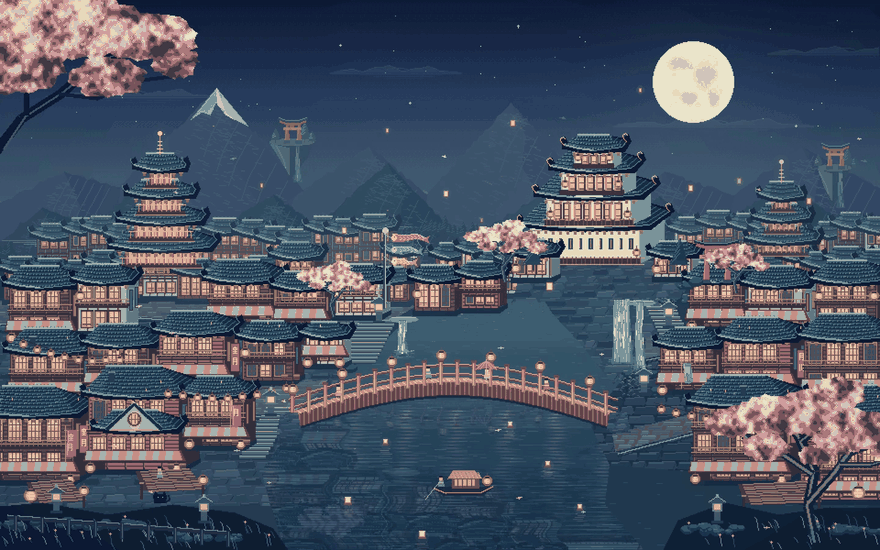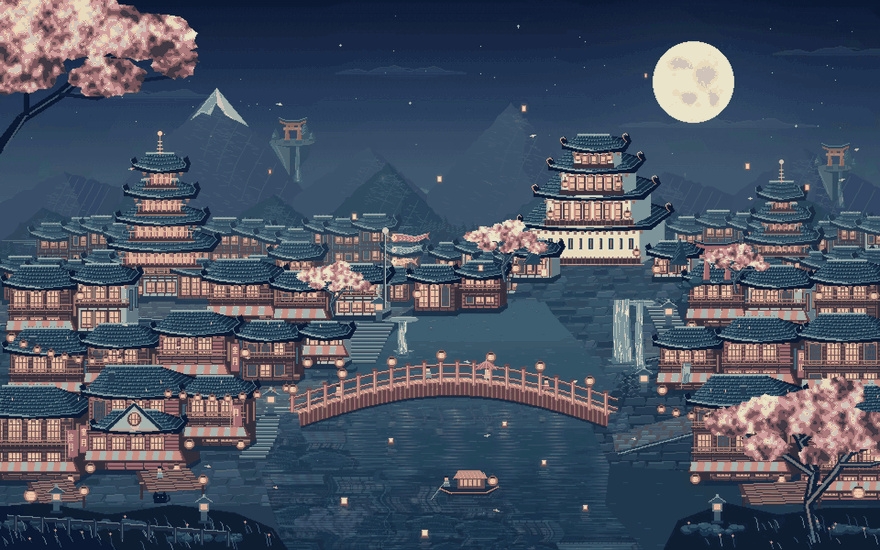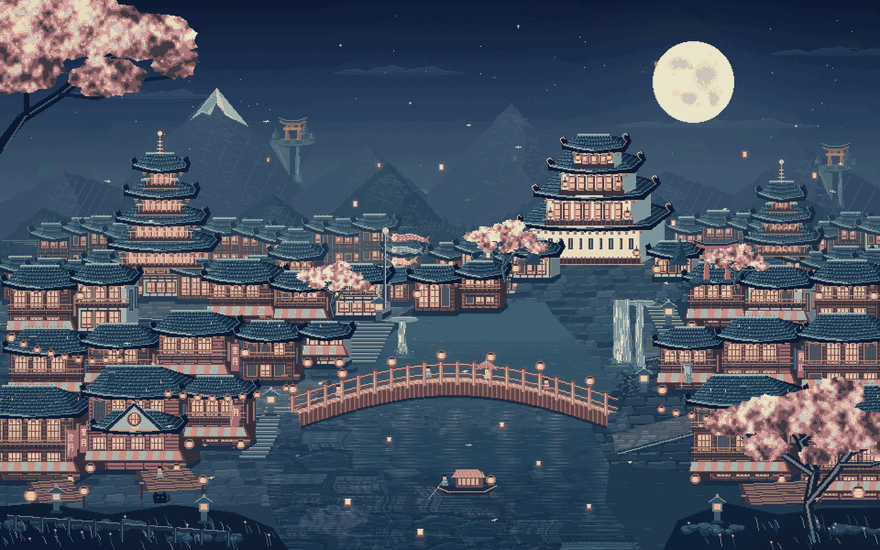
تعليق الصورة: للمقارنة، Hoshikawa من GPT-6 Astra Max، من الموقع نفسه وبالأسلوب نفسه، للمقارنة مع رسوم البكسل المتحركة في 6.2 (تسجيل شاشة بتاريخ 2026-11-03).
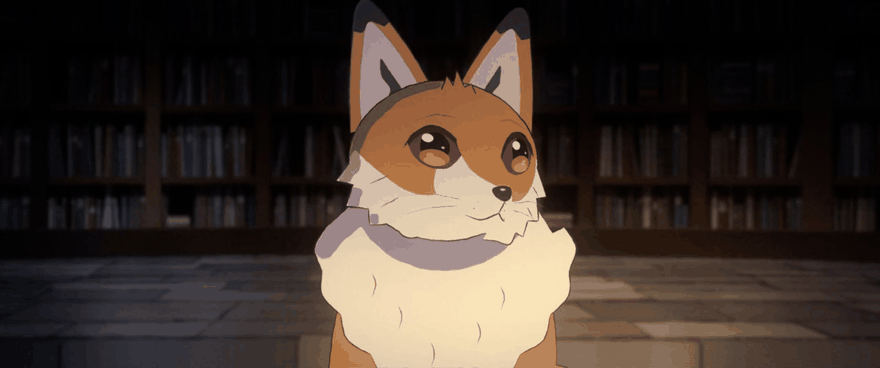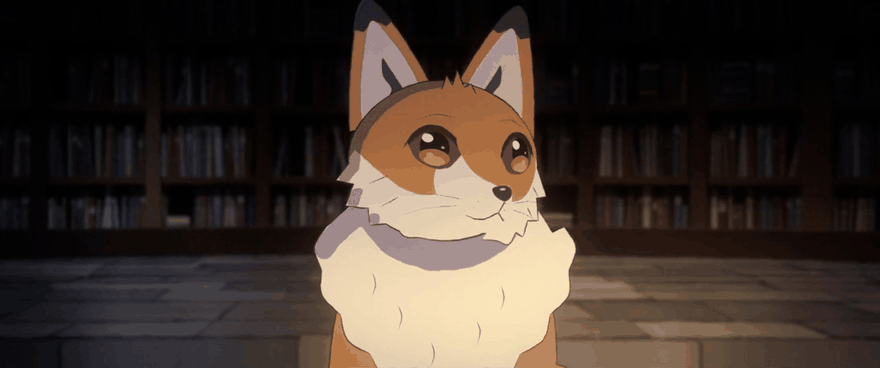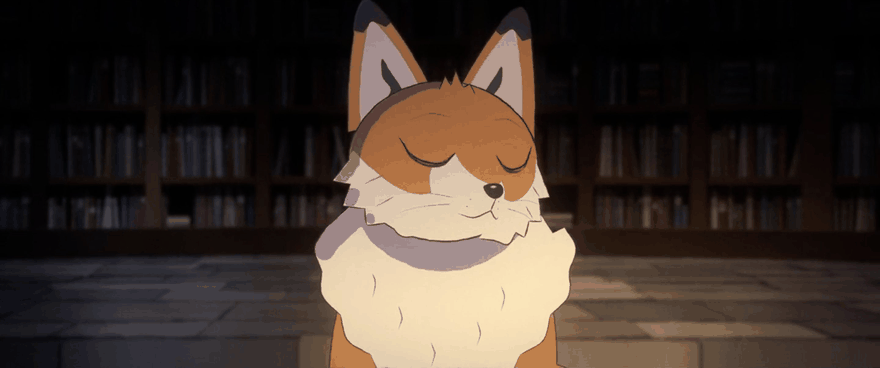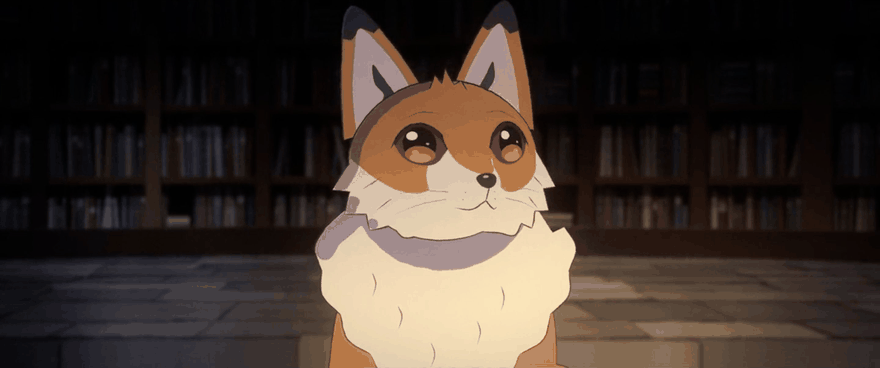
تعليق الصورة: مقطع من The Last Page، وهو فيلم قصير مدته 66 ثانية مع صوت من Fable 5.5 xhigh، يظهر فيه ثعلب في مكتبة مضاءة بضوء القمر (مقتطف GIF بتاريخ 2026-11-03، بلا صوت).
العمل الوحيد على الموقع الذي يذكر التكلفة والوقت المستغرق هو Jelly Koi Pond. استغرقت نسخة Fable 5.1 xhigh نحو ساعة و40 دقيقة بتكلفة $25؛ أما مزيج Devin Fusion (Fable 5.1 xhigh مع Sonnet 5.5 med) فاستغرق نحو ساعة بتكلفة $11 (التاريخ 2026-10-21، مستوى الدليل: إفادة من المجتمع). بخلاف ذلك، لم يُعلن الوقت أو التكلفة لأي عمل آخر على الموقع، ولا تقدم هذه المقالة تقديرات لهما.
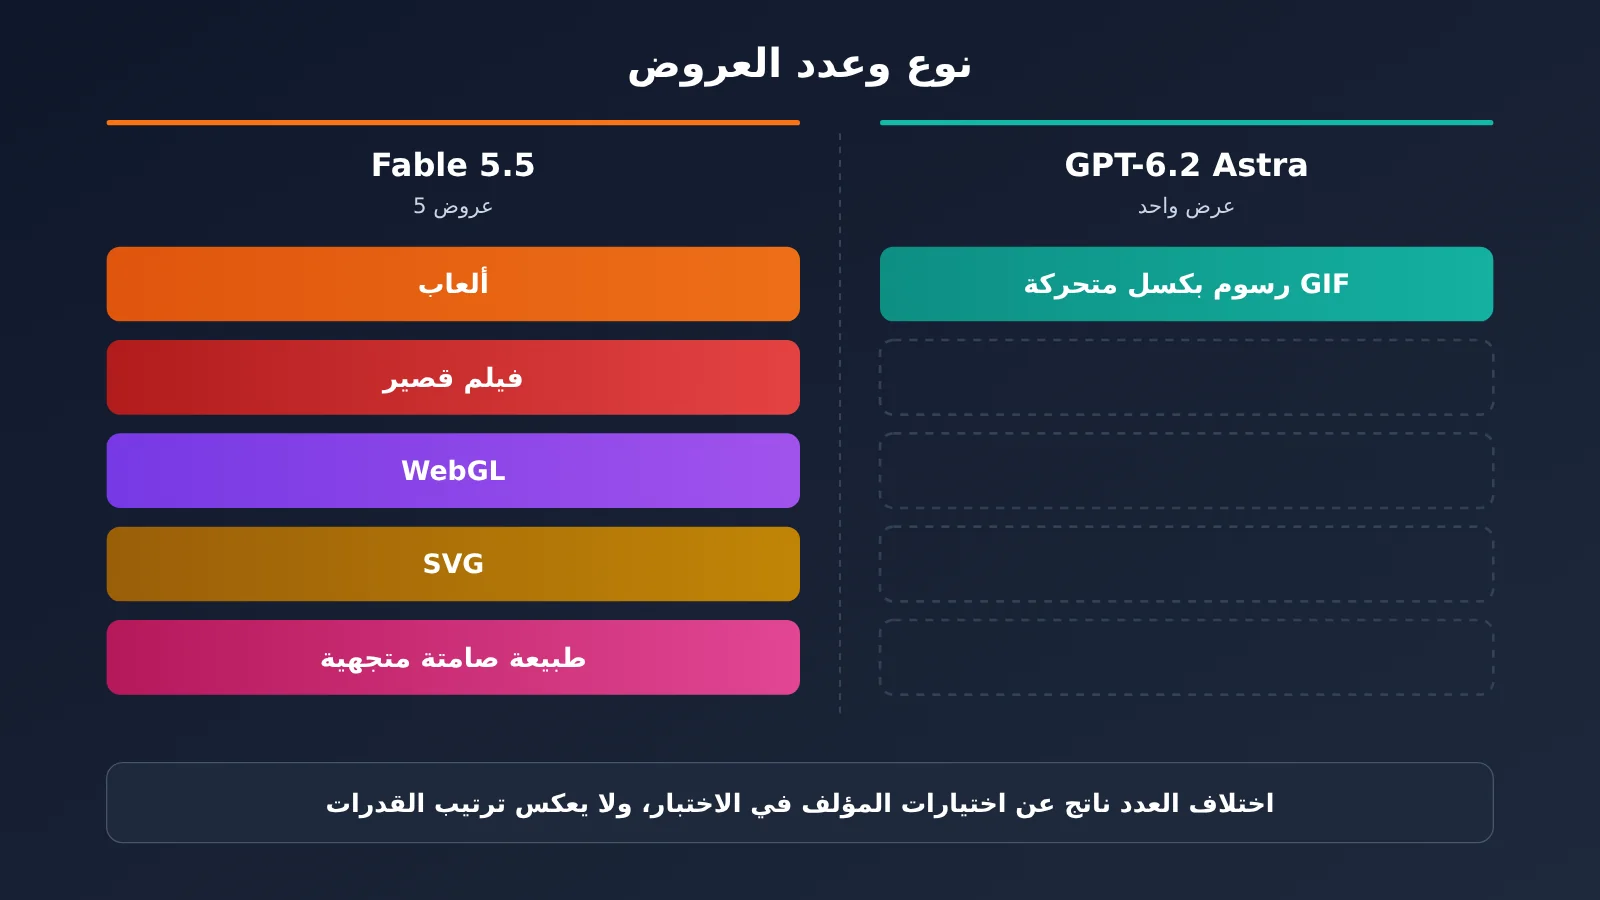
يوضح الرسم أعلاه توزيع العروض التجريبية من حيث النوع والعدد، وليس ترتيبًا للقدرات. إذا أردت معرفة الفرق الفعلي بين النموذجين الرائدين الحاليين لدى الشركتين في مهامك الخاصة، يمكنك استخدام مفتاح API واحد على APIYI apiyi.com لاستدعاء claude-fable-5-1 وgpt-6-astra كلٌّ على حدة.
Fable 5.5 مقابل GPT-6.2 Astra: ثلاث نقاط «تبدو عادلة، لكنها ليست كذلك»
الخلاصة: قد يوحي نشر المقالين على الموقع نفسه وبقلم الكاتب نفسه بأنهما مقارنة مباشرة، لكن هناك ثلاثة أوجه على الأقل لعدم التكافؤ.
النقطة الأولى: المهام مختلفة تمامًا
تغطي الأعمال الخمسة لـ Fable 5.5 أربع فئات: الألعاب والأفلام القصيرة وWebGL وSVG، بينما تقتصر أعمال GPT-6.2 Astra على فئة واحدة هي الرسوم المتحركة بالبكسل. ولم ينفّذ النموذجان أي مهمة مشتركة. فالرسوم المتحركة بالبكسل تختبر التكوين البصري والاتساق بين الإطارات، بينما تختبر الألعاب ذات الملف الواحد تنظيم الشفرة الطويلة وإدارة الحالة؛ ولا يمكن تحويل نتائج إحداهما إلى ما يعادلها في الأخرى. ولإجراء مقارنة مرجعية بين الإصدارات، لا يمكن مقارنة GPT-6.2 Astra إلا بـ GPT-6 Astra (Hoshikawa) على الموقع نفسه، ولا يمكن مقارنة Fable 5.5 إلا بـ Opus 5.5 (VoxelCraft — Shader Edition).
النقطة الثانية لعدم الإنصاف: اختلاف مستويات الاستدلال والتواريخ والعدد
معظم أعمال Fable 5.5 موسومة بمستوى xhigh، باستثناء Fruit Basket الموسوم بمستوى max، بينما وُسم GPT-6.2 Astra بمستوى Max. وتعني اختلافات المستوى اختلاف ميزانية الاستدلال، لذا لا يمكن مقارنة جودة النتائج مباشرة. وهناك أيضًا تفاوت في العدد بنسبة 5 إلى 1، وهو يعكس ما اختار المؤلف اختباره، لا نتائج تقييم رسمي. ومن أكثر الأخطاء شيوعًا في هذا النقاش اعتبار عدد العروض التوضيحية دليلًا على قوة النموذج أو ضعفه.
نقطة عدم الإنصاف الثالثة: تعذّر التحقق من هوية النموذج
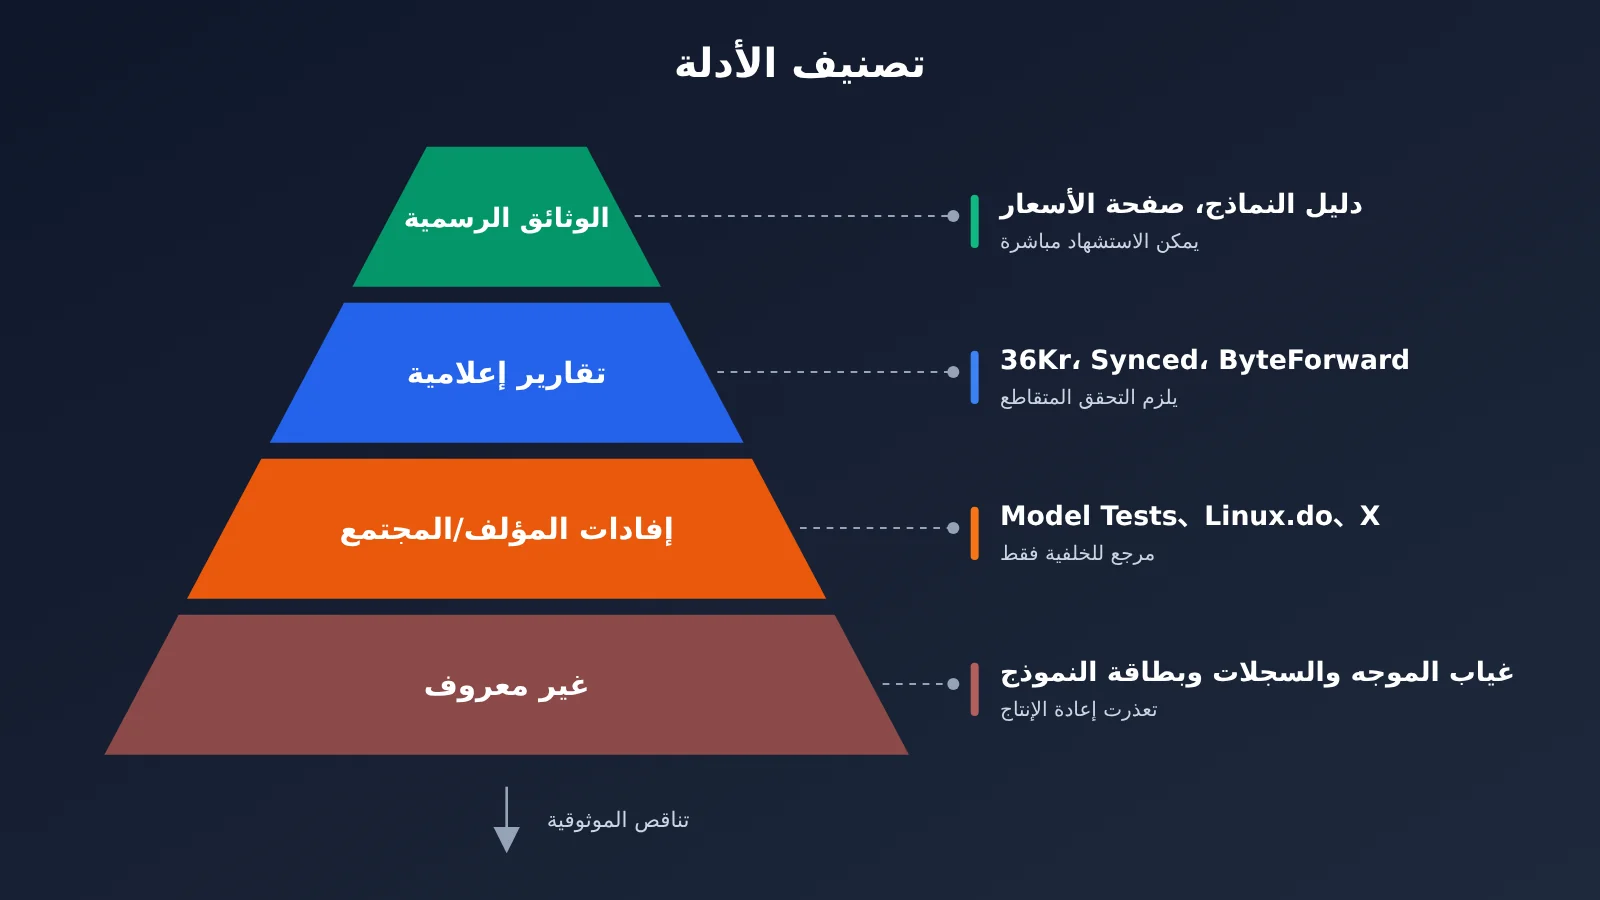
لم تُنشر الموجهات أو سجلات الاستدعاء أو بطاقات النماذج لأي من العروض التجريبية، لذا تعتمد هوية النموذج بالكامل على ما ذكره صاحب كل عرض. وأشارت ByteForward في مراجعتها بتاريخ 11-02 إلى أن بعض العروض المنسوبة إلى «Fable 5.5» قد تكون نتيجة توجيه طلبات Opus 5.5 إلى النموذج الجديد، بينما ظل منتقي النماذج يعرض Opus 5.5 (مستوى الدليل: تقرير إعلامي واحد). في ظل ذلك، لا يصح سوى القول «وفقًا لصاحب العرض، استُخدم Fable 5.5»، وليس «أنجز Fable 5.5 هذا العمل».
يرتب الجدول التالي الادعاءات المتعلقة بالنموذجين بحسب مستوى الدليل. وننصح القراء بالإبقاء على عمود مستوى الدليل عند نقل هذه المعلومات داخل فرقهم.
| الادعاء | المصدر | التاريخ | مستوى الدليل |
|---|---|---|---|
| لا يزال أحدث نموذج Fable في قائمة Anthropic هو Fable 5.1، ولا وجود لـ Fable 5.5 | صفحة أسعار Anthropic وصفحة أخبارها | تمت المراجعة في 11-03 | وثائق رسمية |
| لا يزال أحدث نموذج Astra في قائمة OpenAI هو GPT-6 Astra، ولا وجود لـ GPT-6.2 Astra | قائمة نماذج OpenAI | تمت المراجعة في 11-03 | وثائق رسمية |
أضافت LiteLLM بند تسعير لـ azure_ai/claude-fable-5-5 |
سجل TestingCatalog | 10-13 | سجل من جهة خارجية |
| يدعم Fable 5.5 مليون رمز إدخال و128 ألف رمز إخراج | 36 氪/新智元 | 11-02 | تقرير إعلامي واحد |
| تشير تقييمات مجمّعة إلى أن GPT-6.2 Astra حقق «قفزة ملحوظة» | 机器之心/新浪 | 11-02 | تجميع إعلامي، دون اختبارات معيارية |
| يشكّل gpt-6.2-astra نسبة 1.6% من تفاصيل الاستخدام | Linux.do @fourfour | 11-01 | إفادة شخصية من المجتمع |
| يشكّل gpt-6.2-astra نسبة 19.8% من تفاصيل الاستخدام | X @TokenGremlin | 11-01 | إفادة شخصية من المجتمع |
| هوية النماذج المستخدمة في العروض التجريبية على Model Tests | صاحب العروض @notjazii | من 11-01 إلى 11-02 | بحسب صاحب العروض |
| بعض عروض Fable 5.5 التجريبية هي في الواقع طلبات Opus 5.5 أُعيد توجيهها | ByteForward | 11-02 | تقرير إعلامي واحد |
تستدعي بيانات استخدام GPT-6.2 Astra توضيحًا خاصًا. يعرض منشور Linux.do توزيع استخدام Codex من 10/25 إلى 10/31، حيث لا يزال gpt-6-astra يستحوذ على 97.7%، مقابل 1.6% فقط لـ gpt-6.2-astra. وفي المنشور نفسه، تتعلق 12 من أصل 13 سطرًا في الفاتورة بـ gpt-6-astra، وتتراوح السرعة بين 44 و73 tok/s. أما لقطة الشاشة التي نشرها TokenGremlin على X فتُظهر نسبة 19.8%، وقد انتشرت على نطاق أوسع، بنحو 155 ألف مشاهدة. كلا الرقمين مأخوذ من لقطات شاشة لحسابات شخصية، وليسا بيانات رسمية. وقد أوضحت 机器之心 نفسها أن لقطات الشاشة لا تثبت سوى أن «بعض المستخدمين أفادوا بحصولهم على صلاحية الوصول». كذلك، فإن GPT-6.2 Betelgeuse / Bel اسم رمزي آخر لنموذج أساسي تداوله الناس في وقت سابق، وهو ليس النموذج نفسه الذي يُشار إليه باسم 6.2 Astra.
تتعارض أيضًا انطباعات المجتمع. فالبعض يرى أن Fable 5.5 أقوى، بينما يرى آخرون أنه يتعادل مع Opus 5.5. أما GPT-6.2 Astra، فيقول البعض إنه أقل أداءً من Opus 5.5، ويرى آخرون أنه لا يقدم سوى تحسينات تدريجية، بينما يقول فريق ثالث إنه يتفوق على Opus 5.5 في عدة جوانب. لا تستند هذه الآراء إلى اختبارات معيارية أو أحجام عينات معلنة، لذا لا يمكن التعامل معها إلا كمعلومات سياقية.
مقارنة المواصفات والأسعار الرسمية لـ Fable 5.1 وGPT-6 Astra
الخلاصة: لا توجد مواصفات رسمية للنموذج الجديد بعد، لذا لا يمكن إجراء مقارنة مباشرة إلا بين النموذجين الرائدين المتاحين حاليًا. سعر الوحدة متساوٍ، لكن الاختلاف الحقيقي يكمن في احتساب تكلفة المدخلات الطويلة، وتاريخ انقطاع المعرفة، ومستويات الاستدلال.
يبلغ السعر الرسمي لكل من Fable 5.1 وGPT-6 Astra نحو $10 للإدخال و$50 للإخراج لكل مليون token. ويبلغ الحد الأقصى للإخراج في كليهما 128K، بينما تبلغ نافذة السياق 1M للأول و1.05M للثاني. تستند بيانات الجدول إلى صفحتي النموذجين الرسميتين، وقد جُمعت في 2026-11-03؛ ومستوى توثيقها هو الوثائق الرسمية.
| المواصفة | Fable 5.1 | GPT-6 Astra |
|---|---|---|
| معرّف النموذج | Fable 5.1 الرسمي من Anthropic | gpt-6-astra |
| نافذة السياق | 1M | 1.05M |
| الحد الأقصى للإخراج | 128K | 128K |
| تاريخ انقطاع المعرفة | 2026-06 | 2026-04-30 |
| التحكم في الاستدلال | Adaptive thinking مفعّل دائمًا، ومستوى effort الافتراضي هو high | low / medium / high / xhigh / max |
| إمكانات الأدوات | وفقًا للوثائق الرسمية | استدعاء الدوال، والبحث على الويب، والبحث في الملفات، واستخدام الحاسوب |
يؤثر الاختلاف في التحكم بالاستدلال مباشرةً في تصميم التقييم. ففي Fable 5.1، تكون خاصية Adaptive thinking مفعّلة دائمًا، ومستوى effort الافتراضي هو high؛ أما GPT-6 Astra فيوفر خمسة مستويات للاختيار. ولا تتطابق تسميات المستويات بين النموذجين، لذا يمكن تقريبها قدر الإمكان، لكن لا يمكن اعتبارها متكافئة تمامًا. عند التقييم، يُنصح بتسجيل المستوى ضمن حقول النتائج بدلًا من افتراض أن high في أحدهما يساوي high في الآخر.
من حيث السعر، تتطابق أسعار الوحدات الرسمية، لكن تفاصيل الفوترة تختلف كثيرًا. يعرض الجدول التالي الأسعار الرسمية والأسعار المتاحة على منصة APIYI بالدولار لكل مليون token.
| بند الفوترة | Fable 5.1 الرسمي | GPT-6 Astra الرسمي | المتاح على APIYI apiyi.com |
|---|---|---|---|
| الإدخال | $10 | $10 | claude-fable-5-1 بسعر $10؛ وgpt-6-astra بسعر $10 للمدخلات من 0 إلى 272,000 tokens |
| الإدخال الطويل | يبقى السعر $10 ضمن 1M | وفقًا للصفحة الرسمية | gpt-6-astra بسعر $20 للمدخلات من 272,001 إلى 1,050,000 tokens |
| الإخراج | $50 | $50 | كلاهما بسعر $50 |
| إصابة ذاكرة التخزين المؤقت/القراءة | $0.25 | وفقًا للصفحة الرسمية | claude-fable-5-1 بسعر $0.25؛ وgpt-6-astra بسعر $1 |
| الكتابة إلى ذاكرة التخزين المؤقت | 5 دقائق بسعر $12.50، وساعة واحدة بسعر $20 | وفقًا للصفحة الرسمية | وفقًا لقائمة النماذج على المنصة |
| نقاط النهاية | messages | responses، chat | claude-fable-5-1: chat / messages؛ وgpt-6-astra: responses / chat |
بالنسبة إلى الفرق التي تحلل المستندات الطويلة أو تفهم قواعد الشفرة الكبيرة، هذا الجدول أكثر فائدة من سؤال «أيهما أقوى؟». فعندما يتجاوز الإدخال الواحد 272 ألف token، يتضاعف سعر الإدخال في gpt-6-astra إلى $20، بينما يبقى سعر claude-fable-5-1 عند $10 ضمن نطاق 1M. ويختلف سعر قراءة ذاكرة التخزين المؤقت بأربعة أضعاف أيضًا ($0.25 مقابل $1). إذا كنت تستدعي السياق الطويل نفسه مرارًا، فسيظهر أثر هذين الفرقين بوضوح في الفاتورة. تُعتمد النماذج والأسعار الواردة في قائمة نماذج المنصة.
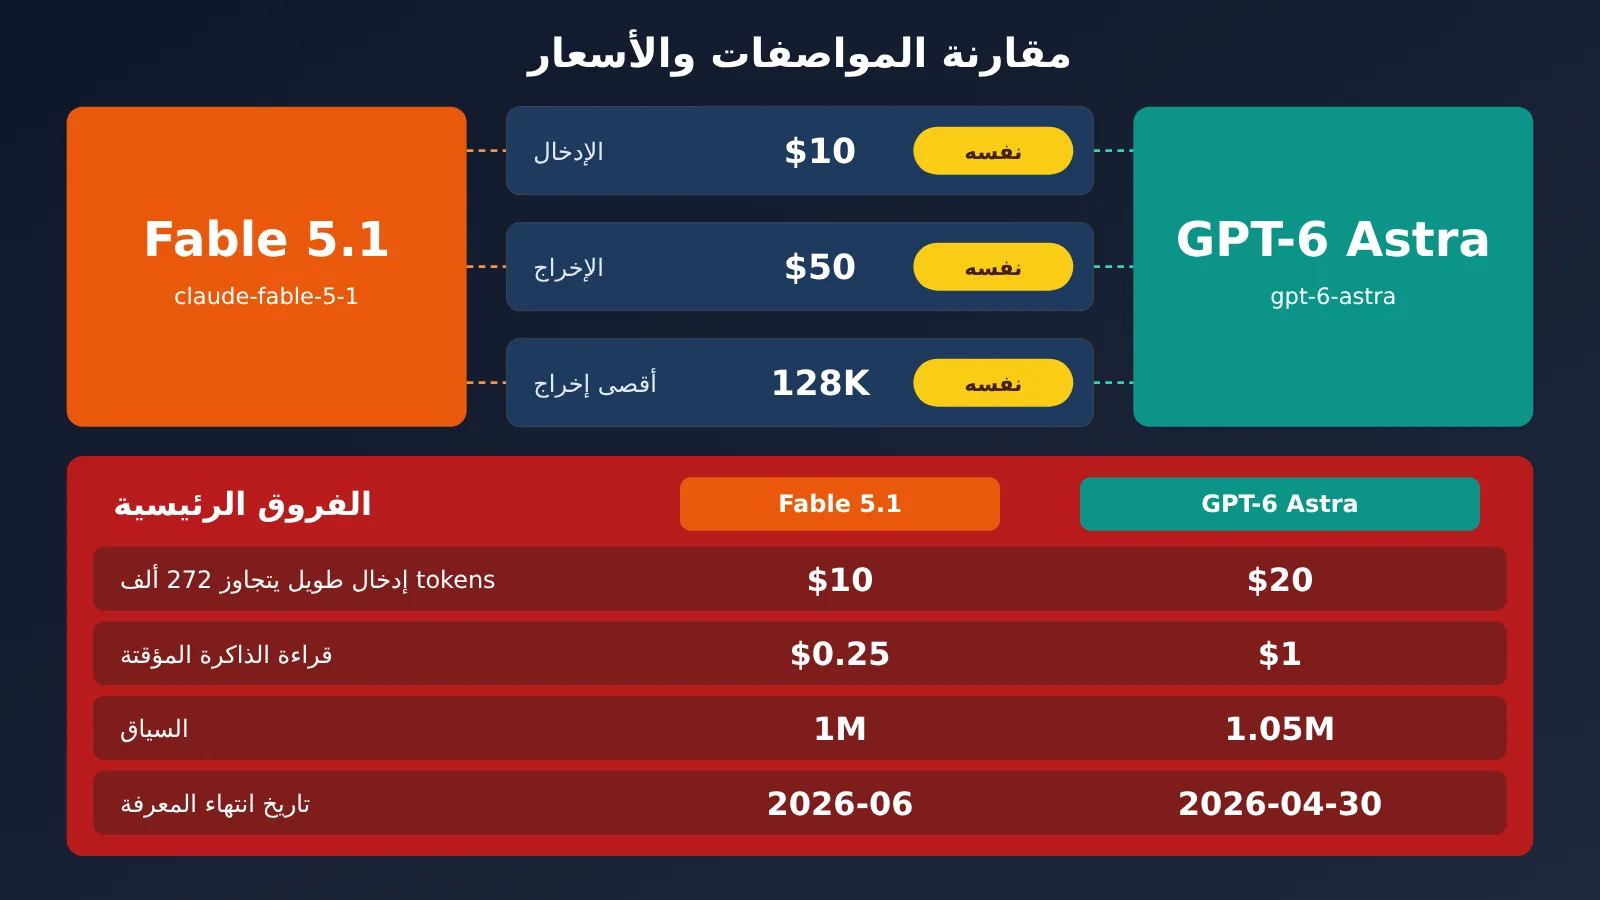
تستند الأسعار في الرسم إلى صفحات النماذج الرسمية وواجهة أسعار منصة APIYI apiyi.com، وقد جرى الاطلاع عليها في 2026-11-03.
ما المتاح الآن قبل إطلاق Fable 5.5 وGPT-6.2 Astra؟
الخلاصة: لا تتوفر واجهة API رسمية للنموذجين الجديدين بعد، لكن يمكن استخدام النموذجين الرائدين الحاليين لدى الشركتين لإجراء اختبار أساس وبناء إطار التقييم مسبقًا.
حتى 2026-11-03، أعادت واجهة قائمة النماذج في منصة APIYI عدد 259 نموذجًا، بينما ضمت واجهة الأسعار 277 نموذجًا. وتشمل القائمة gpt-6-astra وgpt-6.1-sol وgpt-6.1-terra وgpt-6-luna وclaude-fable-5-1، لكنها لا تضم gpt-6.2-astra أو claude-fable-5-5. وهذا يعني أن النموذجين الرائدين الحاليين لدى الشركتين متاحان لإجراء اختبار أساس بالمفتاح نفسه. وفي اليوم ذاته، أُرسل طلب messages إلى claude-fable-5-1 بقيمة max_tokens تبلغ 32، وعاد برمز HTTP 200، ما يؤكد أن الواجهة تعمل.
طريقة التكامل متوافقة مع OpenAI SDK. يكفي ضبط base_url على https://api.apiyi.com/v1، وتحديد اسم النموذج claude-fable-5-1 أو gpt-6-astra. وإذا كنت تحتاج إلى تنسيق messages الأصلي من Anthropic، فإن claude-fable-5-1 يدعمه أيضًا؛ أما gpt-6-astra فيمكن استخدامه عبر نقطة نهاية responses أو chat.
🚀 البدء السريع: بعد التسجيل في APIYI عبر apiyi.com، استخدم رصيد الاختبار المجاني للمستخدمين الجدد لتجربة 3 إلى 5 مهام على
claude-fable-5-1وgpt-6-astra. تأكد من صحة تنسيق المخرجات وتسجيل رموز token، ثم وسّع الاختبار ليشمل مجموعة الأسئلة الكاملة.
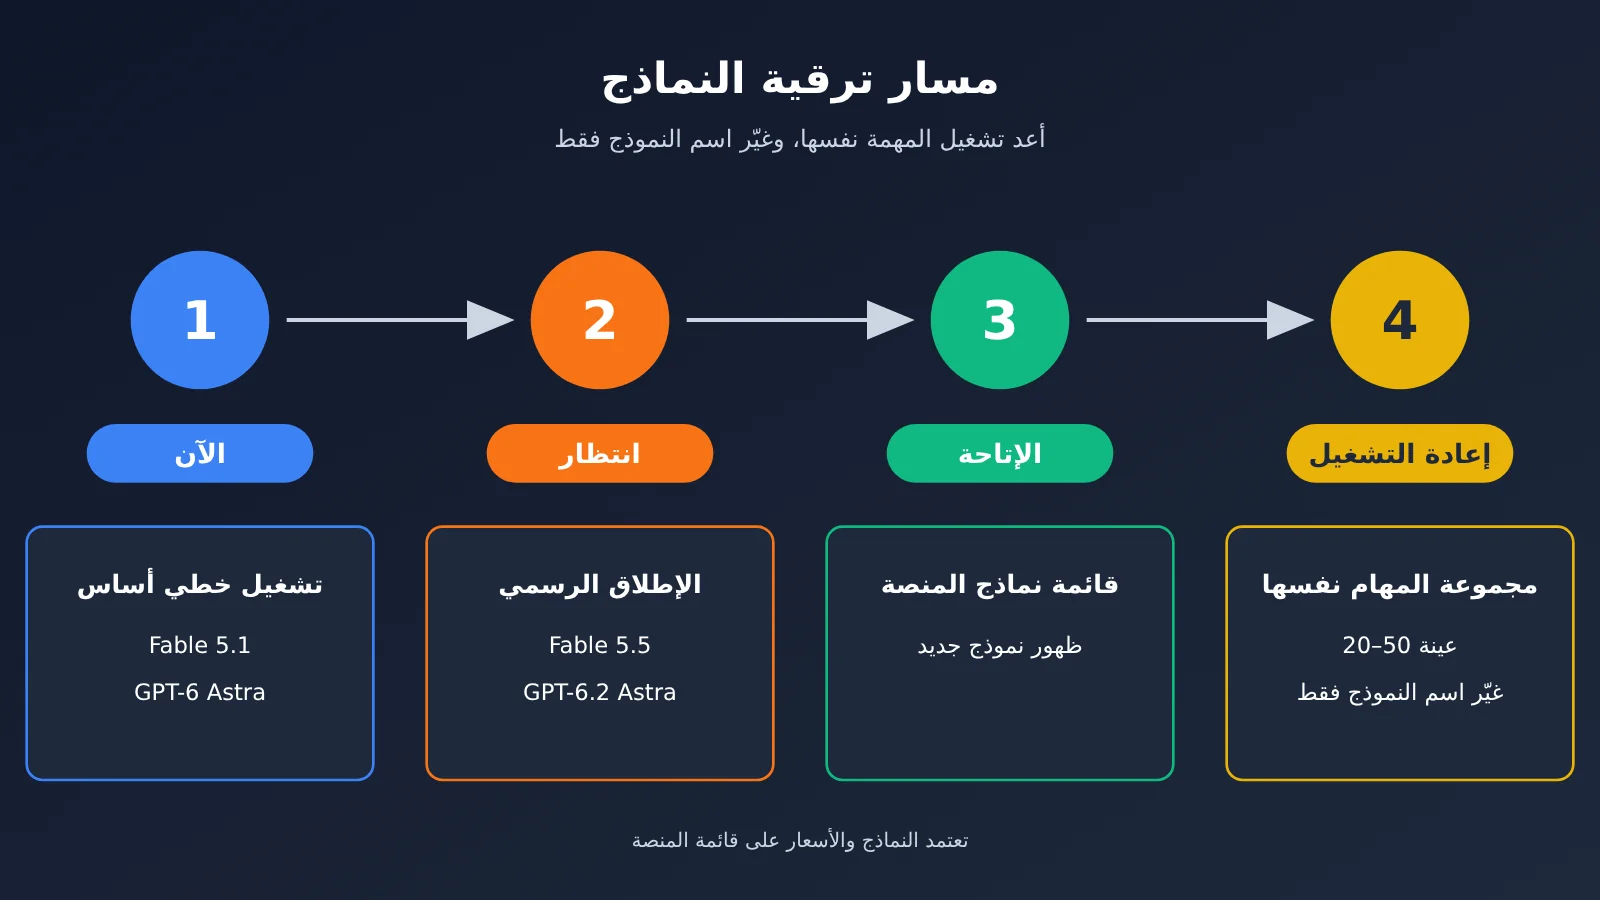
لا تكمن قيمة هذه الخطوة في معرفة أداء النموذجين الجديدين مسبقًا، بل في تجهيز مجموعة الأسئلة ومعايير التقييم وجدول التسجيل. وعندما يُطلق Fable 5.5 أو GPT-6.2 Astra رسميًا، لن يحتاج الفريق سوى إلى تغيير اسم النموذج للوصول إلى نتائج تناسب حالات استخدامه خلال يوم أو يومين، دون الاعتماد على عروض الآخرين التوضيحية ولقطات الشاشة.
كيف تختار بين Fable 5.5 وGPT-6.2 Astra وتختبرهما؟
الخلاصة: لا داعي لانتظار النماذج الجديدة الآن. ابدأ بوضع معيار مرجعي باستخدام النماذج الرائدة المتاحة، واستند في اختيارك إلى 20 إلى 50 مهمة من مهامك، لا إلى العروض التوضيحية العامة.
حتى 2026-11-03، لم يكن Fable 5.5 ولا GPT-6.2 Astra متاحين على APIYI بعد. وسنحرص على إتاحتهما في أقرب وقت بعد إصدارهما؛ وتبقى قائمة نماذج المنصة المرجع المعتمد للأسماء والأسعار. إلى ذلك الحين، يمكنك إجراء تقييم أولي وفق السيناريوهات التالية:
- المستندات الطويلة، ومستودعات الشفرة الكبيرة، والسياقات الطويلة المتكررة: ابدأ بتقييم
claude-fable-5-1. يظل سعر الإدخال ثابتًا ضمن حد 1M، ولا تتجاوز تكلفة قراءة ذاكرة التخزين المؤقت $0.25، ما يجعل التكلفة أسهل في التوقع. - الحاجة إلى ضبط ميزانية الاستدلال بدقة، أو الاعتماد على البحث عبر الويب أو استخدام الحاسوب: ابدأ بتقييم
gpt-6-astra. يتيح خمسة مستويات للاستدلال، وقدرات الأدوات المدرجة رسميًا أكثر شمولًا. - مهام الواجهة الأمامية في ملف واحد والتصورات الإبداعية: توجد أعمال مرجعية لكلا الطرفين، لكنها تستند إلى ادعاءات أصحابها، لذا لا تتجاوز قيمتها كونها مصدر إلهام. اختبر النموذجين بمهامك الخاصة.
- المهام التي تتطلب معلومات حديثة: تاريخ انتهاء المعرفة في Fable 5.1 هو 2026-06، وفي GPT-6 Astra هو 2026-04-30. الفارق نحو شهرين، ويمكن تعويضه باستخدام أدوات البحث.
كيفية إعداد تقييم خاص بك
تقوم فكرة التقييم على «تثبيت كل شيء، وتغيير اسم النموذج فقط». إليك الخطوات:
- اختر من مهام العمل الفعلية ما بين 20 و50 مهمة، تغطي الأنواع الرئيسية مثل البرمجة والمستندات الطويلة والمخرجات المهيكلة، وحدد معيار النجاح لكل مهمة.
- ثبّت موجه النظام وموجه المستخدم والحد الأقصى لرموز الإخراج ومستوى الاستدلال؛ وسجّل قيمة
effortلنموذج Fable 5.1 واسم المستوى لنموذج GPT-6 Astra. - سجّل لكل مهمة عدد رموز الإدخال والإخراج، والوقت من البداية إلى النهاية، ونتيجة التقييم البشري للنجاح أو الإخفاق.
- ميّز المهام التي يتجاوز إدخالها 272,000 رمز، واحسب تكلفتها وفق شرائح الأسعار الفعلية.
- شغّل التقييم أولًا على
claude-fable-5-1وgpt-6-astraلإنشاء خطّي أساس؛ وعندما تتوفر النماذج الجديدة، غيّر اسم النموذج فقط وأعد تشغيل مجموعة المهام نفسها.
يُفضّل أن يتضمن جدول التسجيل الحقول التالية على الأقل، لتسهيل المقارنة بين النماذج وعبر الزمن:
| الحقل | البيانات المسجلة | الغرض |
|---|---|---|
| معرّف المهمة ونوعها | برمجة / مستند طويل / مخرجات مهيكلة وغيرها | توزيع معدلات النجاح حسب السيناريو |
| اسم النموذج ومستوى الاستدلال | مثل gpt-6-astra high |
ضمان ثبات الظروف عند إعادة التشغيل |
| رموز الإدخال / الإخراج | بيانات usage التي تعيدها المنصة | حساب التكلفة الفعلية لكل مهمة |
| الوقت المستغرق | من إرسال الطلب حتى اكتمال الاستجابة | تقييم تجربة التفاعل |
| نتيجة التقييم البشري | نعم / لا + السبب | مؤشر الجودة النهائي |
💡 نصيحة للاختيار: يتيح تشغيل نماذج الشركتين باستخدام مفتاح واحد تجنب تأثير اختلافات الشبكة وحدود المعدل المرتبطة باستخدام حسابات متعددة. وعند توحيد الاستدعاءات عبر APIYI apiyi.com، يكون تنسيق حقل usage المسجل متسقًا، ما يسهّل مطابقة البيانات في الجدول الملخّص.
الأسئلة الشائعة والتوصيات العملية
السؤال 1: هل تثبت العروض على Model Tests أن Fable 5.5 أقوى من GPT-6.2 Astra؟
لا. لم يُختبر النموذجان على المهمة نفسها، كما تختلف مستويات الاستدلال والتواريخ وأعداد الأعمال المعروضة، ونسبة الأعمال إلى كل نموذج تستند إلى ما ذكره صاحبها. أقصى ما يمكن استنتاجه، وفقًا لصاحب العروض، هو أن كليهما قادر على إنتاج أعمال قابلة للتشغيل أو المشاهدة.
السؤال 2: هل صدر Fable 5.5 وGPT-6.2 Astra؟ ومتى يمكن استخدامهما؟
حتى 2026-11-03، لم يظهر أي من النموذجين في كتالوجات النماذج الرسمية للشركتين، ولا يوجد موعد إصدار موثوق لهما. ولم يُتح أي منهما على APIYI حتى ذلك التاريخ، وسنعمل على إتاحتهما في أقرب وقت. يُرجى الرجوع إلى قائمة نماذج المنصة للتأكد من الأسماء والأسعار. بعد إتاحتهما، ستجدهما مباشرة في قائمة النماذج على APIYI عبر apiyi.com.
السؤال 3: هل لقطة الشاشة التي تعرض نسبة حركة مرور تبلغ 19.8% موثوقة؟
تأتي اللقطة من الحساب الشخصي لمستخدم X المسمى TokenGremlin. في المقابل، أظهر منشور أقدم على Linux.do نسبة 1.6% فقط، بينما ظل محدد النماذج يعرض GPT-6 Astra، ولم تتفق تقارير المستخدمين الآخرين أيضًا. كلا الرقمين مبني على تقارير أفراد من المجتمع، وليس بيانات رسمية؛ وكل ما يشيران إليه هو ظهور اسم هذا النموذج في تفاصيل الاستخدام لبعض الحسابات.
السؤال 4: هل أنتظر النماذج الجديدة أم أستخدم النماذج الرائدة المتاحة حاليًا؟
ننصحك باستخدام النماذج الرائدة المتاحة حاليًا. يتمتع Fable 5.1 وGPT-6 Astra بالسعر نفسه وبقدرات من المستوى الأول، ويمكن استخدامهما في بيئات الإنتاج الآن. والأهم أن تبدأ ببناء مجموعة اختبارات التقييم، حتى تتمكن من الوصول إلى نتيجة بسرعة عند إطلاق النماذج الجديدة. يمكنك استخدام رصيد الاختبار المجاني على APIYI عبر apiyi.com لتجربة عينة صغيرة والتحقق من سير عملية التقييم.
السؤال 5: إذا كان سعر النموذجين الرائدين متساويًا، فهل يمكن أن تختلف التكلفة؟
نعم. عند تجاوز مدخل واحد في `gpt-6-astra` حاجز 272,000 tokens، يرتفع سعر الإدخال من $10 إلى $20. ويبلغ سعر قراءة ذاكرة التخزين المؤقت $1، مقابل $0.25 في `claude-fable-5-1`. يظهر الفرق بوضوح أكبر في حالات السياق الطويل وارتفاع معدل الاستفادة من ذاكرة التخزين المؤقت؛ لذا ننصحك بحساب التكلفة وفق التوزيع الفعلي للـ tokens.
توصيات عملية
للفرق التي تختار نموذجًا هذا الشهر، نقترح ثلاث خطوات: ابدأ هذا الأسبوع بتجميع 20 إلى 50 مهمة من أعمالك، مع تحديد معايير اجتيازها. ثم استخدم مفتاح API واحدًا على APIYI apiyi.com لاختبار claude-fable-5-1 وgpt-6-astra كنقطتي مقارنة، وسجّل عدد الرموز والوقت المستغرق ومعدل الاجتياز وفق التقييم البشري. وعندما يُصدر Fable 5.5 أو GPT-6.2 Astra رسميًا ويُتاح على المنصة، أعد تشغيل مجموعة الاختبارات نفسها مع تغيير اسم النموذج فقط. بذلك ستحصل على بيانات مقارنة تستند إلى مهامك الخاصة وفي ظروف متساوية، وهي أكثر موثوقية من أي عرض تجريبي أو لقطة شاشة. ارجع إلى قائمة النماذج على المنصة لمعرفة النماذج والأسعار المعتمدة.
المراجع
- دليل نماذج OpenAI: المواصفات والأسعار الرسمية لـ GPT-6 Astra
- الرابط:
developers.openai.com/api/docs/models - ملاحظة: تمت المراجعة في 2026-11-03، ولم يكن GPT-6.2 Astra مدرجًا في الدليل.
- صفحتا الأسعار والنماذج على منصة Anthropic: المواصفات والأسعار الرسمية لـ Fable 5.1 وآلية احتساب تكلفة التخزين المؤقت
- الرابط:
platform.claude.com - ملاحظة: تمت المراجعة في 2026-11-03، ولم يرد ذكر Fable 5.5 في صفحتي الأسعار والأخبار.
- موقع Model Tests للاختبارات من طرف ثالث: مجموعة العروض التجريبية العامة التي نشرها صاحبها @notjazii
- الرابط:
model-tests.vercel.app - ملاحظة: تستند نسبة النتائج إلى النماذج المذكورة إلى تصريح صاحبها، ولا تتوفر موجهات أو سجلات استدعاء.
الكاتب: الفريق التقني في APIYI
للتواصل التقني: تفضل بزيارة الصفحة الرئيسية لـ APIYI على apiyi.com للتواصل معنا، ويمكنك الاطلاع على النماذج ووثائق التكامل على docs.apiyi.com