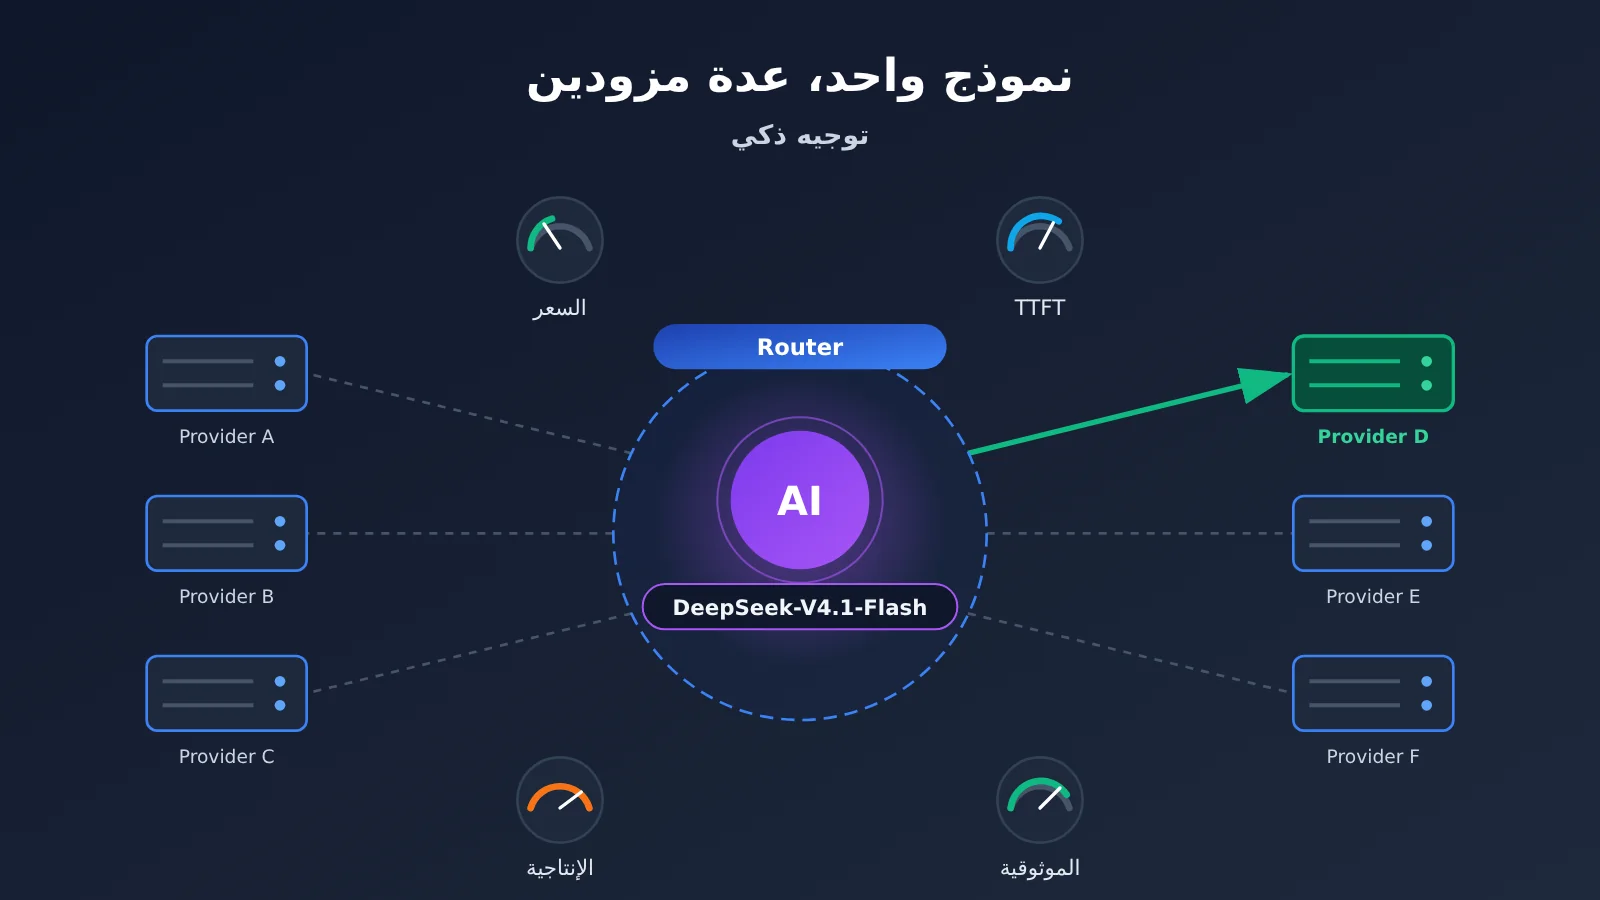
إجابة مباشرة: يمكن للعديد من مزوّدي خدمات الاستدلال نشر النموذج نفسه مفتوح الأوزان، كلٌّ على حدة، ولهذا تظهر عشرات من مزوّدي API. لا يكتفي OpenRouter بالنظر إلى أدنى سعر معلن، بل يختار المزوّد بناءً على التكلفة الإجمالية لاستجابة واحدة قابلة للاستخدام. فهو يقيّم في الوقت نفسه 6 مؤشرات: السعر الفعلي الفعّال، وزمن استجابة أول توكن، والإنتاجية، وحدود المعدل، والموثوقية، وجودة الاستجابة. ثم يوجّه الطلب إلى المزوّد الأنسب في تلك اللحظة، وإذا فشل ينتقل إلى مزوّد آخر ويعيد المحاولة.
وهذا يعني أن المنافسة في تجميع واجهات API للذكاء الاصطناعي انتقلت من «توفير واجهة موحّدة» إلى «الجدولة الديناميكية لمزوّدي الخدمة». في 16 نوفمبر 2026، أعلنت Hugging Face عن إسناد توجيه نماذج اللغة في Inference Providers إلى OpenRouter. ويقدّم هذا التعاون عيّنة ملموسة تساعدنا على فهم كيف تتحول هذه المؤشرات إلى آلية تلقائية لاختيار المزوّد.
ماذا ستتعرف بعد قراءة هذا المقال؟
- لماذا قد يكون للنموذج الواحد للذكاء الاصطناعي عدة مزوّدي API، وما الفرق بين مطوّر النموذج ومزوّد خدمة الاستدلال
- ما مؤشرات القرار التي يعتمد عليها توجيه المزوّد، وما المشكلة التي يحلها كل مؤشر
- ما الذي يمكن أن يحققه التراجع عند الفشل، وما حدوده
- كيف تستخدم البيانات الوصفية في API كتالوج النماذج لدى Hugging Face لمقارنة مزوّدي الخدمة بنفسك
الفهرس: يسير جزء الوقائع الموضوعية على الترتيب التالي: أولاً شرح أصل وجود عدة مزوّدي API، ثم تفكيك هدف القرار في التوجيه الذكي والمؤشرات الستة، ثم الحديث عن عملية التبديل عند الفشل وحدودها، وأخيراً عرض كيفية استخدام المطورين لواجهة الكتالوج لمقارنة مزوّدي الخدمة بأنفسهم، مع إدراج بيانات تجارب التوجيه وتغيّرات الفوترة التي نشرتها OpenRouter. أما جزء التحليل والتقييم فيناقش الاتجاه المقبل لمنافسة منصات تجميع واجهات API، وكيف ينبغي للمطورين الموازنة بين الخيارات والتحقق منها داخل تطبيقاتهم.
فهم المفاهيم الأساسية حول مزوّدي خدمات API وتوجيه Provider
| المفهوم | شرح موجز |
|---|---|
| Provider | المزوّد الذي ينشر النموذج ويقدّم خدمة الاستدلال فعليًا، مثل Together AI وNovita |
| Router | طبقة التوجيه التي تحدّد وجهة الطلب بناءً على شروط الطلب وحالة المزوّدين المتاحين |
| نموذج مفتوح الأوزان | نموذج تُنشر أوزانه بعد التدريب ويمكن نشره ذاتيًا وفق ترخيصه |
| TTFT | Time to First Token، أي زمن الانتظار من إرسال الطلب حتى إرجاع أول Token |
| الإنتاجية | عدد الـ Tokens المُولّدة في وحدة الزمن، وتُقاس عادةً بـ tok/s |
| Failover | التحويل التلقائي إلى مزوّد آخر لإعادة المحاولة عند فشل المزوّد الحالي |
| Prompt Caching | يقوم المزوّد بتخزين المدخلات المتكررة لتقليل كلفة الحساب وزمن الاستجابة |
| BYOK | Bring Your Own Key، أي استخدام مفتاح المزوّد الخاص بك والاستفادة من رصيد الحساب المقابل |
| P50 / P95 | مقاييس إحصائية مئوية؛ P50 هو الوسيط، وP95 يعكس نسبة الـ 5% الأبطأ من الطلبات |
نظرة سريعة على أثر تغيّر التوجيه بين مزوّدي خدمات API المتعددين
- المطوّرون: من حيث المبدأ لا حاجة لتغيير الكود والـ Token على جهة Hugging Face، لكن المزوّد الفعلي سيُحدّده التوجيه، وقد ينتهي نفس معرّف النموذج إلى Provider مختلف في طلبات مختلفة. التطبيقات التي تعتمد على استدعاء الأدوات أو المخرجات المنظّمة تحتاج إلى إعادة اختبارات الانحدار. المطوّرون الذين كانوا يضبطون مفتاح Provider خاصًا بنماذجهم اللغوية على Hugging Face، فقد توقّف هذا المسار،وعليهم إعادة التأكد من المفتاح وجهة الفوترة.
- الشراء المؤسسي وفرق المنصّات: يجب إعادة تقييم قبول المورّدين واستراتيجيات التعافي من الكوارث وشروط معالجة البيانات. يمكن للمؤسسة تعطيل Provider محدّد، لكن هذا لا يعني الحصول على ضمان كامل لإقامة البيانات أو الامتثال، بل يبقى التحقق من سياسات بيانات كل مزوّد على حدة.
نموذج ذكاء اصطناعي واحد وعدة مزوّدين لخدمات API: حقائق موضوعية
لماذا يقدّم النموذج نفسه عبر عدة مزوّدين لـ API؟
تطوير النموذج وتقديم خدمة الاستدلال دورَان مختلفان. تتولى جهة تطوير النموذج تدريبه ونشر أوزانه. وبالنسبة إلى النماذج مفتوحة الأوزان، يمكن لأي مؤسسة لديها قدرة حوسبة وتستوفي شروط الترخيص أن تنشر الأوزان على عناقيد GPU الخاصة بها وتقدّم API للجمهور. ولهذا فإن نماذج مثل DeepSeek وQwen وGLM غالبًا ما تعمل في الوقت نفسه على بنى تحتية متعددة للاستدلال.
لنأخذ deepseek-ai/DeepSeek-V4.1-Flash مثالًا: يطلب المطوّر اسم النموذج نفسه، لكن الجهة التي تنفّذ الاستدلال فعليًا قد تكون Together AI أو Novita أو مزوّدًا آخر يدعم هذا النموذج. تختلف الأجهزة وحجم العناقيد وأسلوب الجدولة واستراتيجية التسعير من مزوّد لآخر، ولذلك تتباين أيضًا أسعار النموذج نفسه وسرعته وسعته الاستيعابية. بعض المزوّدين أرخص لكنهم يتعرضون لقيود المعدل بسهولة في ساعات الذروة، وبعضهم يعيد أول Token بسرعة، وبعضهم يدعم سياقًا أطول، وبعضهم يقدّم دعمًا أكثر اكتمالًا لتنسيق استدعاء الأدوات.
توضح بيانات الحجم مدى تشتّت هذا السوق. كشفت OpenRouter في إعلان الشراكة أن منصتها بأكملها تدعم أكثر من 600 نموذج، وتضم أكثر من 80 مزوّدًا، وتعالج أكثر من 800 تريليون Token شهريًا، وتخدم أكثر من 10 ملايين مستخدم. هذه بيانات منصة OpenRouter بأكملها، وليست حجمًا ناتجًا عن هذه الشراكة وحدها. كما تسرد صفحة Provider على Hugging Face أكثر من عشرة مزوّدين، من بينهم Baseten وCerebras وDeepInfra وFireworks وNebius وNovita وTogether AI، لكن المزوّدين المتاحين يختلفون من نموذج لآخر.
حين يقابل النموذج الواحد عدة مزوّدين، وتتغير ظروف كل مزوّد باستمرار، يصبح سؤال «إلى مَن نوجّه هذا الطلب؟» مسألة تحتاج إلى قرار مستمر. ومن هنا ظهر التوجيه متعدد المزوّدين.
ما الذي يقرره التوجيه الذكي في الواقع؟
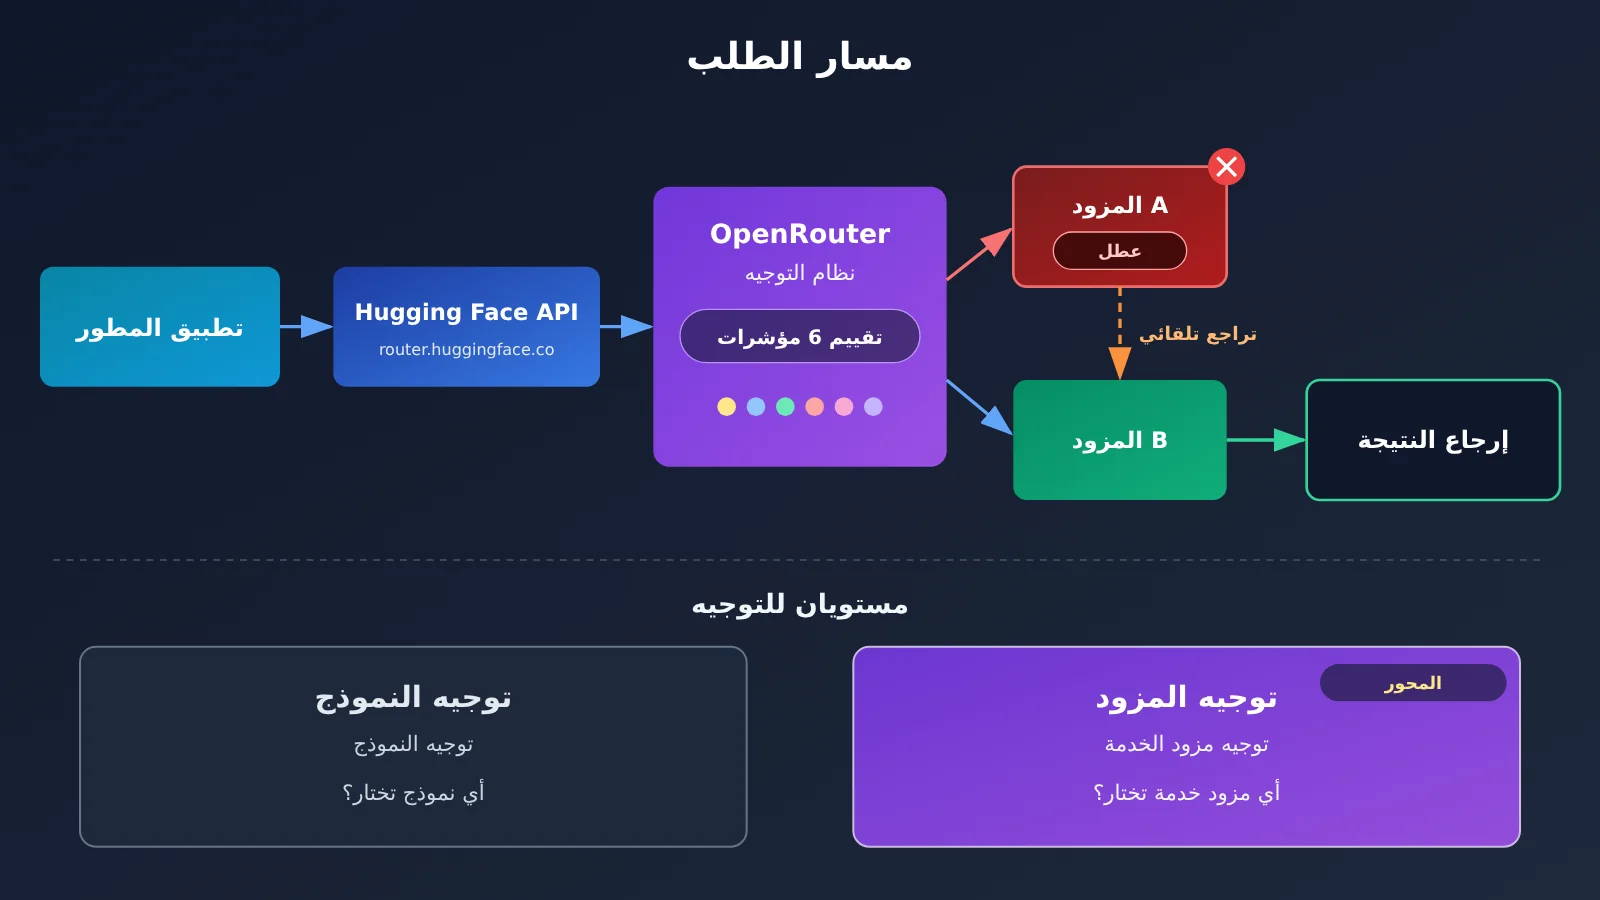
أولاً، لنفرّق بين مفهومين يسهل الخلط بينهما. Model Routing (توجيه النماذج) يحدد أي نموذج يجيب عن الطلب؛ مثلاً تُسلّم الأسئلة البسيطة إلى نموذج صغير، والأسئلة المعقدة إلى نموذج لغة كبير. أما Provider Routing (توجيه مزوّد الخدمة) فيفترض أن النموذج محدد مسبقاً، ويقرر أي مزوّد خدمة ينفّذ الاستدلال. تعاون OpenRouter مع Hugging Face الذي نتناوله هنا يقع في الفئة الثانية: النموذج يحدده المطوّر، وطبقة التوجيه تختار مزوّد الخدمة فقط، ولا تستبدل النموذج نيابةً عنك.
بعد التعاون، يصبح مسار طلب نموذج لغة كالتالي: تطبيق المطوّر أو Coding Agent ← Hugging Face API (router.huggingface.co) ← نظام توجيه OpenRouter ← استدلال أحد مزوّدي الخدمة ← إعادة النتيجة. يتولّى OpenRouter هنا توجيه الطلبات واختيار مزوّد الخدمة، ولا ينفّذ الاستدلال لجميع النماذج. لا يزال المستخدم يستعمل Hugging Face Token، وتتم الفوترة عبر حساب Hugging Face الشخصي أو حساب المؤسسة. وتقول Hugging Face إنها لا تضيف أي هامش ربح على سعر استدلال مزوّد الخدمة.
أما من ناحية التحكم، فتوفّر Hugging Face ثلاثة مستويات:
- التوجيه التلقائي الافتراضي: يستخدم العميل الرسمي
provider="auto"، فيختار النظام مزوّد الخدمة بناءً على مزيج من السعر والسرعة والموثوقية. - تحديد مزوّد خدمة معيّن: مثل
provider="together"، أو إضافة اللاحقة:novitaبعد معرّف النموذج، فيُوجَّه الطلب حتماً إلى ذلك المزوّد. - التوجيه وفق السياسة: تدعم الواجهة المتوافقة مع OpenAI اللاحقتين
:cheapest(الأولوية للسعر) و:fastest(الأولوية للإنتاجية).
يجب الانتباه إلى أن :fastest يحسّن الإنتاجية، وليس «السرعة» بكل معانيها. فزمن الوصول إلى أول Token (TTFT)، وسرعة التوليد، وزمن الطلب الكامل ثلاثة مؤشرات مختلفة. وفي الردود القصيرة التي لا تتجاوز جملة أو جملتين، غالباً ما يكون تأثير زمن تأخير أول Token في التجربة أكبر من تأثير الإنتاجية.
| بند المقارنة | توجيه Hugging Face السابق | توجيه OpenRouter الجديد |
|---|---|---|
| نظام التوجيه | موجّه Hugging Face المبني داخلياً | OpenRouter |
| اختيار مزوّد الخدمة | آلية الاختيار السابقة | تقييم شامل في الوقت الحقيقي |
| أساس السعر | استراتيجية التسعير السابقة | السعر الفعلي المطبّق |
| عامل السرعة | آلية الأداء السابقة | يراعي TTFT والإنتاجية |
| فشل محاولة واحدة | قد يعيد الخطأ مباشرة | يمكن إعادة المحاولة مع مزوّد خدمة آخر ضمن الطلب نفسه |
| التخزين المؤقت للجلسة | السياسة السابقة | يدعم الإبقاء على مزوّد الخدمة نفسه حسب الجلسة |
| بيانات اعتماد المستخدم | Hugging Face Token | متابعة استخدام Hugging Face Token |
ما المؤشرات التي يجب أن يعتمد عليها نظام توجيه متعدد المزوّدين موثوق؟
أعلن OpenRouter في 28 أكتوبر 2026 عن الجيل الجديد من خوارزمية توجيه المزوّدين (Provider Routing). كان التوجيه الافتراضي القديم يعتمد كثيرًا على السعر المعلن لرموز الإدخال، فكان المزوّدون منخفضو السعر يحصلون بسهولة على حركة مرور أكبر. تجمع الخوارزمية الجديدة أنواع الإشارات الستة التالية في «تكلفة توجيه» (Routing Cost) تُحسب لحظيًا، بهدف تحسين التكلفة الإجمالية لـ«استجابة ناجحة وقابلة للاستخدام من أول محاولة»، لا مجرد السعي إلى أقل سعر وحدة.
① السعر الفعلي (Effective Price) يعالج مشكلة أن «السعر المعلن الرخيص لا يعني فاتورة رخيصة». فهو يجمع أسعار ثلاثة أنواع: المدخلات غير المخزّنة مؤقتًا، والمدخلات المخزّنة مؤقتًا، والمخرجات، ثم يحسبها بناءً على النسبة الفعلية بين الإدخال والإخراج في الطلب، ومعدل الإصابة في الذاكرة المؤقتة لدى المزوّد. يقدّم OpenRouter هذا المثال: 40,000 رمز إدخال غير مخزّن مؤقتًا (بسعر $2/M) = $0.080، و60,000 رمز إدخال مخزّن مؤقتًا (بسعر $0.50/M) = $0.030، و4,000 رمز إخراج (بسعر $8/M) = $0.032، والمجموع $0.142. في سياقات الوكيل (Agent)، تكون نسبة المدخلات المخزّنة مؤقتًا مرتفعة غالبًا، لذا قد تؤدي مقارنة سعر الإدخال المعلن فقط إلى اختيار المزوّد الخطأ.
② TTFT (زمن الوصول إلى أول رمز) يعالج مشكلة «كم ينتظر المستخدم قبل أن يرى ردًا». تكون واجهات المحادثة والاستدعاءات المتعددة الجولات لأدوات الوكيل أكثر حساسية له، لأن كل جولة يجب أن تنتظر أول رمز أولًا.
③ الإنتاجية (Throughput) تقيس السرعة بعد بدء التوليد. تنظر الخوارزمية الجديدة إلى إنتاجية التوليد على مدى الاستجابة الكاملة، لا إلى الذروة اللحظية فقط. تتأثر بها أساسًا المهام ذات حجم الإخراج الكبير، مثل توليد النصوص الطويلة وإكمال الشيفرة.
④ حدود المعدل (Rate Limits) تركّز أساسًا على أخطاء HTTP 429، وتعالج مشكلة «نقص سعة المزوّد». إذا كان مزوّد ما يعيد 429 بشكل متكرر، فهذا يعني أن قدرته الحسابية محدودة، وستقلل خوارزمية التوجيه من حركة المرور المخصصة له.
⑤ الموثوقية (Reliability) تقيس تكرار فشل الطلبات. إذا كان معدل الأخطاء لدى مزوّد ما أعلى بوضوح من مزوّدين آخرين يقدّمون النموذج نفسه، فسيقلل النظام من توجيه الحركة إليه، وسيوقف حركة المرور مؤقتًا عند الحاجة حتى يتعافى.
⑥ جودة الاستجابة (Quality) تعالج مشكلة «النموذج نفسه، لكن الأداء يختلف بين عمليات النشر». وفق التوضيحات العامة الحالية، تتعلق إشارة الجودة أساسًا بما إذا كانت استدعاءات الأدوات تعود بشكل صحيح، وبما إذا كان الهيكل مطابقًا للمتطلبات. المزوّدون الذين تكون صيغة استدعاءات أدواتهم غير سليمة أو تكون دقة اختبارات القياس المرجعية لديهم متأخرة بوضوح ستُخفّض تنافسيتهم.
إلى جانب هذه المؤشرات الستة، تضع وثائق التوجيه الخاصة بـ OpenRouter نفسها سياسة البيانات ضمن القيود. على سبيل المثال، يمكن أن يستبعد data_collection: "deny" المزوّدين الذين لا يطابقون متطلبات جمع البيانات، وzdr: true يطلب استخدام نقطة نهاية لا تحتفظ بالبيانات. توضح وثائق الأمان لدى Hugging Face أنها لا تستخدم بيانات طلبات المستخدمين لتدريب النماذج، وأنها لا تحفظ جسم الطلب ولا الاستجابة أثناء التوجيه، وأن سجلات التصحيح تُحفظ لمدة 30 يومًا كحد أقصى ولا تحتوي على بيانات المستخدم أو الرموز (Tokens). لكنها تنبّه المطورين في الوقت نفسه إلى أن عليهم مراجعة سياسة أمان البيانات لدى المزوّد الفعلي. فالتزام المنصة لا يغني عن اتفاقية معالجة البيانات الخاصة بكل مزوّد.
بيانات تجربة توجيه OpenRouter والتنازلات
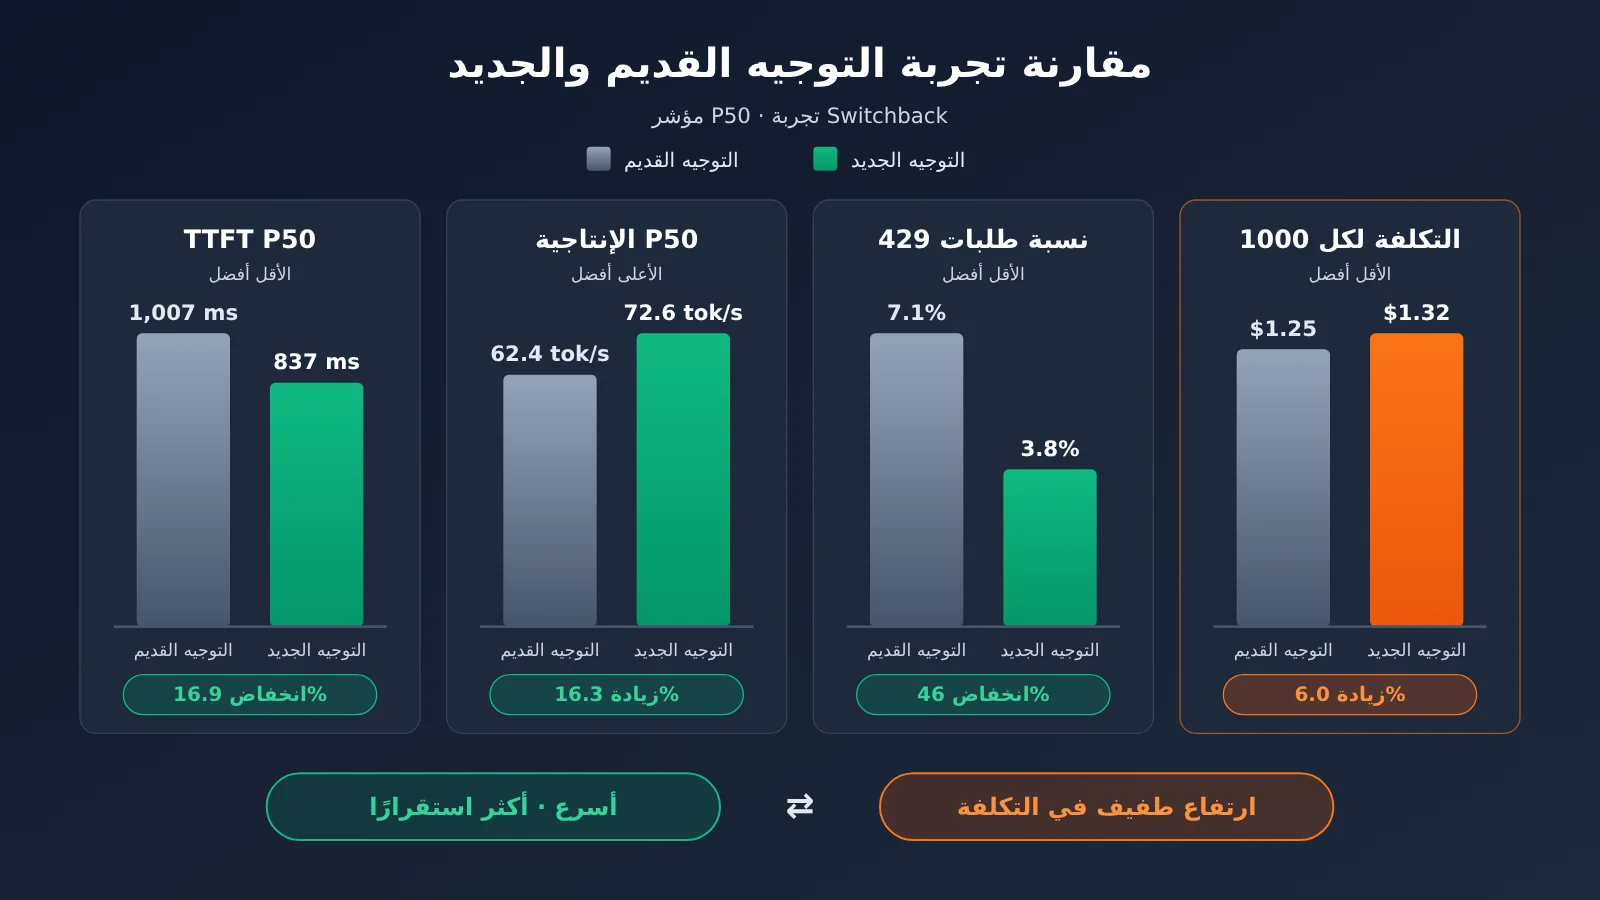
قبل إطلاق الخوارزمية الجديدة، أجرى OpenRouter في أكتوبر 2026 تجربة تبادلية (Switchback) استمرت أسبوعًا واحدًا. قُسّم كل يوم إلى كتل زمنية مدتها 3 ساعات، واستخدمت الكتل المتطابقة الخوارزمية القديمة والجديدة على التوالي، مع فترة تسخين مدتها ساعة واحدة بعد كل تبديل لا تُحتسب في القياس. بلغ الإجمالي أكثر من 24 مليون طلب و103 مليار توكن إدخال. استُخدمت التجربة التبادلية بدلًا من التوزيع العشوائي للمستخدمين، لأن الخوارزمية الجديدة حين تنقل حركة المرور بعيدًا عن مزوّد مثقل، تستفيد مجموعة الخوارزمية القديمة أيضًا، وهذا يشوّش المقارنة.
| المؤشر | التوجيه القديم | التوجيه الجديد | التغيير |
|---|---|---|---|
| TTFT P50 | 1,007 ms | 837 ms | انخفاض 16.9% |
| TTFT P95 | 4,601 ms | 3,733 ms | انخفاض 18.9% |
| الإنتاجية P50 | 62.4 tok/s | 72.6 tok/s | ارتفاع 16.3% |
| زمن الطلب الكامل P50 | 4.00 s | 3.24 s | انخفاض 19.0% |
| الطلبات التي تلقّت 429 مرة واحدة على الأقل | 7.1% | 3.8% | انخفاض 46% |
| الطلبات التي احتاجت إلى إعادة محاولة | 10.4% | 6.9% | انخفاض 34% |
| تكلفة كل ألف طلب | $1.25 | $1.32 | ارتفاع 6.0% |
| تكلفة كل مليون توكن | $0.301 | $0.324 | ارتفاع 7.3% |
تعكس هذه البيانات التنازل الأساسي في التوجيه الجديد: زيادة بنحو 6% في تكلفة كل ألف طلب، مقابل زمن استجابة أقل وأخطاء سعة أقل. ومن الضروري توضيح بعض القيود: التجربة صمّمها وأعلنها OpenRouter بنفسه، ولم تخضع لتدقيق طرف ثالث؛ والعينة مجموعة من النماذج المفتوحة التمثيلية، ولا تمثّل جميع النماذج والمزوّدين؛ والنتائج إحصاءات إجمالية، ولا تعني أن كل طلب سيحصل على تحسّن بنسبة 16.9%. كما أن هذه البيانات مأخوذة من تجربة OpenRouter قبل الشراكة، وليست قياسًا مستقلًا بعد إطلاق Hugging Face.
💡 نصيحة للاختبار: تجربة التوجيه تعطيك إحصاءات إجمالية، أما أداء عملك الخاص فعليك قياسه بنفسك. وإذا كنت بحاجة إلى مقارنة أفقية لجودة مخرجات عدة نماذج رئيسية وتكلفتها داخل الشيفرة نفسها، فيمكنك عبر APIYI apiyi.com استدعاؤها جميعًا بمفتاح API واحد؛ حدّد أولًا اختيارك على مستوى النموذج، ثم انتقل إلى التحسين على مستوى المزوّد.
كيف يبدّل النظام المزوّد عند تعطّله
التدفق النموذجي للتبديل التلقائي عند الفشل (Failover) هو: يختار الموجّه المزوّد A؛ فإن كان A سليمًا تُعاد النتيجة مباشرة؛ وإن أخطأ A أو واجه مشكلة في السعة، يحاول النظام المزوّد B في الطلب نفسه؛ وإن نجح B تُعاد النتيجة. في التجربة، انخفضت نسبة «الطلبات التي تحتاج إلى إعادة محاولة» من 10.4% إلى 6.9%، وتراجع الوقت الذي يستهلكه كل طلب في المحاولات الفاشلة من 349 ms إلى 242 ms. وهذا يدل على أن الموجّه الجيد لا يكفي أن يعرف كيف يعيد المحاولة، بل يجب أن يتجنّب قدر الإمكان المزوّدين في حالة غير مستقرة منذ البداية.
الرجوع التلقائي وتحديد المزوّد خياران يقيّد كل منهما الآخر. الموجّه الافتراضي يسمح بالتبديل، وبالتالي يمنح توافرًا أعلى. أما تحديد المزوّد فيثبّت الطلب على مزوّد واحد، ويلبّي متطلبات قبول الموردين، لكنه يفقد هامش التعافي من الكوارث. وتوفّر واجهة API الخاصة بـ OpenRouter نفسها المعامل only (السماح للمزوّد المحدّد فقط) إلى جانب allow_fallbacks: false (عدم الرجوع تلقائيًا)، وهو اقتران يسمح بفشل الطلب مباشرة عند غياب مزوّد مطابق، بدلًا من تحويله إلى مورد آخر. ويجب التمييز بين الأمرين: هذه معاملات واجهة OpenRouter الكاملة، ولا ينبغي فهمها على أنها تعني أن واجهة Hugging Face أصبحت متاحة بالكامل. القدرة المقابلة على جانب Hugging Face هي تحديد المزوّد وتعطيل المزوّد من الإعدادات.
لإعادة المحاولة تكلفة أيضًا، وليست بلا حدود:
- تكلفة الوقت: كل محاولة فاشلة تُطيل المدة الإجمالية، ولها تأثير واضح على التفاعل في الوقت الفعلي.
- الإخراج المتدفق: الاستجابة المتدفقة التي بدأ إخراجها لا يمكن متابعتها بسلاسة إلى مزوّد آخر.
- آثار جانبية مكررة: إذا كان استدعاء الأدوات قد فعّل إجراءً خارجيًا في المحاولة الأولى، فقد تتسبب إعادة المحاولة في تنفيذه مرة أخرى، وعليه يجب على التطبيق أن يعالج ذلك بنفسه لضمان عدم التكرار (idempotency).
- فقدان التخزين المؤقت: عادةً ما يرتبط Prompt Caching بمزوّد معيّن، وقد يؤدي تبديل المزوّد إلى خسارة فائدة التخزين المؤقت. ولهذا يوفّر Hugging Face ترويسة الطلب
X-HF-Session-Id، باستخدام UUID مستقر لتبقى الجلسة نفسها قدر الإمكان على المزوّد الذي يحتفظ بالتخزين المؤقت. - لا مزوّد متاح: إذا كان نموذج ما متوفرًا لدى مزوّد واحد فقط، أو كان المزوّدون الآخرون لا يدعمون المعاملات الحالية، فلا يوجد ما يمكن التبديل إليه. وبالمثل، لا يستطيع الموجّه حل مشكلات مثل عدم كفاية الحصة، أو نقص صلاحيات Token، أو طلب غير صالح، أو تجاوز حد السياق.
تغييرات فوترة Hugging Face ومفاتيح API الخاصة
يأتي هذا التعاون بتغيير جذري: عند استدعاء نماذج اللغة عبر Hugging Face، لم يعد بإمكانك استخدام مفتاح API الخاص بمزود الخدمة الذي أعددته بنفسك. تُوجَّه جميع الطلبات المرتبطة بذلك عبر OpenRouter، وتُحتسب الرسوم على حساب Hugging Face أو حساب المؤسسة. أما مفاتيح API الخاصة بمهام توليد الصور والفيديو فما زالت متاحة، ويُرجَع في التفاصيل إلى البيان الرسمي.
إذا أراد المطوّر مواصلة استخدام الرصيد الذي اشتراه من مزود الخدمة، فيمكنه استدعاء واجهة API الخاصة بذلك المزود مباشرة، أو التحوّل إلى حساب OpenRouter الخاص به. ووفقًا لصياغة وثائق BYOK الحالية لدى OpenRouter: تُقاس الحصة المجانية لـ BYOK بتكلفة كتالوج الاستدلال المكافئة، وهي 25,000 دولار شهريًا لحسابات الدفع حسب الاستخدام (Pay-as-you-go)، وحصة مخصّصة لحسابات Enterprise؛ ويُحتسب ما يتجاوز ذلك بنسبة 5% من تكلفة الاستدلال المكافئة، وتُخصم من أرصدة المنصة (Credits). الرقم 25,000 هنا هو تكلفة استدلال مقدّرة بالدولار، وليس عدد الطلبات. إضافةً إلى ذلك، قد يستهلك الرجوع إلى السعة المشتركة أرصدة المنصة. ويُعدّ الاتصال المباشر بـ OpenRouter علاقة حساب وفوترة مستقلة بحد ذاتها، ولا تنتقل المفاتيح القديمة إليه تلقائيًا.
في وثائق التسعير الحالية لـ Hugging Face، لا يحصل مستخدمو الخطة المجانية (Free) على حصة شهرية ثابتة، بينما يحصل مستخدمو PRO على دولارين شهريًا، ومستخدمو Team وEnterprise على دولارين لكل مقعد شهريًا. هذه الحصص عبارة عن أرصدة حوسبة عامة (Compute Credits) يمكن استخدامها لتغطية خدمات مثل Inference Providers وInference Endpoints وSpaces. وهناك نقطة جديرة بالانتباه: ثبات آلية تسعير المزود لا يعني ثبات تكلفة كل طلب، لأن التوجيه قد يختار مزودًا أعلى سعرًا قليلًا لكنه أسرع وأكثر استقرارًا.
كيف يمكن للمطورين مقارنة عدة مزوّدي خدمة بأنفسهم باستخدام واجهة برمجة تطبيقات الفهرس
توفّر Hugging Face واجهة برمجة تطبيقات قابلة للاستعلام لفهرس النماذج، وهي نافذة عامة يحصل منها نظام التوجيه على الأساس الذي يبني عليه قراراته:
- كل النماذج:
GET https://router.huggingface.co/v1/models - نموذج واحد:
GET https://router.huggingface.co/v1/models/deepseek-ai/DeepSeek-V4-Pro
| الحقل | المعنى | دوره في اختيار النموذج |
|---|---|---|
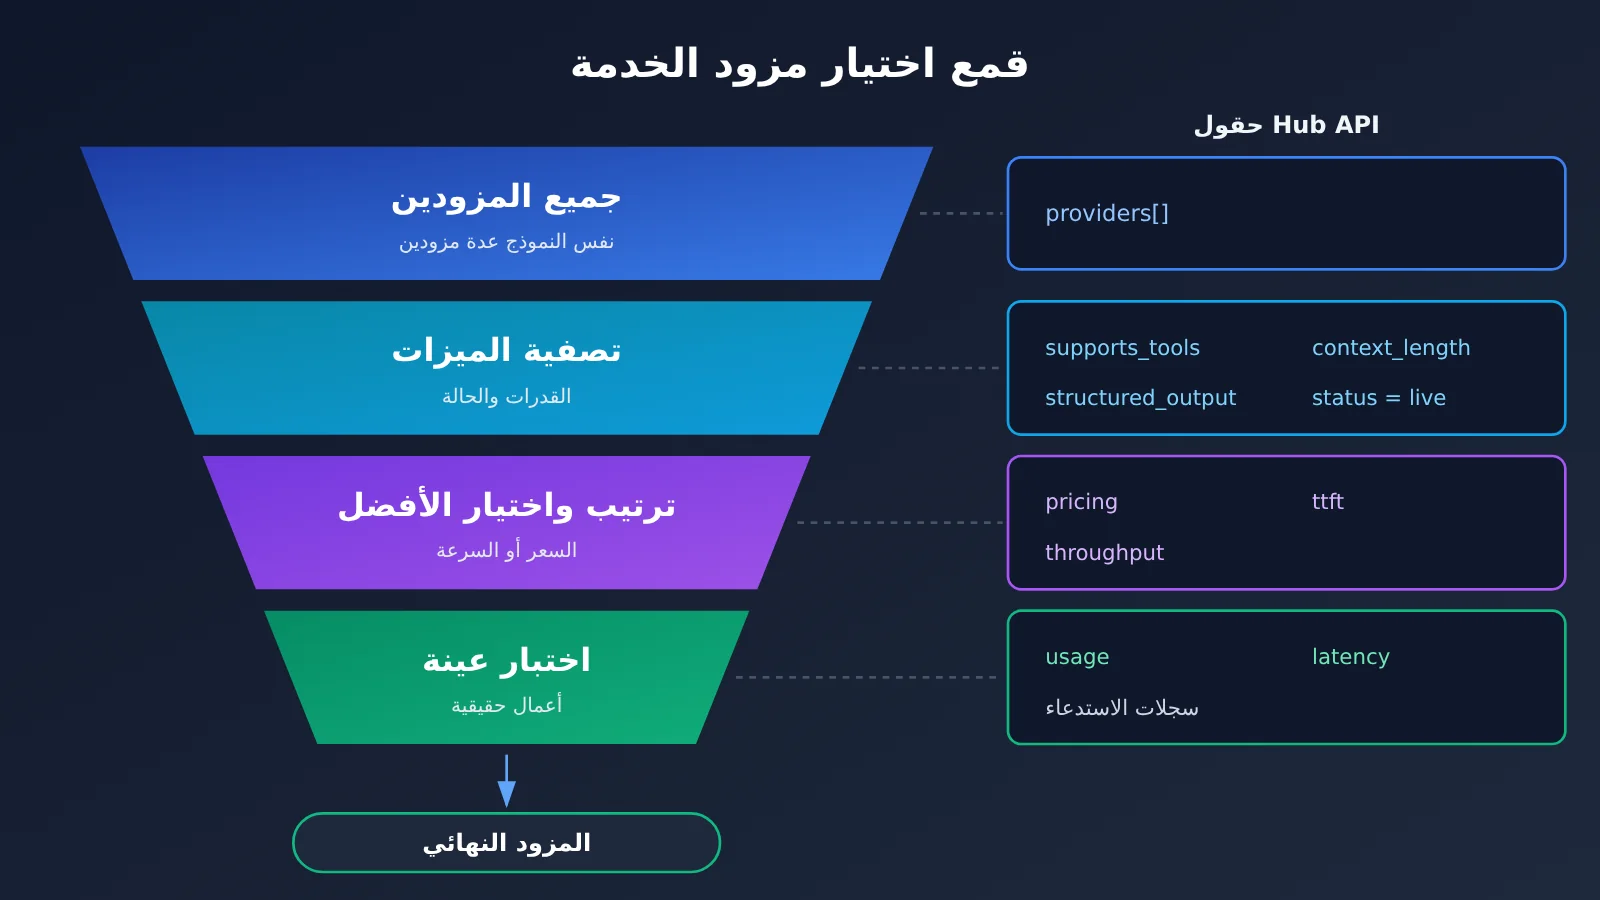
| provider | المزوّد الذي يقوم فعليًا بتشغيل الاستدلال | تحديد قائمة المرشحين |
| status | الحالة الحالية، مثل live أو error | استبعاد المزوّدين غير المتاحين |
| context_length | طول السياق الذي يدعمه هذا المزوّد | تصفية متطلبات السياق الطويل |
| pricing.input / pricing.output | سعر كل مليون Token إدخال أو إخراج بالدولار | الترتيب حسب التكلفة |
| supports_tools | هل يدعم استدعاء الأدوات | شرط أساسي في سيناريوهات الوكيل (Agent) |
| supports_structured_output | هل يدعم المخرجات المهيكلة | شرط أساسي لإخراج JSON |
| first_token_latency_ms | زمن الوصول إلى أول Token في آخر فحص تحقق | الترتيب في حالات الاستخدام التفاعلية |
| throughput | سرعة التوليد في آخر فحص تحقق | الترتيب في حالات المخرجات الطويلة |
| is_free / is_model_author | عرض مجاني مؤقت / هل المزوّد هو ناشر النموذج | مرجع مساعد |
لا يوفّر كل مزوّد هذه الحقول كاملةً، كما أن بيانات الأداء تأتي من آخر فحص تحقق ولا تعبّر بالضرورة عن الأداء الفعلي من طرف إلى طرف في بيئتك. الطريقة المعقولة هي «التصفية أولًا ثم الترتيب»: استخدم حقول القدرات لاستبعاد المزوّدين غير المتوافقين، ثم رتّب النتائج حسب التكلفة أو السرعة. يوضّح المثال التالي هذه الفكرة، أما بنية الاستجابة فارجع فيها إلى وثائق Hub API الرسمية:
import os
import requests

HF_TOKEN = os.environ["HF_TOKEN"]
MODEL = "deepseek-ai/DeepSeek-V4.1-Flash"

resp = requests.get(
    f"https://router.huggingface.co/v1/models/{MODEL}",
    headers={"Authorization": f"Bearer {HF_TOKEN}"},
    timeout=30,
)
data = resp.json()
providers = data.get("providers", [])  # البنية الدقيقة وفقًا للوثائق الرسمية

# الخطوة الأولى: تصفية القدرات (الوكيل يحتاج استدعاء الأدوات + مخرجات مهيكلة + سياق 64K)
candidates = [
    p for p in providers
    if p.get("status") == "live"
    and p.get("supports_tools")
    and p.get("supports_structured_output")
    and (p.get("context_length") or 0) >= 64_000
]

# الخطوة الثانية: الترتيب حسب سعر وحدة الإخراج، والحقول الغائبة تُوضع في النهاية
candidates.sort(key=lambda p: (p.get("pricing") or {}).get("output", float("inf")))

for p in candidates:
    print(p["provider"], p.get("pricing"), p.get("first_token_latency_ms"), p.get("throughput"))
بعد تصفية المرشحين، لا بد من اختبارهم مرة أخرى بطلبات أعمال حقيقية. فبيانات الفهرس الوصفية تقول فقط ما «يدّعي» المزوّد دعمه، ولا يمكنها أن تعوّض عن دقة نتائجك على مهامك الخاصة، ولا عن معدل نجاح استدعاء الأدوات، ولا عن معدل الإنجاز النهائي.
وقبل الضبط الدقيق على مستوى المزوّد، تحتاج عادةً إلى تحديد النموذج الذي ستستخدمه أولًا. يوضّح الكود التالي كيفية مقارنة إجابات عدة نماذج دفعةً واحدة عبر الواجهة نفسها المتوافقة مع OpenAI، مع استبدال معرّفات النماذج بالأسماء الفعلية من قائمة نماذج المنصة:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI الموحدة: مفتاح واحد لاستدعاء عدة نماذج
)

prompt = "用 JSON 返回:{\"city\": 城市名, \"reason\": 一句话理由},推荐一个适合冬季旅行的城市"

for model in ["model-id-a", "model-id-b", "model-id-c"]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, resp.usage.total_tokens, resp.choices[0].message.content)
🚀 بداية سريعة: يمكن للمستخدمين الجدد الحصول على حصة اختبار مجانية من APIYI عبر apiyi.com، وتشغيل مجموعة من عينات أعمالهم باستخدام الكود أعلاه. ستسجّل سجلات الاستدعاء في الخلفية النموذج المستخدم في كل طلب، واستهلاك الـ Tokens، والتكلفة؛ ما يسهّل حساب التكلفة الحقيقية للمهمة الواحدة بدل النظر إلى السعر المعلن فقط.
تجدر الإشارة إلى أن الوصول الموحّد مع سجلات الاستدعاء، وبيانات الأداء اللحظية على مستوى المزوّد (Provider) التي يعرضها Hugging Face، تنتمي إلى مستويات مختلفة من الوظائف: الأول يحل مسألة «القدرة على الاتصال والحساب بدقة»، والثاني يعرض الحالة الديناميكية لمزوّدي الخدمة الأساسيين. ويمكن استخدامهما معًا.
مزودو خدمات API المتعددون والتوجيه الذكي: تحليل وتقييم
أين تكمن المنافسة القادمة لمنصات تجميع API
إذا قسّمنا قدرات OpenRouter إلى طبقات، نجدها ثلاثًا: تجميع النماذج يحل مسألة “كيف نصل إلى نماذج مختلفة”، وتجميع مقدمي الخدمة يحل مسألة “من يقوم بالاستدلال لنفس النموذج”، والتوجيه الديناميكي يحل مسألة “لمن نُسلّم هذا الطلب تحديدًا”. الواجهة الموحدة حلّت مسألة الوصول إلى حد كبير، وهذا التعاون يكشف أن الطبقتين الثانية والثالثة أصبحتا نقطة التنافس الجديدة. ويستند هذا التقييم إلى أن Hugging Face اختارت التخلي عن بناء موجّه خاص بها والاعتماد على قدرات توجيه خارجية، كما أن OpenRouter نشرت خوارزمية التوجيه الخاصة بها بشكل منفصل، وأثبتت قيمتها عبر تجارب إنتاجية.
من المتوقع أن تصبح تحسين التكلفة والاستقرار وحوكمة البيانات أبعادًا جديدة للمقارنة بين منصات API. فيما يلي توقعات تنتظر التحقق اللاحق: سيزداد أهمية شفافية التوجيه، وسيرغب المطورون في معرفة أي مزود خدمة استقر عليه الطلب، ولماذا اختاره، وكم دفعوا مقابله؛ وقد تتحول قيود سياسات البيانات من خيار إضافي إلى شرط أساسي في مشتريات المؤسسات.
غير أن التوجيه ليس حلًا سحريًا لكل شيء. تُظهر بيانات التجارب أن الثمن الحقيقي للسرعة والاستقرار الأعلى هو تكلفة وحدة أعلى. كما أن الخطط المستقبلية المذكورة في إعلان التعاون (مثل ربط الحسابات بين الجانبين، وإدخال مزيد من المهام ضمن توجيه OpenRouter) لا تزال مجرد خطط. ولا يستطيع التوجيه أن يحل مشكلات جودة النموذج نفسه، ولا الترخيص، ولا مدى ملاءمته لأعمال معينة.
الطلب على النماذج مفتوحة الأوزان وضغوط التكاليف على المؤسسات
تدعم بيانات جانب الطلب الحكم القائل بأن «جدولة المزودين أصبحت مهمة». تُظهر إحصاءات OpenRouter أن حصة النماذج مفتوحة الأوزان بلغت 71.7%، بحسب حجم الرموز الأسبوعي لأعلى 50 نموذجًا في 28 سبتمبر 2026. وهذا مقياس إحصائي داخل منصة OpenRouter، ولا يمكن تعميمه على الحصة السوقية العالمية. وكلما زاد استخدام النماذج مفتوحة الأوزان، زاد شيوع وجود عدة مزودين للنموذج نفسه، وباتت قيمة التوجيه أوضح.
وعلى جانب التكلفة، استطلعت Capgemini آراء 500 من كبار المسؤولين التنفيذيين (CXO) في المؤسسات الكبيرة في سبتمبر 2026، وقال 59% منهم إن إنفاقهم على الذكاء الاصطناعي يتجاوز التوقعات بوضوح؛ وفي الشركات المتأثرة، بلغ متوسط تجاوز الميزانية 24%. وهذه الأرقام تمثل عينة ذلك الاستطلاع فقط، لكنها إذا وُضعت إلى جانب نتيجة تجربة التوجيه بأن «تحسن السرعة يأتي مصحوبًا بارتفاع التكلفة»، فإنها تذكّر المؤسسات بأن التوجيه التلقائي يسعى افتراضيًا إلى تجربة متكاملة، وليس بالضرورة إلى أقل فاتورة. أما الأعمال الحساسة للتكلفة فعليها أن تختار بنشاط استراتيجية أولوية السعر أو تحدد سقفًا للسعر، وأن تتحقق باستمرار من خلال سجلات الاستدعاء.
كيف تختار كل فئة من المستخدمين ما يناسبها؟
- المطورون الأفراد والفرق الصغيرة: التوجيه التلقائي الافتراضي يغنيك بالفعل عن بناء آلية التعافي من الأعطال بنفسك، لذا ركّز على التحقق من استقرار استدعاء الأدوات ومخرجات JSON باستخدام عينات حقيقية. ابدأ بتحديد النموذج عبر واجهة موحدة مثل APIYI (apiyi.com)، ثم حسّن على مستوى مزود الخدمة عند الحاجة؛ فهذا مسار منخفض التكلفة.
- المنتجات التفاعلية: ركّز أولاً على TTFT P95 بدلاً من الإنتاجية. قد لا يحسّن
:fastestتجربة الردود القصيرة. - المهام ذات المخرجات الطويلة والمعالجة الدفعية: تكون الإنتاجية والسعر الفعلي أكثر أهمية، ويمكنك اعتماد استراتيجية إعطاء الأولوية للسعر، والاستفادة من ثبات الجلسة للحفاظ على مكاسب التخزين المؤقت.
- فرق المؤسسات والمنصات: ابدأ بجرد التطبيقات التي تعتمد على Provider Key خاص بها، والأعمال التي يجب تثبيت مزود خدمة معين لها، ثم قرّر ما إذا كنت ستسمح بالرجوع إلى مزود بديل، أو تقيّد التعامل بمزود خدمة معين، أو تتصل بالمزود مباشرة. ويجب مراجعة اتفاقيات معالجة البيانات لدى كل مزود على حدة.
أيًا كانت الاستراتيجية التي تختارها، فلا بد أن ينتهي الأمر إلى الخطوة نفسها: أن تجرّب طلباتك ومؤشراتك الخاصة في جولة اختبار. وسواء استخدمت الحصة المجانية على APIYI (apiyi.com) لعقد مقارنة صغيرة، أو استخدمت API كتالوج Hugging Face لتصفية مزودي الخدمة المرشحين أولاً، فإن كليهما نقطة بداية منخفضة التكلفة. إن نسبة 16.9% في التجربة الرسمية هي متوسط إجمالي، ولن تعرف مقدار ما يمكن أن تحققه أعمالك إلا بعد الاختبار.
لا يُعرف جودة البودينغ إلا عند تناوله. (النتائج الفعلية لا تُثبت إلا بالتجربة العملية.)