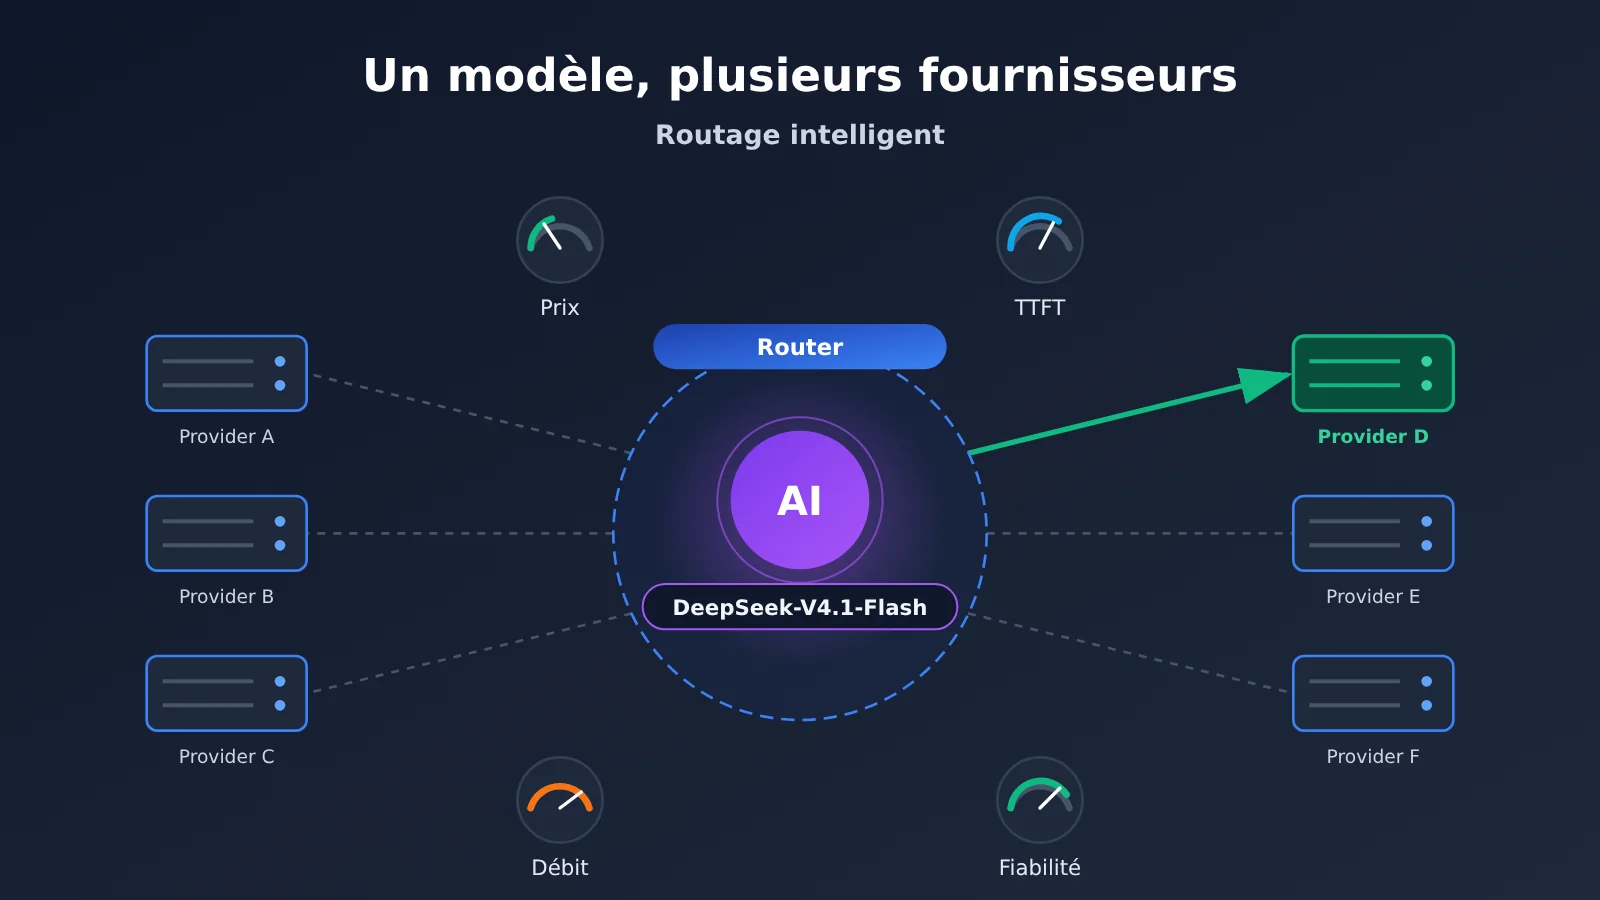
Réponse directe : Un même modèle à poids ouverts peut être déployé séparément par de nombreux fournisseurs d’inférence, ce qui explique l’existence de dizaines de services API. OpenRouter ne se contente pas de regarder qui affiche le prix le plus bas : il sélectionne le fournisseur en fonction du coût global d’une réponse réellement exploitable. Il évalue simultanément six indicateurs — prix réellement appliqué, latence du premier token, débit, limites de débit, fiabilité et qualité de la réponse — puis confie la requête au Provider le plus approprié du moment, et bascule vers un autre en cas d’échec avec nouvelle tentative.
Cela montre que la concurrence dans l’agrégation d’API AI est passée de « fournir une interface unifiée » à « planifier dynamiquement les fournisseurs ». Le 16 novembre 2026, Hugging Face a annoncé confier le routage de ses modèles de langage Inference Providers à OpenRouter. Cette collaboration fournit un échantillon concret pour comprendre comment ces indicateurs se traduisent en un mécanisme automatique de sélection des fournisseurs.
Ce que vous apprendrez en lisant cet article :
- Pourquoi un même modèle AI peut avoir plusieurs fournisseurs API, et quelle est la différence entre le développeur du modèle et le fournisseur d’inférence
- Sur quels indicateurs de décision repose le routage des Providers, et quel problème chacun résout
- Ce que permet le basculement en cas de panne, et quelles sont ses limites
- Comment utiliser les métadonnées de l’API du catalogue de modèles Hugging Face pour comparer soi-même les différents fournisseurs
Index : La partie factuelle se déroule dans l’ordre suivant : d’abord l’origine des multiples fournisseurs API, puis le décryptage des objets de décision et des six indicateurs du routage intelligent, ensuite le déroulement et les limites du basculement en cas d’échec, enfin une démonstration de la façon dont les développeurs peuvent comparer eux-mêmes les Providers via l’interface du catalogue — avec, en filigrane, les données d’expérimentation de routage et les changements de tarification publiés par OpenRouter. La partie analyse et jugement aborde la prochaine direction de la concurrence entre plateformes d’agrégation d’API, ainsi que la manière dont les développeurs devraient arbitrer et valider dans leurs applications.
Les concepts à connaître sur les fournisseurs d’API multiples et le routage par Provider
| Concept | Explication rapide |
|---|---|
| Provider | Fournisseur qui déploie le modèle et assure réellement le service d’inférence, par exemple Together AI, Novita |
| Router | Couche de routage qui décide de la destination d’une requête selon les conditions de la demande et l’état des fournisseurs disponibles |
| Modèle à poids ouverts | Modèle dont les poids après entraînement sont publics et que l’on peut déployer soi-même selon sa licence |
| TTFT | Time to First Token, le temps d’attente entre l’envoi de la requête et le retour du premier Token |
| Débit | Nombre de Tokens générés par unité de temps, généralement exprimé en tok/s |
| Failover | Bascule automatique vers un autre fournisseur avec nouvelle tentative lorsque le fournisseur courant échoue |
| Prompt Caching | Le fournisseur met en cache les entrées répétées afin de réduire le coût de calcul et le temps de réponse |
| BYOK | Bring Your Own Key : utiliser sa propre clé de fournisseur et le quota du compte correspondant |
| P50 / P95 | Quantiles statistiques : P50 est la médiane, P95 reflète les 5 % de requêtes les plus lentes |
Aperçu rapide des impacts du changement de routage entre fournisseurs d’API
- Développeurs : côté Hugging Face, le code et les Tokens n’ont en principe pas besoin d’être modifiés, mais le fournisseur réellement utilisé est déterminé par le routage : un même ID de modèle peut, selon la requête, aboutir chez un Provider différent. Les applications qui s’appuient sur l’appel d’outils ou sur des sorties structurées doivent repasser par des tests de non-régression. Pour les développeurs qui avaient configuré dans Hugging Face une clé de fournisseur pour leur propre modèle de langage, cette voie est désormais fermée : il faut reconfirmer la clé et l’attribution de la facturation.
- Achats d’entreprise et équipes plateforme : l’admission des fournisseurs, les stratégies de tolérance aux pannes et les conditions de traitement des données doivent être réévaluées. Une organisation peut désactiver un Provider donné, mais cela ne signifie pas pour autant qu’elle obtient une garantie complète de résidence des données ou de conformité : il faut encore vérifier, fournisseur par fournisseur, les politiques de données.
Un même modèle d’IA chez plusieurs fournisseurs d’API : les faits objectifs
Pourquoi un même modèle peut avoir plusieurs fournisseurs d’API
Le développeur du modèle et le fournisseur d’inférence sont deux rôles distincts. Le développeur entraîne le modèle et publie les poids. Pour un modèle à poids ouverts, toute organisation disposant de la puissance de calcul nécessaire et respectant les conditions de la licence peut déployer les poids sur ses propres clusters GPU et exposer une API. Ainsi, des modèles comme DeepSeek, Qwen ou GLM tournent souvent en même temps sur les infrastructures d’inférence de plusieurs fournisseurs.
Prenons l’exemple de deepseek-ai/DeepSeek-V4.1-Flash : le développeur demande le même nom de modèle, mais l’inférence peut en réalité être exécutée par Together AI, Novita ou un autre fournisseur qui prend en charge ce modèle. Chaque fournisseur utilise un matériel, une taille de cluster, des méthodes d’ordonnancement et une politique tarifaire différents ; le prix, la vitesse et la capacité de charge d’un même modèle peuvent donc varier. Certains proposent des tarifs bas mais appliquent facilement des limitations de débit aux heures de pointe ; d’autres renvoient rapidement le premier token, prennent en charge une fenêtre de contexte plus longue ou offrent une meilleure prise en charge du format d’appel des outils.
Les chiffres de volume montrent à quel point ce marché est fragmenté. Dans l’annonce de son partenariat, OpenRouter indique que sa plateforme dans son ensemble prend en charge plus de 600 modèles, est connectée à plus de 80 fournisseurs, traite plus de 800 000 milliards de tokens par mois et sert plus de 10 millions d’utilisateurs. Ces données concernent l’ensemble de la plateforme OpenRouter, et non les volumes apportés par ce seul partenariat. La page des fournisseurs de Hugging Face liste également plus d’une dizaine de services comme Baseten, Cerebras, DeepInfra, Fireworks, Nebius, Novita ou Together AI, mais les fournisseurs disponibles diffèrent selon les modèles.
Quand un modèle est proposé par plusieurs fournisseurs dont les conditions évoluent en temps réel, la question « à qui confier cette requête ? » devient une décision à prendre en continu. C’est de là que vient le routage multi-fournisseurs.
Ce que décide réellement le routage intelligent
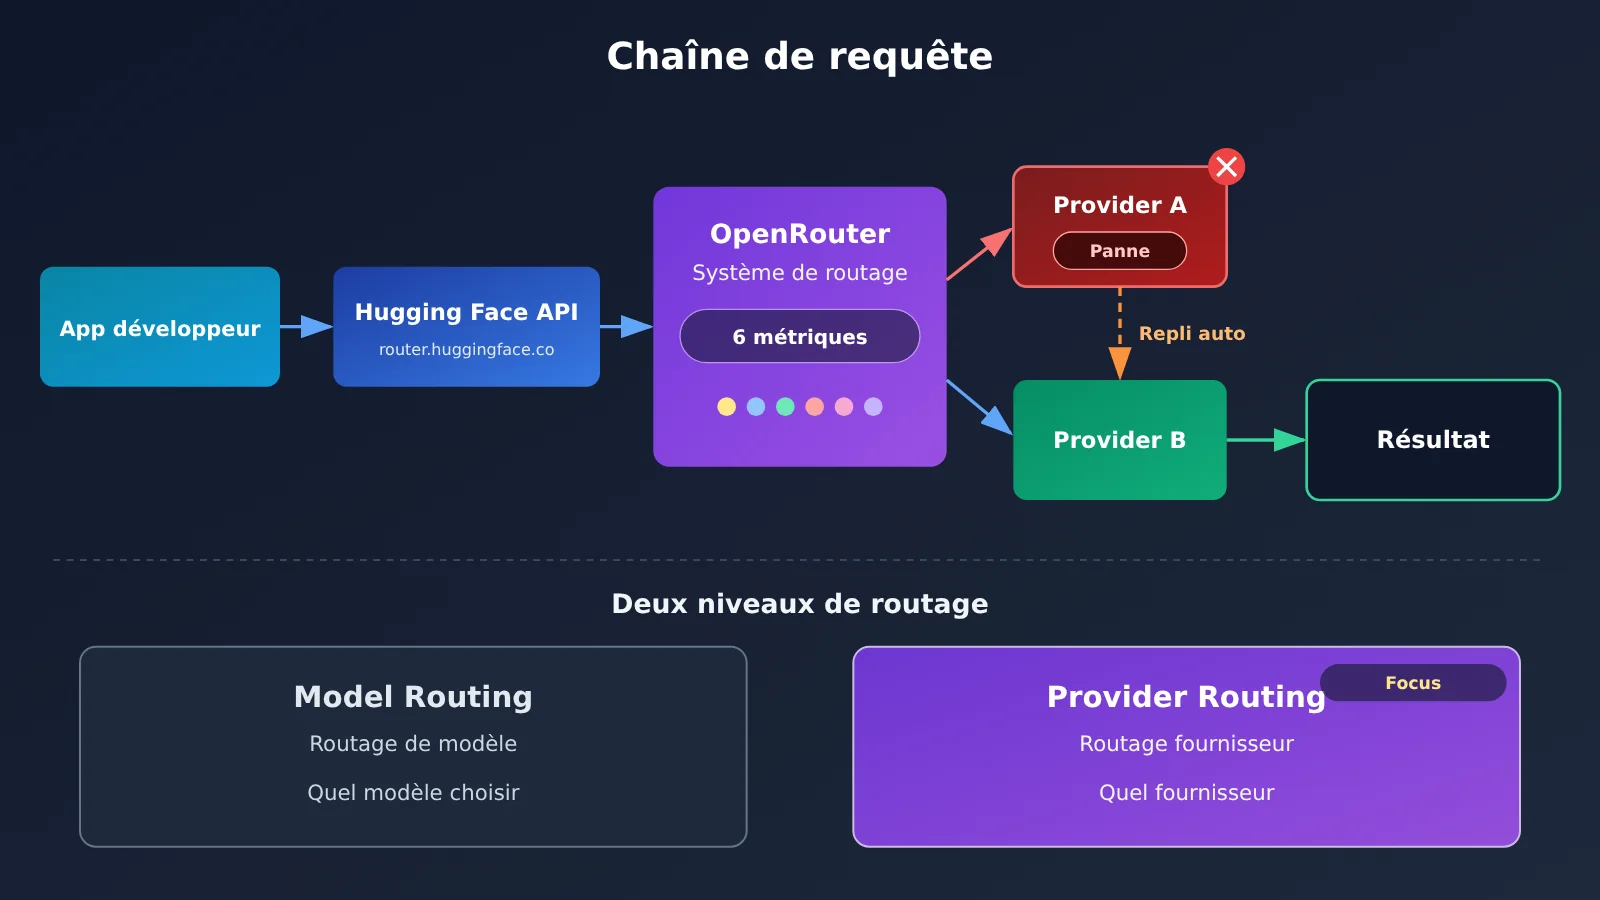
Commençons par distinguer deux concepts qu’on confond facilement. Le Model Routing (routage de modèle) décide quel modèle répond : une question simple part vers un petit modèle, une question complexe vers un grand modèle. Le Provider Routing (routage de fournisseur) intervient une fois le modèle choisi : il décide quel fournisseur exécute l’inférence. Le partenariat OpenRouter × Hugging Face dont on parle ici relève du second cas : le modèle est désigné par le développeur, la couche de routage ne fait que choisir le fournisseur, elle ne change jamais le modèle à votre place.
Après ce rapprochement, le parcours d’une requête vers un modèle de langage ressemble à ceci : application développeur ou Coding Agent → API Hugging Face (router.huggingface.co) → système de routage OpenRouter → inférence chez un Provider → retour du résultat. OpenRouter se charge du routage de la requête et de la sélection du fournisseur, mais n’exécute pas lui-même l’inférence de tous les modèles. L’utilisateur continue d’utiliser un Token Hugging Face, et la facturation passe par le compte Hugging Face ou le compte de l’organisation. Hugging Face indique ne pas appliquer de marge supplémentaire sur le prix d’inférence des Providers.
Côté contrôle, Hugging Face propose trois niveaux :
- Routage automatique par défaut : le client officiel utilise
provider="auto", et le système choisit le fournisseur en combinant prix, vitesse et fiabilité. - Provider imposé : par exemple
provider="together", ou un suffixe:novitaajouté après l’ID du modèle, pour que la requête soit systématiquement confiée à ce fournisseur. - Routage par stratégie : l’interface compatible OpenAI accepte les suffixes
:cheapest(priorité au prix) et:fastest(priorité au débit).
À noter : :fastest optimise le débit, pas la « rapidité » au sens large. Le TTFT, la vitesse de génération et le temps total de la requête sont trois indicateurs différents. Pour une réponse courte de une ou deux phrases, c’est souvent le délai du premier token qui pèse le plus sur le ressenti, davantage que le débit.
| Élément comparé | Routage Hugging Face d’origine | Nouveau routage OpenRouter |
|---|---|---|
| Système de routage | Routeur interne Hugging Face | OpenRouter |
| Choix du Provider | Mécanisme de sélection d’origine | Évaluation complète en temps réel |
| Base de prix | Politique tarifaire d’origine | Prix effectif réel |
| Facteur vitesse | Mécanisme de performance d’origine | Intègre le TTFT et le débit |
| Échec ponctuel | Peut renvoyer directement une erreur | Possibilité de réessayer un autre Provider dans la même requête |
| Cache de session | Politique d’origine | Maintien du Provider par session |
| Identifiants utilisateur | Token Hugging Face | Token Hugging Face conservé |
Quels indicateurs surveiller pour un système de routage multi-fournisseurs qui tient la route
OpenRouter a dévoilé le 28 octobre 2026 la nouvelle génération de son algorithme Provider Routing. L’ancien routage par défaut s’appuyait largement sur le prix affiché des tokens d’entrée, ce qui donnait plus de trafic aux fournisseurs bon marché. Le nouvel algorithme combine les six catégories de signaux ci-dessous en un coût de routage (Routing Cost) calculé en temps réel, avec pour objectif d’optimiser le coût global d’une « réponse réussie et exploitable du premier coup », plutôt que de courir simplement après le tarif unitaire le plus bas.
① Effective Price (prix effectif réel) : il répond à un constat simple — un tarif affiché bas ne signifie pas une facture basse. Il combine les trois prix unitaires (entrée non mise en cache, entrée mise en cache, sortie) en tenant compte du ratio entrée/sortie réel des requêtes et du taux de succès du cache chez ce fournisseur. L’exemple donné par OpenRouter : 40 000 tokens d’entrée non mis en cache ($2/M) = $0.080, 60 000 tokens d’entrée mis en cache ($0.50/M) = $0.030, 4 000 tokens de sortie ($8/M) = $0.032, soit un total de $0.142. Dans les scénarios d’agents, la part d’entrée mise en cache est souvent très élevée : comparer uniquement le prix affiché de l’entrée peut donc conduire à choisir le mauvais fournisseur.
② TTFT (latence du premier token) : il répond à la question « combien de temps l’utilisateur attend-il avant de voir une réponse ? ». Les interfaces de chat et les appels d’outils à plusieurs tours des agents y sont les plus sensibles, car chaque tour commence par l’attente du premier token.
③ Throughput (débit) : il mesure la vitesse une fois la génération lancée. Le nouvel algorithme considère le débit de génération sur l’ensemble du processus de réponse, et pas seulement le pic instantané. Les tâches à forte production de sortie, comme la génération de textes longs ou la complétion de code, en dépendent principalement.
④ Rate Limits (limites de débit) : l’accent est mis sur les erreurs HTTP 429, pour traiter le problème du « manque de capacité » d’un fournisseur. Si un Provider renvoie fréquemment des 429, c’est le signe que sa puissance de calcul est sous tension : le routage réduit alors le trafic qui lui est alloué.
⑤ Reliability (fiabilité) : elle mesure la fréquence des échecs de requête. Si le taux d’erreur d’un fournisseur est nettement supérieur à celui des autres fournisseurs du même modèle, le système réduit la part de trafic dirigée vers lui et, si nécessaire, la suspend jusqu’au retour à la normale.
⑥ Quality (qualité) : il répond au problème de la « même modèle, mais des performances différentes selon le déploiement ». D’après la documentation publique actuelle, les signaux de qualité portent surtout sur la capacité des appels d’outils à répondre correctement et sur la conformité de la structure aux attentes. Les fournisseurs dont le format d’appel d’outils est anormal ou dont la précision sur les benchmarks est nettement en retard voient leur compétitivité revue à la baisse.
Au-delà de ces six indicateurs, la documentation de routage d’OpenRouter intègre aussi la politique de données parmi les contraintes. Par exemple, data_collection: "deny" permet d’exclure les Providers qui ne respectent pas les exigences en matière de collecte de données, et zdr: true impose l’utilisation d’un endpoint à rétention nulle (zero data retention). La documentation de sécurité de Hugging Face précise qu’elle n’utilise pas les données des requêtes des utilisateurs pour entraîner ses modèles, qu’elle ne conserve ni le corps des requêtes ni celui des réponses lors du routage, et que les journaux de débogage sont conservés 30 jours au maximum, sans données utilisateur ni tokens. Elle rappelle toutefois aux développeurs qu’il faut quand même consulter la politique de sécurité des données du Provider réellement utilisé : l’engagement d’une plateforme ne remplace pas l’accord de traitement des données propre à chaque fournisseur.
Données et compromis de l’expérience de routage OpenRouter
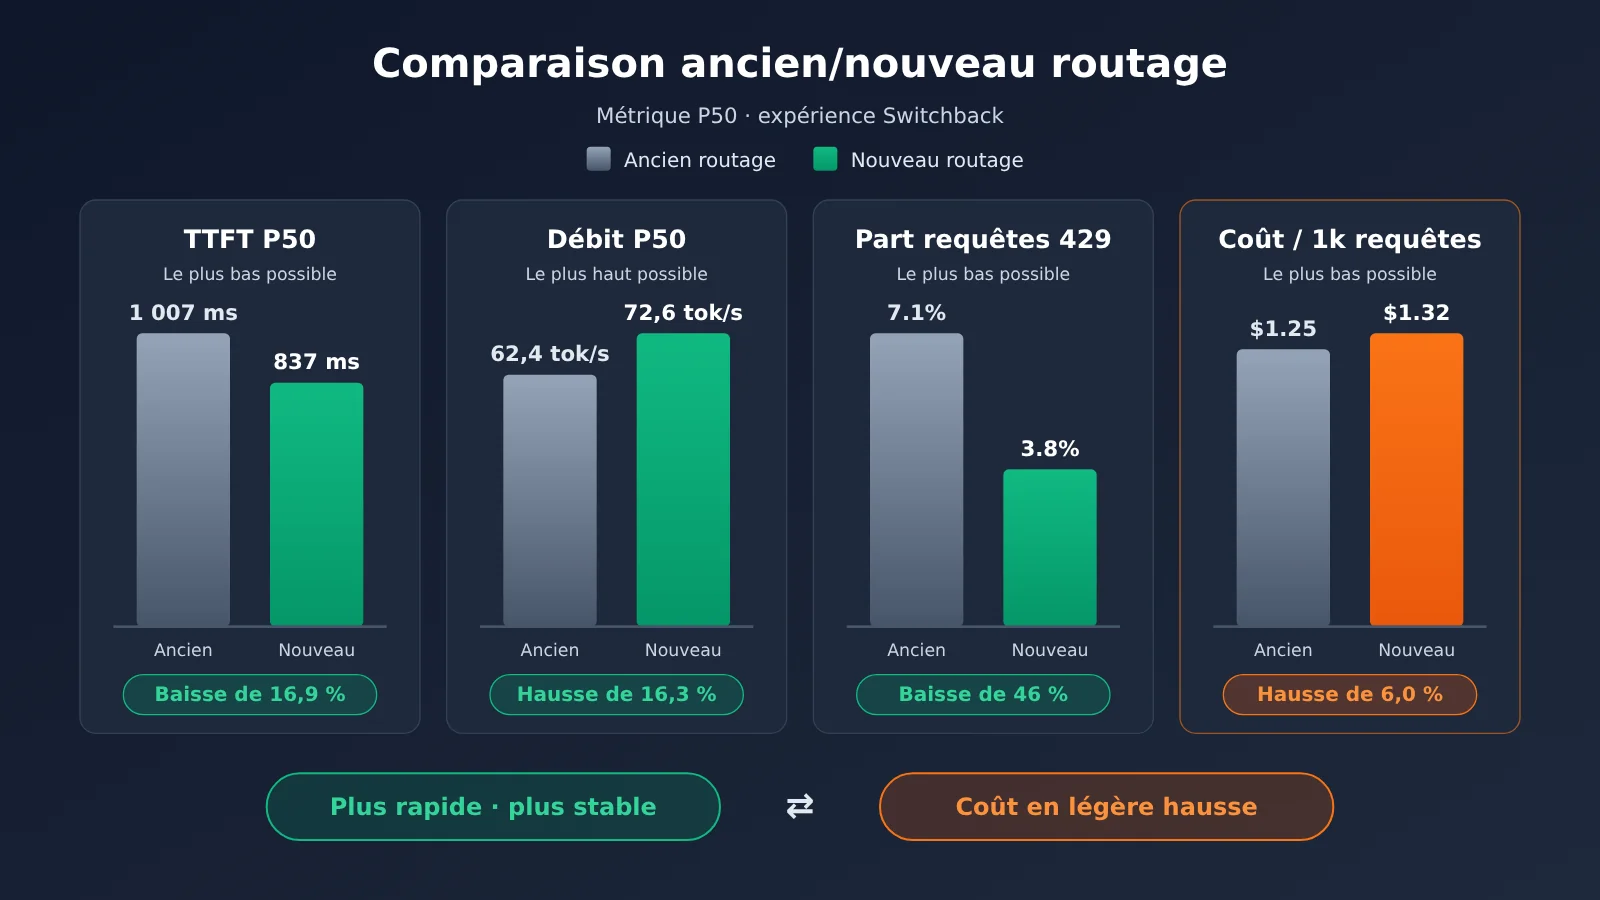
Avant le lancement du nouvel algorithme, OpenRouter a mené en octobre 2026 une expérience alternée de type switchback d’une semaine. Chaque journée était découpée en blocs de 3 heures, les blocs appariés utilisant respectivement l’ancien et le nouvel algorithme. Après chaque bascule, une période de préchauffage d’une heure n’était pas prise en compte dans les mesures. Au total : plus de 24 millions de requêtes et 103 milliards de tokens d’entrée. L’expérience alternée a été choisie plutôt qu’une répartition aléatoire des utilisateurs, car le nouvel algorithme détourne le trafic des fournisseurs en surcharge ; le groupe utilisant l’ancien algorithme en bénéficie donc aussi, ce qui fausserait la comparaison.
| Indicateur | Ancien routage | Nouveau routage | Variation |
|---|---|---|---|
| TTFT P50 | 1 007 ms | 837 ms | Baisse de 16,9 % |
| TTFT P95 | 4 601 ms | 3 733 ms | Baisse de 18,9 % |
| Débit P50 | 62,4 tok/s | 72,6 tok/s | Hausse de 16,3 % |
| Durée complète de requête P50 | 4,00 s | 3,24 s | Baisse de 19,0 % |
| Requêtes avec au moins un 429 | 7,1 % | 3,8 % | Baisse de 46 % |
| Requêtes nécessitant une nouvelle tentative | 10,4 % | 6,9 % | Baisse de 34 % |
| Coût pour 1 000 requêtes | 1,25 $ | 1,32 $ | Hausse de 6,0 % |
| Coût par million de tokens | 0,301 $ | 0,324 $ | Hausse de 7,3 % |
Ces données illustrent le compromis central du nouveau routage : environ 6 % d’augmentation du coût pour 1 000 requêtes, en échange de latences plus faibles et de moins d’erreurs de capacité. Quelques limites méritent d’être précisées : l’expérience a été conçue et publiée par OpenRouter elle-même, sans audit indépendant ; l’échantillon est un ensemble représentatif de modèles ouverts, et ne représente pas tous les modèles ni tous les fournisseurs ; les résultats sont des statistiques globales, et ne signifient pas que chaque requête bénéficiera d’une amélioration de 16,9 %. Ces données proviennent d’une expérience OpenRouter antérieure au partenariat, et non de mesures indépendantes réalisées après le lancement de Hugging Face.
💡 Conseil de test : L’expérience de routage fournit des statistiques globales ; les performances de votre propre activité doivent être mesurées par vous-même. Si vous devez comparer horizontalement la qualité et le coût des sorties de plusieurs grands modèles dans le même code, vous pouvez passer par APIYI apiyi.com pour effectuer des appels unifiés avec une seule clé API. Commencez par fixer le choix au niveau du modèle, puis envisagez l’optimisation au niveau du fournisseur.
Comment le système bascule en cas de défaillance d’un fournisseur
Le processus typique de basculement automatique (failover) est le suivant : le routeur sélectionne le fournisseur A ; si A fonctionne, la réponse est renvoyée directement ; si A renvoie une erreur ou rencontre un problème de capacité, le système essaie le fournisseur B dans la même requête ; si B réussit, le résultat est renvoyé. Dans l’expérience, les « requêtes nécessitant une nouvelle tentative » sont passées de 10.4% à 6.9%, et le temps consacré par requête aux tentatives échouées est passé de 349 ms à 242 ms. Cela montre qu’un bon routage ne doit pas seulement savoir réessayer : il doit aussi éviter autant que possible, dès le départ, les fournisseurs en mauvaise posture.
Le repli automatique et la désignation d’un fournisseur sont deux choix qui se limitent mutuellement. Le routage par défaut autorise le changement, ce qui offre une meilleure disponibilité. La désignation d’un fournisseur fige en revanche les requêtes sur un seul prestataire, ce qui permet de répondre aux exigences d’agrément des fournisseurs, mais supprime toute marge de reprise après incident. L’API d’OpenRouter propose la combinaison only (n’autoriser que le fournisseur indiqué) et allow_fallbacks: false (ne pas basculer automatiquement), ce qui permet à une requête d’échouer directement lorsqu’aucun fournisseur conforme n’est disponible, au lieu d’être transmise à un autre fournisseur. Il faut bien distinguer : ce sont des paramètres de l’API complète d’OpenRouter, et il ne faut pas en déduire que l’interface Hugging Face les expose tous. Côté Hugging Face, les capacités correspondantes consistent à désigner un fournisseur et à en désactiver un dans les paramètres.
Réessayer a aussi un coût, et ce n’est pas illimité :
- Coût en temps : chaque tentative échouée allonge la durée totale, avec un impact visible sur les interactions en temps réel.
- Sortie en streaming : une réponse en streaming dont la sortie a déjà commencé ne peut pas être reprise de façon transparente chez un autre fournisseur.
- Effets secondaires dupliqués : si un appel d’outil a déjà déclenché une action externe lors de la première tentative, une nouvelle tentative peut provoquer une exécution en double ; l’application doit gérer elle-même l’idempotence.
- Perte de cache : la mise en cache des invites (Prompt Caching) est généralement liée à un fournisseur précis ; changer de fournisseur peut faire perdre les bénéfices du cache. Pour cela, Hugging Face fournit l’en-tête de requête
X-HF-Session-Id, qui utilise un UUID stable pour garder autant que possible une même session sur le fournisseur qui détient le cache. - Aucun fournisseur disponible : si un modèle n’a qu’un seul fournisseur, ou si les autres fournisseurs ne prennent pas en charge les paramètres actuels, il n’y a rien vers quoi basculer. Les problèmes de quota insuffisant, d’autorisations de jetons insuffisantes, de requête invalide ou de contexte dépassé ne sont pas non plus résolus par le routage.
Évolution de la facturation Hugging Face et des clés API personnelles
Cette collaboration introduit un changement incompatible : lorsque vous appelez un modèle de langage via Hugging Face, vous ne pouvez plus utiliser votre propre clé API de fournisseur configurée. Toutes les requêtes concernées sont acheminées via OpenRouter, et les coûts sont imputés à votre compte Hugging Face ou à celui de votre organisation. Les clés API personnelles restent utilisables pour les tâches de génération d’images et de vidéos ; pour les détails, référez-vous aux indications officielles.
Si un développeur souhaite continuer à utiliser le quota acheté auprès de son fournisseur, il peut appeler directement l’API de ce fournisseur ou passer à son propre compte OpenRouter. Selon la documentation BYOK actuelle d’OpenRouter, l’allocation gratuite de BYOK est mesurée sur la base du coût équivalent du catalogue d’inférence : 25 000 dollars par mois pour un compte Pay-as-you-go, et un quota personnalisé pour Enterprise. Au-delà, la facturation correspond à 5 % du coût d’inférence équivalent, prélevé sur les Credits de la plateforme. Ces 25 000 dollars représentent un coût d’inférence exprimé en dollars, et non un nombre de requêtes. Par ailleurs, un basculement vers la capacité partagée peut consommer des Credits de la plateforme. Un accès direct à OpenRouter relève d’un autre ensemble de relations de compte et de facturation ; vos clés existantes ne sont pas migrées automatiquement.
Dans la documentation tarifaire actuelle de Hugging Face, les utilisateurs Free ne bénéficient pas d’une allocation mensuelle fixe offerte ; les utilisateurs PRO reçoivent 2 $ par mois, et les offres Team et Enterprise 2 $ par siège et par mois. Ces crédits sont des Compute Credits génériques, qui peuvent servir à couvrir des services comme Inference Providers, Inference Endpoints ou Spaces. Un autre point mérite attention : le fait que le mécanisme de tarification des fournisseurs reste inchangé ne signifie pas que le coût de chaque requête reste le même, car le routage peut choisir un fournisseur un peu plus cher, mais plus rapide et plus stable.
Comment les développeurs peuvent comparer eux-mêmes plusieurs fournisseurs avec l’API de catalogue
Hugging Face propose une interface de catalogue de modèles interrogeable : c’est une fenêtre publique par laquelle le système de routage obtient ses critères de décision :
- Tous les modèles :
GET https://router.huggingface.co/v1/models - Un seul modèle :
GET https://router.huggingface.co/v1/models/deepseek-ai/DeepSeek-V4-Pro
| Champ | Signification | Rôle dans le choix |
|---|---|---|
| provider | Le fournisseur qui assure réellement l’inférence | Détermine la liste des candidats |
| status | État actuel, par ex. live, error | Élimine les fournisseurs indisponibles |
| context_length | Longueur de contexte prise en charge par ce fournisseur | Filtre les besoins de contexte long |
| pricing.input / pricing.output | Prix en dollars par million de Tokens d’entrée / de sortie | Tri par coût |
| supports_tools | Prise en charge de l’appel d’outils | Condition indispensable pour les scénarios Agent |
| supports_structured_output | Prise en charge de la sortie structurée | Condition indispensable pour la sortie JSON |
| first_token_latency_ms | Latence du premier Token lors de la dernière sonde de vérification | Tri pour les usages interactifs |
| throughput | Vitesse de génération lors de la dernière sonde de vérification | Tri pour les sorties longues |
| is_free / is_model_author | Offre gratuite temporaire / s’agit-il de l’éditeur du modèle | Aide au choix |
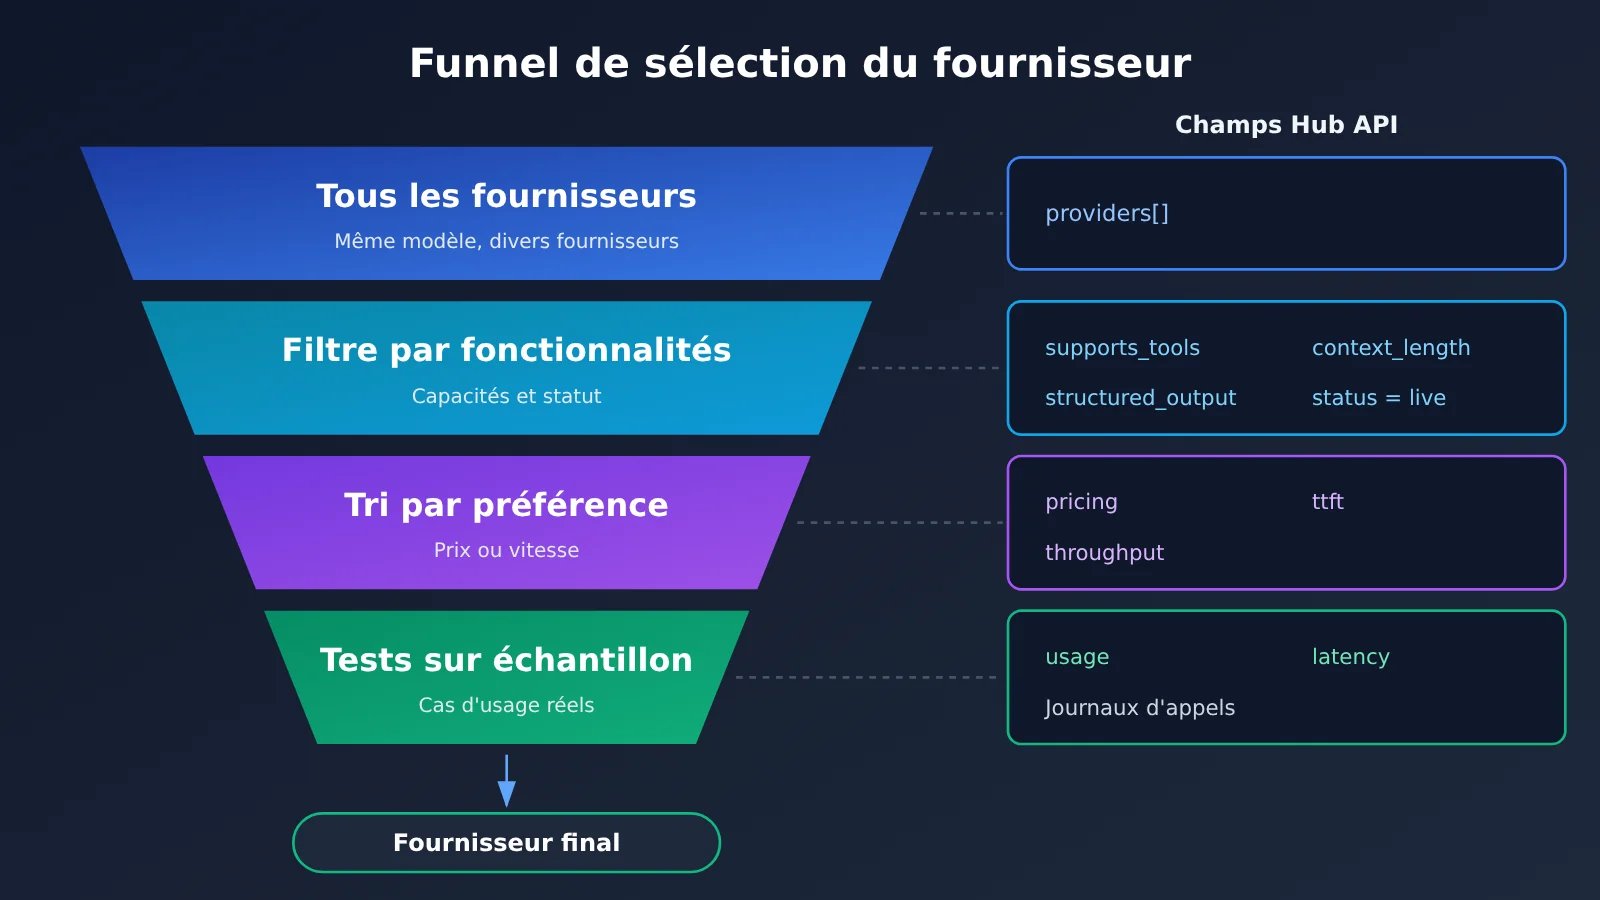
Ces champs ne sont pas fournis de manière complète par tous les fournisseurs, et les données de performance proviennent de la dernière sonde de vérification : elles ne correspondent pas à vos propres performances de bout en bout en temps réel. La bonne approche consiste à « filtrer d’abord, trier ensuite » : on élimine avec les champs fonctionnels les fournisseurs incompatibles, puis on trie par coût ou par vitesse. L’exemple ci-dessous illustre cette démarche ; pour la structure de retour, référez-vous à la documentation officielle de l’API Hub :
import os
import requests

HF_TOKEN = os.environ["HF_TOKEN"]
MODEL = "deepseek-ai/DeepSeek-V4.1-Flash"

resp = requests.get(
    f"https://router.huggingface.co/v1/models/{MODEL}",
    headers={"Authorization": f"Bearer {HF_TOKEN}"},
    timeout=30,
)
data = resp.json()
providers = data.get("providers", [])  # la structure exacte dépend de la documentation officielle

# Première étape : filtrage fonctionnel (l'Agent a besoin de l'appel d'outils + sortie structurée + contexte 64K)
candidates = [
    p for p in providers
    if p.get("status") == "live"
    and p.get("supports_tools")
    and p.get("supports_structured_output")
    and (p.get("context_length") or 0) >= 64_000
]

# Deuxième étape : tri par prix de sortie, les champs manquants relégués à la fin
candidates.sort(key=lambda p: (p.get("pricing") or {}).get("output", float("inf")))

for p in candidates:
    print(p["provider"], p.get("pricing"), p.get("first_token_latency_ms"), p.get("throughput"))
Une fois les candidats sélectionnés, il faut impérativement refaire un test avec de vraies requêtes métier. Les métadonnées du catalogue indiquent ce que le fournisseur « déclare prendre en charge », et ne remplacent pas la précision, le taux de réussite des appels d’outils et le taux de complétion final sur vos propres tâches.
Avant d’affiner au niveau du fournisseur, il faut généralement commencer par déterminer quel modèle utiliser. Le code ci-dessous montre comment comparer en batch les réponses de plusieurs modèles via une même interface compatible OpenAI ; remplacez les ID de modèle par les noms réels de la liste de modèles de la plateforme :
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # interface unifiée APIYI, une seule clé pour appeler plusieurs modèles
)

prompt = "Renvoie du JSON : {\"city\": nom de la ville, \"reason\": une phrase de justification}, recommande une ville adaptée à un voyage d'hiver"

for model in ["model-id-a", "model-id-b", "model-id-c"]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, resp.usage.total_tokens, resp.choices[0].message.content)
🚀 Prise en main rapide : les nouveaux utilisateurs peuvent obtenir un quota de test gratuit sur APIYI apiyi.com, puis utiliser le code ci-dessus pour tester un lot d’échantillons issus de leurs propres cas métier. Les journaux d’appels de la plateforme enregistrent, pour chaque requête, le modèle, la consommation de tokens et le coût, ce qui permet de calculer le coût réel par tâche plutôt que de se limiter au prix affiché.
Il faut préciser que l’accès unifié avec les journaux d’appels, d’une part, et les données de performance en temps réel au niveau des Provider affichées par Hugging Face, d’autre part, relèvent de fonctionnalités de niveaux différents : la première garantit la connexion et un calcul fiable des coûts, la seconde montre en plus l’état dynamique des fournisseurs sous-jacents. Les deux peuvent être combinées.
Plusieurs fournisseurs d’API et routage intelligent : analyse et évaluation
Où se jouera la prochaine bataille des plateformes d’agrégation d’API
Si l’on décompose les capacités d’OpenRouter, on peut les voir en trois couches : l’agrégation de modèles répond à « comment accéder à différents modèles », l’agrégation de fournisseurs à « qui exécute l’inférence pour un même modèle », et le routage dynamique à « à qui confier cette requête-ci ». L’interface unifiée a déjà largement réglé la question de l’accès ; ce partenariat montre que les deuxième et troisième couches deviennent de nouveaux points de concurrence. Ce constat s’appuie sur le fait que Hugging Face a choisi de renoncer à développer son propre routeur et de recourir à une capacité de routage externe ; OpenRouter a également publié séparément son algorithme de routage et démontré sa valeur par des expérimentations en production.
On peut s’attendre à ce que l’optimisation des coûts, la stabilité et la gouvernance des données deviennent de nouveaux critères de comparaison pour les plateformes API. Voici des prévisions qui restent à vérifier : la transparence du routage prendra de plus en plus d’importance ; les développeurs voudront savoir chez quel fournisseur la requête a atterri, pourquoi il a été choisi et combien ils ont payé. Les contraintes liées aux politiques de données pourraient passer d’option supplémentaire à condition préalable aux achats des entreprises.
Le routage n’est toutefois pas une solution miracle. Les résultats expérimentaux montrent que plus de rapidité et de stabilité a un coût : un coût unitaire plus élevé. Les prochaines étapes annoncées dans le cadre du partenariat (par exemple relier les comptes des deux côtés, intégrer davantage de tâches au routage d’OpenRouter) ne sont encore que des projets. Le routage ne résout pas non plus les problèmes de qualité intrinsèque des modèles, de licences et d’adéquation métier.
Demande de modèles à poids ouverts et pression sur les coûts des entreprises
Les données du côté de la demande confirment l’idée selon laquelle « le routage entre fournisseurs devient important ». D’après les statistiques d’OpenRouter, si l’on prend le volume hebdomadaire de tokens des 50 modèles les plus utilisés, les modèles à poids ouverts représentaient 71,7 % au 28 septembre 2026. Il s’agit d’une mesure interne à la plateforme OpenRouter, qu’on ne peut pas généraliser à la part de marché mondiale. Plus l’usage des modèles à poids ouverts augmente, plus la coexistence de plusieurs fournisseurs pour un même modèle devient courante, et plus la valeur du routage devient évidente.
Côté coûts, Capgemini a interrogé en septembre 2026 500 cadres dirigeants (CXO) de grandes entreprises : 59 % déclarent que leurs dépenses en IA dépassent nettement leurs prévisions ; parmi les entreprises concernées, le dépassement moyen atteint 24 %. Ces chiffres ne valent que pour l’échantillon de cette enquête, mais, rapprochés de la conclusion de l’expérience de routage — « un gain de vitesse s’accompagne d’une hausse des coûts » —, ils rappellent une chose aux entreprises : le routage automatique vise par défaut une expérience globale, pas forcément la facture la plus basse. Pour les activités sensibles aux coûts, mieux vaut choisir explicitement une stratégie privilégiant le prix ou fixer un plafond de prix, et vérifier en continu à l’aide des journaux d’appels.
Quel arbitrage pour chaque profil
- Développeurs indépendants et petites équipes : le routage automatique par défaut élimine déjà le travail de mise en place d’une redondance maison ; l’essentiel est de vérifier, avec de vrais échantillons, que les appels d’outils et la sortie JSON sont stables. Commencer par choisir le modèle via une interface unifiée comme APIYI apiyi.com, puis optimiser au niveau du fournisseur selon les besoins, c’est un chemin peu coûteux.
- Produits interactifs : privilégiez le TTFT P95 plutôt que le débit. Le
:fastestn’améliore pas forcément le ressenti sur les réponses courtes. - Sorties longues et tâches par lots : le débit et le prix effectif comptent davantage ; on peut envisager une stratégie privilégiant le prix et s’appuyer sur l’affinité de session pour préserver les gains du cache.
- Équipes entreprises et plateformes : commencez par recenser les applications qui dépendent de leur propre Provider Key et les métiers qui exigent un fournisseur fixe, puis décidez s’il faut autoriser le repli (fallback), restreindre les fournisseurs ou se connecter directement à eux. Les accords de traitement des données doivent être vérifiés fournisseur par fournisseur.
Quelle que soit la stratégie retenue, tout se ramène au même geste : faire tourner un cycle avec ses propres requêtes et ses propres métriques. Faire une petite comparaison sur APIYI apiyi.com avec le quota gratuit, ou commencer par filtrer les fournisseurs candidats avec l’API de catalogue Hugging Face, sont des points de départ peu coûteux. Les 16,9 % de l’expérience officielle sont une moyenne globale ; combien votre activité peut y gagner, seul un test le dira.
The proof of the pudding is in the eating.(C’est en goûtant le pudding qu’on sait s’il est bon ; la réalité se vérifie par la pratique.)