الملخص: بناءً على تقرير اختبار طرف ثالث منشور، يحلل هذا المقال أداء Qwen4-Max-Preview في مهام مثل آلة التقاط الدمى، وإصلاح خدمة Python، والبحث في 1,600 تذكرة دعم، ويوضح حدوده من حيث الوقت المستغرق والأحكام البحثية.
الخلاصة أولاً: الحكم الأساسي على قدرات Qwen4-Max-Preview البرمجية
يوضح تقرير الاختبار المنشور أن Qwen4-Max-Preview قادر على دفع التطوير متعدد الخطوات قدمًا، وإضافة اختبارات، وتسليم مشاريع قابلة لإعادة التحقق. يأتي أقوى دليل من مهمة إصلاح شفرة: إذ أعاد النموذج إنتاج العيب أولاً، ثم أضاف اختبارات جديدة، وأرسل طلبات HTTP حقيقية، وتحقق من سلامة البيانات، حتى اجتازت جميع الاختبارات الـ57. ونقاط ضعفه واضحة أيضًا: تستغرق المهام المعقدة وقتًا طويلاً، فقد استغرقت مهمة آلة التقاط الدمى نحو 75 دقيقة؛ وفي المهام البحثية، تجاوز تفسير النموذج لنتائج الحساب نطاق الأدلة. لذلك، تحتاج المخرجات المعقدة والاستنتاجات العلمية إلى مراجعة المطور.
يبدأ ما يلي بمهمة آلة التقاط الدمى، ثم يعرض تقريرًا يغطي 12 مهمة، مع التركيز على مجموعتين من الأدلة القابلة للتحقق: إصلاح الشفرة والبحث في تذاكر الدعم. بعد ذلك، يوضح مثال تحليل المصفوفات غير السالبة حدود استدلال النموذج، ثم يناقش مشكلة الكفاءة من خلال مقارنة أدوات مختلفة على التحدي نفسه الخاص بآلة التقاط الدمى، وأخيرًا يحدد أنواع المهام المناسبة لإسنادها إليه. هذا المقال تحليل تقييمي لتقرير منشور، ولم نُعِد تشغيل مشروع المؤلف، وجميع الأرقام مذكورة مع مصدرها وظروف الاختبار.
للمعرفة: فهم المصطلحات التسعة لتقييم Qwen4-Max-Preview
| المصطلح | الشرح |
|---|---|
| Agent | طريقة عمل يقوم فيها النموذج بالتخطيط للخطوات بنفسه، واستدعاء الأدوات، ودفع المهمة خطوة بخطوة. |
| آلة الحالة | التحكم في سلوك البرنامج عبر مجموعة من الحالات وقواعد الانتقال بينها، مثل «التحريك—الإمساك—الرفع—التسوية» في ماكينة التقاط الدمى. |
| اختبار الانحدار | إعادة التحقق من الوظائف الموجودة بعد تعديل الشيفرة، للتأكد من عدم كسر السلوك القديم. |
| طلب HTTP | طلب يرسله العميل إلى الخادم للتحقق من النتائج التي تعيدها الواجهة أثناء التشغيل الفعلي. |
| التحقق بالتجزئة | حساب قيمة ملخص لمحتوى الملف؛ وبمقارنتها قبل وبعد يمكن معرفة ما إذا كانت البيانات الأصلية أو ملف الاختبار قد تغيّرا. |
| معدل إنتاجية الـ Token | عدد الـ Token التي تتم معالجتها أو توليدها في وحدة الزمن، وتتأثر القيمة بالأدوات والشبكة وبيئة التشغيل. |
| استرجاع السياق | تحديد المعلومات المستهدفة وربطها ضمن كمية كبيرة من المواد المرافقة لطلب واحد. |
| تحليل المصفوفات غير السالبة | خوارزمية تفكك مصفوفة بيانات غير سالبة إلى مصفوفتين عاملتين غير سالبتين تقريبًا، بحيث يكون حاصل ضربهما مقاربًا للمصفوفة الأصلية. |
| الحل الأمثل المحلي | حل لا يمكن تحسينه ضمن نطاقه المجاور؛ وتحديد ما إذا كان الحل أمثل محليًا يتطلب شروطًا رياضية إضافية أو تحليلًا. |
1 إنجاز آلة التقاط الدمى في 75 دقيقة: مهمة برمجية معقدة لـ Qwen4-Max-Preview
1.1 ما تختبره مهمة آلة التقاط الدمى
في 12 نوفمبر 2026، نشر «人人都是产品经理» تقريرًا تجريبيًا عن Qwen4-Max-Preview عبر Qoder، وكان أكثر ما فيه تعقيدًا هو نظام التفاعل الخاص بآلة التقاط الدمى. تجمع هذه المهمة عدة نقاط صعبة برمجيًا في مشروع واحد: التفاعل الميكانيكي والتغذية الراجعة للقوة، وتأرجح الحبل المعلّق، والتصادم بين الدمى، وآلة الحالات لعملية التحكم، ومنطق احتساب النقاط في النهاية.
هذا النوع من المهام يصعب إنجازه بتوليد واحد فقط. فالتأثيرات الفيزيائية وتبديل الحالات وقواعد احتساب النقاط يعتمد بعضها على بعض، لذا يحتاج النموذج إلى الكتابة والتشغيل والملاحظة والتصحيح مرارًا وتكرارًا، ولهذا فهو يختبر القدرة على التقدم متعدد الخطوات على نمط الوكيل الذكي (Agent).
1.2 الوقت والسرعة والاستهلاك كما سجّلها الكاتب
| المؤشر | تسجيل الكاتب | شروط الاختبار والملاحظات |
|---|---|---|
| الوقت الإجمالي | نحو 75 دقيقة | بيئة Qoder، مهمة واحدة |
| سرعة الإخراج | نحو 33 Tokens/s | السرعة الملاحظة في هذه المهمة |
| استهلاك Credits | نحو 65 | تقدير الكاتب، وفق قياس Token Plan |
| جودة التسليم | متينة نسبيًا | تقييم ذاتي للكاتب، يرى أن الأداء العام يعادل Kimi K3.1 |
هذه الأرقام تخص هذه المهمة وحدها. وCredits هي وحدة القياس الخاصة باشتراك Token Plan، ويتأثر الاستهلاك الفعلي بالمدخلات وإصابة الذاكرة المؤقتة والمخرجات ورموز التفكير واستدعاءات الأدوات معًا، لذلك فإن 65 Credits لا تدل إلا على حجم تكلفة هذه المهمة. كما أن 33 Tokens/s قيمة ملاحظة في بيئة محددة.
يسجّل التقرير نفسه أيضًا عدة مهام أخرى. في مهمة الرسم بالحبر الصيني التي تستخدم NumPy وPIL فقط، أنتج النموذج أكثر من 1,000 سطر من الشيفرة، ورسم نحو 4,019 ضربة فرشاة، واختبر نفسه عبر إحصاء سطوع البكسلات ومسح الحدود بـ ASCII، فاكتشف تداخل السنونو مع الكتلة السوداء لفتحة النافذة، فعَدّل الإحداثيات من تلقاء نفسه. ويرى الكاتب أن تنظيمه للشيفرة وقدرته على الفحص الذاتي قويان نسبيًا، لكن أداءه الجمالي لا يزال بحاجة إلى تحسين.
ما الذي تغطيه اثنتا عشرة مهمة واقعية لـ Qwen4-Max-Preview
2.1 تقرير اختبار أكثر شمولاً
في 16 نوفمبر، نشر موقع 人人都是产品经理 تقرير اختبار أعدّه Z Finance، وذكر الكاتب أنه أنجز 12 مهمة، ثم فحص عينة من النتائج الرئيسية وأعاد التحقق منها. ويرتب الجدول التالي المهام حسب ما غطّاه التقرير:
| الفئة | مهمة الاختبار | القدرة الأساسية المستهدفة |
|---|---|---|
| التوليد البصري | SVG لبليكان يركب دراجة | الفهم البصري، توليد الكود |
| التحليل المالي | تحليل مشترك لثلاثة تقارير مالية | فهم المستندات الطويلة، المعايير المالية |
| التعرف على الرسوم البيانية | رسم بياني شريطي لإيرادات منتجات Apple | قراءة الرسوم البيانية، تقدير القيم العددية |
| التعاون المكتبي | ثلاث جولات من تعديل محضر اجتماع | الحفاظ على السياق، اتساق التعديلات |
| معالجة البيانات | تنظيف 44 صفًا من بيانات المبيعات | إزالة التكرار، تحويل الوحدات، الصيغ |
| العروض التقديمية | PPT حول الطرح العام لـ Pingtouge | البحث في الوقت الفعلي، إنشاء الملفات |
| استرجاع النصوص الطويلة | 1,600 تذكرة دعم عملاء | الربط بين السجلات، التصفية حسب الشروط |
| صيانة الكود | إصلاح خدمة تذاكر بلغة Python | تحديد العيوب، الاختبار والتحقق من عدم الانحدار |
| إعادة إنتاج بحث علمي | خوارزمية تحليل المصفوفة غير السالبة | تنفيذ الخوارزمية، التحقق العددي |
| تطوير صفحات الويب | صفحة لعرض مواد نشرة الاكتتاب | HTML، التسليم دون اتصال، التفاعل |
| أنظمة المحاكاة | محاكاة حديقة مطرية | التصميم التفاعلي، الحسابات العددية |
| تطوير الألعاب | لعبة 3D صغيرة بموضوع الفصول الأربعة | مشاهد 3D، إدارة الحالة، التفاعل |
2.2 خمس حالات جديرة بالاهتمام
من بين هذه المهام الاثنتي عشرة، تُظهر المهام الخمس التالية على أفضل وجه قدرة النموذج على تسليم «نتائج قابلة للاستخدام»:
- تحليل التقارير المالية: إدخال التقرير السنوي FY2026 لشركتي Apple وCostco ومسودة نشرة الإصدار الثانية لـ Ankryptonite… (أعتذر، أستكمل)
أعتذر عن الانقطاع، إليك النص كاملًا:
2.2 خمس حالات جديرة بالاهتمام
من بين هذه المهام الاثنتي عشرة، تُظهر المهام الخمس التالية على أفضل وجه قدرة النموذج على تسليم «نتائج قابلة للاستخدام»:
- تحليل التقارير المالية: إدخال التقرير السنوي FY2026 لشركتي Apple وCostco ومسودة نشرة الإصدار الثانية لـ Anthropic، واكتملت المهمة في نحو 8 دقائق. الأرقام الرئيسية الستة التي جرى فحصها كانت صحيحة جميعًا، وميّز النموذج بين خسارة التشغيل والخسارة الصافية، وأشار إلى تأثير التغيّر في القيمة العادلة للسندات القابلة للتحويل على الخسارة الصافية، ولم يختلق من عنده أي توجيهات مستقبلية لم يُفصح عنها.
- تنظيف Excel: ضمن 44 صفًا من تفاصيل المبيعات كانت هناك سجلات مكررة، وبيانات مكررة لا تختلف إلا بمسافات، ووحدتا قياس هما اليوان والـ«وان» (عشرة آلاف يوان)، وثلاثة صيغ للتواريخ، و5 طلبات مفقودة. بعد التنظيف بقي 35 صفًا، وبلغ مجموع المناطق الأربع 215,700 يوان، والخلايا الخمس المجمَّعة كلها تستخدم معادلات حقيقية، وعند تعديل التفاصيل تتحدّث القيم المجمعة تلقائيًا.
- توليد PPT: حدّد النموذج عبر الاسترجاع الفوري معلومات إعلان التفكيك، وأنتج عرضًا تقديميًا قابلًا للتحرير، وميّز بين توقّعات التقييم وتسعير الإصدار؛ وبعد تعديل الجمهور في الدورة الثانية بقيت الأرقام الرئيسية العشرين والتواريخ والأسماء دون تغيير. وأشار المؤلف أيضًا إلى وجود إغفال في خطوط المنتجات.
- استرجاع التذاكر وإصلاح Python: هذان البندان هما الأكثر تحديدًا من حيث الأدلة، ويُفصَّلان في القسم الرابع والقسم الثالث على التوالي.
القاسم المشترك بين هذه المهام هو أن المخرجات قابلة للفحص: هل تترابط المعادلات، وهل تتطابق الأرقام مع النص الأصلي، وهل تنجح الاختبارات. هذا النوع من الأدلة أكثر إقناعًا من «توليد مقطع برمجي يبدو صحيحًا».
3 نجاح 57 اختبارًا: Qwen4-Max-Preview أقوى دليل هندسي
3.1 إعادة كاملة لعملية الإصلاح
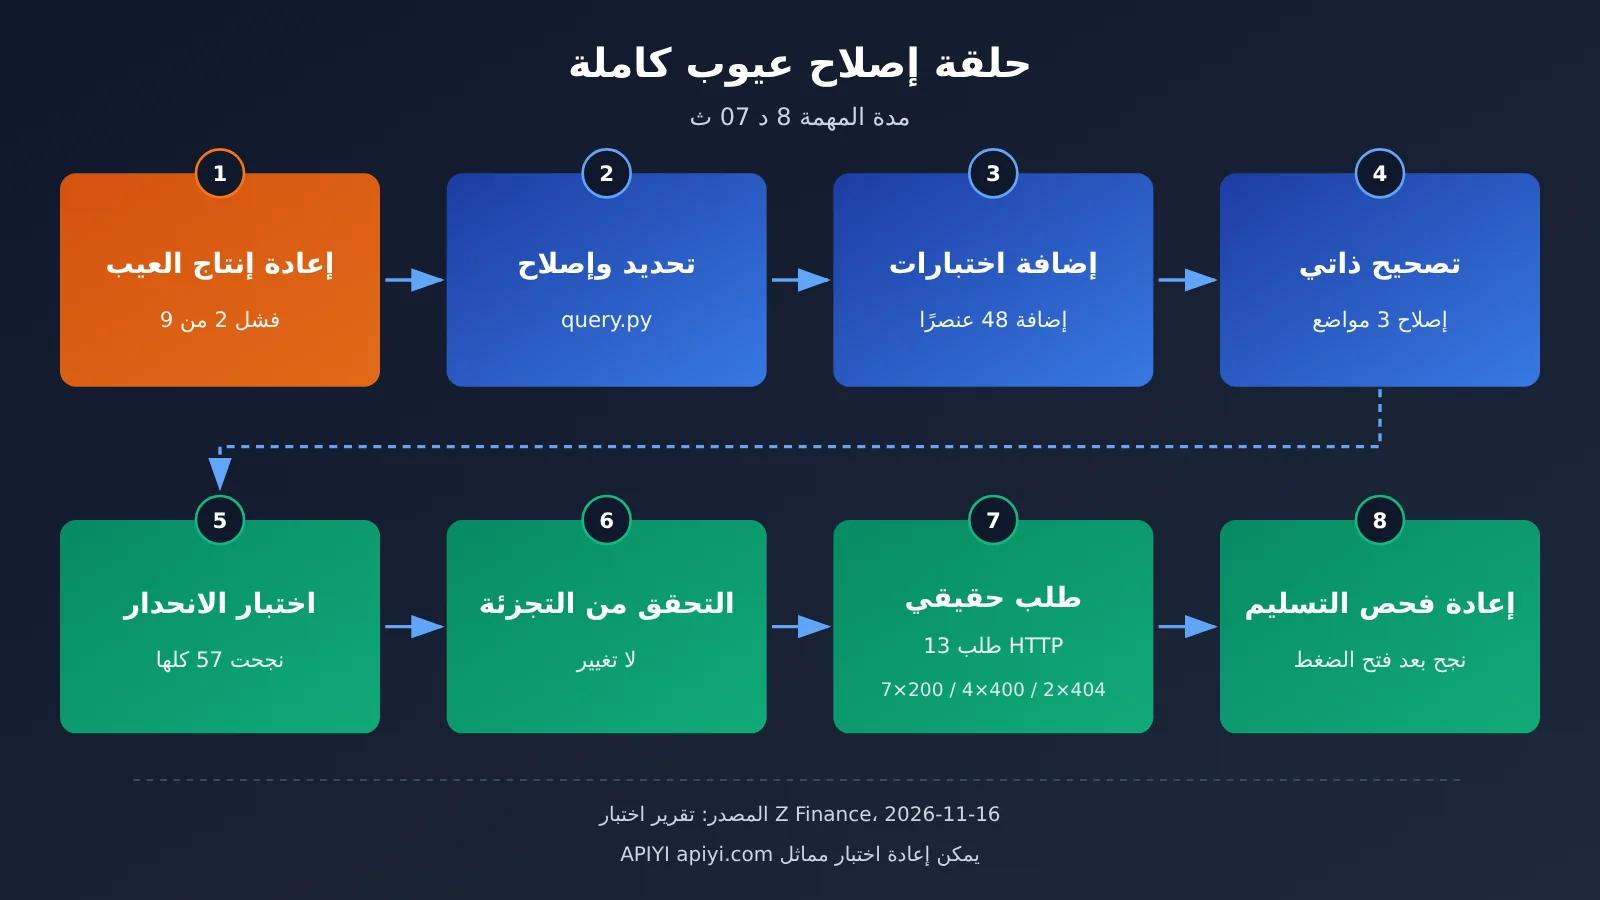
الهدف المُختبَر هو خدمة استعلام عن تذاكر الدعم مكتوبة بمكتبة Python القياسية، وتتعلق العيوب بالتصفية المركبة والفرز والتقسيم إلى صفحات والتحقق من المعاملات. وتشترط المهمة إصلاح العيوب مع الحفاظ على الواجهة والبيانات الأصلية والاختبارات الأصلية. ويسجل التقرير أن هذه المهمة استغرقت 8 دقائق و07 ثوانٍ، وكانت العملية كما يلي:
| الخطوة | إجراء النموذج | الدلالة الهندسية |
|---|---|---|
| استنساخ العيب | تشغيل الاختبارات الأصلية الـ9 أولًا، وإعادة إنتاج فشل اثنين منها | تأكيد وجود المشكلة أولًا قبل البدء بالتعديل |
| تحديد موضع التعديل | تركزت التعديلات الرئيسية في query.py | نطاق التغيير محدود ومنضبط، ما يقلل الآثار الجانبية |
| إضافة اختبارات | إضافة 48 اختبارًا جديدًا | تغطية حالات حدية لم تغطها الاختبارات الأصلية |
| التصحيح الذاتي | إصلاح 3 مشكلات في الاختبارات التي كتبها بنفسه | اكتشاف خطأ في الاختبارات نفسها وتصحيحه في الوقت المناسب |
| التحقق التراجعي | نجاح جميع الاختبارات الـ57 في النهاية | 9 اختبارات أصلية + 48 اختبارًا جديدًا |
| فحص الاكتمال | إجراء تحقق تجزئة (hash) على البيانات الأصلية والاختبارات الأصلية، وبقاء التجزئة دون تغيير | يثبت أنه لم يعتمد على التلاعب بالبيانات أو الاختبارات من أجل “النجاح” |
| طلبات حقيقية | تشغيل خدمة محلية وإرسال 13 طلب HTTP، والحصول على 7 استجابات 200 و4 استجابات 400 واستجابتين 404 | التحقق من الاستجابات الطبيعية ومعالجة الأخطاء أثناء تشغيل الواجهة |
| إعادة التحقق عند التسليم | بعد فك ضغط حزمة التسليم النهائية وتشغيلها مجددًا، نجحت الاختبارات | تأكيد أن المخرجات المسلّمة قابلة للتشغيل باستقلالية |
3.2 لماذا يوضح هذا الأمر أكثر من توليد الشيفرة
في البرمجة بالذكاء الاصطناعي هناك طريقتان شائعتان للفشل: الأولى تعديل الاختبارات أو البيانات لجعل الاختبارات “تتحول إلى الأخضر”، والثانية نجاح الشيفرة داخل الاختبارات لكن فشلها عند التشغيل الفعلي. التحقق من التجزئة في هذه المهمة يعالج الخطر الأول، أما طلبات HTTP الحقيقية وإعادة التحقق من حزمة التسليم فتعالجان الخطر الثاني. واستجابات 400 الأربع و404 الاثنتان تدل على أن النموذج تحقق أيضًا من مسارات الأخطاء، وأن التحقق من المعاملات والتعامل مع الموارد غير الموجودة خضعا لفحص فعلي.
تتوافق هذه العملية مع عادات المهندس الناضج في إصلاح العيوب: الاستنساخ، الإصلاح، إضافة الاختبارات، التحقق التراجعي، التسليم. وهي تثبت أن Qwen4-Max-Preview يمتلك حلقة صيانة متكاملة في خدمة ذات قواعد واضحة وحجم يمكن التحكم به. لكن هذا يبقى سجلًا لمهمة واحدة، ولا يمكن تحويله إلى معدل نجاح عام لإصلاح الشيفرة.
القيمة العملية لسياق بطول 4 ملايين: العثور على خيط يربط بين سجلين تفصل بينهما 741 سطرًا ضمن 1,600 تذكرة
4.1 تصميم الاختبار ونتائجه
أعلنت الجهات الرسمية أن نافذة السياق في Qwen4-Max-Preview تبلغ 1,000,000 Tokens. لكن حجم النافذة ليس سوى الحد الأعلى للسعة؛ أما القيمة العملية فتحددها قدرة النموذج على بناء ارتباطات صحيحة داخل كمية كبيرة من المواد. وقد أجاب اختبار تذاكر الدعم الوارد في تقرير Z Finance عن هذا السؤال.
تتكون بيانات الاختبار من 1,600 تذكرة دعم عملاء، بحجم يقارب 500 ألف بايت، وتتوزع الخيوط الأساسية على سجلين تفصل بينهما 741 سطرًا، مع طرح 5 أسئلة. ويذكر التقرير أن الأسئلة الخمسة جميعها تمت الإجابة عنها بشكل صحيح، ومن مظاهر الأداء تحديدًا:
- ربط تذكرتين متباعدتين، والعثور على مبلغ استرداد بقيمة 1,386 يوان والموظف الذي تولّى معالجته.
- بناءً على تاريخ الموافقة، تحديد ما إذا كانت السياسة الجديدة لقسائم التعويض تنطبق على هذه الحالة.
- إحصاء 62 تذكرة تطابق الشروط المحددة، بما يطابق نتيجة الإحصاء الذي أنتجه السكربت.
- تحديد مجموعتين من أرقام الطلبات المكررة، والتمييز بين المجموعة التي تمثل مسارًا طبيعيًا والمجموعة التي تمثل تعارضًا في معلومات العملاء.
4.2 البايت وToken: وحدتان مختلفتان
نحو 500 ألف بايت هو حجم الملف، أما عدد Tokens فيعتمد على طريقة التقطيع ونسبة النص الصيني إلى النص الإنجليزي، ولذلك يجب حساب الوحدتين بشكل منفصل. وما يثبته هذا الاختبار هو «الربط بين السجلات والتصفية حسب الشروط داخل مواد متوسطة الحجم»، وحجمه أقل بكثير من الحد الأعلى للنافذة البالغ مليون Token، لذلك لا يمكن اعتباره اختبار ضغط للقدرة القصوى.
وتكمن قيمة النتيجة الثالثة في أنها قابلة للتحقق: فقد طابقت 62 تذكرة نتيجة الإحصاء الذي أنتجه السكربت، مما يدل على أن عدّ النموذج يمكن مراجعته بواسطة برنامج حتمي. وعند الاستخدام الفعلي يُنصح باتباع الطريقة نفسها: التحقق من النتائج الإحصائية التي يعطيها النموذج باستخدام سكربت، ثم استخدام النموذج في الربط والتفسير، وهي الأجزاء التي يصعب على السكربت إنجازها.
5 نقطة ضعف لا يمكن تجاهلها: استنتاجات Qwen4-Max-Preview المتجاوزة للأدلة في الاستدلال العلمي
5.1 الحساب صحيح، لكن التفسير يتجاوز حدود الأدلة
تتطلب مهمة إعادة إنتاج بحثية تنفيذ خوارزمية التحديث الضربي لتحليل المصفوفات غير السالبة اعتمادًا على ورقة بحثية محددة. كانت مصفوفة الإدخال بحجم 48×36، وتم استخدام ثلاث مجموعات مختلفة من القيم الابتدائية، مع 500 تكرار لكل مجموعة. وثّق التقرير أن زمن النموذج بلغ 10 دقائق و06 ثوانٍ، وقدّم الشيفرة والنتائج العددية والرسوم البيانية والسجلات؛ كما قدّم 52 نقطة تحقق لكل مجموعة، وطابقت نقاط التحقق الرئيسية في المجموعة A النتائج المرجعية المنشورة، إضافة إلى 63 سجل فحص ذاتي.
تكمن المشكلة في مرحلة الاستنتاج. فبمجرد أن لاحظ النموذج استمرار انخفاض دالة الهدف، فسّر النتائج على أنها تقارب إلى حل أمثل محلي. ويشير المؤلف إلى أن هذا يمثّل استدلالًا مفرطًا.
5.2 ثلاثة مفاهيم يجب الحكم عليها بشكل منفصل
تتضمن هذه الحالة ثلاثة مستويات من الحكم، وكل مستوى لاحق يتطلب أدلة أقوى من المستوى السابق:
- انخفاض دالة الهدف: هذه خاصية تصميمية لقواعد التحديث الضربي، ويمكن ملاحظتها مباشرة في السجلات والرسوم البيانية.
- تقارب التكرار العددي: يتطلب التحقق من أن التغيّرات في المتكررات تتجه إلى الاستقرار، مع تحديد معيار توقف واضح.
- التقارب إلى حل أمثل محلي: يتطلب التحقق من شروط الأمثلية، مثل شروط KKT؛ ولا يكفي انخفاض قيمة الدالة وحده للوصول إلى هذا الاستنتاج.
يوضح هذا أن قدرة النموذج على التنفيذ وصرامة استدلاله بحاجة إلى تقييم منفصل. فالحسابات العددية يمكن التحقق منها عبر نقاط التحقق، أما الاستنتاجات العلمية فتحتاج إلى مراجعة من شخص لديه خلفية ذات صلة. وفي سياقات البحث أو إعادة إنتاج الأوراق أو التقارير التقنية، ينبغي التعامل مع «فقرة الاستنتاج» التي ينتجها النموذج على أنها مسودة.
6 مقارنة Qwen4-Max-Preview مع أدوات البرمجة الأخرى في المهمة نفسها
6.1 بيانات المقارنة في تحدي آلة التقاط الدمى
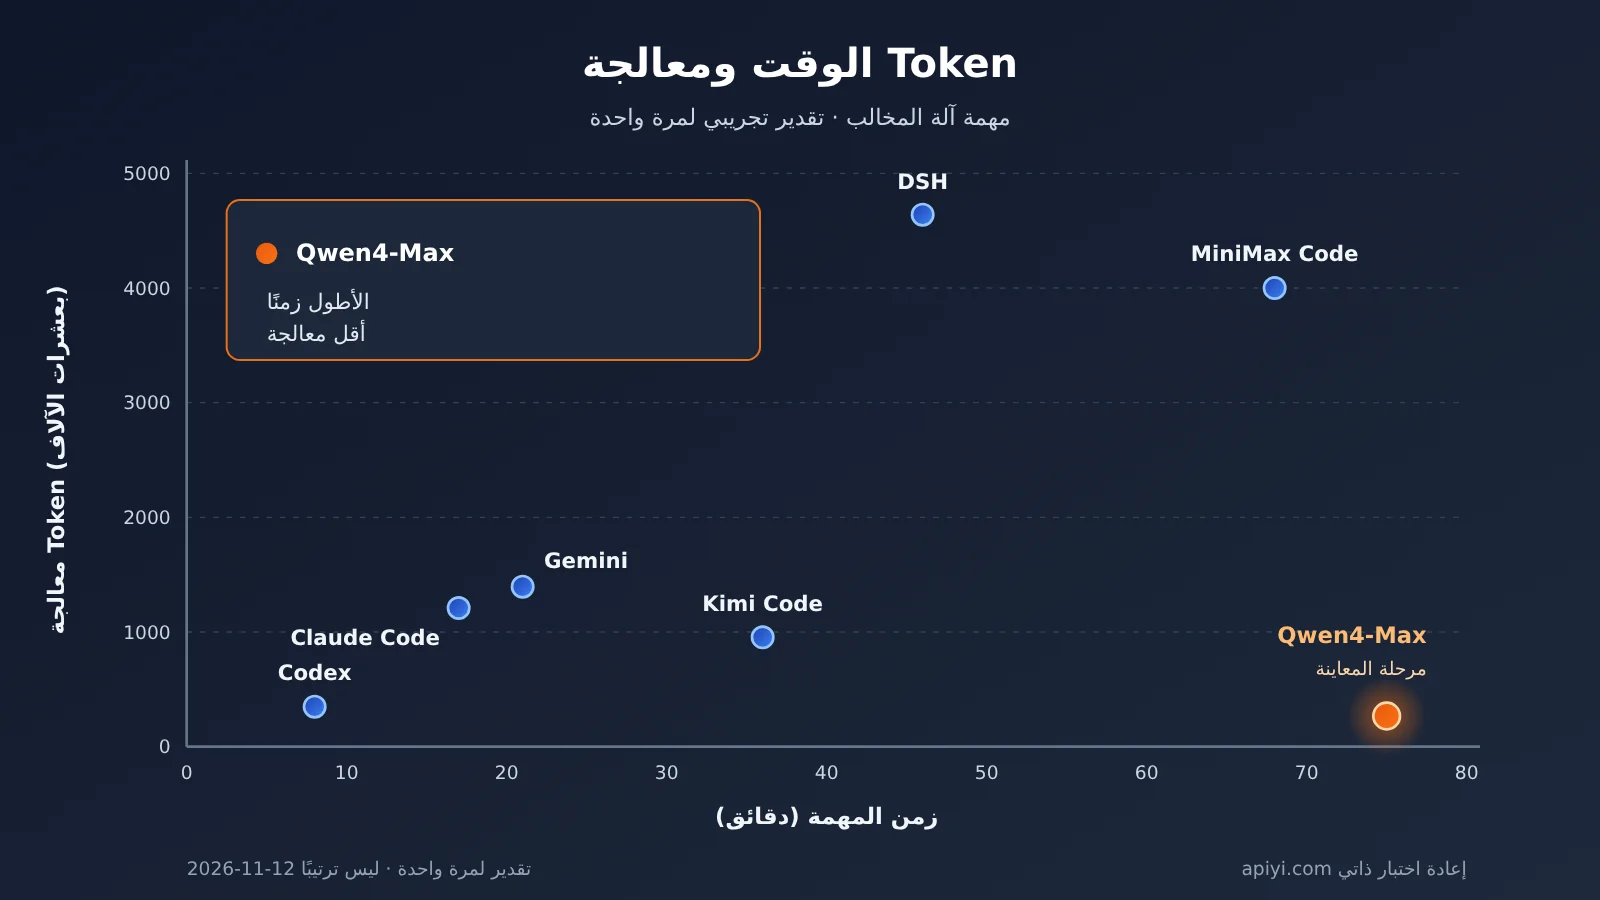
قدّم تقرير 12 نوفمبر أيضًا سجلات التحدي نفسه — تحدي آلة التقاط الدمى — كما جرى تنفيذه بأدوات مختلفة. في الجدول الأصلي كان صف Qwen مُعلَّمًا بـ Qwen4-Max، ووقت الاختبار هو 12 نوفمبر، أي قبل إطلاق النسخة الرسمية في 16 نوفمبر، وهو ما يقابل حينها نموذج مرحلة المعاينة.
| الأداة/النموذج | الوقت المستغرق | إجمالي التوكن المُعالَج (تقديري) | توكن الإخراج | مدخل إعادة الاختبار |
|---|---|---|---|---|
| Codex | 8 دقائق | 3.5 مليون | 28 ألفًا | الأداة الرسمية المطابقة |
| Claude Code | 17 دقيقة | 12.15 مليون | 130 ألفًا | الأداة الرسمية؛ يمكن استدعاء نماذج Claude عبر APIYI apiyi.com |
| Gemini | 21 دقيقة | 13.94 مليون | 81 ألفًا | الأداة الرسمية؛ يمكن استدعاء نماذج Gemini عبر APIYI |
| Kimi Code | 36 دقيقة | 9.5 مليون | 59 ألفًا | الأداة الرسمية المطابقة |
| DSH | 46 دقيقة | 46.44 مليون | 281 ألفًا | الأداة الرسمية المطابقة |
| MiniMax Code | 68 دقيقة | 40 مليون | 198 ألفًا | الأداة الرسمية المطابقة |
| Qwen4-Max (مرحلة المعاينة) | 75 دقيقة | 2.69 مليون | 55 ألفًا | Token Plan (Qoder) |
6.2 كيف نقرأ هذه البيانات
تُظهر البيانات تباينًا واضحًا: كان إجمالي التوكن المُعالَج لـ Qwen4-Max-Preview في هذه المهمة هو الأدنى، نحو 2.69 مليون، بينما كان الوقت المستغرق هو الأطول، نحو 75 دقيقة. وبالنظر إلى السرعة الملاحظة البالغة نحو 33 توكن/ثانية، يتضح أن عنق الزجاجة في هذه المهمة كان في سرعة التوليد، وأن حجم التوكن المستهلك نفسه لم يكن كبيرًا.
هذه البيانات لا تصلح لبناء ترتيب تنافسي، لثلاثة أسباب: إجمالي التوكن هو تقدير الكاتب؛ ونسبة التخزين المؤقت للسياق وسياسات الاستدعاء وأسلوب التنفيذ تختلف بين الأدوات؛ كما أن الإصدارات المحددة لكل نموذج في الجدول لم تُذكر بشكل موحَّد. وانخفاض حجم معالجة التوكن قد يعود إلى قراءات متكررة أقل، وقد يعود إلى اختلاف سياسات التخزين المؤقت في طبقة الأداة، ولا تسمح المواد المتاحة بالتمييز بينهما. أما الحكم الذي يمكن أن تدعمه فهو: في هذه البيئة من الأدوات، يصلح Qwen4-Max-Preview للمهام التي لا تتأثر بزمن الانتظار ويهمّها اكتمال التسليم أكثر.
7 أي المطورين يستحقون تجربة Qwen4-Max-Preview
7.1 السيناريوهات المناسبة والتي تتطلب الحذر
بالنظر إلى التقريرين معًا، يظهر Qwen4-Max-Preview أداءً مستقرًا نسبيًا في المهام التالية:
- صيانة الشيفرة ذات القواعد الواضحة: المهام التي تتوفر لها اختبارات جاهزة، وحدود المشكلة فيها واضحة، سواء أكانت إصلاحًا أم إضافة اختبارات.
- استرجاع المستندات الطويلة وربط المعلومات: البحث عبر السجلات في تذاكر الدعم والسجلات وال عقود والتقارير المالية، مع الاستعانة بسكربت للتحقق من نتائج الإحصاء.
- أتمتة المكاتب: تنظيف البيانات، وملفات Excel ذات الصيغ، وعروض PPT القابلة للتعديل، والتعديل على عدة جولات.
- تطوير النماذج التفاعلية الأولية: صفحات ويب من ملف واحد، وأنظمة محاكاة، ونماذج أولية لألعاب صغيرة، مثل صفحة العرض دون اتصال التي وردت في التقرير بحجم يقارب 46KB والتي لا تعتمد على أي مصادر خارجية.
أما المهام التي تستدعي الحذر فهي ثلاثة أنواع: التطوير التفاعلي الحساس لزمن الاستجابة (قد تستغرق المهمة الواحدة أكثر من ساعة)، وإخراج الاستنتاجات التي تتطلب برهانًا رياضيًا أو علميًا صارمًا، والتغييرات الإنتاجية التي تتطلب موثوقية عالية. ويشمل ملخص مؤلفي التقرير أيضًا عبارة «في المهام واسعة النطاق تُفقد بعض المعلومات» و«لا يزال التحقق البشري من المخرجات النهائية ضروريًا».
قبل الاستخدام، ينبغي الانتباه إلى القيود الرسمية: لا يمكن استخدام Preview إلا تفاعليًا عبر خطة Token Plan من Alibaba Cloud داخل أدوات مثل Claude Code وCursor وQoder، ولا يدعم الدفع حسب الاستخدام، وسيُوقف خلال فترة المعاينة في 25 نوفمبر 2026 الساعة 24:00 (بتوقيت بكين). وقد أُطلقت النسخة الرسمية Qwen4-Max في 16 نوفمبر، وتوصي الجهة الرسمية بالانتقال إليها. وتختلف معاملات الاثنين: الحد الأقصى للإخراج في وضع التفكير للنسخة الرسمية هو 262,144 Tokens، أما Preview فهو 393,216 Tokens، لذا يلزم إعادة ضبط ميزانية الإخراج عند الانتقال.
7.2 إجراء اختبار إعادة من النوع نفسه باستخدام مهامك الخاصة
أقصى ما تستطيع التقارير التي أعدّها آخرون إثباته هو أن «هذا النموذج قادر على إنجاز المهمة». وأما الطريقة الأكثر مباشرةً للحكم على مدى ملاءمته لفريقك، فهي أن تأخذ شيفرتك الحقيقية واختباراتك وتُجري مقارنة فعلية بها. يرسل المثال التالي مهمة إصلاح شيفرة عبر واجهة متوافقة مع OpenAI، ويسجّل الزمن المستغرق وحجم الرموز المستهلكة. استخدم أسماء النماذج الفعلية كما تظهر في قائمة النماذج على المنصة.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI الموحّدة، متوافقة مع OpenAI
)

resp = client.chat.completions.create(
    model="qwen4-max",  # استخدم الاسم الفعلي كما يظهر في قائمة نماذج APIYI
    messages=[{"role": "user", "content": "阅读以下代码与失败的测试,给出最小修复补丁:..."}]
)
print(resp.choices[0].message.content)
عرض سكربت اختبار الإعادة المقارن متعدد النماذج
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # مفتاح واحد لاستدعاء عدة نماذج
)

# استبدلها بالأسماء الفعلية من قائمة النماذج على المنصة
MODELS = ["qwen4-max", "claude-sonnet-model-name", "gpt-model-name"]

TASK = """你将收到一个 Python 服务的源码和测试结果。
要求:1) 先说明复现到的失败原因;2) 只修改必要文件;
3) 补充覆盖边界条件的测试;4) 不得修改原始数据和已有测试。
--- 源码与测试输出 ---
{payload}
"""

def run_case(model: str, payload: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": TASK.format(payload=payload)}],
        max_tokens=32000,  # رموز تفكير نماذج التفكير تستهلك أيضًا من ميزانية الإخراج، لذا يجب حجز مساحة لها
    )
    usage = resp.usage
    return {
        "model": model,
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,
        "answer": resp.choices[0].message.content,
    }

if __name__ == "__main__":
    payload = open("bug_context.txt", encoding="utf-8").read()
    for m in MODELS:
        r = run_case(m, payload)
        print(f"{r['model']}: {r['seconds']}s, "
              f"in={r['prompt_tokens']}, out={r['completion_tokens']}")
        # طبّق التصحيح في دليل معزول، ثم شغّل الاختبارات وتحقق من تجزئة البيانات الأصلية قبل التقييم
السكربت مسؤول فقط عن جمع الحلول وحجم الاستهلاك، أما مرحلة التقييم فيجب أن تحاكي ما ورد في التقرير: تطبيق التصحيح داخل دليل معزول، وتشغيل الاختبارات الأصلية والاختبارات المضافة، والتأكد عبر قيم التجزئة (hash) من أن البيانات والاختبارات القديمة لم تُمَسّ. وهكذا فقط تصبح النتيجة صالحة لقاعدة شيفرتك.
🚀 بداية سريعة: إذا أردت مقارنة عدة نماذج على المجموعة نفسها من المهام، يمكنك الحصول على رصيد تجريبي مجاني عبر APIYI على الموقع apiyi.com. توفّر المنصة واجهة متوافقة مع OpenAI، وبمفتاح API واحد يمكنك التبديل بين النماذج الرائدة مثل OpenAI وClaude وGemini، بما يسهّل تشغيل سكربت اختبار الإعادة ضمن مسار تقييم واحد.
الأسئلة الشائعة حول تقييم Qwen4-Max-Preview
س1: هل يعني إنجاز لعبة التقاط الدمى في 75 دقيقة أنه بطيء؟
في تلك المهمة على Qoder، كان زمن التنفيذ هو الأطول في جدول المقارنة، وبلغت سرعة الإخراج المقاسة نحو 33 Tokens/s. هذا مجرد سجل في بيئة واحدة، إذ تؤثر جدولة الأدوات وظروف الشبكة في النتيجة. إذا كان سيناريوك حساسًا لزمن الانتظار، فمن الأفضل اختباره بمهمة من مهامك.
س2: هل يعني اجتياز 57 اختبارًا أنه يمثل معدل نجاح إصلاح الشيفرة؟
يمثل عملية إصلاح كاملة وقابلة للتحقق، ولا يمكن تحويله إلى معدل نجاح. لتقييم أدائه في مشروعك، يمكنك عبر APIYI apiyi.com مقارنة عدة نماذج باستخدام المجموعة نفسها من عينات العيوب، وإعطاء درجات بناءً على نجاح الاختبارات ونتائج التحقق بالتجزئة (hash).
س3: هل تحقق اختبار تذاكر الدعم من نافذة السياق البالغة مليون Token؟
لا. يبلغ حجم هذا الاختبار نحو 500 ألف بايت، ويعتمد عدد الـ Tokens على طريقة التقسيم، وهو أصغر بكثير من الحد الأقصى لنافذة السياق. ما يتحقق منه هو القدرة على الربط بين السجلات والتصفية الشرطية.
س4: ماذا يجب أن نفعل بعد انتهاء مرحلة Preview؟
أصدرت الشركة النسخة الرسمية Qwen4-Max، وتوصي باستخدامها. تدعم النسخة الرسمية API بالدفع حسب الاستخدام، والحد الأقصى للإخراج في وضع التفكير هو 262,144 Tokens، لذا ستحتاج عند الانتقال إلى تعديل ميزانية الإخراج. يتغير توفر المنصات الخارجية وأسعارها بسرعة، لذلك يمكنك التأكد من أسماء النماذج المتاحة حاليًا في قائمة النماذج على APIYI apiyi.com قبل الربط.
س5: هل يمكن وضع مفتاح Token Plan في الواجهة الخلفية لتطبيقي؟
لا. تنص القواعد الرسمية على أن Token Plan مقتصر على الاستخدام التفاعلي ضمن أدوات البرمجة وأدوات الوكلاء الذكية المسموح بها؛ ولا يشمل النطاق المسموح الاستدعاء الآلي بالجملة عبر نصوص برمجية أو الواجهات الخلفية للتطبيقات المبنية ذاتيًا، وقد يؤدي انتهاك ذلك إلى تعليق الاشتراك أو حظر المفتاح. ينبغي للتطبيقات المبنية ذاتيًا اختيار منتج API يتوافق مع نطاق الاستخدام.
9 خلاصات رئيسية من تقييم Qwen4-Max-Preview
- حلقة تسليم مكتملة: غطّت مهام إصلاح الشفرة إعادة إنتاج المشكلة، ثم الإصلاح، ثم إضافة اختبارات، ثم التحقق من الهاش، ثم الطلبات الحقيقية، وأخيرًا إعادة التحقق من التسليم، وقد نجح 57 اختبارًا.
- الربط في النصوص الطويلة: من بين 1,600 تذكرة دعم، رُبطت الأدلة عبر 741 سطرًا، وأُجيب عن 5 أسئلة إجابة صحيحة كاملة، وتطابق 62 إحصاءً مع السكربت.
- التسليم المكتبي: صيغ Excel قابلة للربط فيما بينها، وبعد عدة دورات من التعديل على PPT بقيت 20 حقيقة رئيسية دون تغيير.
- نقطة ضعف في السرعة: استغرقت مهمة آلة التقاط الدمى نحو 75 دقيقة، مع حجم منخفض من معالجة الرموز (Token) ووقت طويل.
- حدود الاستدلال: تطابقت حسابات إعادة إنتاج البحث العلمي مع النتائج المرجعية، لكن الاستنتاجات تضمّنت استنتاجًا مفرطًا يحتاج إلى مراجعة بشرية.
- طبيعة الأدلة: كل ما سبق اختبارات مهام أداها مؤلف واحد، ولا يشكّل تصنيفًا معياريًا.
- طريقة البدء: أعد الاختبار بالمقارنة باستخدام شفرتك واختباراتك الخاصة، ويمكنك عبر APIYI apiyi.com تبديل عدة نماذج داخل واجهة واحدة.
10 الخلاصة: أين ينبغي للمطورين استخدام Qwen4-Max-Preview
الصورة التي يرسمها التقرير المنشور واضحة نسبيًا. يتفوّق Qwen4-Max-Preview في الأعمال ذات القواعد الصريحة والنتائج القابلة للفحص: صيانة الشفرة المصحوبة باختبارات، والاسترجاع عبر السجلات في المواد الطويلة، ومعالجة البيانات ذات الصيغ، والملفات المكتبية القابلة للتعديل، وتطوير النماذج التفاعلية. وفي هذه المهام يستطيع أن يضيف اختبارات بنفسه، ويكتشف أخطاءه بنفسه، ويسلّم نتائج قابلة لإعادة التحقق.
قيوده محددة بالمثل: المهام المعقدة تستغرق وقتًا طويلًا، لذا تناسب التشغيل في الخلفية؛ والاستنتاجات العلمية قد تتجاوز نطاق الأدلة، وتحتاج إلى مراجعة متخصصة؛ ونسخة Preview لا يمكن استخدامها تفاعليًا إلا عبر Token Plan داخل أدوات محددة، وستتوقف في 25 نوفمبر، لذا ينبغي التحول إلى النسخة الرسمية للاستخدام طويل المدى.
النهج الأكثر واقعية هو التعامل معه كمساعد هندسي يستطيع إتمام حلقة الصيانة بشكل مستقل، بينما يبقى على المطور ضبط الاستنتاجات والدمج النهائي. وقبل الإطلاق، يُوصى بإجراء مقارنة بين عدة نماذج باستخدام مهامك الحقيقية؛ فمن خلال الواجهة الموحدة لـ APIYI apiyi.com يمكنك إتمام الاختبار والمقارنة ضمن التدفق نفسه.
📚 المراجع
-
人人都是产品经理: إصدار Qwen4-Max المعاين وصل! تجربة فعلية وانطباعات: تجربة Qoder لآلة التقاط الدمى ومقارنة عبر الأدوات، 2026-11-12
- الرابط:
woshipm.com/ai/6492544.html - الوصف: مصدر بيانات مدة 75 دقيقة، و33 Tokens/s، و65 Credits، وجدول المقارنة
- الرابط:
-
人人都是产品经理: تجربة Qwen4-Max-Preview (تقرير اختبار Z Finance): اختبار شامل لـ 12 مهمة، 2026-11-16
- الرابط:
woshipm.com/evaluating/6494229.html - الوصف: مصدر بيانات إصلاح الشفرة، والبحث في تذاكر الدعم، وإعادة إنتاج البحث العلمي، ومهام المكتب
- الرابط:
-
Alibaba Cloud Model Studio: وثائق Qwen4-Max-Preview: المواصفات الرسمية وتعليمات الاستخدام
- الرابط:
help.aliyun.com/zh/model-studio/qwen4-max-preview - الوصف: نافذة السياق، والحد الأقصى للإخراج، ومدة المعاينة، وطريقة الوصول
- الرابط:
-
Alibaba Cloud Model Studio: وثائق Qwen4-Max: معلمات الإصدار الرسمي والفوترة
- الرابط:
help.aliyun.com/zh/model-studio/qwen4-max - الوصف: ميزانية الإخراج في الإصدار الرسمي ومعلومات الدفع حسب الاستخدام
- الرابط:
-
Alibaba Cloud: أذونات خطة Token وقواعد الاستخدام: حدود نطاق الاستخدام
- الرابط:
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - الوصف: متطلبات الاستخدام التفاعلي والسيناريوهات المحظورة
- الرابط:
المؤلف: فريق APIYI التقني
التواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI على apiyi.com، ولمزيد من مواد التكامل يمكنكم زيارة مركز الوثائق docs.apiyi.com