
GPT、Claude、Kimi写作测试摘要:先说判断
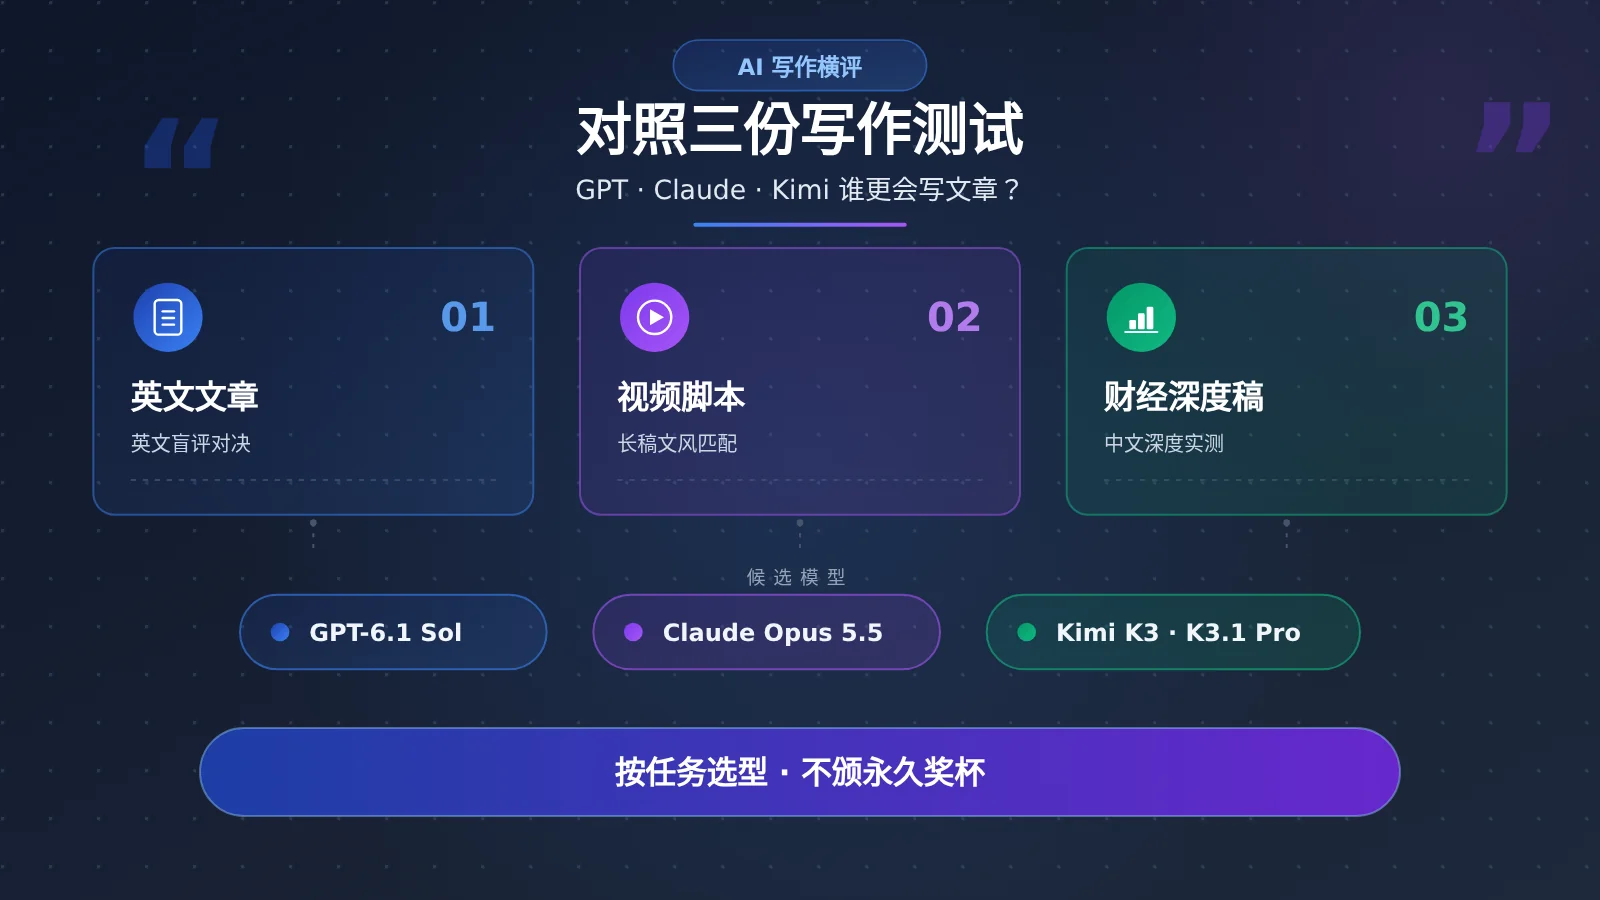
英文文章优先试 GPT-6.1 Sol;强调文风的长稿优先试 Claude Opus 5.5;解释科普值得加入 Kimi K3。 Kimi K3.1 Pro 的英文综合表现也很强,与 GPT 在 ToneBench 中接近。
三份测试覆盖的任务、语言和评价方法不同。最实用的结论是建立候选名单,再用自己的稿件验证,而非给三个模型家族颁一座永久奖杯。
上手建议:可通过 API易 apiyi.com 的统一接口调用候选模型,用同一份资料包比较初稿。新用户免费测试额度以平台当前规则为准。
GPT、Claude、Kimi写作测试:后文会说什么?
本文依次拆解英文写作榜、风格化视频长稿测试和中文财经深度稿实测。最后给出场景选择、盲测步骤与调用示例,重点看文章质量和人工编辑成本。
先约定两个术语:写作基准是按既定任务评价输出的测试;盲评是隐藏模型身份后比较文本。盲评可以由人或模型完成,阅读结果时要分清评审是谁。
GPT、Claude、Kimi写作测试一:英文文章看 GPT
AI Writing Benchmark 是 Johannes Eva 维护的英文写作项目,声明未接受模型厂商付费。本文采用 2026 年 11 月 11 日更新、11 月 12 日查询的结果。
项目覆盖 115 款模型,记录 131,507 次公开盲评对决。它通过匿名文本比较评价写作,AI 评审排名与人类投票排名分别展示。
| 模型 | 英文综合得分 | 结果口径 |
|---|---|---|
| GPT-6.1 Sol | 95.3 | 综合榜第一 |
| Claude Opus 5.5 | 92.9 | 综合榜第二 |
| Kimi K3.1 Pro | 91.9 | 综合榜第三 |
综合得分汇总多类任务;任务分类得分只反映某类题目。GPT-6.1 Sol 在文章、博客、编辑类内容中的分类得分为 98.5,需要与综合分 95.3 分开记录。
这些是基准内部的相对分数。项目把 50 定义为击败当前语言和类别平均模型的估计概率为二分之一,读者应关注竞争位置,而非把分数当成可发布内容比例。
直白地说:若任务是英文博客或编辑类文章,GPT-6.1 Sol 有充分理由进入首轮测试。 至于中文文章,需要另找中文证据。
另一个值得关注的结果是:Kimi K3 在解释与科普分类中以 94.9 领先。这里获胜的是 K3,综合榜第三则是 K3.1 Pro,版本名要跟成绩一起保存。
GPT、Claude、Kimi写作测试二:长稿文风看 Claude
ToneBench 让模型读取创作 Brief、研究资料包和风格指南,再生成完整 YouTube 脚本。模型看不到原作者成稿,也不能联网或调用外部工具。
本文采用 2026 年 11 月 10 日更新的资料。任务是特定创作者的视频长稿;所给资料未明确列出全部任务语种,因此这里按脚本场景解读。
测试包含 87 款模型、151 种配置,每种配置完成 10 项任务,每项独立生成 5 次。共生成 7,550 份稿件,由四名 AI 评审完成 30,200 次评分。
它尤其关注风格匹配,即语气、节奏和表达方式是否接近目标创作者。文风匹配权重为 19%,内容深度、准确性与价值为 15%,还评价连贯性和篇幅控制。
下表采用各模型最佳配置的 Writing Score,以及资料列出的模型排名。Claude 对应 xhigh;资料未给出另两款的具体推理配置名称,复测时应补齐。
| 模型 | 模型排名 | Writing Score | 测试估算单篇成本 |
|---|---|---|---|
| Claude Opus 5.5 | 1 | 85.8 | $1.003 |
| GPT-6.1 Sol | 8 | 82.4 | $0.239 |
| Kimi K3.1 Pro | 9 | 82.5 | $0.251 |
Writing Score 是该测试汇总写作表现的指标,排名则涉及 Elo 口径。因此,Kimi 分数高 0.1、排名低一位,应理解为两者表现接近。
Claude 在这组结果中领先,测试估算成本约为 GPT 的 4.2 倍。这是 ToneBench 的成本估算,不能直接套用为其他平台的文章报价。
为了理解排名,最好把任务和评审也放在同一张图里。通过 API易 apiyi.com 复测时,建议保留配置记录,再回到原榜单核对比较口径。
ToneBench 的第一、第二名置信区间重叠,移除任意一份参考脚本也会改变榜首。研究还发现评审存在一定厂商偏好,不过排除单位评审后 Claude 仍居首。
核心判断是:需要吸收资料、维持创作者声音的长稿,Claude 值得优先试。 这个结果适合指导候选选择,优势幅度仍需自己的稿件验证。
另需留意,GPT-6 Sol 的 Least Slop 单项成绩属于另一版本、另一指标,不能拿来替换 GPT-6.1 Sol 的 Writing Score。
GPT、Claude、Kimi写作测试三:中文深稿看什么?
OmniTools 的测试发生于 2026 年 10 月 26 日至 11 月 3 日,对象为 PANews 中文财经深度稿。它比较了 10 款模型、26 篇文章。
| 模型 | AI 盲评分 | 测试篇数 | 自然度评分 |
|---|---|---|---|
| Claude Opus 5.5 | 8.25 | 7 | 8.3 |
| GPT-6.1 Sol | 6.33 | 3 | 5.5 |
这项测试中,Claude 的整体评分和自然度更高。对于中文财经深度稿,Claude Opus 5.5 是更值得先试的候选。
但样本少、各模型篇数不均衡,而且 Kimi 未参与。因此,这份资料只能补充 GPT 与 Claude 的中文场景证据,无法给出三者完整的中文排名。
评审使用 Claude Opus 5.5 和 DeepSeek V4 Pro,并设置不评审自身模型的规则。发布方具有 API 路由服务商业背景,阅读时应保留这一来源信息。
编辑评价是另一套记录。Claude 的 100% 编辑采用率仅对应 1/1 轮,适合当案例观察;长期采用情况仍需更多稿件支持。
一句话总结:这里提供了 Claude 写中文财经长稿的积极信号,证据范围就落在这个场景里。
GPT、Claude、Kimi写作测试:按场景选候选
把三份结果放在一起,应该形成一张选型表,而不是把分数相加。文章语言、任务和目标文风,决定哪些证据与你有关。
| 写作场景 | 优先候选 | 选择依据 |
|---|---|---|
| 英文博客、编辑类文章 | GPT-6.1 Sol | 英文文章分类领先 |
| 创作者风格视频长稿 | Claude Opus 5.5 | ToneBench 当前领先 |
| 中文财经深度稿 | Claude Opus 5.5 | 中文小样本实测领先 |
| 英文解释、科普 | Kimi K3 | 解释与科普分类领先 |
| 资料包驱动的长内容 | 三款共同盲测 | GPT 与 Kimi 在 ToneBench 接近 |
| 调用验证平台 | API易 apiyi.com | 统一接口便于切换模型 |
中文技术教程、产品介绍等场景,现有三份证据没有完整覆盖。更稳妥的做法是同时测试候选,看谁能把技术讲清楚、把事实写准确。
GPT、Claude、Kimi写作测试:如何自己做对照?
建议选择真实选题,给各模型完全相同的资料、策划、篇幅和工具权限。每款独立生成至少三次,隐去模型名后交给编辑评价。
评分可从五项开始:事实准确性、策划执行、表达自然度、结构清晰度、内容价值。权重由团队任务决定,并标明这是自建规则。
再记录人工编辑成本:修改到可发布状态所需的工作量。最好同时记录修改时间、重写段落、事实错误和最终采用情况。
配置建议:在 API易 apiyi.com 使用一个 API Key 切换模型,可减少重复接入工作。测试时保留模型版本、参数与实际 Token 用量,方便复现。
下面是最小调用示例。把相同的实际资料包放入 brief,切换模型名即可生成对照初稿;密钥应由运行环境安全提供。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

brief = """请依据以下资料和策划生成文章。
只使用资料支持的事实,遵守目标篇幅与文风。
这里替换为各模型共同使用的实际资料包和策划。
"""

for model in [
    "gpt-6.1-sol",
    "claude-opus-5-5",
    "kimi-k3.1-pro",
]:
    result = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": brief}],
    )
    print(model, result.choices[0].message.content)
这段代码用于起步,正式盲测还应重复生成、匿名呈现并记录配置。若要验证解释分类的领先模型,需要额外加入 Kimi K3。
GPT、Claude、Kimi写作测试 FAQ
GPT、Claude、Kimi写作测试中,Kimi 应该测哪个版本?
解释科普优先加入 Kimi K3;比较本文综合榜与 ToneBench 结果时使用 K3.1 Pro。通过 API易 apiyi.com 调用前,核对模型列表和具体模型名,避免版本串线。
GPT、Claude、Kimi写作测试中,怎样比较实际费用?
比较“单篇合格成本”:累计调用费用加上编辑工作量。在 API易 apiyi.com 测试时,记录实际用量与重试次数,再按当时价格核算,比只看初稿费用更贴近生产。
GPT、Claude、Kimi写作测试结尾:选更省编辑的模型
英文文章先试 GPT,风格化长稿和中文财经深稿先试 Claude,解释科普加入 Kimi。 这些是具体任务下的优先顺序,而非整个模型家族的永久排名。
推荐通过 API易 apiyi.com 用同一资料包验证效果。最终选谁,就看谁更准确地完成策划、保留更多可用段落,让编辑少加一轮班。
GPT、Claude、Kimi写作测试参考资料
-
AI Writing Benchmark:aiwritingbenchmark.com
英文综合榜与分类榜,采用 2026 年 11 月 11 日更新口径。 -
Towards AI ToneBench:benchmark.towardsai.com/models/
视频脚本测试、模型排名、配置与成本估算,采用 2026 年 11 月 10 日资料。 -
OmniTools 深度长文写作实测:omnitools.ai/evals/longform-writing
PANews 中文财经深度稿测试,测试期为 2026 年 10 月 26 日至 11 月 3 日。
作者:API易技术内容团队。欢迎通过 API易 apiyi.com 交流模型配置、盲测方法与编辑经验。


