作者注:拆解 DeepSeek Harness 官方披露的三组数据,判断 Agent 平台化的机会与风险,并给出模型后端选型与成本控制的实际建议。
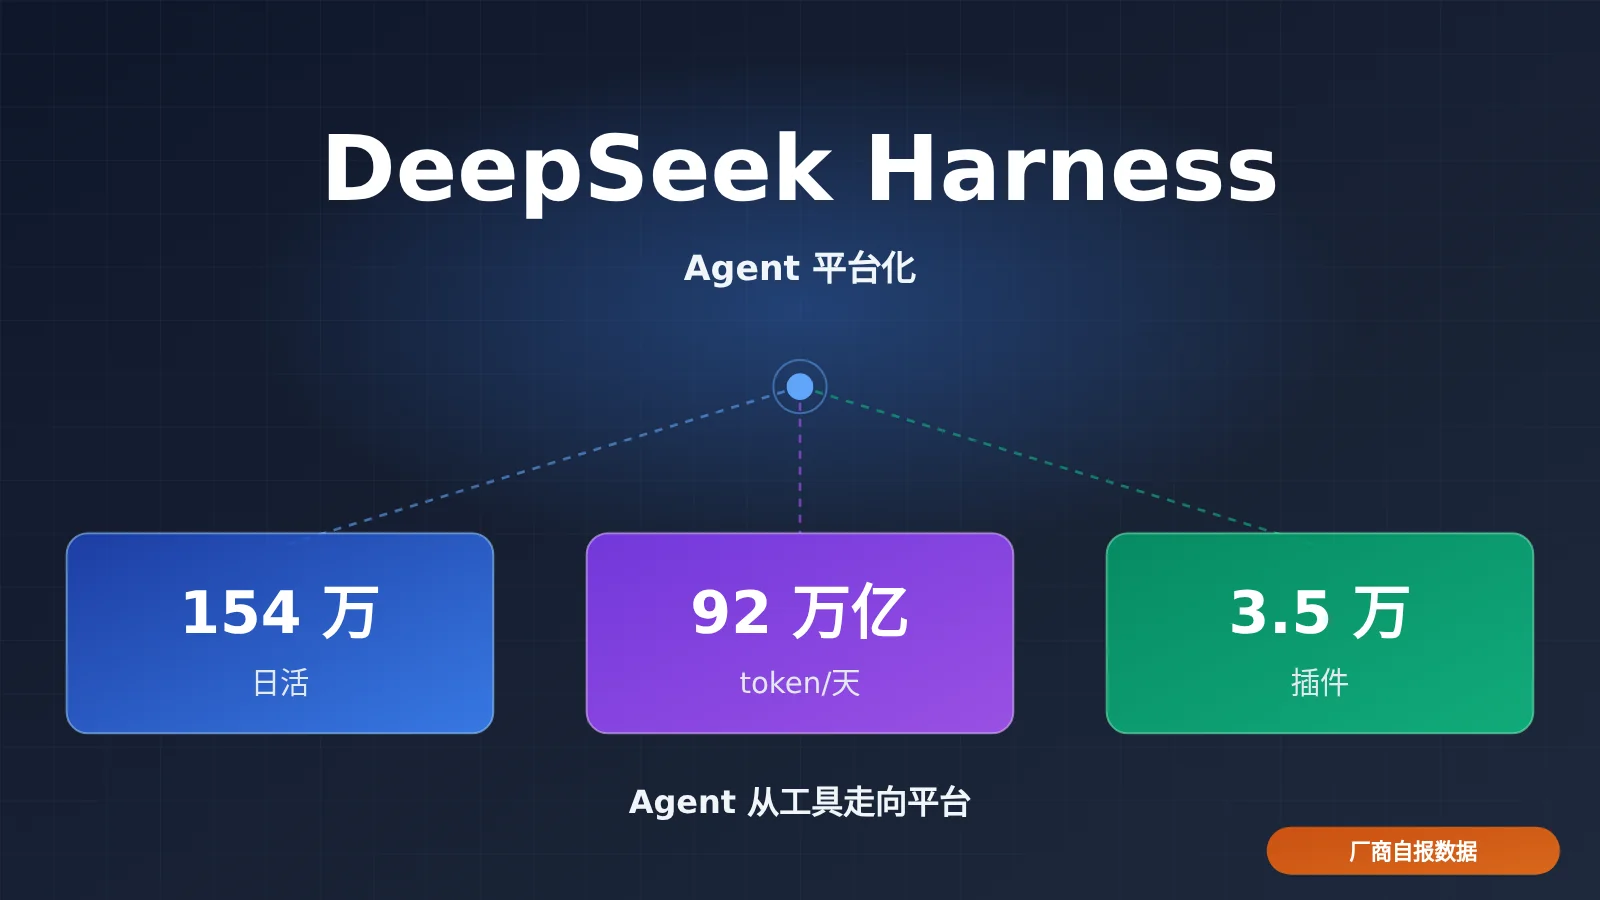
DeepSeek Harness 在 2026 年 11 月 5 日披露了一组数据:截至 11 月 4 日,日活 154 万、每天约 92 万亿 token、第三方插件约 3.5 万个,约 60% 的活跃用户创建或安装过至少一个插件。三个数字放在一起看,结论很直接:这不只是一个 Agent 工具突然走红,而是 Agent 正在从“好用的工具”走向“有生态的平台”。
这不是全市场数据:以上数字均为厂商自报,统计范围仅限使用 DeepSeek 官方 API 的用户,目前没有第三方审计。本文不做产品评测,只从用户规模、使用强度、插件生态三个平台化信号切入,最后落到 Agent 开发者在插件 API、权限、数据和模型后端上该怎么做。
核心价值:读完本文,你能看懂这三个数字背后的增长曲线和成本含义,并带走一个判断:Agent 平台的竞争,最终是插件生态和模型成本的竞争。
DeepSeek Harness 核心信息与增长曲线
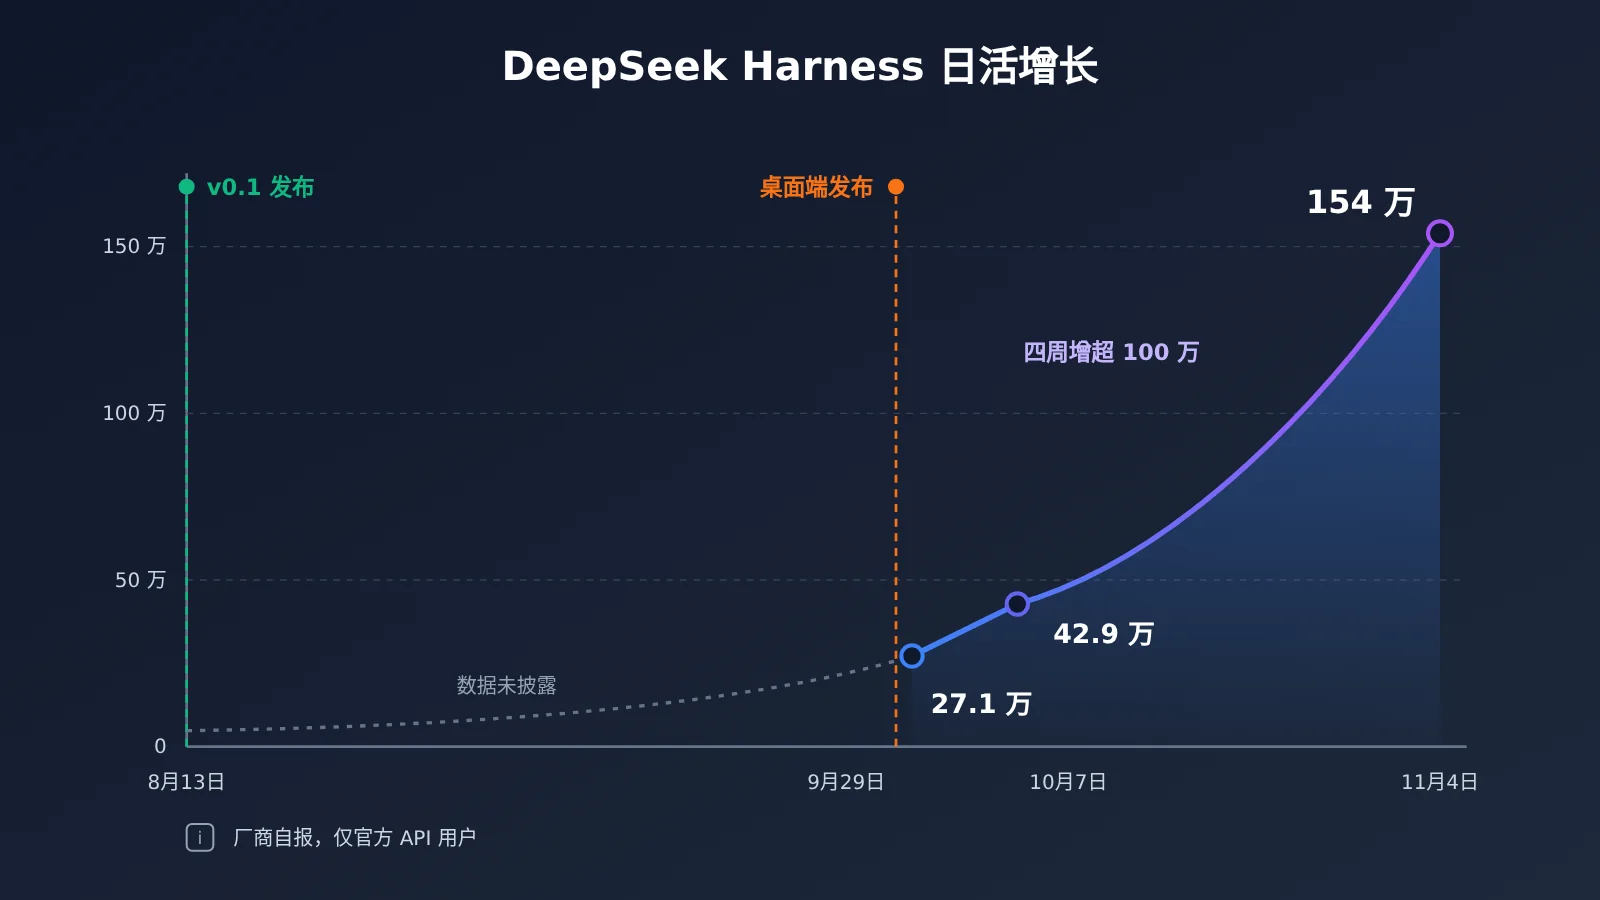
结论先行:DeepSeek Harness 的增长拐点在桌面端上线之后,不到五周日活放大了约 5.7 倍。
先把官方披露的基础信息放在一张表里,方便后面引用。
| 信息项 | 详情 |
|---|---|
| 披露时间 | 2026 年 11 月 5 日(数据截至 11 月 4 日) |
| 发布方 | DeepSeek(厂商自报,无第三方审计) |
| 统计口径 | 仅使用 DeepSeek 官方 API 的用户 |
| 用户规模 | 日活 154 万 |
| 使用强度 | 每天约 92 万亿 token |
| 插件生态 | 第三方插件约 3.5 万个,约 60% 活跃用户使用过 |
| 下一步 | 官方插件市场与作者支持计划筹备中,尚未上线 |
DeepSeek Harness 增长数据表
| 时间 | 日活 | 关键事件 | 说明 |
|---|---|---|---|
| 8 月 13 日 | 未披露 | 发布 v0.1 | 早期版本,用户以尝鲜开发者为主 |
| 9 月 29 日 | 未披露 | 发布桌面端 | 使用门槛下降,是增长加速的关键节点 |
| 9 月 30 日 | 27.1 万 | 桌面端上线次日 | 7 日均值,包含桌面端发布前的数据 |
| 10 月 7 日 | 42.9 万 | 桌面端上线一周 | 7 日均值,一周增长约 58% |
| 11 月 4 日 | 154 万 | 官方披露数据截止日 | 约四周新增超过 100 万日活 |
这组数据有两点值得注意。第一,从 v0.1 到桌面端用了一个半月,但真正的放量发生在桌面端之后;从 42.9 万到 154 万只用了四周,增速不是线性的。第二,9 月 30 日和 10 月 7 日明确是 7 日均值,而 11 月 4 日的 154 万是否同一口径,披露中没有完全展开,横向比较时建议留出余量。
桌面端为什么关键?Agent 的核心场景是长时间运行、读写本地文件、调用本地工具,这些在网页端都受限。桌面端让 Agent 能接触到用户真实的工作环境,插件也才有了足够的施展空间。增长曲线本身,就是“工具形态决定平台上限”的一个注脚。
92 万亿 token/天:DeepSeek Harness 的使用强度意味着什么
结论先行:92 万亿 token/天说明 Agent 的用量模式和聊天完全不同,单看每百万 token 单价会严重低估真实成本。
按 30 天粗算,92 万亿 token/天约等于每月 2,760 万亿 token,而这仍然只是官方 API 用户的部分。如果再粗略除以 154 万日活,人均每天约 6,000 万 token。这个均值显然会被少数重度用户和长时间运行的任务拉高,但它足以说明一个事实:Agent 用户不是在“聊天”,而是在让模型持续干活。
同期作为量级参照,OpenRouter 在 11 月 2-8 日的全球周调用量约为 210 万亿 token,其中中国模型占约 116.18 万亿。两者口径完全不同,不能直接比较,但能看出 Agent 平台单点的 token 吞吐已经进入很高的量级。需要强调的是,token 量不等于收入,更不等于利润。
Agent 任务的 token 放大因素
| 放大因素 | 发生场景 | 对成本的影响 |
|---|---|---|
| 多轮迭代 | 规划、执行、检查、修正循环 | 同一上下文被反复计费 |
| 工具调用 | 搜索、读文件、跑命令后回填结果 | 工具返回内容整段进入上下文 |
| 长上下文 | 代码库、文档、历史记录 | 每一轮输入都很重 |
| 失败重试 | 工具报错、格式不合规、超时 | 无产出的消耗,最容易被忽视 |
| 插件叠加 | 多个插件串联完成一个任务 | 调用链变长,难以预估 |
对 Agent 开发者来说,这意味着成本核算的单位要从“每百万 token 多少钱”换成“完成一个任务花多少钱”。一个单价便宜但需要三次重试的模型,可能比单价贵但一次做对的模型更贵。按任务、按会话、按可用产出来算,才能看清真实账单。
💰 成本建议:要按任务核算 token,前提是能看到每次调用的明细。通过 API易 apiyi.com 接入模型时,控制台可以查看用量、账单和调用日志,方便把一次 Agent 任务拆成多次调用逐项核对,找出重试和长上下文造成的浪费。
3.5 万插件:DeepSeek Harness 的插件生态是不是护城河
结论先行:3.5 万插件加上 60% 使用率,说明插件已经是主要使用方式,但数量本身不等于护城河,更不等于质量。
约 60% 的活跃用户创建或安装过至少一个插件,这个比例比插件总数更有说服力。它说明插件不是少数极客的玩具,而是大多数用户扩展 Agent 能力的默认路径。一旦用户的工作流依赖了某几个插件,迁移到别的平台的成本就会明显上升,这正是平台黏性的来源。
但护城河要看三个维度,而不只是数量:
- 质量分布:3.5 万个插件里有多少被长期使用、有多少是一次性实验,披露中没有给出。
- 接口稳定性:插件 API 如果频繁变动,作者维护成本高,生态容易流失。
- 安全边界:插件能访问哪些文件、哪些凭证、哪些网络资源,直接决定企业能否放心使用。
换句话说,插件数量是平台化的起点,插件 API 的稳定性、兼容性和安全性才是能否形成护城河的关键。对 Agent 开发者而言,这三点也会成为选择在哪个平台上写插件的核心考量。
官方插件市场与作者补贴:Agent 平台化的下一步
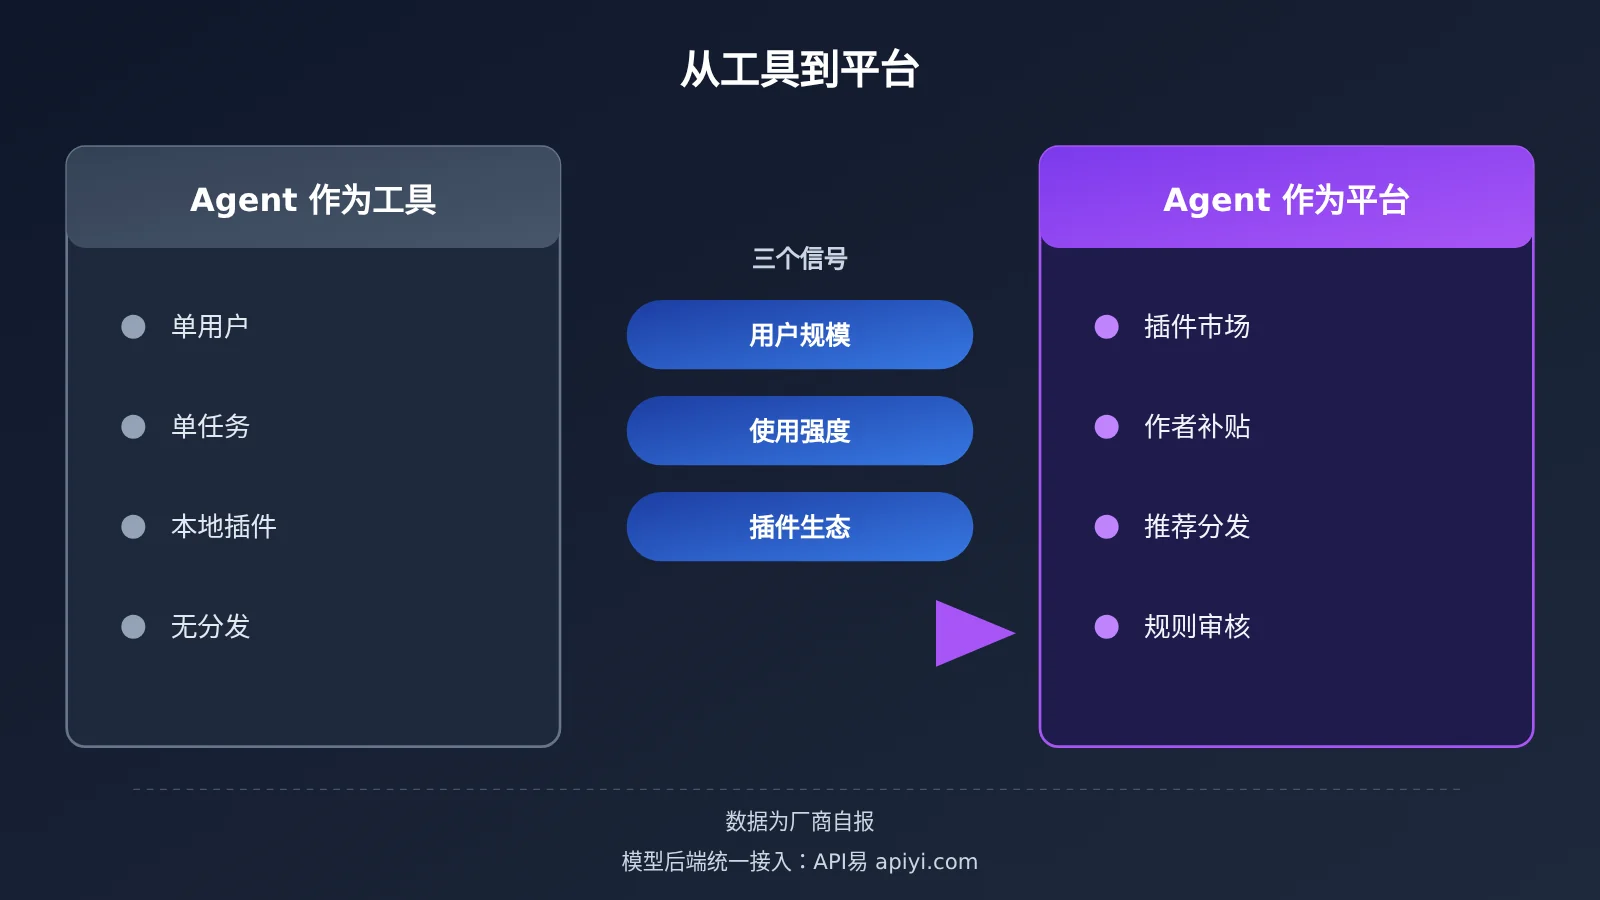
结论先行:官方插件市场和作者补贴意味着 DeepSeek Harness 要从“工具”转向“分发渠道”,这是 Agent 平台化的标志性动作。
根据披露,官方插件市场和作者支持计划正在筹备,内容包括 token 补贴、技术交流和推荐位。这三项分别对应作者最关心的三件事:开发成本、技术支持和曝光。一旦落地,插件作者和平台之间就形成了类似应用商店的分发关系。
Agent 平台化信号表
| 信号 | 数据 | 含义 | 对开发者的影响 |
|---|---|---|---|
| 用户规模 | 154 万日活(厂商自报) | 有足够大的分发入口 | 插件有现成的潜在用户 |
| 使用强度 | 约 92 万亿 token/天 | 用户在用 Agent 做实际工作 | 长任务场景的插件更有价值 |
| 生态参与 | 约 3.5 万插件,约 60% 用户使用 | 插件是主流使用方式 | 插件 API 成为新的开发接口 |
| 分发机制 | 官方市场筹备中 | 从自发生态走向平台运营 | 规则、审核、分成将影响收益 |
| 作者激励 | token 补贴、交流、推荐 | 平台主动培育供给侧 | 早期作者可能获得流量红利 |
需要冷静看待的是,市场尚未上线,上架规则、审核标准、分成方式都没有公布。平台化带来的分发红利是真实的,但平台对规则的掌控力也会同步增强。插件、工作流、用户数据和权限都沉淀在平台侧,这就是锁定风险的来源。
DeepSeek Harness 对 Agent 开发者的影响
结论先行:插件 API、权限、数据和模型后端是四个必须提前想清楚的问题,其中模型后端最容易被锁死,也最容易提前规避。
插件 API 与权限
如果你计划为 Harness 或类似平台开发插件,先评估插件 API 的版本策略和兼容承诺,不要在接口频繁变动的阶段投入过重。权限上,遵循最小授权原则:插件只申请完成任务所需的权限,API Key 和用户凭证不应直接暴露给插件,而应通过平台或自建网关代理。
数据与自托管取舍
托管平台的好处是开箱即用、有分发入口;代价是工作流和数据都在平台侧。对数据敏感的团队,可以考虑核心流程自托管或私有化,只把通用能力交给托管平台。这不是二选一,而是按数据敏感程度分层。
模型后端选择
Agent 平台的竞争最终会落到模型成本上,而模型后端不应绑死一家。不同任务适合不同模型:规划和复杂推理用强模型,批量的文本处理、格式转换用性价比更高的模型。主模型容量吃紧时,还需要有备用模型接得住。
同期的腾讯 Hy4 就是一个例子:11 月 4 日发布首日大量用户触及额度,推理集群扩容十倍,官方建议切换 Hy3 或错峰使用。新模型和 Agent 平台的容量压力是普遍问题,不是个例。
| 后端方案 | 核心特点 | 适用场景 | 切换成本 |
|---|---|---|---|
| 单一官方 API | 接入简单,能力与官方同步 | 早期验证、单模型产品 | 高,换模型需改接入 |
| 多家官方 API 并接 | 可选模型多 | 有专人维护的大团队 | 中,需维护多套鉴权与格式 |
| 多模型网关(如 API易 apiyi.com) | 一个 Key 调用多家模型,OpenAI 兼容 | 多任务路由、需要备用模型 | 低,主要改 model 参数 |
| 自托管开源模型 | 数据可控 | 敏感数据、私有化部署 | 高,需自建推理与运维 |
以 API易 为例,一个 Key 可以调用 OpenAI、Claude、Gemini、DeepSeek、Qwen、Kimi、GLM、MiniMax 等 400+ 模型,兼容 OpenAI API 标准,同时支持 Claude、Gemini 原生格式。接入时把 base_url 设为 https://api.apiyi.com/v1,切换模型主要是修改 model 字段,不必为每家厂商单独维护一套接入代码。
需要注意的是,统一接口降低的是接入成本,不能抹平模型差异。不同模型的工具调用格式、上下文长度、缓存机制都可能不同,切换前要用自己的 Agent 任务做回归测试。价格和可用性以控制台和文档为准。
🎯 技术建议:搭建 Agent 后端时,建议先通过 API易 apiyi.com 用新用户免费测试额度,把同一组任务跑在两到三个模型上,对比完成率和单任务成本,再决定主力模型和备用模型的组合。
DeepSeek Harness 数据的风险与边界
结论先行:这组数据可以作为 Agent 平台化的信号,但不能作为全市场结论,更不能作为收入或质量的证明。
读这组数据时,有几条边界必须守住:
- 厂商自报:154 万日活和 92 万亿 token/天均未经第三方审计,待第三方验证。
- 口径有限:只统计使用 DeepSeek 官方 API 的用户,不能等同于整个 Agent 市场。
- token 不等于收入:92 万亿 token 反映的是用量,不是营收或利润,补贴和优惠会显著影响实际收入。
- 数量不等于质量:3.5 万插件没有披露活跃度和质量分布。
- 规则未定:插件市场尚未上线,审核、分成、权限规则都未公布。
从行业背景看,Menlo Ventures 估计 2026 年企业 AI 支出约 1,768 亿美元,Agent 是需求爆发的重要推动力。需求在涨,容量压力也在涨,这对 Agent 开发者的直接含义是:可用性风险必须在架构层面处理,而不是寄希望于单一供应商永远不限流。
🛡️ 稳定性建议:为 Agent 配置备用线路是低成本的保险。API易 apiyi.com 官方描述采用多节点部署、智能路由、自动降级和负载均衡,并提供实时监控;在此之上,建议你在应用层也写好降级策略,比如主模型超时或被限流时自动切到备用模型,保证长任务不中断。
常见问题 FAQ
Q1: DeepSeek Harness 的 154 万日活是怎么统计的?
根据官方披露,154 万日活的统计范围仅限使用 DeepSeek 官方 API 的用户,数据截至 11 月 4 日,由厂商自报,没有第三方审计。早期的 27.1 万和 42.9 万明确是 7 日均值。它反映的是 Harness 在这一口径下的规模,不代表整个 Agent 市场。
Q2: 每天 92 万亿 token 是什么概念?
按 30 天粗算约每月 2,760 万亿 token,粗略人均每天约 6,000 万 token(会被重度用户拉高)。它说明 Agent 的多轮、工具调用、长上下文和重试会大幅放大用量。但 token 量只代表用量,不能换算成收入或利润。
Q3: 插件多是不是就安全、就好用?
不是。3.5 万插件和 60% 使用率说明生态活跃,但没有披露质量分布和安全审核情况。插件能访问的文件、凭证和网络范围才是关键。建议按最小权限授权,不要把 API Key 直接交给插件,敏感操作走独立网关。
Q4: Agent 的模型后端要不要绑死一家?
不建议。不同任务适合不同模型,主模型也可能因容量压力限流。更稳妥的做法是用一个 Key 接入多模型的网关,例如通过 API易 apiyi.com 统一调用,主力和备用模型可以快速切换。切换前记得针对工具调用格式和缓存差异做回归测试。
Q5: DeepSeek Harness 官方插件市场什么时候上线?
截至本文发布,官方插件市场和作者支持计划仍处于筹备阶段,官方没有公布上线时间,也没有公布上架规则和分成方式。已知的支持内容包括 token 补贴、技术交流和推荐位,具体以官方后续公告为准。
总结:DeepSeek Harness 之后,Agent 开发者的 5 条建议
结论先行:DeepSeek Harness 的三组数据共同指向一件事,Agent 平台的竞争,最终是插件生态和模型成本的竞争。
用户规模提供分发入口,使用强度暴露成本压力,插件生态决定黏性。官方市场和作者补贴一旦落地,平台化会进一步加速。对 Agent 开发者来说,机会在插件和分发,风险在锁定和成本,下面 5 条可以直接执行:
- 先算任务成本:把成本单位从“每百万 token 单价”换成“每个完成的任务花多少”,把重试、长上下文、工具回填都算进去。
- 保留备用模型:至少配置一个能接住核心任务的备用模型,主模型超时或限流时自动降级。
- 插件权限隔离:插件只拿最小权限,API Key 和用户凭证不进插件,敏感操作走自有网关。
- 关注插件 API 稳定性:在插件 API 版本策略和兼容承诺明确之前,不要把核心业务重度绑定在某个平台的插件体系上。
- 不要只看日活:日活是厂商自报、口径有限的指标,选平台时更要看插件 API 质量、权限模型、数据归属和模型成本。
DeepSeek Harness 核心要点 Key Takeaways
- 增长拐点:桌面端上线后不到五周,日活从 27.1 万到 154 万。
- 使用强度:约 92 万亿 token/天,Agent 用量模式远重于聊天。
- 插件生态:约 3.5 万插件、60% 用户使用,插件已是主流用法。
- 平台化动作:官方市场与作者补贴筹备中,规则尚未公布。
- 数据边界:厂商自报、仅官方 API 用户,待第三方验证。
- 后端策略:模型后端不绑死一家,可通过 API易 apiyi.com 一个 Key 多模型切换。
如果你正在搭建 Agent 产品或平台,建议先把模型后端和成本核算做扎实。推荐通过 API易 apiyi.com 快速验证多模型组合,平台提供免费测试额度、统一接口和用量日志,便于在平台化浪潮里保持选择权。
参考资料
- DeepSeek Harness 官方数据披露:2026 年 11 月 5 日发布,数据截至 11 月 4 日
- 说明:日活、token 用量、插件数量、增长时间线与插件市场筹备信息,均为厂商自报
- 腾讯 Hy4 发布与扩容说明:2026 年 11 月 4 日
- 说明:新模型首日容量压力与集群扩容的行业背景
- Menlo Ventures 企业 AI 支出研究:2026 年企业 AI 支出估算
- 说明:Agent 推动企业 AI 需求增长的宏观背景
- OpenRouter 周度调用数据:2026 年 11 月 2-8 日
- 说明:全球模型调用量级参照,与 Harness 口径不同,不可直接比较
作者:APIYI 技术团队
技术交流:欢迎在 API易 官网首页联系我们,模型列表与接入说明可查阅 docs.apiyi.com 文档中心