作者注:从 f(t) 渲染原理和 SenseNova 6.8 Code2Video 案例出发,用 4 个问题判断视频该走代码生成还是像素生成。
做科普讲解、公式推导或数据动画时,很多创作者都遇到过同样的麻烦:画面看起来不错,文字却错了,公式也变了形,重新生成一次又带来新的问题。本文将介绍 代码生成视频 vs 像素生成视频的选型方法,帮你判断哪些视频应该让 AI 写代码,哪些不应该。
这不是一篇“代码路线取代一切”的宣传稿。 本文以 2026 年 11 月 3 日一篇开源模型实践分享帖介绍的 SenseNova 6.8 Code2Video 为案例,拆解原理和流程,也会说明资料尚未证实的部分。
核心价值:读完本文,你将理解代码生成视频如何从时间函数 f(t) 变成 MP4,并能用 4 个问题判断自己的视频类型适合哪条路线。
代码生成视频 vs 像素生成视频核心要点
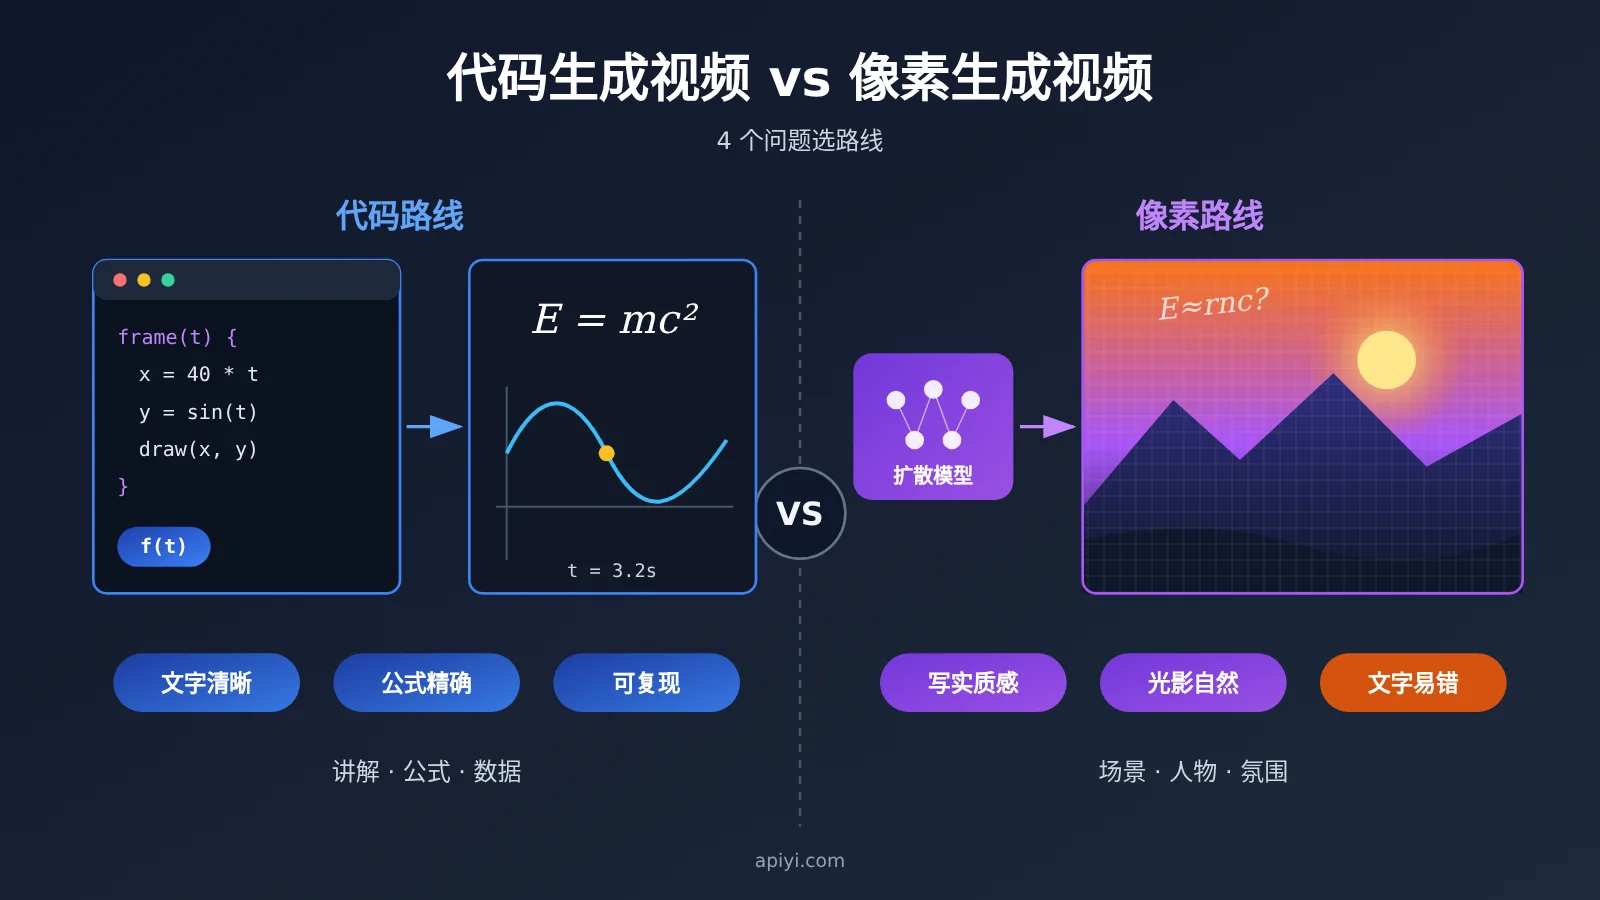
两条路线的根本差异不在模型大小,而在模型最终产出什么。像素路线直接产出画面,代码路线则产出一个能够渲染画面的程序。
| 对比维度 | 代码生成视频 | 像素生成视频 |
|---|---|---|
| 模型产出 | HTML/CSS、Canvas、SVG、Three.js、Manim、p5.js 等可执行代码 | 直接生成每一帧的像素 |
| 文字与公式 | 以字符和输入数据的形式渲染 | 由模型生成图像,分享帖作者称常见乱码和变形 |
| 修改方式 | 修改规格或源码后重新渲染 | 通常要调整提示词后重新生成 |
| 复现能力 | 同一份纯函数代码可重复渲染 | 取决于具体模型和工具 |
| 主要风险 | 写实质感可能不足,需要搭建渲染环境 | 精确信息难以保证,需要反复筛选 |
需要说明的是,“像素扩散模型常见文字乱码、公式变形、物理穿模”来自分享帖作者的概括,并没有附带对比测试。可以把它当作选型时的风险提示,正式决策前最好用自己的素材各跑一遍。
代码生成视频的工作原理:画面是时间的纯函数
Code2Video 的核心是把每一帧写成时间参数 t 的纯函数。给定任意时间点,程序都能算出所有元素的位置、形变和色彩。由于画面不依赖系统实时时钟,同一份代码重复渲染,结果应当保持一致。
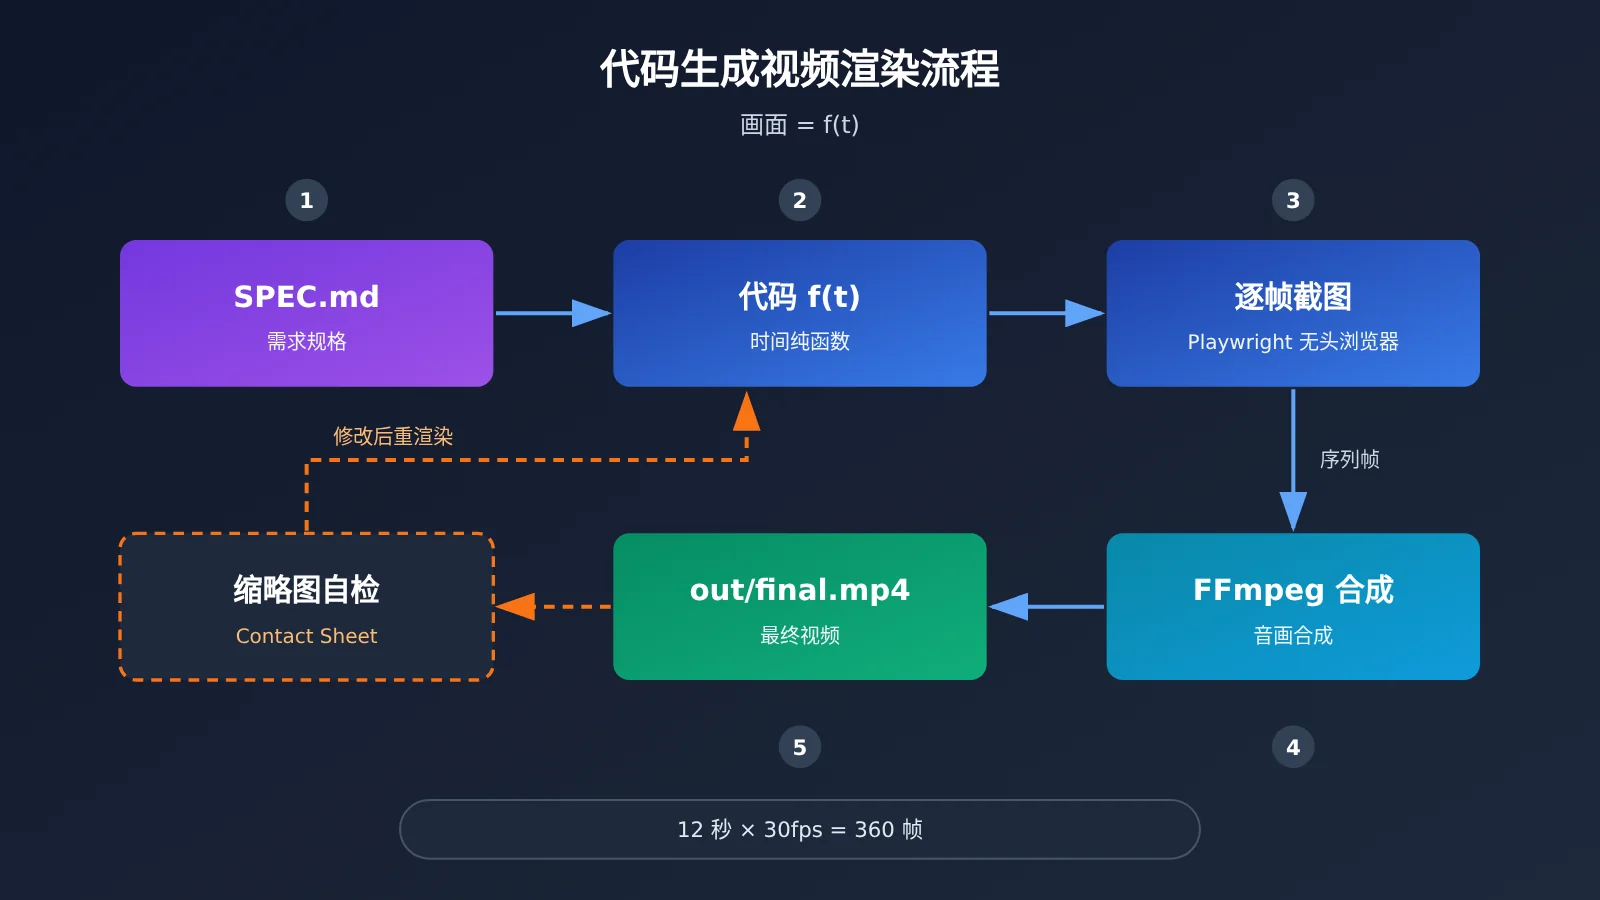
完整的渲染链路可以拆成 4 步:
- 写时间函数:模型把构图、运动和节奏写成随 t 变化的代码。
- 逐帧步进:Playwright 启动无头 Chromium,按帧率依次设置时间点。以 12 秒、30fps 为例,总共需要渲染 360 帧。
- 截图生成序列帧:每到一个时间点就截取一张高清画面。
- FFmpeg 合成:把序列帧和音轨合成为最终的 MP4。
这与录屏有本质区别。录屏受设备实时性能影响,而逐帧渲染即使某一帧计算得慢,也不会改变它在时间轴上的位置。实践中还要注意,未固定种子的随机数或不同机器上的字体差异,都可能破坏这种确定性。
代码生成视频的确定性来自规格,而不只是代码
分享帖认为,普通模型一句话生成的代码动画容易粗糙,关键差别在工作流。Code2Video 配合 code-video Skill,会先把需求转成可核查的 SPEC.md,确定构图、配色、缓动曲线和分镜时间轴。自然语言修改也主要作用于这份规格,因此多轮调整后风格和逻辑更容易保持一致。
初版渲染后,模型会抽取关键帧生成 Contact Sheets,检查文字重叠、元素出画和节奏问题,然后修改代码并重新渲染。据帖子介绍,单次任务可支撑 10 小时以上、超过 2,000 轮工具调用,最终输出 VERIFY.md 和 out/final.mp4。这些数字属于项目方向的说法,模型参数和能力请以官方仓库及模型卡为准。
💡 技术建议:如果暂时不想部署大模型,可以先通过 API易 apiyi.com 的统一接口,让不同文本模型基于同一份需求生成
SPEC.md,比较分镜和约束写得是否清楚。这一步不涉及渲染,却能较快验证需求是否足够明确。
用 4 个问题判断代码生成视频 vs 像素生成视频
选型时不必先争论哪种模型更强,先拆解视频中最不能出错的要素。下面 4 个问题可以按顺序回答:
- 有没有必须一字不差的内容? 例如术语、公式、价格、图表数值。
- 有没有必须精确控制的数值? 例如坐标、时长、运镜路径、音乐卡点。
- 会不会反复局部修改? 例如只换配色、只加一个标注,其余内容必须保持不变。
- 画面价值是否依赖真实质感? 例如真实人物、实拍环境、自然光影。
前 3 个问题中有 2 个以上回答“是”,且第 4 个回答“否”,优先考虑代码路线。第 4 个回答“是”时,代码路线很可能不是首选。不过这只是基于原理的推断,参考资料没有提供写实风格的对比证据,建议自行测试。
| 视频要素 | 依赖的能力 | 建议路线 | 判断理由 |
|---|---|---|---|
| 字幕与排版 | 字符准确、布局稳定 | 代码优先 | 文字以字符方式排版 |
| 公式与图表 | 数据和结构准确 | 代码优先 | 内容可直接来自输入 |
| 镜头与节拍 | 时间点和路径精确 | 代码优先 | 时长、节拍和路径都是数字 |
| 物理与粒子模拟 | 方程驱动 | 代码优先 | 运动可由数学和物理公式计算 |
| 真人与实拍质感 | 真实感和细节 | 像素或实拍优先 | 代码路线的效果尚缺证据,需要实测 |
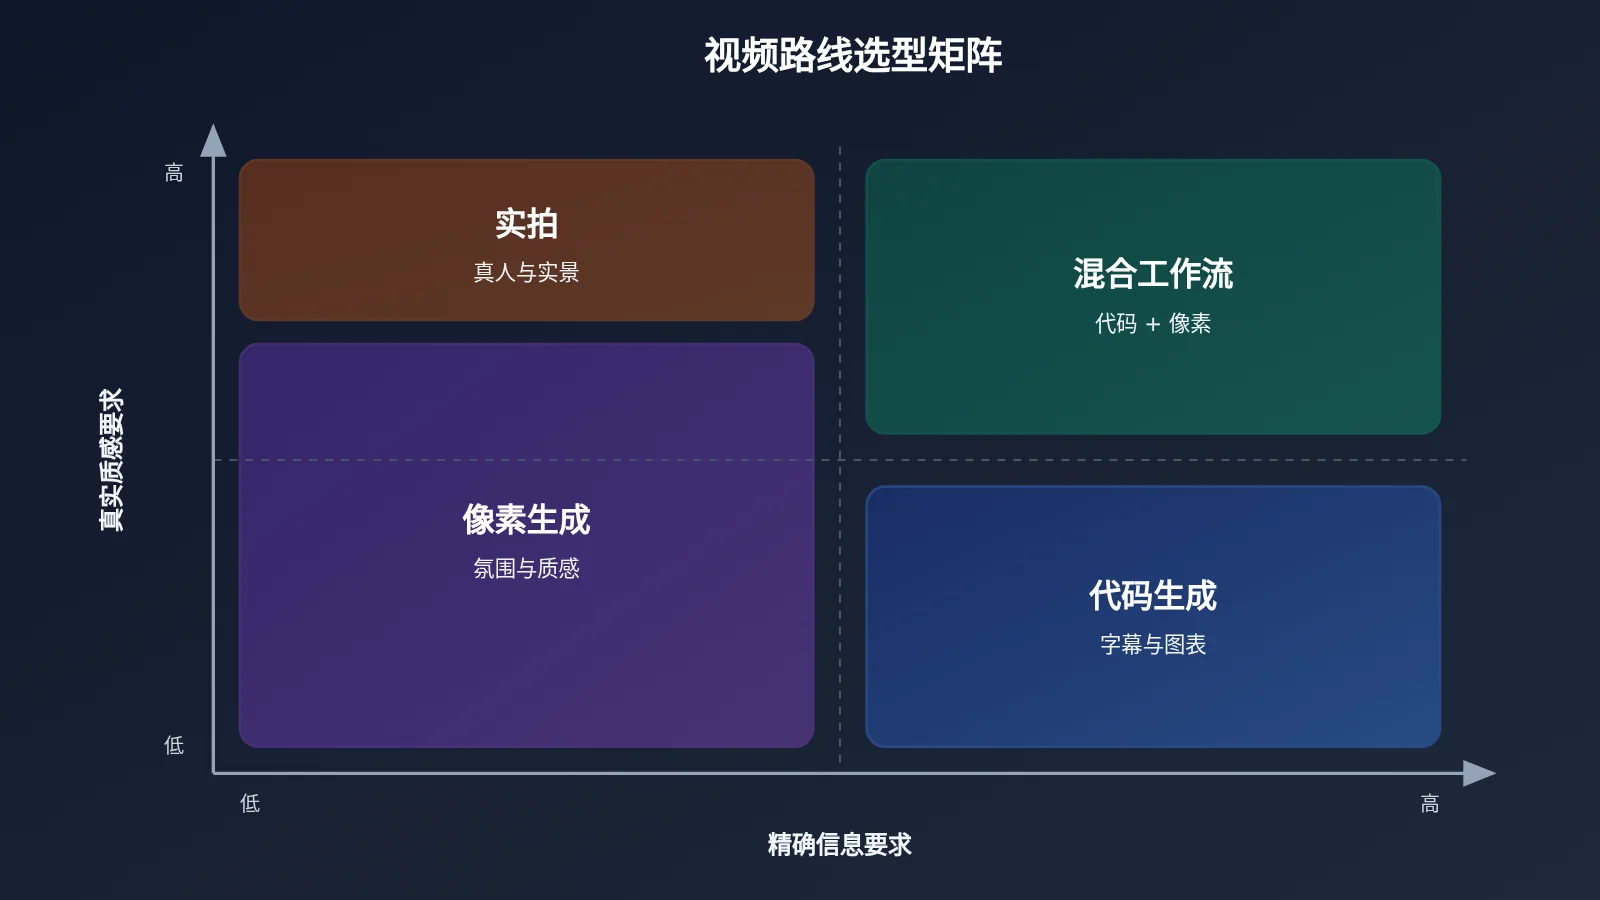
如果想为上图补充自己的判断依据,可以固定同一份脚本,通过 API易 apiyi.com 接入可用的文本和视频模型做小样对比。具体模型是否可用,以平台当前列表为准。
代码生成视频适合的 6 类场景
code-video Skill 提供了 8 个领域的工艺指南,其中可以归纳出这些比较适合优先尝试的场景。表中的“适合程度”是本文根据原理作出的判断,并非官方评级。
| 视频类型 | 对应指南 | 适合程度 | 注意事项 |
|---|---|---|---|
| 科普与数据可视化 | explainer-diagrams.md |
高 | 输入数据要先校对 |
| 动态排版与 UI 动效 | motion-graphics-and-promos.md |
高 | 需提前准备所需字体 |
| 音乐卡点短片 | music-and-beat-sync.md |
高 | 需明确节拍和切镜时间 |
| 粒子与物理模拟 | simulations-and-generative.md |
高 | 要约束参数和种子 |
| 3D 产品展示 | threejs-scenes-and-cameras.md |
中 | 质感需看样片判断 |
| 风格化角色动画 | character-and-creature-motion.md |
中 | 不等于写实人物表演 |
需要警惕的是,代码路线保证的是“按输入精确呈现”,而不是“内容一定正确”。如果脚本把公式写错了,它也会把错误公式清晰地渲染出来,所以事实校对仍然要由人负责。
代码生成视频快速上手:以 Code2Video 为例
以下流程整理自分享帖,适合已有 GPU 环境的工作流搭建者。部署参数可能随版本变化,操作前请先对照官方 README。
第 1 步:准备代码生成视频环境
建议提前装好依赖,避免 Agent 首次运行时花大量时间配置环境。
| 组件 | 要求 | 作用 |
|---|---|---|
| 编程 Agent | Codex 或 Claude Code 等 | 执行写码、渲染和修复循环 |
| Node.js | 18 及以上 | 运行前端渲染工程 |
| Python 3 | 安装仓库 requirements.txt 依赖 |
处理音频和辅助脚本 |
| FFmpeg / FFprobe | 系统可调用 | 合成视频并校验媒体流 |
| Playwright | 包含 Chromium 和对应语言字体 | 无头浏览器逐帧截图 |
第 2 步:部署模型并安装 Skill
- 下载权重:
huggingface-cli download sensenova/SenseNova-6.8-Code2Video --local-dir /path/to/SenseNova-6.8-Code2Video - 启动服务:帖子使用 vLLM 容器提供 OpenAI 兼容接口,并以 4 卡张量并行为例。关键参数包括
--tensor-parallel-size 4和--max-model-len 524288。 - 克隆仓库:
git clone https://github.com/OpenSenseNova/SenseNova-6.8-Code2Video.git - 创建隔离目录:
mkdir -p ~/video_tasks/methane_explainer/.claude/skills。Agent 会自动执行 Shell 命令,请不要在重要工程目录中运行。 - 复制 Skill:
cp -r SenseNova-6.8-Code2Video/skills/code-video ~/video_tasks/methane_explainer/.claude/skills/code-video - 声明上下文:帖子给出的环境变量为
CODEX_MAX_CONTEXT_TOKENS=524288、CODEX_AUTOCOMPACT_PCT=80和CODEX_MAX_OUTPUT_TOKENS=64000。
帖子里同时出现了 .claude/skills 和 .codex/skills 两种路径,实际目录应按所用 Agent 和官方说明确认。
如果团队还处在评估阶段,不必一开始就投入多卡环境。可以先用 API易 apiyi.com 接入现有编程模型,跑通规格书和简单 Canvas 动画的流程,再决定是否部署专用模型。这样能先验证需求和工作流,但成片效果不能直接代表 Code2Video 的能力。
第 3 步:把一句话扩写成代码生成视频 Brief
帖子的示例是一条 12 秒的甲烷燃烧科普短片。一句话需求会被扩写为结构化 Brief,也可以使用仓库 prompts/ 目录下的 Enhance Prompt 模板生成 dense_prompt.md。一份合格的 Brief 至少应写清以下内容:
- 基础规格:分辨率 1920×1080、帧率 30fps、时长 12 秒、程序化音效。
- 教学目标:说明化学反应只重排原子,不创造也不消灭原子。
- 时间轴:0–3 秒展示反应物,3–7 秒断键,7–10 秒重组,10–12 秒显示配平方程式。
- 硬约束:右上角计数器全程锁定为
C: 1 | H: 4 | O: 4。
最后一条最能体现代码路线的优势。计数器不需要模型“记住”它的外观,只需在程序中固定渲染这组值,就能全程保持一致。
第 4 步:用自然语言精修代码生成视频
首版成片通常只是起点。帖子建议在同一任务目录中使用 --continue 继续修改,并掌握 3 个提示词技巧:
- 先锁定不变项:开头写明
Keep the molecular coordinates, bond-breaking timing...,防止改样式时重写时间轴。 - 给出精确时间点:例如
At 3.5s when bonds break...,方便模型定位到对应时间段。 - 要求原地修改:结尾写上
Edit the existing source in place and overwrite out/final.mp4.,避免另起一份新工程。
没有源码时,还可以把参考视频放入项目目录,让模型分析布局、转场和运动轨迹,再重构为可编辑工程。这一能力适合学习结构和节奏,但用于发布前,应确认参考素材的版权和授权范围。
🚀 流程建议:长程任务开始前,可以先通过 API易 apiyi.com 调用文本模型,复核脚本中的公式、术语和旁白,再把定稿内容写入
SPEC.md。在渲染前修正事实错误,通常比成片后返工更省事。
代码生成视频 vs 像素生成视频常见问题 FAQ
Q1:什么是代码生成视频?
代码生成视频是指由 AI 编写可执行的图形或前端代码,再把代码逐帧渲染成视频。模型不直接生成像素,而是定义每个时间点的画面规则。
Q2:代码生成视频和像素生成视频最大的区别是什么?
区别在于产物和修改方式。代码路线留下可编辑的工程,适合控制文字、公式和节拍;像素路线直接输出画面。至于真实感表现和综合成本,目前资料不足,需要按项目实测。
Q3:代码生成视频能完全替代 Sora、Runway 这类工具吗?
目前不能这样下结论。资料主要展示了科普、动效和风格化案例,并未证明代码路线能胜任实拍质感。更稳妥的做法是根据视频中最关键的要素选择路线,必要时再尝试混合制作。
Q4:代码生成视频一定比像素生成视频便宜吗?
不一定。分享帖开头提到的高额成本没有给出来源,本文不将其作为依据。代码路线的成本取决于模型调用、硬件和迭代轮数,长程任务也可能消耗不少资源,建议先做短片小样再估算。
Q5:没有多卡 GPU,如何验证代码生成视频工作流?
可以先做一段 10 秒左右的 SVG 或 Canvas 动画,重点验证规格书、渲染脚本和修改流程。通过 API易 apiyi.com 接入兼容接口后,只需切换模型名即可比较不同模型的代码质量。接口配置和可用模型请查阅 docs.apiyi.com。
Q6:Code2Video 有哪些限制需要提前了解?
帖子只给出了 4 卡并行示例,未说明最低硬件配置,INT4 和 INT8 量化权重也要等待后续发布。此外,资料缺少渲染耗时和客观成片样例,写实表现也有待验证。Agent 会自动执行命令,务必在隔离目录中运行。
Q7:两条路线可以混合使用吗?
从工作流上可以尝试,例如用实拍或像素模型制作背景素材,再用代码叠加标题、公式和图表。参考资料没有验证这种做法,需要先测试素材嵌入和逐帧渲染是否同步。比较素材模型时,也可以通过 API易 apiyi.com 查看当前可接入的选项。
代码生成视频 vs 像素生成视频 Key Takeaways
- 核心差异:代码路线生成可渲染的程序,像素路线直接生成画面。
- 确定性来源:画面是 f(t) 的纯函数,并由无头浏览器逐帧渲染。
- 优先场景:文字、公式、数据、坐标和节拍要求精确时优先考虑代码。
- 工作流关键:
SPEC.md、缩略图自检和原地修改共同保证多轮一致性。 - 主要边界:写实和实拍质感缺少证据,不能默认代码路线同样擅长。
- 上手建议:先用短片小样和 API易 统一接口验证需求,再投入专用部署。
总结:什么视频该让 AI 写代码
选择代码生成视频 vs 像素生成视频时,可以记住 3 个要点:
- 看要素:画面中的文字、公式、数据和时间点越不能出错,越适合代码路线。
- 看修改:需要多轮局部调整且保持其余内容不变时,可编辑工程更有优势。
- 看质感:真实人物和实拍氛围是核心价值时,不要默认代码路线能够胜任。
下一步可以选一条 10–15 秒的现有视频,用 4 个问题拆解后分别制作小样,比较准确性、修改次数和实际耗时。需要同时评估多个模型时,可以通过 API易 apiyi.com 用统一接口完成脚本扩写和代码生成测试,再根据结果决定是否部署 Code2Video。
📚 参考资料
- 分享帖 – SenseNova 6.8 Code2Video 实践介绍:本文的原理、流程和案例来源
- 链接:
v2ex.com/t/1254274 -
说明:发布于 2026 年 11 月 3 日,其中部分比较和成本说法缺少独立验证。
-
GitHub – SenseNova 6.8 Code2Video:官方仓库与 code-video Skill
- 链接:
github.com/OpenSenseNova/SenseNova-6.8-Code2Video -
说明:部署方式、目录结构和功能更新应以此为准。
-
Hugging Face – SenseNova 6.8 Code2Video:模型权重发布页
- 链接:
huggingface.co/sensenova/SenseNova-6.8-Code2Video - 说明:用于核实模型规格、权重版本和量化进度。
作者:APIYI 技术团队
技术交流:如需了解多模型统一接入方式,可访问 API易 apiyi.com 或 docs.apiyi.com 文档中心