作者注:从 DeepSeek 超级代理设计出发,拆解多代理系统中 router 与 worker 的模型分配逻辑,并讲清楚缓存读取 Token 如何影响架构成本。
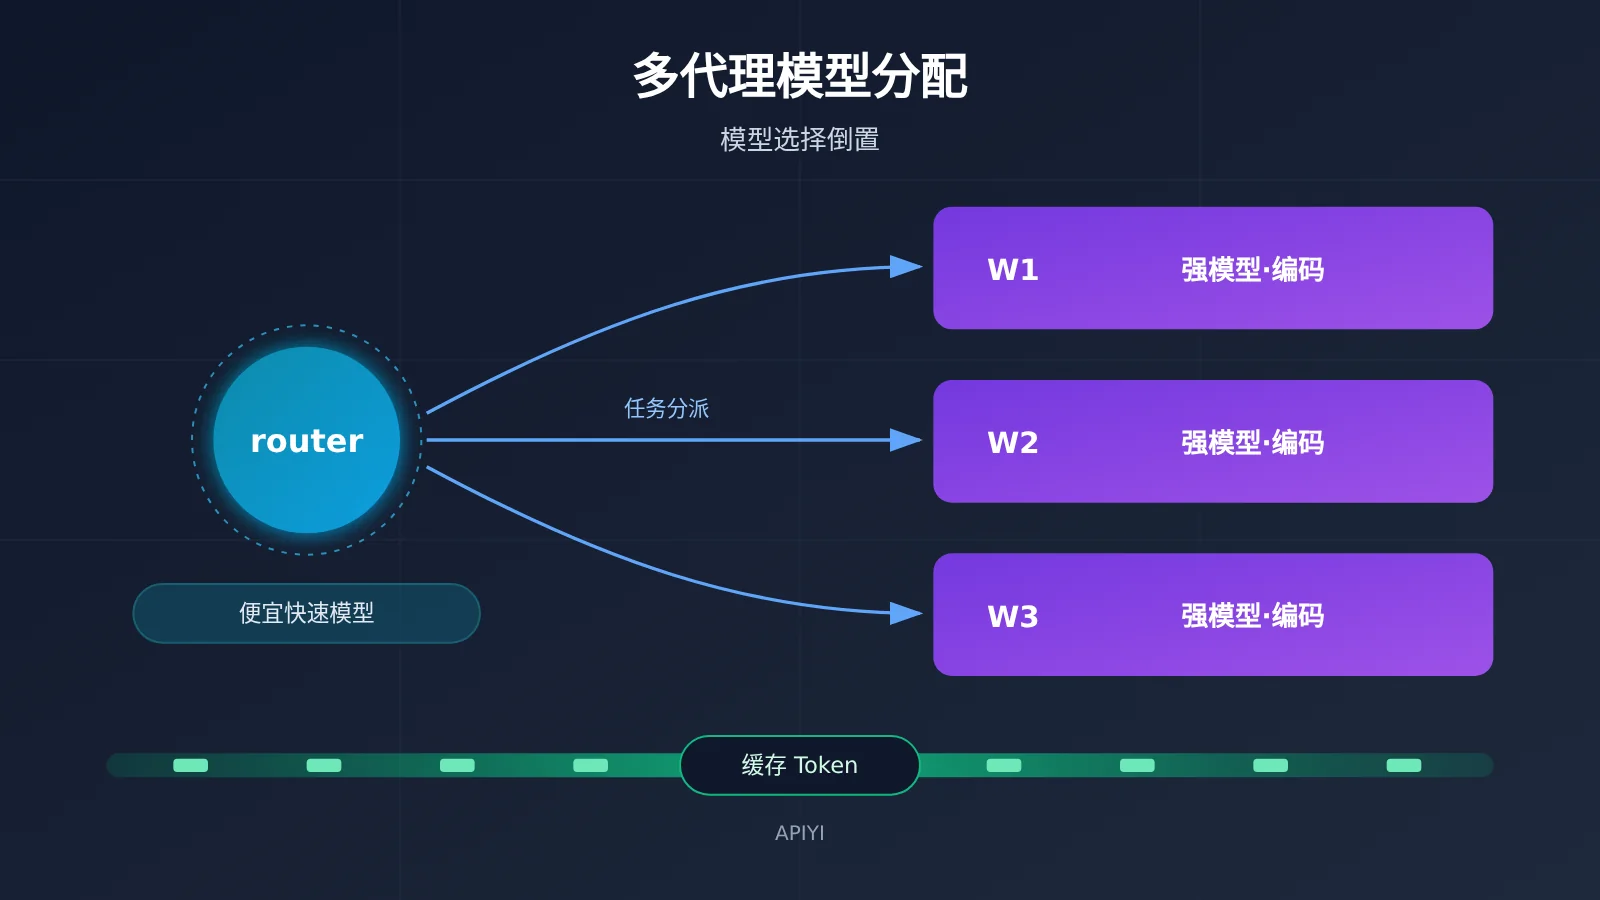
搭建多代理编码系统时,多数人会给“总指挥”配最强的模型,再让下面的执行者用便宜模型。DeepSeek Harness 团队在 2026 年 11 月公开的超级代理设计给出了相反的思路:router 用便宜模型、worker 用强模型。负责对话和派活的 router 用轻量模型,真正写代码的 worker 用最强的模型。
这不是一篇转述新闻的文章。我们把这套架构翻译成可执行的模型选型判断:router 需要哪些能力,worker 需要哪些能力,缓存读取 Token 怎样估算,什么时候该选低价模型。文中引用的测试数据,DeepSeek 自己也只称为“指示性”结果,我们会把边界讲清楚。
核心价值:读完本文,你能为自己的多代理系统写出一份按角色分配模型的方案,并用缓存读取量粗算出这份方案的成本量级。
多代理模型分配核心要点
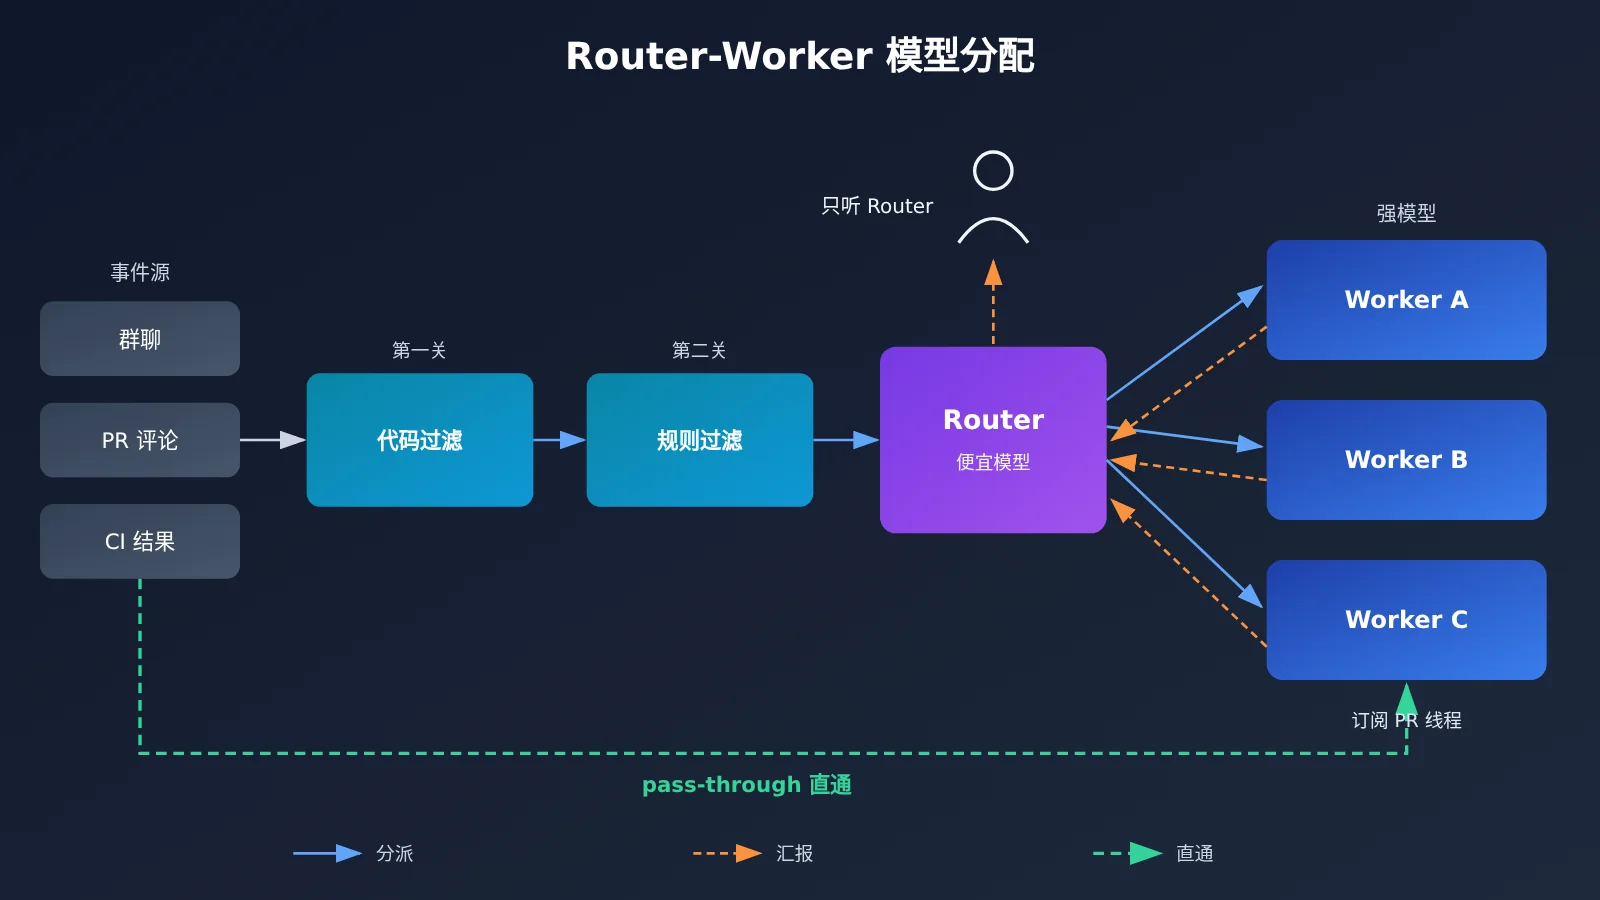
DeepSeek 的设计分为两层。router 是一个长期存在的会话,负责和人沟通、分派任务、跟踪任务之间的关系。worker 每次只领一个任务,拥有独立的干净上下文,从不直接和人对话,只向 router 汇报状态。按这个分工,模型分配可以先用下表定下基调。
| 角色 | 核心职责 | 是否写代码 | 推荐模型档次 | 选型理由 |
|---|---|---|---|---|
| router | 对话、分派、跟踪任务关系 | 否,可以不给 shell 权限 | 轻量、低价、快速 | 工作简单但调用频繁,延迟和单价更重要 |
| worker | 领取单个任务并完成编码 | 是 | 当前可用的最强编码模型 | 代码质量直接决定交付结果 |
| 触发器过滤层 | 筛掉群聊、CI 通知里的噪声 | 否 | 第一道用普通代码,第二道用小模型 | 大多数事件不需要进入模型 |
为什么多代理模型分配要“倒置”
DeepSeek 认为,AI 辅助编码的瓶颈已经从模型能力转移到人的注意力上。一个人通常只能同时跟踪 3 到 5 个活跃的代理会话,再多就会搞不清哪个在等审批、哪个卡住了、哪两个在悄悄修改同一个 PR。所以 router 的价值不在“聪明”,而在“稳定地派活和记账”。它不拆解任务,只负责分配和跟踪,这与常见的“主代理把任务拆成步骤”模式不同。
既然 router 不需要深度推理,也不写代码,把最贵的模型放在这里就是浪费。worker 才是真正产出代码的地方,代码质量决定交付成败,强模型的预算应该花在这里。这就是“模型选择倒置”:越靠近用户的角色越轻,越靠近代码的角色越重。
router 与 worker 分别需要哪些能力
把角色职责拆成能力项,才能落到具体的模型选择上。下面这张清单可以直接用来评估候选模型。
| 能力项 | router 要求 | worker 要求 | 选型提示 |
|---|---|---|---|
| 指令遵循与分类 | 高,要稳定判断任务归属 | 中 | router 优先测分派准确率 |
| 长上下文与回溯 | 中,靠 ID 摘要逐级展开 | 高,需要读大量代码 | worker 看上下文窗口和代码检索能力 |
| 代码生成质量 | 不需要 | 最高优先级 | worker 预算不要省 |
| 响应延迟 | 高优先级,频繁做决策 | 中,单任务可以慢一些 | router 选 Flash 类快速模型 |
| 单价敏感度 | 很高,缓存读取量巨大 | 中 | router 的单价影响总账 |
| 工具调用 | 少,可以不给 shell | 多,需要执行与测试 | 用权限边界约束角色 |
router 还有一个容易被忽略的要求:结构上不能“自己动手”。DeepSeek 特意让 router 没有 shell 权限,就是为了消除它直接干活的可能。所以给 router 选模型时,不必追求它“什么都会”,反而要接受它“只会派活”。
多代理模型分配中的缓存 Token 开销
router 便宜还不够,这套架构真正的成本大头是缓存读取 Token。router 是长期会话,会反复读取缓存中的上下文;多个 worker 并行运行,又各自读取大量上下文。DeepSeek 的测试数据把这个问题摆得很直观。
| 测试指标 | 数值 | 说明 |
|---|---|---|
| 每轮消息数 | 约 300 条 | 其中约 20 条是真实工作请求 |
| 超级代理平均完成时间 | 12.4 分钟 | 慢的一端为 15.7 分钟 |
| 单会话基线慢端耗时 | 29.5 分钟 | 用作对照 |
| router 决策负载 | 每分钟约 1 次升至约 40 次 | 单次决策耗时从 6.4 秒降到 1.6 秒 |
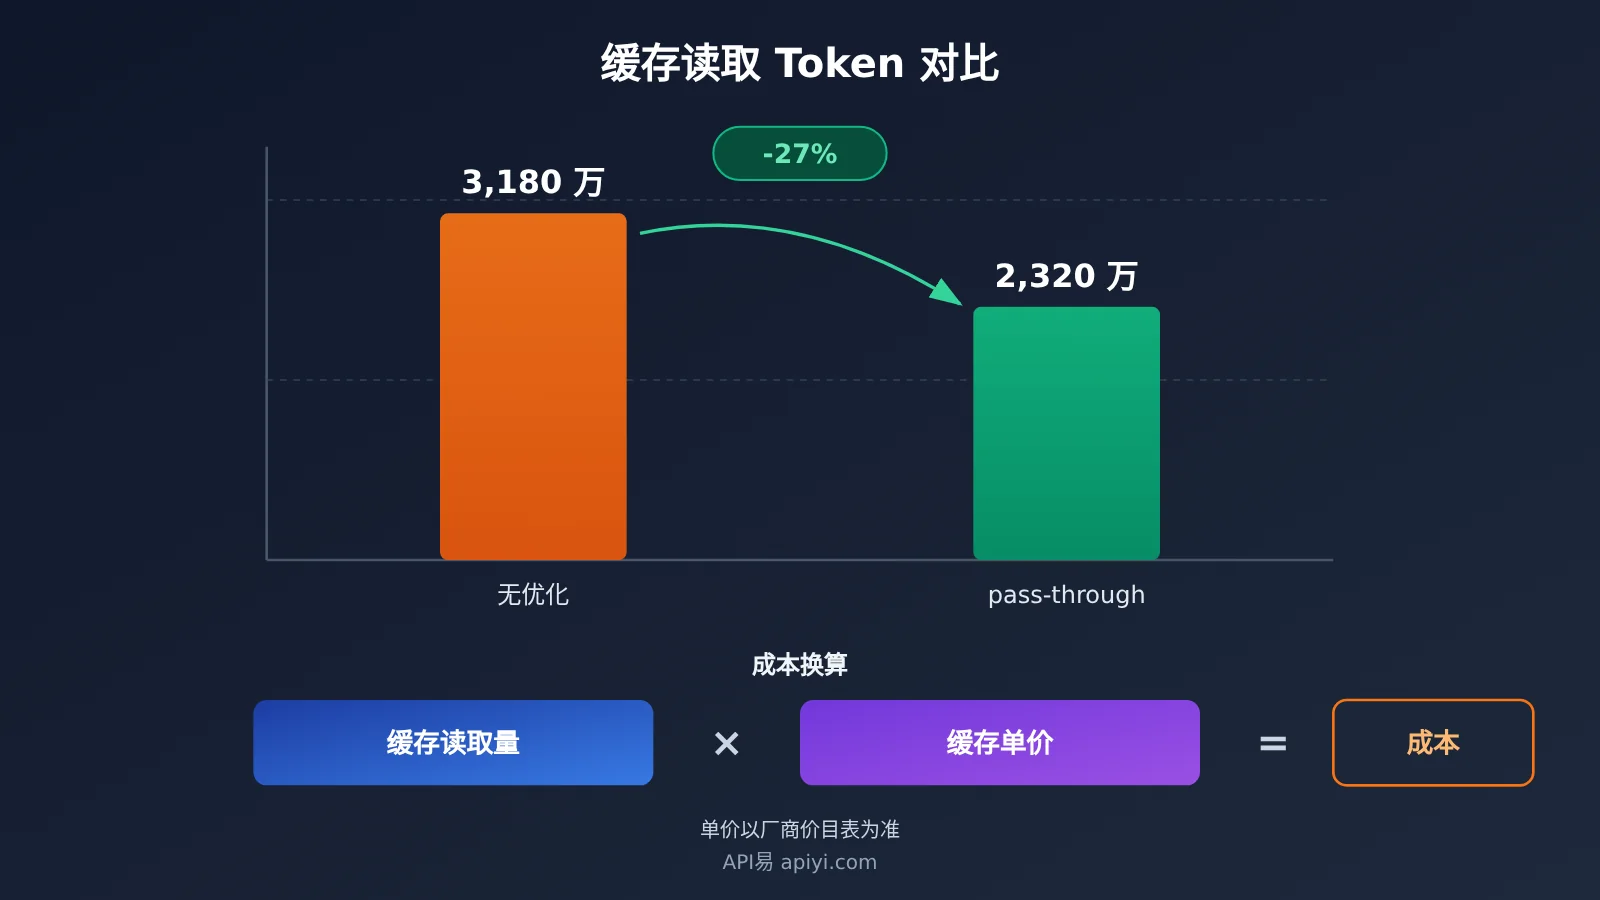
| 缓存读取 Token | 2,320 万 | 开启 pass-through 优化 |
| 无优化时缓存读取 | 3,180 万 | worker 不直接订阅线程的情况 |
| 缓存成本 | 约 7 美元 | 按 DeepSeek 自家闲时 Flash 档定价 |
如何根据缓存读取量估算多代理模型分配成本
估算时可以把一轮运行的成本拆成三块:缓存读取 Token 乘以缓存读取单价,加上未命中缓存的输入 Token 乘以输入单价,再加上输出 Token 乘以输出单价。在 router-worker 架构里,第一项往往占绝对大头,所以缓存读取单价是选型时最该盯住的价格项。
用报道的数字做反推:约 7 美元对应 2,320 万缓存读取 Token,折合约每百万 Token 0.3 美元的量级。这只是由报道数字反推的近似值,不是官方报价,实际价格要以模型厂商当前的价目表为准。有了这个量级,你可以把候选模型的缓存读取单价代入,快速看出同样的工作量换成高价模型会放大多少倍。
pass-through 优化本身也值得注意。worker 订阅线程后,新事件直达 worker,不必经过 router 转发,缓存读取量从 3,180 万降到 2,320 万,减少了约 27%。也就是说,架构层面的优化和换便宜模型一样,都能直接压低账单。
原文数据需要注意的三个边界
- 编码环节是模拟的:测试中“写代码”由一个只消耗时间的工具代替,测的是调度行为,不是代码质量,所以无法用它证明 worker 用什么模型效果最好。
- 数据只是指示性的:DeepSeek 明确说这些数字是 indicative,不是严格的基准测试。
- 与 Sonnet 档的比价表述不一致:报道摘要提到按 Sonnet 档估算约 4.64 美元,正文却说同样用量在高价档会“明显更贵”,两处说法互相矛盾。在查阅 DeepSeek 原始文章核实之前,不建议引用这个具体比价。
多代理模型分配快速上手
把上面的逻辑落到自己的系统里,可以按以下步骤推进。这里不给代码,所有配置项都以行内形式说明,便于你对照自己的框架。
- 先拆角色,再选模型:列出系统中所有会调用模型的角色,至少区分 router、worker、触发过滤三类,为每类写出它是否写代码、是否需要工具。
- 把模型名做成配置项:在配置中为每个角色单独设置
router_model、worker_model、filter_model之类的参数,不要把模型名写死在业务代码里。 - 用结构保证委派:给 router 去掉 shell 等执行工具。DeepSeek 的实验显示,单会话代理在中性提示词下 5 次运行一次都没委派过,最慢一次接近半小时;即使提示词明确要求委派,5 次里也有 1 次判断任务太小自己干了。
- 过滤先行:触发事件先用普通代码按事件来源、白名单筛掉噪声,只把留下的事件交给模型按团队规则判断。
- 记录缓存读取量:每轮运行都记录缓存读取、未缓存输入、输出三类 Token,用前文的公式算出单轮成本。
- 换模型做对比:保持任务集不变,只替换
router_model,观察分派准确率、延迟和成本的变化,再决定是否降档。
在第 2 步和第 6 步,接入方式会直接影响实验效率。如果 router 和 worker 来自不同厂商,各自维护一套密钥和 SDK 配置,切换一次就要改很多地方。通过 API易 apiyi.com 这类统一接口平台,可以用同一个 API 密钥、同一套 OpenAI 兼容请求格式,只改 model 参数就为 router 和 worker 分配不同厂商的模型,对比实验的成本会低很多。
🚀 快速上手建议:做原型验证时,建议先在 API易 apiyi.com 上用同一个密钥分别配置 router 和 worker 的模型参数,跑同一批任务记录 Token 用量。具体有哪些模型可用(例如 DeepSeek 的 Flash 档模型),以平台当前的模型列表为准。
何时该为多代理模型分配选择低价模型
低价模型不是处处适用。下表给出一组判断依据,帮你决定每个角色要不要降档。
| 场景特征 | 建议 | 原因 | 接入方式 |
|---|---|---|---|
| 角色只做分派、跟踪、检查缓存上下文 | 选低价快速模型 | 任务简单,单价和延迟主导体验 | API易 apiyi.com 或厂商官方 API |
| 角色负责生成和修改代码 | 选强模型 | 代码质量决定交付结果 | API易 apiyi.com 或厂商官方 API |
| 缓存读取量达到千万级、并且每天重复运行 | 优先压低缓存读取单价 | 缓存成本随运行次数线性增长 | 按厂商价目表核算 |
| 偶发、轻量的单次任务 | 按量计费即可 | 用量小,不值得为架构复杂度买单 | 任意按量渠道 |
| 高频、Token 密集的自动化任务 | 评估包月或高限额方案 | 单次运行的边际成本不再体现在账单上 | 视具体订阅条款 |
最后一行有一个参照:同期报道的 Claude Code Pass 定价为每月 9.99 美元,在 Kimi K3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash 等开放模型上提供约 2 到 5 倍的速率限额,并设有 5 小时、每周、每月三层用量上限。报道同样认为,在只做路由决策或检查缓存上下文的环节,快速便宜的模型在技术上就更合适,而不只是更省钱。不过这类方案会把你锁定在套餐内的模型上,worker 如果依赖套餐外的模型,仍需要另外的接入渠道。
多代理模型分配的风险与边界
模型分配解决的是成本和分工问题,不解决这套架构本身的遗留难题。DeepSeek 承认了两个未解决的问题:一是长期记忆,系统运行几个月后,如何在不撑爆上下文窗口的前提下保留相关历史仍然很难;二是提示词注入,凡是读取外部事件(群聊、PR 评论)的代理都可能被操纵,而 router 与 worker 通过共享的云端循环相连,一个被攻破的事件源理论上可能把指令扩散到系统接触的每台机器。
这对模型分配有直接影响。router 用了便宜模型,不代表可以放松它的防护,因为它恰恰是第一个接触外部事件的角色。DeepSeek 内部部署时,主动行为先以“本来会这样做”的日志模式运行,而不是立刻执行。比如“静默复现并修复”策略:有人报告 bug 时,代理在后台尝试复现,确认并修好后才在对话进行中提交 PR,复现不了就什么都不发。新系统上线时,先观察日志、再逐步放权,是更稳妥的做法。
此外,原型代码 DSH Super Agent 在 GitHub 上明确标注为研究代码,不是正式产品。参考它的设计思路没有问题,但不建议直接部署到生产环境。
常见问题 FAQ
Q1: 什么是多代理系统中的“模型选择倒置”?
指 router 用轻量便宜的模型,worker 用最强的模型。router 只负责对话、分派和跟踪,不写代码;worker 负责实际编码,因此强模型的预算应该花在 worker 上,而不是放在“总指挥”的位置。
Q2: router-worker 架构和“主代理拆解任务”的模式有什么区别?
主代理模式中,主代理要把任务拆成步骤,对推理能力要求较高。DeepSeek 的 router 不做任何拆解,只分配和跟踪任务,所以能用更轻的模型。代价是 worker 必须能独立完成整个任务。
Q3: 这套设计是什么时候公开的?DSH Super Agent 能直接用吗?
相关报道发布于 2026 年 11 月 3 日。DSH Super Agent 是随设计文章一起发布在 GitHub 上的研究原型,官方明确它不是受支持的产品,只适合用来理解架构。
Q4: 只用提示词让单个代理学会委派,可行吗?
DeepSeek 的测试表明不可靠:中性提示词下 5 次运行零委派,强调委派的提示词也有 1 次没有委派。可靠的委派要靠结构隔离,例如拆分会话、移除执行工具,而不是写更长的提示词。
Q5: 如何在同一个系统里方便地为 router 和 worker 配置不同厂商的模型?
关键是把模型名做成按角色区分的配置项,并统一接入方式:
1. 在 API易 apiyi.com 注册并获取一个 API 密钥
2. 在系统配置中分别设置 router 和 worker 的 `model` 参数
3. 保持请求格式不变,只替换模型名来做对比实验
这样不需要为每个厂商单独维护一套 SDK 配置。可用模型以平台当前列表为准。
Q6: 原文的成本数据能直接用来做预算吗?
不建议直接套用。编码环节是模拟的,数据只是指示性结果,与 Sonnet 档的比价表述也前后不一致。更好的做法是用自己的任务集实测缓存读取量,再乘以当前单价。在 API易 apiyi.com 上保持任务不变、切换模型分别跑一轮,就能得到适合自己场景的数据。
Q7: 这种架构有哪些已知限制?
主要有三点:长期运行后的记忆退化;读取外部事件带来的提示词注入风险;缓存读取 Token 量很大,用高价模型时成本会被明显放大。此外,目前缺少 router 具体使用哪个模型的效果数据,需要自行测试。
多代理模型分配核心要点 Key Takeaways
- 模型选择倒置:router 用轻量便宜模型,worker 用强模型写代码。
- 瓶颈在注意力:人通常只能盯住 3 到 5 个会话,router 负责收拢沟通。
- 委派靠结构:去掉 router 的执行工具,比改提示词可靠得多。
- 缓存是成本大头:一轮测试缓存读取达 2,320 万 Token,单价最关键。
- 架构优化同样省钱:pass-through 直通让缓存读取减少约 27%。
- 数据要谨慎引用:编码为模拟,结果仅具指示性,比价待核实。
- 用统一接口做实验:在 API易 apiyi.com 只改
model参数即可对比不同分配方案。
总结
router 用便宜模型、worker 用强模型,这套多代理模型分配思路的核心要点如下:
- 按职责分档:不写代码、只做分派跟踪的角色用低价快速模型,编码角色用强模型。
- 按缓存算账:缓存读取 Token 是这类架构的主要开销,选型时优先比较缓存读取单价。
- 按实测定案:原文数据只能参考方向,最终要用自己的任务集跑出成本和效果。
建议先用一个小任务集搭起 router-worker 原型,把模型名做成按角色配置的参数,再逐步替换 router 的模型,观察分派准确率和成本的变化。推荐通过 API易 apiyi.com 用一个密钥统一接入多家模型来完成这组对比,让选型决策建立在自己的数据上。
📚 参考资料
- DeepSeek’s Super Agent Harness: Fixing the Attention Bottleneck in AI Coding:DeepSeek 超级代理设计解读
- 链接:
mindstudio.ai/blog/deepseek-super-agent-harness-design -
说明: 包含 router-worker 架构、委派实验、缓存 Token 数据与未解决问题
-
Claude Code Pass Pricing: What’s in the $9.99/Month Plan:包月高限额方案解读
- 链接:
mindstudio.ai/blog/claude-code-pass-pricing - 说明: 讨论按量计费与包月方案在多代理、Token 密集型工作流中的取舍
作者: APIYI 技术团队
技术交流: 欢迎在 API易 apiyi.com 首页联系我们讨论多代理模型分配方案,更多接入资料可访问 docs.apiyi.com 文档中心