作者注:Fable 5.5 与 GPT-6.2 Astra 都有公开 demo,但没有同题对比。本文梳理 6 个 demo 的证据等级,对比现役旗舰 Fable 5.1 与 GPT-6 Astra 的官方规格和价格,并给出一套可重跑的选型评测方法。
先给结论:Fable 5.5 和 GPT-6.2 Astra 谁更强,目前没有答案。两个模型都没有正式发布。截至 2026-11-03,Anthropic 模型目录里仍是 Fable 5.1,OpenAI 模型目录里仍是 GPT-6 Astra(来源:两家官方模型页,证据等级:官方文档)。两者的公开 demo 都放在同一个第三方测试站 Model Tests 上,作者是 @notjazii,但做的不是同一道题。Fable 5.5 有游戏、短片、SVG、WebGL 等 5 个作品,GPT-6.2 Astra 只有 1 条像素动画 GIF。任务不同,就谈不上谁赢。
所以本文不排名次,只回答三个问题:这些 demo 能证明什么、不能证明什么;现在能拿来比的 Fable 5.1 和 GPT-6 Astra 在官方规格上差在哪里;以及怎样准备一套 20 到 50 条任务的自有评测,等新模型上线后只换模型名就能重跑。其他传闻线(如 Mythos 5.5、Gemini 4 Carbon)本文不展开。
这不是一篇“看起来各有千秋”的折中稿。证据不够的地方会直接写明不够,能下判断的地方会直接给建议。
Fable 5.5 vs GPT-6.2 Astra 的公开 demo 清单
判断:demo 能证明模型可以产出可运行的成品,但两边题目、数量、档位都不一样,不能直接拿来比。
Model Tests 站点共收录 11 个项目、8 个模型,每条都标注了日期、模型和类型(来源:站点页面,证据等级:社区自述)。下表把 Fable 5.5 和 GPT-6.2 Astra 名下的全部 6 个作品,以及站内可以当基线的几条放在一起。模型归属全部是作者自称。
| 作品 | 作者标注 | 类型 | 日期 | 内容要点 |
|---|---|---|---|---|
| VoxelCraft | Fable 5.5 xhigh | 可玩 HTML 游戏 | 2026-11-01 | 单文件《我的世界》克隆,含生存/创造、合成、熔炉、附魔、红石、村民、多生物群系、下界与末地 |
| The Last Page | Fable 5.5 xhigh | 66 秒有声短片 | 2026-11-02 | 狐狸、月光图书馆、书页风暴、飞向云层 |
| Open Me | Fable 5.5 xhigh | WebGL 交互体验 | 2026-11-02 | raymarched WebGL2 加生成式音乐,需要独立 GPU |
| Acorn Bread on a Stick | Fable 5.5 xhigh | 手写 SVG | 2026-11-02 | 橡子面包插画 |
| Fruit Basket | Fable 5.5 max | 纯矢量静物 | 2026-11-02 | 3000×2400,无位图,写实水果篮 |
| Tsukimi Moon Ferry | GPT 6.2 Astra Max | 像素动画 GIF | 2026-11-02 | 满月下的日式河镇:城堡、富士山、红桥、飞鲤、浮灯、渡船 |
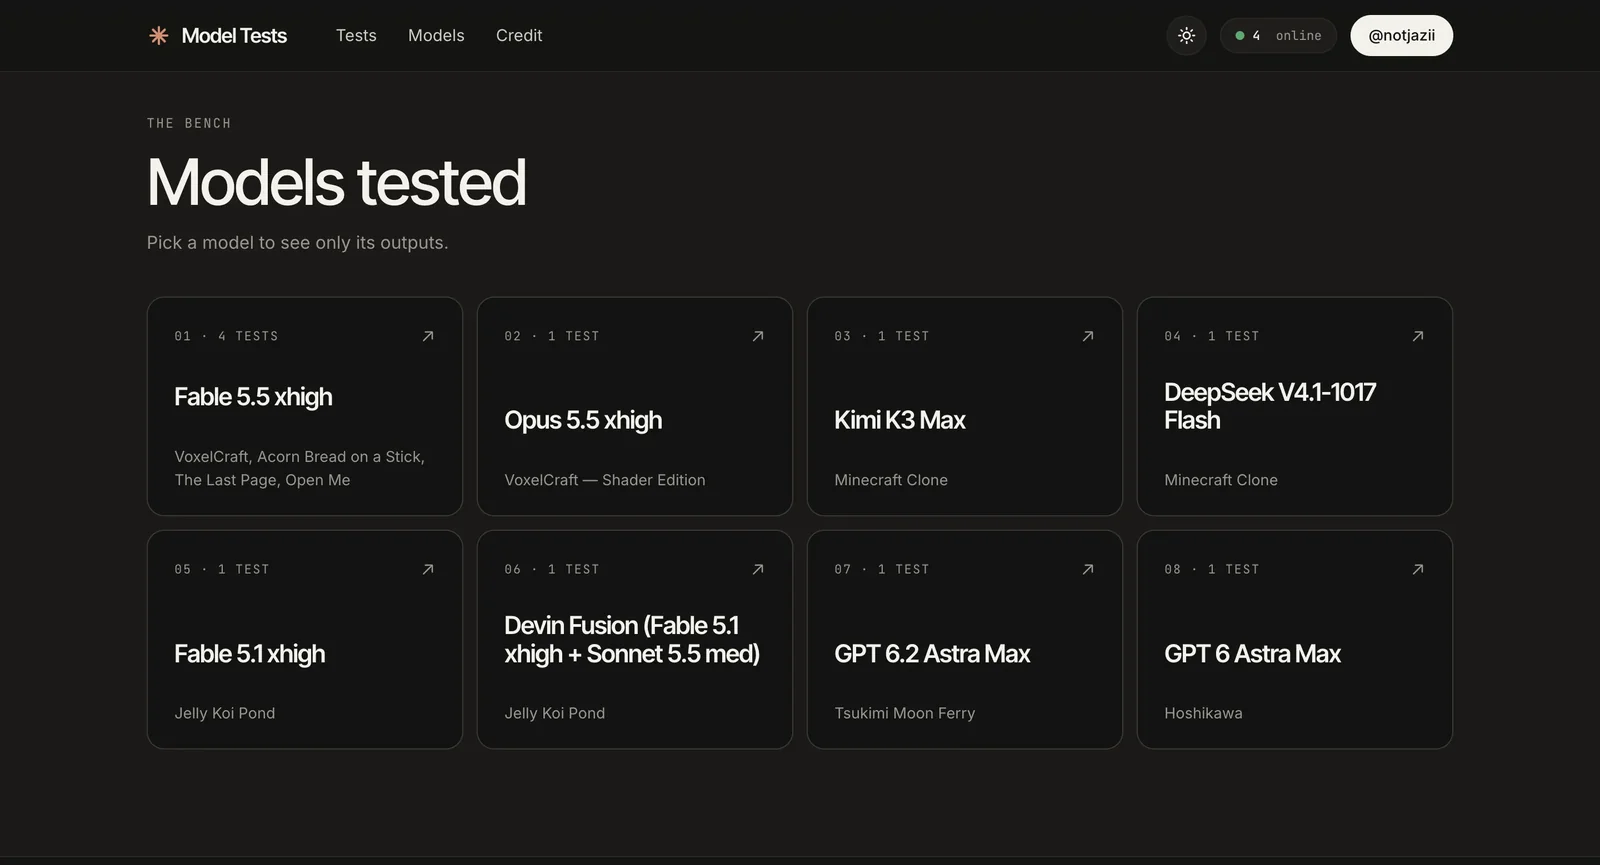
图注:Model Tests 的模型列表。Fable 5.5 xhigh 名下 4 条测试,GPT-6.2 Astra Max 只有 1 条,GPT-6 Astra Max 也是 1 条(截图 2026-11-03)。
站内还有几条可以当参照的作品。Hoshikawa 标注为 GPT 6 Astra Max,同样是满月下的日式小镇像素动画(2026-11-02),风格和 Tsukimi Moon Ferry 接近,是站内唯一接近同题的 OpenAI 新旧版本对照。VoxelCraft — Shader Edition 标注为 Opus 5.5 xhigh(2026-11-01),和 Fable 5.5 的 VoxelCraft 是同一道题。此外,Kimi K3 Max 和 DeepSeek V4.1-1017 Flash 也各做过一个 Minecraft 克隆(2026-10-17)。
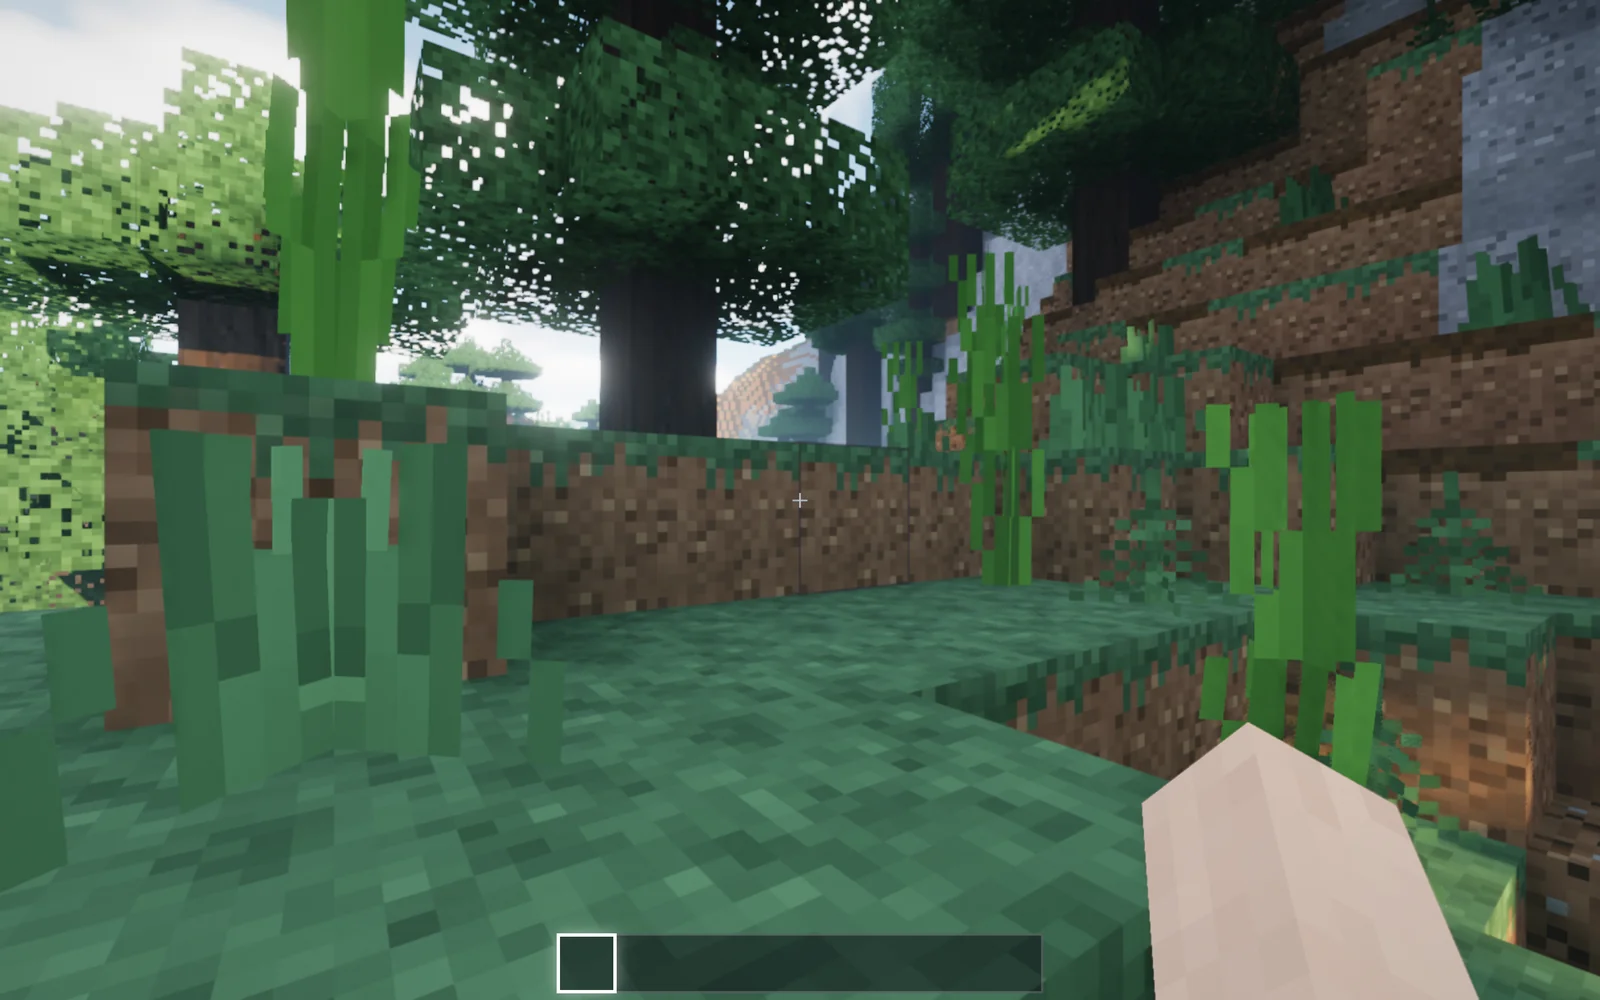
图注:Fable 5.5 xhigh 的 VoxelCraft,单文件《我的世界》克隆,点开就能走(截图 2026-11-03)。
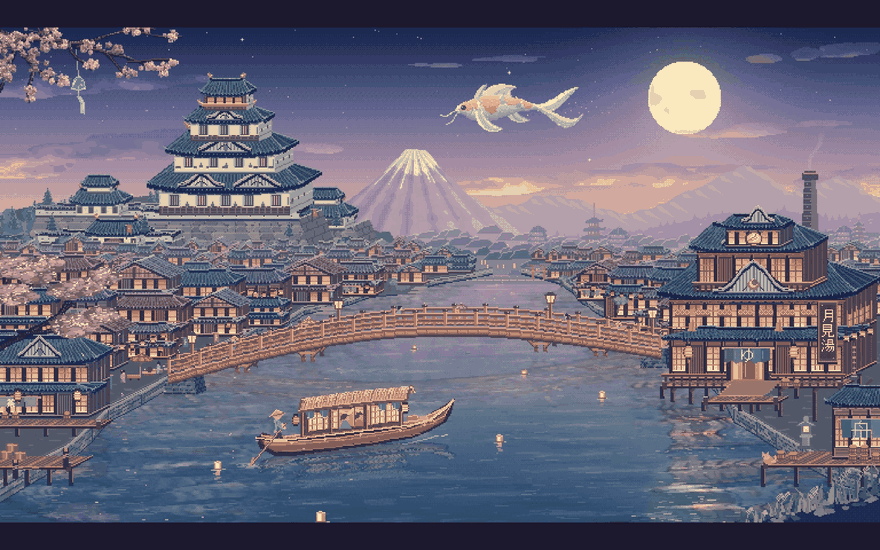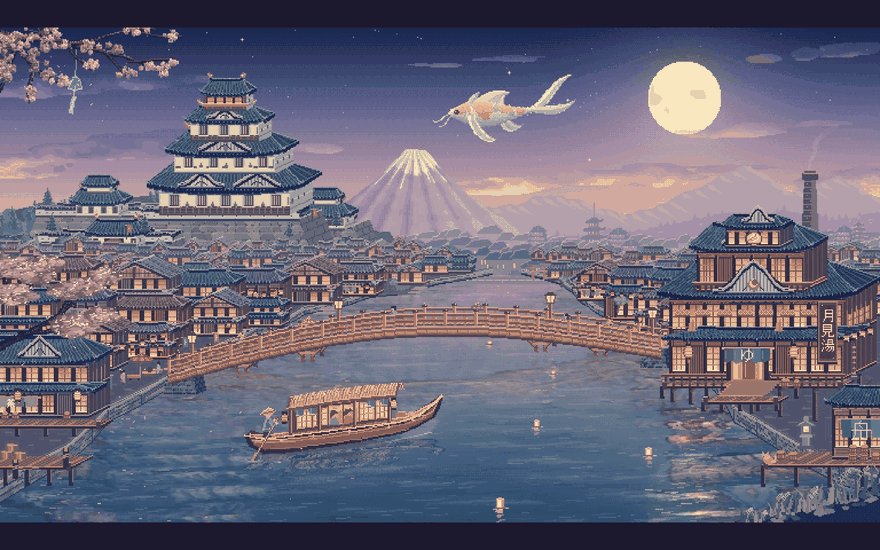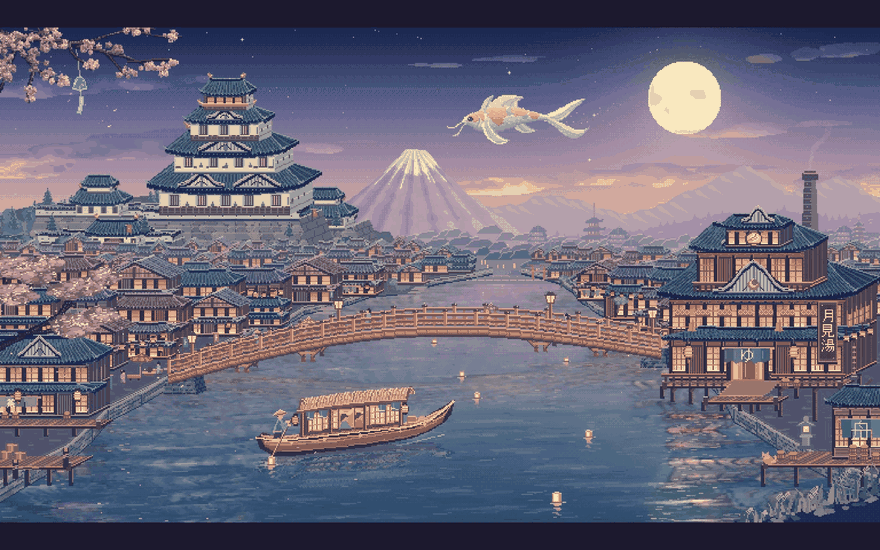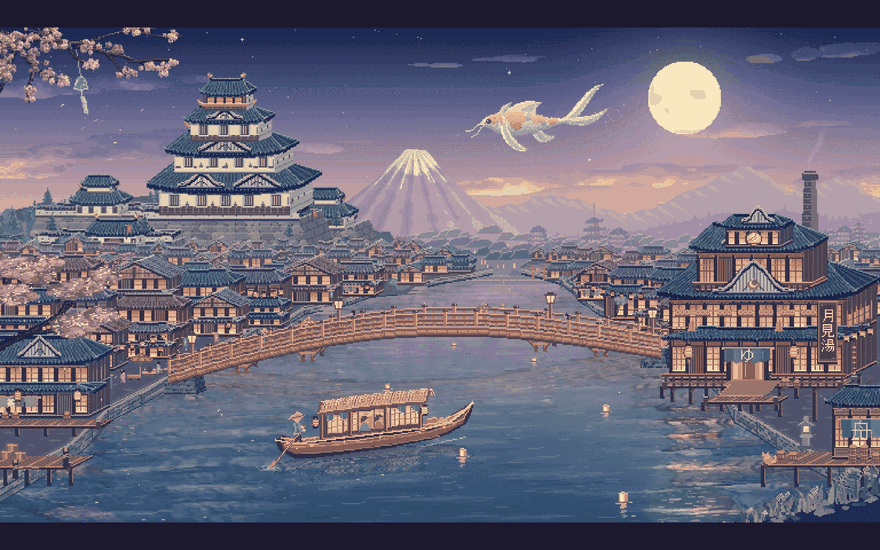
图注:GPT-6.2 Astra Max 的 Tsukimi Moon Ferry,像素动画 GIF,满月下的日式河镇(录屏 2026-11-03)。
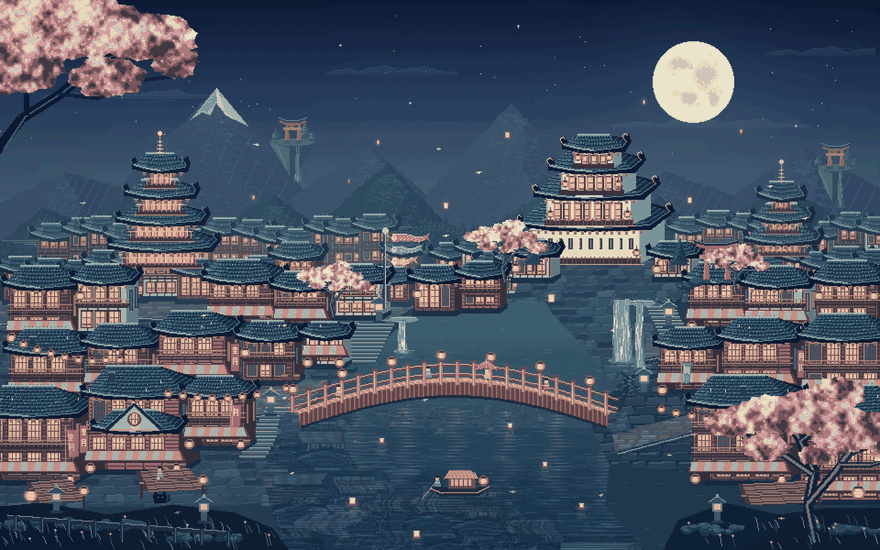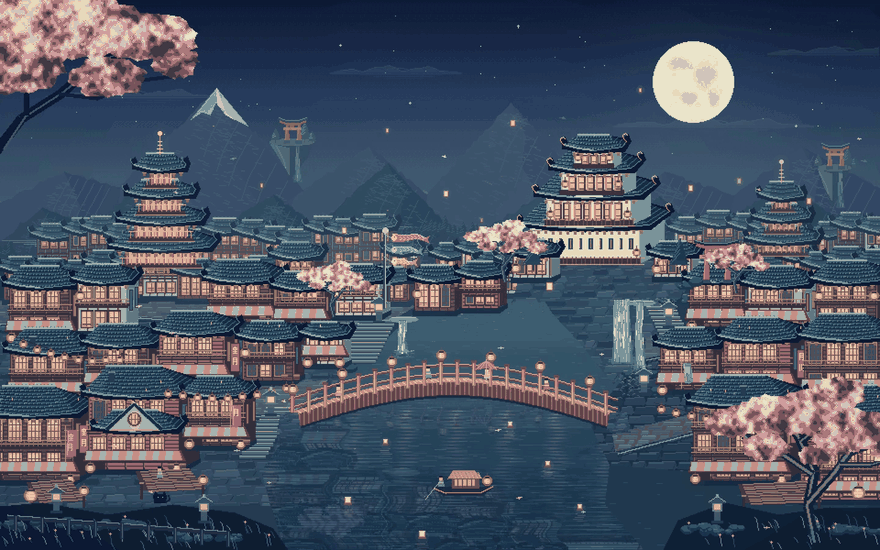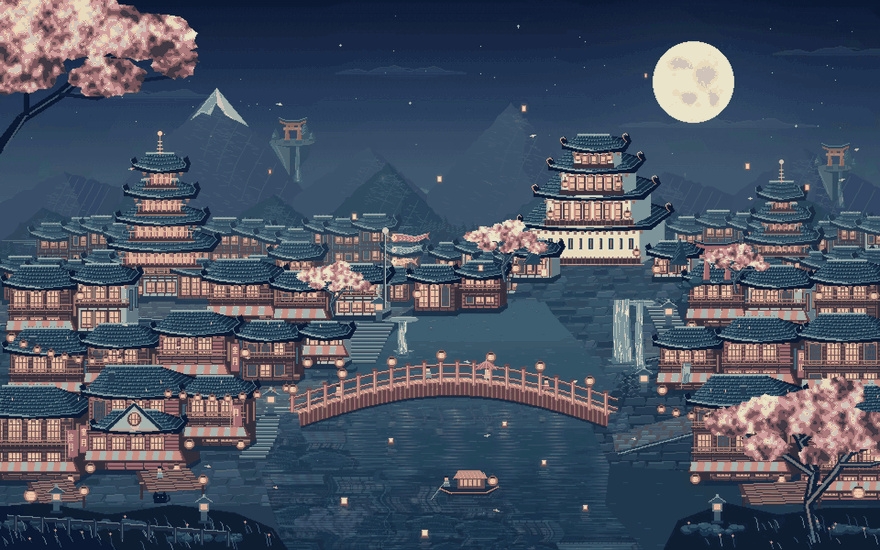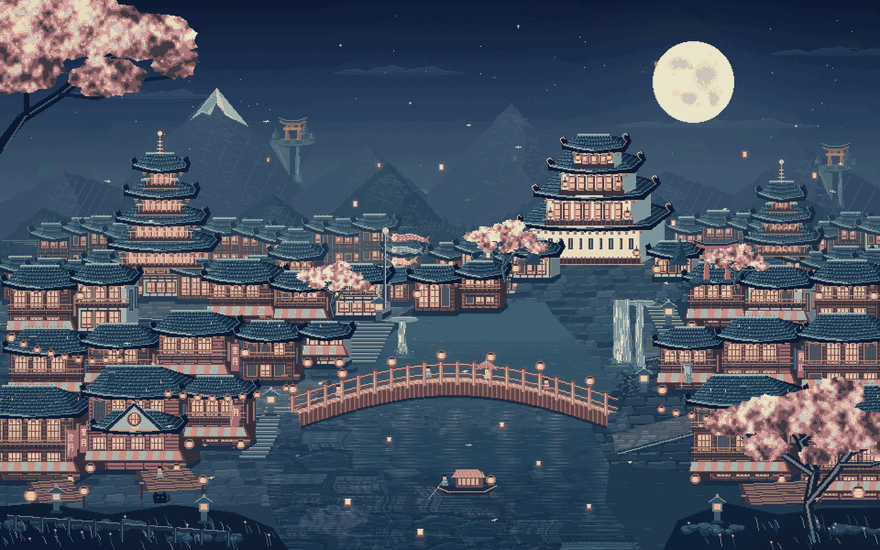
图注:对照组,GPT-6 Astra Max 的 Hoshikawa,同站同风格,用来对照 6.2 的像素动画(录屏 2026-11-03)。
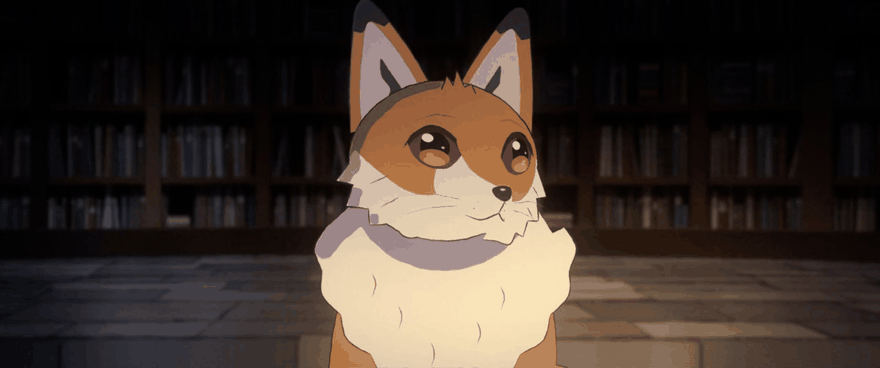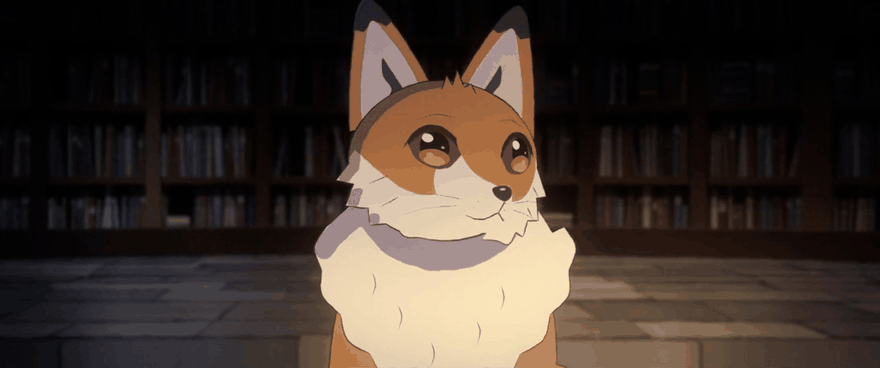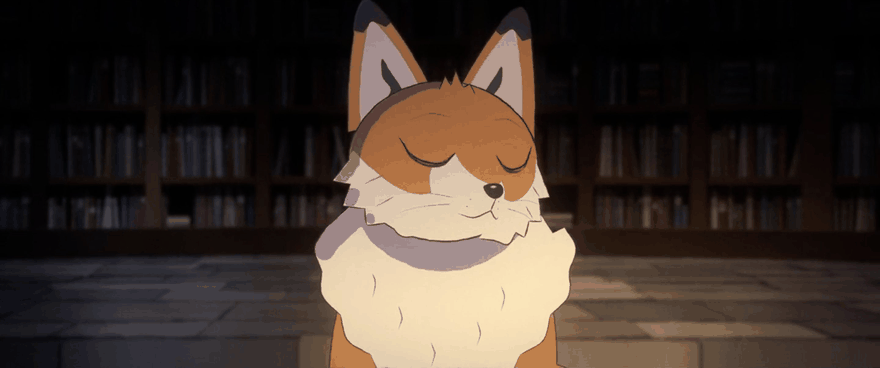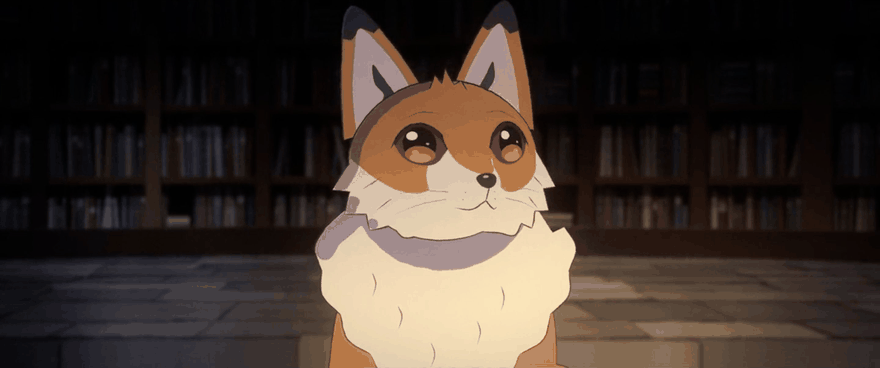
图注:Fable 5.5 xhigh 的 66 秒有声短片 The Last Page,狐狸在月光图书馆的一段(GIF 截取 2026-11-03,无声音)。
站内唯一带成本和耗时的是 Jelly Koi Pond。Fable 5.1 xhigh 版本约耗时 1 小时 40 分、成本 $25;Devin Fusion 组合(Fable 5.1 xhigh 加 Sonnet 5.5 med)约耗时 1 小时、成本 $11(日期 2026-10-21,证据等级:社区自述)。除这一条之外,站内没有任何作品公开耗时或成本,本文也不做推算。
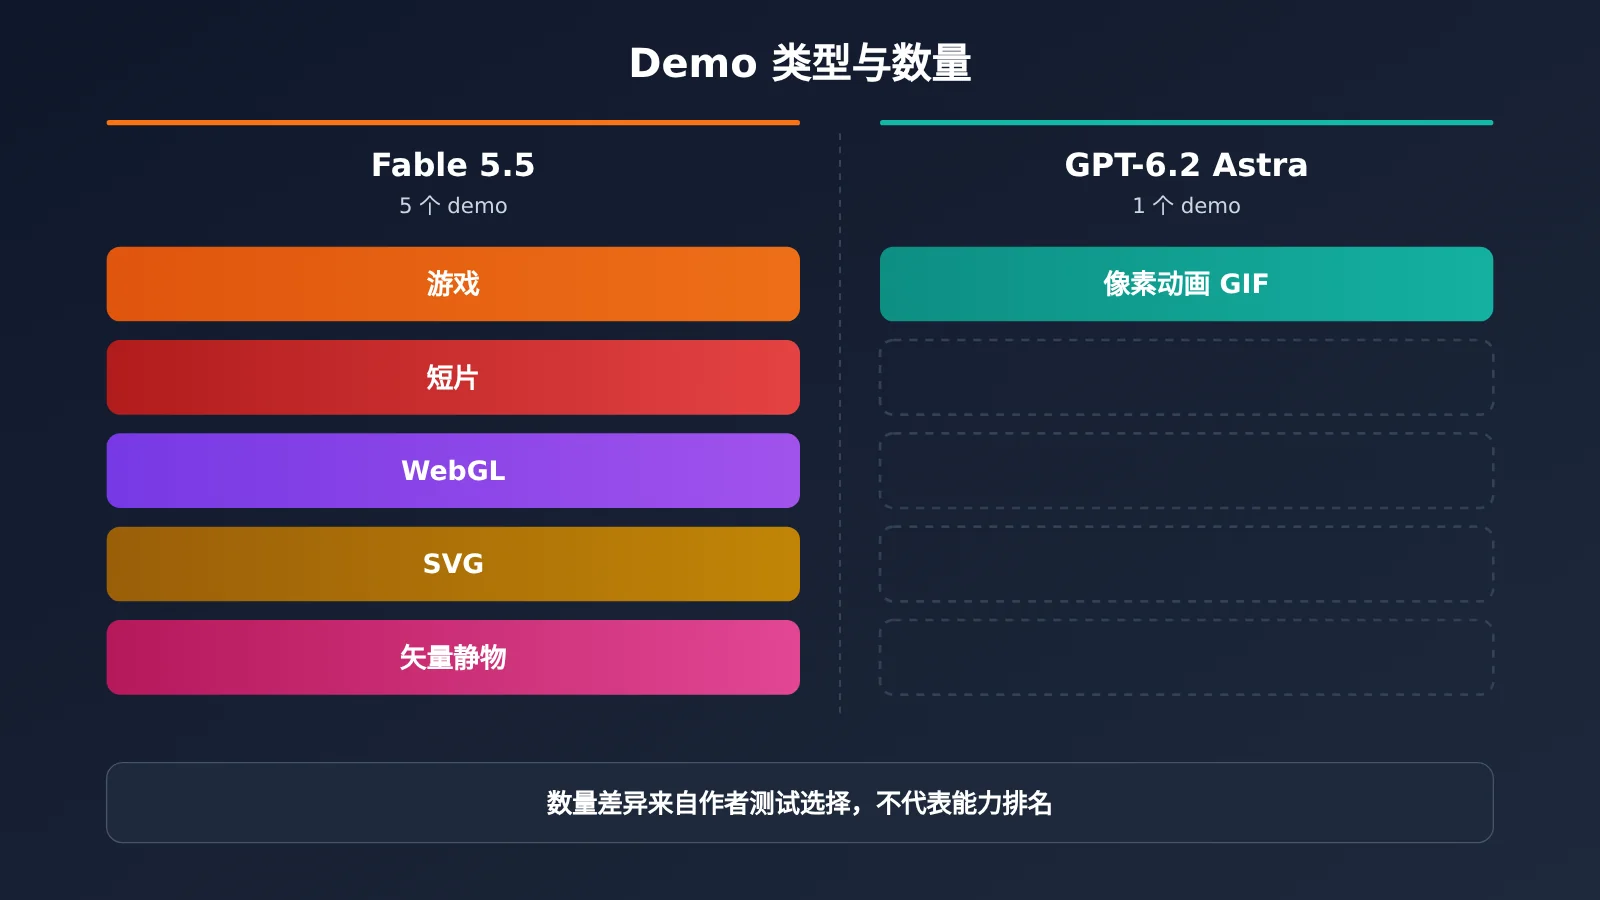
上图展示的是 demo 类型和数量的分布,不是能力排名。如果想在自己的任务上看两家现役旗舰的真实差距,可以在 API易 apiyi.com 用同一个 Key 分别调用 claude-fable-5-1 和 gpt-6-astra。
Fable 5.5 vs GPT-6.2 Astra:三个“看起来公平其实不公平”的点
判断:同一个站、同一个作者,容易让人以为这是一次横评,实际上至少有三处不对等。
不公平点一:题目完全不同
Fable 5.5 的 5 个作品覆盖游戏、短片、WebGL、SVG 四类,GPT-6.2 Astra 只有像素动画一类。没有任何一道题两者都做过。像素动画考的是构图和逐帧一致性,单文件游戏考的是长代码组织和状态管理,两者没法互相换算。真要做纵向参考,GPT-6.2 Astra 只能对照同站的 GPT-6 Astra(Hoshikawa),Fable 5.5 只能对照 Opus 5.5(VoxelCraft — Shader Edition)。
不公平点二:推理档位、日期、数量都不对等
Fable 5.5 的作品多数标注 xhigh,只有 Fruit Basket 是 max;GPT-6.2 Astra 标注的是 Max。不同档位意味着推理预算不同,产出质量自然不能直接比。数量上也是 5 比 1,这只是作者选择测什么,不是官方评测结果。把 demo 数量当成能力强弱,是这次讨论里最常见的误读。
不公平点三:模型归属无法核验
所有 demo 都没有公开提示词、调用日志或模型卡,模型归属完全依赖作者标注。ByteForward 在 11-02 的核查中提到,部分标注为“Fable 5.5”的演示,可能是 Opus 5.5 请求被路由到新模型,模型选择器里仍显示 Opus 5.5(证据等级:单一媒体报道)。在这个前提下,只能写“作者自称 Fable 5.5”,不能写“Fable 5.5 做出了”。
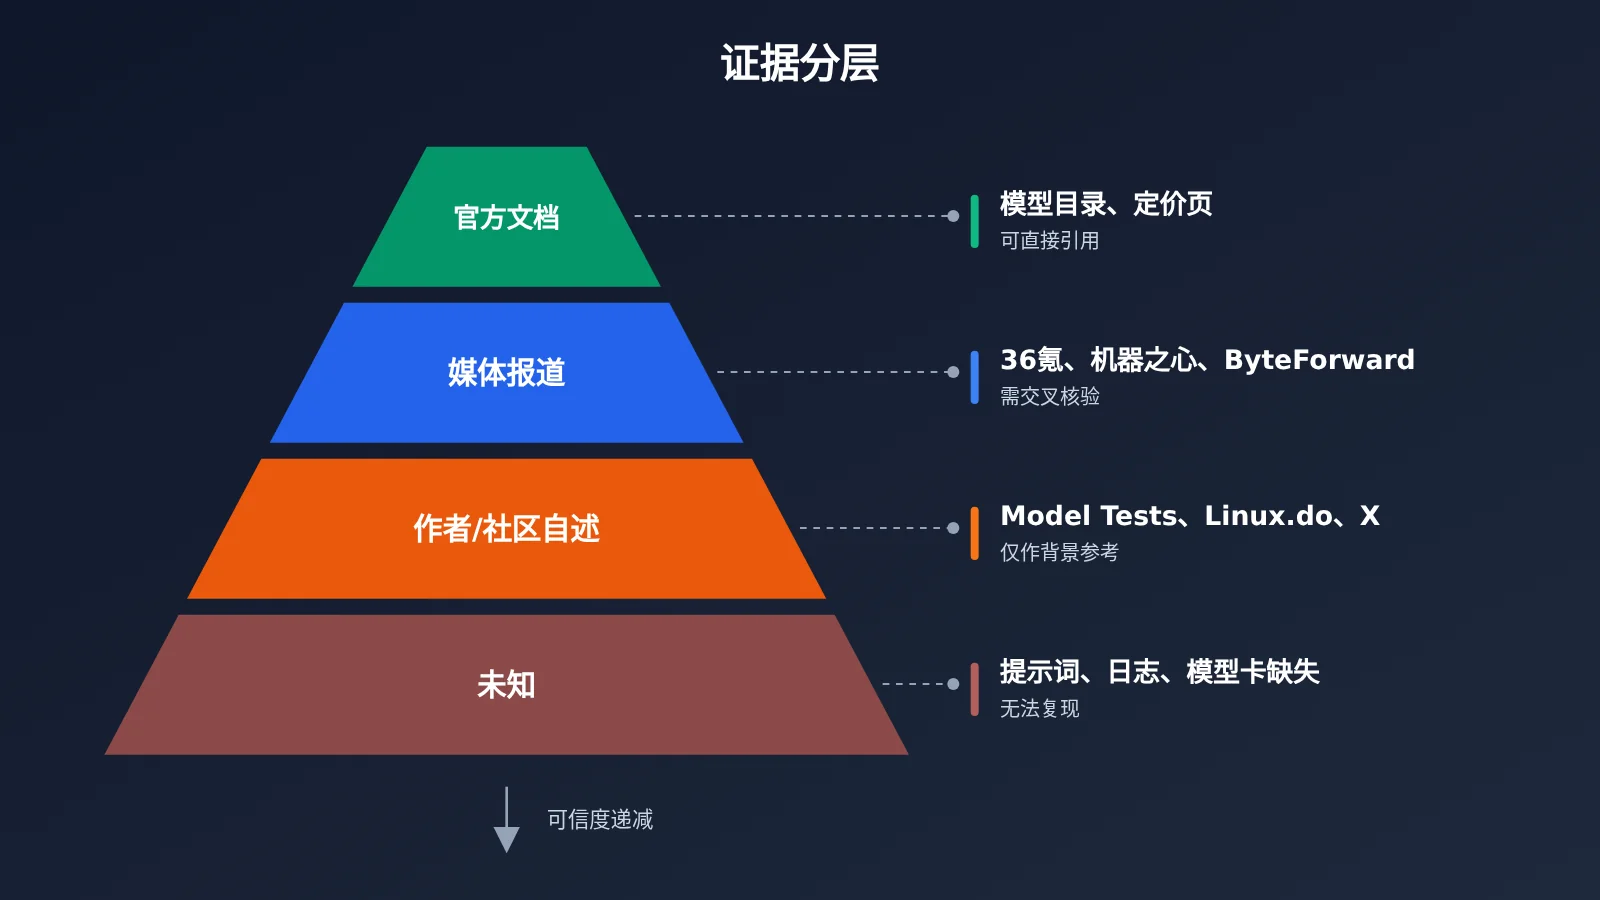
下表按证据等级整理目前和这两个模型相关的说法。建议读者在团队内部转述时,也保留证据等级这一列。
| 说法 | 来源 | 日期 | 证据等级 |
|---|---|---|---|
| Anthropic 目录仍为 Fable 5.1,无 Fable 5.5 | Anthropic 定价页与新闻页 | 11-03 读取 | 官方文档 |
| OpenAI 目录仍为 GPT-6 Astra,无 GPT-6.2 Astra | OpenAI 模型目录 | 11-03 读取 | 官方文档 |
LiteLLM 加入 azure_ai/claude-fable-5-5 价目项 |
TestingCatalog 记录 | 10-13 | 第三方记录 |
| Fable 5.5 支持 1M 输入、12.8 万输出 | 36 氪/新智元 | 11-02 | 单一媒体报道 |
| GPT-6.2 Astra 汇总评价“显著跃升” | 机器之心/新浪 | 11-02 | 媒体汇总,无 benchmark |
| 用量明细中 gpt-6.2-astra 占 1.6% | Linux.do @fourfour | 11-01 | 社区自述 |
| 用量明细中 gpt-6.2-astra 占 19.8% | X @TokenGremlin | 11-01 | 社区自述 |
| Model Tests 上的 demo 模型归属 | 作者 @notjazii | 11-01 至 11-02 | 作者自称 |
| 部分 Fable 5.5 demo 实为 Opus 5.5 被路由 | ByteForward | 11-02 | 单一媒体报道 |
关于 GPT-6.2 Astra 的流量数据需要特别说明。Linux.do 帖子晒的是 10/25 到 10/31 的 Codex 用量分布,97.7% 仍是 gpt-6-astra,gpt-6.2-astra 只占 1.6%;同帖 13 行账单里有 12 行仍是 gpt-6-astra,速度在 44 到 73 tok/s 之间。X 上 TokenGremlin 晒出的版本是 19.8%,传播更广(约 15.5 万浏览)。这两个数字都是个人账号截图,不是官方数据。机器之心自己也写明,截图只能证明“有用户报告获得访问权限”。另外,GPT-6.2 Betelgeuse / Bel 是更早流传的另一个基座代号,和 6.2 Astra 不是同一回事。
社区体感也互相矛盾。有人认为 Fable 5.5 更强,也有人认为它和 Opus 5.5 打平;关于 GPT-6.2 Astra,有人说它不如 Opus 5.5,有人说只是增量改进,也有人说它多个维度超过 Opus 5.5。这些说法都没有 benchmark 和样本量,只能当作背景参考。
Fable 5.1 vs GPT-6 Astra 官方规格与价格对比
判断:新模型还没有官方规格,能对齐比较的只有现役旗舰。两者单价相同,真正的差别在长输入计费、知识截止和推理档位。
Fable 5.1 和 GPT-6 Astra 的官方单价都是输入 $10、输出 $50(每百万 tokens),最大输出都是 128K,上下文是 1M 对 1.05M。下表数据来自两家官方模型页,读取时间为 2026-11-03,证据等级为官方文档。
| 规格项 | Fable 5.1 | GPT-6 Astra |
|---|---|---|
| 模型 ID | Anthropic 官方 Fable 5.1 | gpt-6-astra |
| 上下文窗口 | 1M | 1.05M |
| 最大输出 | 128K | 128K |
| 知识截止 | 2026-06 | 2026-04-30 |
| 推理控制 | Adaptive thinking 常开,默认 effort 为 high | low / medium / high / xhigh / max |
| 工具能力 | 以官方文档为准 | 函数调用、网页搜索、文件搜索、computer use |
推理控制的差异会直接影响评测设计。Fable 5.1 的 Adaptive thinking 常开,默认 effort 为 high;GPT-6 Astra 提供五档可选。两者的档位命名不对应,所谓“同档”只能尽量对齐,不能完全等价。评测时建议把档位作为记录字段,而不是假设 high 等于 high。
价格方面,官方单价相同,但计费细节差别很大。下表同时列出官方价格和 API易 平台的在架价格(每百万 tokens,美元)。
| 计费项 | Fable 5.1 官方 | GPT-6 Astra 官方 | API易 apiyi.com 在架 |
|---|---|---|---|
| 输入 | $10 | $10 | claude-fable-5-1 $10;gpt-6-astra 0 到 272,000 tokens 为 $10 |
| 长输入 | 1M 内维持 $10 | 以官方页为准 | gpt-6-astra 272,001 到 1,050,000 tokens 为 $20 |
| 输出 | $50 | $50 | 两者均为 $50 |
| 缓存命中/读取 | $0.25 | 以官方页为准 | claude-fable-5-1 $0.25;gpt-6-astra $1 |
| 缓存写入 | 5 分钟 $12.50,1 小时 $20 | 以官方页为准 | 以平台型号列表为准 |
| 端点 | messages | responses、chat | claude-fable-5-1:chat / messages;gpt-6-astra:responses / chat |
对做长文档分析、大型代码库理解的团队来说,这张表比“谁更强”更有用。单次输入超过 27.2 万 tokens 时,gpt-6-astra 的输入价会翻倍到 $20;claude-fable-5-1 在 1M 范围内一直是 $10。缓存读取价也差 4 倍($0.25 对 $1)。如果你的场景反复调用同一份长上下文,这两项差异在账单上会很明显。型号与价格以平台型号列表为准。
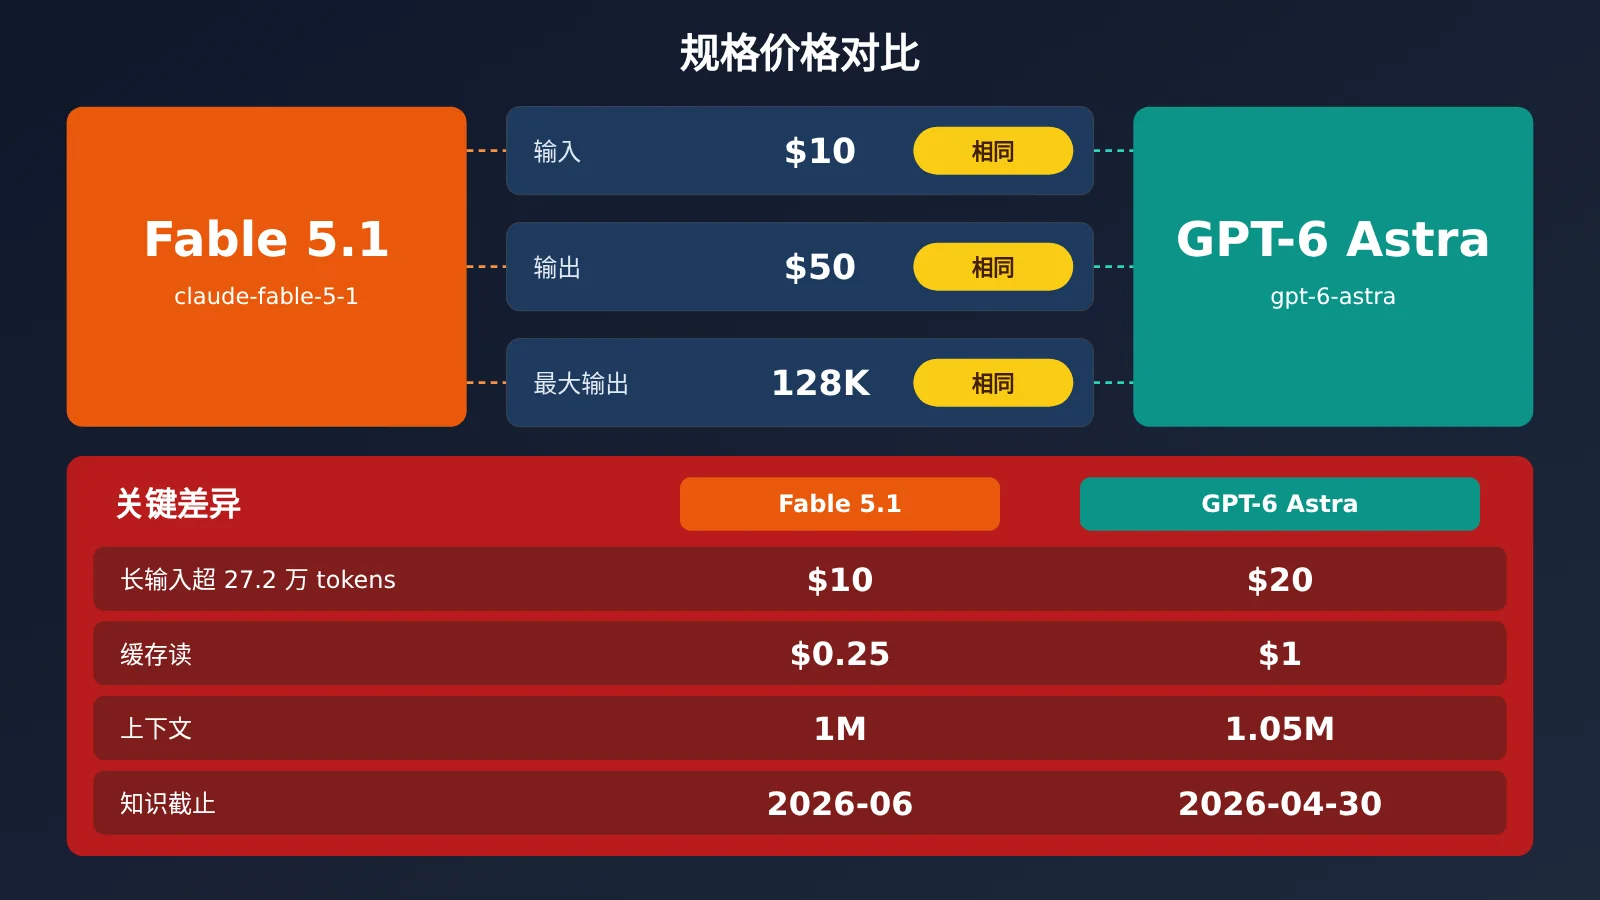
图中价格来自官方模型页和 API易 apiyi.com 平台价格接口,读取时间为 2026-11-03。
Fable 5.5 与 GPT-6.2 Astra 上线前,现在能用什么
判断:新模型没有官方 API,现在能做的是用两家现役旗舰跑基线,把评测框架先搭起来。
截至 2026-11-03,API易 平台的型号接口返回 259 个型号,价格接口共 277 个型号。其中包含 gpt-6-astra、gpt-6.1-sol、gpt-6.1-terra、gpt-6-luna 和 claude-fable-5-1,没有 gpt-6.2-astra,也没有 claude-fable-5-5。也就是说,两家现役旗舰已经可以在同一个 Key 下同台跑基线。同日用 claude-fable-5-1 发起一次 max_tokens 为 32 的 messages 请求,返回 HTTP 200,接口可用。
接入方式和 OpenAI SDK 兼容。把 base_url 设为 https://api.apiyi.com/v1,模型名分别填 claude-fable-5-1 和 gpt-6-astra 即可。如果需要 Anthropic 原生的 messages 格式,claude-fable-5-1 同样支持;gpt-6-astra 则可以走 responses 或 chat 端点。
🚀 快速开始:在 API易 apiyi.com 注册后使用新用户免费测试额度,先用 3 到 5 条任务试跑
claude-fable-5-1和gpt-6-astra,确认输出格式和 token 记录都正常,再扩展到完整题库。
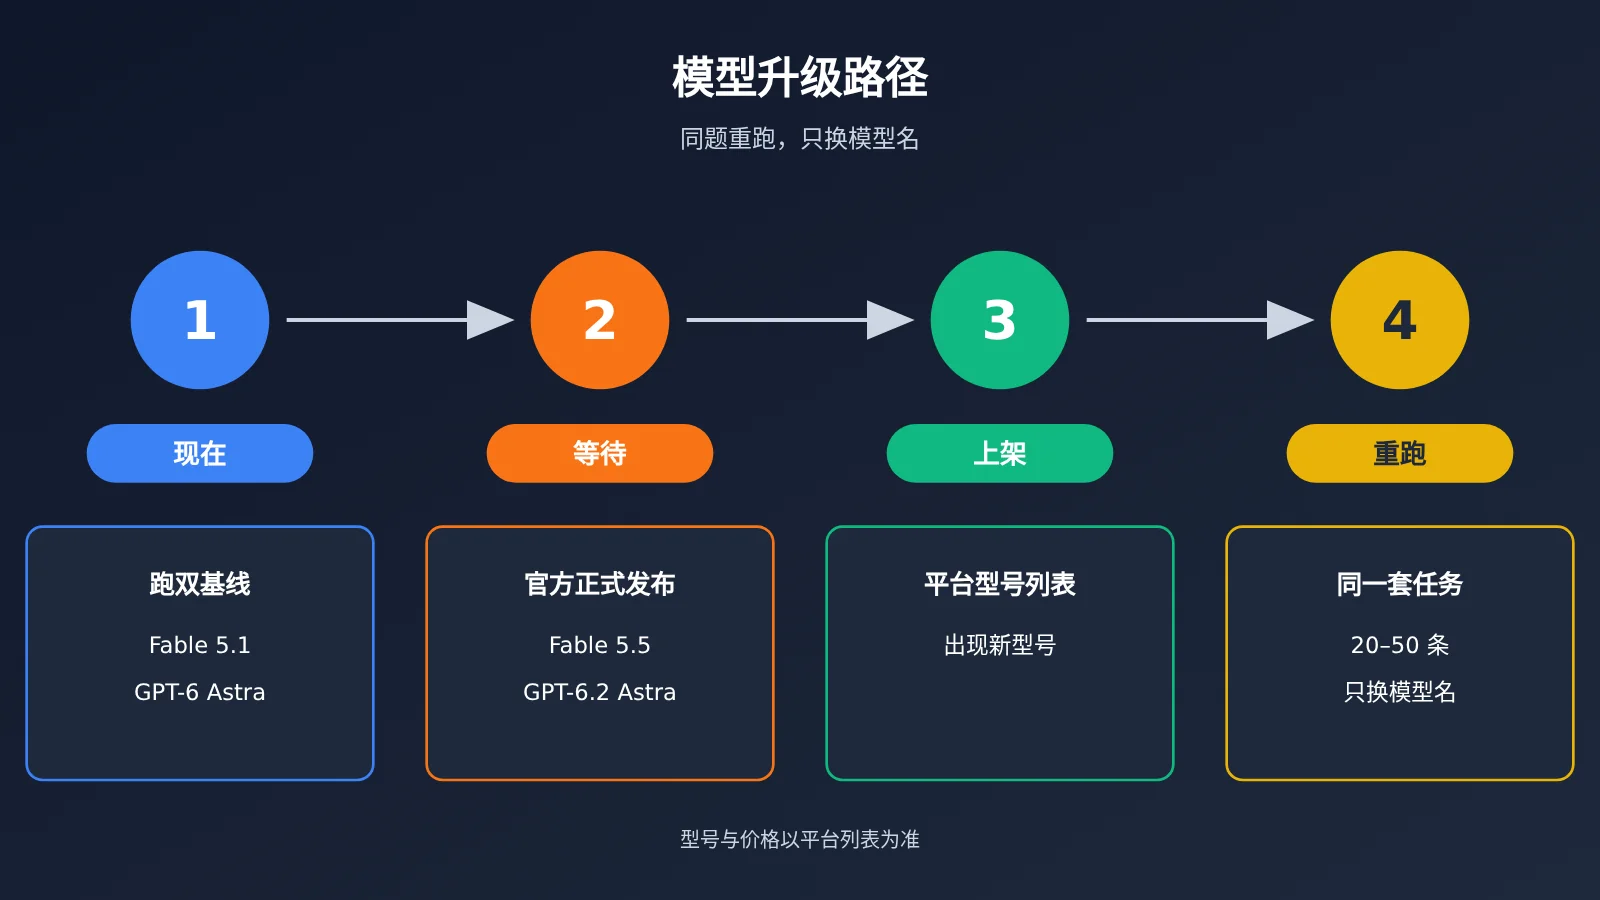
这一步的价值不在于提前知道新模型的表现,而在于提前准备好题库、评分标准和记录表。等 Fable 5.5 或 GPT-6.2 Astra 正式上线,团队只需要改一个模型名,就能在一两天内拿到自己场景下的结论,不必再依赖别人的 demo 和截图。
Fable 5.5 vs GPT-6.2 Astra 怎么选、怎么测
判断:现在不必等新模型,先用现役旗舰定基线;选型结论应该来自自己的 20 到 50 条任务,而不是公开 demo。
截至 2026-11-03,Fable 5.5 与 GPT-6.2 Astra 都还没在 API易 上架,模型一旦发布,我们会尽快上架这两个模型;型号与价格以平台型号列表为准。在此之前,可以按下面的场景先做初步判断:
- 长文档、大代码库、重复长上下文:优先评估
claude-fable-5-1。1M 内输入价不变,缓存读取只要 $0.25,成本更可预测。 - 需要细调推理预算、依赖网页搜索或 computer use:优先评估
gpt-6-astra。五档推理可选,官方列出的工具能力更完整。 - 前端单文件、创意可视化类任务:两边都有参考作品,但都是作者自称,只能当灵感来源,必须用自己的题目验证。
- 对知识时效敏感:Fable 5.1 的知识截止为 2026-06,GPT-6 Astra 为 2026-04-30,差距约两个月,可结合检索工具弥补。
自有评测的搭建方法
评测的核心是“固定一切,只换模型名”。具体步骤如下:
- 从真实业务中抽取 20 到 50 条任务,覆盖代码、长文档、结构化输出等主要类型,每条写明通过标准。
- 固定系统提示词、用户提示词、最大输出 token 和推理档位;Fable 5.1 记录 effort,GPT-6 Astra 记录档位名称。
- 每条任务记录 input tokens、output tokens、端到端耗时,以及人工判定是否通过。
- 单独标出输入超过 27.2 万 tokens 的任务,按实际阶梯价计算成本。
- 先跑
claude-fable-5-1和gpt-6-astra两条基线;等新模型上线后,只换模型名,用同一套题重跑。
记录表建议至少包含以下字段,方便后续横向和纵向对比:
| 字段 | 记录内容 | 用途 |
|---|---|---|
| 任务 ID 与类型 | 代码 / 长文档 / 结构化等 | 按场景拆分通过率 |
| 模型名与推理档 | 如 gpt-6-astra high |
保证重跑时条件一致 |
| input / output tokens | 平台返回的 usage | 计算真实单题成本 |
| 耗时 | 从请求到完整返回 | 评估交互体验 |
| 人工通过 | 是 / 否 + 原因 | 最终质量指标 |
💡 选择建议:同一个 Key 下跑两家模型,可以避免多账号带来的网络、限流差异干扰结果。通过 API易 apiyi.com 统一调用,记录的 usage 字段格式一致,汇总表更容易对齐。
常见问题与行动建议
Q1:Model Tests 上的 demo 能说明 Fable 5.5 比 GPT-6.2 Astra 强吗?
不能。两者没有做过同一道题,推理档位、日期和作品数量也不同,模型归属又是作者自称。它最多说明,按作者的说法,两边都能产出可运行或可观看的成品。
Q2:Fable 5.5 和 GPT-6.2 Astra 发布了吗?什么时候能用?
截至 2026-11-03,两家官方模型目录里都没有这两个型号,也没有可靠的发布日期。截至 2026-11-03,Fable 5.5 与 GPT-6.2 Astra 都还没在 API易 上架,我们会尽快上架这两个模型;型号与价格以平台型号列表为准。上架后可以直接在 API易 apiyi.com 的型号列表里查到。
Q3:19.8% 的流量截图可信吗?
它来自 X 用户 TokenGremlin 的个人截图,更早的 Linux.do 帖子显示只有 1.6%,而且模型选择器仍显示 GPT-6 Astra,不同用户的报告也不一致。两个数字都是社区自述,不是官方数据,只能说明部分账号的用量明细出现过这个型号名。
Q4:现在应该等新模型,还是先用现役旗舰?
建议先用现役旗舰。Fable 5.1 和 GPT-6 Astra 单价相同,能力都在一线,现在就能用于生产。更重要的是先把评测题库搭起来,新模型上线时就能快速得出结论。在 API易 apiyi.com 可以用免费测试额度先跑小样本,验证评测流程。
Q5:两家现役旗舰价格一样,成本还会有差别吗?
会。`gpt-6-astra` 单次输入超过 272,000 tokens 后,输入价从 $10 涨到 $20;缓存读取 $1,而 `claude-fable-5-1` 为 $0.25。长上下文、高缓存命中的场景差异最明显,建议按真实 token 分布计算。
行动建议
对本月正在做选型的团队,建议按三步走:本周从业务中整理 20 到 50 条任务和通过标准;接着在 API易 apiyi.com 用同一个 Key 跑 claude-fable-5-1 与 gpt-6-astra 双基线,记录 token、耗时和人工通过率;等 Fable 5.5 或 GPT-6.2 Astra 正式发布并上架后,只换模型名重跑同一套题。到那时,你手里会有一份基于自己任务、条件一致的对比数据,比任何 demo 或截图都更可靠。型号与价格以平台型号列表为准。
参考资料
- OpenAI 模型目录:GPT-6 Astra 官方规格与价格
- 链接:
developers.openai.com/api/docs/models - 说明:2026-11-03 读取,目录中无 GPT-6.2 Astra
- Anthropic 平台定价与模型页:Fable 5.1 官方规格、价格与缓存计费
- 链接:
platform.claude.com - 说明:2026-11-03 读取,定价页与新闻页中无 Fable 5.5
- Model Tests 第三方测试站:作者 @notjazii 的公开 demo 合集
- 链接:
model-tests.vercel.app - 说明:模型归属为作者自称,无提示词与调用日志
作者:APIYI 技术团队
技术交流:欢迎访问 API易 apiyi.com 首页联系我们,型号与接入文档可在 docs.apiyi.com 查阅