作者注:本文按 2026-10-24 抓取的官方价目表,拆解 Kimi K3.1 Pro 的五档价格、缓存计费、限流档位,并用三个可套用的算账示例说明一次请求到底花多少钱。
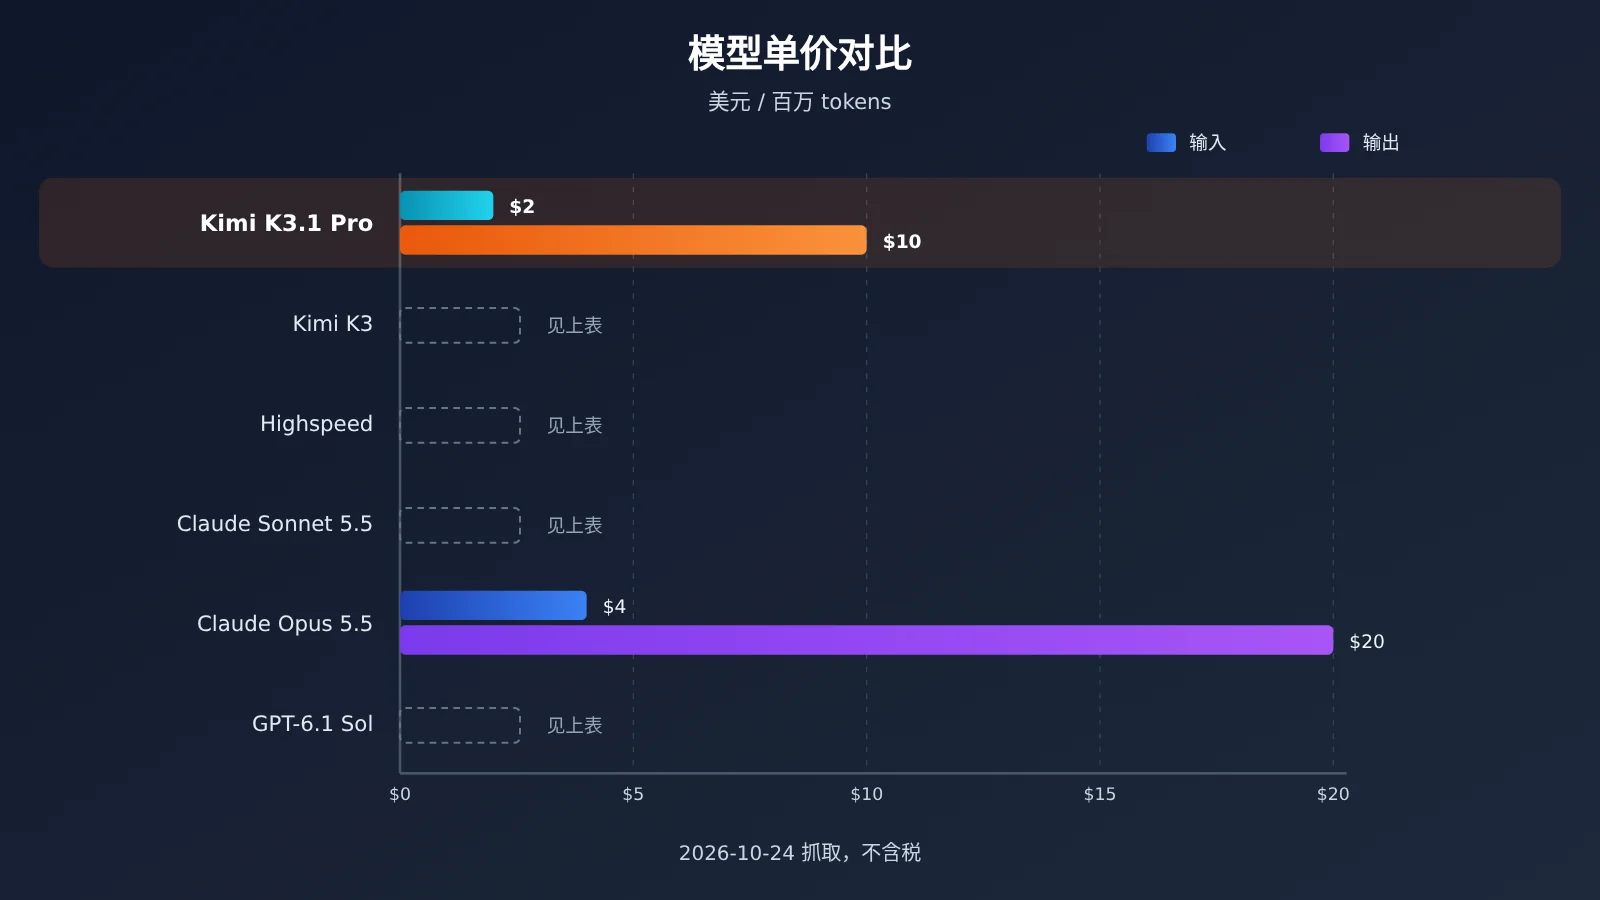
Kimi K3.1 Pro 的官方价格是 输入 $2、输出 $10,缓存命中只要 $0.20(单位:美元/百万 tokens)。这一价格比上一代 Kimi K3 便宜 33%。它和 Claude Sonnet 5.5、GPT-6.1 Sol 同价,是 Claude Opus 5.5 的一半。
以上结论的依据是 Moonshot 官方定价页(platform.kimi.ai 的 pricing 文档)和第三方机构 Artificial Analysis 的算账数据。文中所有数字都会标注来源档位:「官方」指 Moonshot 博客或官方文档自报,「第三方」指 Artificial Analysis 等外部测算,查不到可靠来源的标「未核实」。
这不是一篇只抄价目表的文章。 单价降了 33%,不代表你的账单一定降 33%,后面会把省钱和不省钱的地方都讲清楚。
核心价值:读完本文,你能自己算出一次 Kimi K3.1 Pro 请求的成本,知道什么场景该开缓存、什么时候要提前升级限流档位,以及国内开发者怎么付费和接入。
1. Kimi K3.1 Pro 价格核心要点
先用一张表把最常被问到的几件事说完,后面每一节再展开。
| 要点 | 说明 | 来源 | 对你意味着什么 |
|---|---|---|---|
| 基础单价 | 输入 $2 / 输出 $10 / 缓存命中 $0.20 | 官方 | 与 Sonnet 5.5、GPT-6.1 Sol 同一价位 |
| 对比上一代 | 三项单价都比 K3 低 33% | 官方 / 第三方 | 单价层面明显降价 |
| 上下文 | 1,048,576 tokens,统一单价不分档 | 官方 | 长文档不会因为长度触发涨价 |
| 单任务成本 | 约 $1.98(发布文章)/ $2.11(模型页) | 第三方 | 与 K3 基本持平,并未同比下降 |
| 起步门槛 | 至少充值 $1,Tier0 仅 3 RPM | 官方 | 正式上量前要先升档 |
这里先解释两个后面反复出现的词。token 是模型计费的最小单位,可以理解成“字词碎片”,官方给的参考是英文大约 3-4 个字符算 1 个 token;百万 tokens(MTok) 就是 1,000,000 个 token,价目表里的 $2 指每处理一百万个输入 token 收 $2。
1.1 Kimi K3.1 Pro 的计费项有哪些
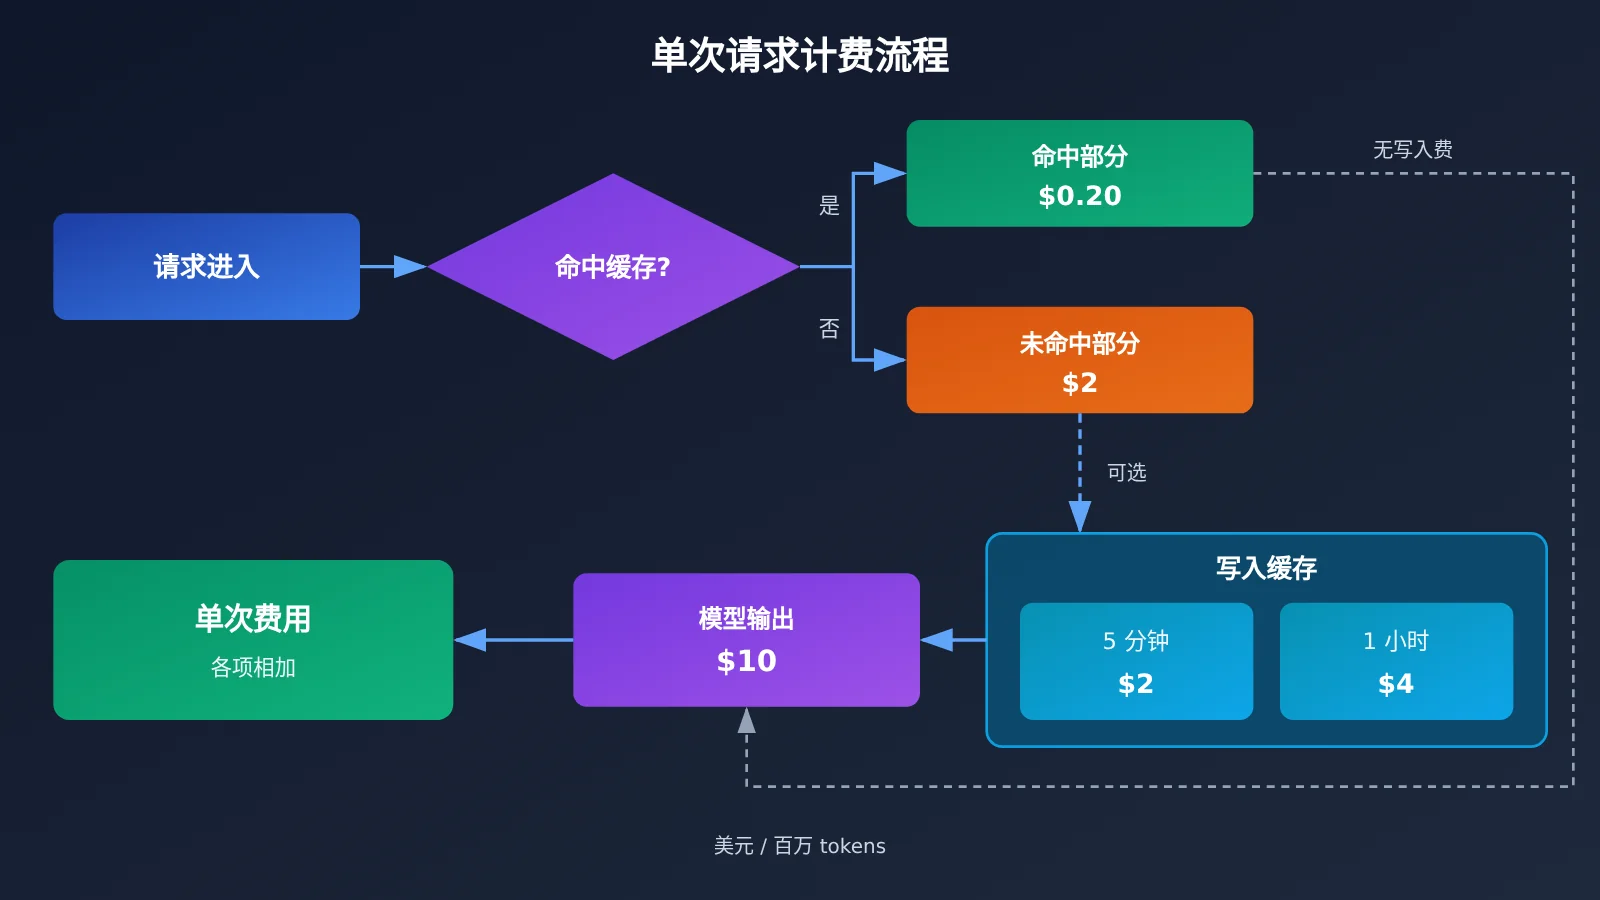
官方文档列出的可计费项一共三类:缓存写入(分 5 分钟和 1 小时两档)、输入(分缓存命中和未命中)、输出。把它们拆开就是价目表里的五列价格,每一次请求的账单都是这几项按 token 数相加。
上下文缓存是这次定价里最值得关注的部分。它的意思是:如果你连续几次请求的开头部分完全一样(比如同一段很长的系统提示词),平台会把这段内容存起来,下次直接复用,复用部分按便宜得多的“命中价”收费。官方说明 Kimi API 会对重复的请求前缀自动开启缓存计费,默认 TTL 为 5 分钟,TTL 就是“缓存保留多久”的意思。
另外几条容易忽略的规则也写在官方文档里:K3 系列缓存命中只收命中价,不再额外收写入费;文件相关 API(文档内容抽取、文件存储)暂时免费,但抽取出来的内容送进模型时照样按 token 计费;价目表是税前价,最终按付款地区规则结算。
2. Kimi K3.1 Pro 完整价目表:五档价格一次看全
下面这张表把 Kimi 当前主力型号的五档价格全部列出,方便你横向比较。“未列”表示官方定价页没有给出该项价格,不代表免费。
| 模型 | 输入(未命中) | 输出 | 缓存命中输入 | 缓存写入 5 分钟 | 缓存写入 1 小时 |
|---|---|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| kimi-k3.1-pro-highspeed | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
| kimi-k3(上一代) | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
| kimi-k2.7-code | $0.95 | $4.00 | $0.19 | 未列 | 未列 |
| kimi-k2.6 | $0.95 | $4.00 | $0.16 | 未列 | 未列 |
注:2026-10-24 抓取,单位美元/百万 tokens,价格不含税。来源:官方定价页。
从表里可以读出几个规律。第一,K3.1 Pro 的 5 分钟缓存写入价和普通输入价相同,都是 $2,也就是说开启 5 分钟缓存几乎没有额外成本;1 小时写入是 $4,为输入价的 2 倍。第二,Highspeed 版本所有项都是标准版的两倍,唯独缓存命中价同样是 $0.20,长前缀复用场景下两者的差距会被缩小。第三,K2.7 Code 和 K2.6 的单价不到 K3.1 Pro 的一半,对于不需要最强推理能力的任务,它们仍然是更便宜的选择。
2.1 Kimi K3.1 Pro 与同价位模型横向对比
按同一口径(美元/百万 tokens)把几家主流模型放在一起看,K3.1 Pro 的位置会更清楚。
| 模型 | 输入 / 输出 | 缓存命中输入 | 缓存写入 · 短档 | 缓存写入 · 长档 | 来源 |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2 / $10 | $0.20 | $2(5 分钟) | $4(1 小时) | 官方 |
| Kimi K3.1 Pro Highspeed | $4 / $20 | $0.20 | $4(5 分钟) | $8(1 小时) | 官方 |
| Claude Sonnet 5.5 | $2 / $10 | $0.10 | $2.50(5 分钟) | $4(1 小时) | 官方 |
| Claude Opus 5.5 | $4 / $20 | $0.20 | $5(5 分钟) | $8(1 小时) | 官方 |
| GPT-6.1 Sol(输入 ≤272K) | $2 / $10 | $0.10 | $2.50(30 分钟) | $5(12 小时) | 官方 |
| GPT-6.1 Sol(输入 >272K) | $4 / $15 | $0.20 | $5(30 分钟) | $10(12 小时) | 官方 |
| GPT-6 Astra(输入 ≤272K) | $10 / $50 | $1.00 | $12.50(30 分钟) | $25(12 小时) | 官方 |
| GPT-6 Astra(输入 >272K) | $20 / $75 | $2.00 | $25(30 分钟) | $50(12 小时) | 官方 |
表内数据来自各家官方定价页,2026-10-24 抓取,单位美元/百万 tokens,不含税。三家的缓存档位不一样:Kimi 与 Claude 是 5 分钟 / 1 小时,OpenAI 是 30 分钟 / 12 小时,写入价分别是未缓存输入价的 1.25 倍与 2.5 倍;读取价多数模型是输入价的 10%,只有 GPT-6.1 Sol 是 5%。OpenAI 还按输入长度分档:≤272K tokens 走短上下文价,>272K tokens 跳到长上下文价。表内只列标准档,OpenAI 的 Batch 半价、Fast(原 Priority)和 UltraFast 更贵,都没列。
对比下来,Claude Sonnet 5.5 和 GPT-6.1 Sol 的缓存命中价更低(都是 $0.10),频繁复用长前缀的场景下它们更有优势。但 Sonnet 5.5 的 5 分钟写入价是 $2.50,比 K3.1 Pro 的 $2 略高。相比之下,K3.1 Pro 在“写入便宜、上下文统一单价”这两点上更适合一次性读入大文档的任务。Claude Opus 5.5 的输入输出都是 K3.1 Pro 的两倍,选它的理由应该是能力需求,而不是价格。GPT-6.1 Sol 的短板在缓存写入:30 分钟档 $2.50,比 K3.1 Pro 的 5 分钟档 $2 贵;而且它按输入长度分档,超过 272K tokens 后输入涨到 $4、输出涨到 $15,长文档任务要按长上下文那一行算。
选择建议:同价位模型实际效果差异要看具体任务,建议用同一批提示词分别跑一遍再决定。API易(apiyi.com)的模型表里同时有 claude-sonnet-5-5、claude-opus-5-5、kimi-k3 等型号,可以用一个 Key 对比测试;K3.1 Pro 的具体型号名与价格以平台型号列表为准,我们会尽快推出此模型。
3. Kimi K3.1 Pro 一次请求多少钱:3 个算账示例
价目表看懂了,真正关心的还是“我这一次调用要花多少”。下面三个例子覆盖了短对话、长提示复用和长文档阅读三类典型场景,算式都写出来了,你把自己的 token 数代进去即可。通用公式是:费用 = token 数 × 单价 ÷ 1,000,000。
3.1 示例 1:Kimi K3.1 Pro 短请求成本
场景:一次普通问答,输入 2,000 tokens(没有命中缓存),输出 500 tokens。
- 输入:
2000 × 2 ÷ 1000000 = $0.004 - 输出:
500 × 10 ÷ 1000000 = $0.005 - 合计:
$0.004 + $0.005 = $0.009
也就是说一次这样的短对话不到一美分。需要注意的是,输出单价是输入的 5 倍,短请求里输出往往占了一半以上的费用,控制输出长度比压缩输入更有效。
3.2 示例 2:Kimi K3.1 Pro 长提示复用与缓存
场景:系统提示词 20,000 tokens,在 5 分钟内连续提 10 个问题,每次追加 1,000 tokens 新输入,输出 800 tokens。
不用缓存时,每次请求都要按全价付整段提示词:
- 单次:
(20000 + 1000) × 2 ÷ 1000000 + 800 × 10 ÷ 1000000 = $0.042 + $0.008 = $0.05 - 10 次:
$0.05 × 10 = $0.50
用缓存时,第一次需要把系统提示写入缓存,之后 9 次直接命中:
- 第 1 次:写入
20000 × 2 ÷ 1000000 = $0.04,加新输入$0.002、输出$0.008,共$0.05 - 第 2-10 次每次:命中
20000 × 0.2 ÷ 1000000 = $0.004,加$0.002 + $0.008,共$0.014 - 后 9 次合计:
$0.014 × 9 = $0.126 - 总计:
$0.05 + $0.126 ≈ $0.18
同样 10 次对话,从 $0.50 降到约 $0.18,省掉约六成。这类“固定长提示 + 多轮追问”的结构在客服机器人、代码助手、Agent 框架里非常常见,是缓存最能发挥作用的地方。
3.3 示例 3:Kimi K3.1 Pro 长文档阅读
场景:把一份 300,000 tokens 的文档读一遍,输出 3,000 tokens 的总结。
- 输入:
300000 × 2 ÷ 1000000 = $0.60 - 输出:
3000 × 10 ÷ 1000000 = $0.03 - 合计:约
$0.63
如果 5 分钟内针对同一份文档再问一个问题,文档部分会命中缓存,光输入只需要 300000 × 0.2 ÷ 1000000 = $0.06,再加上本次输出的费用即可。对需要反复追问同一份合同、财报、代码库的场景,把提问集中在缓存有效期内能显著降低成本。
4. Kimi K3.1 Pro 1M 上下文统一单价:不分档意味着什么
上下文可以理解成“模型一次能看到的内容总量”,包括你的提示词、历史对话和上传的文档。官方文档写明 K3 系列全部支持 1,048,576 tokens 上下文,并且 K3.1 Pro 采用扁平按量计费,不按上下文长度分档。
官方 FAQ 的原意是:K3.1 Pro 用 1M 上下文和扁平按量计费,缓存写入、输入(命中与未命中)、输出全部按统一单价计费。换句话说,你发 2,000 tokens 和发 800,000 tokens,每百万 token 的单价都是同一个 $2,不会因为请求变长而换算成更贵的价格。
这一点在对比时很关键,因为不是所有厂商都这样算。OpenAI 的 GPT-6 系按输入长度分档:≤272K tokens 走短上下文价,超过 272K tokens 立刻换成更贵的长上下文价(以 GPT-6 Astra 为例,输入从 $10 跳到 $20、输出从 $50 跳到 $75,缓存命中从 $1.00 跳到 $2.00)。Claude 走的是另一条路:官方定价页写明 Claude 4.6 及之后的模型(Claude Haiku 5.5 除外)在完整的 1M 上下文里都按标准价计费,90 万 tokens 的请求和 9 千 tokens 的请求单价相同;只有 Claude Haiku 5.5 会在提示超过 10 万 tokens 后涨价。所以 K3.1 Pro 的「不分档」不是独一份,Claude Sonnet 5.5 / Opus 5.5 也不按长度加价,真正会跳档的是 GPT-6 系。
对开发者来说,统一单价带来两个直接好处:
- 预算可以线性估算:token 数翻倍,费用就翻倍,不会在某个长度突然跳涨,示例 3 那种 30 万 token 的文档可以放心按单价直接乘。
- 不必刻意切分文档:在分档计价的模型上,有人会把长文档切成多段来避开高价档;在 K3.1 Pro 上这样做不会省钱,反而可能因为丢失上下文影响效果。
5. 为什么 Kimi K3.1 Pro 省钱,以及不省钱的地方
这一节把账算得老实一点。单价确实降了,但实际任务成本还受输出长度影响。
| 维度 | 具体情况 | 来源 | 对成本的影响 |
|---|---|---|---|
| 单价下调 | 输入、输出、缓存命中三项都比 K3 低 33% | 官方 / 第三方 | 省钱 |
| 缓存命中价 | $0.20,只有输入价的 1/10 | 官方 | 长前缀复用场景大幅省钱 |
| 1 小时缓存写入 | $4,是输入价的 2 倍 | 官方 | 长间隔任务更划算,短任务不必用 |
| 始终思考 | 不能关闭思考,平均输出 55K tokens,比 K3 多 14% | 官方 / 第三方 | 抵消一部分降价 |
| 单任务成本 | $1.98(发布文章)/ $2.11(模型页加权) | 第三方 | 与 K3 基本持平 |
5.1 Kimi K3.1 Pro 省钱的三个点
第一是单价直接降 33%,从 K3 的 $3/$15 降到 $2/$10,缓存命中从 $0.30 降到 $0.20,这一点官方价目表和 Artificial Analysis 的数据一致。第二是缓存命中只要输入价的 1/10,示例 2 已经算过,固定长提示的多轮对话能省掉约六成。第三是 1 小时缓存写入虽然是 2 倍价,但它让缓存保留更久,适合两次调用间隔超过 5 分钟的任务,比如每隔十几分钟跑一次的定时 Agent,或者用户会停下来思考再追问的长文档问答。只要 1 小时内命中两次以上,多付的写入费通常就能收回来。
5.2 Kimi K3.1 Pro 不省钱的地方
思考指模型在给出答案前先在内部推演一段,这部分推演内容同样按输出计费。官方文档说明 K3.1 Pro 不能关闭思考,只能把 reasoning_effort 调到 low 来减少思考量。
根据 Artificial Analysis(第三方)的测算,K3.1 Pro 在其 Intelligence Index 每个任务上平均输出约 55K tokens,K3 为 48K,多出 14%。输出单价是最贵的一项,多出来的这部分 token 吃掉了一部分降价空间。最终第三方算出的单任务成本约 $1.98(发布文章口径),模型页显示的加权单任务成本为 $2.11(缓存折扣按 90% 计),和 K3 基本持平。
所以结论是:如果你的业务以长输入、多轮复用为主,K3.1 Pro 的降价能明显体现在账单上;如果主要是复杂推理、输出很长的任务,单任务成本未必比 K3 低,建议先拿真实任务小规模跑一批,再看实际账单。
6. Kimi K3.1 Pro 充值门槛与限流档位
官方采用按量付费,没有订阅制,而且 Kimi API 和 Kimi 会员、Kimi Code 是两套独立计费,会员不能抵 API 费用。账户至少充值 $1 才能开始调用;累计充值满 $5 送 $5 代金券,代金券不计入累计充值金额(官方)。
限流档位由累计充值金额决定。先解释几个缩写:并发是同一时刻能同时进行的请求数;RPM 是每分钟最多请求次数;TPM 是每分钟最多处理的 token 数;TPD 是每天最多处理的 token 数。
| 档位 | 累计充值 | 并发 | RPM | TPM | TPD |
|---|---|---|---|---|---|
| Tier0 | $1 | 1 | 3 | 50 万 | 150 万 |
| Tier1 | $10 | 15 | 100 | 200 万 | 不限 |
| Tier2 | $20 | 40 | 100 | 300 万 | 不限 |
| Tier3 | $100 | 50 | 200 | 300 万 | 不限 |
| Tier4 | $1000 | 60 | 200 | 400 万 | 不限 |
| Tier5 | $3000 | 100 | 300 | 500 万 | 不限 |
注:来源为官方限流文档(platform.kimi.ai 的 pricing/limits 页面),2026-10-24 抓取。
Tier0 的限制非常紧:每分钟只能发 3 个请求,每天总共 150 万 tokens。按示例 3 的 30 万 token 文档算,一天读 5 次就到顶了,而且 TPM 50 万意味着一分钟内连两份这样的文档都放不下。如果你要做批量处理或者上线给用户用,建议在测试阶段就把累计充值提到 Tier1 以上。
还有一条需要特别注意:官方说明触发风控限流后不可解除。上线前请在客户端做好请求速率控制和重试退避,不要用并发脚本去试探上限。
7. Kimi K3.1 Pro 国内怎么付费、怎么接
官方渠道按美元计价、按付款地区规则结算,虽然国内能直接支付。对国内开发者来说,常见的顾虑是境外支付方式、发票,以及要同时维护多家厂商的 Key。另一种做法是通过 API 聚合平台接入,用一个账户和一个 Key 调用多家模型。
API易(apiyi.com)是一个 AI 大模型 API 聚合平台,一个 API Key 可以调用 OpenAI、Claude、Gemini 等主流模型,接口兼容 OpenAI 格式,按量计费,新用户有免费测试额度。根据 2026-10-24 对平台模型表 docs.apiyi.com/models 的核对,Kimi 系列目前上架的有:
kimi-k3:输入 $3 / 输出 $15 / 缓存读 $0.3kimi-k2.7-code:输入 $0.95 / 输出 $3.99 / 缓存读 $0.19kimi-k2.6:输入 $0.6 / 输出 $2.4 / 缓存读 $0.1kimi-k2.5:输入 $0.6 / 输出 $3.15 / 缓存读 $0.1
kimi-k3.1-pro 在核对当天还没有出现在 API易 的模型表里,因此本文不给出它在平台上的价格。K3.1 Pro 的型号名、价格和上架时间请以平台控制台的型号列表为准,我们会尽快推出此模型;在此之前,可以先用 kimi-k3 跑通流程,上架后只需要改型号名。
7.1 Kimi K3.1 Pro 快速上手步骤
无论走官方还是聚合平台,接入步骤大致相同。以 OpenAI 兼容方式为例:
- 注册并获取 API Key,官方渠道需先充值至少 $1。
- 在你使用的 OpenAI SDK 或客户端里,把
base_url设为https://api.apiyi.com/v1(走 API易 时);如果项目用的是 Anthropic 格式,base 地址填https://api.apiyi.com。 - 把
api_key设为你的 Key,model填平台型号列表里的名称,例如目前可用的kimi-k3,K3.1 Pro 上架后按列表填写。 - 如果想压缩思考带来的输出成本,在请求参数里加入
reasoning_effort,值设为low(官方说明 K3.1 Pro 只支持调低,不支持关闭)。 - 把固定的长系统提示词放在消息最前面且保持不变,让重复前缀能自动命中缓存。
- 调用后在账单或响应的用量字段里核对输入、命中、输出各自的 token 数,再按第 3 节的公式复算。
快速上手建议:先用 API易 apiyi.com 的免费测试额度把第 3 节的示例 2 跑一遍,对比开启和不开启固定前缀时的用量差异,这是验证缓存是否生效最快的办法。K3.1 Pro 在平台上的型号与价格以型号列表为准,我们会尽快推出此模型。
常见问题 FAQ
Q1:Kimi K3.1 Pro 价格到底是多少?
官方价格为输入 $2、输出 $10、缓存命中 $0.20、5 分钟缓存写入 $2、1 小时缓存写入 $4,单位美元/百万 tokens,不含税,2026-10-24 抓取。
Q2:Kimi K3.1 Pro 比 K3 便宜多少?实际账单会降 33% 吗?
单价三项都低 33%(官方)。但 K3.1 Pro 始终思考,平均输出多 14%,第三方 Artificial Analysis 测算的单任务成本约 $1.98 到 $2.11,与 K3 基本持平。长输入、多轮复用的场景降幅会更明显。
Q3:Kimi K3.1 Pro 和 Claude Sonnet 5.5 选哪个更省钱?
两者输入输出同为 $2/$10。Sonnet 5.5 缓存命中更便宜($0.10),K3.1 Pro 的 5 分钟写入更便宜($2 对 $2.50),且 1M 上下文统一单价。高频复用短前缀偏向 Sonnet,大文档一次性读入偏向 K3.1 Pro,最好用真实任务对比。
Q4:Kimi K3.1 Pro 的 1 小时缓存值得开吗?
1 小时写入是 $4,比 5 分钟写入多 $2。只要同一前缀在 5 分钟以外、1 小时以内会被再次使用两次以上,通常就值得开;调用都集中在几分钟内的,用默认 5 分钟即可。
Q5:国内开发者如何通过 API 调用 Kimi K3.1 Pro?
可以走官方渠道,也可以通过 API易 apiyi.com 用 OpenAI 兼容接口接入,`base_url` 填 `https://api.apiyi.com/v1`。平台目前已有 `kimi-k3`、`kimi-k2.7-code` 等型号;K3.1 Pro 的型号与价格以平台型号列表为准,我们会尽快推出此模型。
Q6:Kimi 会员能抵扣 API 费用吗?
不能。官方说明 Kimi API 是按量付费,没有订阅制,和 Kimi 会员、Kimi Code 是两套计费。
Q7:Kimi K3.1 Pro 有哪些计费上的坑?
– 不能关闭思考,输出 token 会偏多,可用 `reasoning_effort` 设为 `low` 缓解。
– Tier0 只有 3 RPM、150 万 TPD,量大要提前升档。
– 触发风控限流后不可解除。
– 文件抽取免费,但抽取内容送入模型仍按输入计费。
Q8:还没上架 K3.1 Pro 的平台上,现在能先做什么准备?
可以先在 API易 apiyi.com 用 `kimi-k3` 搭好调用链路、缓存结构和用量统计,K3.1 Pro 上架后替换型号名即可。具体型号名与价格以平台型号列表为准,我们会尽快推出此模型。
Kimi K3.1 Pro 价格核心要点 Key Takeaways
- 基础价格:输入 $2 / 输出 $10 / 缓存命中 $0.20,官方价,不含税。
- 五档齐全:5 分钟写入 $2、1 小时写入 $4,写入成本很低。
- 对比定位:与 Sonnet 5.5、GPT-6.1 Sol 同价,是 Opus 5.5 的一半。
- 统一单价:1M 上下文不按长度分档,预算可线性估算。
- 真实成本:始终思考、输出多 14%,单任务成本与 K3 基本持平(第三方)。
- 起步门槛:充值 $1 起,Tier0 仅 3 RPM,风控限流不可解除。
- 国内接入:可通过 API易 用 OpenAI 兼容接口接入,K3.1 Pro 型号与价格以平台列表为准,我们会尽快推出此模型。
总结
Kimi K3.1 Pro 价格的核心要点:
- 单价:$2 输入 / $10 输出 / $0.20 缓存命中,比 K3 低 33%,1M 上下文统一单价。
- 省钱关键:把固定长前缀放在最前面,用好缓存,多轮对话能省掉约六成输入成本。
- 成本预期:始终思考带来更长输出,复杂推理任务的单任务成本与 K3 接近,不要按 33% 降幅做预算。
- 上线准备:提前升级限流档位,做好速率控制,避免触发不可解除的风控限流。
建议先用第 3 节的公式结合自己的 token 分布估一遍账,再用少量真实任务验证。需要在国内用一个 Key 对比 Kimi、Claude、GPT 等模型的,可以通过 API易 apiyi.com 先拿免费额度测试;K3.1 Pro 在平台上的型号与价格以型号列表为准,我们会尽快推出此模型。
参考资料
- Kimi 开放平台 – 模型定价:K3.1 Pro 及各型号五档价格与计费规则
- 链接:
platform.kimi.ai/docs/pricing/chat -
说明: 本文价目表与 1M 上下文统一计费说明的官方来源
-
Kimi 开放平台 – 充值与限流:Tier0 到 Tier5 档位与风控说明
- 链接:
platform.kimi.ai/docs/pricing/limits -
说明: 充值门槛、RPM/TPM/TPD 限制的官方来源
-
Artificial Analysis – Kimi K3.1 Pro:第三方单任务成本与输出 token 测算
- 链接:
artificialanalysis.ai -
说明: 本文 $1.98 / $2.11 单任务成本与 55K 输出 tokens 数据来源
-
API易 模型列表:平台当前上架型号与价格
- 链接:
docs.apiyi.com/models - 说明: Kimi、Claude 等型号在平台上的实际可用情况
作者:APIYI 技术团队
技术交流:欢迎在 API易 网站首页联系我们,更多资料可访问 docs.apiyi.com 文档中心