作者注:本文说明在 API易用两种协议向 Gemini 4 Neon 发出第一条请求,以及请求成功后应该核对哪些字段和日志。
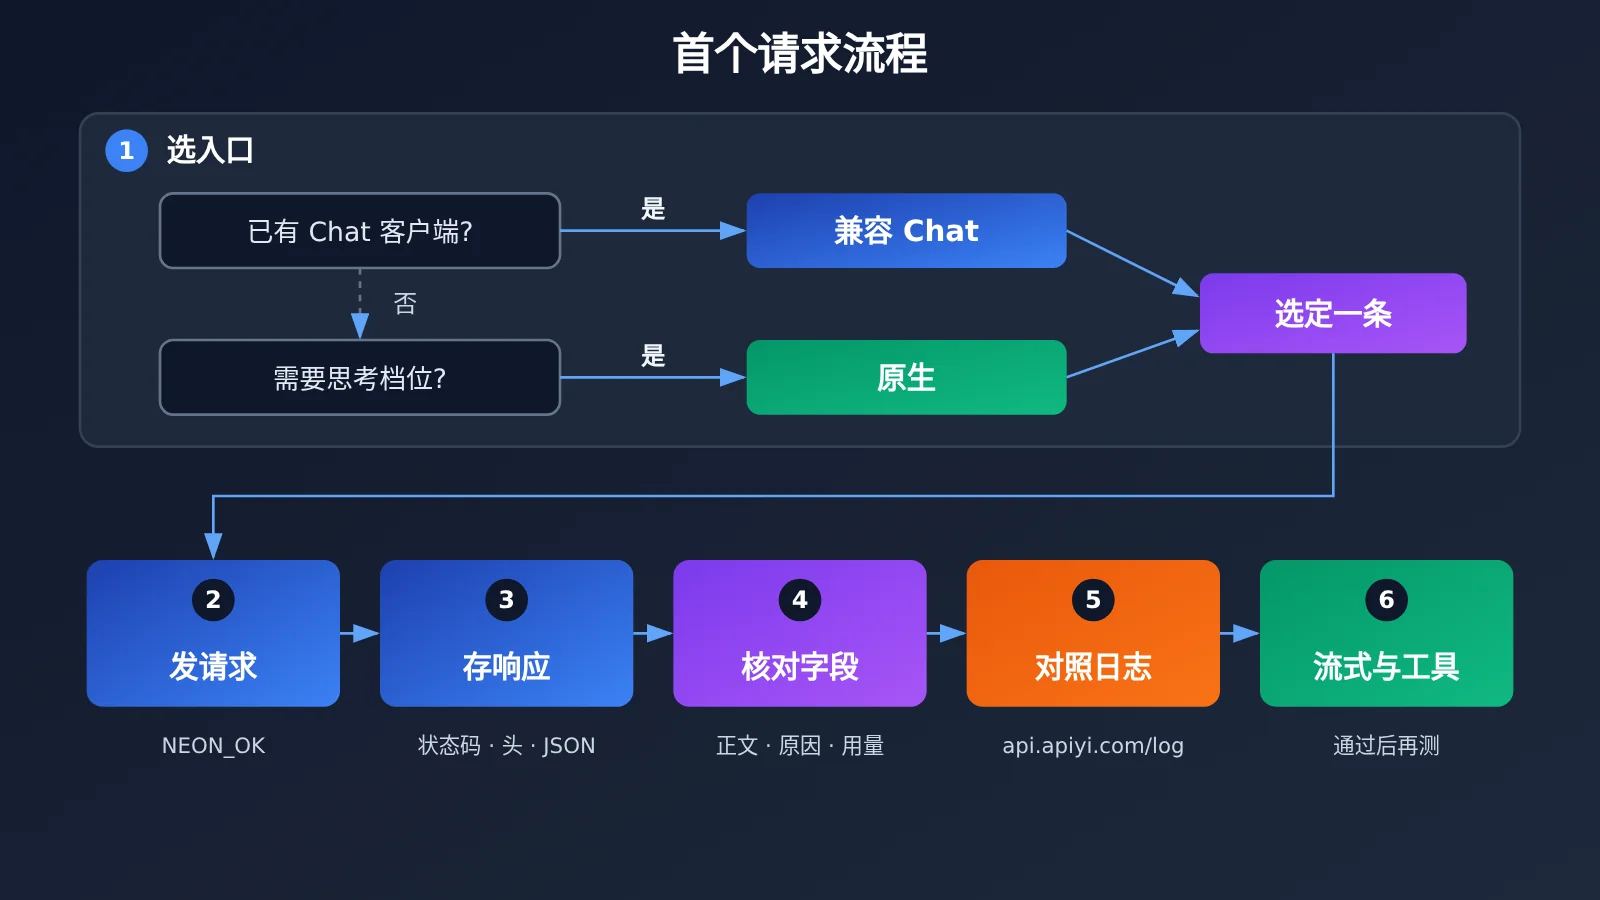
结论先行:如果项目里已经有 OpenAI Chat 客户端,就走 OpenAI 兼容的 Chat Completions 入口,只需要换 base_url 和模型名。如果需要明确设置 Gemini 的思考档位,就走 Gemini 原生 generateContent 入口,在 generationConfig.thinkingConfig.thinkingLevel 里指定。无论选哪条路,都先用同一条短提示词跑通纯文本,再根据 HTTP 状态、正文、停止原因、用量和平台日志做验收。验收通过以后,再去测流式输出、工具调用等能力。
背景信息如下。Google 在 2026 年 11 月 18 日的 AI Studio 更新日志中发布了 Gemini 4 Neon,并宣布 GA。API易于北京时间 2026-11-20 11:45 确认上架,公开价格目录里可以看到 gemini-4-neon,可用分组为 default 和 svip。本文的示例都是按 API易文档和 SDK 文档编写的,没有调用收费接口,文中也没有任何实测统计。
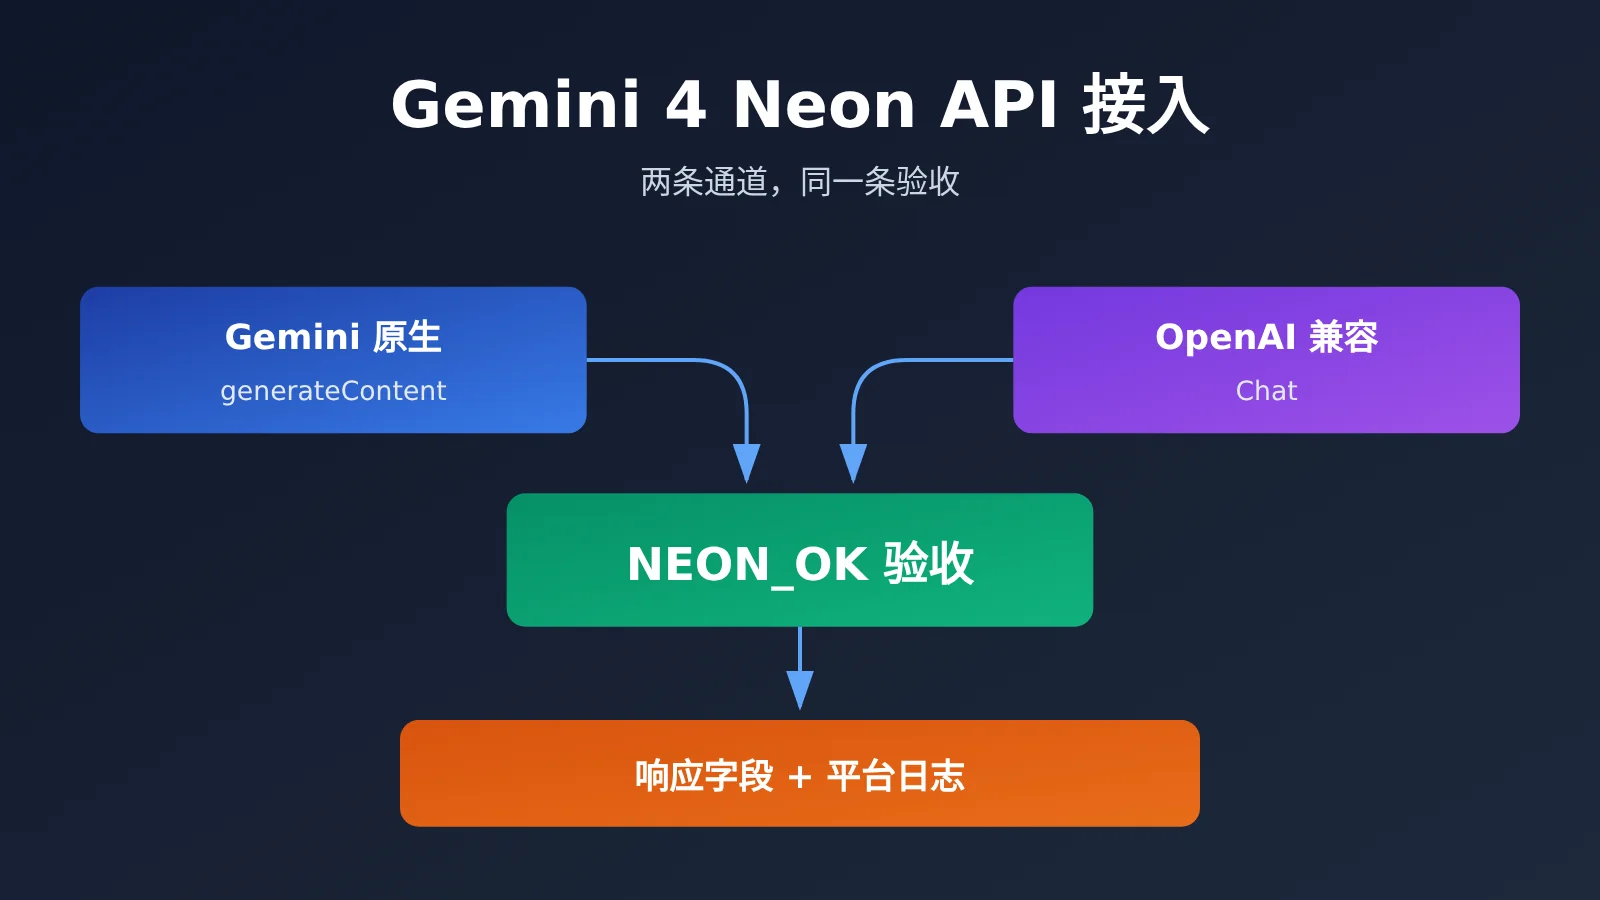
Gemini 4 Neon API 接入知识地图与索引
整个接入过程分三步:选接口、发请求、核对输出与日志。每一步的产出都是下一步的输入。下表把这三步的先后关系、安排理由和每一步要达到的目标放在一起,可以当作知识地图,也可以当作阅读索引。
| 编号 | 步骤 | 前一步提供什么 | 为什么这样排 | 本步目标 |
|---|---|---|---|---|
| 1 | 选入口(1.1 兼容 Chat / 1.2 原生与思考档) | 你现有的代码栈和对思考档位的需求 | 入口决定 URL、鉴权写法和字段结构,后面所有步骤都取决于它 | 确定一条协议,不在两条路上同时排错 |
| 2 | 发同一条短请求(2.1 原生 cURL / 2.2 Python SDK) | 已确定的入口和请求格式 | 用固定的短提示词,可以把模型能力的差异排除在外,只检验链路是否通 | 拿到完整的状态码、响应头和响应体 |
| 3 | 验收(3.1 字段 / 3.2 身份与日志 / 3.3 失败留证) | 第 2 步保存的原始响应 | 先看响应本身,再去和平台日志对照,证据从近到远 | 判断“文本成功”是否成立;如果不成立,留下可追查的证据 |
阅读建议:只用其中一种协议的读者,第 1 节读完对应小节以后,直接看 2.1 或 2.2 中的一个,第 3 节需要完整读。
To Know:Gemini 4 Neon API 必要术语
| 术语 | 简明解释 |
|---|---|
generateContent |
Gemini 原生的非流式生成接口,请求体里用 contents 和 parts 组织内容 |
thinkingLevel |
原生接口 generationConfig.thinkingConfig 下的思考档位字段,本文示例取 high |
| thought part | 原生响应中被标记为思考内容的 part,拼接正文时要排除 |
finishReason / finish_reason |
原生和兼容接口各自的停止原因字段 |
X-Shellapi-Request-Id |
API易在原始响应头或错误信息里返回的请求标识,用于排障 |
1 选择 Gemini 4 Neon API 接入入口
两个入口指向同一个模型,区别在于协议形态和可以控制的参数。下面先给出对照,再分两小节说明选择理由。
| 对比项 | OpenAI 兼容 Chat | Gemini 原生 |
|---|---|---|
| 地址 | https://api.apiyi.com/v1 + Chat Completions |
https://api.apiyi.com/v1beta/models/gemini-4-neon:generateContent |
| 适合谁 | 已有 OpenAI SDK 或 Chat 客户端的项目 | 需要显式控制 Gemini 参数的项目 |
| 思考档位 | 本文不传相关参数 | thinkingConfig.thinkingLevel |
| 正文位置 | choices[0].message.content |
candidates[0].content.parts 中非 thought 的 text |
| 模型标识 | 响应里的 model |
响应里的 modelVersion(如果返回) |
1.1 Gemini 4 Neon 兼容入口:沿用现有 Chat 客户端
已有代码基于 OpenAI Python SDK 或其他 Chat Completions 客户端时,改动最少的做法是把 base_url 换成 https://api.apiyi.com/v1,模型名写 gemini-4-neon,消息结构不用动。这样做的好处是业务层代码几乎不用改,出问题时也比较容易判断问题在网络、鉴权还是模型。
使用这条路有几条边界需要说清楚。第一,不要传 reasoning_effort。Google 自己的兼容层对它有映射,但这不代表 API易的兼容入口也做了同样的承诺。第二,本文不使用 /v1/responses 接口。第三,旧的 thinkingBudget 写法和 minimal 档位也不在本文范围内。如果你确实需要控制思考档位,请改走 1.2 的原生入口。
1.2 Gemini 4 Neon 原生入口:明确设置思考档位
原生入口使用 Gemini 自己的请求结构。思考档位通过 generationConfig.thinkingConfig.thinkingLevel 显式传入,API易专项用例里用的值是 "high"。原生响应还会把思考内容和正文分成不同的 part,所以读取正文时要主动过滤,2.1 节给出具体写法。
鉴权方面,这个原生用例用的是 Authorization: Bearer 请求头,没有使用 Gemini 官方常见的 key 参数写法。迁移已有的原生代码时,要先核对这一处。
2 向 Gemini 4 Neon API 发送同一条短请求
两种协议使用同一条提示词:Reply with exactly NEON_OK and nothing else. 这条提示词的预期输出很短,结果也容易判断。只要返回不是 NEON_OK,就说明链路或解析环节有问题,可以排除“模型回答风格不同”这类干扰。API Key 一律从环境变量 APIYI_API_KEY 读取,不要写进代码或命令历史。
2.1 Gemini 4 Neon 原生 cURL 与 JSON 取值
下面的命令会把 HTTP 状态码、响应头和 JSON 响应体分别保存下来,第 3 节验收时会用到全部三项。
curl -sS -X POST "https://api.apiyi.com/v1beta/models/gemini-4-neon:generateContent" \
  -H "Authorization: Bearer ${APIYI_API_KEY}" \
  -H "Content-Type: application/json" \
  -D neon_native_headers.txt \
  -o neon_native_body.json \
  -w "%{http_code}\n" \
  -d '{
    "contents": [
      {"role": "user", "parts": [{"text": "Reply with exactly NEON_OK and nothing else."}]}
    ],
    "generationConfig": {
      "thinkingConfig": {"thinkingLevel": "high"}
    }
  }' > neon_native_status.txt
读取正文时,要把 candidates[0].content.parts 中所有不是 thought 的 text 拼接起来,不能只取第一个 part。以下示例用 jq 处理,没有安装 jq 的话,可以换成任何 JSON 解析工具:
# 正文:拼接非 thought 的 text
jq -r '[.candidates[0].content.parts[]? | select(.thought != true) | .text // empty] | join("")' neon_native_body.json

# 停止原因、用量、模型版本(字段不存在时输出 null,不要自行补值)
jq '{finishReason: .candidates[0].finishReason, usageMetadata, modelVersion}' neon_native_body.json

# 平台请求标识
grep -i "x-shellapi-request-id" neon_native_headers.txt
2.2 Gemini 4 Neon 的 Python OpenAI SDK 调用与返回读取
兼容入口使用 with_raw_response,这样既能拿到解析后的对象,也能读到原始响应头。max_retries=0 用来关闭 SDK 的自动重试,避免一次失败被重试掩盖,同时防止平台上出现多条日志,对不上是哪一次请求。
import os
from openai import OpenAI, APIStatusError, APIConnectionError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",  # API易 OpenAI 兼容入口
    max_retries=0,
    timeout=120.0,
)

try:
    raw = client.chat.completions.with_raw_response.create(
        model="gemini-4-neon",
        messages=[{"role": "user", "content": "Reply with exactly NEON_OK and nothing else."}],
        max_tokens=4096,
    )
    print("HTTP:", raw.status_code)
    print("X-Shellapi-Request-Id:", raw.headers.get("x-shellapi-request-id"))

    completion = raw.parse()
    if not completion.choices:
        print("choices 为空,不读取正文")
    else:
        choice = completion.choices[0]
        print("content:", choice.message.content)
        print("finish_reason:", choice.finish_reason)
    print("usage:", completion.usage)
    print("model:", completion.model)

except APIStatusError as e:
    print("HTTP:", e.status_code)
    print("X-Shellapi-Request-Id:", e.response.headers.get("x-shellapi-request-id"))
    print("error:", e.message)  # 记录前确认不含密钥等敏感信息
except APIConnectionError as e:
    print("未拿到 HTTP 响应:", type(e).__name__)
这段代码有一处需要特别注意:choices 为空时,不要直接写 choices[0],否则会抛出索引错误,把真正的问题掩盖掉。连接错误没有 HTTP 状态码,也没有响应头,所以要和 APIStatusError 分开处理。
3 验收 Gemini 4 Neon API 的首个请求
验收的目标是判断“纯文本请求成功”这件事是否成立。HTTP 2xx 并且正文是预期的 NEON_OK,只能说明这一次文本请求成功了。它不能证明模型身份,也不能当作性能测试结果。
3.1 HTTP 状态、正文、停止原因和用量
| 检查项 | 原生字段 | 兼容字段 | 通过条件 |
|---|---|---|---|
| HTTP 状态 | 保存的 status | raw.status_code |
2xx |
| 正文 | 非 thought text 拼接 |
choices[0].message.content |
等于 NEON_OK |
| 停止原因 | candidates[0].finishReason |
choices[0].finish_reason |
已记录,并与正文情况一致 |
| 用量 | usageMetadata |
usage |
已记录,用于和日志对照 |
如果某个字段在响应里不存在,就把它记为“未返回”,不要按经验去推断它的值。停止原因要和正文放在一起看。正文为空,而停止原因又不是正常结束时,问题通常出在生成过程,而不是解析代码。
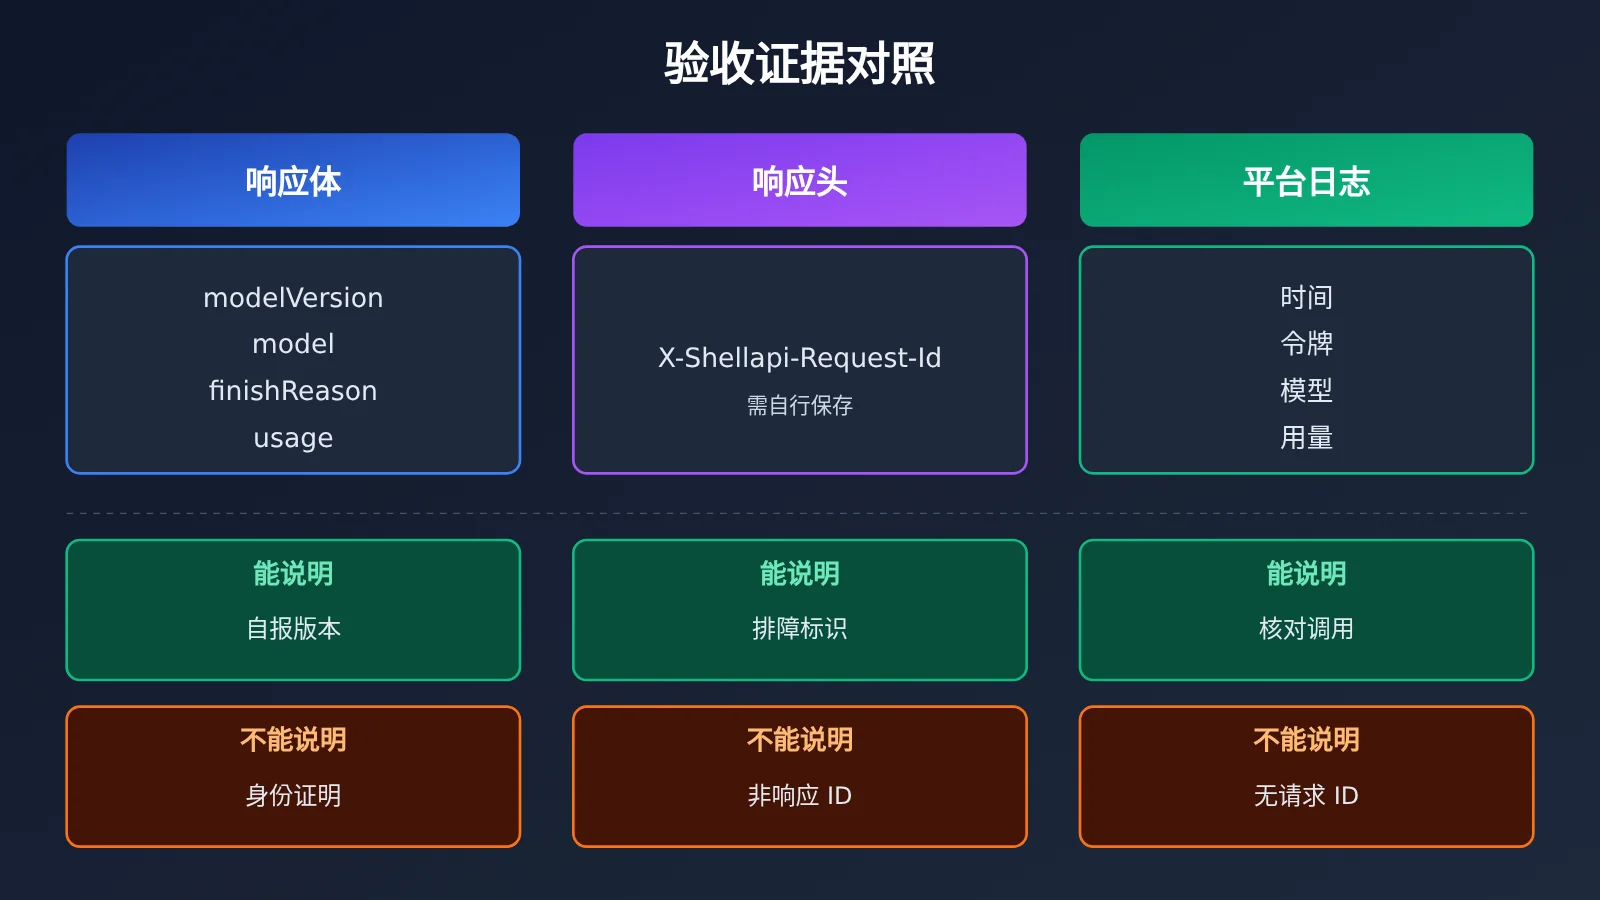
3.2 原生 modelVersion、兼容 model 与日志各能说明什么
这几项信息各自能证明的范围不同,记录时不要互相替代:
| 信息 | 来源 | 能说明 | 不能说明 |
|---|---|---|---|
modelVersion |
原生响应体(如果返回) | 响应自报的模型版本 | 不能单独作为身份证明 |
model |
兼容响应体 | 响应自报的模型名 | 同上 |
| 平台日志 | api.apiyi.com/log |
按时间、令牌、模型、用量核对这次调用 | 控制台不显示请求 ID |
X-Shellapi-Request-Id |
原始响应头或错误信息 | 平台排障时用的请求标识 | 它不是 responseId、Chat id,也不是 SDK 的 _request_id |
核对日志时,用请求发出的时间、所用令牌、模型名 gemini-4-neon 以及用量数字去匹配。由于控制台不显示请求 ID,X-Shellapi-Request-Id 必须自己从响应头里保存下来,事后在控制台是查不到的。
3.3 Gemini 4 Neon 没有正文或请求失败时怎样留证
请求失败或者没有正文时,先不要重试,按下面的顺序保存证据:
- 保存 HTTP 状态码。如果是连接错误,记下异常类型。
- 保存原始响应头,从中取出
X-Shellapi-Request-Id。 - 保存原始响应体或错误信息,并去掉 API Key 等敏感内容。
- 记录停止原因和用量(如果有),以及请求发出的时间、所用令牌名称、模型名。
- 到
api.apiyi.com/log按时间和令牌找到对应的记录,再拿着上面的材料对照平台的请求 ID 排障文档处理。
关于原生响应还有一点要注意。如果 parts 里只有 thought 内容,过滤后的正文就会是空的。这时应该如实记录“过滤后正文为空”,不要为了拿到输出而把 thought 内容当成正文。
单轮纯文本按上面的方式验收通过以后,再根据项目需要去验证流式输出、工具调用等能力。每加一项能力,都按“同一请求、保存原始响应、对照日志”的方法单独验收。本文不涉及跑分和价格,相关信息请以官方发布和 API易公开目录为准。
参考资料
- Google AI Studio 更新日志(2026-11-18):
aistudio.google.com/docs/changelog - Gemini GenerateContentResponse 结构:
aistudio.google.com/api-reference/generate-content - API易 Gemini 4 Neon 上架公告与两协议示例:
docs.apiyi.com/news/gemini-4-neon-launch.md - API易 Gemini 响应处理:
docs.apiyi.com/api-capabilities/gemini/response-handling - API易 OpenAI 兼容响应处理:
docs.apiyi.com/api-capabilities/openai/response-handling - API易 请求 ID 排障:
docs.apiyi.com/faq/request-id-troubleshooting - openai-python 原始响应访问:
github.com/openai/openai-python
千里之行,始于足下。——《道德经》